
#사실탐색기
9개의 포스트
한 줄만 틀려도 버린다 — 뉴스 4만 7천 묶음을 읽힐 LLM, 7종 12가지 설정을 같은 검증기로 재다
사실탐색기는 같은 사건을 다룬 기사 묶음 4만 7,300개에서 주장·시점·같은 사건 관계를 원문 인용과 함께 뽑아야 합니다. 어느 모델에 맡길지 정하려고 Claude 3종, DeepSeek Flash, Muse Spark, 무료 K-EXAONE, 사내 A100에 올린 Qwen3.8-27B까지 7종 12가지 설정을 같은 지시문과 같은 검증기로 쟀습니다. 검증기는 행 하나만 틀려도 이야기 전체를 거부합니다. 그래서 순위는 ‘통과하면 얼마나 잘하나’보다 ‘긴 이야기에서 끝까지 버티나’로 갈렸습니다. Claude Haiku 5.5는 7개를 모두 통과하며 기준 주장의 89%를 회수했습니다. DeepSeek·EXAONE·Qwen은 통과한 이야기에서는 72~88%를 회수하고도 긴 이야기를 거의 다 잃어, 판본에 남은 양이 14~29%였습니다. 지시문 한 줄은 Sonnet 5.5의 회수율을 34%에서 68%로 두 배 올렸지만 DeepSeek에는 독이 됐고, 생각 모드는 답 대신 생각만 남겼습니다. 무료와 할인의 조건, 사내 GPU로 돌리는 데 드는 시간, 주장 하나당 비용까지 정리했습니다. 위젯 3종, 코어닷투데이 실측, 삽화 6장.
새 판정 모델, 한국어로 다시 재다 — StartLux·d3·Perplexity Decider·AutoTrust JEV·Liquid d1
StartLux가 0.8B부터 27B까지 모든 크기에서 동급보다 7.4~16.9점 앞선다는 그림을 냈고, d3·Perplexity Decider·AutoTrust JEV·Liquid d1이 잇달아 Ollama에 올라왔습니다. 코어닷투데이는 새 판정 모델 15가지 구성을 11월 1일과 같은 한국어 2,221문항과, 사실탐색기의 부산 공공기록으로 새로 만든 사실 탐색 1,449문항에 올렸습니다. 한국어에서 StartLux가 동급을 뚜렷하게 앞선 곳은 0.8B(+6.9점)뿐이고, 4B는 +1.5점, 2B·9B·27B는 d3와 겹쳤습니다. 게시판의 비공개 시험을 합친 총점에서도 StartLux의 공개분 우위는 크게 줄었습니다. Ollama의 d3는 8비트 포장에도 원본과 0.4점 안쪽으로 같았고, 사실 탐색에서는 d3:27b와 StartLux 27B가 87점대로 맨 위였습니다. 판정 모델의 문턱을 라벨로 고르면 값 비교는 모든 모델이 완벽했고, 남은 어려움은 ‘본문에 이유가 적혀 있는가’를 묻는 부재 검문 하나였습니다.
‘롯데 홈구장 새로 짓는 거’를 찾아라 — 부산 공적 기록으로 잰 한국어 임베딩 모델 14종
사실탐색기가 질문 속 바꿔 말한 이름을 찾을 때 쓰는 임베딩 모델을 고르려고, 부산 공적 기록 362건에서 만든 네 과제로 임베딩 14종(설정 28가지)을 맥과 A100에서 쟀습니다. 한국어로 다시 학습한 1.1B 모델 KURE-v3가 8B 모델들보다 앞섰고, 300M짜리 EmbeddingGemma 1세대가 그 바로 뒤에 붙었습니다. 그러나 과제마다 1위가 바뀌었고, 권장 접두사를 빼면 1위 모델이 글자 검색보다도 못해졌으며, 열네 모델 가운데 여섯은 ‘7월 1일’과 ‘7월 8일’처럼 숫자 하나 다른 값의 절반 넘게를 같은 값 쪽으로 봤습니다. 무엇을 고를지와 함께, 임베딩에 맡기지 말아야 할 일을 정리했습니다.
‘299억’을 고른 재정렬기 — 재정렬기 15종·로컬 LLM·질의 고쳐 쓰기로 정한 사실탐색기 검색 설계
1편에서 고른 임베딩 KURE-v3 위에 무엇을 더 얹어야 할지 정하려고, 재정렬기 15종과 로컬 LLM 두 개, 질의 고쳐 쓰기, 문단에 제목 붙이기를 같은 부산 시험지로 쟀습니다. 재정렬기는 근거·술어 찾기를 올렸지만 주어 찾기는 대부분 깎았습니다. 작은 재정렬기는 '순천만 박람회 경제적 효과'에 대상 이름 대신 '299억'을 골랐습니다. 지시문 한 줄이 이 어긋남을 고쳤고, 값 가르기까지 거의 완벽하게 만들었습니다. 근거 찾기의 가장 큰 개선은 재정렬이 아니라 제목 붙이기였고, '기록에 없음'은 어떤 점수로도 잘 걸러지지 않았습니다. 프로덕트에 무엇을 넣을지 설치 환경별로 정리했습니다.
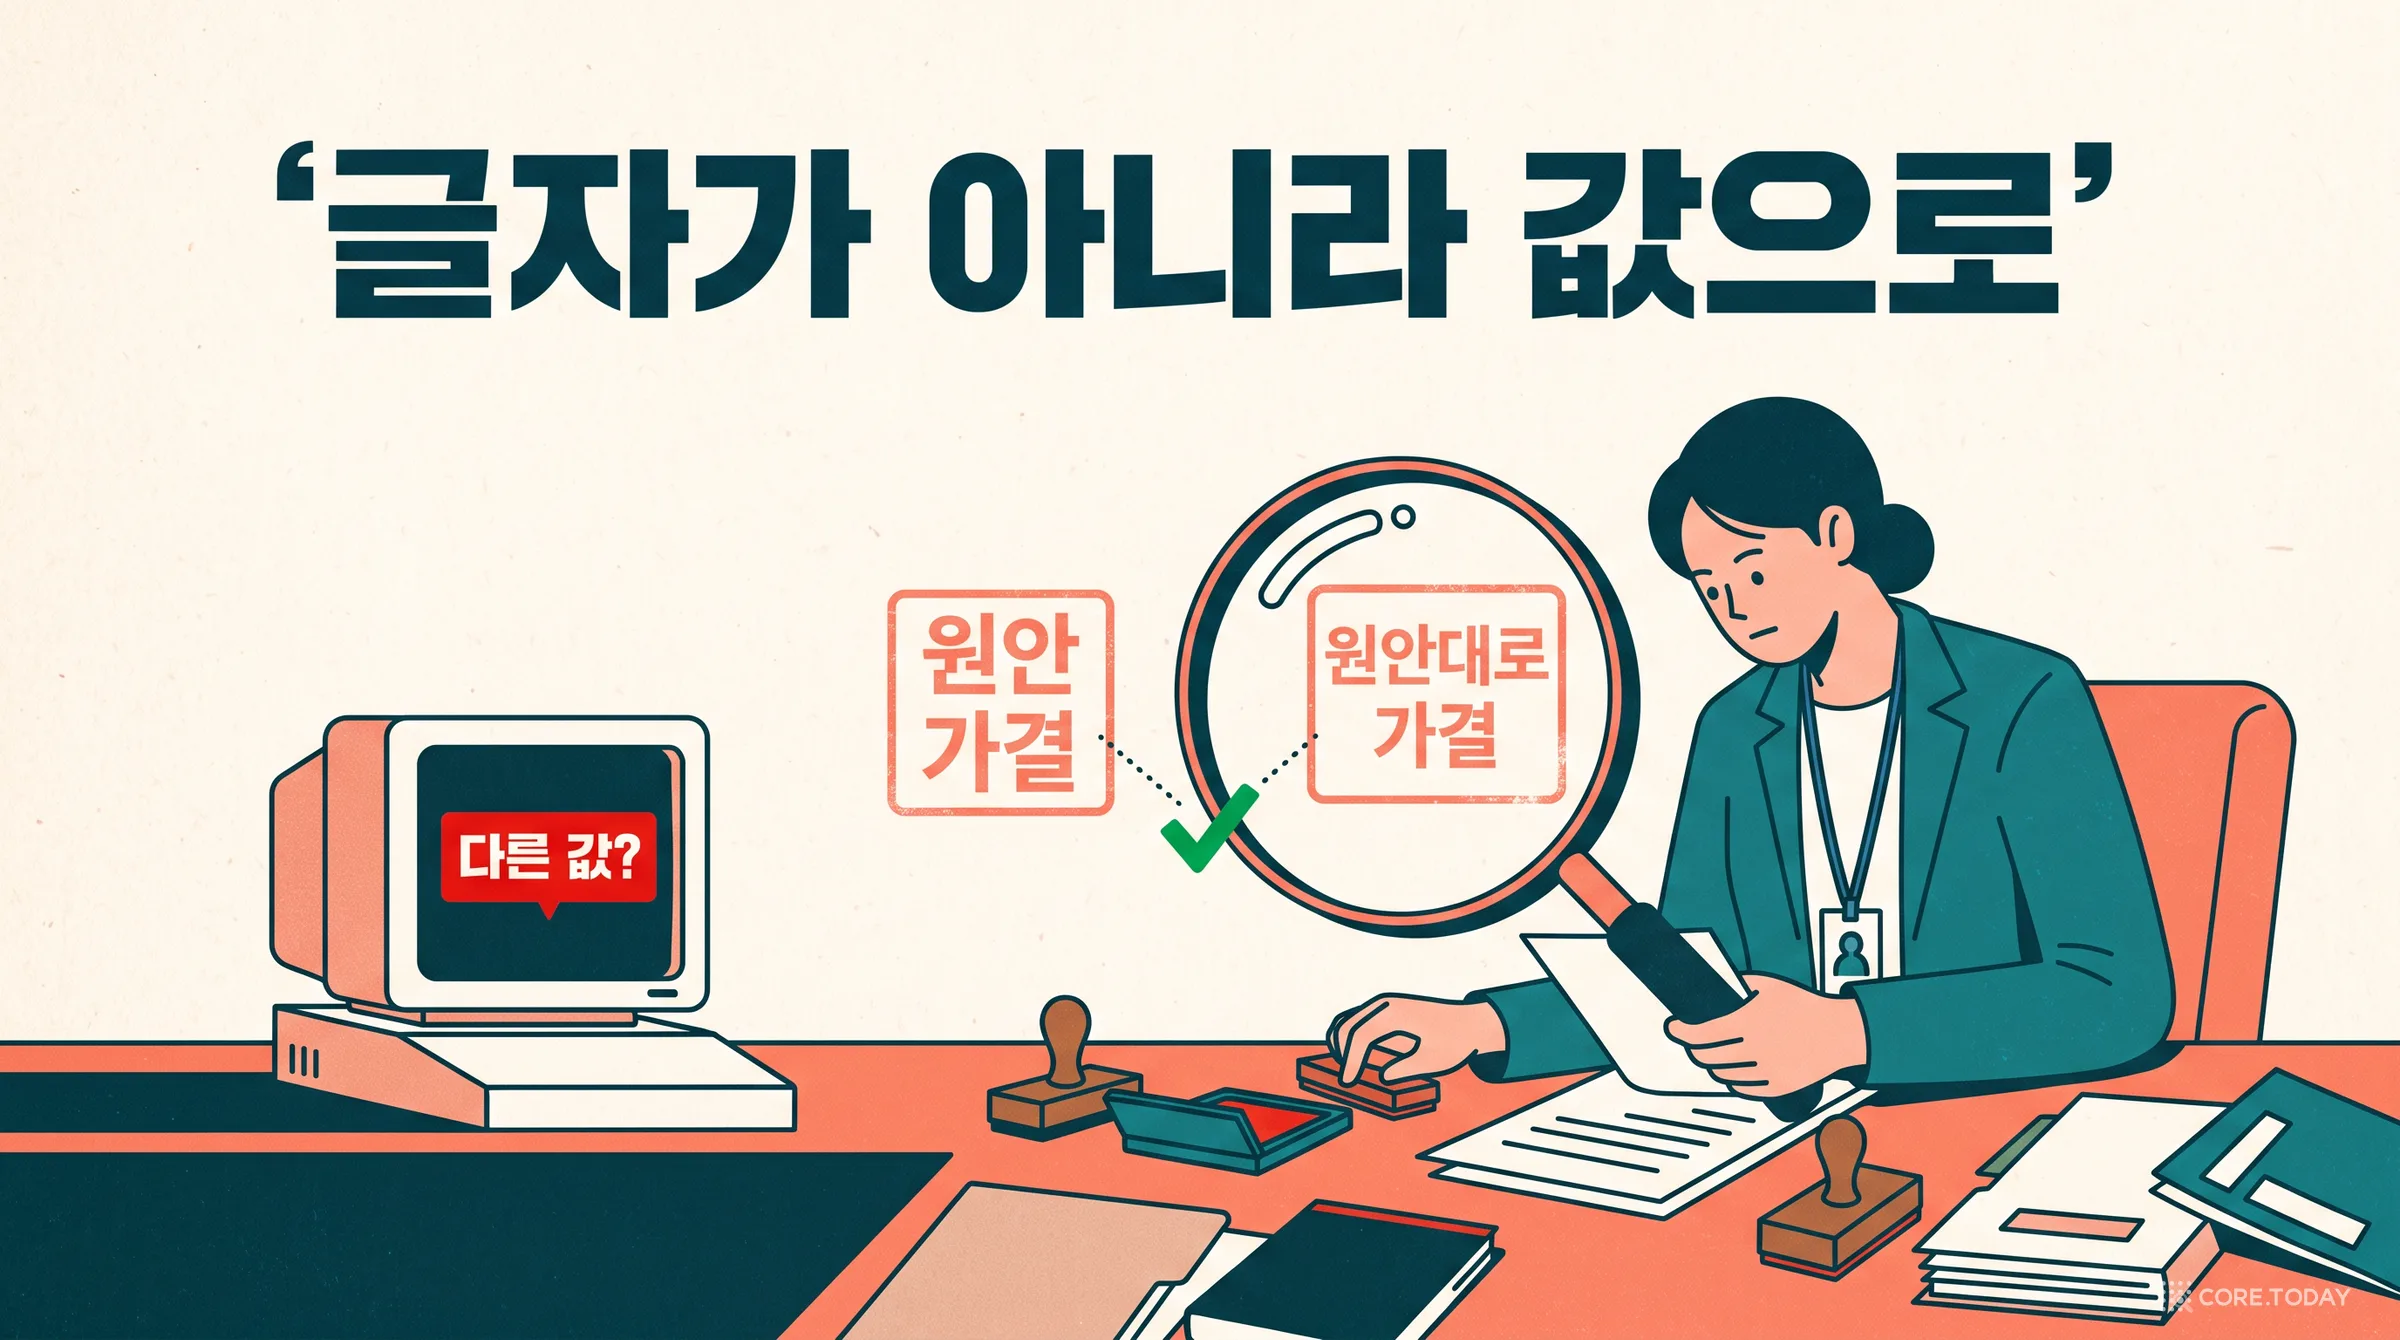
‘가결’과 ‘원안대로 가결’은 같은 값인가 — 글자 유사도를 걷어 내고 값의 ‘해상도’로 비교하기
코어닷투데이 사실탐색기는 부산시의회 회의록의 '원안 가결'과 '원안대로 가결'을 서로 다른 값으로 보고, 한 안건에 의결결과를 둘씩 열어 두고 있었습니다. 그런 안건이 134개였습니다. 같은 엔진은 '2024년 4월 1일부터'와 '…까지'를 같은 값으로 보았습니다. 원인은 둘 다 값을 글자 조각의 겹침으로 비교한 데 있었습니다. 날짜·나이 범위·의결결과를 칸이 있는 구조로 읽고, 칸이 빈 값은 '덜 자세한 같은 값'으로 다루는 계층을 넣었습니다. 그 결과 판정이 바뀐 값 쌍은 열 개였지만 명제가 136개 줄었고, 설명 안 되는 대체가 7건에서 5건으로 줄었습니다. Y2K와 엑셀의 1900년 윤년, 앨런의 구간 관계 13가지, 푸앵카레와 루스의 '같은데 다른' 역설을 따라가며, 값의 해상도가 왜 값의 일부인지, 2026년의 판정 모델은 어디에 서야 하는지 정리했습니다.
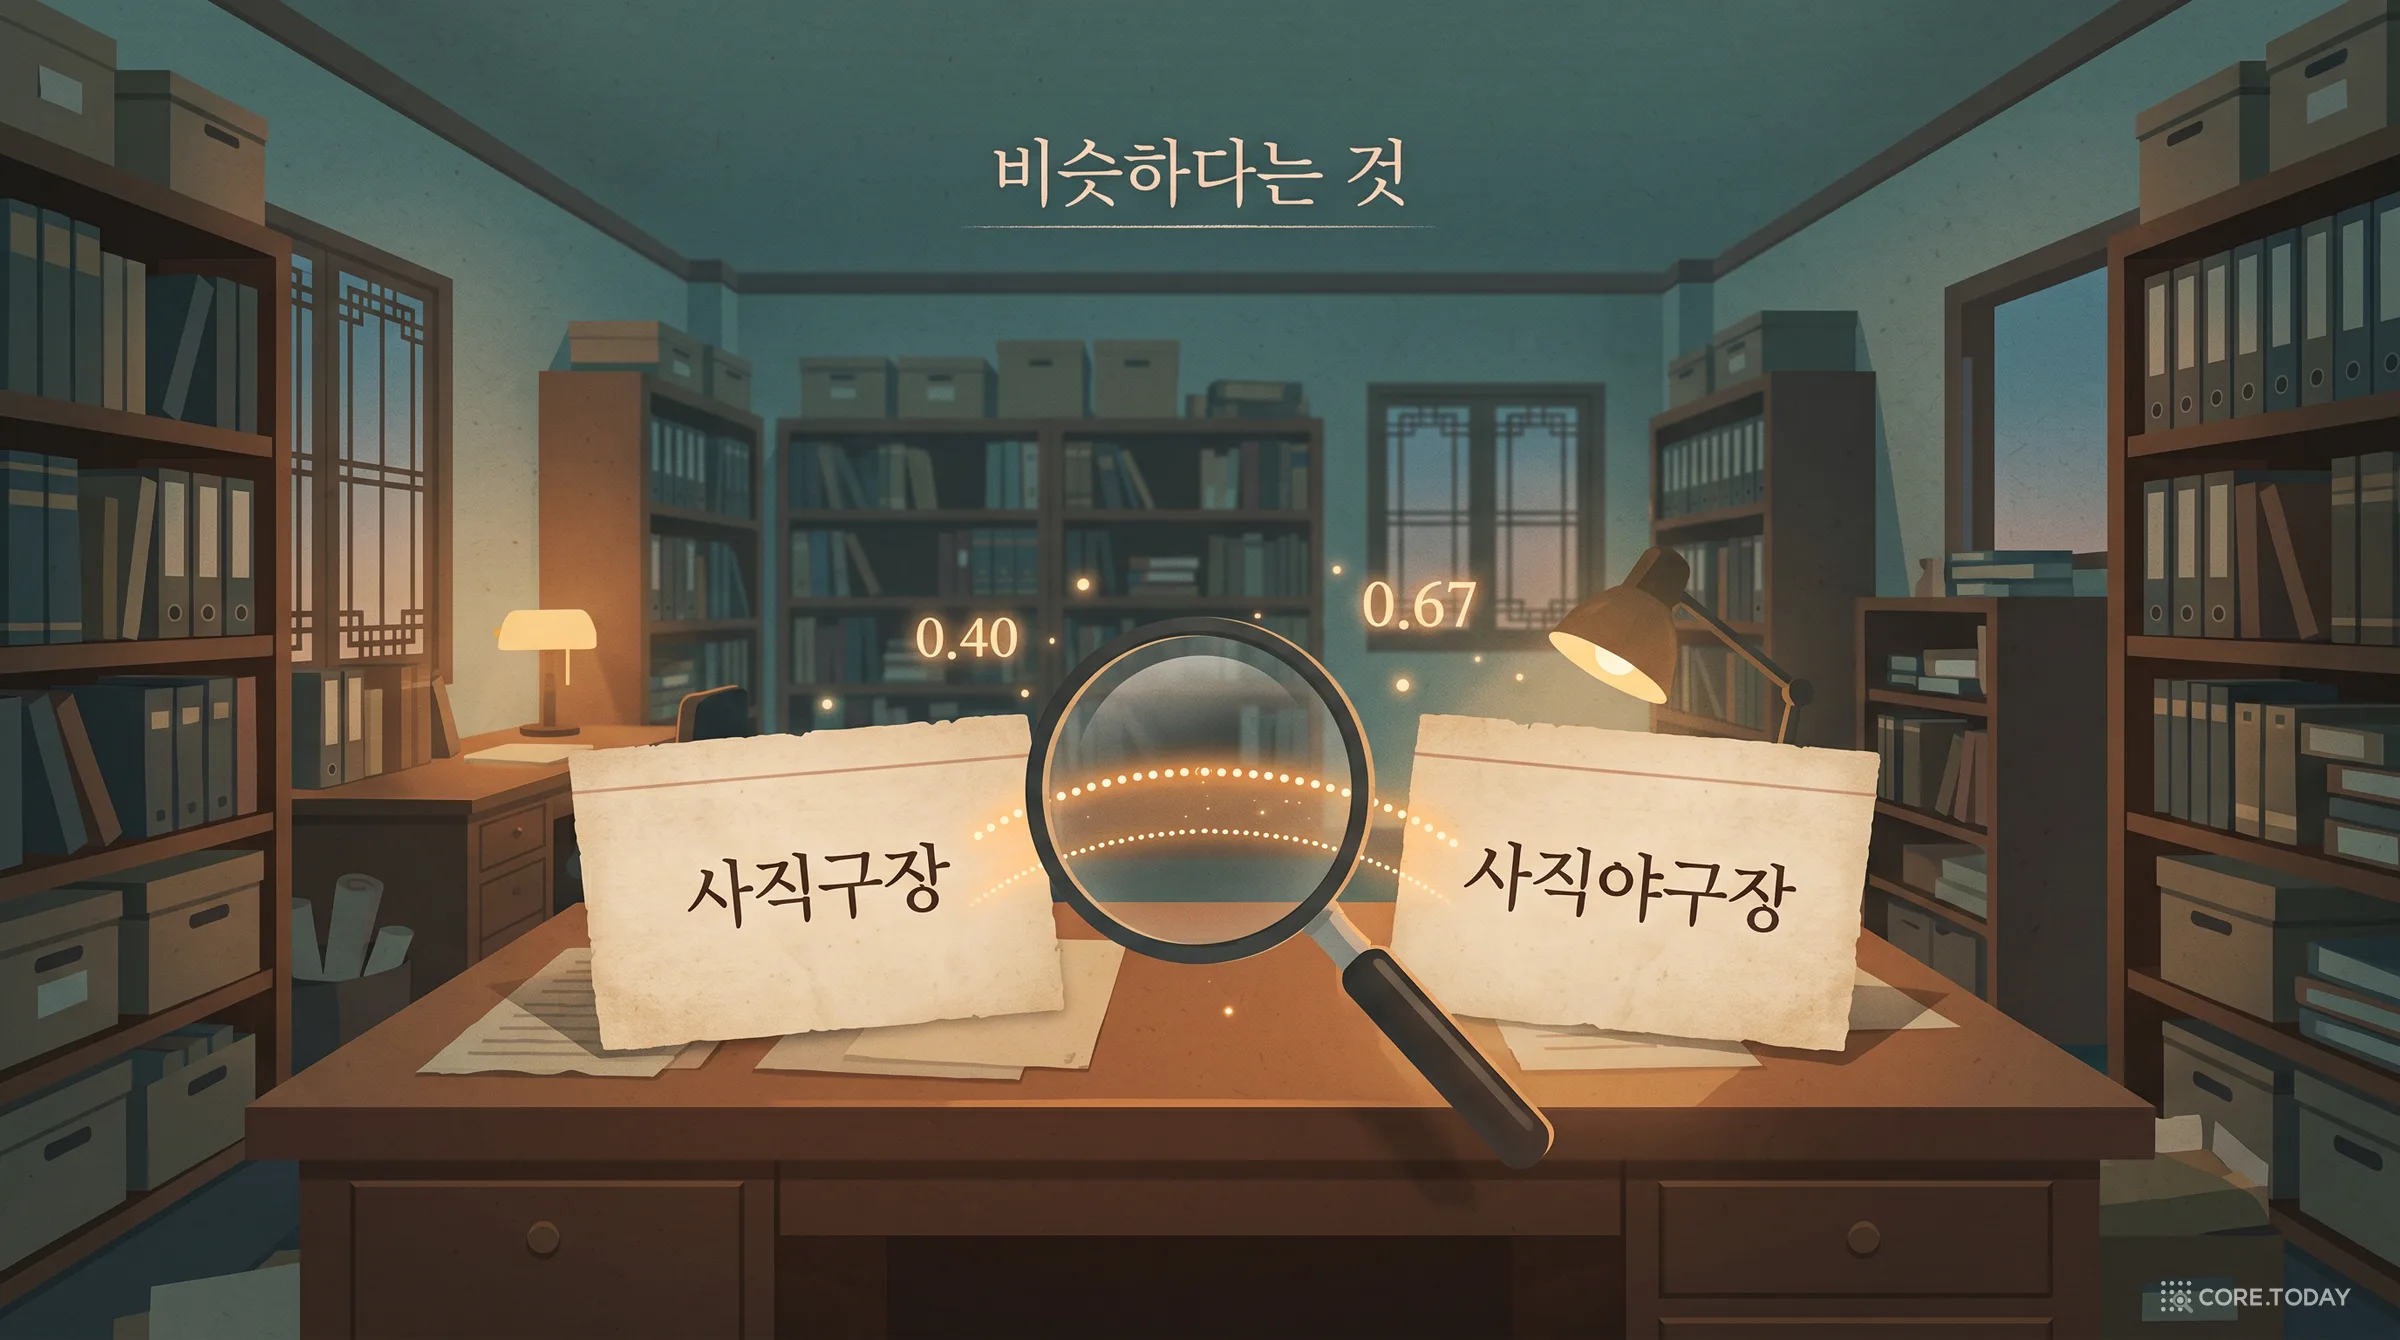
‘비슷하다’는 네 가지 질문이다 — 알프스 꽃밭의 자카드에서 2026년 한국어 사실탐색기까지, 유사도 125년
2026년 10월, 코어닷투데이 사실탐색기는 부산 조례 부칙의 '1981년 1월 1일부터 시행'과 '1984년 1월 1일부터 시행'을 같은 값으로 묶었습니다. 두 문장이 71% 비슷하다는 계산 때문이었습니다. 이 글은 '비슷하다'를 재는 기술이 왜 생겨났는지부터 시작합니다. 1901년 알프스 식물 목록을 비교한 자카드, 인구조사 이름을 소리로 묶은 사운덱스, 단어를 벡터로 바꾼 설턴과 IDF의 스파크 존스, 뜻을 좌표로 만든 임베딩까지요. 그리고 같은 기술이 한국어 공적 기록 앞에서 어디서 미끄러지는지, 2026년 임베딩 14종 실측과 최신 논문으로 따라갑니다. 결론은 하나입니다. '비슷하다'는 같은 대상·같은 값·같은 사건·비슷한 사안이라는 네 가지 다른 질문이고, 질문마다 도구가 다릅니다.
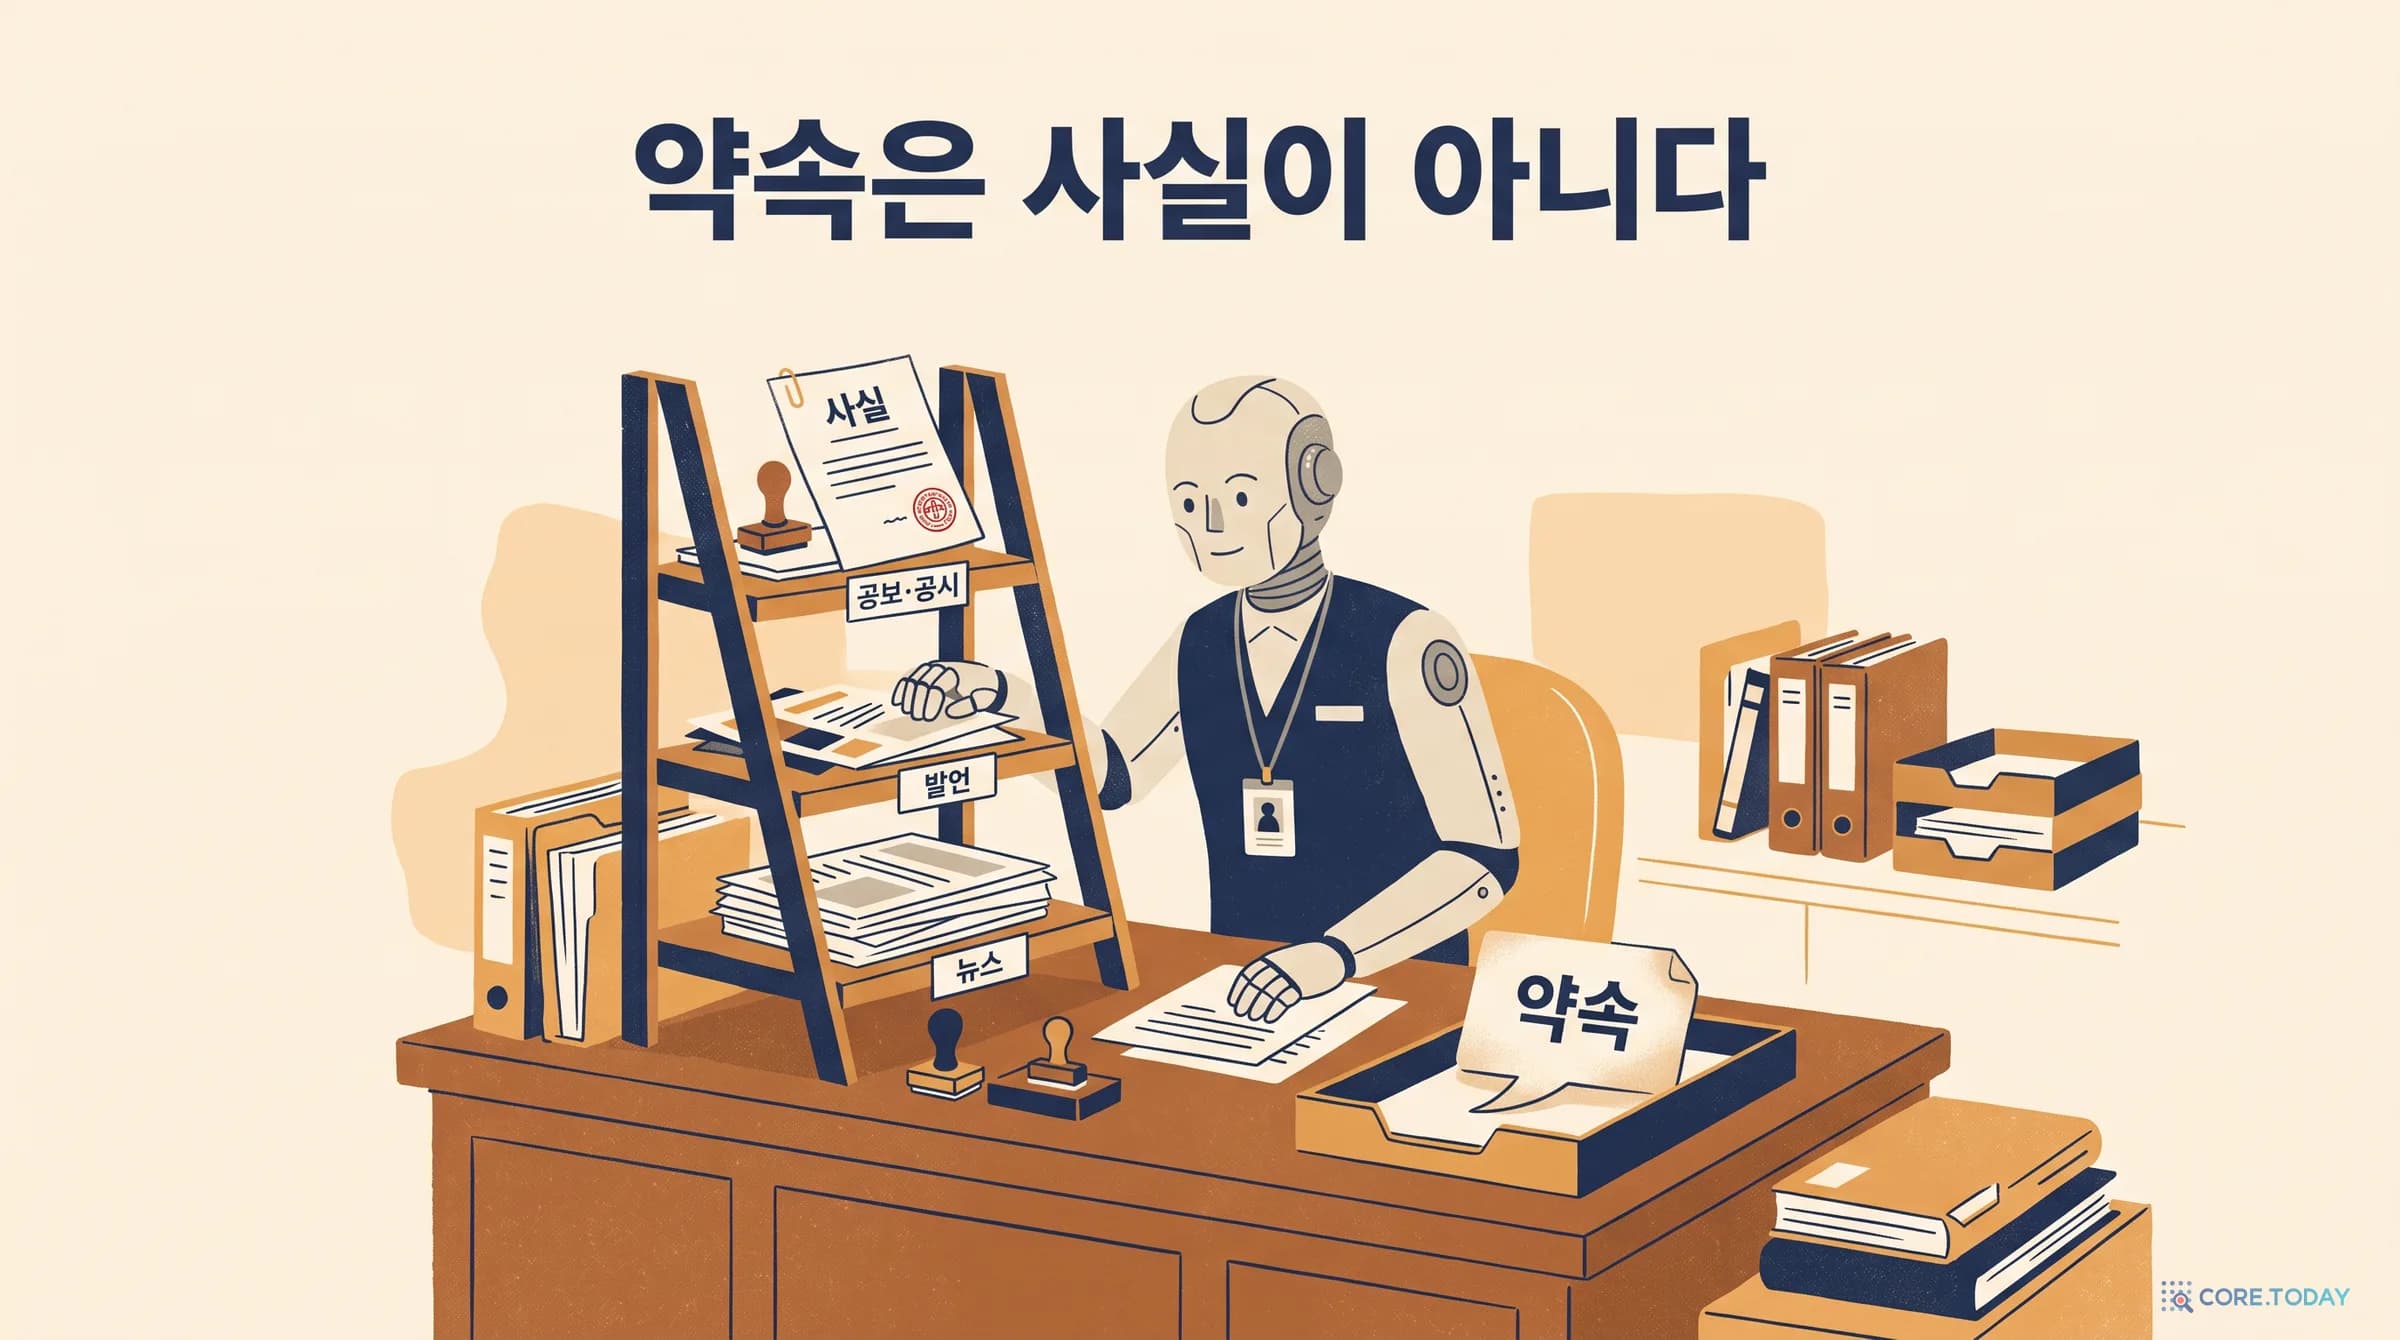
약속은 사실이 아니다 — 코어닷투데이 사실탐색기 v2 설계
에이전트 기억 엔진 다섯 개를 해부하고 나서 남은 질문은 하나였다. 공적 기록에서 '지금 참인 것'은 무엇이고, 누가 그것을 바꿀 수 있는가. 최신 문장이 이기는 기억은 개인 비서에게는 맞지만, 국장의 약속·뉴스의 오보·공보의 확정이 섞인 세계에서는 틀린 답을 자신 있게 낸다. 코어닷투데이 사실탐색기 v2는 문장을 클레임과 명제로 가르고, 권위 격자(전언 ≺ 1인칭 ≺ 공식)와 발화행위로 '닫을 자격'을 따지는 AGS(권위 기반 대체)를 중심에 둔다. 닫는 조건 다섯 가지, 도착 순서와 무관한 키별 재생, 허용성 세 축과 인증서로 정하는 기권, 지우지 않고 가리는 봉인, 세상 사실과 사용자 기억의 분리, 그리고 한국어를 1급 시민으로 다루는 결정론 계층까지 — 설계의 뼈대를 위젯 4개로 직접 돌려 본다.
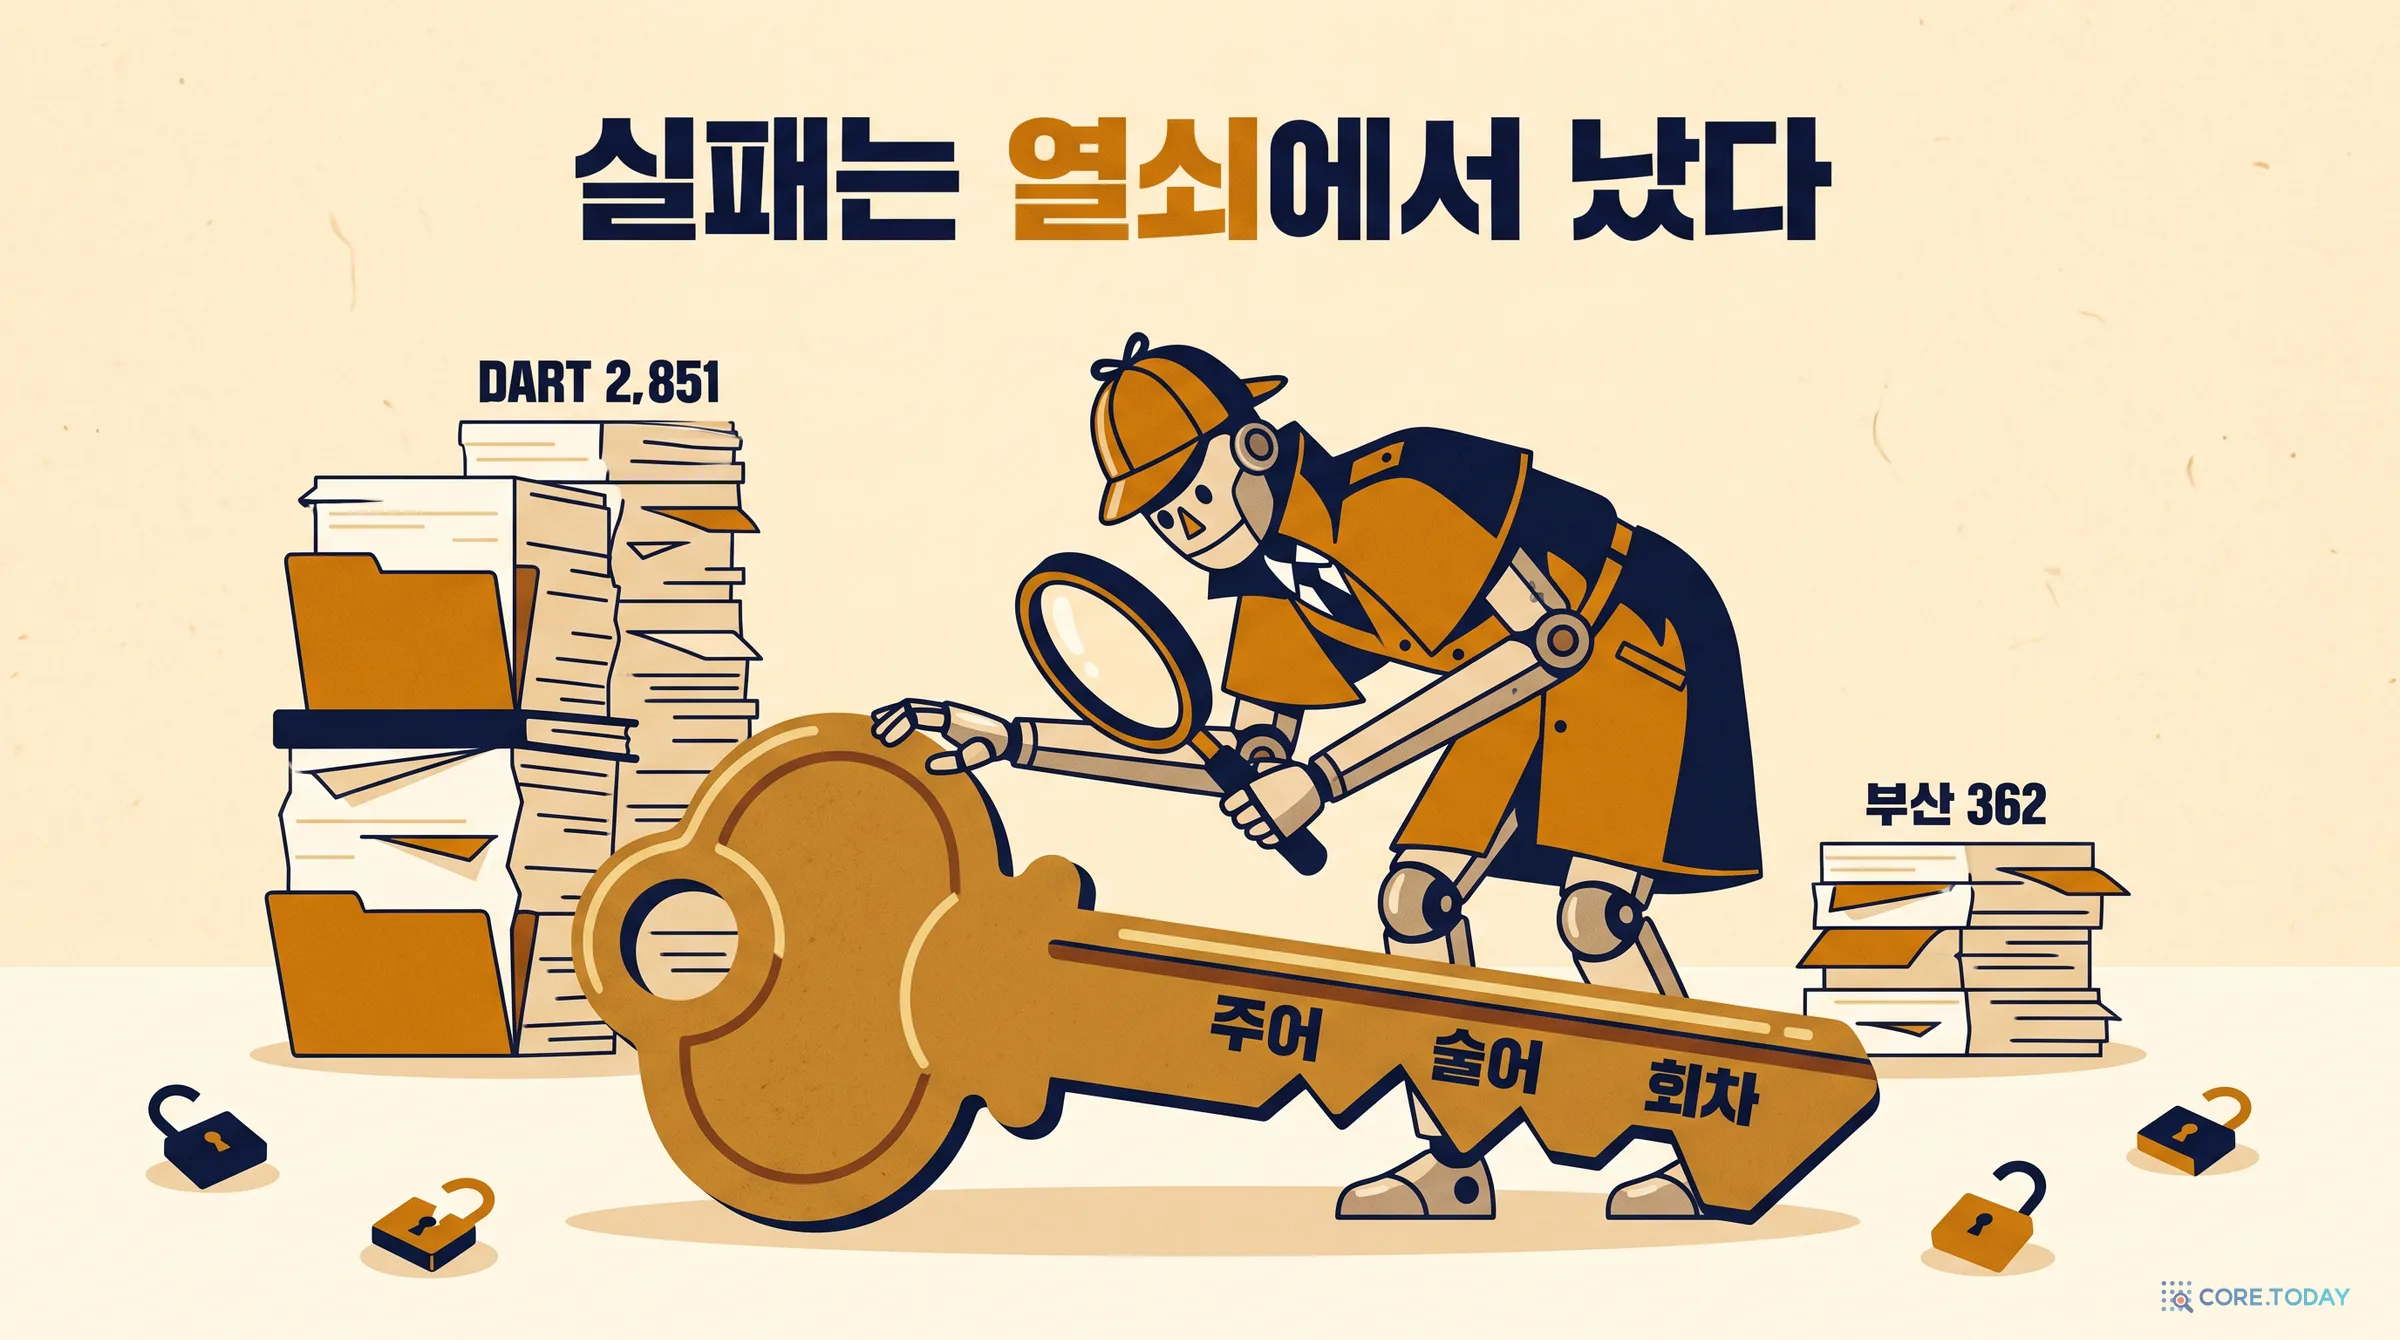
실패는 열쇠에서 났다 — 사실탐색기 v2를 실제 공시 2,851건과 부산 기록 362건에 돌려 보니
합성 코퍼스에서 모든 질문을 맞힌 사실탐색기 v2를 실제 기록에 넣었다. 2026년 DART 배당 공시 2,742건과 뉴스 109건, 부산시의회 회의록·고시공고·조례 공포문·현행 조례 362건이다. 깨진 곳은 권위를 따지는 AGS가 아니라 그 앞의 '열쇠'였다. DART에서 정정이 아닌 대체 305건 가운데 304건이 열쇠 오류였다. 분기배당 네 번이 한 열쇠가 되었고, 지주사가 자회사 배당을 다시 낸 공시가 주체를 바꿨고, 서로 다른 조례의 '이 조례'가 시행일을 서로 덮었다. 원칙 하나 — 기록 밖에서 뜻이 정해지지 않는 주어는 그 기록의 이름으로 좁힌다 — 와 측정으로 고른 회차 간격 45일·연도 오기 문턱 180일, 그리고 '설명되지 않는 대체'라는 건강 신호로 부산의 숨은 버그 94건을 6건까지 줄인 과정을 위젯 4개로 따라간다.
최신 기사는 대체로 맞다, 엇갈린 값은 끝내 남는다 — 기사 2천 건에서 사실 1,831개를 따라가 보니
뉴스를 읽는 기계는 흔히 '가장 최근 기사의 값'을 믿습니다. 13개 언론사 여드레치 기사 2천여 건에서 두 기사 이상이 함께 실은 사실 1,831개를 뽑아 값이 어떻게 갈리는지 따라갔습니다. 89%는 처음부터 끝까지 같은 값이었고, 실제로 바뀐 사실에서도 가장 최근 기사는 91%가 지금 값을 담고 있었습니다. 출처 등급을 앞세운 규칙(85%)보다 나았습니다. 문제는 다른 데 있었습니다. 새 값이 나온 뒤에도 여덟 건 중 한 건은 옛 값만 실었고, 출처마다 엇갈린 값 35개 중 31개는 마지막 날까지 정정되지 않고 나란히 남았습니다.