
#뉴스 분석
4개의 포스트
최신 기사는 대체로 맞다, 엇갈린 값은 끝내 남는다 — 기사 2천 건에서 사실 1,831개를 따라가 보니
뉴스를 읽는 기계는 흔히 '가장 최근 기사의 값'을 믿습니다. 13개 언론사 여드레치 기사 2천여 건에서 두 기사 이상이 함께 실은 사실 1,831개를 뽑아 값이 어떻게 갈리는지 따라갔습니다. 89%는 처음부터 끝까지 같은 값이었고, 실제로 바뀐 사실에서도 가장 최근 기사는 91%가 지금 값을 담고 있었습니다. 출처 등급을 앞세운 규칙(85%)보다 나았습니다. 문제는 다른 데 있었습니다. 새 값이 나온 뒤에도 여덟 건 중 한 건은 옛 값만 실었고, 출처마다 엇갈린 값 35개 중 31개는 마지막 날까지 정정되지 않고 나란히 남았습니다.
뉴스에는 대본이 없다 — 883개 후속 전개로 본 한국 뉴스 이야기의 문법
사건 보도에는 정해진 순서, 즉 대본이 있을까요? 13개 언론사 여드레치 기사에서 정답으로 확인한 후속 전개 883개에 단계 유형 22개를 붙여 다음 단계를 맞혀 봤습니다. 대본은 법이 순서를 정한 사법 절차에만 있었습니다. 그 밖에서는 유형으로 다음을 맞히는 통계가 '늘 비판이라고 답하기'와 같았습니다. 대신 규칙성은 다른 데 있었습니다. 발표 뒤에는 시행보다 비판이 세 배 많이 오고, 해명은 이야기를 잇고 재판·시행·행사는 닫습니다. 그리고 여러 단계로 이어진 이야기의 절반 가까이는 '말'입니다.
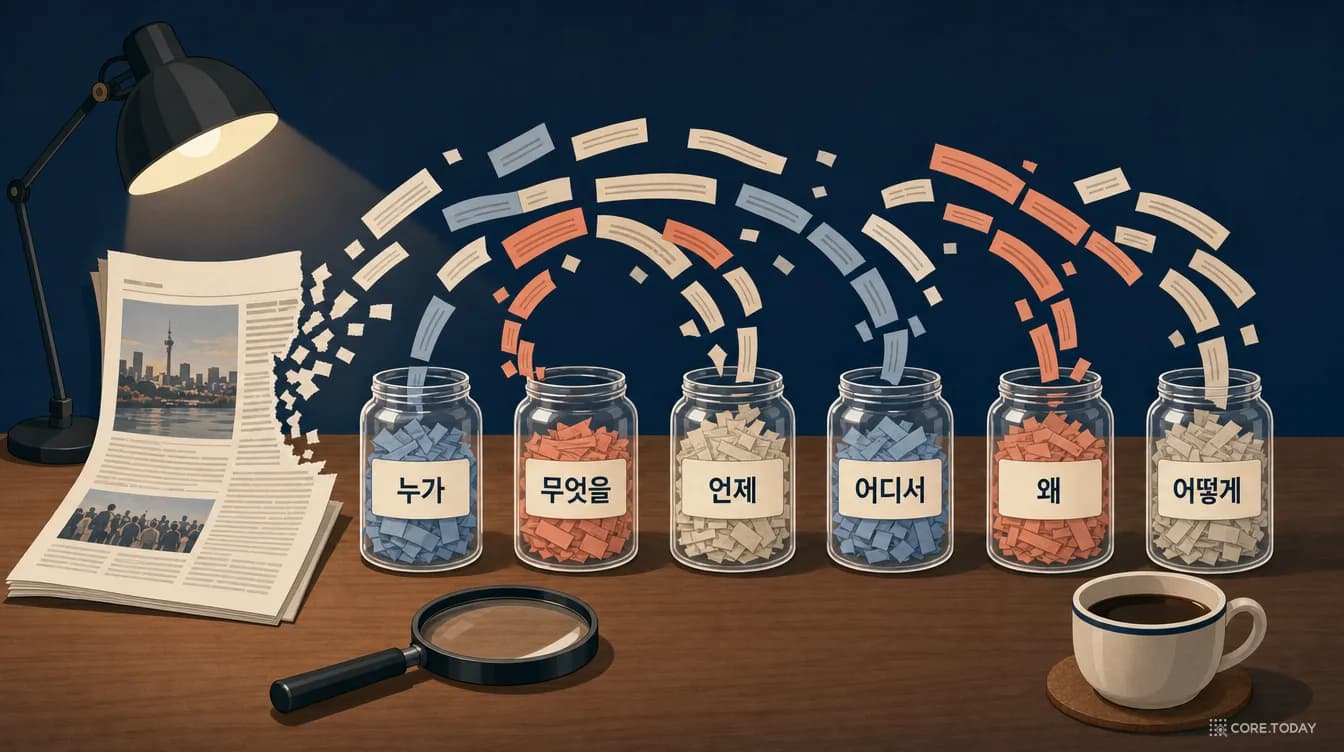
뉴스에서 육하원칙 뽑기 — 자르기·쓰기·고르기, 한국어 기사 72건으로 짠 추출 설계도
기자는 기사 첫 문장에서 여섯 질문에 답합니다. 누가, 무엇을, 언제, 어디서, 왜, 어떻게. 그걸 기계가 꺼내게 하는 손은 2026년에 네 종류입니다. 독해 모델은 자르고, 임베딩은 찾고, LLM은 쓰고, 판정 모델은 고릅니다. 연합뉴스 7개 섹션의 당일 기사 60건과 네이버 뉴스 12건, 합쳐 72건 432칸에 같은 정의서를 주고 스무 가지가 넘는 조합을 돌렸습니다. KorQuAD 독해 모델은 '이 사건의 주체는?' 같은 범용 질문에 '다소', '이미'를 잘라 와 평균 0.18에 그쳤고, 사고를 끈 Gemini 3.8 Flash가 0.86, 로컬 Qwen3.5 9B가 0.69였습니다. 판정 모델에게 후보 중 하나를 고르게 하면 정답이 후보 안에 있는데도(상한 0.9 이상) 단독 쓰기보다 낮았습니다. 반대로 '기사에 이유가 명시돼 있는가'를 따로 물으면 Nimble이 AUROC 0.85로 가려냈고, 이것을 Flash 뒤에 붙이자 '왜'가 0.73에서 0.79로, 쓰기 모델 셋의 다수결로는 0.85로 올랐습니다. 이 과제의 절반은 답을 찾는 일이고 나머지 절반은 '없다'고 말하는 일입니다. 방법별 점수표·기사별 탐색기·판정 앙상블·부재 탐지·파이프라인 설계기 위젯 5개와 삽화 6장.
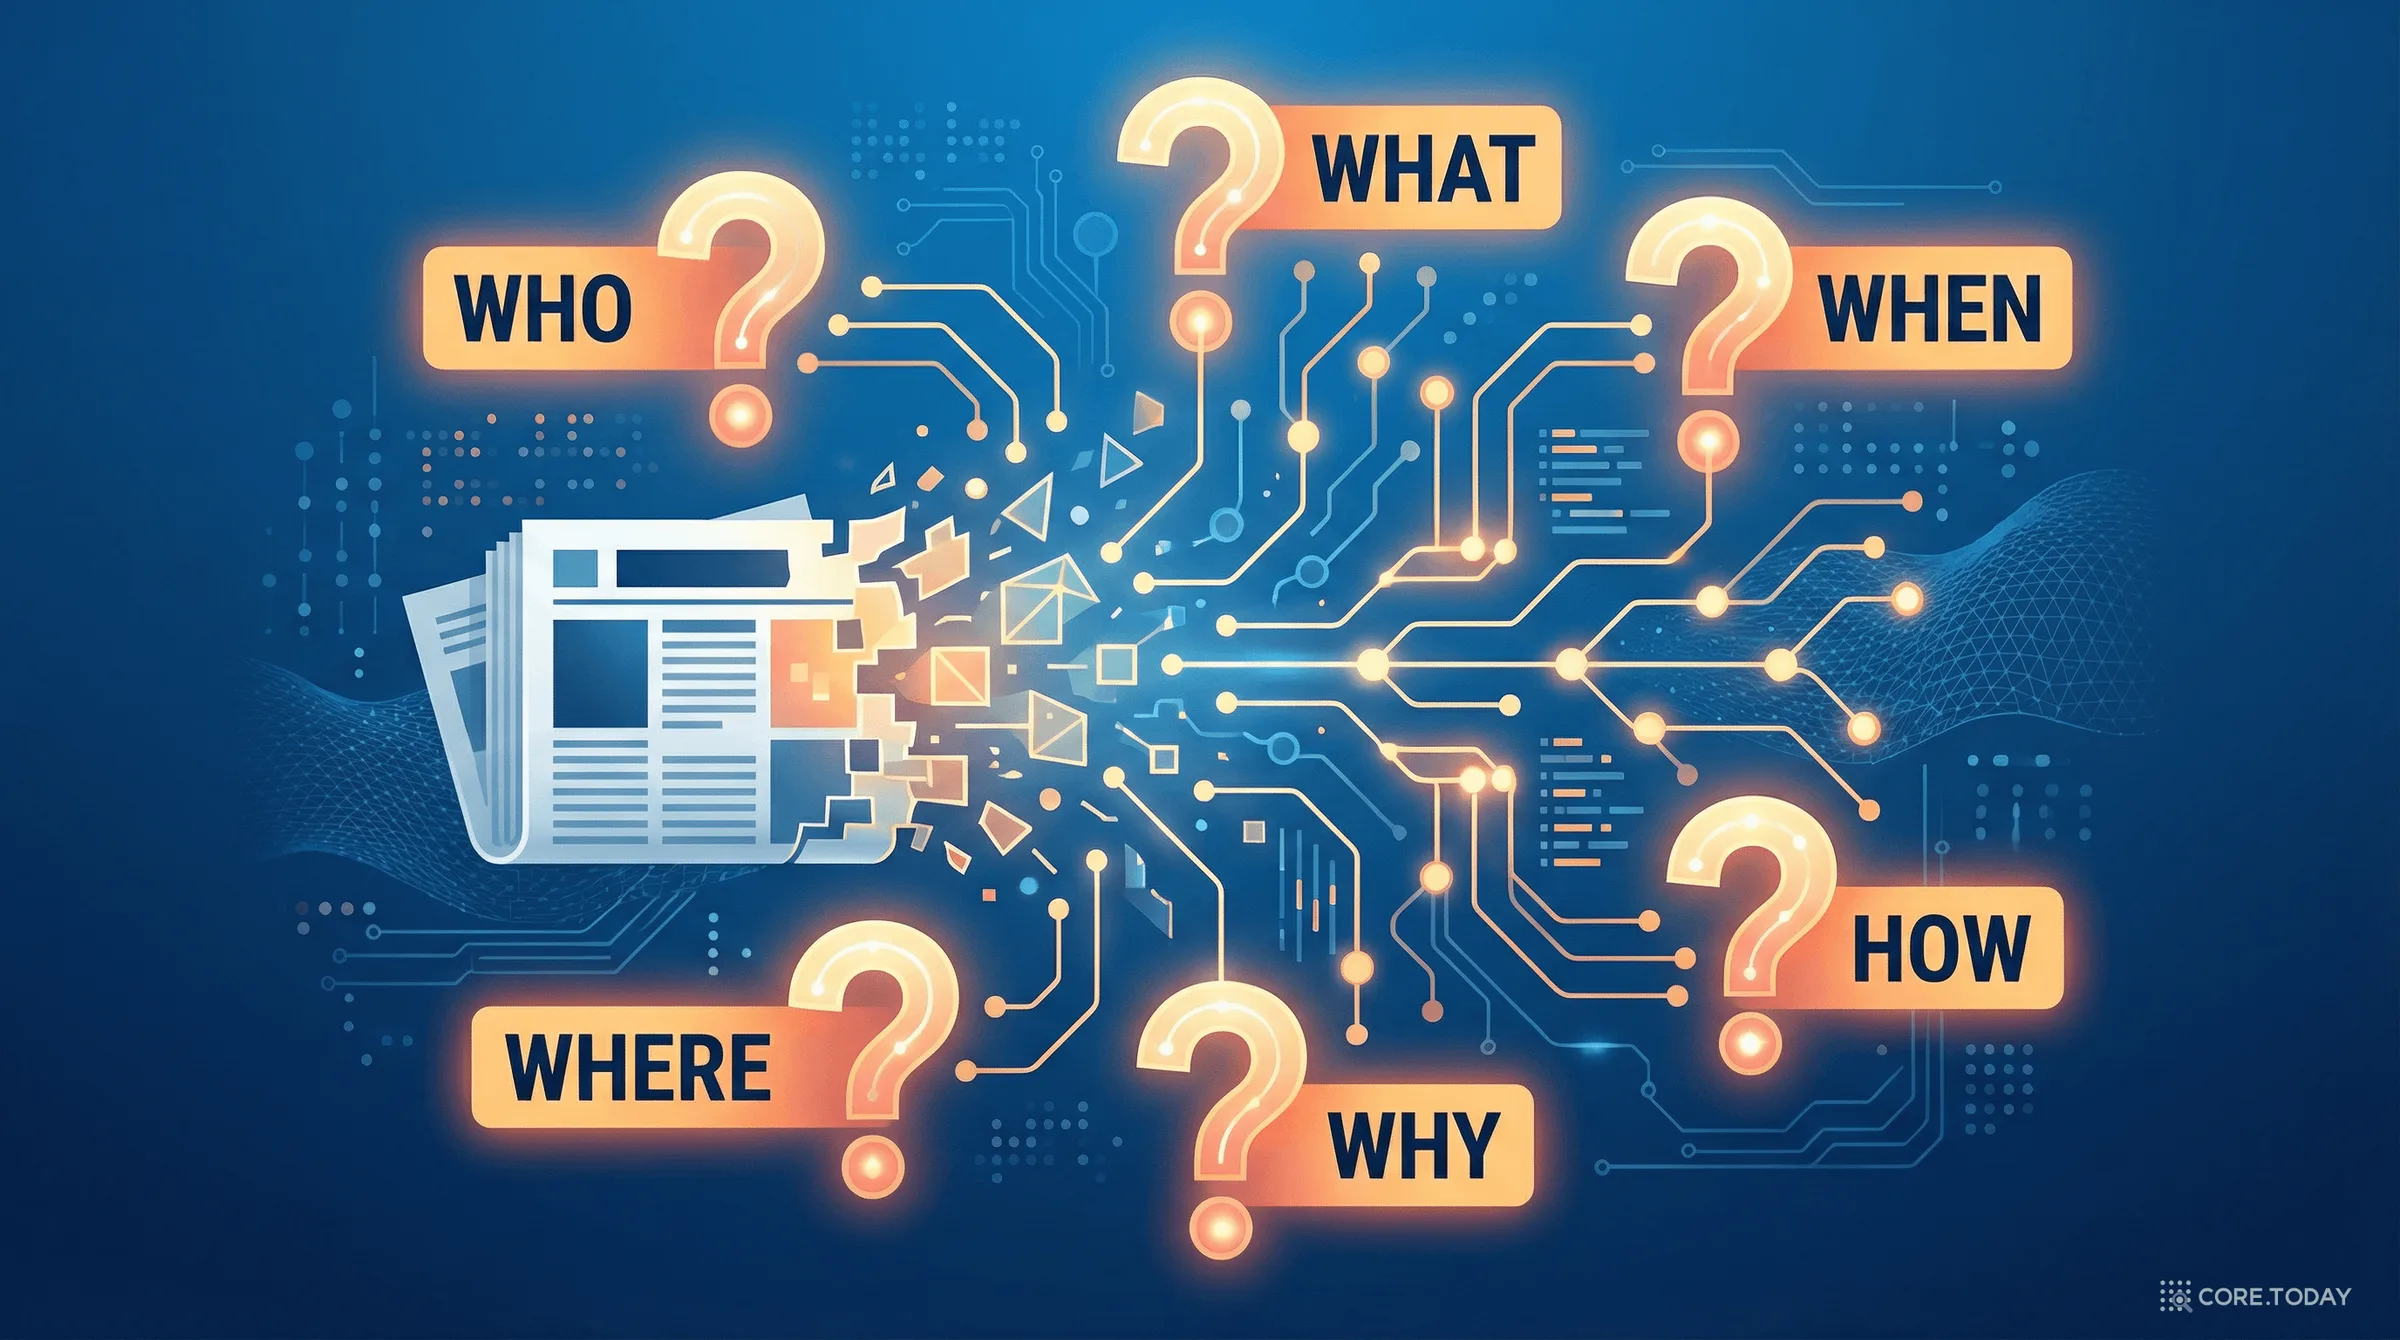
Giveme5W1H — AI가 뉴스를 읽는 법: 육하원칙으로 해체하는 기사 분석의 모든 것
기자가 기사를 쓸 때 반드시 답하는 육하원칙(누가, 무엇을, 언제, 어디서, 왜, 어떻게) — 이걸 AI가 자동으로 추출할 수 있을까? 2019년 독일 콘스탄츠 대학 연구팀이 만든 Giveme5W1H 시스템의 원리부터 2026년 LLM 시대의 의미까지, 뉴스 이벤트 추출의 세계를 완전 해부한다.