
TECH BLOG
기술 블로그
AI 기술 인사이트와 엔지니어링 경험을 공유합니다.
EDITOR'S PICK
에디터 추천
사건을 뽑는 AI에게 채점표를 주다 — EAGER로 읽는 사건 추출 40년과 '검증 가능한 보상'
GPT-5.4에게 기사를 주고 사건을 뽑으라고 하면 평균 F1이 10점 안팎입니다. 독일 DFKI의 EAGER는 70억 매개변수 모델에 '여섯 명의 채점관'과 '문제지마다 다른 오답 보기'를 붙여 평균 30.79점까지 끌어올렸습니다. 사건 추출이 1987년 MUC의 템플릿 채우기에서 어떻게 지금의 코드 생성·강화학습까지 왔는지, 검증 가능한 보상(RLVR)이 수학 밖으로 나오면 무엇이 달라지는지, 그리고 그룹 점수가 모두 같아져 학습이 멈추는 '어드밴티지 붕괴'를 SCAE가 어떻게 푸는지 풀어 씁니다. 본문과 부록 표의 숫자가 엇갈리는 곳, 보상 식을 글자 그대로 구현하면 생기는 문제도 짚었습니다. 한국어 문장 40개로 로컬 4B 모델을 360번 돌려 같은 채점표를 직접 대 봤습니다.
프롬프트 엔지니어링 완전 정복: AI에게 말 거는 기술의 모든 것
AI에게 '잘 물어보는 법'이 왜 이렇게 중요해졌을까? GPT-3의 등장부터 2026년 에이전트 시대까지, 프롬프트 엔지니어링의 역사·핵심 기법·실전 사례를 논문 기반으로 깊이 있게 풀어봅니다. 인터랙티브 실험실에서 직접 기법을 비교해 보세요.
RAG의 숨겨진 약점: '충분한 컨텍스트'가 환각을 결정한다 — Google ICLR 2025 논문 심층 분석
RAG 시스템에서 왜 여전히 환각이 발생하는가? Google Research가 ICLR 2025에서 발표한 'Sufficient Context' 개념이 그 답을 제시한다. 컨텍스트가 많다고 좋은 게 아니다 — 충분해야 한다.
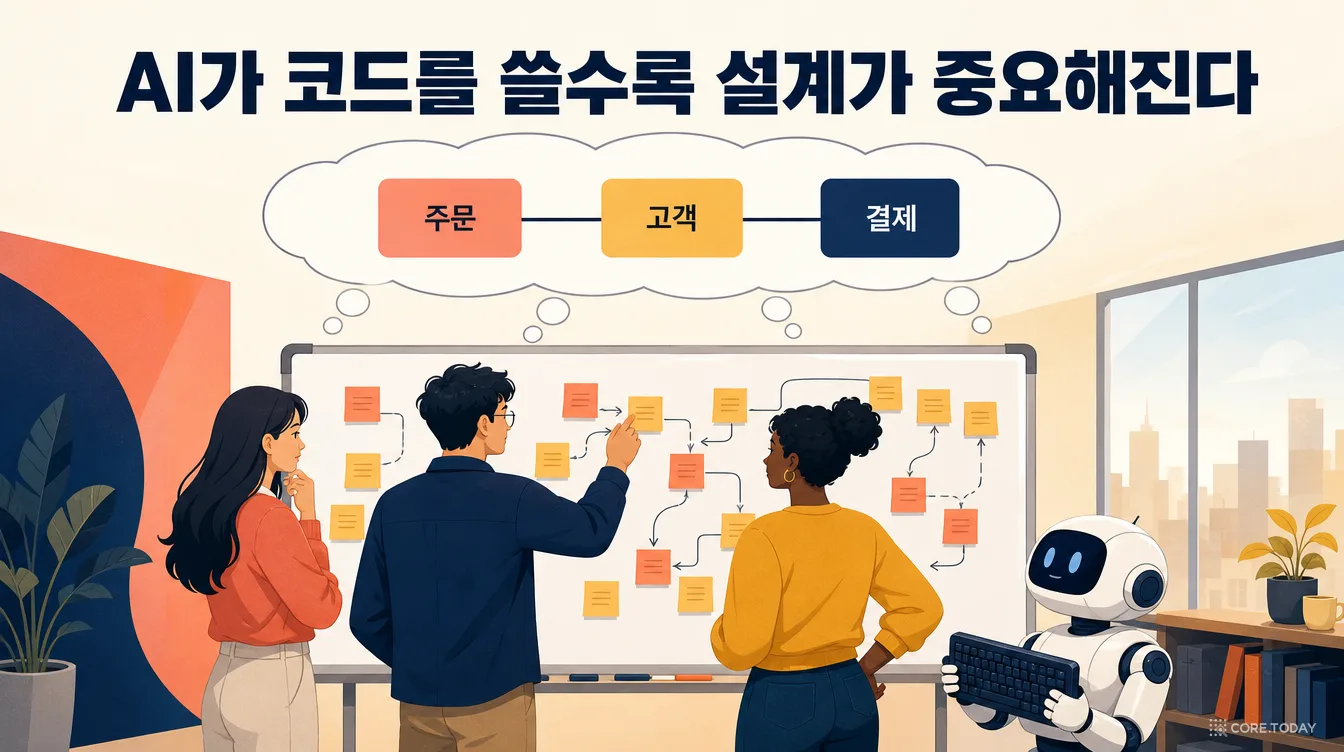
[특집] AI가 코드를 쓸수록 설계가 중요해진다 — 「도메인 주도 설계는 AI가 코드를 쓸 때 더 중요해진다」 완전 해부
2026년 8월 20일, 폴란드의 Go 백엔드 교육 회사 스리 닷 랩스의 공동창업자 미워시 스몰카가 올린 에세이 한 편이 두 달에 걸쳐 조용히 퍼졌다. 주장은 단순하다 — '에이전트를 어떻게 설정하고 어떤 LLM을 쓰는지는 해법에 대한 명확한 정신 모델만큼 중요하지 않다. 둘 중 하나를 골라야 한다면 나는 생각을 건너뛰느니 코드를 한 줄도 직접 쓰지 않겠다.' 이 글은 그 주장을 끝까지 파고든다. 2003년 에릭 에반스의 '파란 책'이 왜 나왔고 지식 탐구·유비쿼터스 언어·바운디드 컨텍스트가 정확히 무엇을 뜻하는지, 1985년 피터 나우르의 '이론 만들기'부터 2026년 OpenAI의 하니스 엔지니어링까지 어떤 계보 위에 서 있는지, 월 1달러를 아낀 에이전트 일화가 왜 팀 커뮤니케이션의 축소판인지, 그리고 Faros·METR·GitClear·LinearB의 2025~2026년 데이터가 '쓰기가 싸지자 읽기가 비싸졌다'를 어떻게 증명하는지를 사례와 함께 풀었다. 본 버논의 '에이전트는 아직 도메인 모델을 못 만든다'는 증언, 에반스의 2026년 기조연설, 네이버·카카오·삼성·토스의 AI 코딩 도입과 GeekNews의 차가운 반응까지 — 다섯 개의 인터랙티브 도구로 2026년 가을 한국의 독자가 이 글에서 가져갈 것을 정리했다.
ALL POSTS
모든 포스트
[특집] 본문에 없는 사실은 받지 않는다 — 앵커로 묶은 지식 그래프 추출 AEVS, 그리고 출처를 글자 단위로 다는 시대
LLM에게 문서에서 사실(주어·관계·목적어)을 뽑게 하면 '세상에서는 참이지만 본문에는 없는' 트리플이 섞입니다. 2026년 3월 MDPI Computers에 실린 AEVS는 본문에서 개체·관계구·값과 그 글자 위치를 먼저 찾아 '앵커'로 삼고, 트리플을 앵커로만 조합한 뒤, 원소마다 원문으로 되돌려 검증합니다. 세 데이터셋에서 학습 모델과 EDC를 넘었고, 남은 오류의 95% 이상은 개체가 아니라 관계였습니다. 다만 'EDC 대비 최대 +0.152'는 서로 다른 모델끼리의 비교였고(같은 모델이면 +0.007~+0.074), 공개 코드는 논문과 달리 셋 중 둘만 맞아도 통과시켜 논문 자신의 환각 예시를 모두 받아들였습니다. 코어닷투데이가 로컬 모델로 한국어 30문장과 WebNLG 20문장을 다시 돌려 보니, 스키마를 준 '그냥 묻기'에서는 환각이 나오지 않았고 AEVS는 한국어에서 오히려 재현율을 잃었습니다(F1 0.80 대 0.72). 그냥 묻기에서 스키마를 빼면 F1이 0.18로 무너져, 향상의 상당 부분이 스키마 몫일 수 있음을 보여 줍니다. 검증 LLM은 본문에 충실한 반사실 트리플을 '현실과 다르다'며 거부하기도 했습니다. 역사, 논문의 주요 그림과 표, 2026년의 '글자 단위 출처' 도구들까지 함께 읽습니다.
한 문장에 사실은 몇 개인가 — Claimify, 모르면 뽑지 않는 주장 추출기
LLM의 긴 답변을 사실 확인하려면 먼저 문장을 ‘확인할 수 있는 주장’으로 쪼개야 합니다. 그런데 무엇을, 어디까지, 어떤 맥락과 함께 쪼개야 잘 쪼갠 것일까요? Microsoft Research의 Claimify 논문(ACL 2025)은 수반·커버리지·탈맥락화라는 세 잣대와, 해석이 갈리면 아예 뽑지 않는 3단계 추출기를 내놓았습니다. 팩트체킹의 역사에서 이 문제가 어떻게 나왔는지, 논문의 표와 그림이 무엇을 말하는지, 2026년에 이 기술이 어디에 쓰이는지 정리하고, 논문 프롬프트를 그대로 로컬 9B 모델에 넣어 한국어 답변으로 직접 돌려 보니, 문장 고르기와 물러서기는 재현됐지만 수반은 76%에 그쳤고, 주어가 생략된 문장에서는 모호성을 절반도 못 알아봤으며, 세 번 생성해 다수결하는 설정을 줄이자 틀린 사실이 검증대에서 사라졌습니다.
판정 모델 219개, 무엇을 골라야 하나 — Jev부터 GLiDE·Sieve·KnowLine까지 네 가지 질문
Decision Index에 오른 공개 판정 모델이 두 달 만에 219개가 됐습니다. 코어닷투데이는 0.8B부터 36B까지 25개 모델을 같은 한국어 2,221문항과 인젝션·규칙 시험에 올리고, 라이선스와 가격까지 비교했습니다. 한국어 1군은 Sieve 82.2, Turion 82.0, KnowLine 81.4이고, 게시판 82위 d3-flash(9B)가 Jev 1.13과 같은 74.2를 냈습니다. 게시판 총점은 한국어 점수를 ±5점으로 맞혔고, 새 영역 열이 낫다는 가설은 사전 예측 시험에서 무너졌습니다. 9B 이하는 운영 규칙을 거의 듣지 않았고, API 값은 체급과 거의 무관했습니다. 어떤 일인가, 남의 글이 섞이는가, 얼마나 틀려도 되는가, 어디서 돌릴 수 있는가. 네 질문으로 고르는 법을 정리합니다.
AI 심판을 심판하다 — 육하원칙 추출을 채점하는 LLM 판사 벤치마크, 원자료로 다시 읽기
칠레 북부 가톨릭대 연구진이 2026년 2월 Electronics에 낸 논문은 GPT-4.1·Claude Sonnet 4.5·Gemini 2.5 Pro를 스페인어 뉴스의 육하원칙 추출을 채점하는 판사로 세우고, 기자 두 명에게 그 판결을 검수시켰습니다. 결론은 판사 셋 모두 98% 넘게 '수용'됐고 Claude가 99.79%로 1등이라는 것입니다. 이 글은 육하원칙이 2,000년 동안 어떻게 기사의 뼈대가 됐는지, 글자를 세던 BLEU·ROUGE가 왜 뜻을 못 보는지, LLM 판사가 어떤 구조로 채점하는지를 논문의 그림과 표로 차근차근 풀고, 이어서 논문 저장소의 검수 엑셀 5,736행을 직접 다시 셉니다. 기자는 판사가 1점을 줘도 5점을 줘도 거의 같은 비율(97~99%)로 동의했고, 같은 추출에 판사들 점수가 두 점 이상 갈린 358건 중 342건에서 세 판사 모두에게 동의했습니다. 카파 0.67은 4점과 5점 사이의 일치였고, ROUGE와의 상관 −0.53은 두 데이터셋을 섞어서 생긴 심슨의 역설이었습니다. 끝으로 한국어 기사 36건에 날짜·주체·숫자를 바꾸고 이유를 지어낸 함정 추출을 심어 판사가 실제로 오류를 잡는지 쟀습니다. Claude Sonnet은 함정 194쌍을 모두 깎았지만, 로컬 Qwen3.5 4B는 사실 함정 28건을 전부 5점으로 통과시키며 '출처와 완전히 일치한다'고 썼습니다. 자의 착시를 걷어 내면 이 논문이 남기는 교훈은 '판사는 쓸 만하다'가 아니라 '판사를 검증하는 방법을 바꿔야 한다'입니다. 위젯 6개와 삽화 10장.
리더보드 1·2·3위를 한국어로 붙였더니 — GLiDE·Sieve·KnowLine 판정 모델 실측
Decision Index 0.4.1에서 KnowLine 71.86, GLiDE 71.52, Sieve 71.10. 247개 모델의 맨 위에서 세 모델이 0.76점 안에 묶였고 Jev 1.13은 59.22였습니다. 그런데 이 리더보드에는 한국어가 없습니다. 코어닷투데이는 core2의 A100 80GB와 core3의 A100 40GB에 세 모델을 올려 한국어 2,221문항과 변형 문항으로 재고, Jev와 기존 로컬 모델 8종과 나란히 놓았습니다. 세 모델은 모두 Jev를 앞섰지만 5~8점 차였고, Sieve와 KnowLine은 구분되지 않았으며 GLiDE는 그 둘에 뒤졌습니다. 가장 크게 갈린 곳은 점수가 아니라 글 속에 심은 지시였습니다. Sieve는 65%가 넘어갔고 KnowLine은 0.3%만 넘어갔는데, 그 KnowLine도 평서문으로 쓴 고객 메모에는 16건을 다 따랐습니다. 세 모델의 약점이 서로 다르고, 세 칸을 모두 통과한 모델은 없었습니다. 8비트로 줄여도 세 모델 모두 점수를 잃지 않았고, 셋 다 40GB 카드에서 돌았습니다. KnowLine이 4천 토큰에서 막힌 원인은 서버의 한 줄이었고, 인자 두 개로 2만 3천 토큰까지 늘렸습니다.
[특집] 영수증 있는 기억 — SodaMem으로 읽는 AI 에이전트의 '지금 참인 것': 출처·시간·대체, 그리고 92.8%의 뒷면
AI 비서가 '매운 음식 좋아하시죠?'라며 위염 환자에게 마라탕을 권한다면, 기억을 못 해서가 아니라 무엇이 지금 참인지 몰라서입니다. 2026년 8월 공개된 SodaMem은 대화에서 뽑은 사실마다 원문 영수증(출처 조각)을 붙이고, 네 개의 시계로 시간을 적고, 바뀐 사실은 지우지 않고 닫습니다. 그래프·BM25·임베딩 세 터널에서 함께 걸린 증거를 위로 올리고, 플래너가 모은 증거로 리더가 인용을 달아 답합니다. LongMemEval-S에서 92.8%, 문항당 0.16센트라는 숫자도 냈습니다. 바틀릿의 재구성 기억과 파치올리의 장부에서 시작해 이중 시간 데이터베이스, 진리 유지 시스템, BM25와 RRF, MemGPT·Mem0·Zep으로 이어지는 계보를 따라가며 논문의 개념을 하나씩 풀었습니다. 코어닷투데이는 공개된 답안 500개를 다른 모델로 다시 채점했고(88.6%, 직접 판정하면 약 90%), 같은 검색 결과를 작은 모델에 읽혔고, 코드를 열어 논문과 다른 세 곳을 찾았습니다. 92.8%를 낸 저장소는 대체를 '관찰만' 하는 모드였고, 공개 코드의 BM25는 한글을 한 글자도 토큰으로 만들지 못합니다. 작은 모델로 같은 시나리오를 넣어 보니 옛 주소는 닫히지 않았고, 영어 대화에서는 위염 환자에게 매운 김치찌개를 권했습니다. 인터랙티브 7개.
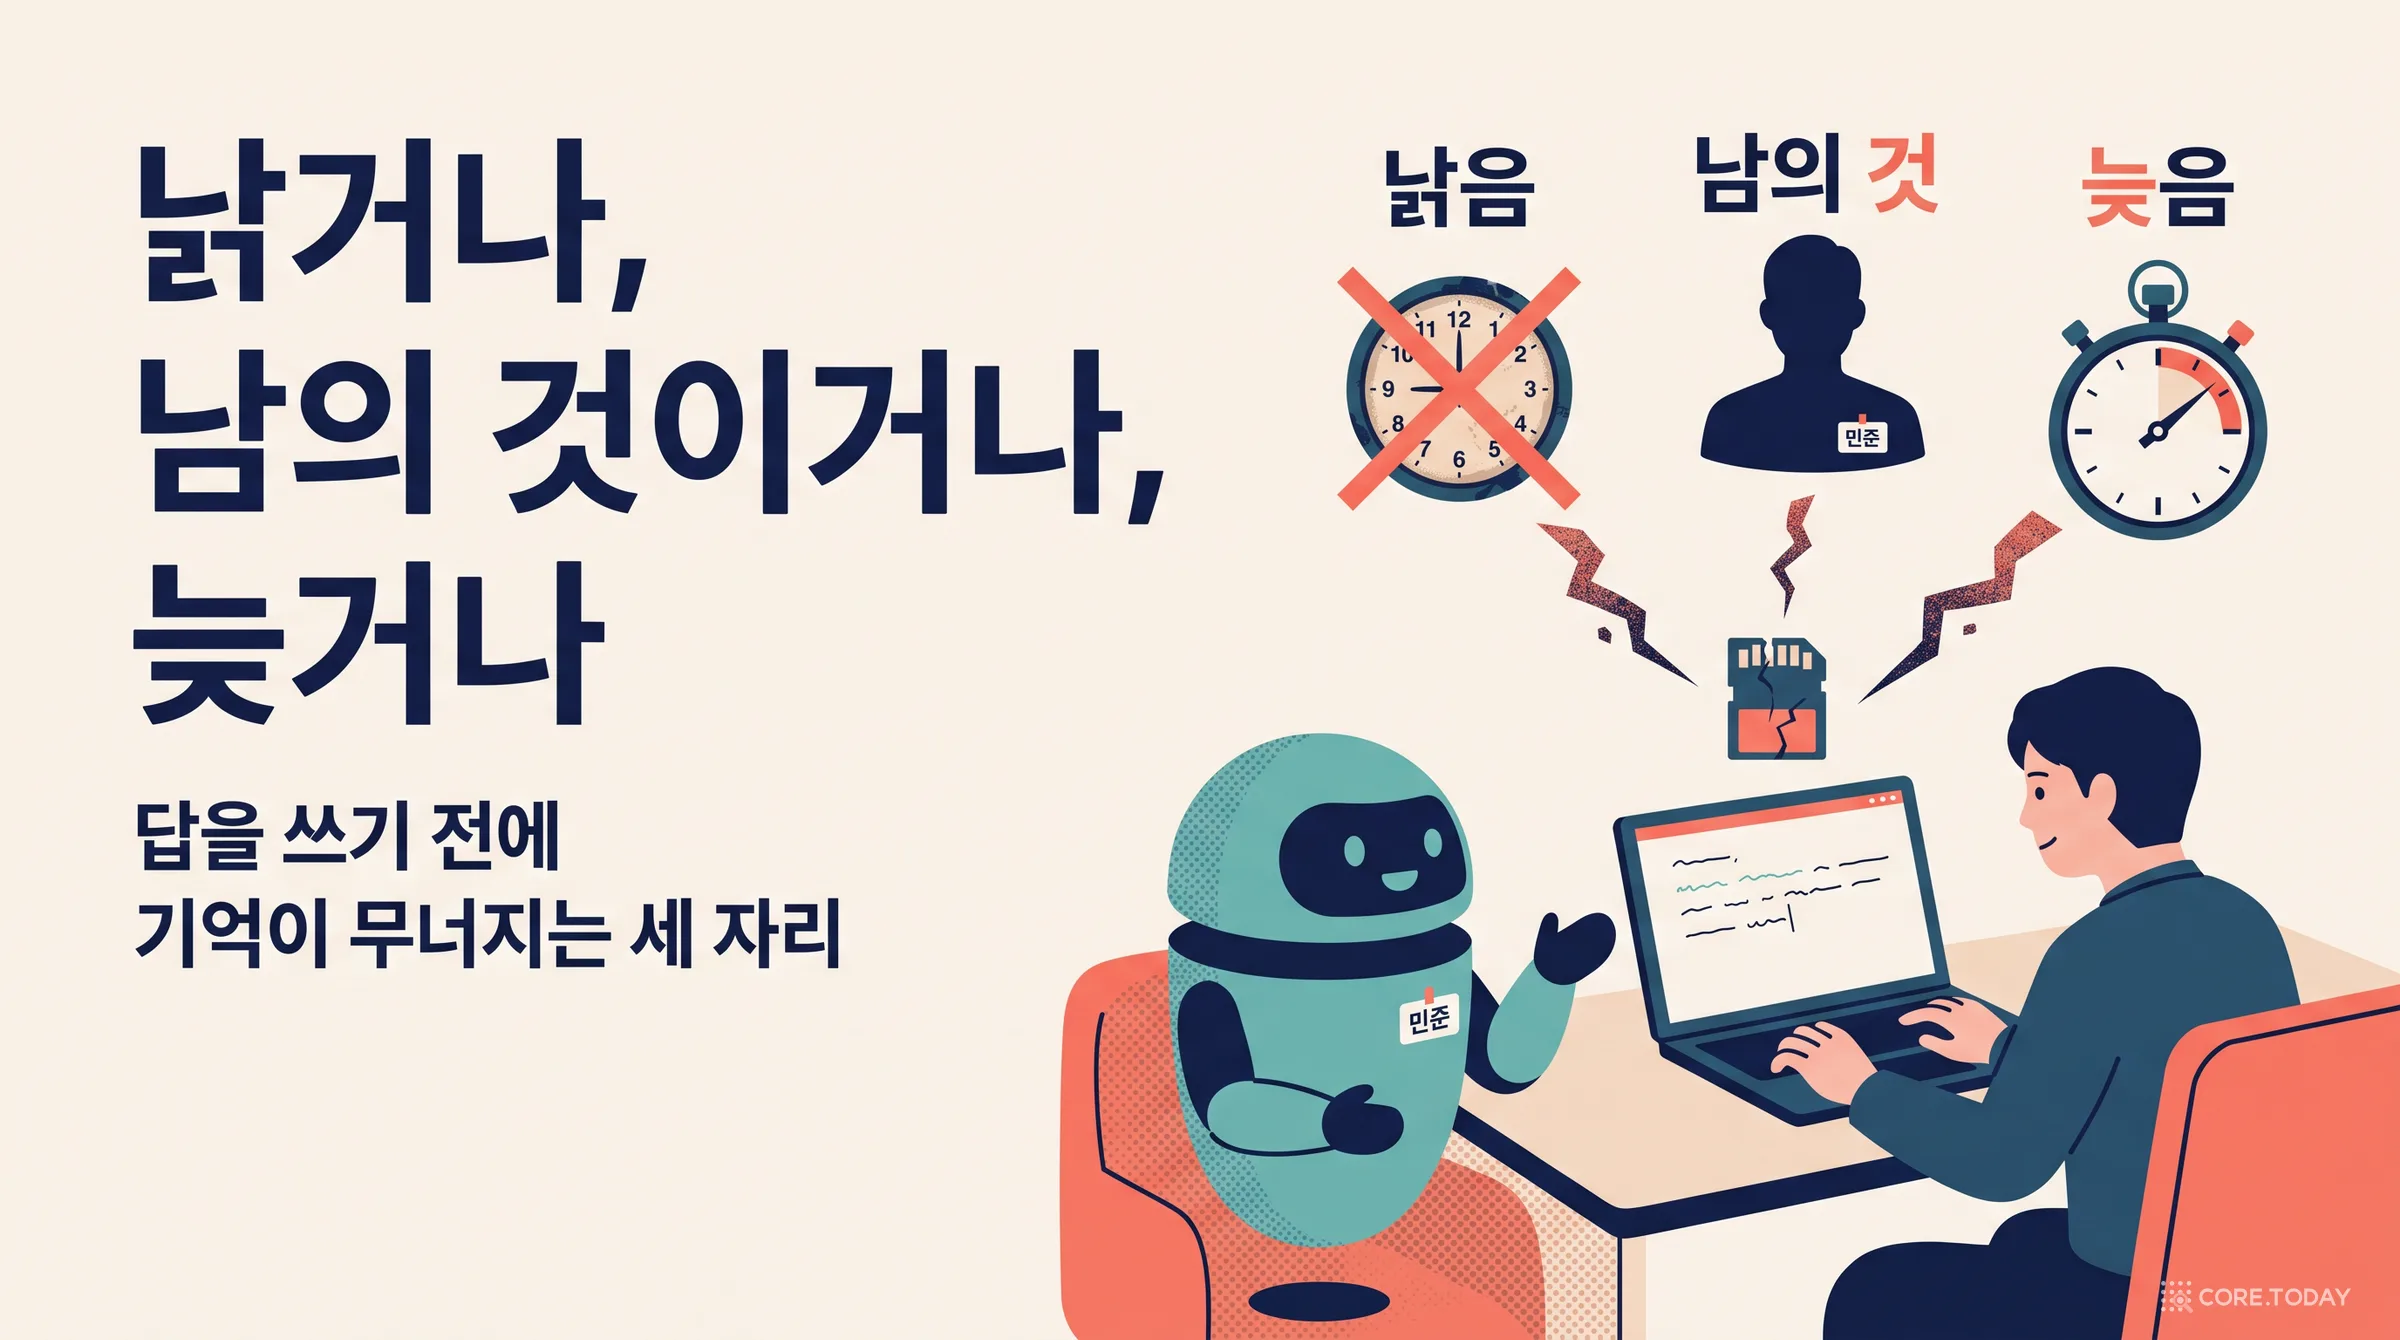
[특집] 낡거나, 남의 것이거나, 늦거나 — AI 비서의 기억은 답을 쓰기 전에 무너진다
AI 비서의 기억은 보통 최종 답이 맞았는지로 채점한다. UC 버클리 연구진의 2026년 10월 논문 「Stale, Misattributed, or Late」는 채점 지점을 한 칸 앞으로 당겨, 모델에 들어가기 직전의 '기억 블록'이 낡은 값을 담았는지, 같은 이름의 다른 사람 값을 담았는지, 답이 없는데 무언가를 채웠는지, 프리필 전에 도착했는지를 따로 센다. 결론은 단순하다. 낡음은 검색이 아니라 쓰기의 문제이고, 진짜 어려운 일은 개정을 올바른 칸에 묶는 '키 붙이기'이며, 동명이인·기권·지연은 각각 다른 정보가 필요하다. 1959년 레코드 연결과 1985년 '유효 시간 대 기록 시간'에서 시작해 BM25·RCU·John Smith 문제를 거쳐 2026년 기억 제품까지 계보를 따라가고, 표와 그림을 하나씩 읽는다. 같은 실험을 한국어로 다시 만들어 로컬 Qwen 모델로 돌려 봤더니 저장소 구조에서 나오는 결과는 대부분 재현됐고, 'LLM 키 할당기가 규칙보다 나쁘다'는 모델 의존적인 결과는 재현되지 않았다.
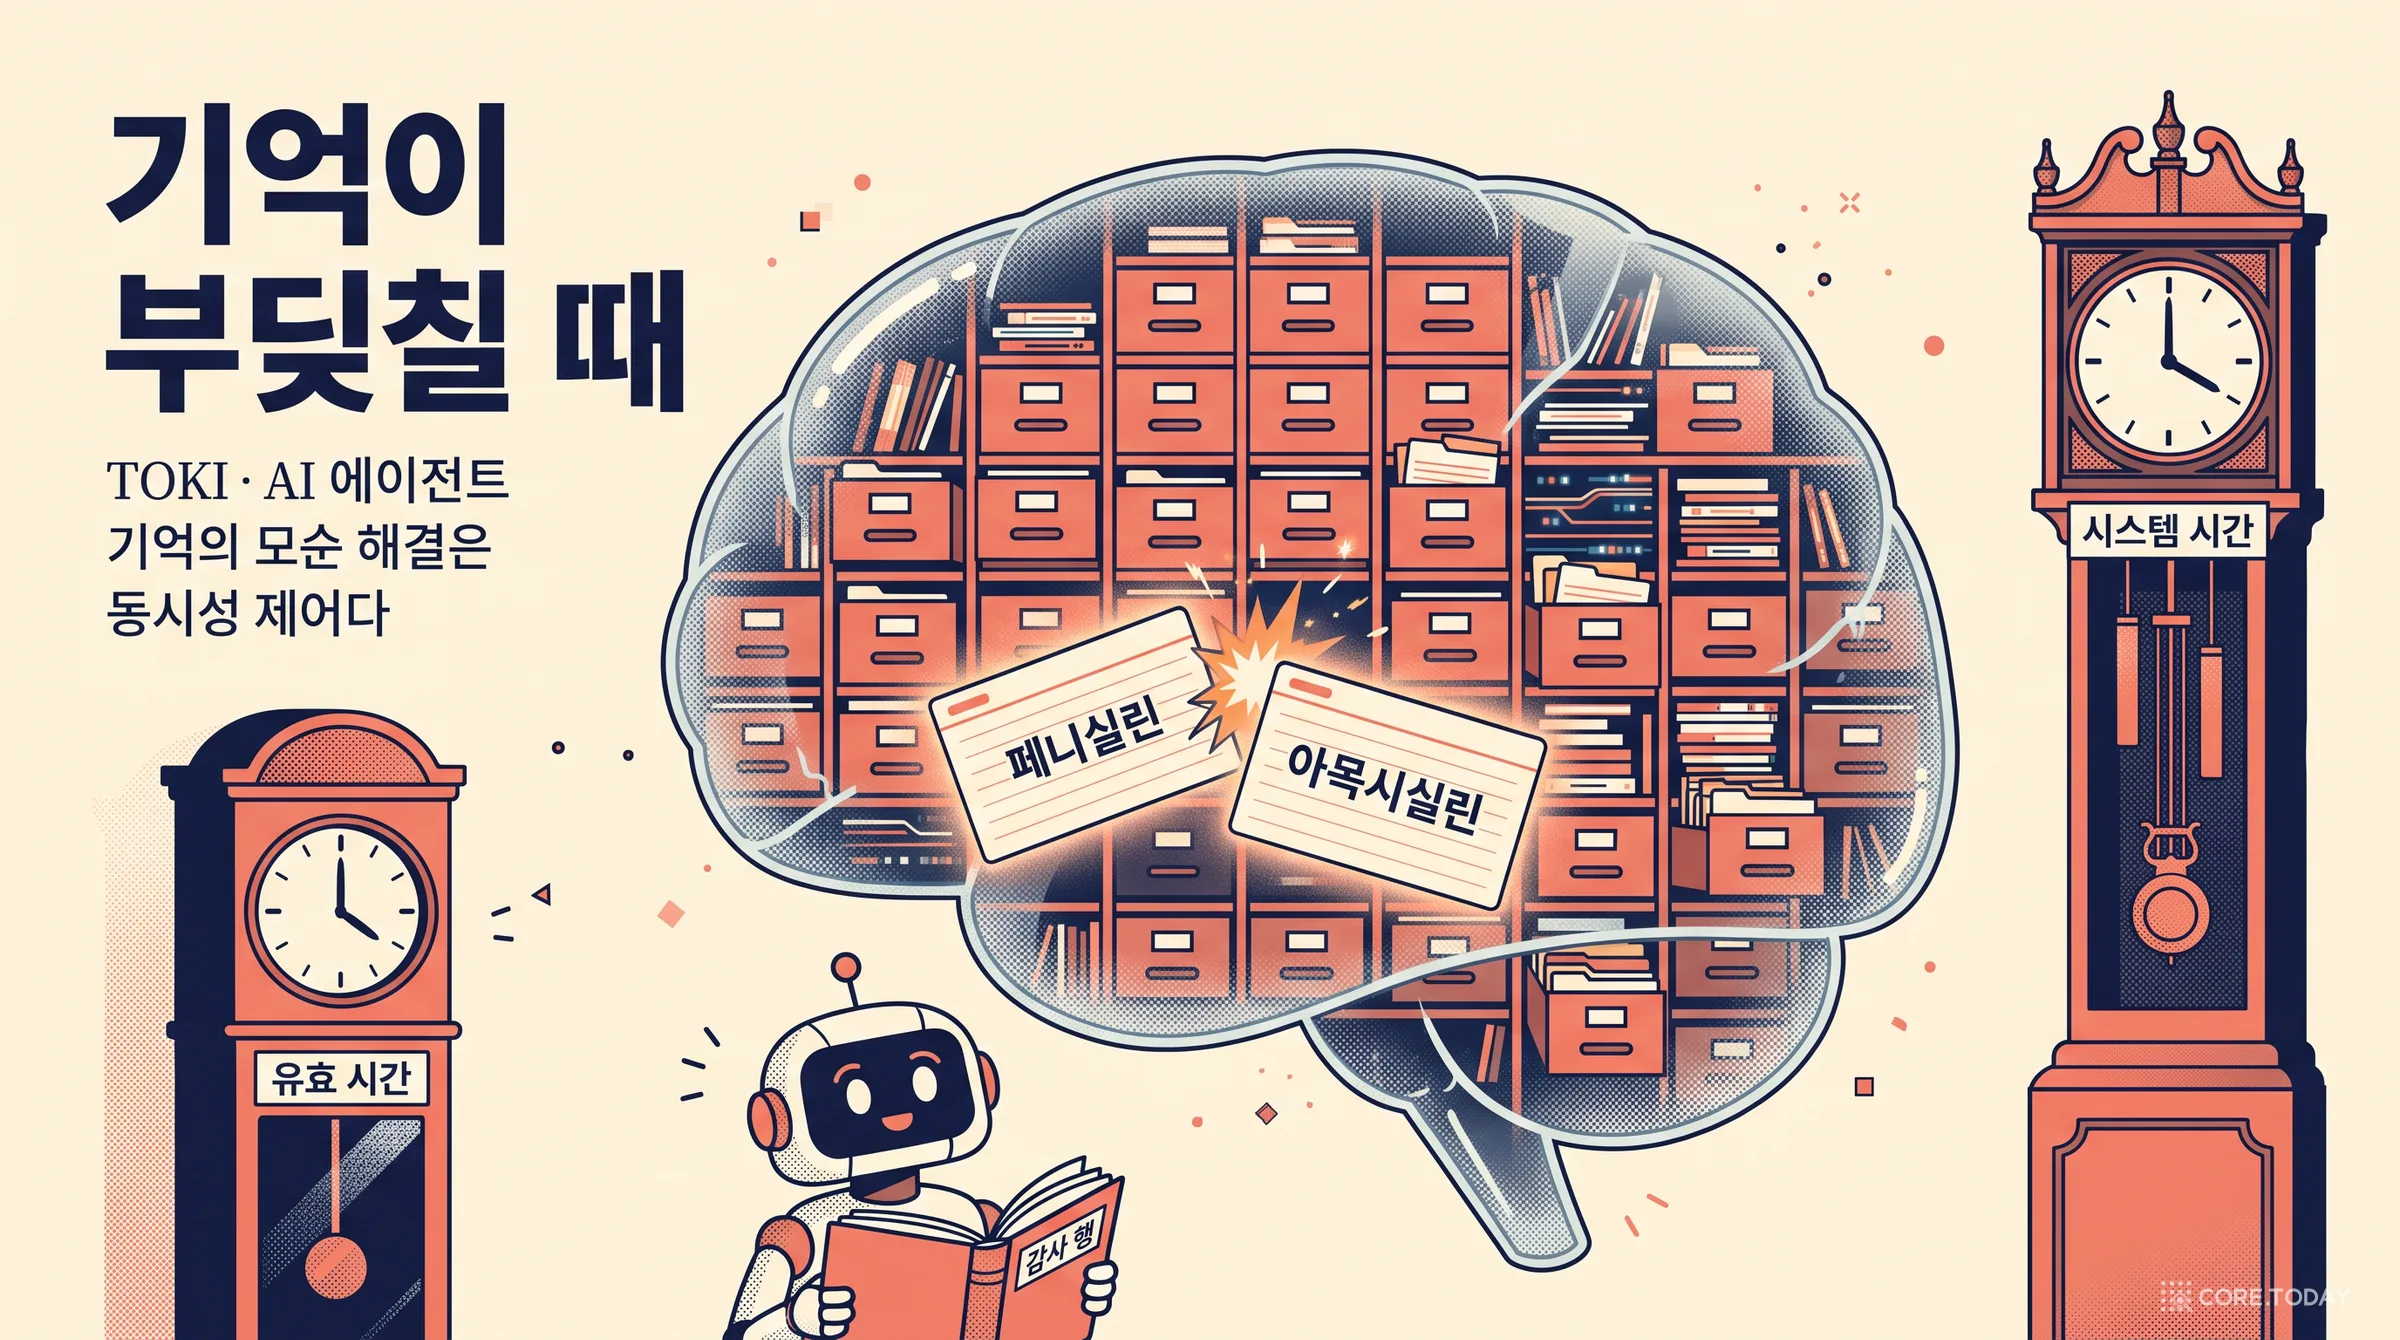
기억이 부딪칠 때 — AI 에이전트 기억의 모순 해결은 왜 '동시성 제어'인가, TOKI 논문 완전 해설
에이전트의 기억에 '담당자는 박 과장'과 '담당자는 이 대리'가 함께 들어오면 누가 이기나. 홍콩과기대의 TOKI 논문(arXiv 2606.06240)은 이 질문이 사실 50년 된 데이터베이스 문제, 즉 동시성 제어라고 말한다. 최신 우선·증거 가중·확인 대기·규칙 정책이라는 네 가지 생산 전략을 격리 수준이 붙은 연산자로 다시 쓰고, 진 사실을 지우지 않는 '감사 행'과 LLM 판정을 키로 기록하는 '판정 로그'로 세 가지 새 이상(판정 재현 불일치·믿음 표류 스큐·감사 소거)을 막는다. 이중 시간 데이터베이스, 베렌슨의 격리 수준 비판, 출처 반가환이라는 세 뿌리부터 정리 다섯 개의 쉬운 풀이, 여덟 시스템 판정표의 칸별 무게까지 읽었다. PostgreSQL 17에서 두 에이전트의 동시 쓰기를 격리 수준별로 50번씩 돌리고, 로컬 4B 모델을 판정자로 같은 모순을 반복해 물어 판정이 얼마나 뒤집히는지 직접 쟀다 — 온도 0에서도 두 기록의 제시 순서만 바꾸면 36쌍 중 13쌍에서 승자가 바뀌었다. 논문이 밝힌 코드 저장소가 404라는 점, 판정표 일부 칸이 지금 코드와 맞지 않는다는 점도 짚었다. 인터랙티브 위젯 6개.
[특집] 옛 주소로 기차표를 끊는 AI — '기억 갱신 격차'를 재고, 훈련으로 줄인 Supersede 완전 해부
"저 부산으로 이사했어요"라고 말해 두었는데, 몇 주 뒤 AI 비서가 대구행 기차표를 끊는다. 2026년 6월 arXiv 논문 「Supersede」는 이 실패를 '기억 갱신 격차'라고 부르고, 네 가지 질문으로 파고든다. 실패는 정말 있나? 더 큰 모델이면 풀리나? 더 큰 메모장이면 풀리나? 훈련하면 줄어드나? 답은 있다, 아니다, 아니다, 그렇다. 300자 메모장만 쥔 gpt-5.4는 전체 대화를 다 본 자신보다 15점 낮았고, 대화가 24배 길어지자 정답률은 68%에서 28%로 무너졌으며, 메모장을 24배로 늘려 줘도 28%였다. 마지막으로 3B 모델을 GRPO로 훈련해 9.0%를 16.7%로 끌어올렸다. 1957년의 순행 간섭 실험부터 데이터베이스의 UPDATE, 2026년의 'ChatGPT Dreaming'까지 이 문제가 어디서 왔는지 따라가고, 논문의 그림과 표를 하나씩 읽는다. 같은 데이터와 같은 프롬프트로 공개 모델(Qwen 3.5 9B)에서 실험을 직접 재현해 25.6점의 격차를 확인했고, 메모를 요약 대신 '주제: 값' 장부로 쓰게 하는 지시문 하나로 그 격차가 11.5점까지 줄어드는 것도 보았다. 하지만 그 장부도 대화가 48세션으로 길어지자 88%에서 8%로 무너졌다. 그리고 논문의 문자열 채점기가 옛 값 '7:00 pm'을 정답으로 처리한다는 것도 찾아냈다.