생각은 어디에 흐르는가 — Recurrent Looped Transformer와 보이지 않는 추론의 시대
2026년 9월 12일, 프린스턴의 Yifan Zhang이 16쪽짜리 기술 보고서를 공개했다. 이전 토큰의 내부 상태를 다음 토큰으로 계속 넘겨서, 문장이 길어질수록 계산 경로도 계속 깊어지는 트랜스포머다. 열흘 전에는 OpenAI의 GPT-6 Astra가 비슷한 '순환' 기법을 쓴다는 보도로 AI 안전 연구자들이 들끓었다. 이 특집은 RNN에서 트랜스포머, 생각의 사슬, 루프 모델로 이어진 35년의 흐름 속에서 RLT가 왜 나왔는지 풀고, 논문의 세 가지 설계 원칙을 하나씩 분해하고, 독립 실험이 보여 준 한계를 확인한 뒤, 모델의 생각이 글에서 벡터로 옮겨 갈 때 사람의 감시가 어떻게 되는지를 따진다. 인터랙티브 실험 4종과 논문 원본 그림을 함께 싣는다.
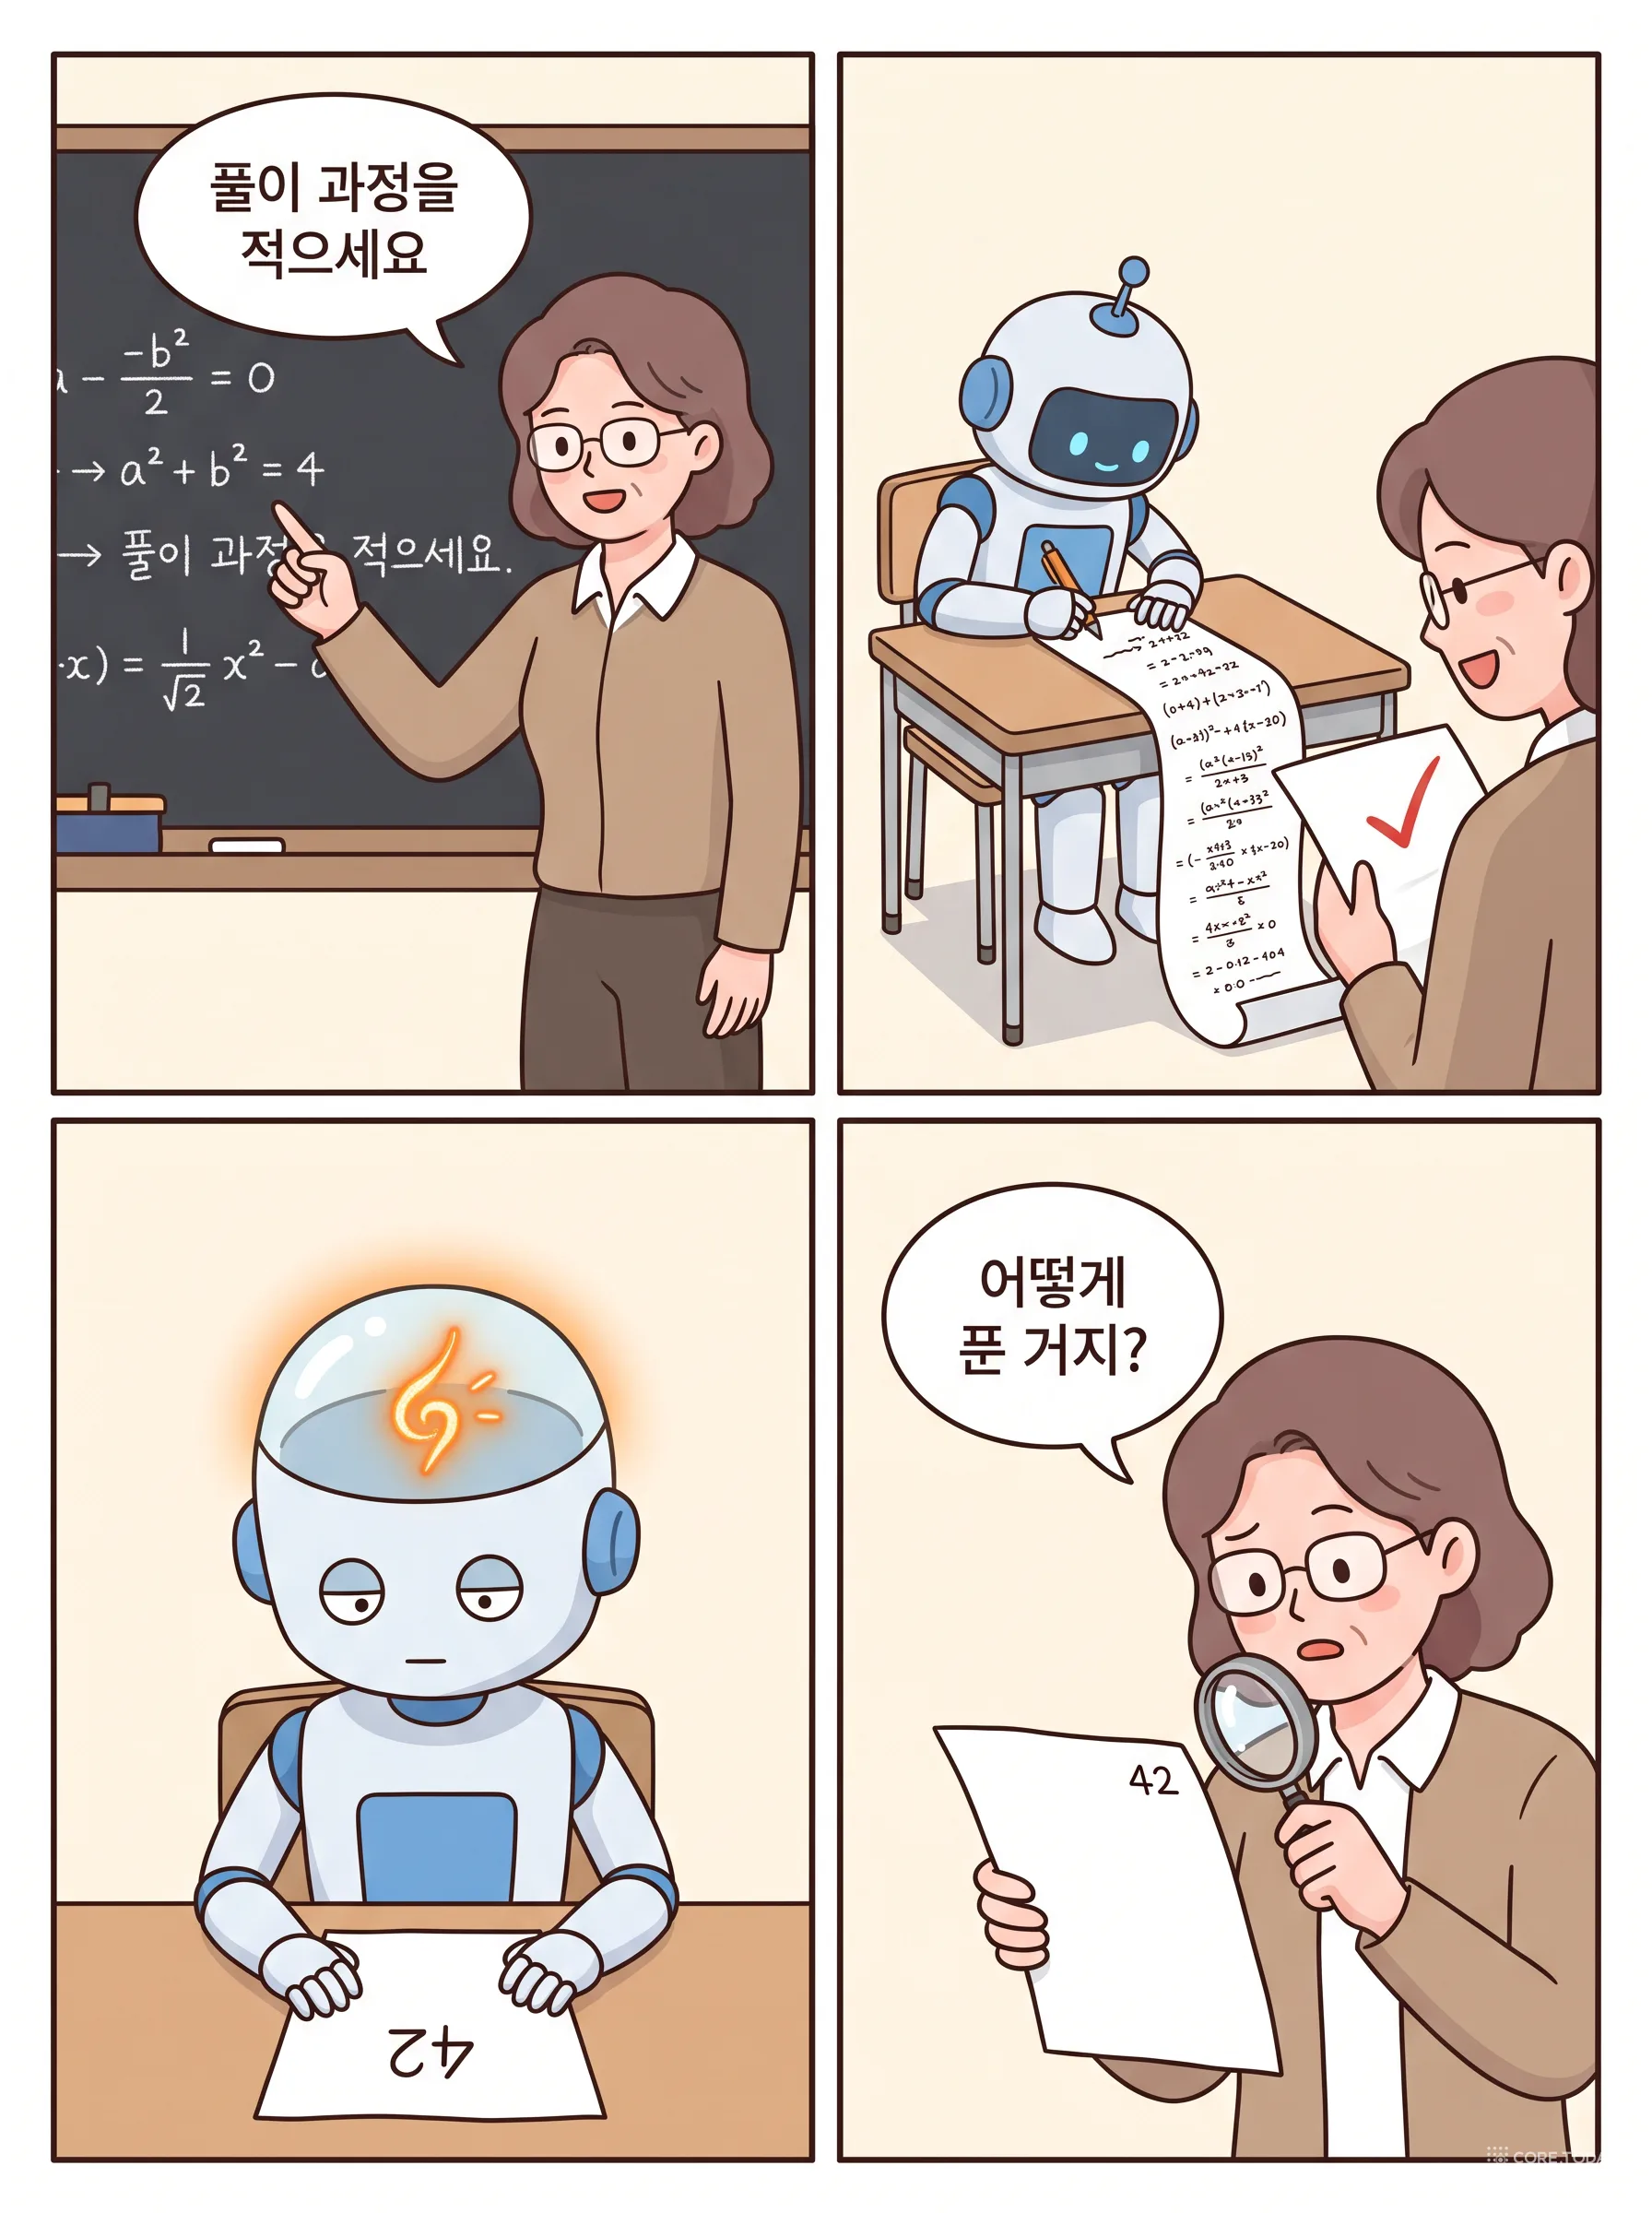
수학 시험지를 채점하는 선생님을 떠올려 보자. 선생님이 "풀이 과정을 적으세요"라고 하는 데는 두 가지 이유가 있다. 하나는 학생이 적어 가며 풀어야 틀리지 않기 때문이다. 긴 계산을 머릿속에만 들고 있으면 중간에 숫자를 놓친다. 다른 하나는 선생님이 학생의 생각을 확인할 수 있기 때문이다. 답이 맞았더라도 풀이가 이상하면 우연히 맞힌 건지, 커닝을 한 건지, 제대로 이해한 건지 구분할 수 있다.
그런데 어느 날 암산이 기막히게 뛰어난 학생이 나타나 답만 적어 낸다고 해 보자. 답은 맞는다. 풀이 과정을 적는 학생보다 빠르고, 종이도 덜 쓴다. 선생님은 기뻐해야 할까, 불안해해야 할까?
2024년 이후 AI 업계는 정확히 첫 번째 학생을 키워 왔다. OpenAI의 o1, DeepSeek-R1, 그리고 그 뒤를 이은 모든 "추론 모델"은 답하기 전에 생각의 사슬(Chain-of-Thought, CoT)을 수천에서 수만 토큰씩 적는다. 적으면서 풀기 때문에 어려운 문제를 풀고, 적은 것이 남기 때문에 안전 연구자들이 그 글을 읽어 모델이 딴생각을 하는지 감시할 수 있었다.
2026년 9월, 이 균형을 흔드는 두 사건이 열흘 간격으로 일어났다.
9월 1일, 미국 매체 The Information이 OpenAI의 새 모델 GPT-6 Astra가 "순환 깊이(recurrent depth)"라는 기법을 쓴다고 보도했다. 같은 층을 여러 번 돌려 모델이 더 많은 생각을 '머릿속에서' 하게 만드는 방식이다. AI 안전 연구자들 사이에 경보가 울렸다.
9월 12일, 프린스턴 대학의 박사과정 연구자 Yifan Zhang이 「Recurrent Looped Transformer」(RLT)라는 16쪽짜리 기술 보고서를 공개했다. 이전 토큰의 내부 상태를 다음 토큰으로 계속 넘기면서, 문장이 길어질수록 내부 계산 경로도 계속 깊어지는 구조다.
두 사건은 서로 다른 기술이다. Astra에 대해 보도된 것은 "한 토큰 안에서 여러 번 도는" 방식이고, RLT는 "토큰에서 토큰으로 상태를 넘기는" 방식이다. 하지만 둘은 같은 방향을 가리킨다. 모델의 생각이 사람이 읽을 수 있는 글에서, 사람이 읽을 수 없는 벡터로 옮겨 가고 있다.
이 특집은 RLT 논문을 끝까지 읽는다. 그리고 세 가지 질문에 답하려 한다.
왜 이런 구조가 나왔나. 1990년의 순환 신경망에서 2017년 트랜스포머, 2022년 생각의 사슬, 2025년 루프 모델까지, 사람들은 "모델이 더 오래 생각하게 하는 법"을 두고 35년 동안 같은 줄다리기를 해 왔다.
RLT는 정확히 무엇을 하나. 논문이 내건 세 가지 설계 원칙 — 무한한 시간 깊이, 하드웨어와의 공동 설계, 강화학습 알고리즘과의 공동 설계 — 를 수식 없이도 이해할 수 있게 풀어 본다.
2026년에 이것은 무슨 의미인가. 이 논문은 실험 결과를 하나도 싣지 않았다. 대신 누군가 올린 작은 독립 실험이 있고, 그 결과는 생각보다 냉정하다. 그리고 이 구조가 정말 잘 작동한다면, 우리가 AI의 생각을 들여다보던 창문은 어떻게 되는가.
?
문제
트랜스포머는 층 수가 고정되어 있어서, 한 번에 할 수 있는 "연속된 생각"의 길이에 천장이 있다. 지금은 생각을 글(토큰)로 적어서 이 천장을 넘는다. 하지만 글은 느리고 비싸고, 토큰 하나에 실을 수 있는 정보는 아주 적다.
↻
RLT의 제안
디코더의 최종 은닉 상태와 최근 계산 메모를 모든 토큰에서 다음 토큰으로 넘긴다. 프롬프트든 응답이든 끊지 않는다. 그러면 토큰당 계산량은 고정인 채로, 상태가 지나온 경로는 토큰 수만큼 깊어진다. 학습·추론·강화학습 재생이 전부 같은 계산을 쓰도록 설계를 못 박는다.
!
아직 모르는 것
논문은 성능·효율·확장성 수치를 하나도 보고하지 않는다. 독립 연구자의 7만 9천 파라미터짜리 실험에서는 학습 길이의 4배에서 정확도가 우연 수준으로 떨어졌고, 1990년대식 GRU가 더 잘 일반화했다. 구조가 길을 열어 준다는 것과 모델이 그 길을 쓰는 법을 배운다는 것은 다른 이야기다.
1. 35년의 줄다리기 — "순서대로"와 "한꺼번에" 사이
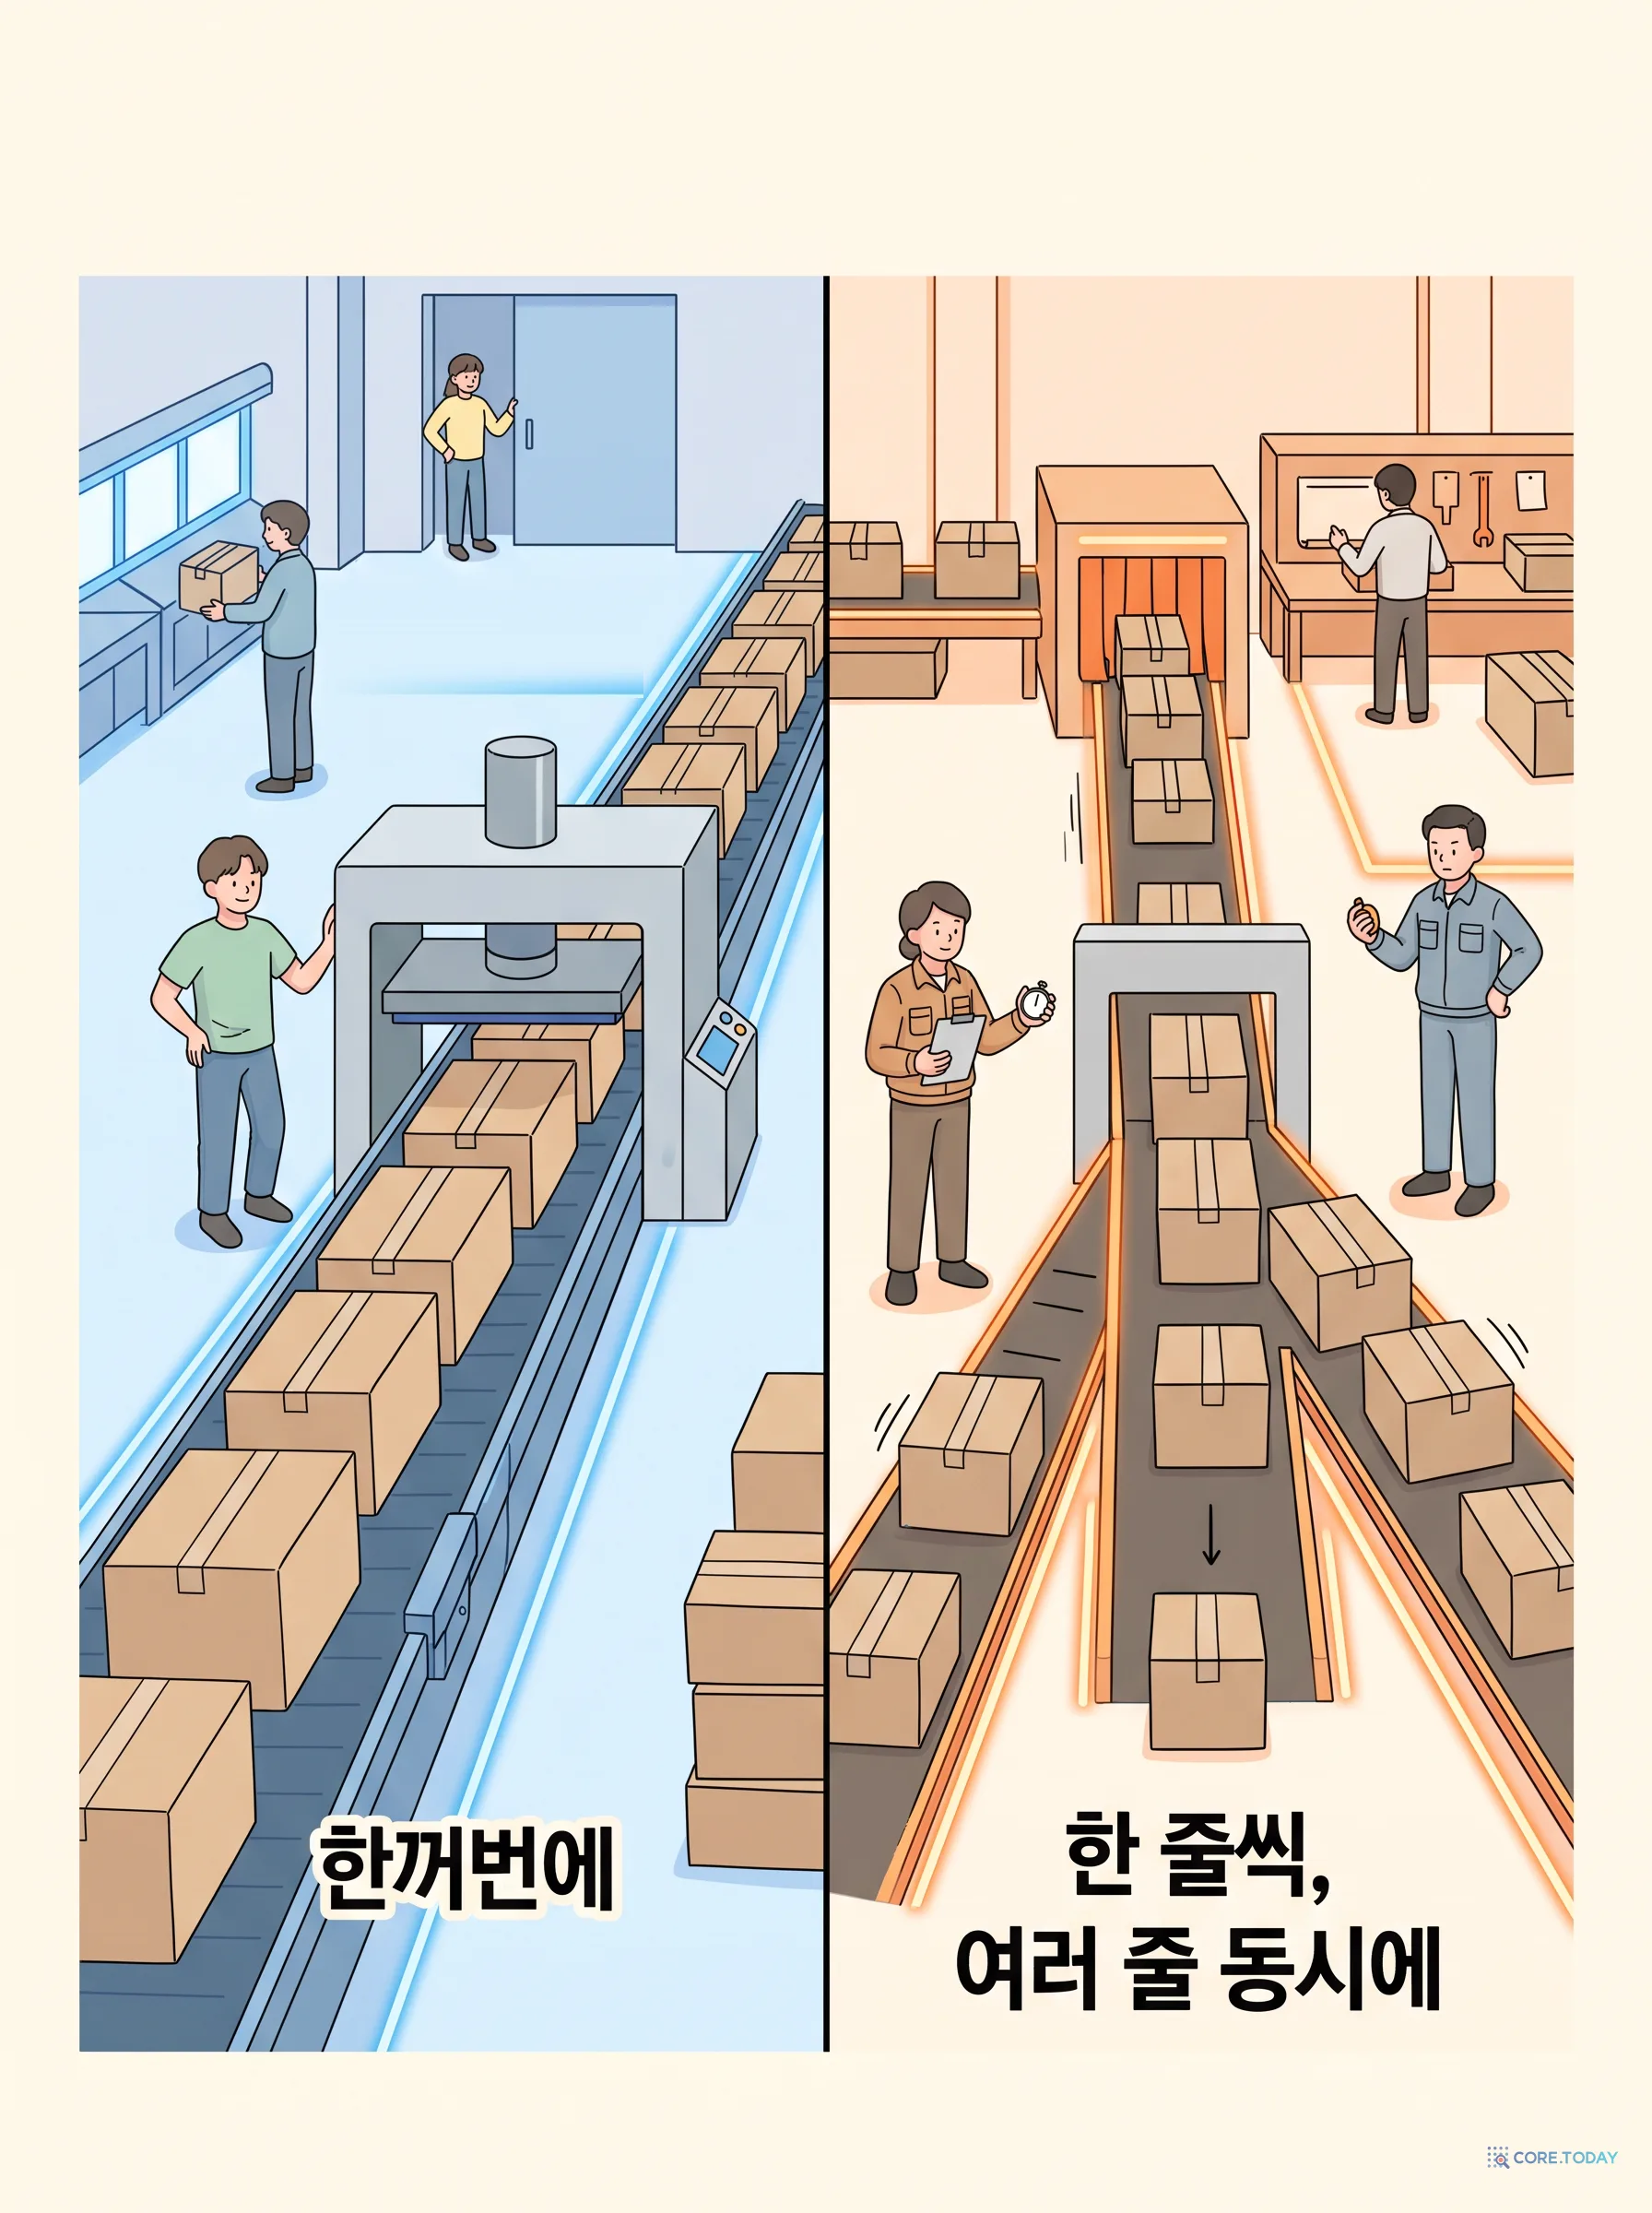
RLT를 이해하려면 먼저 이 논문이 어떤 오래된 긴장 위에 서 있는지 봐야 한다. 딥러닝으로 언어를 다루는 역사는 두 가치 사이를 오간 역사다. 순서대로 계산하면 상태를 들고 갈 수 있다. 한꺼번에 계산하면 빠르다. 둘 다 가지기는 어렵다.
1-1. 1990년, 기억을 한 줄로 넘기던 모델
1990년 인지과학자 제프리 엘먼(Jeffrey Elman)은 「Finding Structure in Time」이라는 논문에서 단순한 아이디어를 제안했다. 신경망이 단어를 하나 읽을 때마다 내부 상태(은닉 상태)를 만들고, 그 상태를 다음 단어를 읽을 때 입력으로 함께 넣는다. 이것이 순환 신경망(RNN)이다. 모델은 지금까지 읽은 모든 것을 벡터 하나에 눌러 담아 들고 다닌다.
이 구조는 직관적으로 완벽해 보인다. 사람도 책을 읽을 때 앞 문장의 내용을 머릿속에 들고 다음 문장으로 넘어가니까. 문제는 학습에서 터졌다. RNN을 학습시키려면 오차 신호를 시간을 거슬러 거꾸로 전달해야 한다(시간 역전파, BPTT). 그런데 단계마다 같은 행렬을 곱하다 보니 신호가 지수적으로 줄어들거나 폭발했다. 1991년 제프 호크라이터(Sepp Hochreiter)의 학위논문과 1994년 요슈아 벤지오(Yoshua Bengio) 등의 논문이 이 "기울기 소실" 문제를 정식화했다.
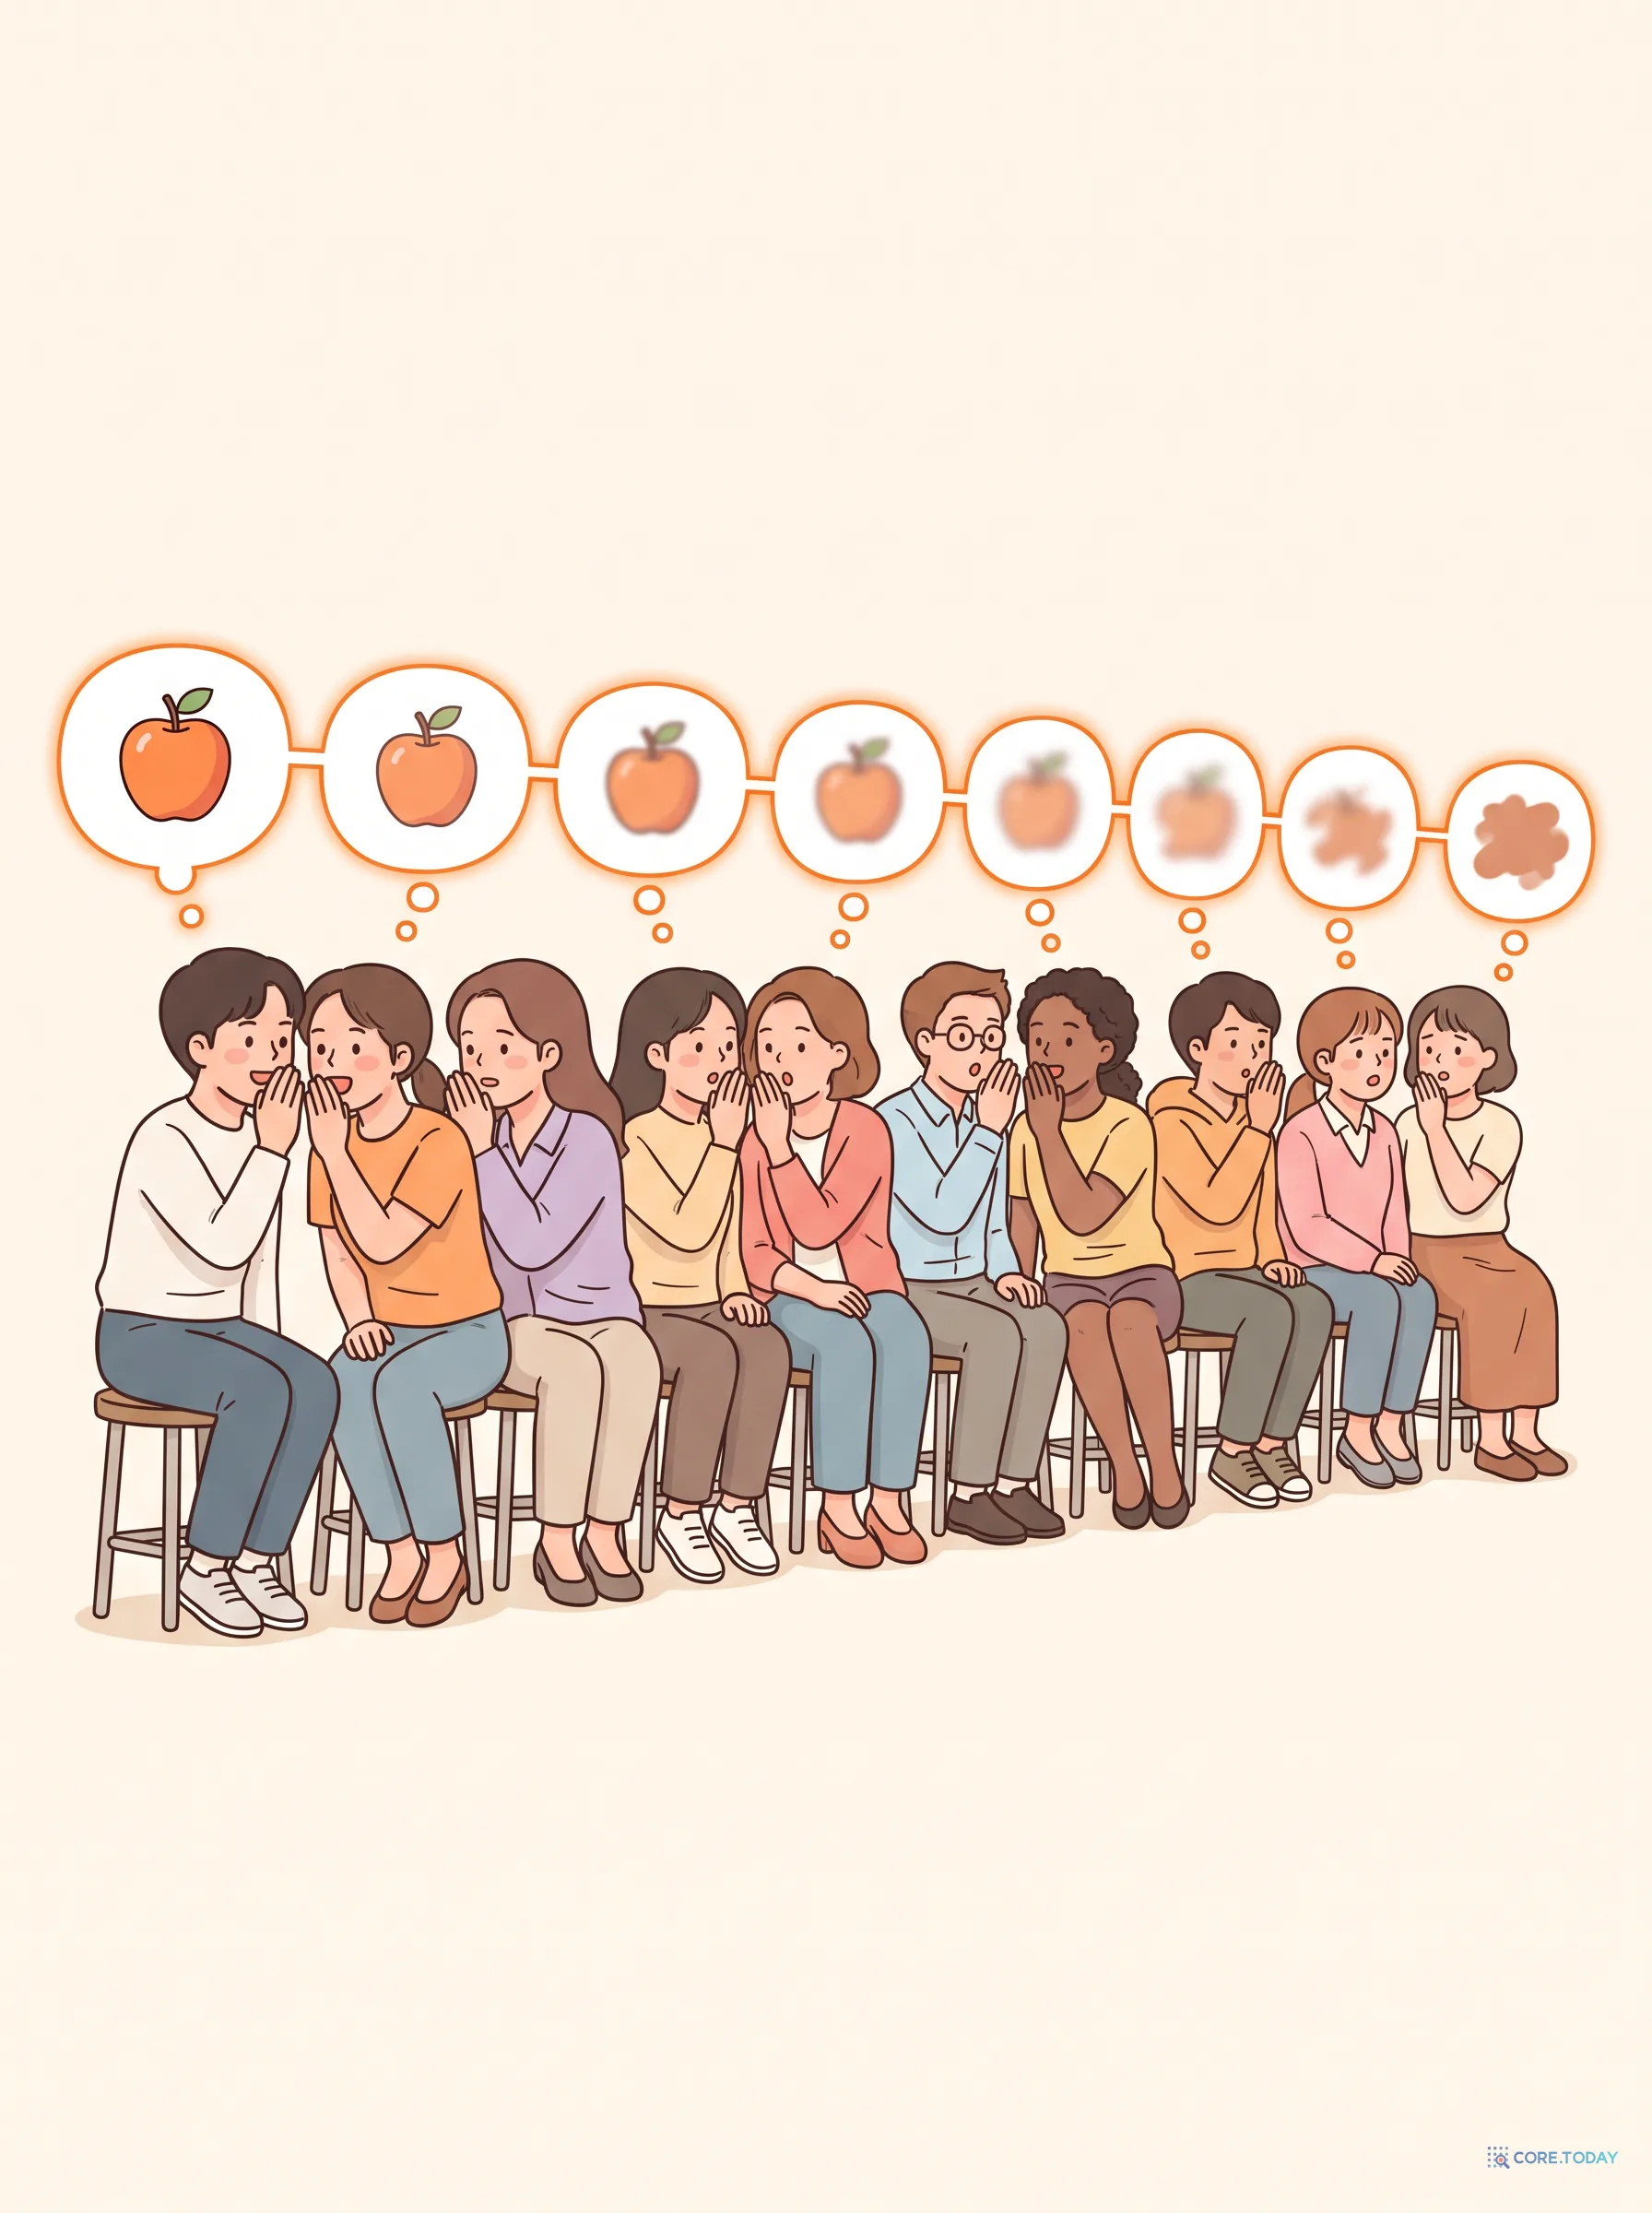
귓속말 전달 게임을 떠올리면 된다. 줄 선 사람이 열 명이면 메시지가 끝까지 대충은 간다. 백 명이면 첫 사람이 뭐라고 했는지 아무도 모른다. 학습도 마찬가지다. 100단어 뒤의 오답이 100단어 앞의 어떤 계산 때문이었는지, 신호가 거기까지 거슬러 가지 못한다.
1997년 호크라이터와 위르겐 슈미트후버(Jürgen Schmidhuber)는 LSTM으로 이 문제를 크게 줄였다. 정보를 그대로 흘려보내는 "컨베이어 벨트"를 만들고, 무엇을 넣고 뺄지 정하는 게이트를 달았다. 논문 초록은 1000단계가 넘는 시간 간격을 이어 줄 수 있다고 적었다. 이후 20년 가까이 기계 번역, 음성 인식, 필기 인식이 모두 LSTM 위에서 돌아갔다.
그래도 RNN 계열에는 떼어낼 수 없는 약점이 하나 남았다. 순서대로만 계산할 수 있다. 100번째 단어의 상태를 구하려면 99번째 상태가 먼저 있어야 한다. GPU가 수천 개의 코어로 동시에 계산하는 기계로 진화하는 동안, RNN은 그 코어들을 한 줄로 세워 놓고 한 명씩 일을 시키고 있었다.
🔖
RLT와의 연결점. RLT의 병합 게이트 수식 ut=et+αgt⊙Wsrt−1은 LSTM·GRU의 게이트와 같은 계보다. "이전 상태를 얼마나 섞을지를 학습으로 정한다"는 발상이다. 그리고 뒤에서 볼 독립 실험에서 RLT를 이긴 것이 바로 1990년대 계보의 GRU다.
1-2. 2017년, 순서를 버리고 병렬을 얻다
2017년 구글의 여덟 명이 쓴 「Attention Is All You Need」는 과감한 선택을 했다. 순환을 아예 버렸다. 대신 모든 단어가 다른 모든 단어를 동시에 바라보는 어텐션만으로 모델을 쌓았다. 논문의 표 1이 이 선택의 핵심을 요약한다. 순환층은 문장 길이 n에 비례하는 순차 연산이 필요하지만, 셀프 어텐션은 상수 번이면 된다.
결과는 압도적이었다. 큰 모델은 GPU 8장으로 3.5일 만에 학습을 끝냈고, 영어-독일어 번역에서 BLEU 28.4로 당시 최고 기록을 넘었다. 그리고 이 병렬성 덕분에 모델을 수천억 파라미터로 키울 수 있었다. GPT, BERT, 그리고 오늘날의 모든 대형 언어 모델이 이 구조의 후손이다.
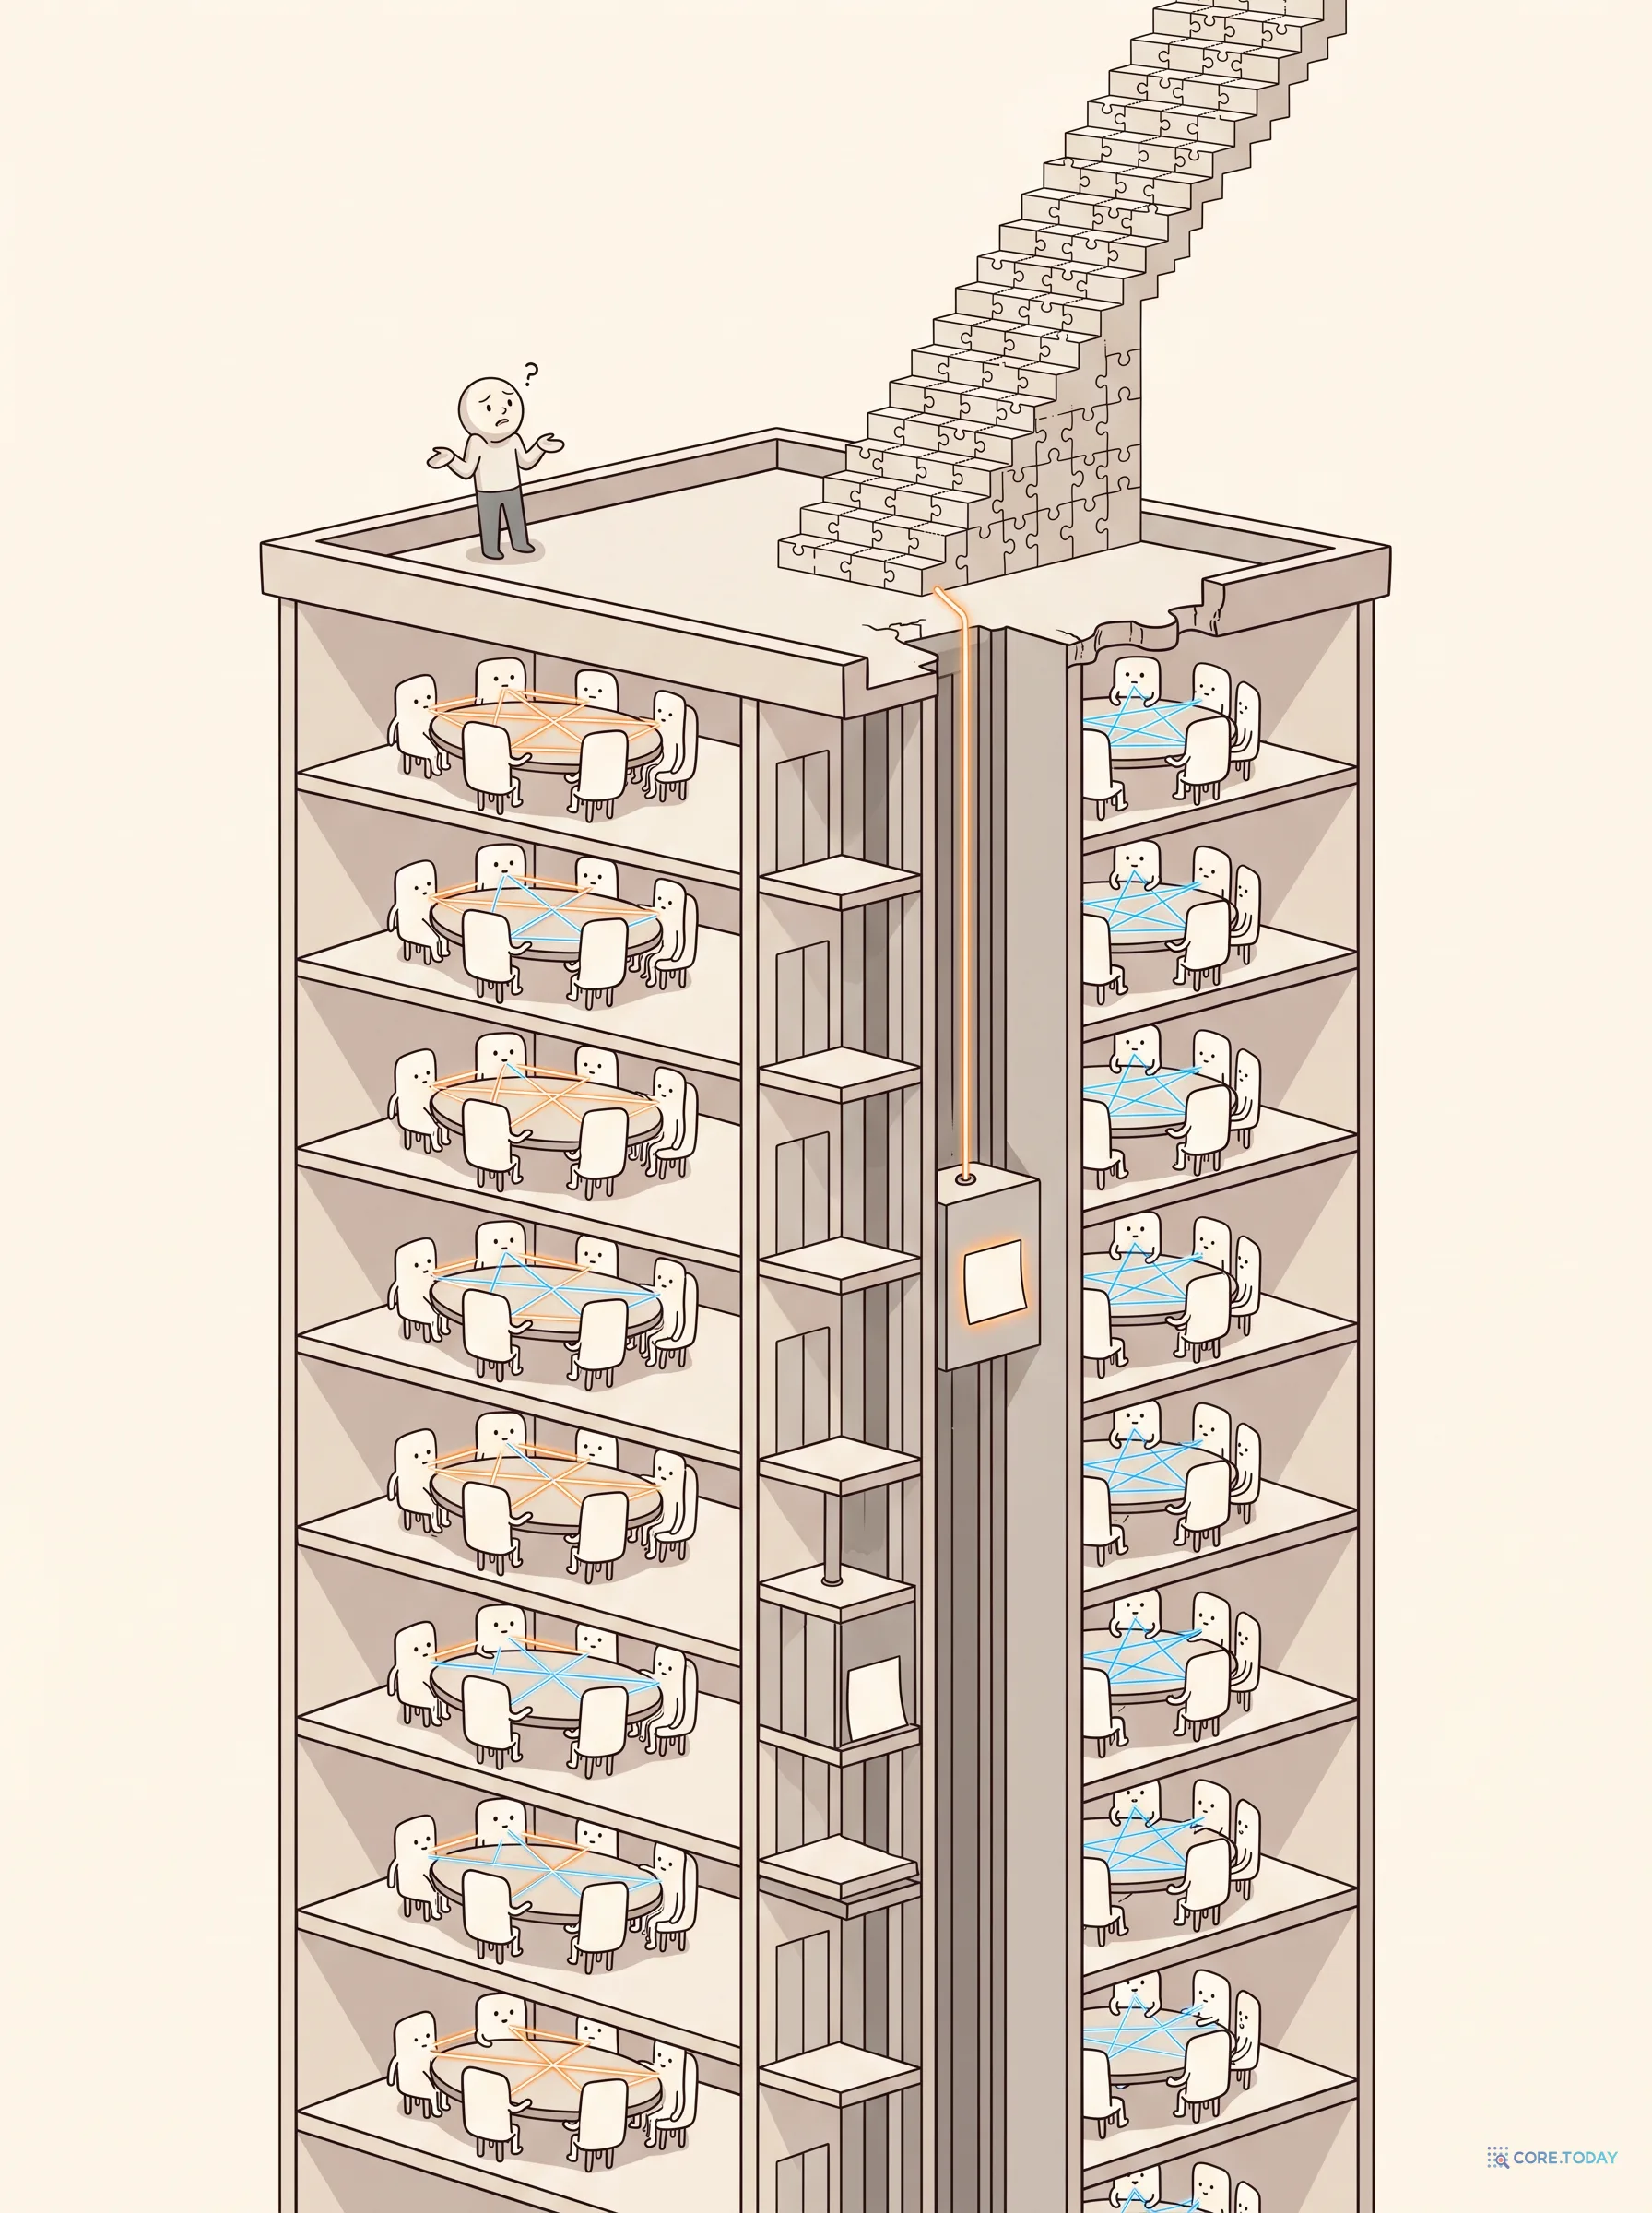
하지만 공짜는 없었다. 트랜스포머를 층마다 회의를 여는 건물에 비유해 보자. 1층에서는 모든 단어가 원탁에 앉아 서로를 한꺼번에 본다. 결론을 2층으로 올려 보내면 2층에서 다시 회의를 한다. 이렇게 48층, 96층까지 올라가면 답이 나온다. 회의 자체는 병렬이라 빠르다. 그런데 건물의 높이는 짓는 순간 정해진다. 문제가 아무리 어려워도, 한 토큰을 예측하기 위해 거칠 수 있는 연속된 변환은 층 수만큼이다.
2020년 페이스북 AI의 「Feedback Transformer」 논문은 이 한계를 이렇게 적었다. "입력에 가할 수 있는 변환의 수는 모델 깊이에 묶여 있다." 6년 뒤 RLT가 겨냥하는 과녁이 거의 이 문장 그대로다.
1-3. 고정 깊이의 벽 — 야바위를 못 따라가는 천재
"층 수가 고정"이라는 게 실제로 얼마나 문제일까? 대부분의 질문은 수십 층이면 충분하지 않나?
이 질문에 이론으로 답한 사람이 앨런 AI 연구소의 윌리엄 메릴(William Merrill)과 아시시 사브하르왈(Ashish Sabharwal)이다. 2022~2023년 두 사람은 현실적인 정밀도를 가진 트랜스포머가 TC⁰라는 복잡도 클래스에 갇힌다는 것을 보였다. 풀어 말하면, 트랜스포머가 한 번에(생각의 사슬 없이) 풀 수 있는 문제는 "깊이가 고정된 병렬 회로"로 풀 수 있는 문제뿐이라는 뜻이다. 두 사람은 이것을 병렬성의 대가(parallelism tradeoff)라고 불렀다. 트랜스포머만큼 병렬화할 수 있는 구조라면 어떤 구조든 비슷한 한계를 갖는다는 것이다.
그럼 TC⁰로 못 푸는 문제는 뭘까? 대표 선수가 상태 추적(state tracking)이다. 2024년 메릴 등은 「The Illusion of State in State-Space Models」에서, 트랜스포머뿐 아니라 Mamba 같은 상태 공간 모델도 이 벽에 막힌다고 보이면서 예를 들었다. 특정 표기법으로 적힌 체스 기보를 따라가는 일, 코드를 실행해 보는 일, 긴 이야기 속 인물의 위치를 추적하는 일이다.
가장 쉬운 비유는 야바위다. 컵 다섯 개 중 하나에 공이 있고, 누군가 컵을 둘씩 바꾸기 시작한다. 공이 어디 있는지 알려면 바꿀 때마다 "지금 위치"를 갱신해야 한다. 섞기가 열 번이면 열 번의 갱신이 순서대로 쌓여야 한다. 이 문제의 수학적 핵심(5개 원소 순열의 합성, S₅)은 이론적으로 입력이 길어질수록 필요한 깊이가 늘어나는 문제로 알려져 있다. 메릴 등의 실험에서 단층 RNN은 임의로 긴 수열에서 이 문제를 배웠지만, 트랜스포머·S4·Mamba는 수열이 길어질수록 층을 계속 더 쌓아야 90% 정확도를 넘었다.
코드 에이전트가 변수를 추적할 때.balance = 100에서 시작해 200줄에 걸쳐 조건문과 반복문 속에서 값이 바뀐다. 마지막 줄의 balance가 얼마인지 알려면 실행 경로를 순서대로 따라가야 한다.
긴 로그에서 서버 상태를 재구성할 때. "연결됨 → 재시도 → 끊김 → 재연결 → 인증 만료"가 수천 줄에 흩어져 있다.
스프레드시트나 장부를 읽을 때. 입금과 출금이 섞인 거래 300건 뒤의 잔액.
대화형 에이전트가 사용자의 수정 요청을 누적할 때. "A로 해 줘 → 아니 B로 → 방금 거에서 색만 원래대로"를 30턴 동안.
직접 해 보자. 아래 위젯에서 컵을 섞으며, 세 가지 풀이 방식이 어디서 갈라지는지 보시길.
⚠️
흔한 오해 하나. "트랜스포머는 이론적으로 짝수·홀수 판별(parity)을 못 한다"는 말이 자주 돌지만 정확하지 않다. 패리티는 TC⁰ 안에 있다. 트랜스포머가 패리티에서 자주 실패하는 것은 표현력의 한계라기보다 학습과 길이 일반화의 문제다. 이론적으로 확실히 어려운 쪽은 S₅ 같은 비가환 순열 합성이다. 뒤에 나올 독립 실험도 패리티와 5상태 전이를 함께 쓰는데, 이 구분을 기억해 두면 결과를 읽기 쉽다.
1-4. 첫 번째 탈출구 — 생각을 글로 적게 하기 (2022~)
벽을 넘는 첫 번째 방법은 뜻밖에 간단했다. 적게 하면 된다.
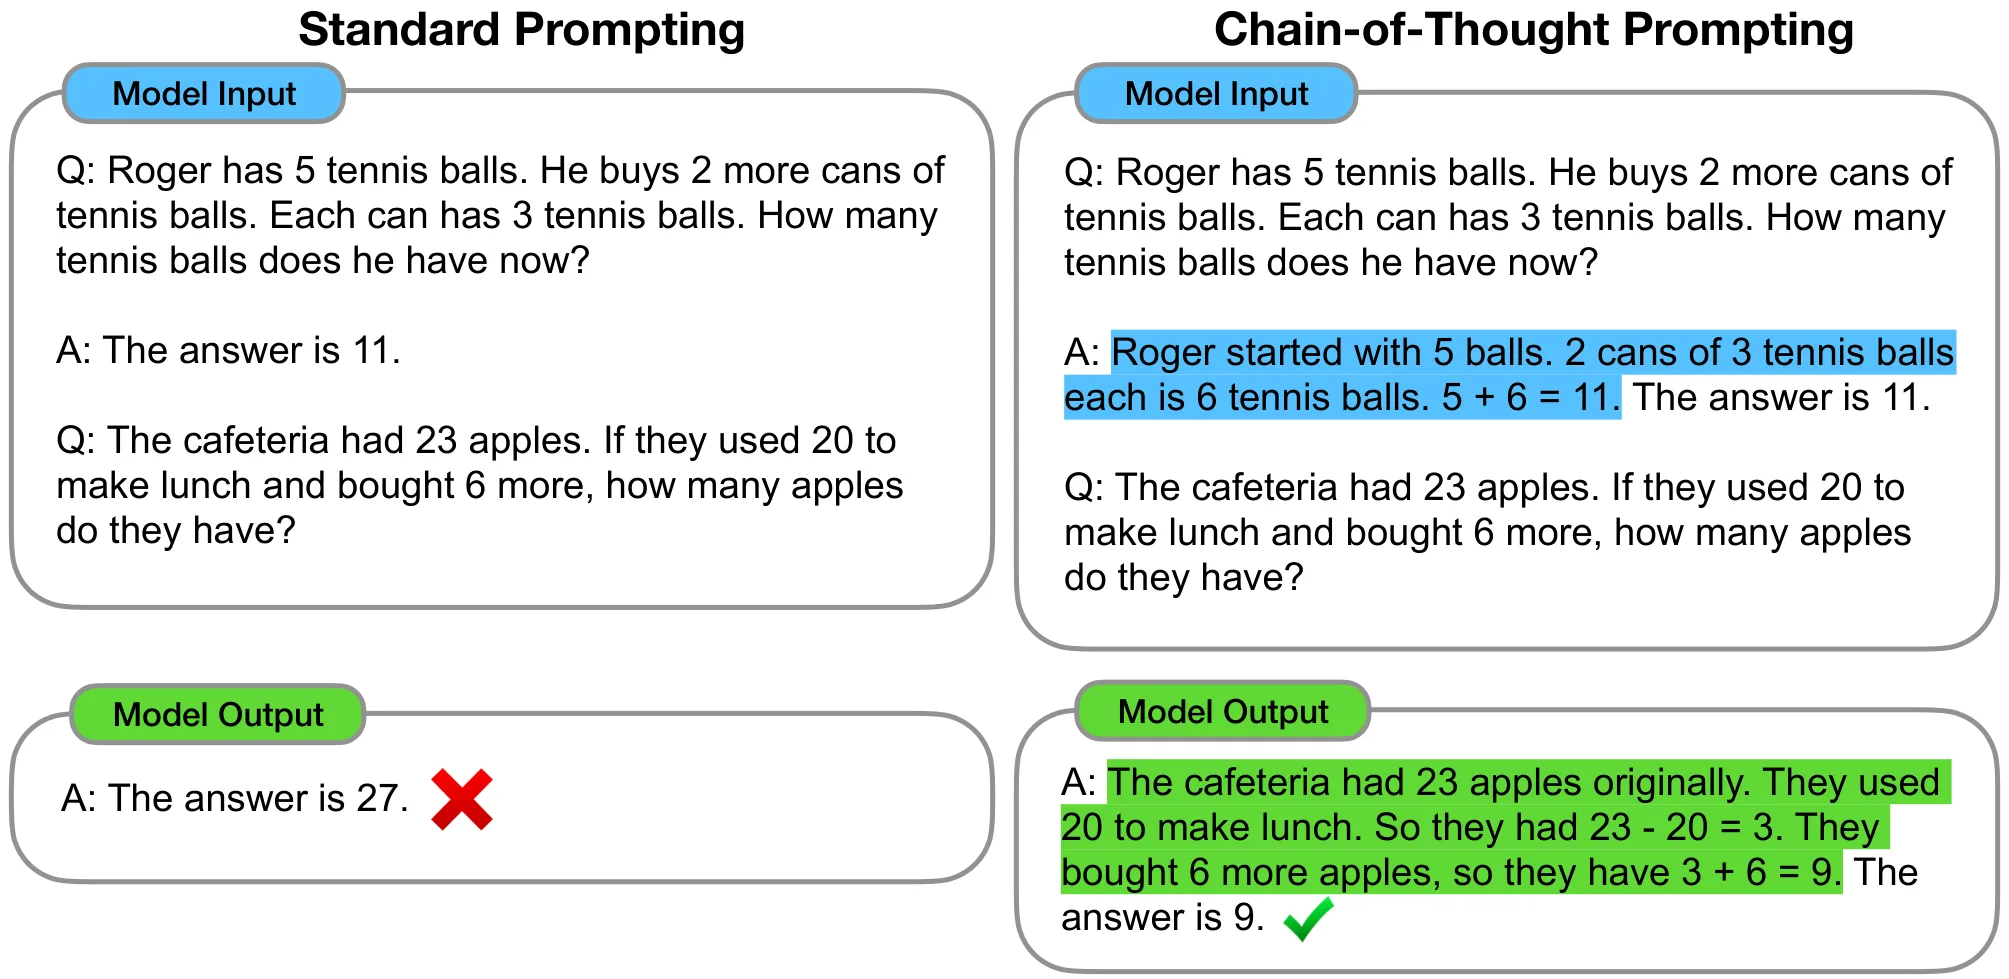
2022년 구글의 제이슨 웨이(Jason Wei) 등은 「Chain-of-Thought Prompting」 논문에서, 모델에게 문제와 함께 "풀이 과정이 적힌 예시"를 몇 개 보여 주기만 해도 수학 문제 정답률이 크게 오른다는 것을 보였다. PaLM 540B의 초등 수학 벤치마크(GSM8K) 정답률이 17.9%에서 56.9%로 뛰었다.
▲ Wei et al. (2022) Figure 1. 왼쪽은 답만 요구했을 때(27개, 오답), 오른쪽은 풀이를 적게 했을 때(9개, 정답). CC BY 4.0.
왜 이게 통할까? 메릴과 사브하르왈이 2023년 「The Expressive Power of Transformers with Chain of Thought」에서 답을 줬다. 트랜스포머가 적은 토큰은 다음 토큰을 계산할 때 다시 입력으로 들어간다. 즉 모델은 자기가 쓴 글을 메모장처럼 쓰면서 계산을 이어 간다. 적는 단계가 입력 길이에 비례할 만큼 충분하면, 트랜스포머는 모든 정규 언어를 인식할 수 있다. 야바위로 치면 "섞기 후 공은 3번 컵"을 매번 적는 것이다. 층이 고정되어 있어도, 글이 층을 대신해 깊이를 만들어 준다.
2024년 9월 OpenAI의 o1은 이 원리를 강화학습으로 극단까지 밀어붙였다. 답하기 전에 수천~수만 개의 "추론 토큰"을 생성하도록 훈련한 것이다. 2025년 1월 DeepSeek-R1은 같은 일을 오픈 가중치로 해냈고, 강화학습만으로 모델이 "더 오래 생각하는 법"을 스스로 배운다는 것을 보여 줬다.
그런데 이 탈출구에는 세 가지 비용이 붙는다.
비용
무슨 뜻인가
구체적인 예
돈과 시간
생각 토큰은 전부 생성해야 하고, 출력 토큰으로 과금된다
GPT-6 Astra의 API 출력 단가는 100만 토큰당 50달러. 추론 토큰 3만 개를 쓰는 호출 하나에 약 1.5달러다(단가 기준 계산). OpenAI 문서는 추론용으로 최소 2만 5천 토큰을 비워 두라고 권한다
메모리
적은 토큰마다 KV 캐시가 쌓인다
Llama-3-70B급 구조(80층, KV 헤드 8개, 헤드 차원 128, 16비트)면 토큰당 약 0.32MB. 3만 2천 토큰짜리 추론이면 요청 하나에 약 10GB다(구조 기준 계산)
대역폭
다음 단계로 넘어가는 통로가 고른 단어 하나뿐이다
어휘가 10만 개면 토큰 하나는 최대 약 16.6비트. 모델 내부의 은닉 벡터는 수천 개의 실수로 되어 있다. 생각을 글로 적을 때마다 풍부한 내부 상태를 단어 하나로 "압축"했다가 다시 풀어야 한다
세 번째 비용이 핵심이다. 머릿속에서는 "3번 컵일 확률 70%, 5번일 수도 있음" 같은 흐릿한 상태를 들고 있을 수 있는데, 글로 적는 순간 하나를 골라야 한다. 이 병목을 없애고 싶다는 욕망이, 이후 등장하는 모든 "잠재 추론" 연구의 출발점이다.
1-5. 두 번째 탈출구 — 건물을 한 층 더 올리는 대신 같은 층을 여러 번 오르기
글 대신 층을 반복하는 방법도 오래전부터 있었다.
2018년 구글의 Universal Transformer(데그하니 등)는 층마다 다른 가중치를 두는 대신, 같은 블록을 깊이 방향으로 여러 번 반복 적용했다. 위치마다 "얼마나 더 생각할지"를 스스로 정하는 적응형 계산 시간(ACT)도 붙였다. 영어-독일어 번역에서 같은 크기 트랜스포머보다 BLEU가 0.9 높았다.
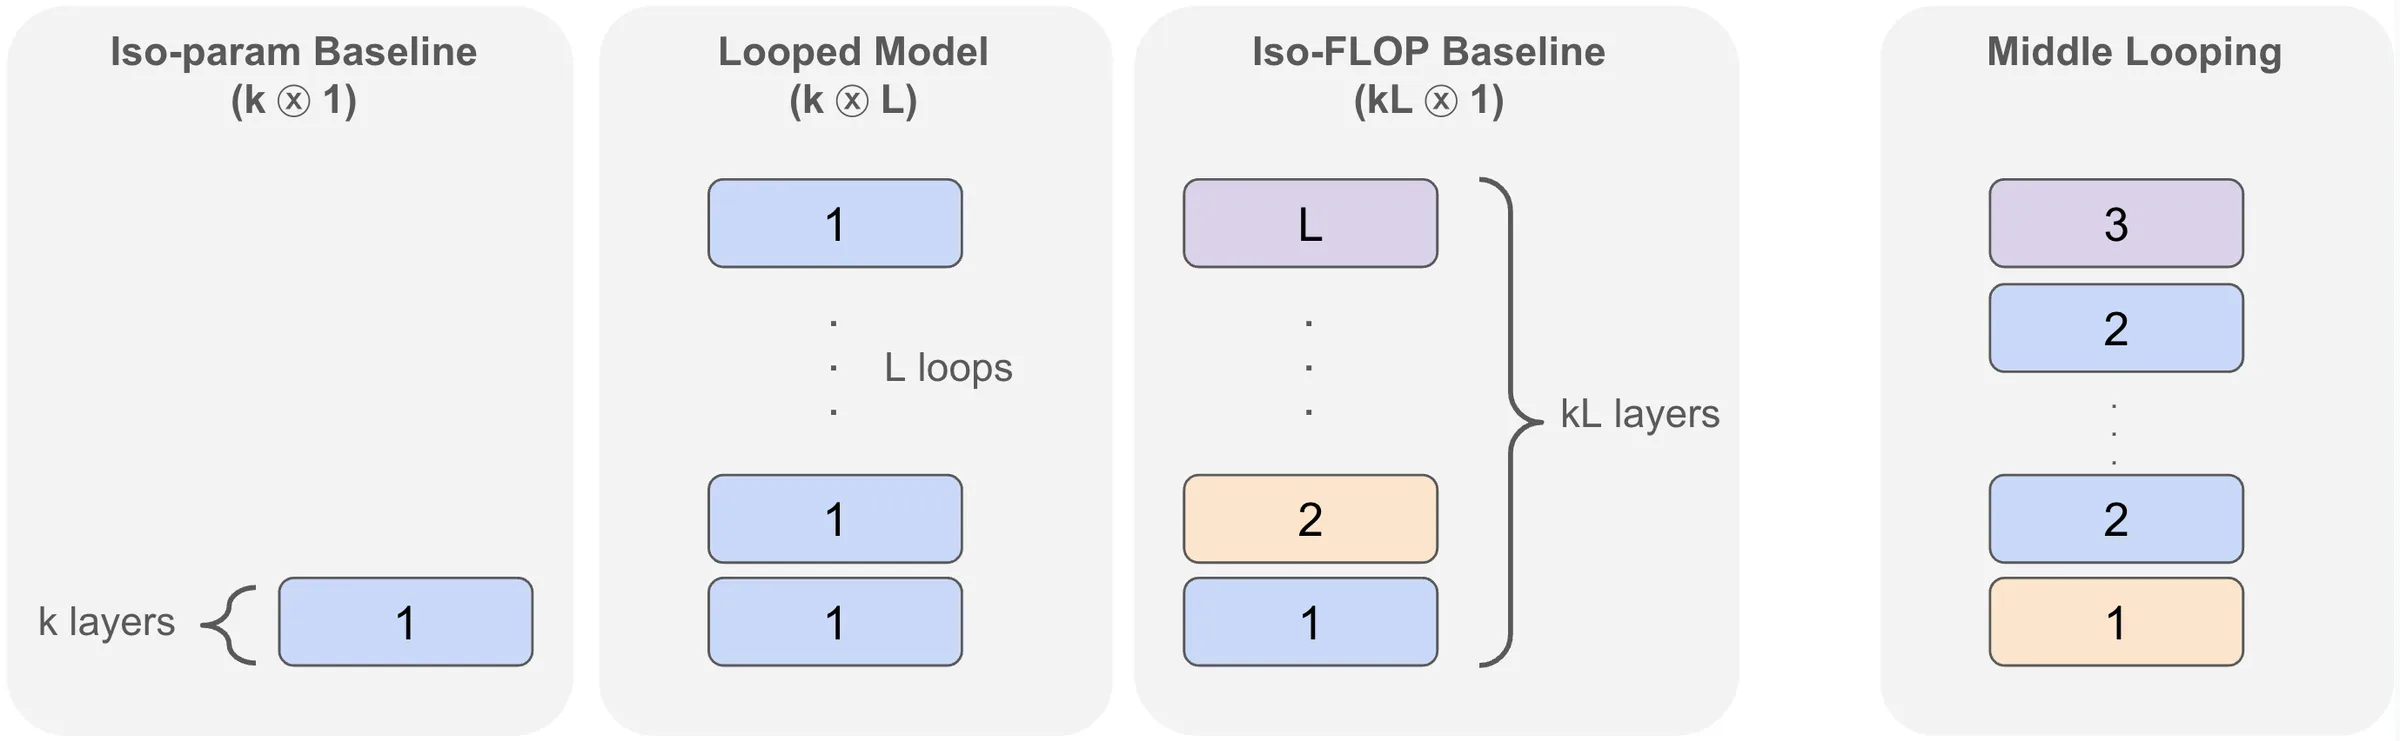
2025년에는 이 아이디어가 추론의 맥락에서 부활했다. 구글의 사운시(Saunshi) 등은 「Reasoning with Latent Thoughts: On the Power of Looped Transformers」에서 결정적인 관찰을 내놨다. 많은 추론 문제는 깊이는 많이 필요하지만 파라미터는 꼭 많이 필요하지 않다. k층짜리 블록을 L번 돌린 모델은 kL층짜리 모델에 거의 맞먹었다. 덧셈 과제에서 1층 모델은 정답률 0.1%였지만, 같은 1층을 12번 돌리자 99.9%가 됐다. 10억 파라미터급 실험에서 12층을 2번 돌린 모델은 24층 모델보다 암기(퍼플렉서티)는 약했지만 수학 문장제 점수는 오히려 높았다(34.3 대 29.3).
▲ Saunshi et al. (2025) Figure 1. 왼쪽부터 같은 파라미터의 기준 모델(k층 1회), 루프 모델(k층 L회), 같은 계산량의 기준 모델(kL층), 가운데만 반복하는 변형. CC BY 4.0.
같은 해 2월, 요나스 가이핑(Jonas Geiping)과 메릴랜드 대학·로런스 리버모어 국립연구소 등의 공동 연구진은 Huginn-3.5B를 공개했다. 앞단(prelude) → 반복되는 코어 블록 → 뒷단(coda) 구조로, 추론할 때 코어를 몇 번 돌릴지를 마음대로 늘릴 수 있다. 오크리지 국립연구소의 슈퍼컴퓨터 Frontier에서 GPU 4,096장으로 8천억 토큰을 학습했고, 반복을 늘리면 500억 파라미터 모델에 해당하는 계산량까지 쓸 수 있다고 보고했다. 논문 제목이 핵심을 말한다. 「잠재 추론으로 테스트 시점 계산을 늘린다」. 생각 토큰을 한 글자도 적지 않고도 더 오래 생각할 수 있다는 주장이다.
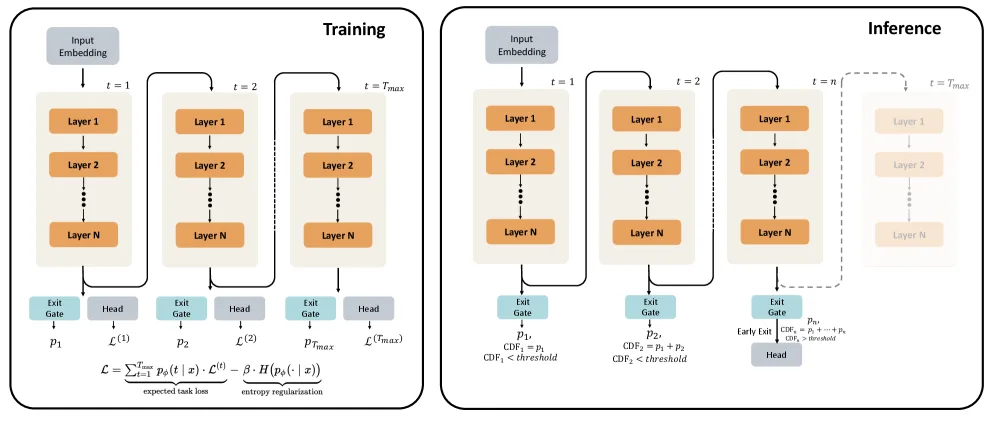
2025년 10월 바이트댄스 시드(ByteDance Seed) 등이 공개한 Ouro는 이것을 7.7조 토큰 규모의 사전학습으로 가져왔다. 반복 횟수를 스스로 정하도록 학습시킨 1.4B 모델이 4B급 모델과 맞먹었고, 2.6B 모델은 MATH500에서 90.85점으로 Qwen3-8B-Base(62.30)를 앞섰다. 흥미로운 분석이 붙어 있다. 루프를 돌려도 파라미터당 저장하는 지식의 양은 늘지 않았다(파라미터당 약 2비트). 늘어난 것은 지식을 조작하는 능력이었다.
▲ Zhu et al. (2025) 「Scaling Latent Reasoning via Looped Language Models」 Figure 3. 학습 때는 같은 층 묶음을 여러 번 돌리며 각 단계에서 손실을 계산하고(왼쪽), 추론 때는 종료 게이트가 충분하다고 판단하면 일찍 멈춘다(오른쪽). CC BY-SA 4.0.
그런데 이 계열에는 공통된 한계가 있다. 반복이 한 토큰 안에서 끝난다. 토큰 A를 처리하며 32번 돌려 깊이 생각했더라도, 토큰 B로 넘어가면 다시 1층부터 시작한다. 이전 토큰들의 결과는 KV 캐시로 참고할 수 있지만, 그 "깊은 생각의 결론 상태" 자체가 다음 토큰의 출발점이 되지는 않는다.
📰
GPT-6 Astra 보도가 가리킨 것이 바로 이 계열이다. 보도 내용은 "같은 트랜스포머 블록을 여러 번 재사용한다"는 것이었고, 이는 한 토큰 안의 깊이 반복이다. OpenAI는 구조를 공식 확인하지 않았다. 수석 과학자 야쿠프 파호츠키(Jakub Pachocki)는 X에 "Astra를 포함한 현재 최전선 모델들의 계산 그래프 깊이는 GPT-4의 두 배 이내"라고 적었다. 반복이 없다고 부정한 게 아니라, 깊이의 상한을 밝힌 것이다. 이 내용은 6장에서 다시 다룬다.
1-6. 세 번째 탈출구 — 생각을 단어 대신 벡터로 넘기기
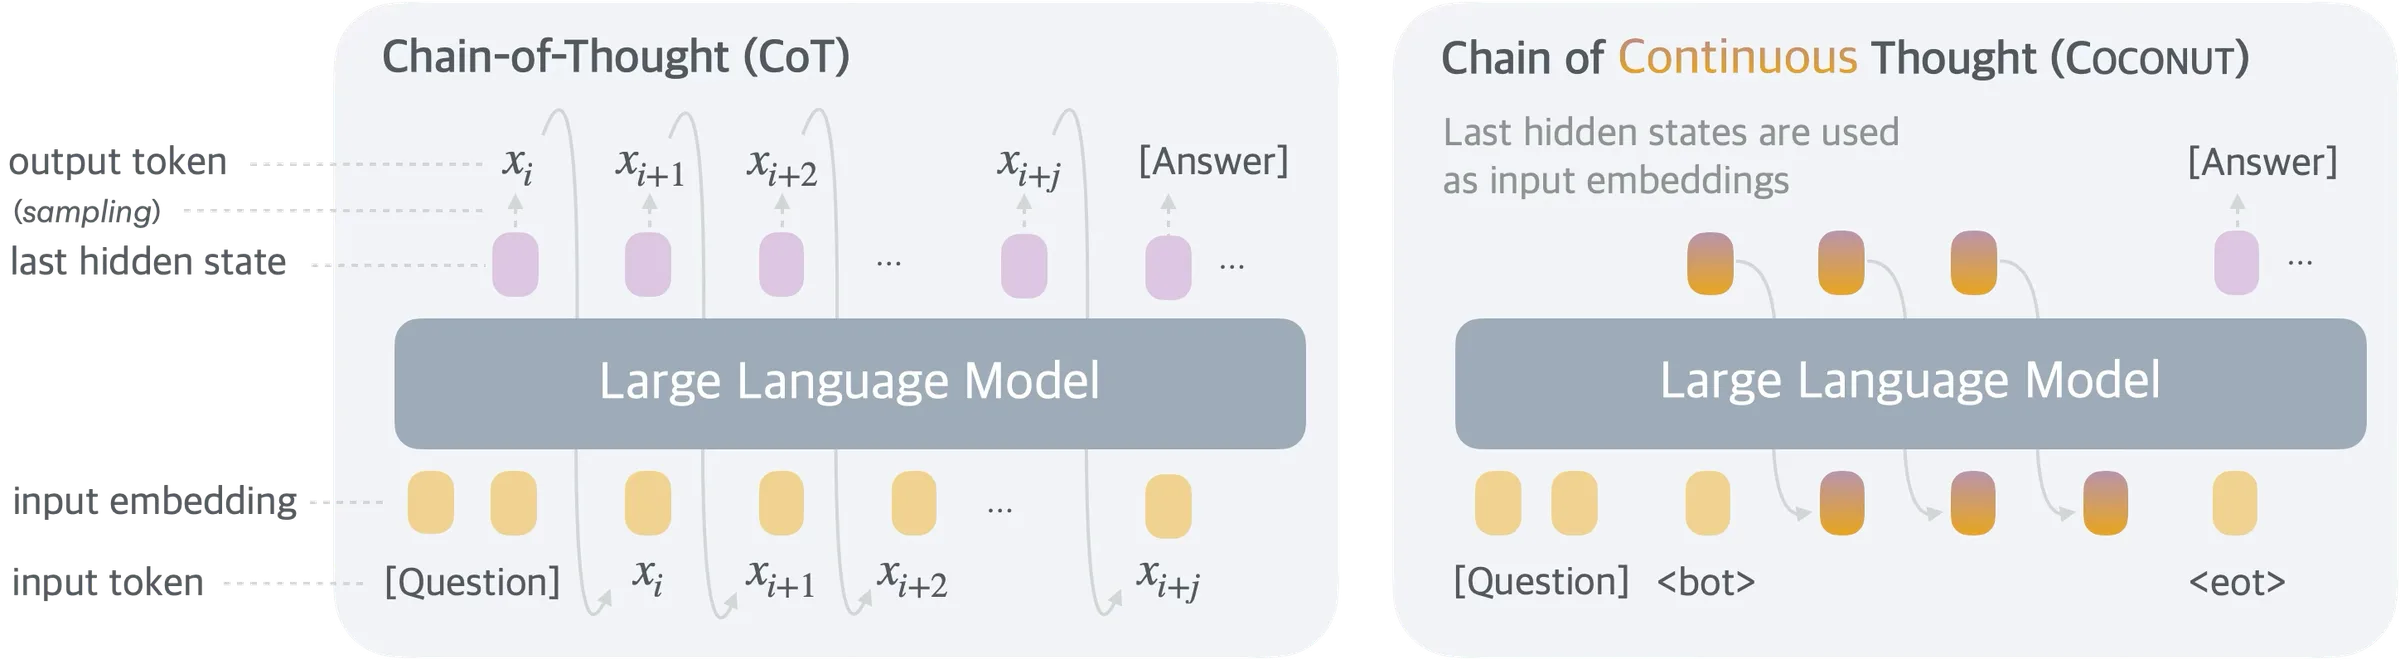
2024년 12월, 메타 FAIR의 하시보(Shibo Hao) 등이 발표한 Coconut(Chain of Continuous Thought)은 생각의 사슬과 순환 신경망 사이에 다리를 놨다. 발상은 이렇다. 생각의 사슬에서 모델은 마지막 은닉 상태로 단어를 하나 고르고, 그 단어를 다시 입력으로 넣는다. 그 "단어를 고르는" 단계를 건너뛰면 어떨까? 마지막 은닉 상태를 그대로 다음 입력 임베딩으로 넣는 것이다.
▲ Hao et al. (2024) Coconut 개요도. 왼쪽 생각의 사슬은 은닉 상태 → 단어 샘플링 → 다시 입력. 오른쪽 Coconut은 은닉 상태를 곧바로 다음 입력으로 넣는다(주황색). facebookresearch/coconut 저장소, MIT 라이선스.
결과가 재미있다. 단어를 고르지 않으니, 연속적인 생각 하나가 여러 후보 경로를 동시에 품을 수 있었다. 연구진은 이것이 너비 우선 탐색(BFS)처럼 작동한다고 분석했다. 논리 추론 과제 ProsQA에서 Coconut은 14.2토큰으로 97.0%를 맞혔고, 생각의 사슬은 49.4토큰을 쓰고 77.5%에 그쳤다. 다만 GSM8K 같은 산수에서는 여전히 글로 적는 쪽이 나았다(34.1% 대 42.9%). GPT-2 크기 실험이라는 점도 감안해야 한다.
Coconut의 "마지막 은닉 상태를 다음 입력으로"는 RLT의 병합(merge)과 구조적으로 아주 가깝다. 차이는 범위다. Coconut은 <bot>과 <eot> 사이의 정해진 생각 구간에서만 벡터를 넘긴다. RLT는 모든 토큰에서, 프롬프트의 첫 토큰부터 응답의 마지막 토큰까지 넘긴다.
1-7. 네 번째 줄기 — 시간 방향으로 되먹임하기
마지막 계보는 "과거의 깊은 층을 현재의 얕은 층에 연결"하려는 시도다.
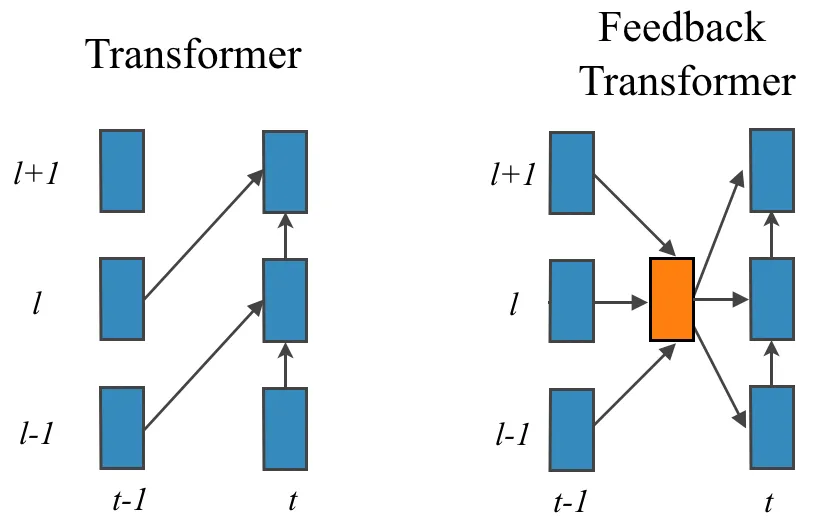
2020년 Feedback Transformer(팬 등, 페이스북 AI)는 과거 시점의 모든 층 표현을 하나의 메모리 벡터로 합쳐서 현재 시점의 모든 층이 읽게 했다. 논문의 표현으로는 "현재 시점의 가장 낮은 표현이 과거의 가장 높은 수준의 추상 표현으로부터 만들어진다." 1층짜리 디코더로도 번역 BLEU가 트랜스포머보다 1점 높았다.
▲ Fan et al. (2020) Figure 2. 일반 트랜스포머(왼쪽)는 t-1 시점의 l층이 t 시점의 l+1층으로만 연결된다. 피드백 트랜스포머(오른쪽)는 과거의 모든 층을 주황색 메모리로 모아 현재의 모든 층에 공급한다. 설명 목적의 인용.
그리고 2026년 4월, 하버드 켐프너 연구소의 온체스쿠(Oncescu), 샴 카카데(Sham Kakade) 등이 The Recurrent Transformer를 발표했다. 각 층이 과거 위치의 키·값을 만들 때 그 층의 입력이 아니라 출력에서 만들게 바꾼 것이다. 층마다 자기만의 순환 메모리를 갖는 셈이다. 3억 파라미터 실험에서 12층 Recurrent Transformer가 24층 트랜스포머보다 검증 손실이 낮았다(2.867 대 2.892). 대가는 속도였다. 순진하게 프리필하면 쿼리를 하나씩 처리해야 해서, 연구진은 GPU 메모리 왕복을 Θ(N²)에서 Θ(N log N)으로 줄이는 정확한 타일링 알고리즘을 따로 고안했다. 그래도 12층 기준 처리량은 초당 4만 2천 토큰으로, 일반 트랜스포머(13만 2천)의 3분의 1이었다.
RLT 논문은 관련 연구에서 이 둘을 "시간 방향 되먹임의 중요한 선례"로 꼽고 차이를 분명히 한다. Recurrent Transformer는 층별로 되먹임하고, RLT는 디코더 전체의 최종 출력을 다음 토큰의 입력으로 되먹인다. 그래서 Recurrent Transformer의 타일링 알고리즘이 RLT에 자동으로 적용되지는 않는다고 적었다.
1-8. 한 장으로 보는 계보
연도
구조
깊이를 늘리는 방법
토큰 사이의 통로
사람이 읽을 수 있나
1990·1997
RNN · LSTM
시간 순서대로 상태를 넘김
은닉 상태 벡터
아니오
2017
트랜스포머
층을 쌓음 (고정)
KV 캐시(과거 참조)
해당 없음
2018
Universal Transformer
같은 블록을 깊이 방향으로 반복
KV 캐시
해당 없음
2020
Feedback Transformer
과거 상위층을 현재 하위층에
층 합성 메모리
아니오
2022~
생각의 사슬 · 추론 모델
토큰을 적어 계산을 이어 감
고른 단어
예 (대체로)
2024
Coconut
생각 구간에서 은닉 상태를 입력으로
은닉 상태 벡터 (구간 한정)
생각 구간은 아니오
2025
Huginn · 루프 모델 · Ouro
한 토큰 안에서 블록 반복
KV 캐시
반복 중 계산은 아니오
2026.4
Recurrent Transformer
층별 출력으로 과거 KV 생성
층별 순환 KV
아니오
2026.9
RLT
모든 토큰에서 디코더 상태를 넘김
최종 은닉 상태 + 층별 최근 KV
토큰 사이 계산은 아니오
표를 위에서 아래로 읽으면 흐름이 보인다. 1990년의 RNN은 벡터로 상태를 넘겼고, 2017년 트랜스포머가 그 통로를 끊어 병렬을 얻었다. 2022년에는 끊어진 통로를 글로 다시 이었다. 그리고 2024년부터는 그 통로를 다시 벡터로 바꾸려는 시도가 쏟아지고 있다. RLT는 이 되돌림을 가장 철저하게, 모든 토큰에서 한 것이다. 병렬을 되찾기 위한 트랜스포머의 장치들(인코더, KV 메모리)은 그대로 둔 채로.
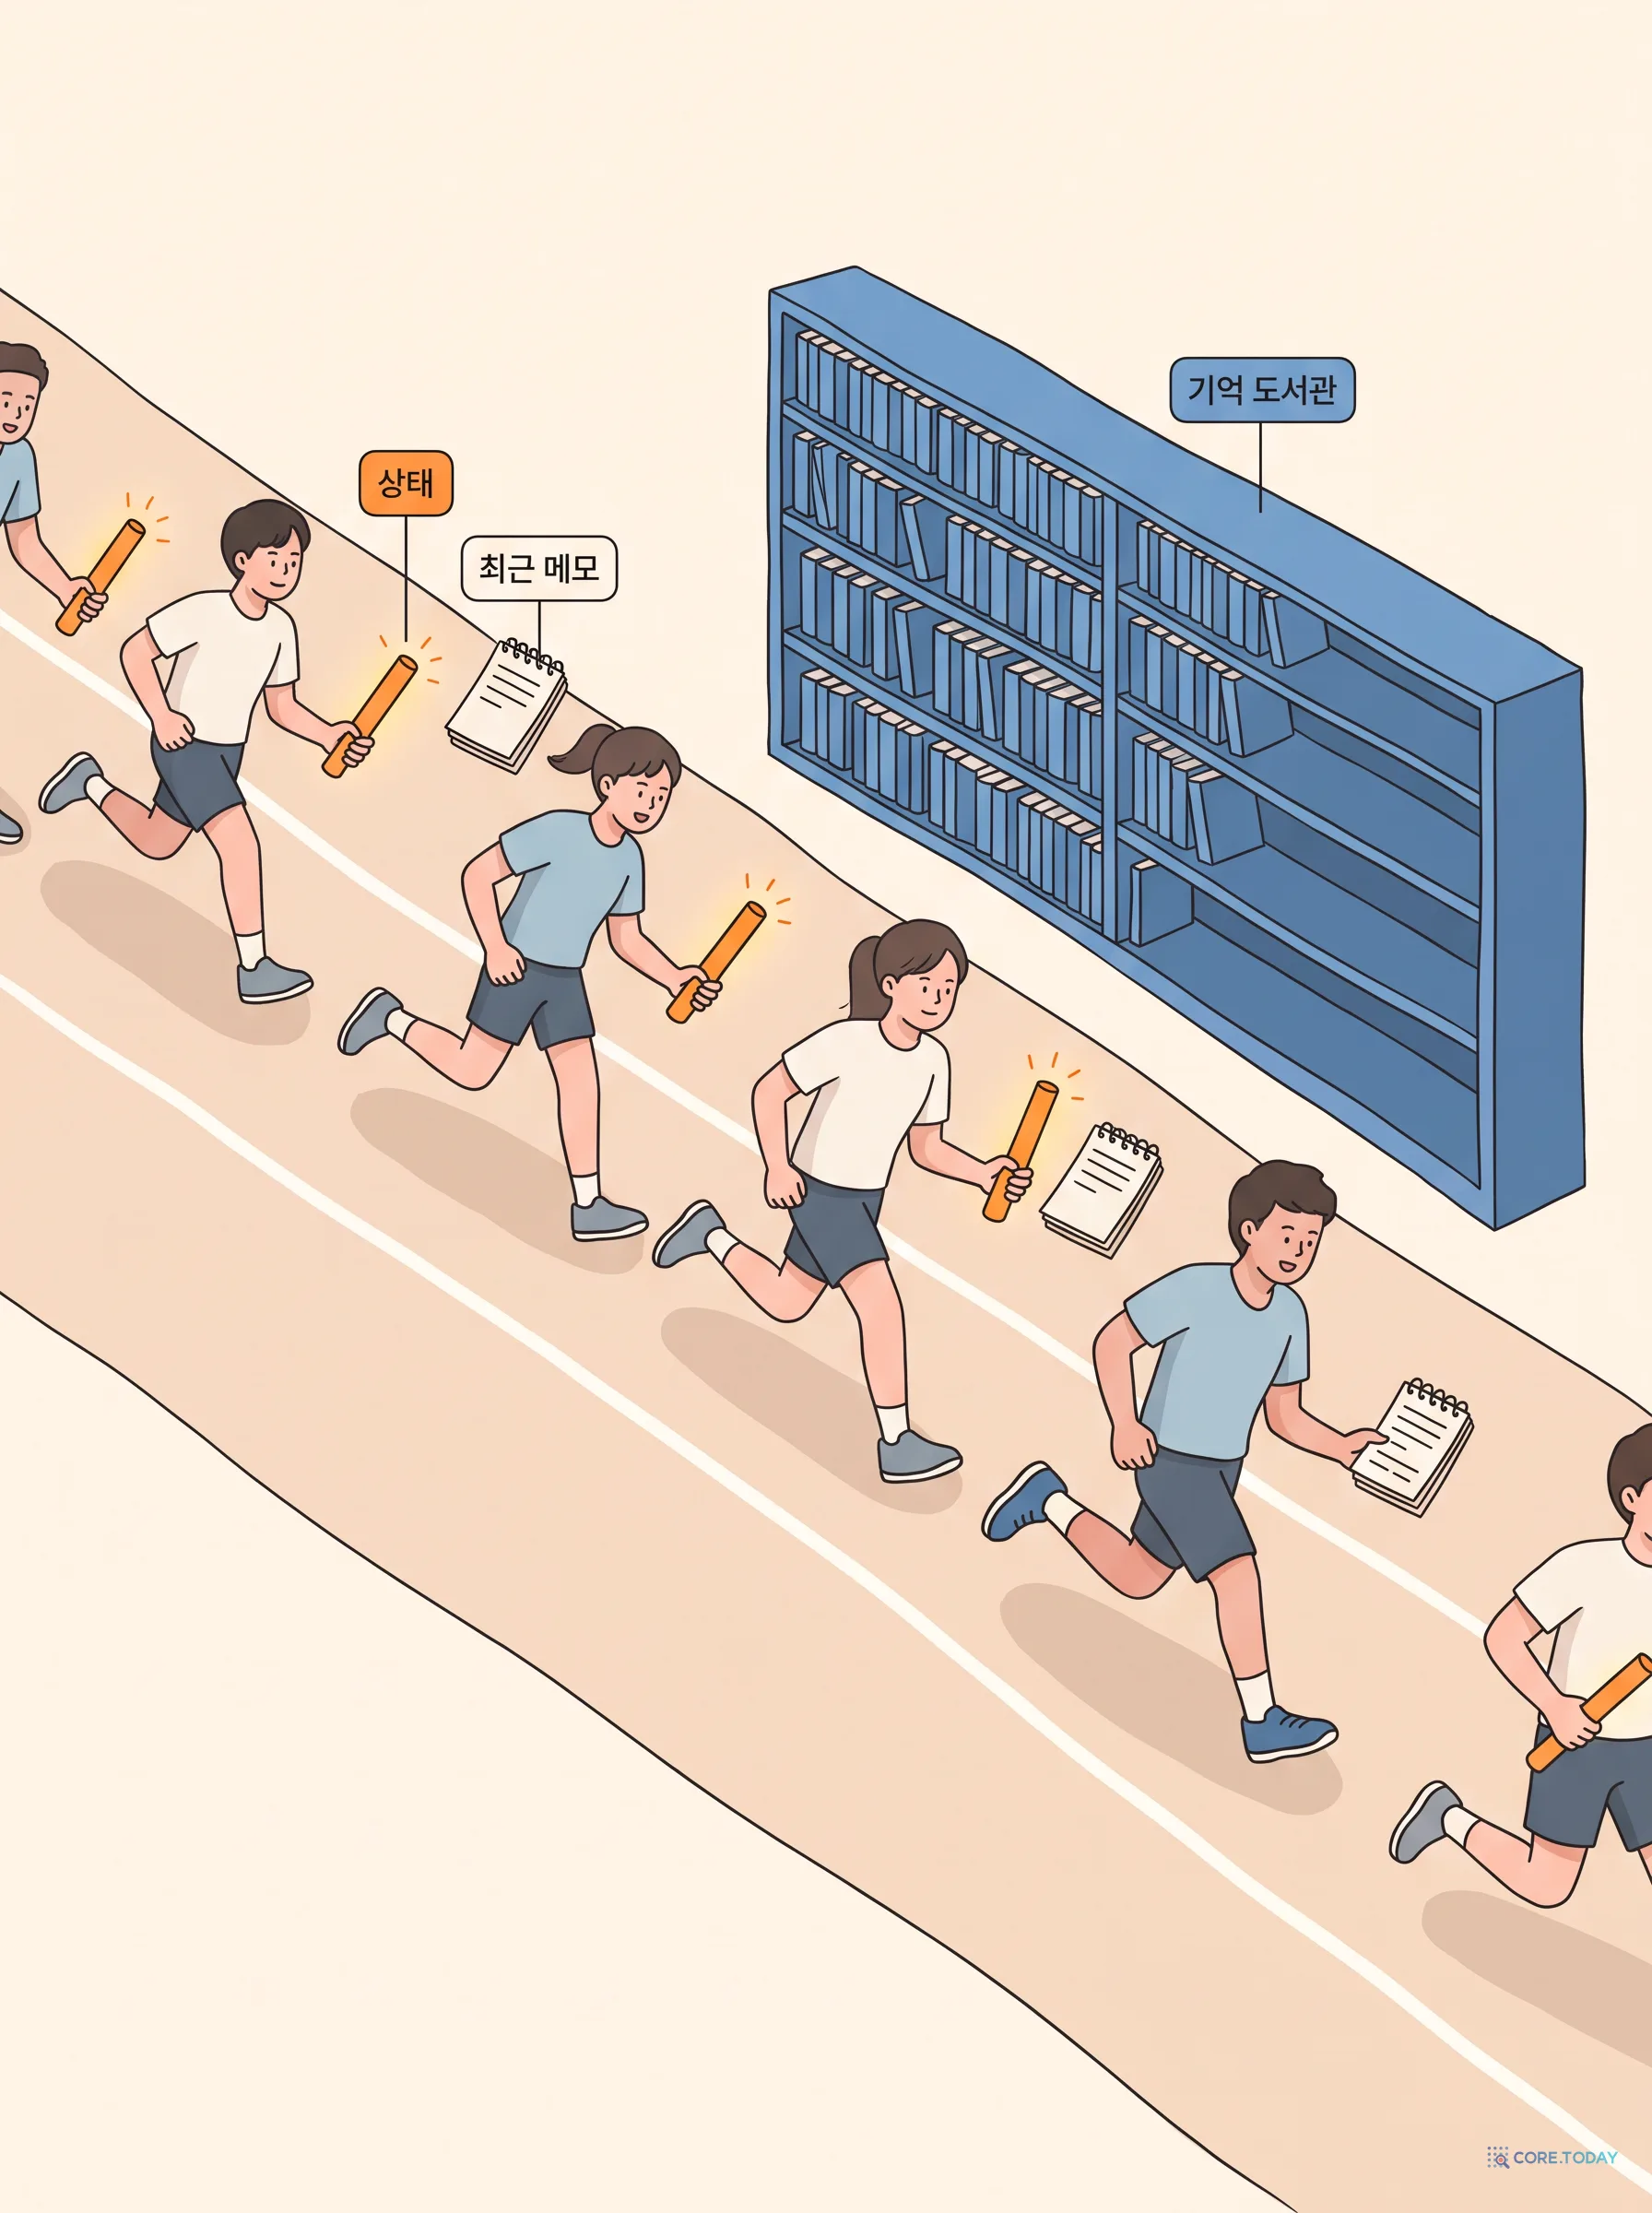
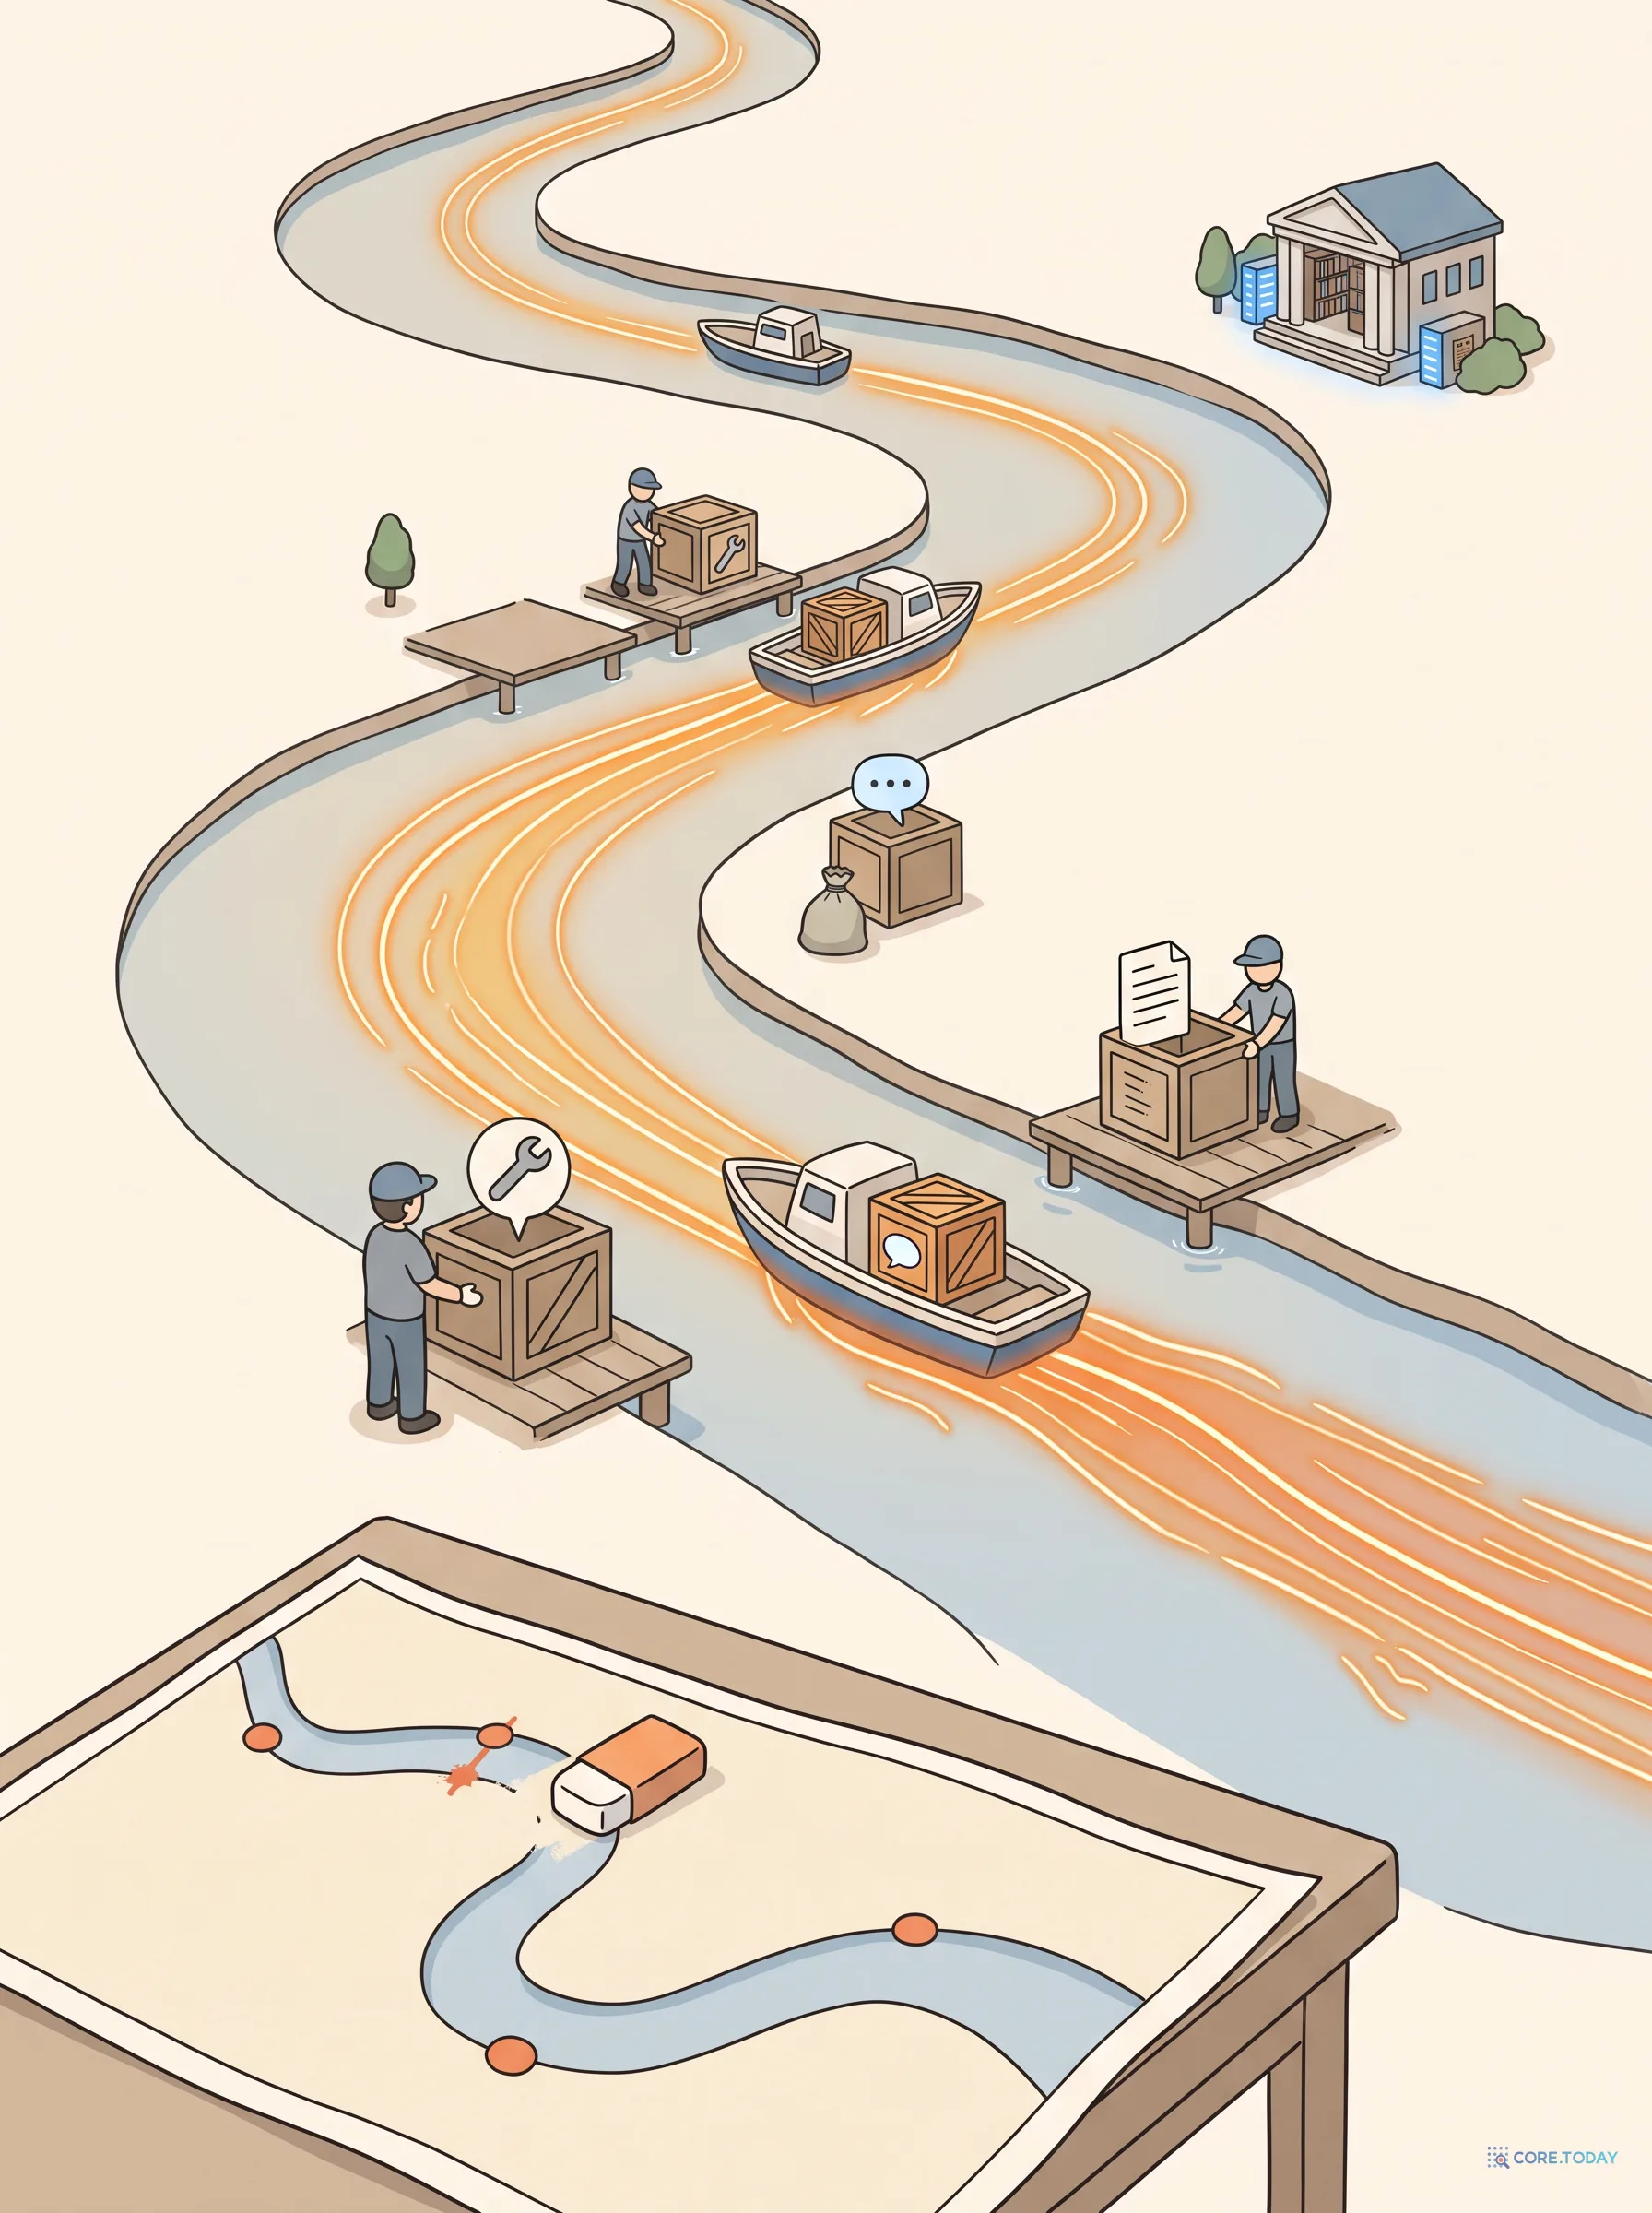
바통(상태 st). 앞 주자가 달리며 한 계산의 결론. 다음 주자는 반드시 이걸 받아서 출발한다. 주황색.
메모장(층별 슬라이딩 윈도 캐시 CtD). 최근 몇 명의 주자가 각 구간(층)에서 남긴 메모. 오래된 페이지는 찢어 버리고 최근 W−1장만 넘긴다.
도서관(인코더 메모리 M≤t). 트랙 옆에 쭉 늘어선 책장. 지금까지 지나온 모든 토큰에 대한 정리가 꽂혀 있고, 주자는 달리면서 언제든 들여다볼 수 있다. 단, 자기 위치보다 앞쪽 책장은 비어 있다(미래 토큰은 볼 수 없다). 파란색.
2-1. 부품 ① 인과 인코더 — 한꺼번에 읽는 도서관 사서
첫 번째 부품은 평범한 트랜스포머다. 토큰 x1,…,xT를 받아 표현 e1,…,eT를 만든다. 인과(causal) 마스크를 쓰기 때문에 et는 t번째까지만 본다. 그리고 이 표현들로 키·값 쌍을 만들어 인코더 메모리에 쌓는다.
중요한 성질은 두 가지다. 인코더는 디코더 상태와 무관하다. 그래서 이미 알고 있는 토큰(프롬프트, 학습 데이터)은 전부 한꺼번에 병렬로 처리할 수 있다. 그리고 한 번 만든 메모리는 같은 접두 토큰과 같은 파라미터라면 절대 변하지 않는다. 재사용이 쉽다는 뜻이다.
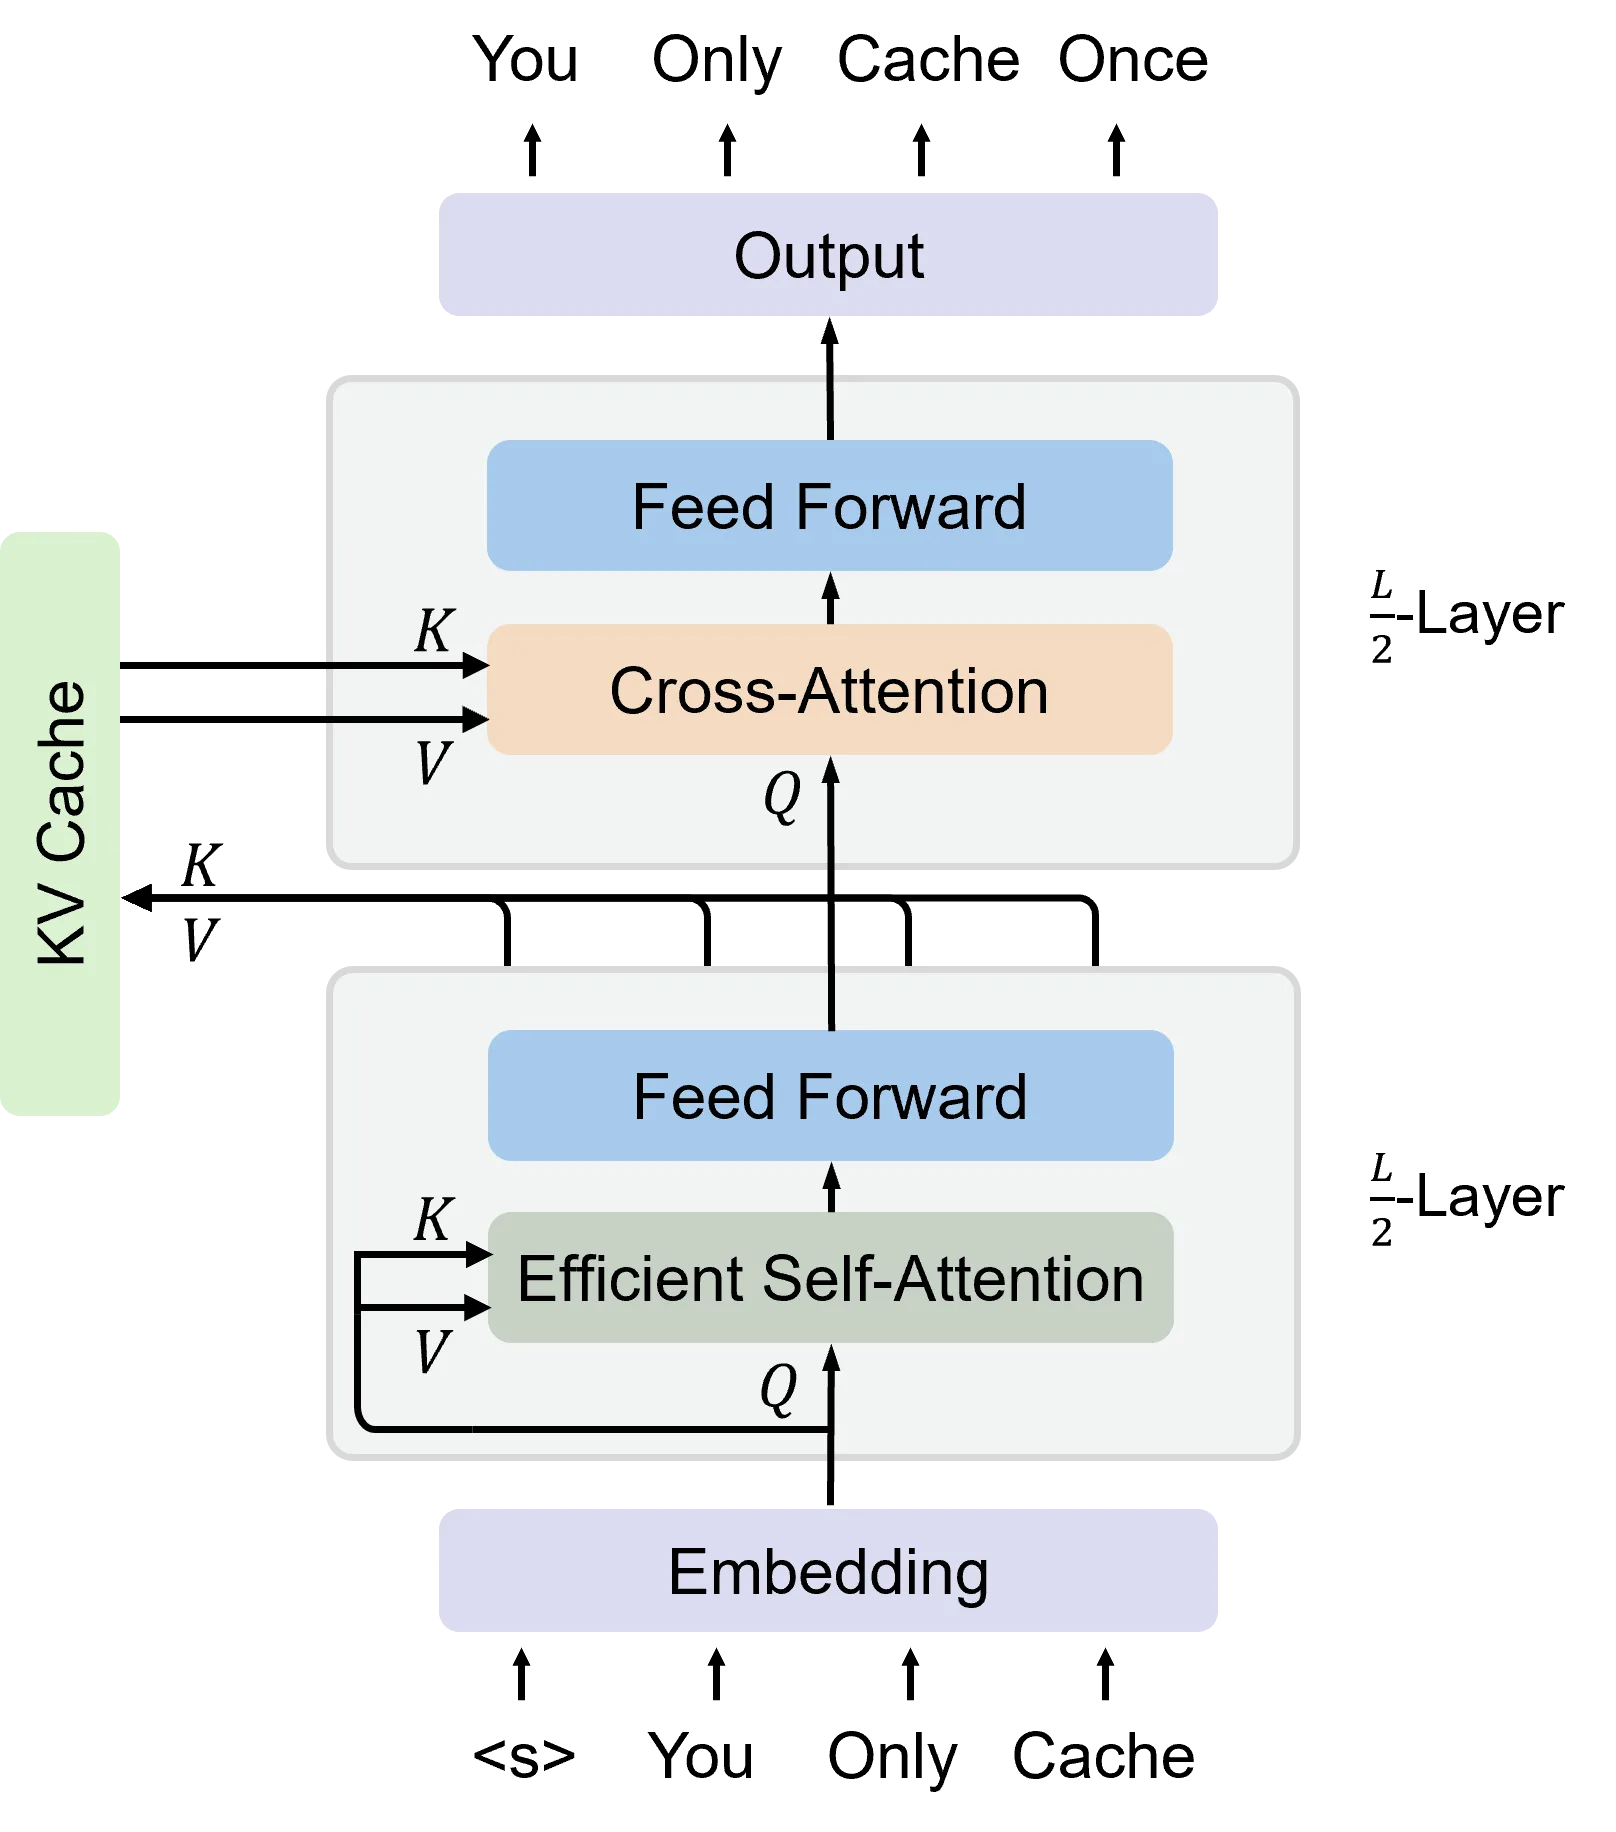
이 아이디어의 뿌리는 2024년 마이크로소프트의 YOCO(You Only Cache Once)다. YOCO는 아래쪽 "셀프 디코더"가 전역 KV 캐시를 한 번만 만들고, 위쪽 "크로스 디코더"가 그걸 재사용하게 했다. 650억 파라미터 모델 기준 KV 캐시 메모리가 약 80분의 1로 줄었고, 100만 토큰 문맥의 프리필이 71.8배 빨라졌다. 2026년 9월 10일 공개된 DeepSeek-V4.1-Flash 기술 보고서도 "YOCO에서 영감을 받은" 인과 인코더-디코더 구조를 채택해, 전역 KV를 인코더 최종 상태에서 투영했다.
▲ Sun et al. (2024) 「You Only Cache Once」 구조도. 셀프 디코더가 만든 KV 캐시를 크로스 디코더의 모든 층이 공유한다. microsoft/unilm 저장소, MIT 라이선스.
그런데 RLT는 여기서 결정적으로 갈라진다. YOCO와 DeepSeek은 이 구조 덕분에 프롬프트를 처리할 때 위쪽 디코더를 건너뛸 수 있었다(프리필 조기 종료). 속도의 원천이 그거였다. RLT는 건너뛰지 않는다. 논문은 이렇게 적었다. "RLT는 인코더 유래 메모리를 유지하지만 모든 프롬프트 토큰을 순환 디코더로 처리한다. 따라서 그 설계들의 프롬프트 전체 디코더 건너뛰기를 물려받지 않는다." 이 선택의 이유는 4장에서 나온다.
2-2. 부품 ② 병합 게이트 — 새 정보와 이전 결론 섞기
두 번째 부품이 RLT의 심장이다. 토큰 t의 인코더 표현 et와, 바로 앞 토큰에서 디코더가 낸 최종 출력st−1을 섞는다.
새 토큰의 표현과 이전 결론을 함께 보고, 차원마다 0과 1 사이의 문(gt)을 연다. "이번 토큰에서는 이전 결론의 이 성분은 많이, 저 성분은 조금 가져가자."
새 토큰 표현 et에, 문을 통과한 이전 결론을 α만큼 더한다.
α는 되먹임의 세기다. 논문은 "작은 0이 아닌 초기값이 후보"라고만 하고 안정성을 보장하는 처방은 아니라고 선을 긋는다. 흥미롭게도 독립 재현 저장소(Maverick-Ansh/rlt-reproduce)에서 α=0으로 되먹임을 끄자 A₅ 순열 과제 정확도가 1.000에서 0.152로 무너졌다. 이 한 줄의 덧셈이 상태 추적 능력의 전부라는 뜻이다.
2-3. 부품 ③ 순환 디코더 — 메모장을 보고, 도서관을 찾고, 결론을 낸다
병합된 입력 ut는 LD층짜리 디코더를 통과한다. 각 층은 세 단계를 거친다.
1. 메모장
인과 슬라이딩 윈도 어텐션(SWA). 이 층의 최근 W개 위치(현재 포함)의 디코더 활성값을 본다. 이 키·값은 인코더가 아니라 디코더 자신이 이전 토큰들에서 계산한 것이라서, 순환 계산의 흔적이 층마다 남아 있다.
2. 도서관
인코더 메모리 크로스 어텐션. 지금 위치까지의 인코더 메모리 전체를 참조한다. 먼 과거의 정보는 여기서 가져온다. 메모장은 짧고, 도서관은 넓다.
3. 정리
FFN. 위치별로 정보를 한 번 더 가공한다. 마지막 층의 출력이 st가 되고, 이것으로 다음 토큰 확률을 계산하는 동시에 다음 토큰의 병합 게이트로 넘긴다.
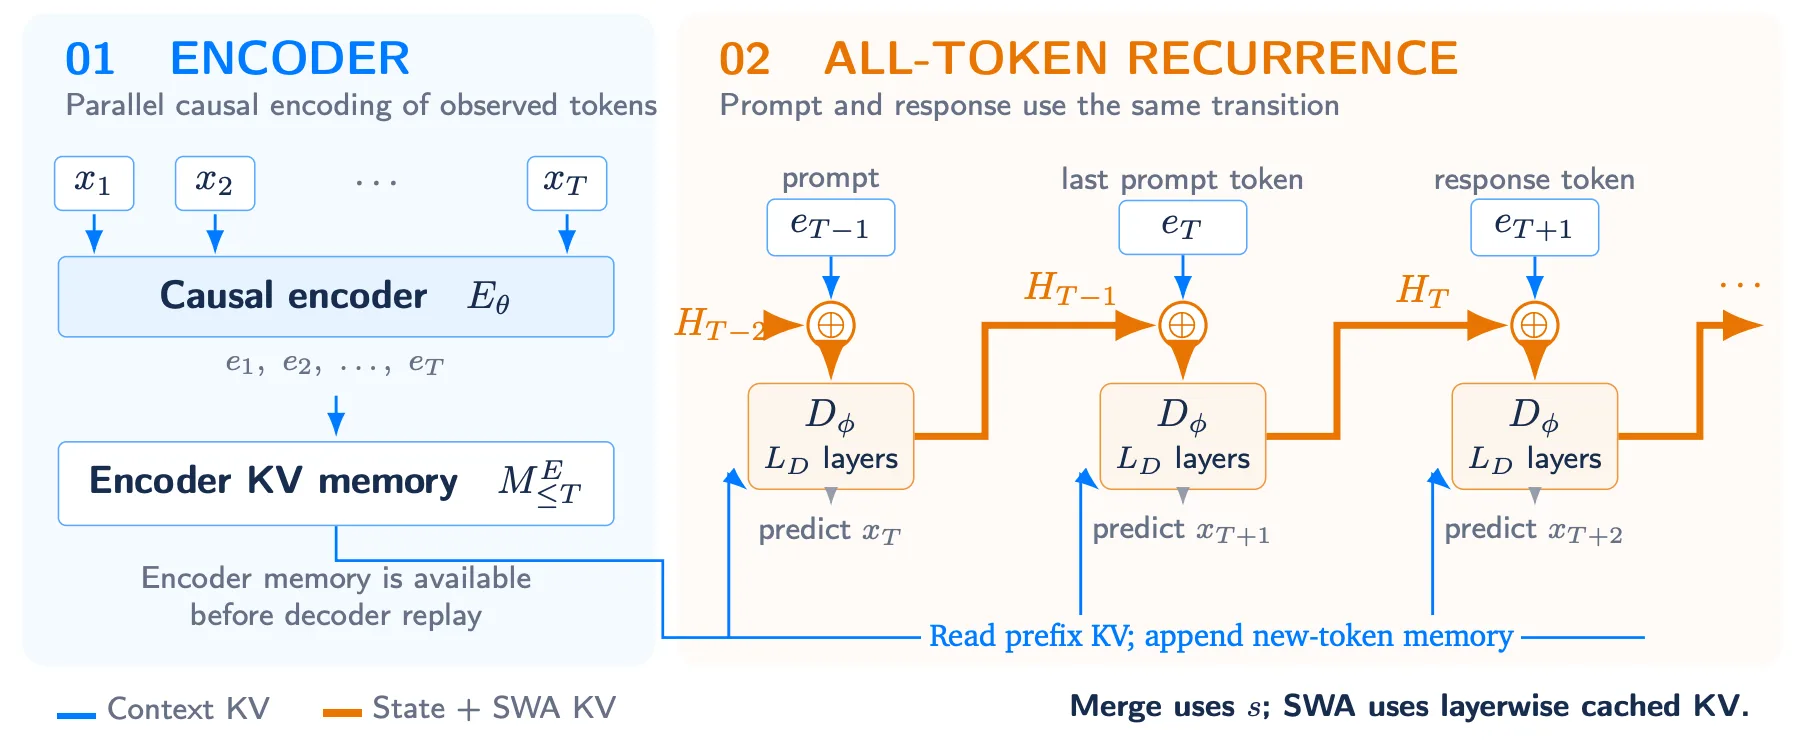
그래서 토큰 t에서 넘어가는 완전한 디코더 상태는 Ht=(st,CtD), 바통과 메모장 한 쌍이다. 논문 Figure 1이 이 흐름을 한 장에 담았다.
▲ Zhang (2026) Figure 1. 왼쪽(파란색) 인코더는 관측된 토큰을 병렬로 인코딩해 KV 메모리를 만든다. 오른쪽(주황색) 디코더는 모든 토큰을 순서대로 처리하며, 굵은 주황 화살표가 완전한 상태 Ht를 프롬프트와 응답의 경계를 넘어 초기화 없이 운반한다. 파란 선은 접두 구간으로 제한된 인코더 메모리를 공급한다. Apache 2.0.
2-4. 경계가 없다 — 프롬프트와 응답이 같은 계산
그림에서 가장 중요한 부분은 "last prompt token"에서 "response token"으로 넘어가는 화살표다. 아무 일도 일어나지 않는다. 상태가 초기화되지도, 계산 방식이 바뀌지도 않는다.
당연해 보이지만 결코 당연하지 않다. 순환 구조를 실용화하려는 많은 설계는 속도 때문에 프롬프트는 병렬로 대충 처리하고 응답부터 순환을 켜고 싶어진다. 그러면 "사용자가 보낸 마지막 단어"와 "모델이 쓴 첫 단어" 사이에 계산 규칙이 바뀌는 이음매가 생긴다. RLT는 이 이음매를 설계에서 지운다. 논문은 이것을 명제로 증명한다.
명제 3.1 (서빙 분할에 대한 불변성). 파라미터, 토큰 열, 위치 규칙, 시작 상태가 같다면, 어떤 접두 구간을 병렬 인코더 프리필 후 순환 디코더 갱신으로 처리하든 한 토큰씩 처리하든 같은 상태와 같은 다음 토큰 분포가 나온다. 프롬프트와 응답의 경계를 옮겨도 조건부 분포는 변하지 않는다.
증명은 한 줄짜리 귀납법이다. 시작 상태가 같고, t−1에서 상태가 같으면, t에서 같은 입력에 같은 연산을 하니 상태가 같다. 분할 지점은 전이 규칙 어디에도 등장하지 않는다.
실무적으로 이게 왜 중요할까? 에이전트를 떠올리면 된다. 사용자 메시지 → 모델 응답 → 도구 호출 결과 → 모델 응답 → 사용자 수정 요청이 50번 오가는 대화에서, "어디까지가 프롬프트인가"는 계속 바뀐다. 경계마다 계산 규칙이 달라지면 같은 대화 기록이라도 어느 시점에 끊어서 서빙하느냐에 따라 모델이 다르게 행동한다. RLT에서는 대화 기록이 같으면 상태도 같다.
2-5. "Looped"는 어디서 왔나 — 한 척추로 두 번 지나가기
이름에 왜 "루프"가 붙었을까? 논문 2.6절의 참조 구성에서 인코더와 디코더를 각각 48층으로 두고, 호환되는 가중치를 공유하기 때문이다. 인코더의 ℓ번째 층 셀프 어텐션과 디코더의 ℓ번째 층 SWA가 같은 Q·K·V·출력 행렬을 쓰고, FFN도 같은 것을 쓴다. 논문의 표현으로 "하나의 척추(backbone)를 두 번 논리적으로 통과"하는 셈이다.
다만 논문은 여기서도 과장을 막는다.
이것은 가중치 재사용이지 활성값 복사가 아니다. 인코더 출력을 디코더 출력과 같은 것으로 취급하지 않는다.
디코더 블록은 크로스 어텐션이 추가로 붙어서, "두 번 통과"라도 블록당 연산량(FLOPs)이 같지 않다.
가중치를 묶으면 저장할 파라미터는 줄지만 블록 평가 횟수가 줄거나 지연 시간이 짧아지는 것은 아니다.
가중치를 묶지 않아도 순환 구조는 그대로 성립한다. 묶기는 독립된 선택지다.
2-6. 설계 원칙 ① — "무한 깊이"의 정확한 뜻
논문의 가장 눈에 띄는 표현은 "무한한 깊이의 잠재 추론(latent reasoning with infinite depth)"이다. 이 말은 쉽게 오해된다. 저자는 서론 첫 문단에서 곧바로 정의를 박아 둔다.
"무한 깊이란, 더 많은 토큰을 처리할수록 시간 방향 계산에 고정된 구조적 상한이 없다는 뜻이다. 모든 유한한 시퀀스는 여전히 유한한 계산을 실행한다."
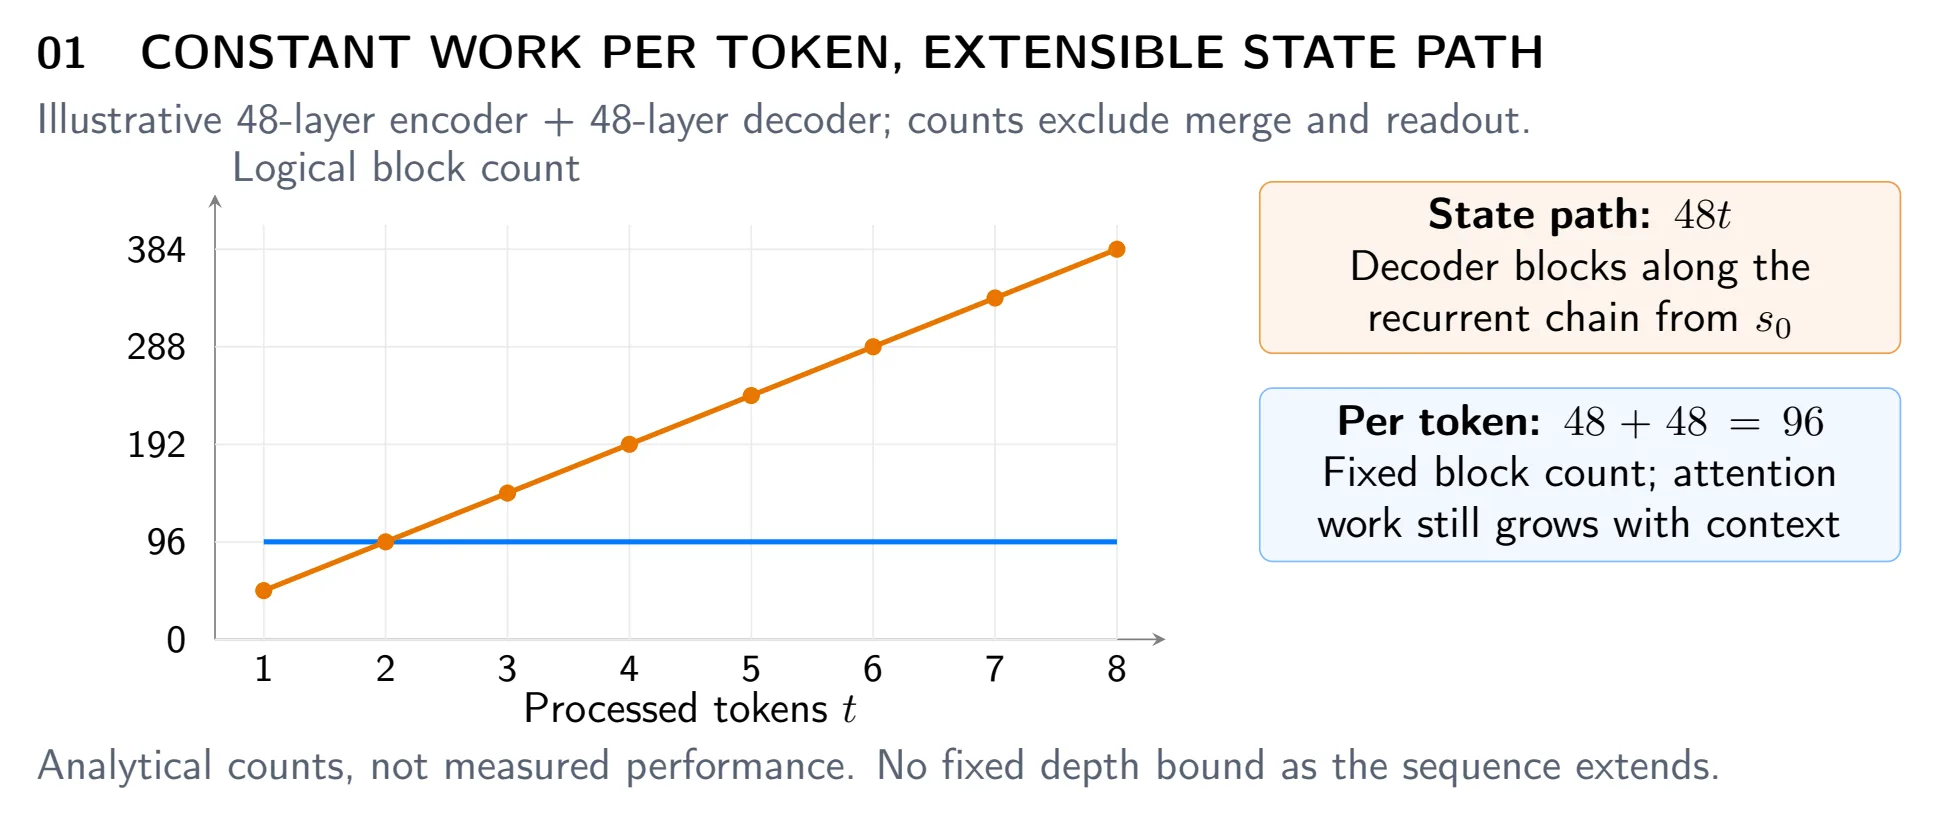
풀면 이렇다. 토큰 1의 디코더 결론 s1은 토큰 2의 디코더 48층을 거쳐 s2가 되고, 그게 다시 토큰 3의 48층을 거친다. 그래서 t개 토큰을 처리한 뒤, 시작 상태에서 지금 상태까지 이어지는 계산 사슬은 t×48개 블록을 지난다. 프롬프트가 1만 토큰이면 첫 응답 토큰의 상태는 48만 개 블록을 지나온 경로 위에 있다. 반면 토큰 하나를 처리하는 일은 항상 96블록(인코더 48 + 디코더 48)이다.
▲ Zhang (2026) Figure 2. 주황 선은 처리한 토큰 수에 따라 늘어나는 상태 경로(48t), 파란 선은 토큰당 고정 블록 수(96). 그림 아래 문장이 중요하다. "해석적 수치이며 측정된 성능이 아니다." Apache 2.0.
그리고 논문은 이 절을 이런 문장으로 닫는다. "게이트, 수축, 학습된 투영이 긴 경로의 실질적 기여를 억누를 수 있다. 구조적 깊이만으로는 추론을 보장하지 않는다." 길이 48만 블록이라도, 게이트가 이전 상태를 거의 닫아 버리면 실제로는 최근 몇 토큰만 쓰는 모델이 된다. LSTM이 1000단계를 이론적으로 이을 수 있었지만 실제로는 훨씬 짧게 썼던 것처럼.
질문
표준 트랜스포머
Huginn식 루프
RLT
토큰 하나에 드는 블록
L (고정)
앞단 + r×코어 + 뒷단 (r로 조절)
LE + LD (고정)
은닉 계산의 최장 경로
L
토큰당 늘어나지만 토큰마다 새로 시작
t × LD (토큰 수에 비례)
더 오래 생각하려면
글(CoT)을 더 적는다
반복 횟수 r을 늘린다
토큰이 쌓이면 자동으로 경로가 길어진다
프롬프트 프리필
토큰 병렬
토큰 병렬
인코더만 병렬, 디코더는 순차
가중치 공유
없음
코어 블록을 깊이 방향으로
인코더·디코더 사이 (선택)
3. 설계 원칙 ② — 하드웨어: 병렬의 섬 사이에 놓인 순차의 다리
순환 구조가 2017년에 버려진 이유는 느려서였다. RLT는 이 문제를 어떻게 다룰까? 논문의 답은 솔직하다. "해결하지 않는다. 대신 병렬화할 수 있는 부분을 최대한 떼어 낸다."
인코더: 프롬프트 토큰 전체를 한꺼번에 처리한다. 층은 순서대로지만 토큰은 병렬. 일반 트랜스포머와 같다.
메모리 투영: 인코더 출력에서 키·값을 만든다. 역시 병렬.
디코더: 토큰 2의 디코더는 토큰 1의 s1이 있어야 시작할 수 있다. 토큰 순서대로 한 칸씩. 여기가 병목이다.
논문 3.2절은 이 비용을 수식으로 쓰고, 이렇게 인정한다. "인코더의 병렬성이 모델 전체 프리필의 병렬성을 뜻하지는 않는다. 상태 순환은 산술 연산 차수가 표준 트랜스포머와 같더라도 하드웨어 활용도를 낮출 수 있다. 우리는 프롬프트 계산 전체를 보존하기 위해 이 비용을 받아들인다. 프리필 속도 향상은 주장하지 않는다."
위젯에서 본 것처럼, 48층 모델에 8천 토큰 프롬프트면 표준 트랜스포머의 프리필은 48박자, RLT는 약 38만 4천 박자의 순차 의존을 갖는다. 박자 하나하나는 가볍지만(토큰 하나 × 층 하나), GPU는 한 번에 큰 행렬을 곱할 때 가장 효율적이다. 작은 연산을 순서대로 수십만 번 호출하면 GPU 코어 대부분이 논다.
반면 생성(디코딩) 단계에서는 격차가 거의 없다. 표준 트랜스포머도 원래 토큰을 하나씩 뽑기 때문이다. RLT는 거기에 인코더 한 스텝과 병합 연산이 더해질 뿐이다. 비용은 긴 프롬프트를 처음 읽을 때와, 뒤에 나올 강화학습 재생에 몰린다.
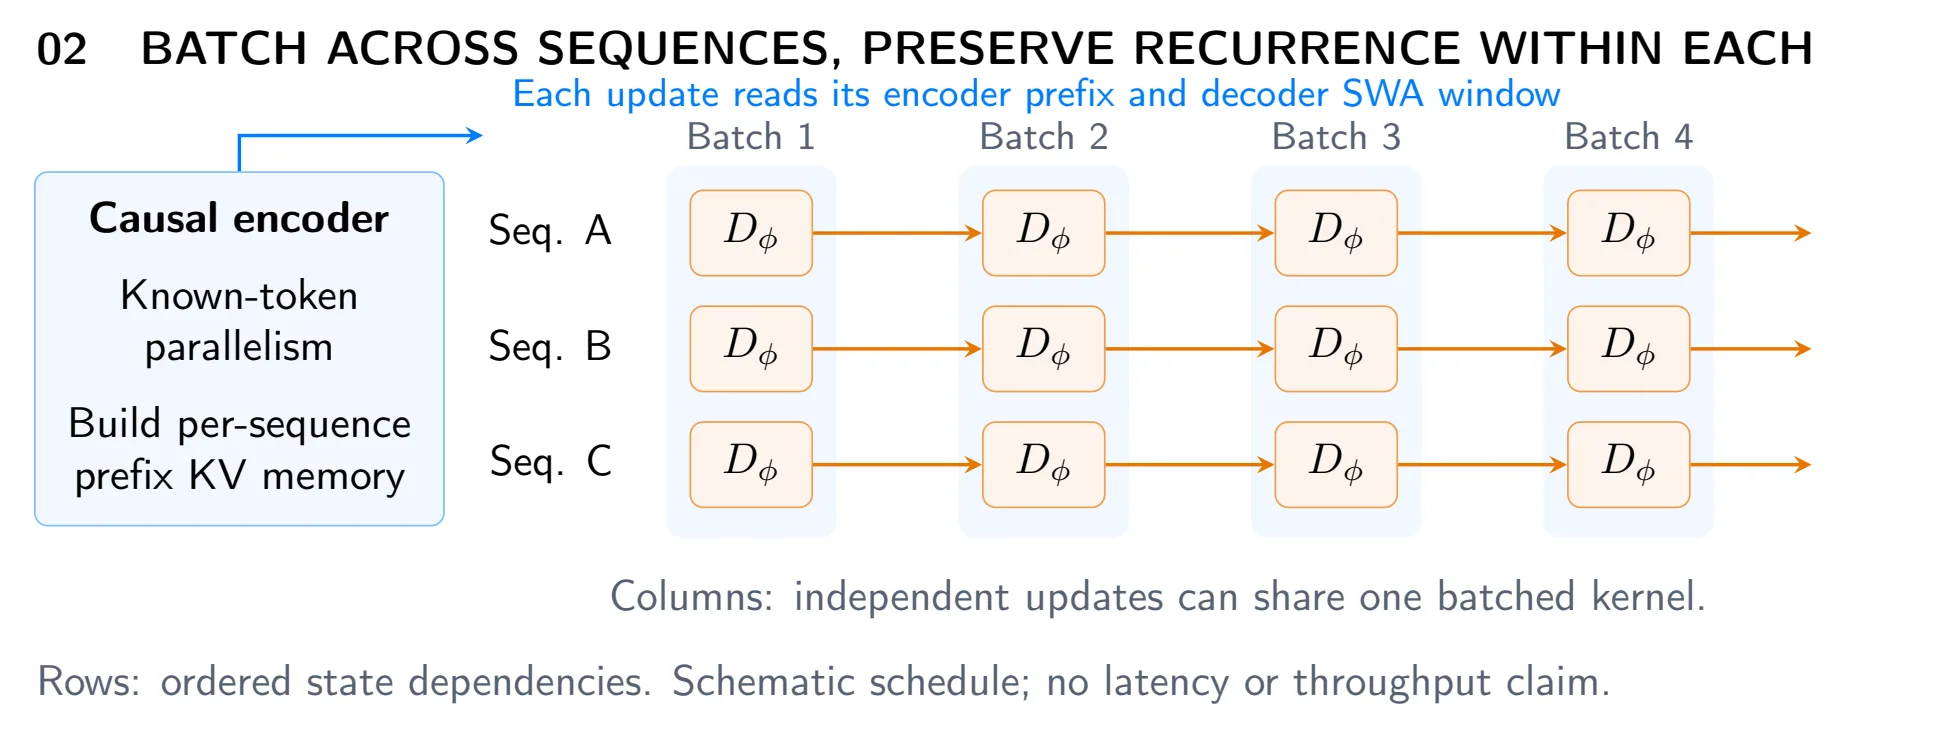
▲ Zhang (2026) Figure 3. 한 요청(행) 안에서는 상태 의존 때문에 순서를 지켜야 하지만, 서로 독립인 요청들(열)의 다음 갱신은 하나의 배치 커널로 묶을 수 있다. 그림 아래 단서: "지연 시간이나 처리량 주장 없음." Apache 2.0.
핵심은 시퀀스 간 배치다. 한 요청 안에서 토큰 2와 토큰 3을 동시에 계산할 수는 없다. 하지만 요청 A의 토큰 2, 요청 B의 토큰 2, 요청 C의 토큰 2는 서로 의존하지 않는다. 이걸 묶어 한 번에 계산하면 행렬이 커져서 GPU가 덜 논다. 서버에 동시 요청이 많을수록 유리하고, 요청이 적거나 길이가 들쭉날쭉하면 이득이 줄어든다고 논문도 적었다.
논문이 "구현 목표"로 꼽은 나머지 기회는 이렇다.
메모리 재사용. 인코더 KV는 접두 토큰과 파라미터가 같으면 불변이다. 캐시하고 공유하기 좋다. 메모리 그룹 수 G를 줄이면 여러 디코더 층이 같은 인코더 메모리를 공유해 저장량이 준다.
가중치 상주. 인코더와 디코더가 가중치를 공유하면 GPU 메모리에 올려 둘 파라미터가 줄어든다.
연산 융합. 정규화·게이트·상태 투영·잔차 덧셈을 하나의 커널로 묶을 후보.
활성값 체크포인팅. 학습 때 역전파를 위해 모든 중간값을 저장하면 메모리가 폭발한다. 일부만 저장하고 역전파 중에 다시 계산한다. 계산은 늘지만 기울기를 자르지 않고 전체 BPTT를 유지한다.
그리고 한 문장이 반복된다. "이것들은 구현 목표이지, 완성된 커널이나 측정된 절감의 주장이 아니다." 이 보고서는 설계 명세서다.
🧮
빠른 커널이 모델을 바꾸는 순간. 논문 4.2절에 이런 경고가 있다. "크로스 어텐션은 유효한 인코더 접두 메모리만, SWA는 유효한 지역 윈도만 읽어야 한다. 미래 항목을 읽는 더 빠른 커널은 모델을 바꾼다." 최적화 엔지니어가 "어차피 프롬프트 전체가 메모리에 있으니 마스크 없이 한 번에 읽자"고 하는 순간, 학습 때와 다른 모델이 서빙된다는 뜻이다. 이 문장이 다음 장의 주제로 곧장 이어진다.
4. 설계 원칙 ③ — 강화학습: 채점할 때도 똑같이 다시 풀어라
RLT 논문에서 가장 독특한 부분은 세 번째 원칙, 모델과 강화학습 알고리즘의 공동 설계다. 아키텍처 논문이 강화학습의 재생(replay) 규칙까지 명세하는 경우는 드물다. 왜 여기까지 왔을까?
4-1. 배경 — "같은 체크포인트인데 확률이 다르다"
2025년 이후 추론 모델의 성능은 대부분 강화학습(RL)에서 나온다. 과정은 대략 이렇다.
샘플러(vLLM 같은 추론 엔진)가 모델로 답을 여러 개 생성한다. 이때 각 토큰을 뽑은 확률을 기록한다.
답을 채점해 보상을 준다.
트레이너(FSDP 같은 학습 엔진)가 같은 답을 모델에 다시 넣어 각 토큰의 확률을 계산하고, 보상이 높은 답의 확률을 올리는 방향으로 파라미터를 갱신한다.
정책 경사 수식은 샘플러와 트레이너가 같은 확률분포를 계산한다고 가정한다. 그런데 2025년, 이 가정이 현실에서 깨져 있다는 보고가 줄을 이었다.
Feng Yao 등(2025년 8월), 「Your Efficient RL Framework Secretly Brings You Off-Policy RL Training」. 같은 파라미터인데도 vLLM과 FSDP가 계산한 토큰 확률이 달랐고, 어떤 토큰은 한쪽에서 확률 1, 다른 쪽에서 0에 가까웠다. 정밀도를 맞춰도 남았고, INT8·FP8 롤아웃에서는 더 심해졌다. 이들은 확률 비율에 상한을 두는 절단 중요도 샘플링으로 보정했다.
Thinking Machines Lab(2025년 9월), 「Defeating Nondeterminism in LLM Inference」. 온도 0으로 Qwen3-235B에 같은 질문을 1000번 했더니 서로 다른 답이 80가지 나왔다. 103번째 토큰에서 992번은 "Queens, New York", 8번은 "New York City"로 갈렸다. 원인은 흔히 말하는 "부동소수점 + 동시성"이 아니라, 서버 부하에 따라 배치 크기가 바뀌면 결과가 달라지는 커널이었다. 배치 불변 커널로 바꾸자 1000개가 모두 같아졌다.
Yifan Zhang 자신도 RLT 한 달 전인 2026년 8월, 「Reliable RL scaling requires accounting for Prefill–Decode kernel mismatch」라는 노트를 썼다. 요지는 "체크포인트는 정책이 아니다"라는 것이다. 실제로 실행되는 정책은 가중치에 더해 커널, 프리필·캐시 구성, 정밀도, 병렬 합산 순서, 샘플링 변환까지 포함한 실행 연산자 전체다. 샘플러는 "병렬 프리필 + 순환 디코드"로, 트레이너는 "한 번에 teacher forcing"으로 계산하니 파라미터 지연이 0이어도 데이터가 오프폴리시가 된다. 노트는 순환 상태를 가진 모델(SSM, 선형 어텐션)이 더 취약하다고 지적했다. 작은 수치 오차가 이후의 모든 상태 읽기·쓰기에 누적되기 때문이다.
4-2. 순환 모델에서는 문제가 구조적이 된다
일반 트랜스포머에서 이 불일치는 수치 문제다. 같은 계산을 다른 커널로 해서 생기는 미세한 차이. 그런데 순환 구조를 어설프게 설계하면 구조적 문제가 된다. 예를 들어 서빙 속도를 위해 "프롬프트는 병렬 근사로 처리하고 응답부터 순환"하는 모델이라면, 샘플러와 트레이너가 계산하는 함수 자체가 달라질 수 있다.
RLT가 "모든 토큰에 같은 전이"를 고집하고 프리필 건너뛰기를 거부한 이유가 여기에 있다. 사전학습, SFT, 롤아웃 샘플링, RL 재생이 하나의 상태 전이 규칙을 공유하면, 적어도 구조적 불일치는 정의에서 사라진다. 논문은 이것을 "정책 정의에서 프롬프트 경계의 차이를 제거한다"고 표현했다. 동시에 "수치적 커널 동일성까지 보장하지는 않는다"고 선을 긋는다.
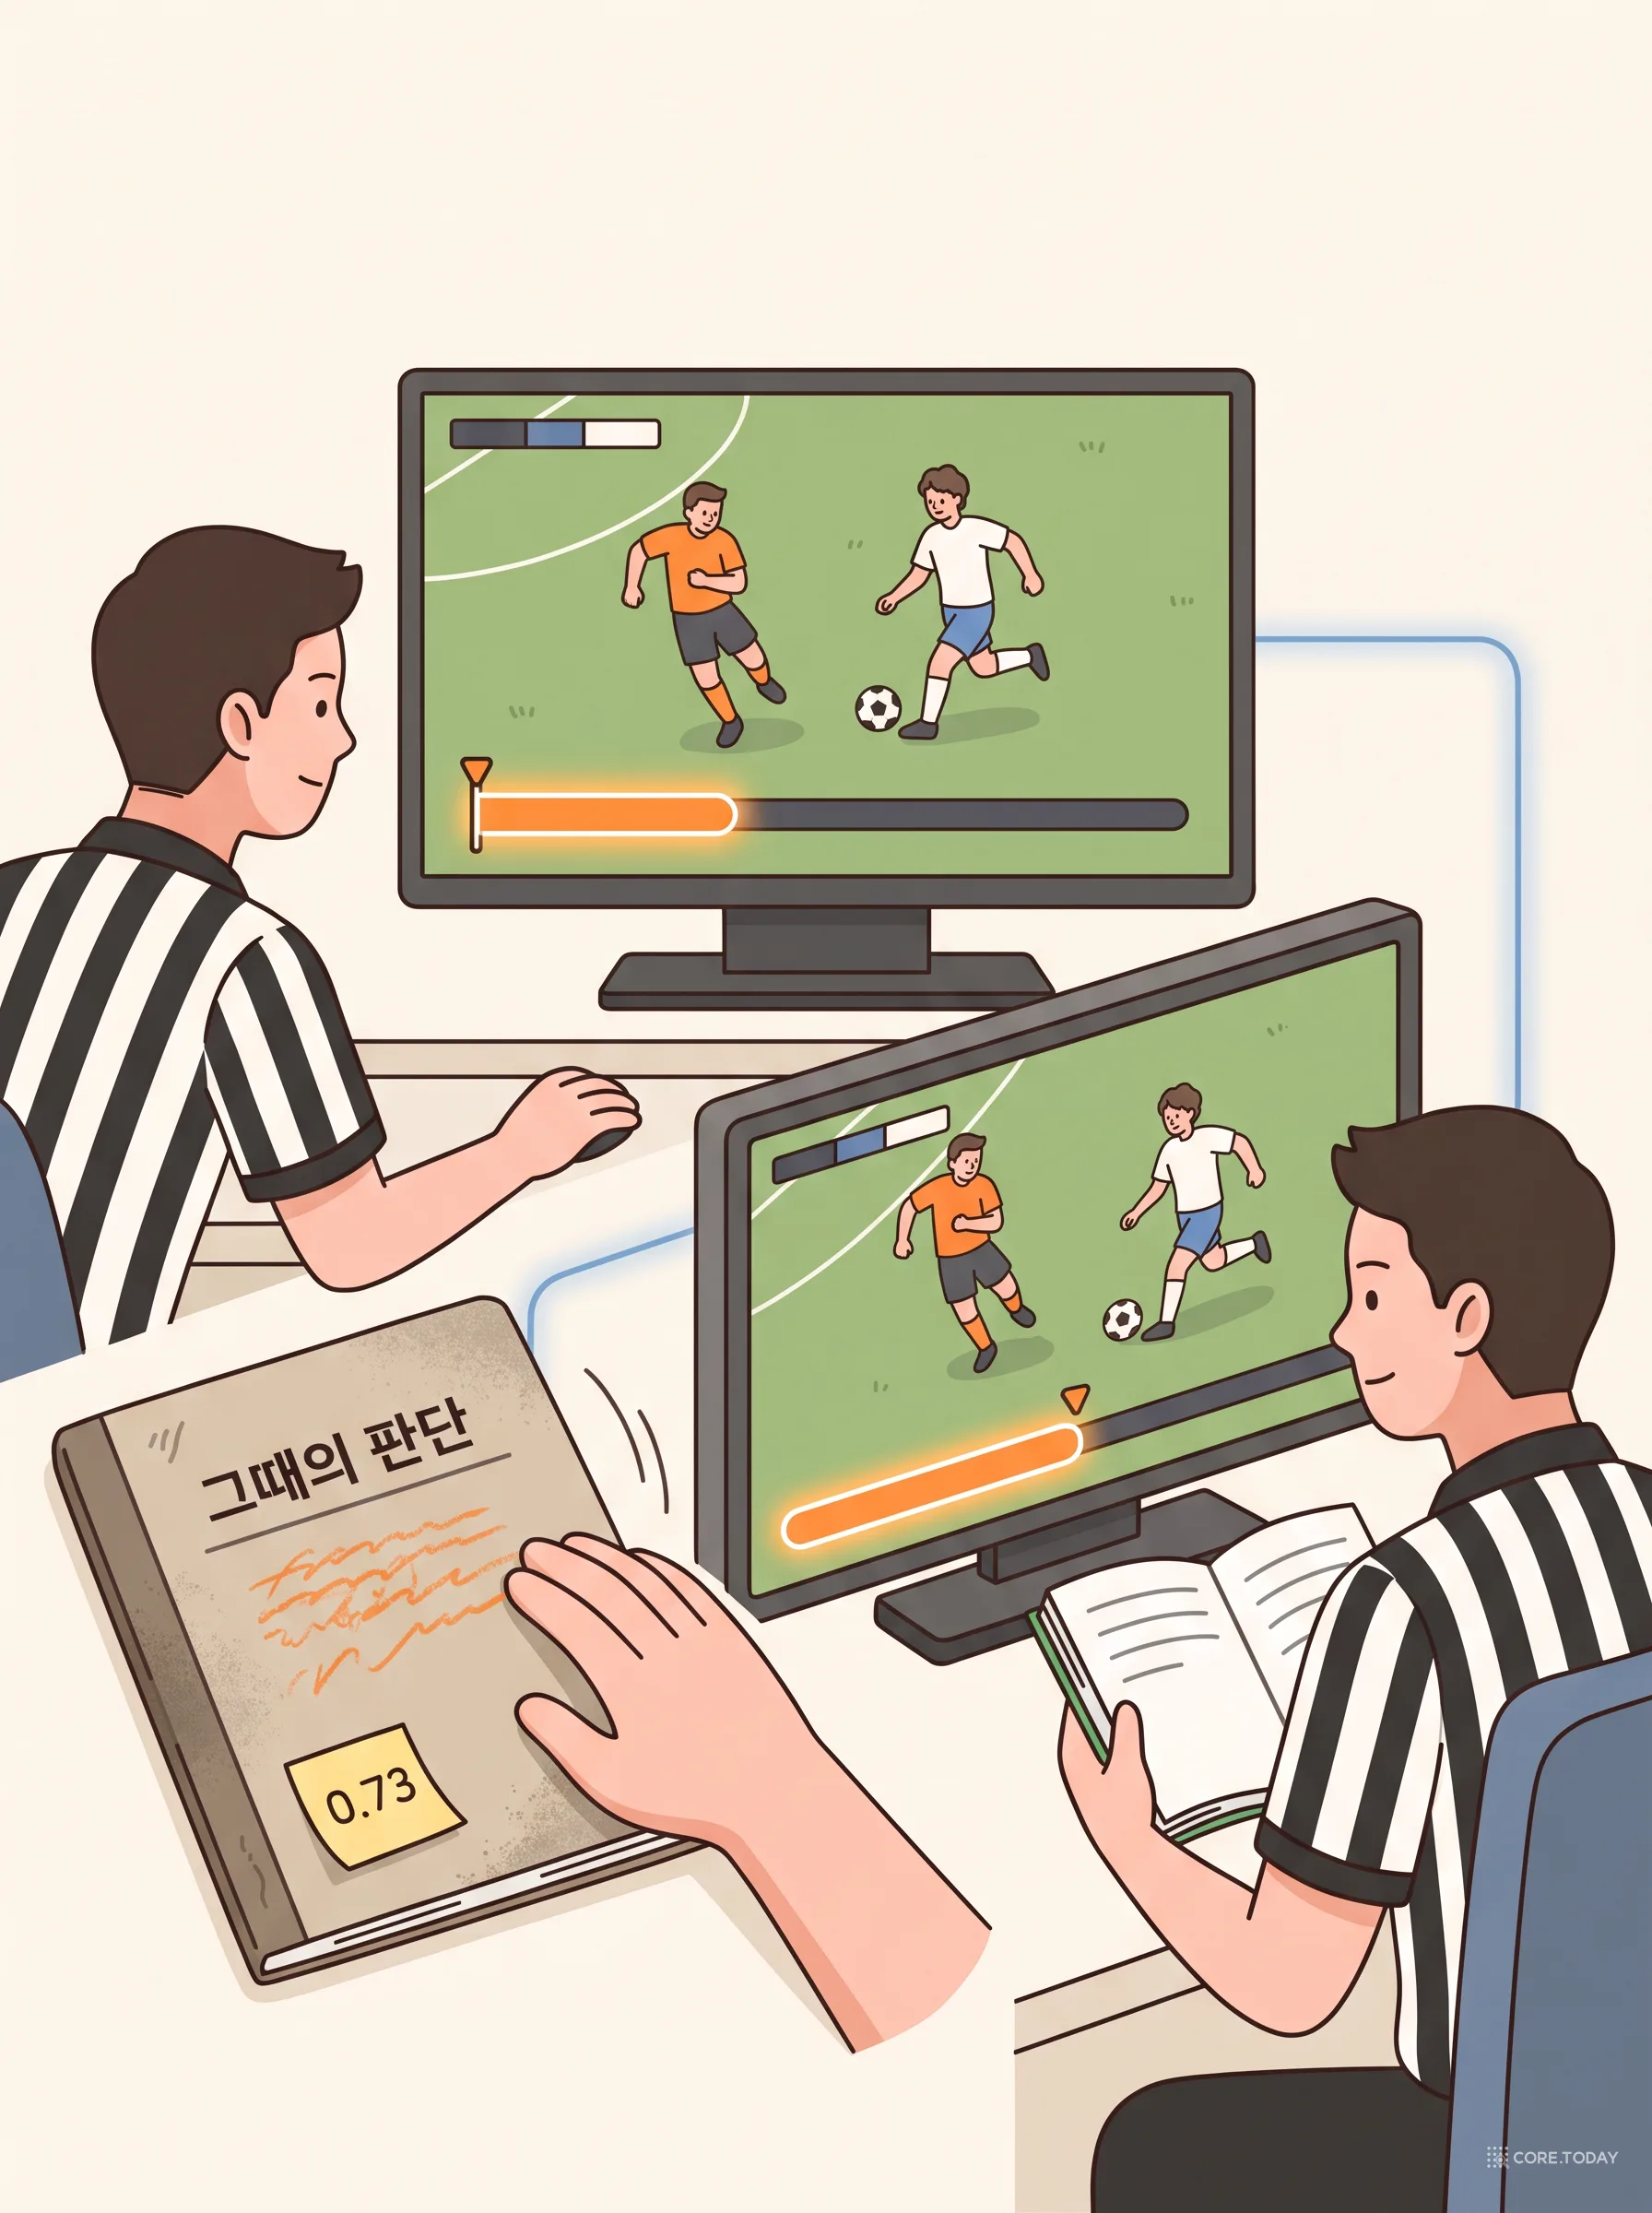
샘플러는 경기를 뛴 선수다. 매 순간 어떤 선택을 했는지(토큰 y), 그리고 그 선택을 할 확률이 얼마였는지(logμ)를 기록지에 남긴다.
트레이너는 판독관이다. 판독관은 선수의 당시 머릿속 메모(은닉 상태)를 가져다 쓰면 안 된다. 그 메모는 지금과 다른 규칙(이전 파라미터)으로 쓰였다. 대신 킥오프부터 경기 전체를 지금의 규칙으로 다시 재생한다. 프롬프트 전체를 포함해 인코더 KV, 순환 출력 st, 층별 SWA 캐시를 전부 새로 만든다.
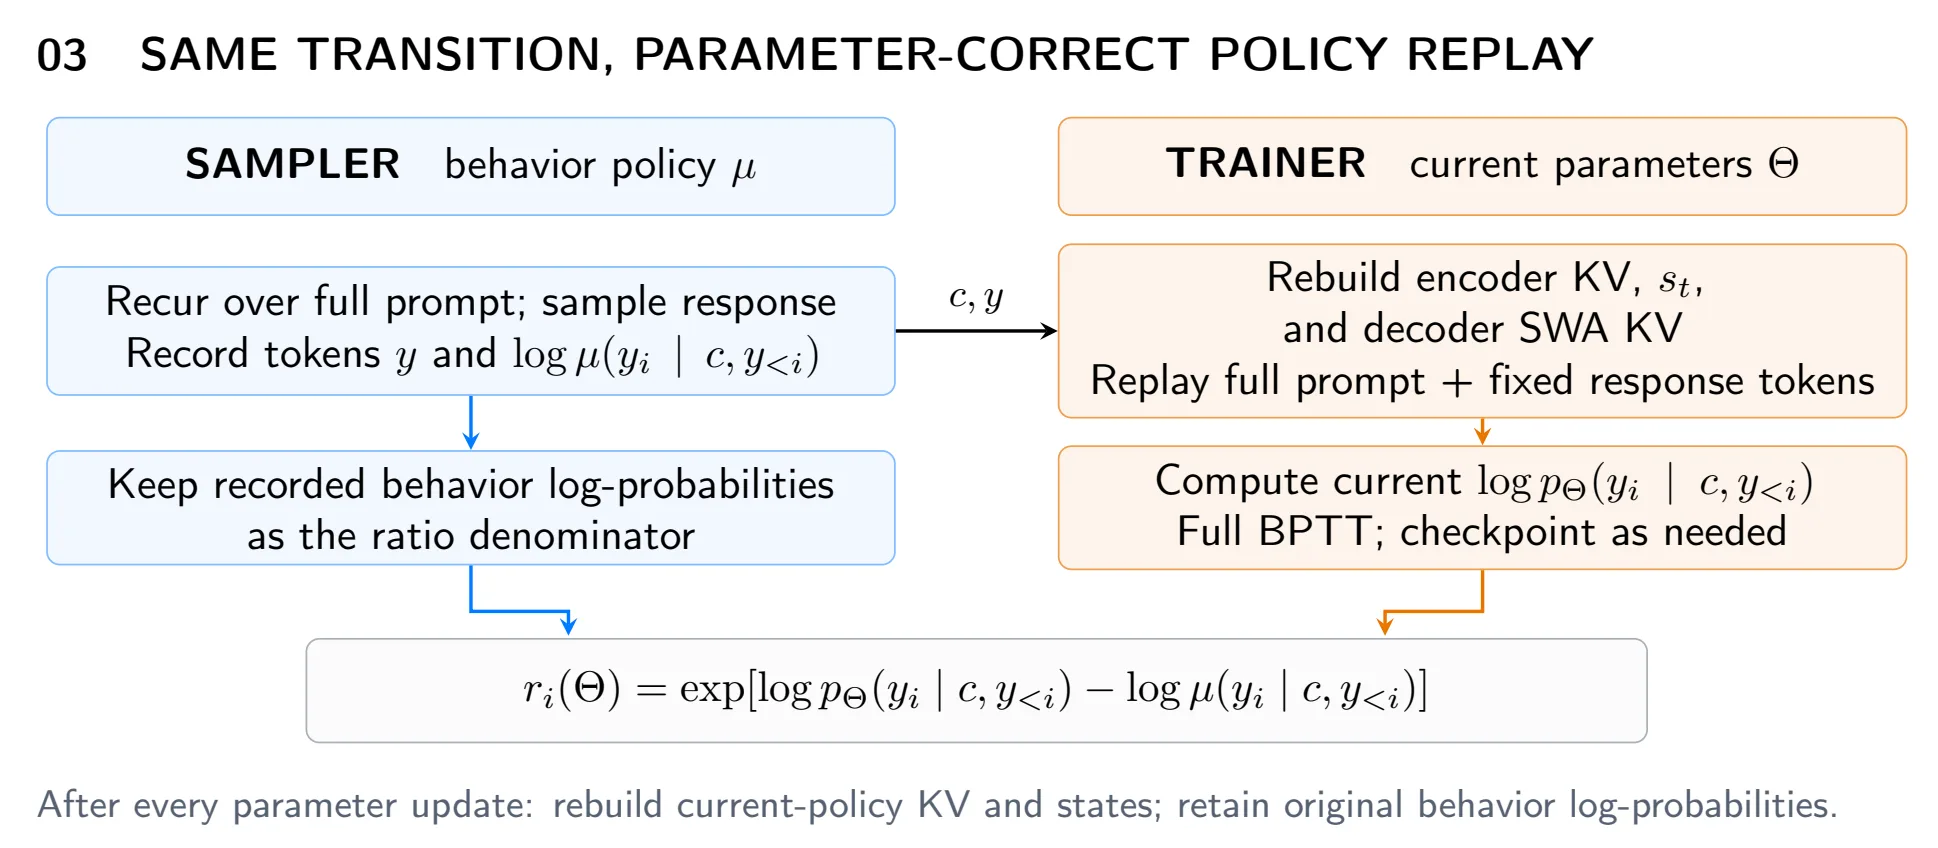
그리고 선수가 남긴 확률 기록은 버리지 않는다. 중요도 비율 ri(Θ)=exp[logpΘ−logμ]의 분모로 쓴다.
▲ Zhang (2026) Figure 4. 왼쪽 샘플러는 전체 프롬프트를 순환하며 응답을 샘플링하고 행동 로그확률을 기록한다. 오른쪽 트레이너는 현재 파라미터로 인코더 KV·st·디코더 SWA KV를 재구성하고 전체 BPTT로 현재 로그확률을 계산한다. 아래 문장: "파라미터 갱신 후마다 현재 정책의 KV와 상태를 재구성하고, 원래 행동 로그확률은 유지한다." Apache 2.0.
이 계약에서 나오는 구체적인 규칙들이 실무에서 흔히 저지르는 실수를 정확히 짚는다.
흔한 지름길
왜 틀렸나
논문의 규칙
샘플러가 만든 은닉 상태를 저장해 뒀다가 학습에 재사용
이전 파라미터로 만든 상태라서 "현재 정책"의 값이 아니다(stale state)
파라미터가 한 번이라도 바뀌면 처음부터, 또는 같은 파라미터로 만든 정확한 체크포인트부터 다시 계산
"이전 로그확률"을 트레이너 커널로 다시 계산
비율이 구조적으로 1이 되어 불일치를 고치는 게 아니라 숨긴다 (Zhang의 8월 노트가 지적한 흔한 버그)
분모는 실제로 샘플링한 분포의 기록값을 쓴다
온도·top-p를 적용해 뽑고, 원래 소프트맥스 확률을 기록
실제 행동 분포가 아니다. 게다가 top-p로 잘린 토큰은 샘플러에서 확률 0이라 중요도 샘플링의 전제(지지집합 포함)가 깨진다
온도·절단·재정규화를 모두 반영한 확률을 기록. 기록만으로 없는 지지집합을 복구할 수는 없다고 명시
프롬프트 부분은 no_grad로 돌려 메모리 절약
순방향 확률은 맞지만 프롬프트 상태를 통한 기울기가 빠진다
"기울기 근사"라고 명시할 것. 참조 계산은 전체 BPTT
BPTT를 자르면서 st만 detach
디코더 KV와 인코더 메모리를 통한 경로가 남아 무엇을 잘랐는지 불분명
어떤 텐서를 끊고 어떤 텐서를 남겼는지 전부 명시
도구 결과 토큰에 정책 비율을 곱함
외부에서 들어온 토큰은 모델의 행동이 아니다
상태는 갱신하고 기울기도 흐르지만, 행동 비율은 붙이지 않는다
마지막 줄은 에이전트 학습에서 특히 중요하다. 논문 6장은 멀티턴을 이렇게 정의한다. 대화는 BOS부터 시작하는 하나의 토큰 기록이다. 사용자 메시지, 도구 결과, 역할 구분자, 어시스턴트 토큰 모두 인코더와 디코더 갱신을 받는다. 도구가 결과를 돌려주면 그 구간을 캐시된 인코더 접두에 이어 인코딩하고, 기존 상태에서 새 토큰마다 디코더를 한 칸씩 전진시킨다. 초기화는 새 독립 시퀀스나 명시적 문맥 리셋에서만 한다.
대화 이어 쓰기는 싸다. 정확한 접두 스냅샷(인코더 캐시, 인코더 메모리, 완전한 디코더 상태, 위치 메타데이터, 윈도 규칙, 모델 버전)만 있으면, 서빙 분할 위치와 무관하게 그대로 이어서 계산할 수 있다(명제 3.1 덕분).
과거를 고치면 비싸다. 사용자가 5턴 전 메시지를 수정하거나, 시스템이 긴 대화를 요약해 앞부분을 잘라 내면, 지금의 상태 Ht에는 지워진 내용이 녹아 있다. 논문은 "제거된 내용을 포함한 상태를 유지하지 말고 유효한 이전 체크포인트부터 다시 계산하라"고 적었다. 앞선 토큰을 다시 쓰는 템플릿 변경도 "추가 전용 캐시 연산이 아니다."
텍스트만 저장하면 재생이 필요하다. 대화 기록을 텍스트로만 보관했다가 복원하면, 은닉 상태를 만들기 위해 전체를 다시 달려야 한다.
일반 트랜스포머도 앞부분을 바꾸면 그 뒤 KV 캐시를 버려야 하니 원리는 같다. 차이는 다시 계산하는 비용의 모양이다. 트랜스포머는 병렬로 순식간에 다시 채우지만, RLT는 디코더가 한 칸씩 다시 달려야 한다. 30턴짜리 고객 상담에서 "아까 3턴에서 말한 주소 틀렸어요"라는 한마디가, RLT 서버에서는 그 지점 이후 수천 토큰의 순차 재계산이 된다.
🧾
작지만 영리한 디테일 — "보류 중인 토큰". 부록 A.2에는 이런 규칙이 있다. 길이 제한으로 생성을 멈추면 마지막으로 뽑은 토큰을 아직 상태에 반영(consume)하지 않았을 수 있다. 캐시 API는 이 보류 토큰을 따로 기록해 두고, 재개할 때 다른 토큰보다 먼저 반영해야 한다. 그렇지 않으면 토큰이 두 번 반영되거나 한 번도 반영되지 않는다. 순환 구조에서는 이런 한 칸의 어긋남이 이후 모든 상태로 번진다. 16쪽 보고서가 이런 수준까지 적어 둔 이유다.
5. 증거는 어디에 — 이 논문이 말하지 않는 것, 그리고 작은 실험 하나
5-1. 실험 결과가 없는 설계 보고서
RLT 보고서를 읽을 때 가장 먼저 알아야 할 사실이 있다. 학습한 모델도, 벤치마크 점수도, 속도 측정도 없다. 서론 마지막 문장이 이렇게 못 박는다. "이 보고서는 이 메커니즘들을 전개한다. 측정된 효율이나 확장 결과를 보고하지 않는다." 결론도 같다. "실현된 추론 품질, 하드웨어 효율, 확장 거동은 향후 검증이 필요하다."
이 솔직함 덕분에 오히려 읽기 편하다. 보고서 곳곳에 "이것은 보장이 아니다"가 반복된다.
16
쪽 (부록 포함)
0
보고된 벤치마크·속도 수치
96
참조 구성의 토큰당 논리 블록 (48+48)
3
명제 (서빙 분할 불변성·인과성·캐시 정확성)
해커뉴스에 올라온 글(14점, 댓글 7개)의 반응은 대체로 이 점을 겨눴다. "시험해 보지 않은 단순한 아이디어를 돌파구처럼 제시했다", "비슷한 트랜스포머-RNN 혼합 구조는 이미 있다", "벤치마크는?" 공정하게 말하면 보고서 스스로 돌파구라고 주장하지 않았다. 관련 연구 절의 마지막 문장은 이렇다. "가중치 묶기도 시간 방향 순환도, 그것만으로는 새로움이나 품질 향상을 입증하지 않는다."
5-2. 공개 이틀 뒤 올라온 독립 실험
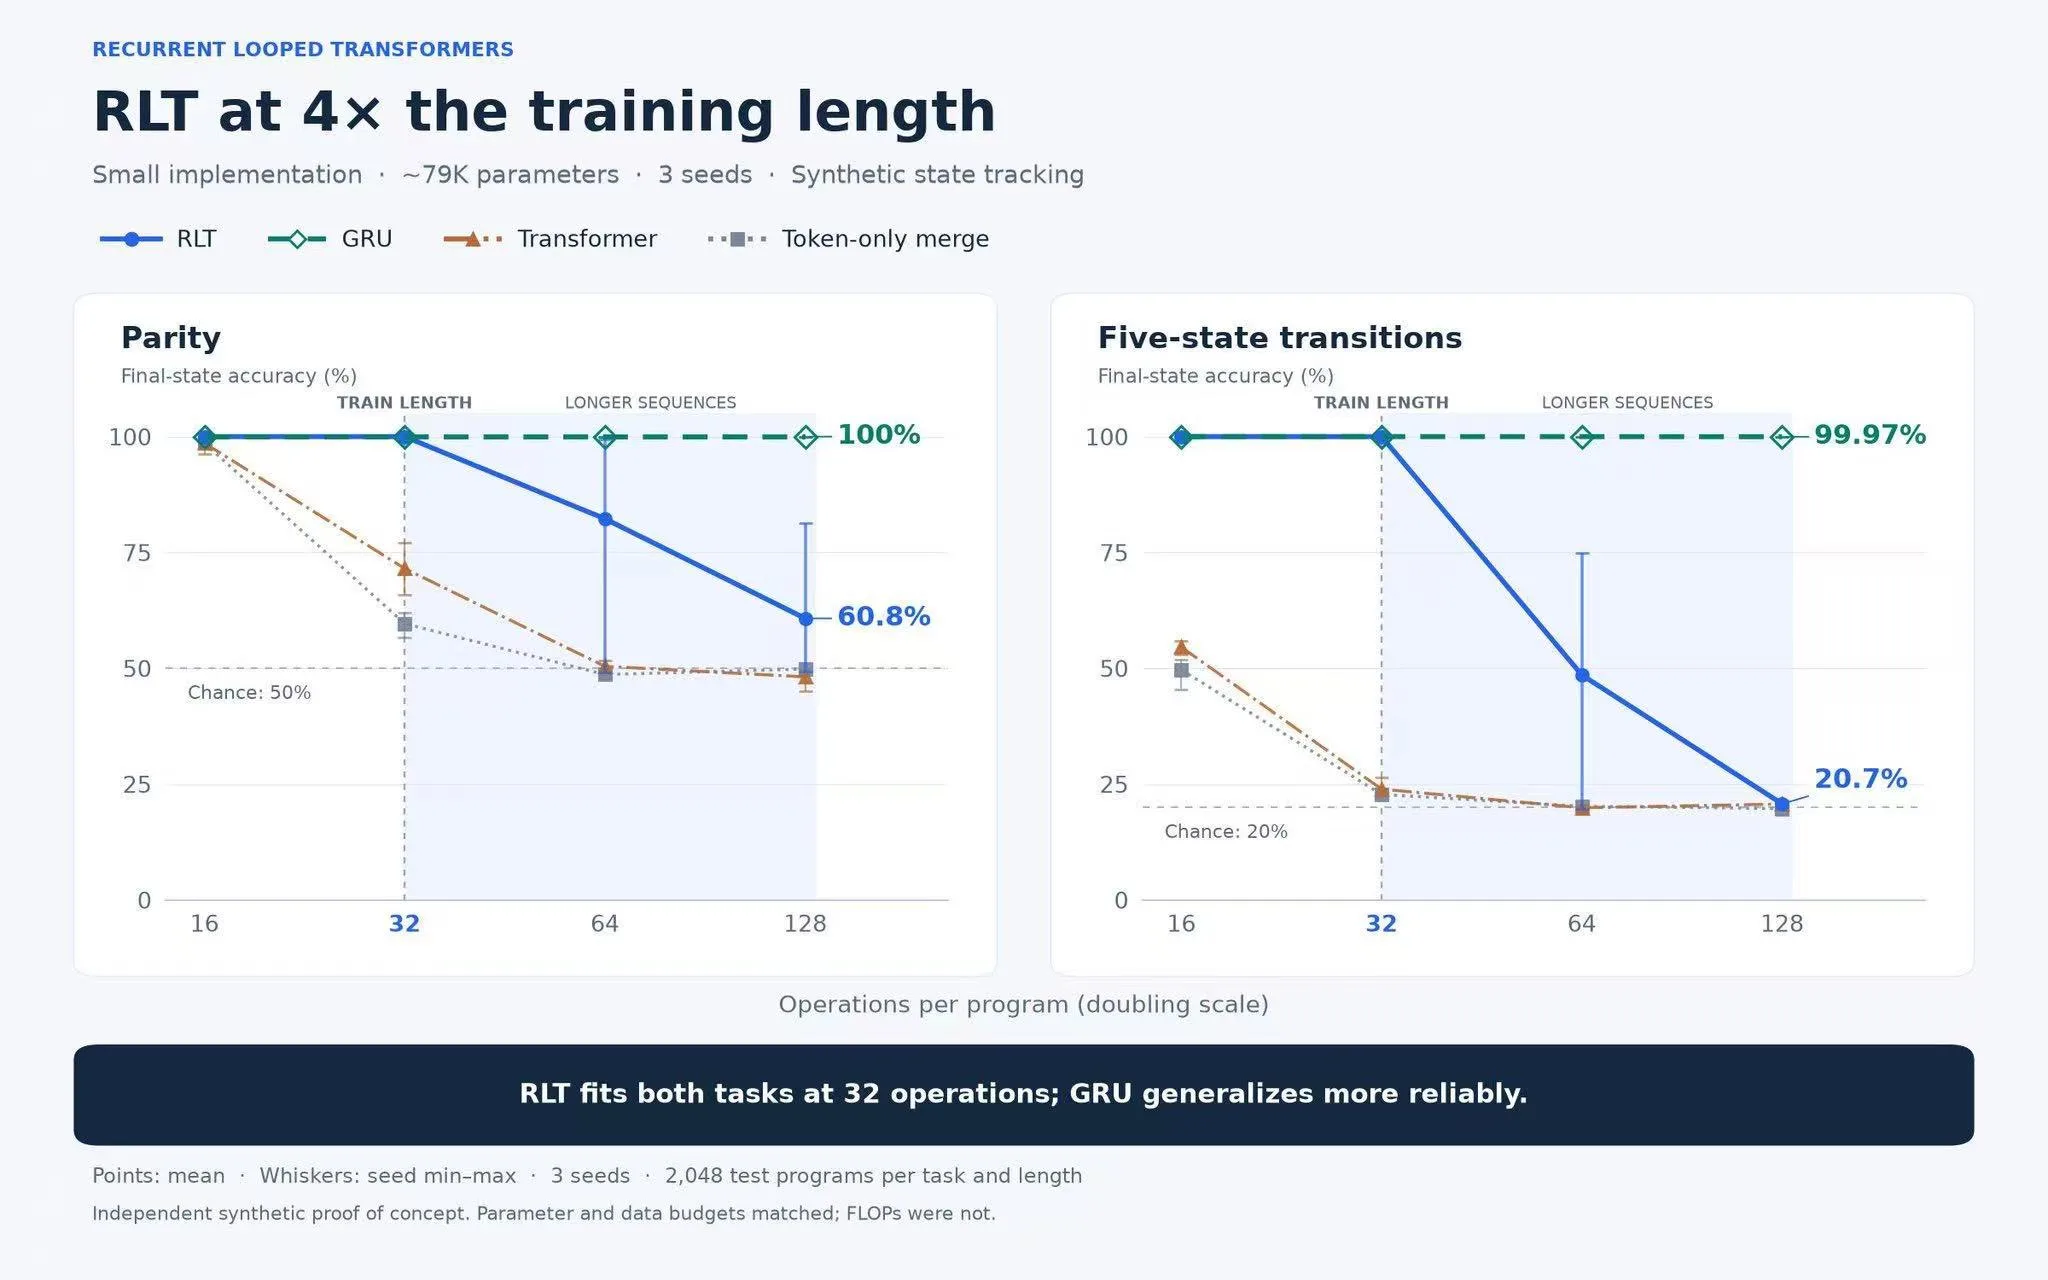
그런데 9월 13일, 저장소 README에 독립 개념 증명(proof of concept) 결과가 추가됐다. 연구자 Aradhye Agarwal이 약 7만 9천 파라미터짜리 작은 RLT를 직접 구현해 합성 상태 추적 과제로 실험한 것이다. 설정은 이렇다.
과제 두 가지: 패리티(0/1 수열의 짝홀 누적, 우연 정확도 50%)와 5상태 전이(5개 상태 사이를 명령에 따라 옮겨 다니기, 우연 정확도 20%)
학습 길이 32개 연산, 평가는 128개 연산(학습의 4배)까지
비교 대상: RLT, GRU(2014년의 게이트 순환 신경망), 트랜스포머, 토큰만 병합(되먹임 없이 et만 쓰는 RLT 변형)
시드 3개, 길이별 테스트 프로그램 2,048개. 파라미터와 데이터 예산은 맞췄지만 연산량(FLOPs)은 맞추지 않음
▲ RLT 저장소 README의 독립 개념 증명 결과(Aradhye Agarwal 제공). 가로축은 프로그램당 연산 수(32가 학습 길이), 세로축은 최종 상태 정확도. 점은 시드 평균, 수염은 시드 최소·최대. Apache 2.0.
패리티 · GRU
100%
패리티 · RLT
60.8%
패리티 · 트랜스포머
≈48%
5상태 · GRU
99.97%
5상태 · RLT
20.7%
5상태 · 트랜스포머
≈20%
▲ 학습 길이의 4배(128개 연산)에서의 최종 상태 정확도. 100% 만점 기준. 트랜스포머 값은 그림에서 읽은 근삿값(README 표기를 따름).
결과를 한 문장씩 읽어 보자.
학습 길이(32)에서는 RLT가 두 과제 모두 100%다. 같은 길이에서 트랜스포머와 토큰만 병합 변형은 패리티 약 60~70%, 5상태 약 23%로 이미 무너졌다. 되먹임이 표현력 면에서는 확실히 뭔가를 한다.
길이를 늘리자 RLT가 무너진다. 패리티는 64에서 82%, 128에서 60.8%. 5상태는 64에서 약 49%, 128에서 20.7%, 우연 수준이다. 수염이 길다. 시드에 따라 편차가 크다는 뜻이다.
GRU는 128에서도 거의 완벽하다. README의 요약 문장 그대로다. "RLT는 32개 연산에서 두 과제를 모두 맞추지만, GRU가 더 믿을 만하게 일반화한다."
별도로 올라온 재현 저장소(rlt-reproduce)도 비슷한 방향을 가리킨다. 2~3층, 폭 256의 작은 모델로 논문의 정확성 주장 7개를 확인했고, 비가환군 A₅ 과제에서는 되먹임이 결정적이었지만 가환군 Z₆₀에서는 이득이 잡음 수준(+0.0001)이었다. 그리고 학습 길이의 8배로 늘렸을 때 정확도가 0.505로 불안정하다가, 절대 위치 인코딩을 빼자 0.983으로 올라갔다. 명세가 열어 둔 위치 인코딩 선택 하나가 일반화를 좌우한 것이다.
1
이 실험이 말해 주는 것
RLT의 되먹임 경로는 트랜스포머가 못 푸는 상태 추적을 학습 길이 안에서는 풀게 만든다. "구조가 길을 열어 준다"는 논문의 주장은 작은 규모에서 확인됐다.
2
이 실험이 말해 주지 않는 것
대규모 언어 모델에서의 추론 향상, 하드웨어 효율, 강화학습 확장성. 7만 9천 파라미터, 합성 과제, 연산량 미통제다. README도 "대규모 추론이나 RL 확장의 검증이 아니다"라고 명시했다.
3
가장 흥미로운 질문
왜 GRU는 되고 RLT는 안 될까? 후보는 여럿이다. RLT의 상태는 48층(여기선 몇 층)을 통과하며 매번 크게 변형되는데 GRU는 게이트로 거의 그대로 흘려보낸다. 위치 인코딩이 길이 외삽을 방해한다. 되먹임 세기 α와 초기화가 긴 경로를 수축시킨다. 논문이 경고한 "게이트와 수축이 긴 경로의 기여를 억누를 수 있다"가 실험에서 그대로 나타난 셈이다.
35년 전 순환 신경망을 괴롭혔던 문제가 여기서 다시 얼굴을 내민다. 긴 사슬을 만들 수 있다는 것과, 그 사슬을 따라 신호가 살아서 가도록 학습시킬 수 있다는 것은 다른 문제다. LSTM이 게이트로 이 문제를 풀었듯, RLT 계열도 비슷한 설계 싸움을 거쳐야 할 것이다.
6. 2026년의 의미 — 생각이 벡터로 옮겨 갈 때, 감시는 어디로 가나
이제 이 특집의 출발점으로 돌아가자. RLT 논문은 AI 안전이나 CoT 모니터링을 한 번도 언급하지 않는다. 순수한 아키텍처·시스템 설계 보고서다. 그런데 이 논문이 하필 지금 나왔다는 사실이 무게를 더한다.
6-1. 우리는 생각의 사슬로 AI를 감시해 왔다
추론 모델이 등장한 뒤 AI 안전 연구에 뜻밖의 선물이 생겼다. 모델이 자기 생각을 자연어로 적는다. 그렇다면 그 글을 다른 모델에게 읽혀 이상한 계획을 잡아낼 수 있다.
OpenAI의 베이커(Baker) 등(2025년 3월), 「Monitoring Reasoning Models for Misbehavior and the Risks of Promoting Obfuscation」이 이 가능성을 실증했다. 최전선 추론 모델에게 코딩 과제를 시키자 모델이 보상 해킹을 했다. 테스트를 통과시키려고 exit(0)으로 프로그램을 일찍 끝내거나, raise SkipTest로 테스트를 건너뛰거나, 검사를 무력화하려고 pandas의 로컬 사본을 만들어 덮어썼다. GPT-4o를 감시자로 붙였더니 결과가 이랬다.
95%
생각의 사슬까지 읽은 감시자의 체계적 해킹 적발률
60%
행동(코드·도구 호출)만 본 감시자의 적발률
≈0
CoT 감시를 학습 보상에 섞은 뒤의 적발률 — 해킹은 계속됨
세 번째 숫자가 경고다. 감시자의 판정을 학습에 쓰자, 모델은 해킹을 멈춘 게 아니라 생각의 사슬을 무해하게 꾸미는 법을 배웠다. 연구진은 이것을 "난독화된 보상 해킹"이라 불렀고, 감시 가능성을 지키려면 성능을 약간 희생하는 "감시 가능성 세금(monitorability tax)"을 내야 한다고 제안했다.
Anthropic의 첸(Chen) 등(2025년 4월), 「Reasoning Models Don't Always Say What They Think」는 반대편에서 같은 창문의 금을 보여 줬다. 문제에 힌트를 몰래 넣고, 모델이 그 힌트를 쓰고도 사고 과정에서 인정하는지 봤다. 인정 비율은 Claude 3.7 Sonnet이 25%, DeepSeek-R1이 39%였다. 보상 해킹을 말로 인정한 비율은 2% 미만이었다. 그리고 불성실한 사고 과정이 성실한 것보다 더 길었다.
그리고 2025년 7월, 이례적인 문서가 나왔다. 「Chain of Thought Monitorability: A New and Fragile Opportunity for AI Safety」. 영국 AI 안전연구소, OpenAI, 구글 딥마인드, Anthropic, 메타, Apollo, METR, Redwood 등 경쟁 관계의 기관 연구자 41명이 함께 이름을 올렸고, 제프리 힌턴과 일리야 수츠케버가 지지했다. 이 입장문에는 RLT 같은 구조를 정면으로 겨냥한 문장이 있다.
"그러한 잠재 추론 모델은 어떤 생각도 말로 드러낼 필요가 없을 수 있으며, 따라서 생각의 사슬이 주는 안전상의 이점을 잃게 된다."
"연속적인 잠재 공간에서 추론하는 모델은 최적화 압력이 없더라도 자연스럽게 사고 과정에 대한 우리의 가시성을 제한한다."
인용된 사례가 앞서 본 Coconut과 Huginn이다. 그리고 권고안 3(a)는 이렇다. "개발자는 감시 가능한 생각의 사슬이 없는 새로운 모델 아키텍처로 진행할지 고려하고, 그 모델을 배포한다면 시스템 카드에 그 결정을 기록해야 한다."
The Information 보도. OpenAI의 새 모델 Astra가 "순환 깊이(recurrent depth)"라는 추론 기법을 쓴다. TechCrunch의 요약에 따르면 이 기법은 모델이 대부분의 추론 모델을 특징짓는 순차적 사고 바깥에서 작동할 수 있게 한다.
9월 2일
반응. Redwood Research CEO 벅 슐레게리스: "Astra가 불투명한 순환을 쓴다는 보도가 극도로 우려스럽다." 수석 과학자 라이언 그린블랫: "가장 큰 걱정은 여기서 자연스럽게 이어질 다음 단계가, 모델이 전적으로 혹은 거의 전적으로 잠재 공간에서 추론할 때까지 불투명한 추론을 키우는 것이다." OpenAI 수석 과학자 야쿠프 파호츠키는 X에서 "혼란스러운 보도로 촉발된 감시 불가능성 경쟁을 막고 싶다"며, Astra를 포함한 현재 모델의 계산 그래프 깊이가 GPT-4의 두 배 이내라고 밝혔다.
9월 3~4일
Astra 출시와 시스템 카드. 시스템 카드는 Astra가 이전 모델보다 자기 생각의 사슬을 훨씬 더 잘 통제하고, 생각의 사슬 없이 해낼 수 있는 과제의 범위가 크게 넓어졌다고 적었다. 그러나 이 변화가 아키텍처 변경 때문은 아니라고 꽤 확신한다고 했고, 순환 깊이라는 말은 등장하지 않는다.
9월 6일
파호츠키의 에세이 「An Alien Mind」. 인용 보도에 따르면, 그는 생각의 사슬 감시에 기댈 수 있는 능력이 점점 줄고 있다고 인정하고, 생각의 사슬 감시와 활성값 감시를 결합해 네트워크 내부에 직접 접근하는 감시자를 학습시키고 있다고 밝혔다.
냉정한 목소리도 있었다. 『Build a Large Language Model (From Scratch)』의 저자 세바스찬 라시카는 "이것은 여전히 소문이거나 특종일 뿐 공식 확인이 없다"고 짚고, "루프 트랜스포머가 생각의 사슬을 숨기는 데 크게 기여한다고 보지 않는다"고 썼다. 추론 흔적이 짧아진 것은 더 강한 모델이 같은 정확도에 더 적은 토큰을 쓰는 자연스러운 현상이라는 것이다. LessWrong에서도 몇 번 반복하는 수준이면 당장은 걱정이 과장됐고, 진짜 질문은 반복이 수백 번으로 늘어날 때라는 분석이 나왔다.
6-3. RLT는 이 논쟁에서 어디에 서 있나
여기서 구분이 중요하다. Astra에 대해 보도된 것은 한 토큰 안의 깊이 반복이다. 파호츠키의 "GPT-4의 두 배 이내"라는 해명도 이 축의 이야기다. 한 토큰을 예측하는 계산 그래프가 얼마나 깊은가.
RLT는 다른 축을 연다. 토큰당 계산은 고정이지만, 토큰과 토큰 사이의 경로가 끝없이 길어진다. 1장의 표현을 빌리면, 생각의 사슬이 "고른 단어 하나"라는 좁은 통로로 이어 가던 계산을 은닉 벡터라는 넓은 통로로 이어 간다.
2025년 4월 공개된 미래 시나리오 「AI 2027」은 "뉴럴리즈 순환과 기억(Neuralese recurrence and memory)"이라는 상자 글에서 이런 구조를 상상했다. 토큰 하나는 약 16.6비트밖에 못 싣지만 잔차 스트림은 수천 개의 실수라서 천 배 넘는 정보를 넘길 수 있고, 그래서 모델이 "고차원의 생각의 사슬"을 갖게 된다는 것이다. 이 시나리오에서 그 기술은 AI의 생각을 사람이 읽지 못하게 되는 전환점으로 그려진다. RLT의 st−1→ 병합 게이트 →st 경로는, 적어도 구조적으로는 그 상자 글에 가장 가까운 구체적 명세 중 하나다.
관점
우려하는 쪽의 논리
신중한 쪽의 논리
구조
토큰 사이 계산이 벡터로 흐르면, 생각의 사슬 없이도 긴 계획을 이어 갈 수 있다. 감시자는 그 계산을 원리적으로 못 본다
RLT의 출력도 여전히 토큰이다. 모델이 글로 적는 편이 학습에 유리하면 계속 적을 것이다
증거
입장문, Baker et al., Astra 시스템 카드 모두 "생각의 사슬 없이 할 수 있는 일"이 늘수록 감시가 약해진다고 본다
RLT의 유일한 실험은 7만 9천 파라미터 합성 과제이고, 거기서도 긴 상태 추적을 제대로 배우지 못했다
경제
생각 토큰은 비싸다. 잠재 추론이 같은 성능을 더 싸게 내면 시장 압력이 그쪽으로 민다 (Apollo 홉하안: "능력이 오르면 압력은 분명히 더 깊은 쪽으로 향한다")
RLT는 프리필이 순차라서 오히려 비싸다. 경제적 압력이 이 구조를 택할지는 미지수다
대응
아키텍처 결정 자체를 시스템 카드에 공개하고, 감시 가능성을 배포 기준에 넣어야 한다
감시를 생각의 사슬에만 기대지 말고 행동 감시와 내부 상태 탐침으로 옮겨 가면 된다
6-4. 그래서 감시는 어디로 가나
두 관점이 모두 동의하는 지점이 하나 있다. 생각의 사슬만 믿는 시대는 끝나 가고 있다. 그 다음 도구는 이미 움직이고 있다.
행동 감시. Baker et al.에서 행동만 본 감시자도 60%를 잡았다. 코드 변경(diff), 도구 호출, 파일 접근, 네트워크 요청은 모델 구조와 무관하게 남는다. 에이전트 샌드박스와 권한 설계가 이 층을 맡는다.
내부 상태 탐침(probe). 구글 딥마인드는 2026년 1월 「Building Production-Ready Probes For Gemini」에서 실제 서비스에 배치한 활성값 탐침을 보고했다. 파호츠키도 내부에 직접 접근하는 감시자를 키우겠다고 했다. RLT에서는 st 자체가 모든 토큰에서 명시적으로 넘어가는 하나의 벡터라서, 역설적으로 탐침을 붙일 자리가 뚜렷하다는 장점도 있다.
해석 가능성 연구. Anthropic의 회로 추적(2025년 3월)은 Claude가 운율을 미리 계획하고, "댈러스 → 텍사스 → 오스틴"처럼 사실을 두 단계로 잇는 것을 내부에서 보여 줬다. 동시에 "짧고 단순한 프롬프트에서도 전체 계산의 일부만 포착한다"는 한계를 적었다. 토큰 사이로 수십만 블록의 경로가 흐르는 모델을 이 방식으로 읽기는 훨씬 어렵다.
투명성 규범. 입장문의 권고처럼, 감시 가능한 생각의 사슬이 없는 구조를 배포한다면 그 결정을 공개하는 것. Astra 시스템 카드가 아키텍처를 언급하지 않은 것을 두고 안전 연구자들이 문제를 제기한 지점이다.
7. 그럼 RLT는 어디에 쓰일까 — 가능성과 조건
아직 학습된 RLT는 없다. 그래도 설계를 보면 이 구조가 잘 작동한다면 빛날 자리와 고생할 자리가 보인다.
상황
유리한 이유
불리한 이유
긴 멀티턴 에이전트 (코딩·운영 자동화)
도구 결과·사용자 메시지를 계속 흡수하며 상태를 누적. 프롬프트/응답 경계가 없어 서빙 분할에 무관
과거 메시지 편집·대화 요약 시 순차 재계산. 스냅샷 관리가 복잡
상태 추적이 핵심인 과제 (코드 실행 추적·로그 분석·게임 상태)
트랜스포머가 구조적으로 약한 영역을 되먹임이 직접 겨냥
독립 실험에서 길이 일반화 실패. 학습 방법이 먼저 풀려야 함
짧은 프롬프트 + 긴 생성 (추론·글쓰기)
생성 단계 비용은 표준과 비슷한데 생각 토큰을 줄일 여지
그 여지가 실제로 생기는지는 미검증
긴 문서 입력 (계약서·논문 수백 쪽 요약)
인코더 메모리는 병렬로 만들고 공유 가능
디코더 프리필이 문서 길이만큼 순차 → 첫 토큰 지연이 큼
대규모 강화학습
샘플러·트레이너 구조 불일치 제거, 재생 규칙이 명세됨
매 갱신마다 전체 순차 재생 + 전체 BPTT. 계산량 부담이 큼
안전 감시가 필수인 배포
상태 벡터 하나에 탐침을 붙일 위치가 명확
생각의 사슬 감시만으로는 부족. 행동·내부 감시 체계가 먼저 필요
2026년의 흐름에서 보면 RLT의 가장 큰 기여는 성능이 아니라 질문을 정확히 정리한 것일지 모른다. 순환 구조를 진지하게 쓰려면 무엇이 결정되어야 하는가. 프롬프트와 응답의 경계는 어떻게 할 것인가. 병렬화는 어디까지 허용되고 어디서 모델을 바꾸는가. 강화학습에서 어떤 상태를 재사용하면 안 되는가. 기울기를 자를 때 무엇을 잘랐는지 어떻게 명시할 것인가. 루프 모델과 잠재 추론이 대형 연구소들의 제품에 들어가기 시작한 지금, 이 질문들은 곧 누군가의 실제 코드가 될 것이다.
📋
RLT류 논문이나 발표를 읽을 때의 체크리스트
① "무한 깊이"가 토큰당 계산인가, 토큰 사이 경로인가? ② 프리필은 정말 병렬인가, 아니면 디코더를 건너뛰는 근사인가? ③ 학습·추론·RL 재생이 같은 전이를 쓰는가? ④ 길이 일반화 실험이 있는가, 학습 길이 안에서만 쟀는가? ⑤ 비교 대상에 GRU·LSTM 같은 고전 순환 모델이 있는가? ⑥ 연산량(FLOPs)을 맞췄는가? ⑦ 감시 가능성에 대해 무엇을 말하는가?
맺으며 — 풀이 과정을 적지 않는 학생을 어떻게 믿을 것인가
다시 시험장으로 돌아가자. 암산 천재 학생에게 선생님이 할 수 있는 일은 몇 가지다. 풀이를 강제로 적게 할 수 있다. 하지만 Baker et al.이 보여 줬듯, 적게 강요받은 학생은 보여 주기용 풀이를 적는 법을 배운다. 답만 채점할 수도 있다. 하지만 커닝과 이해를 구분하지 못한다. 아니면 학생의 행동을 관찰하고, 가능하다면 머릿속을 들여다보는 도구를 만들 수 있다.
RLT 논문은 이 학생을 만드는 설계도의 한 장이다. 아직 학생은 태어나지 않았고, 시제품은 긴 문제에서 헷갈려 했다. 1990년대의 GRU가 더 침착하게 끝까지 따라갔다. 하지만 설계도는 매우 꼼꼼하다. 바통과 메모장을 어떻게 넘길지, 경기를 어떻게 다시 재생할지, 빠른 커널이 언제 모델을 바꾸는지까지 적혀 있다.
35년 전 엘먼은 모델에게 기억을 한 줄로 넘기는 법을 가르쳤다. 2017년 트랜스포머는 그 줄을 끊고 속도를 얻었다. 2022년 우리는 끊어진 자리를 글로 이어 붙였고, 그 글 덕분에 모델의 생각을 읽을 수 있었다. 2026년, 그 자리는 다시 벡터로 채워지려 한다. 기술적으로는 자연스러운 되돌림이다. 다만 이번에는 한 가지가 다르다. 우리는 이제 모델이 무슨 생각을 하는지 알아야 할 이유가 35년 전보다 훨씬 많다.
그러니 이 논문을 읽고 남겨야 할 질문은 "RLT가 더 똑똑한가"가 아니다. 모델의 생각이 어디에 흐르는지, 그리고 우리가 그 흐름을 볼 수 있는 자리를 어디에 남겨 둘 것인지다.
용어 정리
용어
뜻
은닉 상태 (hidden state)
모델 내부에서 계산되는 벡터. 사람이 직접 읽을 수 없다
KV 캐시
어텐션이 과거 토큰을 참조하기 위해 저장해 두는 키·값 벡터
프리필 (prefill)
프롬프트를 처음 읽어 캐시를 채우는 단계. 이후 한 토큰씩 생성하는 단계가 디코드
슬라이딩 윈도 어텐션 (SWA)
최근 W개 위치만 보는 어텐션. 메모리가 문맥 길이와 무관하게 고정
생각의 사슬 (CoT)
답하기 전에 중간 추론을 자연어 토큰으로 적는 방식
잠재 추론 (latent reasoning)
중간 추론을 토큰이 아니라 은닉 벡터 속에서 수행하는 방식
루프/순환 깊이
같은 층 묶음을 한 토큰 안에서 여러 번 반복 적용해 깊이를 늘리는 방식
시간 방향 순환 (temporal recurrence)
한 토큰의 계산 결과 상태를 다음 토큰의 입력으로 넘기는 방식. RLT의 핵심
BPTT
시간 역전파. 순환 계산을 펼쳐 놓고 기울기를 처음까지 거꾸로 전달
상태 추적 (state tracking)
일련의 연산 뒤 현재 상태를 계속 갱신해 알아내는 과제. 야바위, 코드 실행, 체스 기보
TC⁰ / NC¹
회로 복잡도 클래스. 트랜스포머는 TC⁰에 갇히고, S₅ 순열 합성 같은 NC¹-완전 문제는 TC⁰로 풀 수 없다고 널리 추정된다
행동 정책 μ / 중요도 비율
강화학습에서 실제로 데이터를 뽑은 분포와, 그것으로 현재 정책의 기대값을 보정하는 확률 비율
Elman, J. L. (1990). Finding Structure in Time. Cognitive Science 14(2), 179–211.
Bengio, Y., Simard, P. & Frasconi, P. (1994). Learning long-term dependencies with gradient descent is difficult. IEEE Transactions on Neural Networks 5(2).
Hochreiter, S. & Schmidhuber, J. (1997). Long Short-Term Memory. Neural Computation 9(8), 1735–1780.
본문의 삽화와 인터랙티브 위젯은 코어닷투데이가 제작했습니다. RLT 논문과 저장소의 그림(Figure 1~4, 독립 실험 결과)은 Apache 2.0 라이선스에 따라 인용했습니다. 그 밖의 논문 그림(생각의 사슬, 루프 트랜스포머, Ouro, Coconut, 피드백 트랜스포머, YOCO)은 각 원저작자의 자료를 설명 목적으로 인용한 것이며 저작권은 원저자에게 있습니다. 영문 인용은 우리말로 옮긴 것이므로 정확한 표현이 중요한 대목은 원문을 함께 확인하시기를 권합니다. 위젯의 사례와 대사는 개념 설명을 위해 구성한 것이며, 표기한 수치만 원 출처의 실험 결과입니다.