
TECH BLOG
기술 블로그
AI 기술 인사이트와 엔지니어링 경험을 공유합니다.
ALL POSTS
모든 포스트
8-bit Adam 특집: 옵티마이저 메모리를 75% 줄인 블록별 양자화의 비밀
Adam 옵티마이저의 상태만 84GB — 모델보다 6배 크다. 2021년, Tim Dettmers는 옵티마이저 상태를 8비트로 압축해 75%를 절약하면서도 32비트와 동일한 학습 품질을 유지하는 방법을 발견했다. 블록별 양자화와 동적 트리 양자화의 원리를 파헤친다.
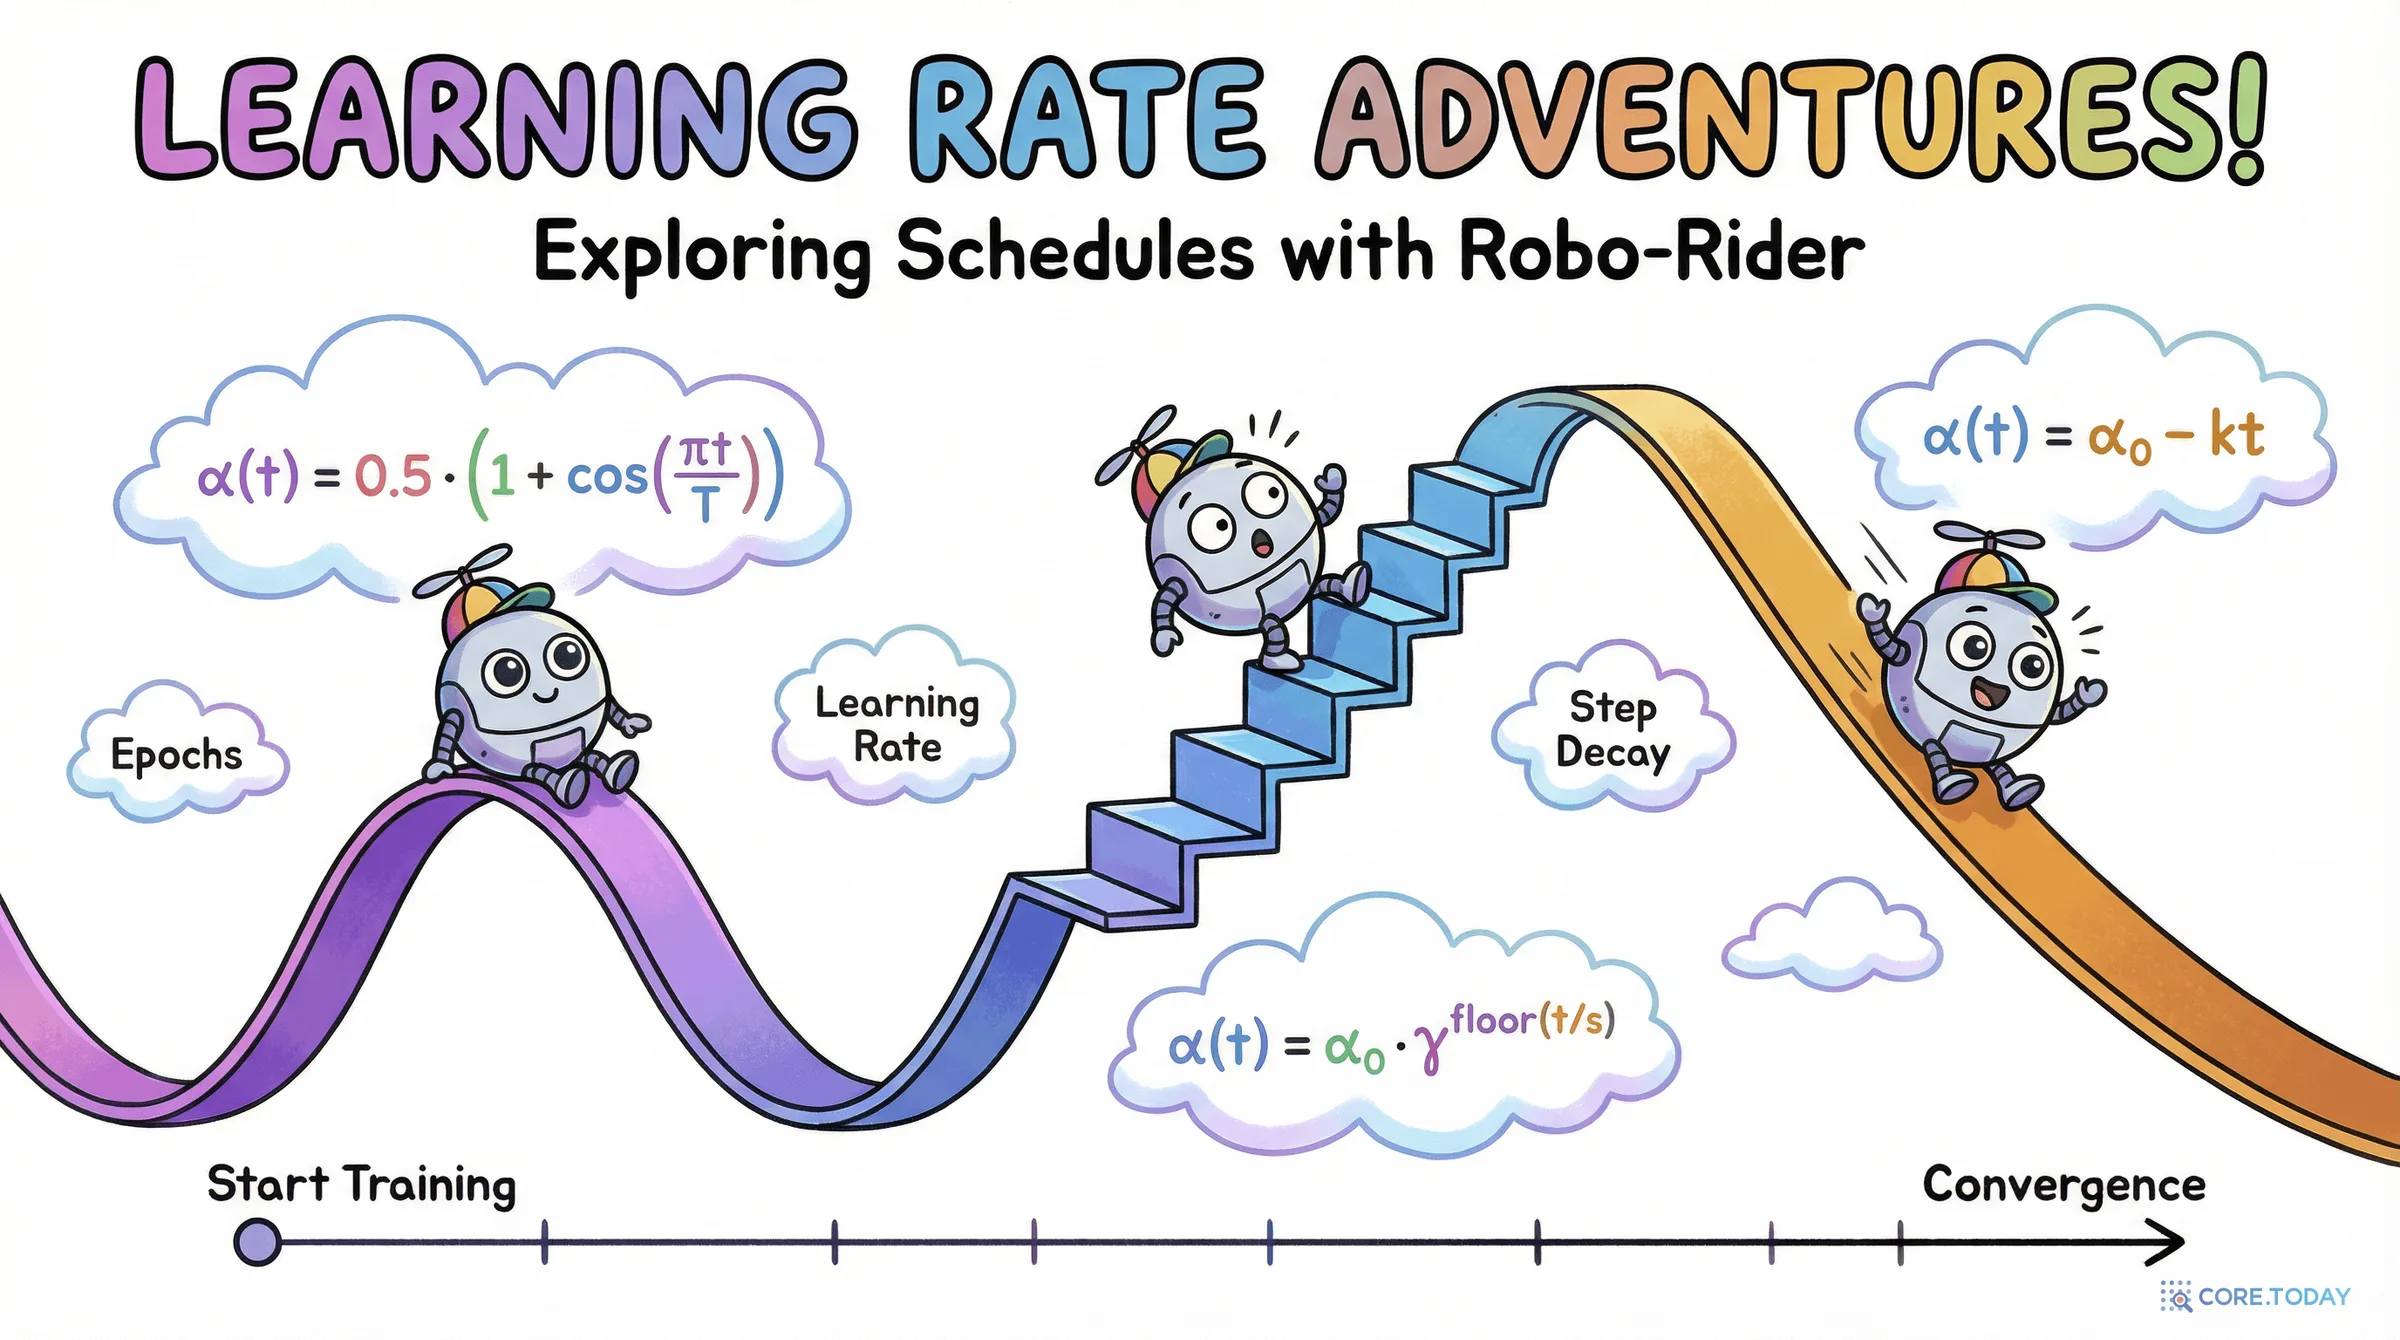
Learning Rate Schedule의 역사: 1951년 수학 정리에서 GPT의 코사인 스케줄까지
딥러닝에서 가장 중요한 하이퍼파라미터, 학습률. 1951년 Robbins-Monro의 수렴 조건에서 시작해, AlexNet의 계단식 감소, 코사인 어닐링, 워밍업, 그리고 GPT가 사용하는 현대적 스케줄까지 — 75년의 역사를 논문과 사례로 추적한다.
EfficientNet 완전 이해: 작은 것이 아름답다 — AI 효율 혁명의 시작
'더 크게'가 아니라 '더 똑똑하게' — 모델 크기를 키우는 세 가지 차원을 동시에 최적화하는 Compound Scaling이 어떻게 AI 효율 혁명을 일으켰는지를 논문과 사례로 풀어본다.
DPO 특집: 강화학습 없이 AI를 정렬하는 법 — 'AI는 사실 보상 모델이었다'
ChatGPT를 만든 RLHF는 복잡하고, 불안정하고, 비싸다. 스탠퍼드의 DPO 논문은 이 모든 것을 하나의 수식으로 해결했다. 강화학습 없이 AI를 인간의 선호에 맞추는 혁명적 방법론의 탄생부터 2026년 현재까지를 추적한다.
FlashAttention 해부: 박사과정 학생이 만든 커널이 AI 산업 전체를 바꿨다
GPT-3의 컨텍스트가 2K에 머물렀던 이유? 어텐션이 O(N²) 메모리를 잡아먹었기 때문이다. 한 박사과정 학생이 GPU 메모리 계층을 이해하고, 수학은 그대로 두되 메모리 접근만 바꿔서 2~4배 빠르고 10~20배 적은 메모리를 달성했다. 정확도 손실 0%.
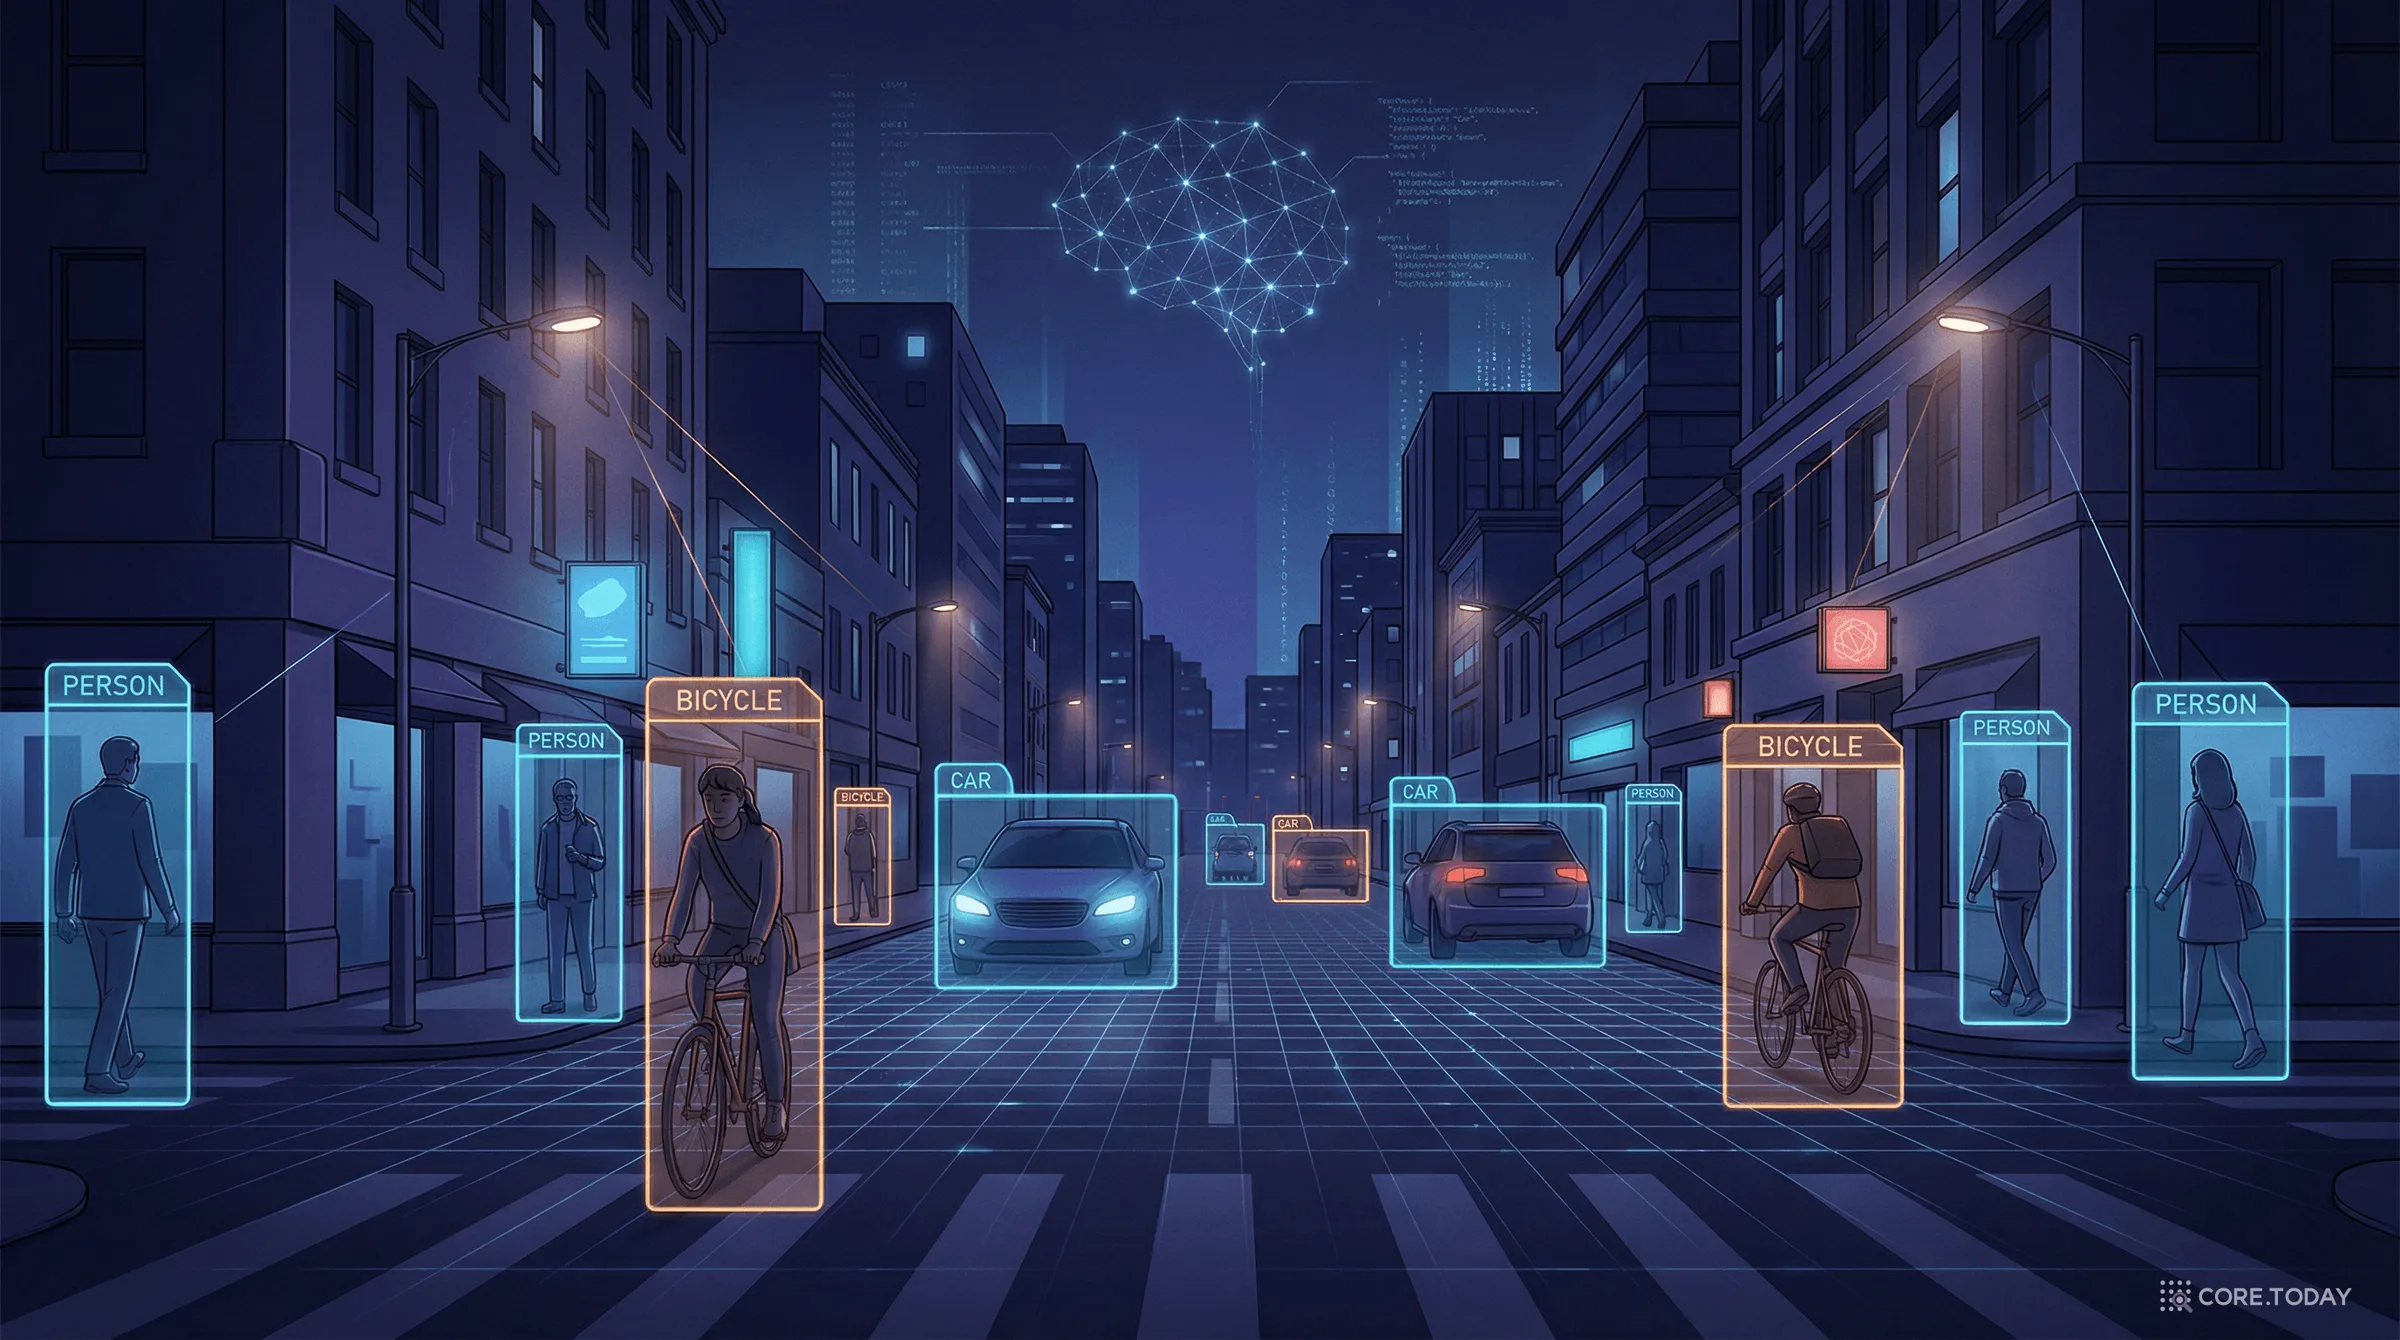
RT-DETR 완전 이해: DETR가 YOLO를 이긴 날 — 실시간 트랜스포머 검출의 혁명
NMS 없이 실시간으로 — YOLO의 왕좌에 도전한 최초의 실시간 엔드투엔드 트랜스포머 검출기 RT-DETR가 어떻게 탄생했고, 왜 객체 검출의 패러다임을 바꾸고 있는지를 두 편의 논문과 함께 풀어본다.
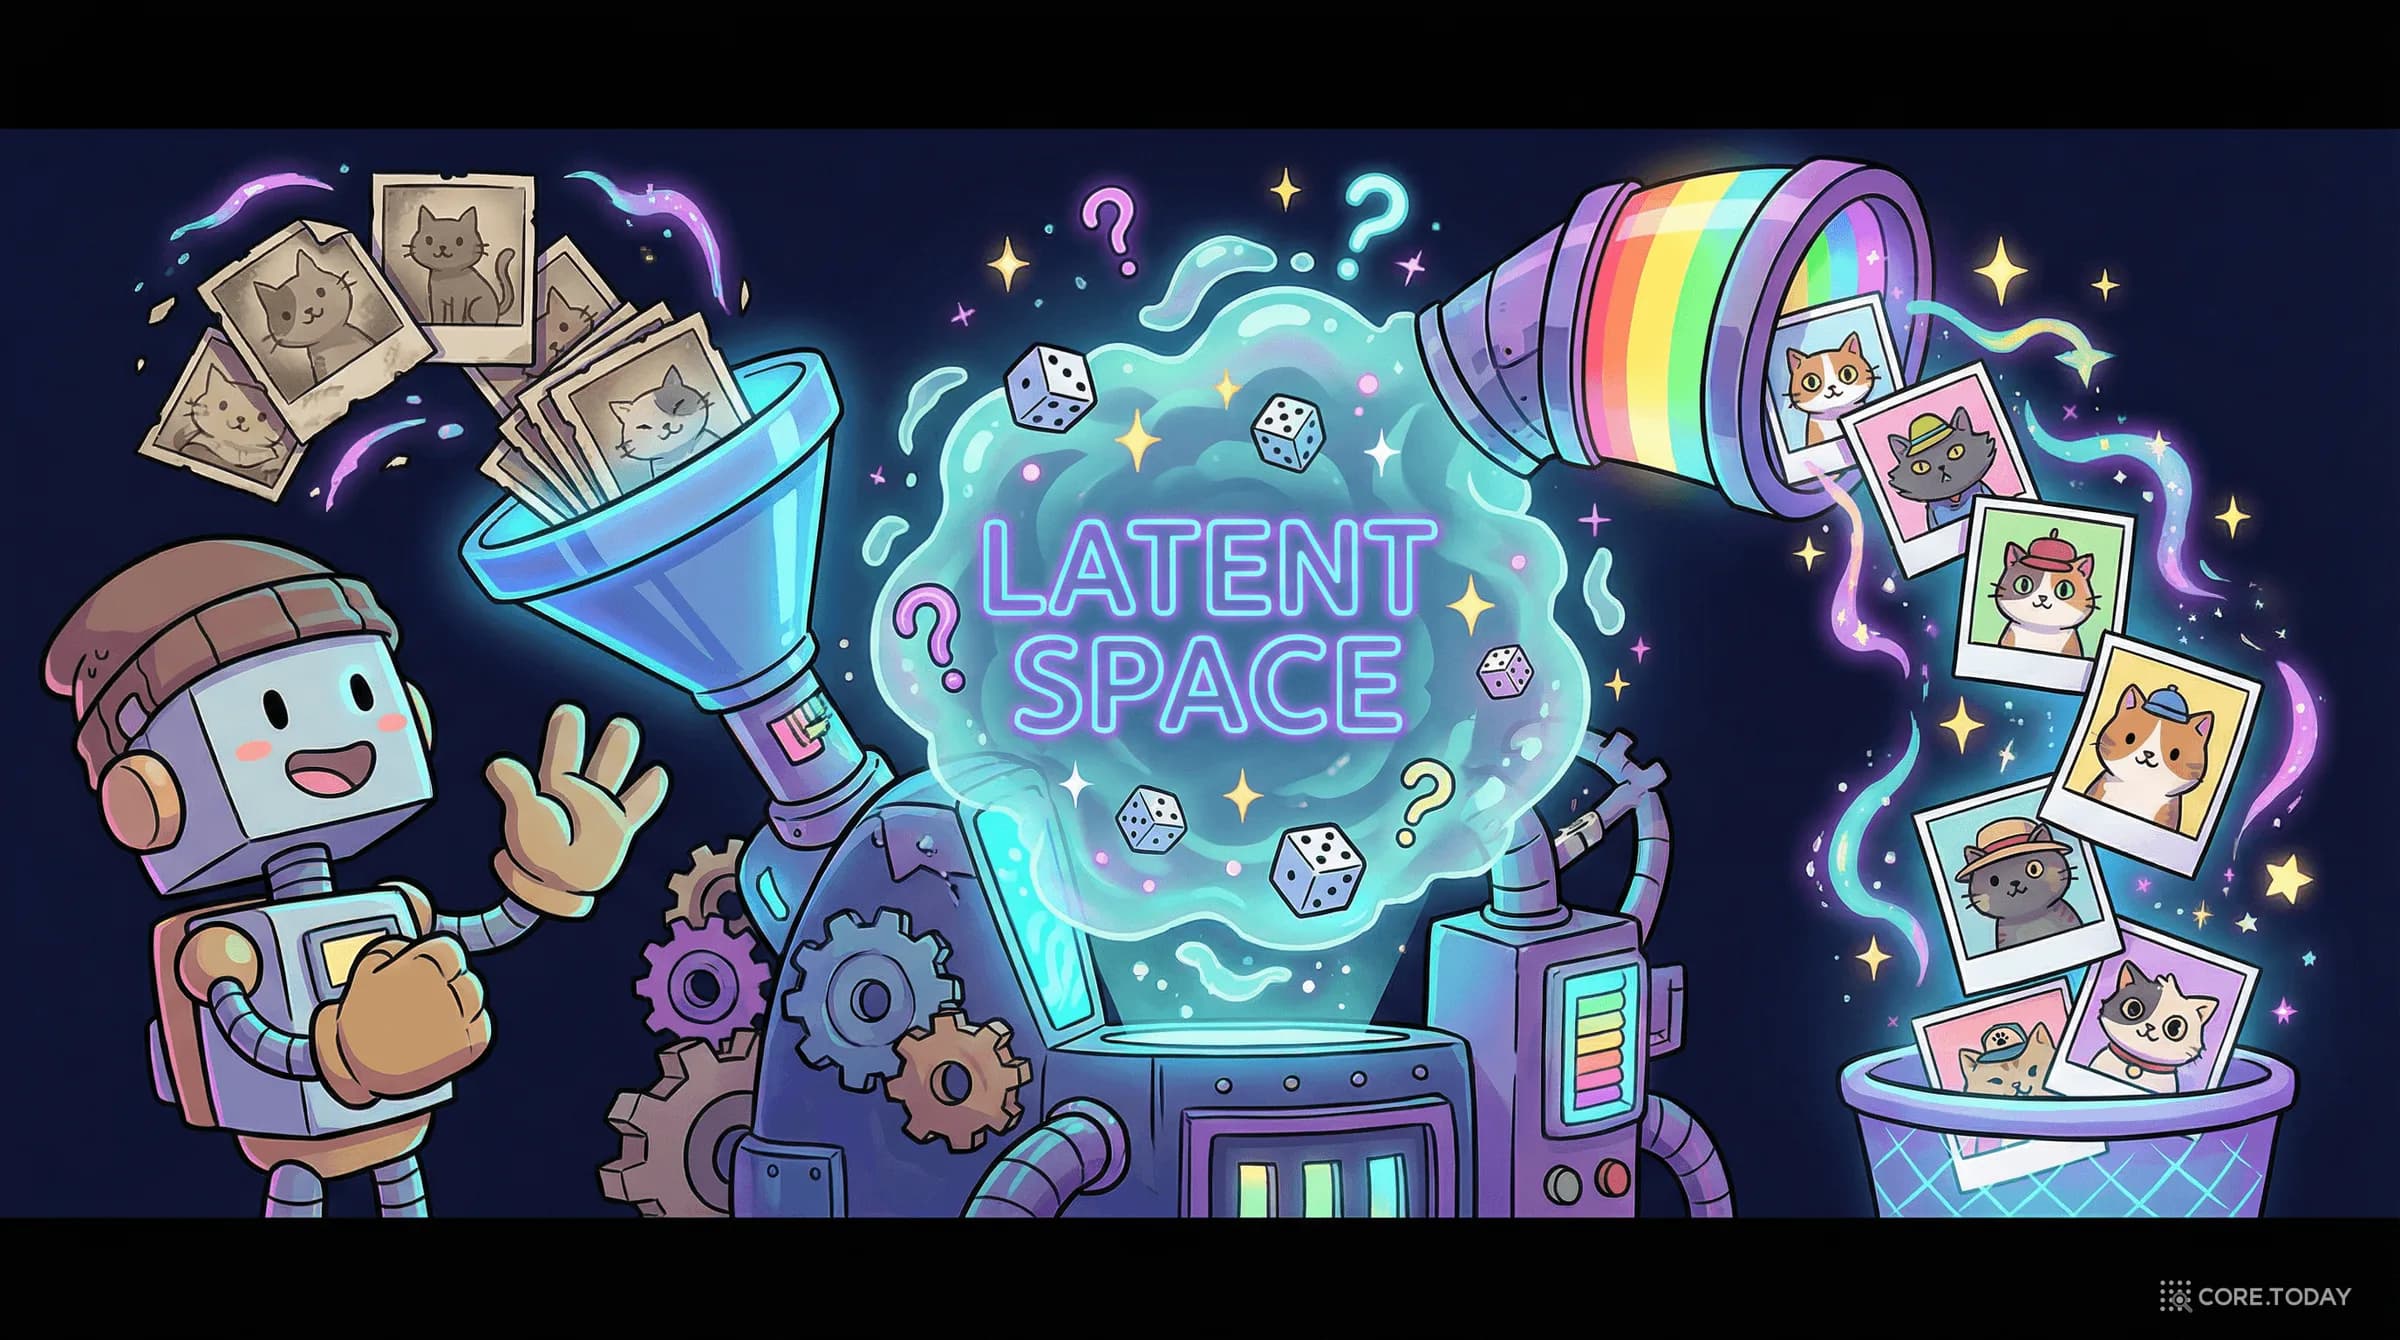
VAE 완전 정복: 확률의 마법으로 '없던 것'을 만들어내는 AI
점 하나 대신 '구름'을 배우는 AI — Variational Autoencoder가 확률을 무기로 생성 AI의 시대를 연 이야기. 원리부터 신약 설계, Stable Diffusion과의 연결까지.
GPT-3 논문 해부: 예시 몇 개만으로 배우는 AI의 탄생
1,750억 파라미터, 예시 몇 개면 새 과제를 수행하는 AI. '파인튜닝 없이 학습한다'는 혁명적 발견이 어떻게 ChatGPT와 프롬프트 엔지니어링 시대를 열었는지, GPT-3 논문을 처음부터 끝까지 해부한다.
친칠라 스케일링 법칙: '더 크게'가 정답이 아니었다 — AI 훈련 패러다임을 뒤집은 논문
GPT-3는 '과소 훈련'된 모델이었다? 2022년 DeepMind의 친칠라 논문이 밝힌 '모델 크기 vs 데이터 양'의 최적 비율, 그리고 업계가 이를 넘어선 이유까지 — AI 스케일링의 역사를 총정리합니다.