
TECH BLOG
기술 블로그
AI 기술 인사이트와 엔지니어링 경험을 공유합니다.
ALL POSTS
모든 포스트
CORPGEN 특집: AI가 사무실에 출근한다면, 멀티태스킹부터 배워야 한다
현실의 지식 노동자는 하루에 수십 개의 업무를 동시에 저글링한다. 그런데 AI 에이전트는 아직 하나도 제대로 못 끝낸다? Microsoft Research의 CORPGEN이 이 문제를 어떻게 해결하는지, 역사부터 아키텍처까지 완전 해부한다.
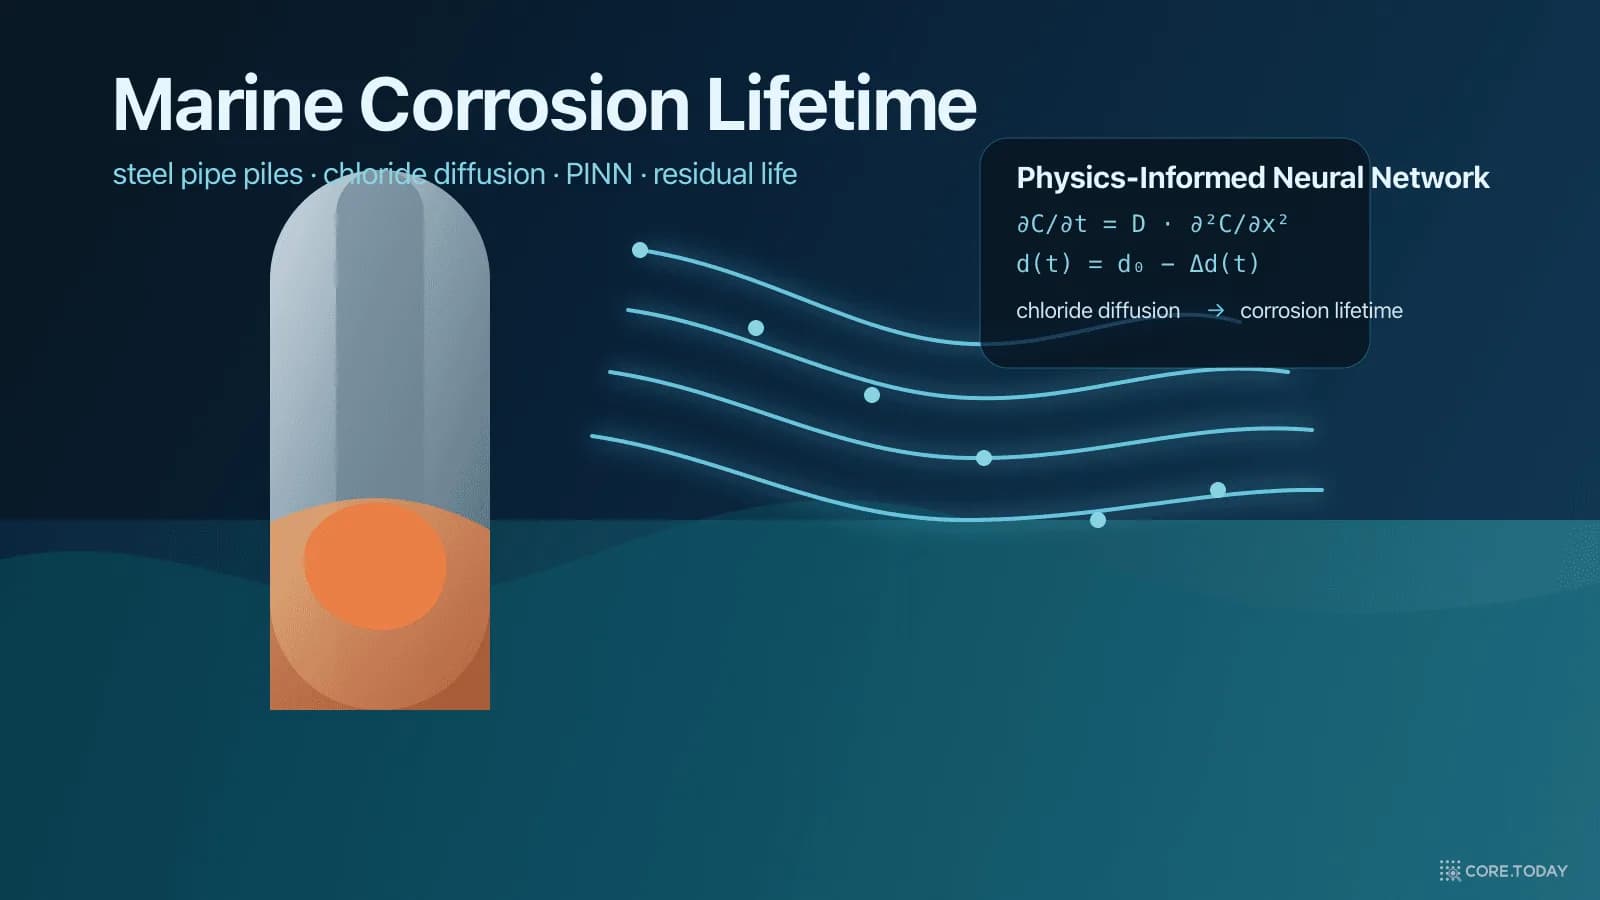
바닷속 강관말뚝은 언제 위험해지는가 — PINN으로 읽는 해양 부식 수명 예측
해양 강관말뚝은 왜 녹고, 그 속도는 어떻게 예측할까? 염화물 확산, 부식 깊이, 잔존 두께, 구조 성능 저하를 하나의 흐름으로 묶은 2026년 논문을 중심으로, Physics-Informed Neural Network가 해양 인프라 유지보수에서 어떤 역할을 맡게 되는지 깊고 쉽게 풀어본다.
X의 'For You' 피드는 어떻게 당신의 마음을 읽을까 — 오픈소스로 공개된 추천 알고리즘 완전 해부
X(구 트위터)가 오픈소스로 공개한 'For You' 피드 추천 알고리즘을 완전 해부합니다. Grok 기반 Transformer, Two-Tower 검색, Candidate Isolation까지 — 5억 개 트윗에서 당신의 피드를 만드는 기술의 모든 것.
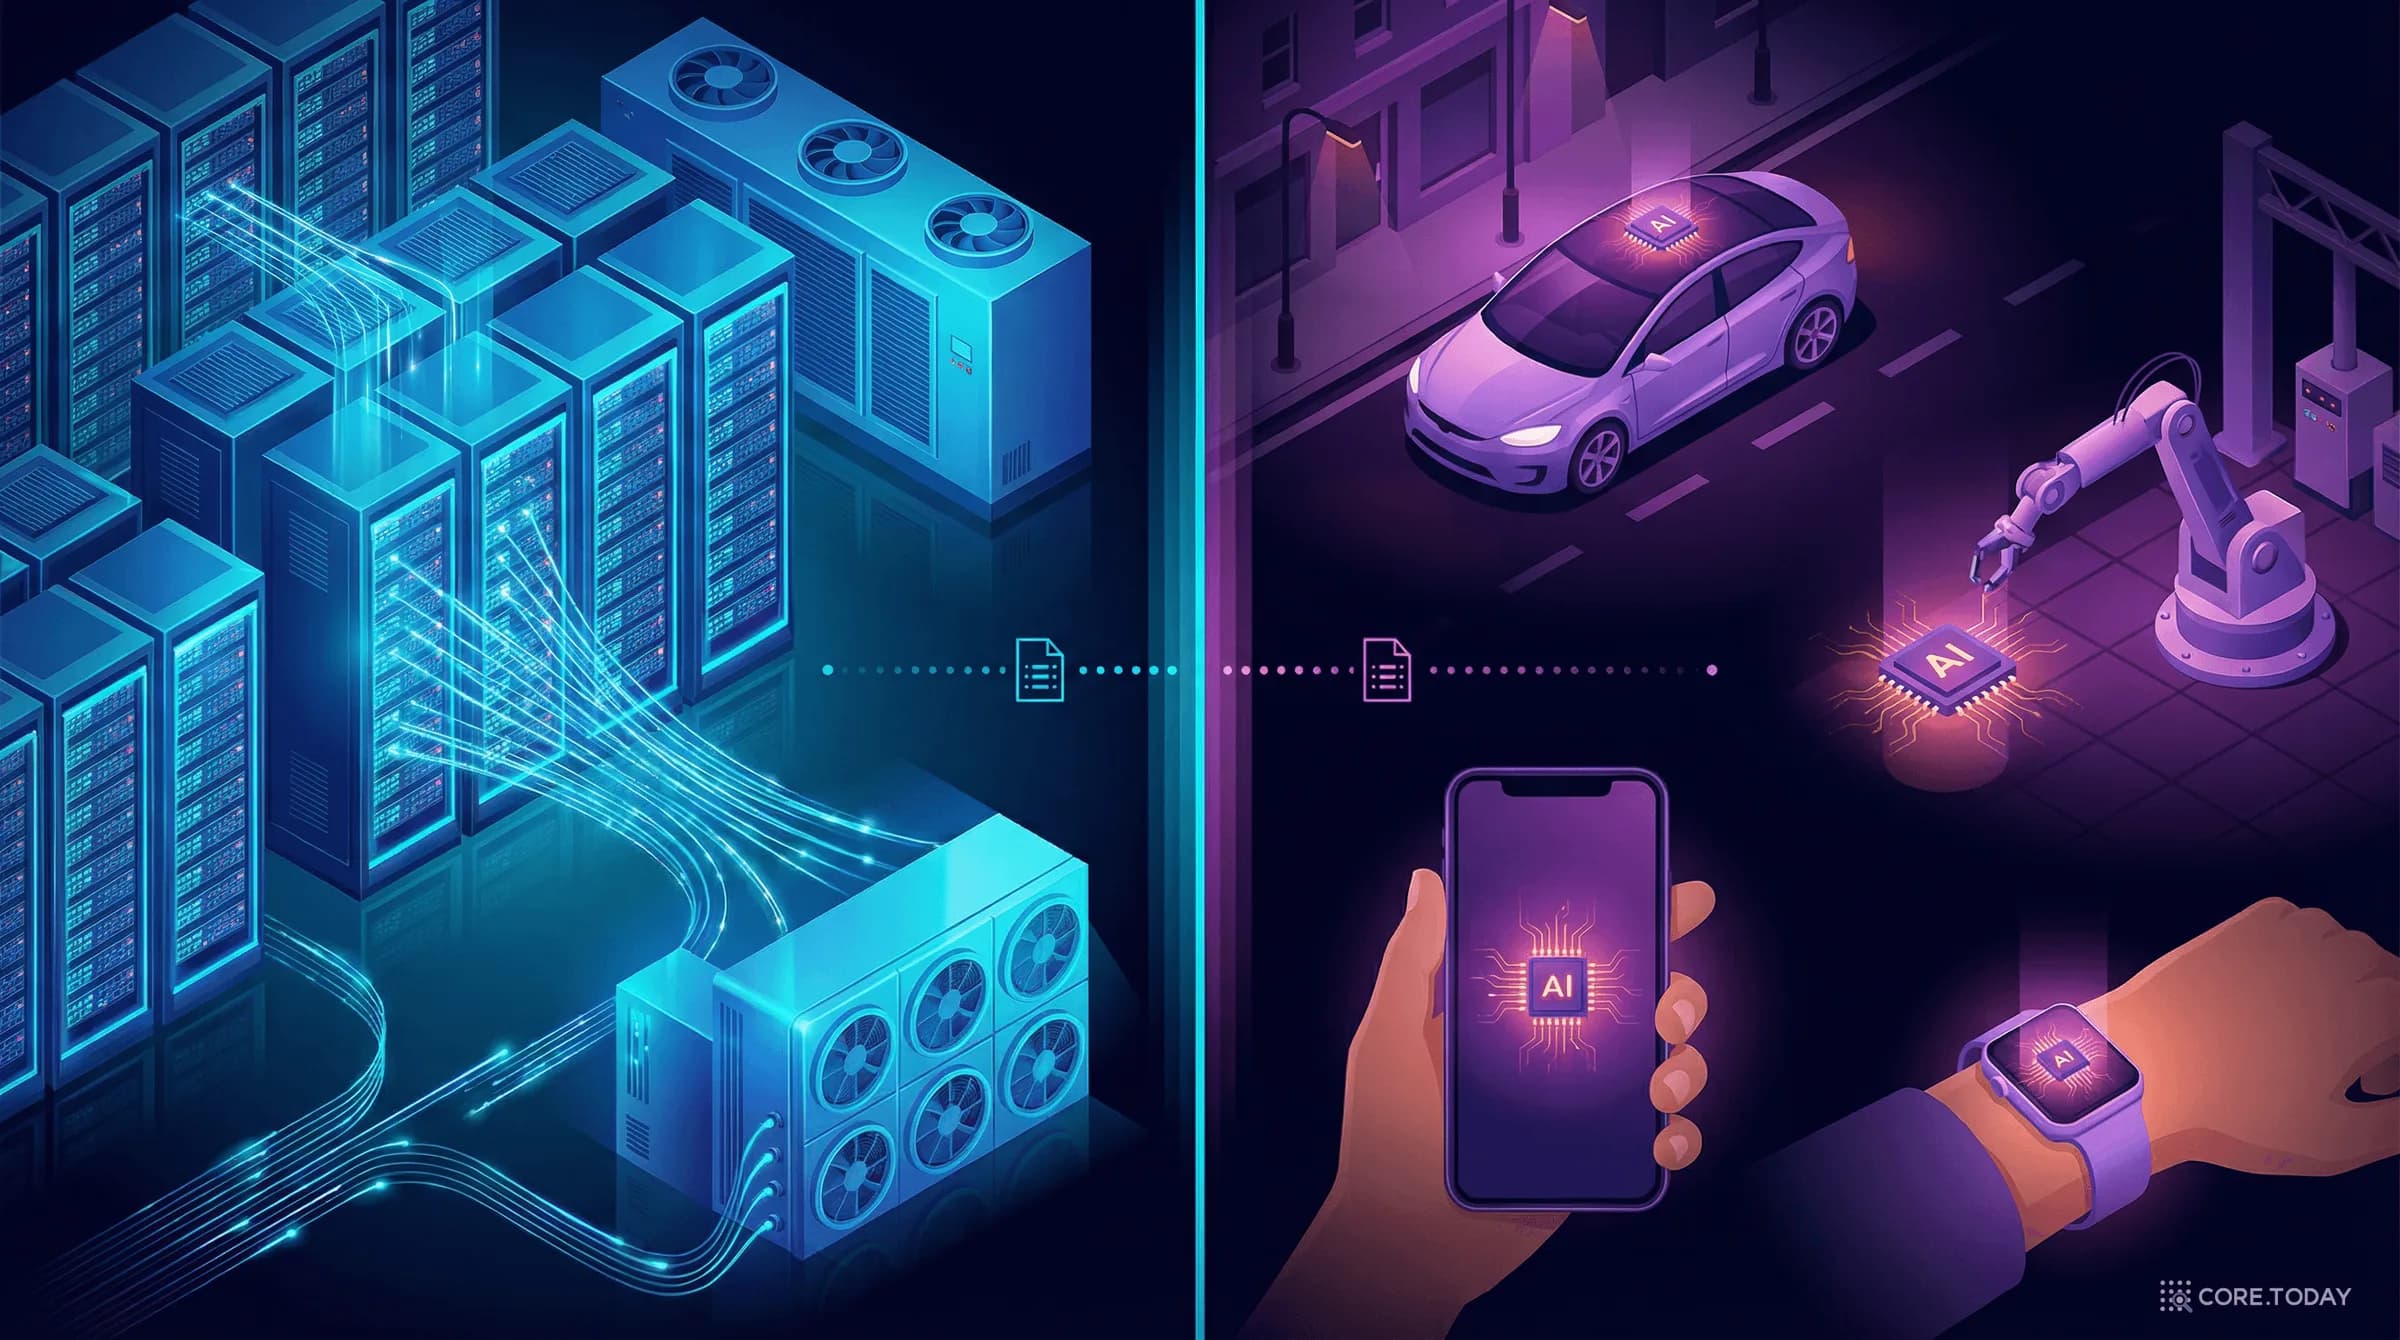
Edge AI vs Cloud AI 특집 (Part 1): 추론을 어디서 할 것인가 — 두 세계의 탄생과 핵심 개념
자율주행차는 브레이크를 밟기 위해 클라우드에 물어볼 시간이 없다. CDN에서 시작된 '가장자리의 컴퓨팅'이 AI를 만나 Edge AI가 되기까지 — 역사, 기술적 차이, 핵심 트레이드오프를 처음부터 이해한다.
MIT Missing Semester 완전 가이드 — CS 교육이 빠뜨린 '진짜 실력'
MIT가 만든 전설의 무료 강의 'The Missing Semester'를 완전 해부한다. 왜 세계 최고의 CS 학생들도 터미널 앞에서 헤매는가? 1969년 Unix 쉘부터 2026년 AI 코딩 에이전트까지, CS 교육이 빼먹은 '진짜 실력'의 모든 것.
한국 AI 5인방 완전 해부 — HyperCLOVA X Think, K-EXAONE, Kanana, Gauss, A.X K1
LG의 K-EXAONE은 AIME 2025에서 92.8%로 GPT를 넘었고, SKT의 A.X K1은 519B 파라미터로 국내 최대 규모를 자랑한다. 네이버, 카카오, 삼성까지 — 2026년 한국 AI 5인방의 기술, 벤치마크, 전략을 낱낱이 해부한다.
교과서가 답이다: 작은 AI가 거대한 AI를 이긴 날
1.3B 파라미터 모델이 175B GPT-3.5를 이겼다. 비결은 '교과서 품질' 데이터. 'Textbooks Are All You Need' 논문이 열어젖힌 소형 언어 모델 혁명과, 3년이 지난 2026년 지금 그 논문이 어떻게 현실이 되었는지를 추적한다.
Attention Is Not What You Need: 어텐션 없이도 AI가 '생각'할 수 있다면?
2017년, 구글은 'Attention Is All You Need'로 AI 혁명을 열었다. 2025년 12월, 한 연구자가 같은 구조에 정면으로 반기를 든다 — 'Attention Is Not What You Need.' 어텐션 없이 기하학적 다양체 위에서 추론하는 새로운 시퀀스 모델링 패러다임을 해부한다.
DEIMv2 완전 이해: DINOv3와 만난 실시간 검출 — 0.5M에서 50M까지, 하나의 프레임워크
0.49M 파라미터의 초소형 Atto부터 57.8% AP의 거대 X까지 — DINOv3의 강력한 표현력을 STA로 실시간에 녹여낸 DEIMv2가 8개 스케일로 GPU, 엣지, 모바일을 동시에 정복한 이야기.