
#Lost in the Middle
2개의 포스트
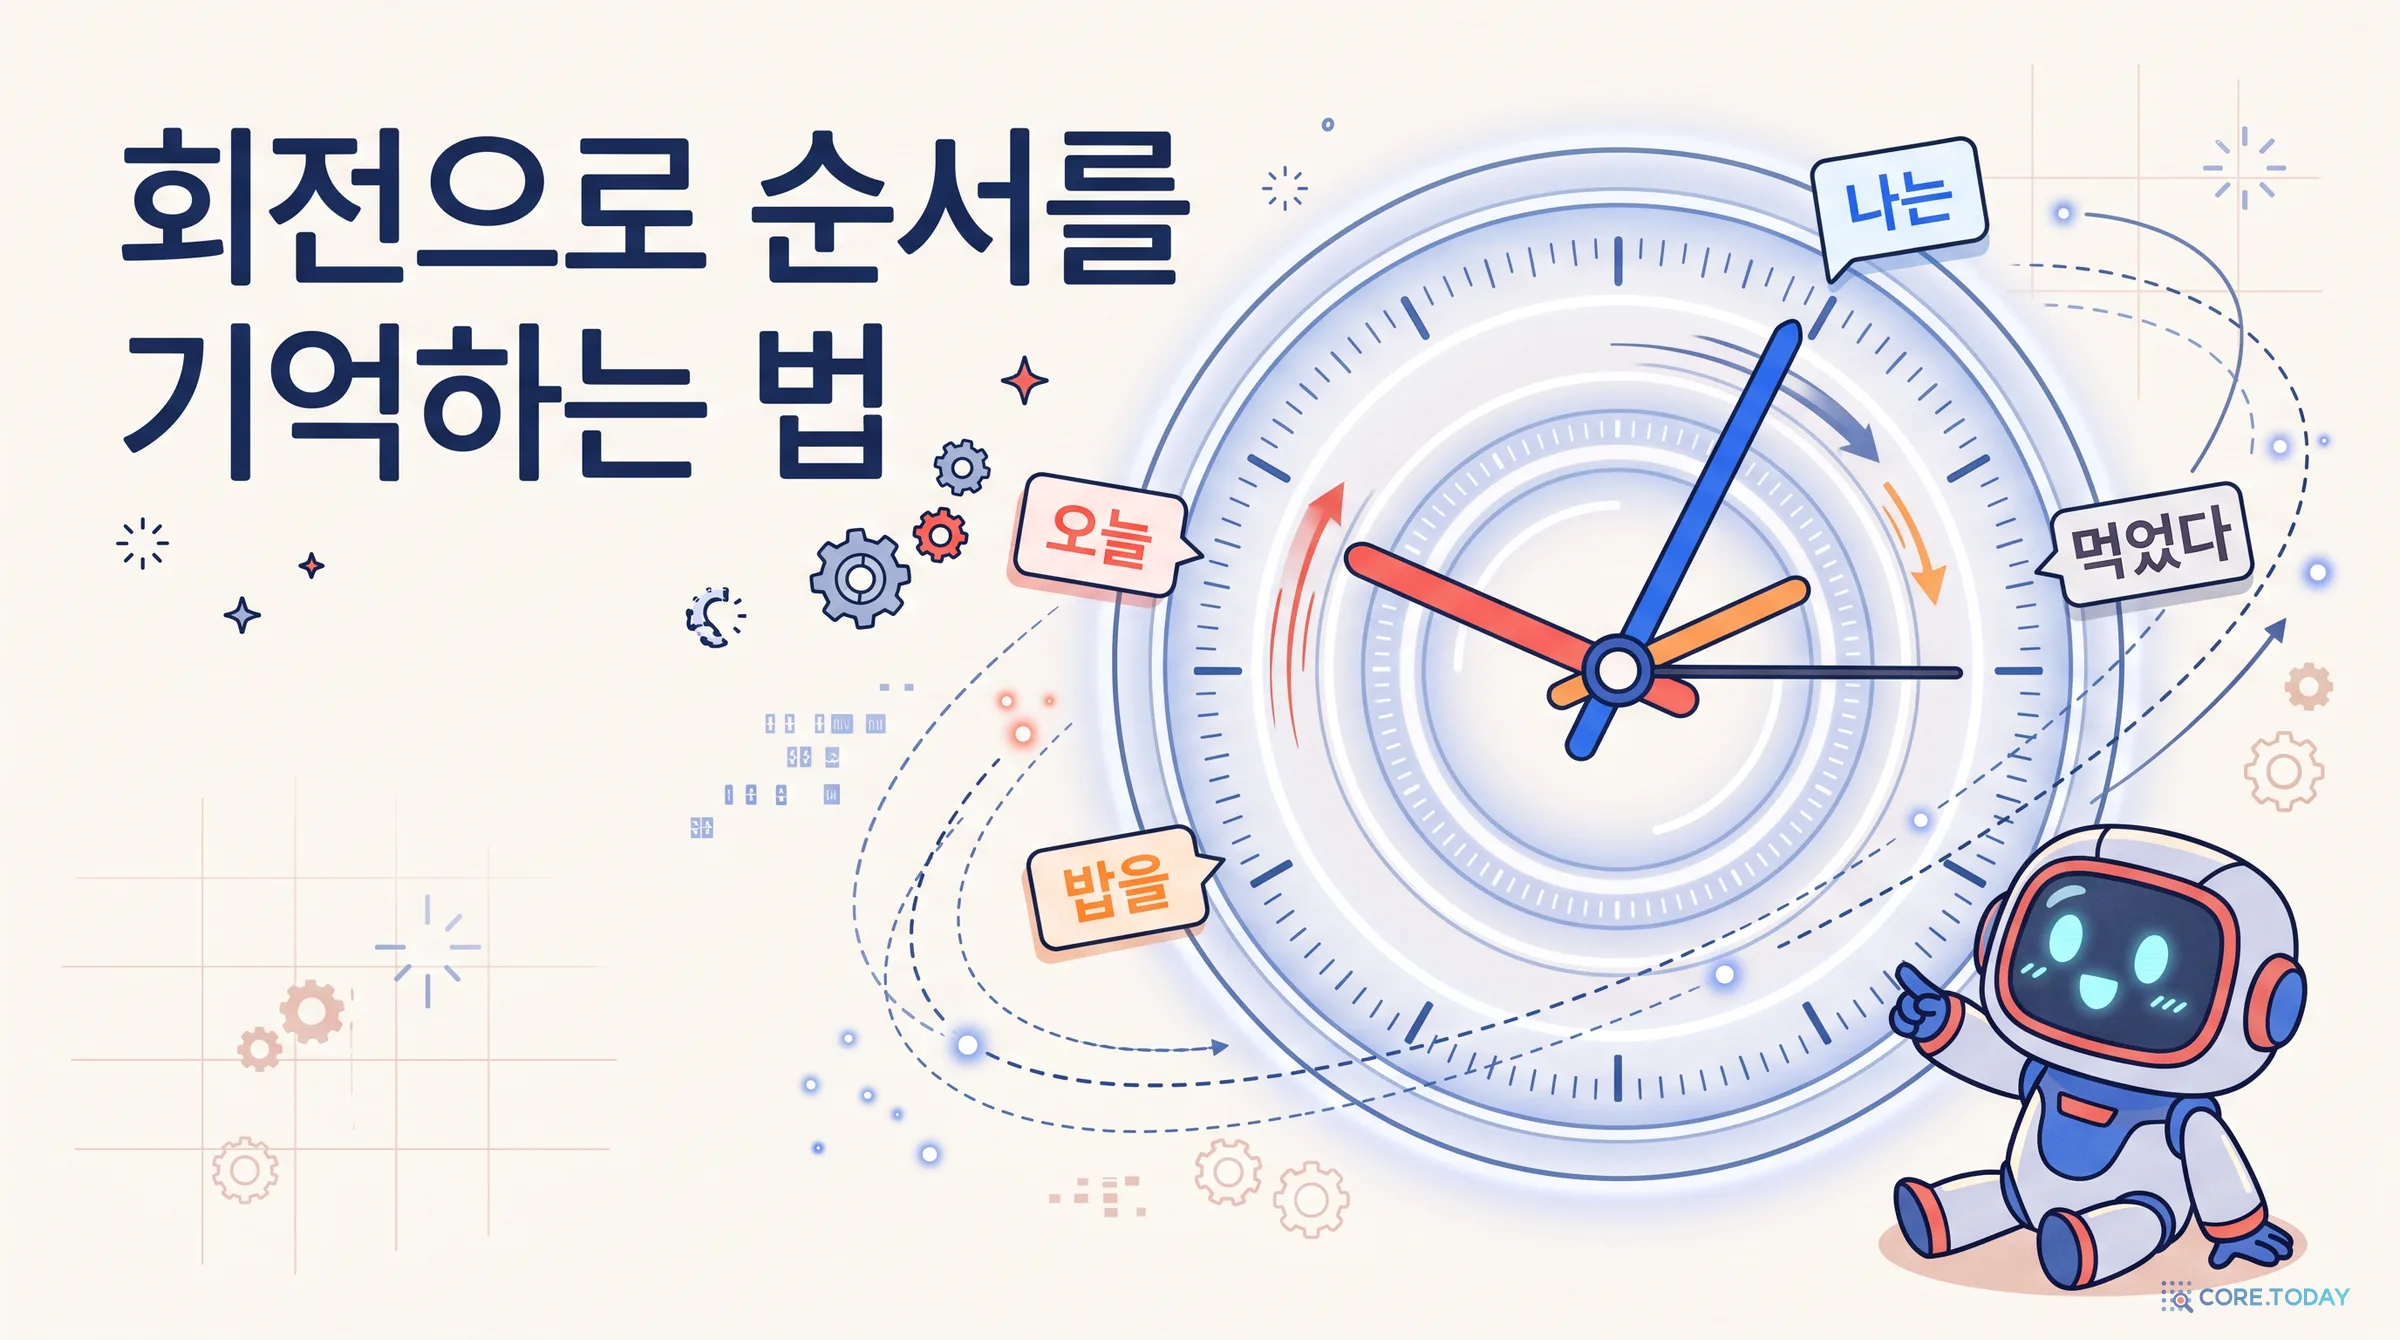
순서를 모르는 트랜스포머에게 순서를 가르치는 법 — 회전 위치 인코딩 RoPE와 100만 토큰 문맥 (특집)
트랜스포머의 어텐션은 단어 순서를 모른다. 위치 정보가 없으면 ‘dog bites man’과 ‘man bites dog’에서 dog가 받는 계산 결과가 똑같다. 2017년 사인파를 더하는 방식으로 시작한 위치 인코딩은, 2021년 중국 블로그에서 나온 ‘벡터를 위치만큼 돌린다’는 아이디어 RoPE로 수렴했고 지금 Llama·Qwen·Gemma·EXAONE이 모두 이를 쓴다. 이 글은 회전이 왜 상대 거리를 담는지 시계 바늘로 따라가고, 학습 길이를 넘으면 왜 무너지는지, 개인 개발자와 레딧 게시판이 논문보다 먼저 찾은 문맥 확장 트릭이 어떻게 YaRN과 100만 토큰 시대로 이어졌는지 정리한다. 2,048토큰만 배운 모델에게 8,192토큰을 읽힌 실측, 공개 모델 17종의 RoPE 설정 비교, 긴 문맥을 정말 다 쓰는지에 대한 평가까지 담았다. 인터랙티브 위젯 5종, 코어닷투데이 실측, 삽화 13장.
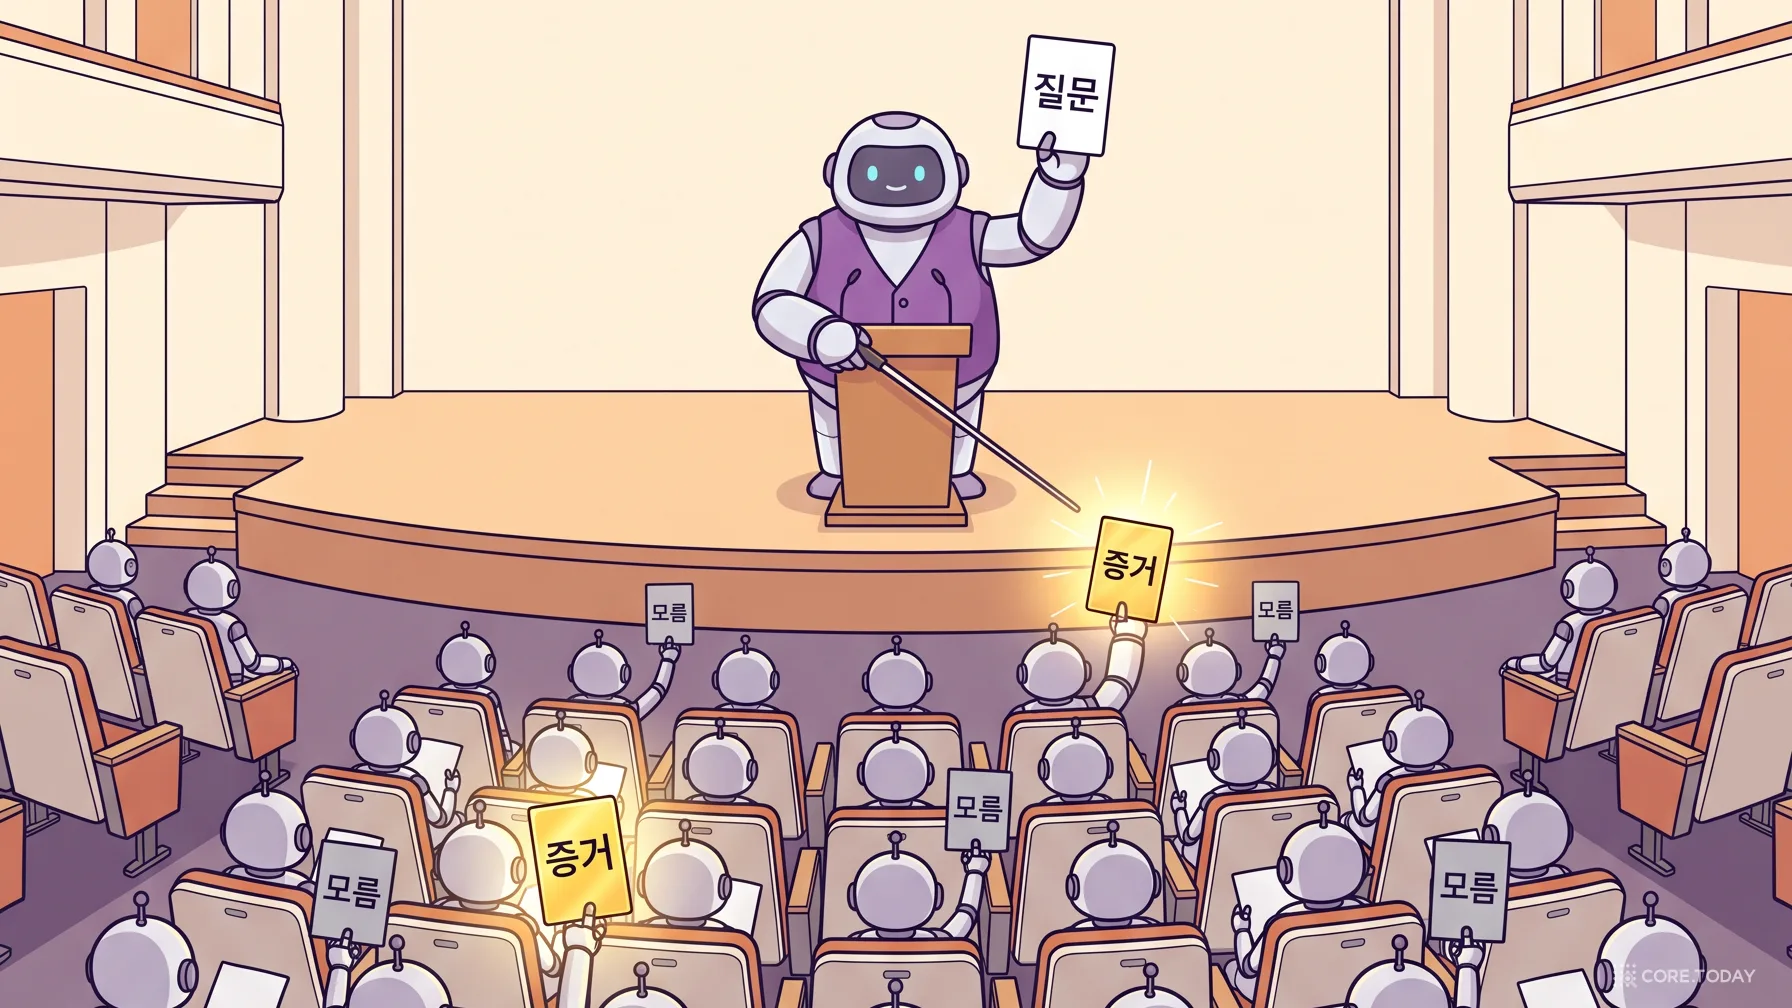
읽기는 병렬로, 추론은 깊게 — 896K 토큰 문서를 4B 모델이 읽어 내는 법, PARSER 논문 특집
100만 토큰짜리 창을 가진 모델도 긴 문서 앞에서는 정확도가 수십 점씩 떨어집니다. 홍콩중문대 연구진이 2026년 9월에 내놓은 PARSER는 '문서를 읽는 순서는 문서가 정하지만, 질문을 푸는 순서는 질문이 정해야 한다'는 한 문장에서 출발합니다. 문서를 보지 않는 리드 에이전트가 질문을 쪼개 수천 개의 청크 담당 서브에이전트에게 동시에 흩뿌리고, 돌아온 증거로 다음 질문을 다듬습니다. 4B 모델이 896K 토큰에서 순차 메모리 에이전트를 12점 앞서고, 9B 모델이 DeepSeek-V4-Pro를 6.3점 앞섰으며, 지연은 11배 줄었습니다. 이 글은 Transformer의 어텐션 창에서 시작해 'Lost in the Middle'과 Context Rot, MemAgent의 순차 메모리까지 이 논문이 서 있는 자리를 되짚고, 흩뿌리기-모으기 구조와 리드 에이전트만 강화학습하는 설계, 세 가지 통제 실험, 실패 사례와 한계, 그리고 2026년 멀티 에이전트 지형에서의 의미를 사례와 함께 풀어 씁니다. 시뮬레이터·결과 탐색기·접근법 가이드 위젯 3개.