
#LongMemEval
7개의 포스트
[특집] 기억은 하는데 지금을 모른다 — AI 에이전트의 '상태 표류'와 StateMem 완전 해부
에이전트가 며칠씩 일하게 되면서 '기억했는가'보다 '지금 무엇이 참인가'가 중요해졌다. UIUC 연구진의 2026년 8월 논문은 이것을 상태 추적이라 부르고, 사실은 맥락 안에 있는데 낡은 값으로 행동하는 실패를 '상태 표류'로 정의했다. 1969년 프레임 문제와 1979년 진리 유지 시스템·VisiCalc에서 시작해 대화 상태 추적, MemGPT·Mem0·Zep까지 이어지는 계보를 따라가고, 함정 234개짜리 StateMemBench가 어떻게 실패를 '만드는지', 대체 표시와 의존성 그래프로 상태를 지키는 StateMem과 답변 호출 하나만 바꾸는 래퍼가 무엇을 얼마나 고치는지 표와 그림을 하나씩 읽는다. 논문과 같은 계열의 로컬 모델(Qwen 3.5 9B)로 한국어 함정 40문항을 직접 돌려, 답변 프롬프트만 바꿔도 정답이 28개에서 38개로 느는 것도 확인했다.
메모리 벤치마크 점수, 믿어도 되나 — LoCoMo·LongMemEval을 직접 다시 채점해 봤다
2026년 에이전트 기억 업계는 LoCoMo·LongMemEval에서 90점대를 발표합니다. 하지만 같은 Zep의 LoCoMo 점수는 누가 쟀느냐에 따라 58점에서 95점까지 흩어져 있습니다. 두 벤치마크를 직접 다시 돌렸습니다. 기억 시스템 없이 대화를 통째로 넣은 2026년 저가 모델이 LoCoMo 80.7%, LongMemEval 81.6%로 2025년의 기억 시스템들을 넘었습니다. 같은 답에 채점 프롬프트만 바꾸자 점수가 26점 움직였고, 정답과 오답을 나란히 적은 답을 Mem0의 2026년 채점 프롬프트는 100% 정답 처리했습니다. LoCoMo 정답지 1,540개를 대화 원문과 대조하니 7%가 틀렸거나 모호했고, 대화 10개에 몰린 문항이라 95% 구간은 ±3.1점이었습니다. bAbI부터 건초더미 속 바늘, SWE-bench Verified의 은퇴까지 벤치마크의 역사와, 점수를 읽는 점검표 10문항을 함께 정리했습니다. 인터랙티브 6개.
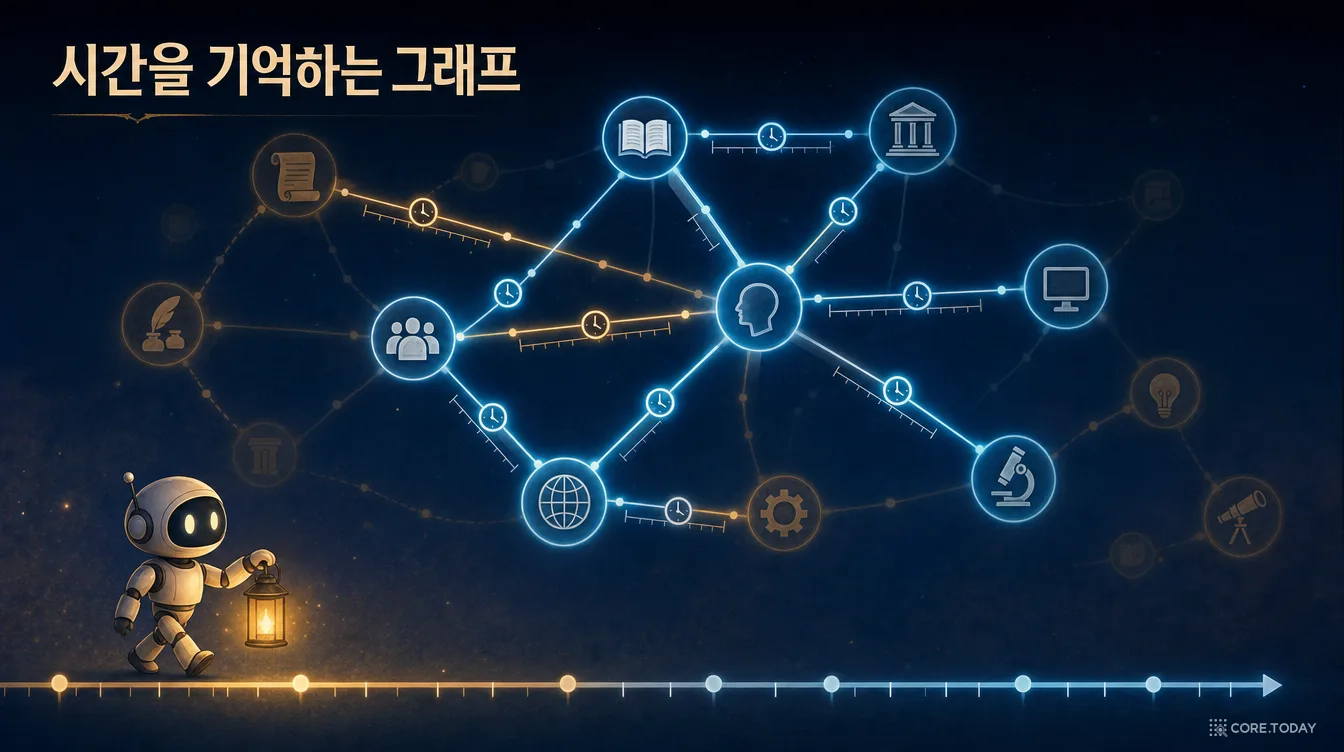
기억에 유효기간을 적다 — Graphiti 시간 그래프, 개념부터 코드까지
AI 비서가 '서울 사세요?'라고 묻는다면, 그건 기억을 못 해서가 아니라 기억은 하는데 언제의 기억인지를 몰라서입니다. Graphiti는 사실마다 '참이었던 기간'과 '알게 된 때'라는 두 개의 시계를 달아, 옛 사실을 지우지 않고 닫습니다. 1986년 데이터베이스 연구자들이 만든 이중 시간 모델이 어떻게 2026년 에이전트 메모리의 핵심이 됐는지, 네 개의 타임스탬프가 무엇을 뜻하는지, 옛 사실이 닫히는 규칙이 실제 코드에서 어떻게 생겼는지를 처음부터 따라갑니다. 다섯 개의 인터랙티브와 그림으로 시간 그래프를 직접 만져 봅니다.
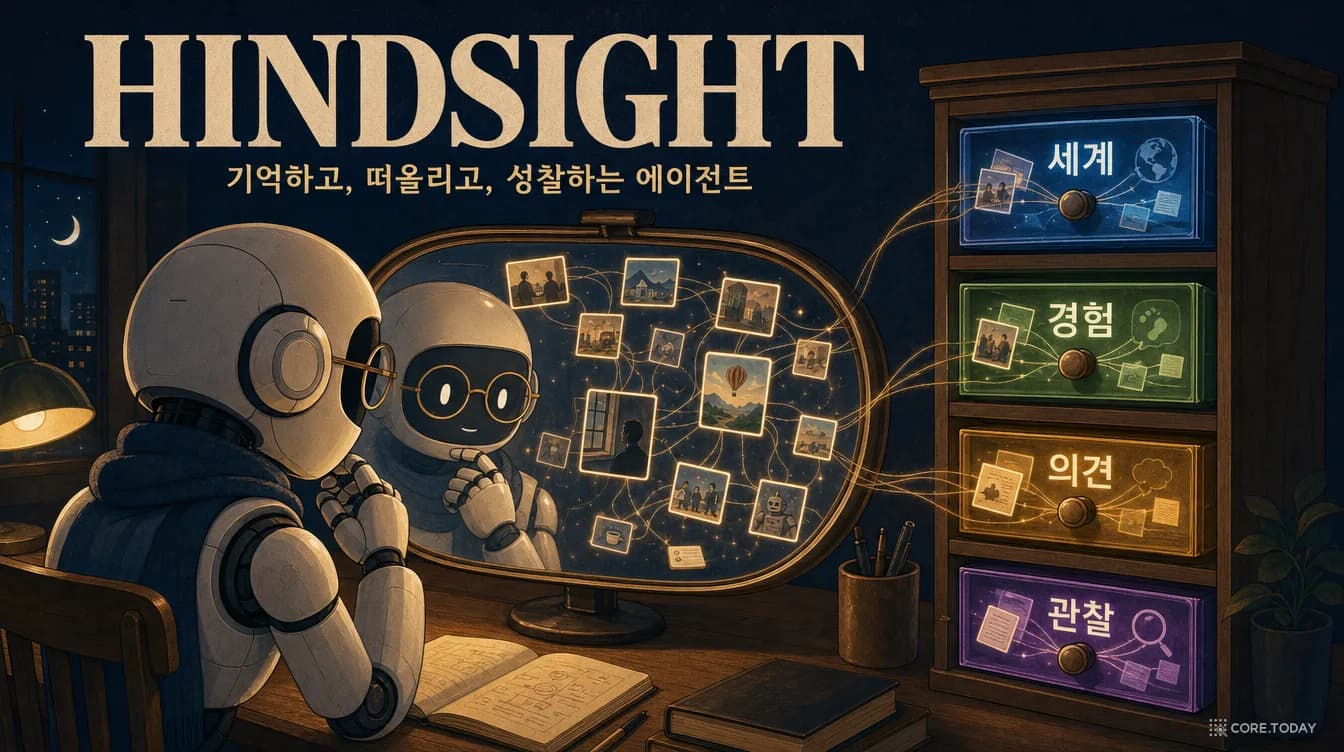
Hindsight 완전 해부 — 에이전트에게 '본 것'과 '믿는 것'을 따로 기억하게 했더니 생긴 일
11개월 만에 GitHub 별 4만 7천 개. 오픈소스 에이전트 메모리 Hindsight는 기억을 하나의 벡터 창고가 아니라 네 개의 서랍 — 세계·경험·의견·관찰 — 으로 나누고, 저장(retain)·회상(recall)·성찰(reflect) 세 동작으로 다룬다. 같은 20B 모델의 LongMemEval 점수가 39.0%에서 83.6%로 뛰었다. 왜 '증거와 믿음의 분리'가 중요한지, 네 갈래 검색과 역순위 융합·확산 활성화가 어떻게 돌아가는지, 성격 다이얼과 의견 강화 공식은 무엇인지, 그리고 2026년의 제품은 논문과 어떻게 달라졌는지 — 심리학의 140년 계보부터 벤치마크의 함정, 경쟁 설계와의 비교까지 인터랙티브 위젯 7개로 완전 해부한다.
기억은 미리 만들지 말고, 물어볼 때 지어라 — Just-In-Time 에이전트 메모리(JAM) 완전 해부
석 달 전 회의 요약에는 '가격 협의함'이라고만 적혀 있다. 그런데 오늘 필요한 건 '1,240만 원, VAT 별도'라는 한 줄이다. 대부분의 에이전트 메모리는 질문이 오기 전에 기록을 요약·추출해 두는 AOT(Ahead-of-Time) 방식이고, 그래서 '그때는 사소했던' 디테일을 먼저 버린다. BAAI·베이징대·홍콩이공대 연구진의 JAM은 발상을 뒤집는다. 원본은 폴더에 그대로 두고 README 색인만 미리 만든 뒤, 질문이 오면 작은 Researcher 에이전트가 open·search·browse로 찾아 들어가 그 질문만을 위한 맥락을 짓는다. 4B 모델로 14B 메모리 에이전트를 이기고, 4배 빨랐다. 토요타 공장과 JIT 컴파일러에서 시작해 Memory-Gym 데이터 합성, 힌트를 주는 강화학습, 결과표와 한계, 2026년의 다른 기억 설계와의 비교까지 인터랙티브 위젯 6종과 함께 해부한다.
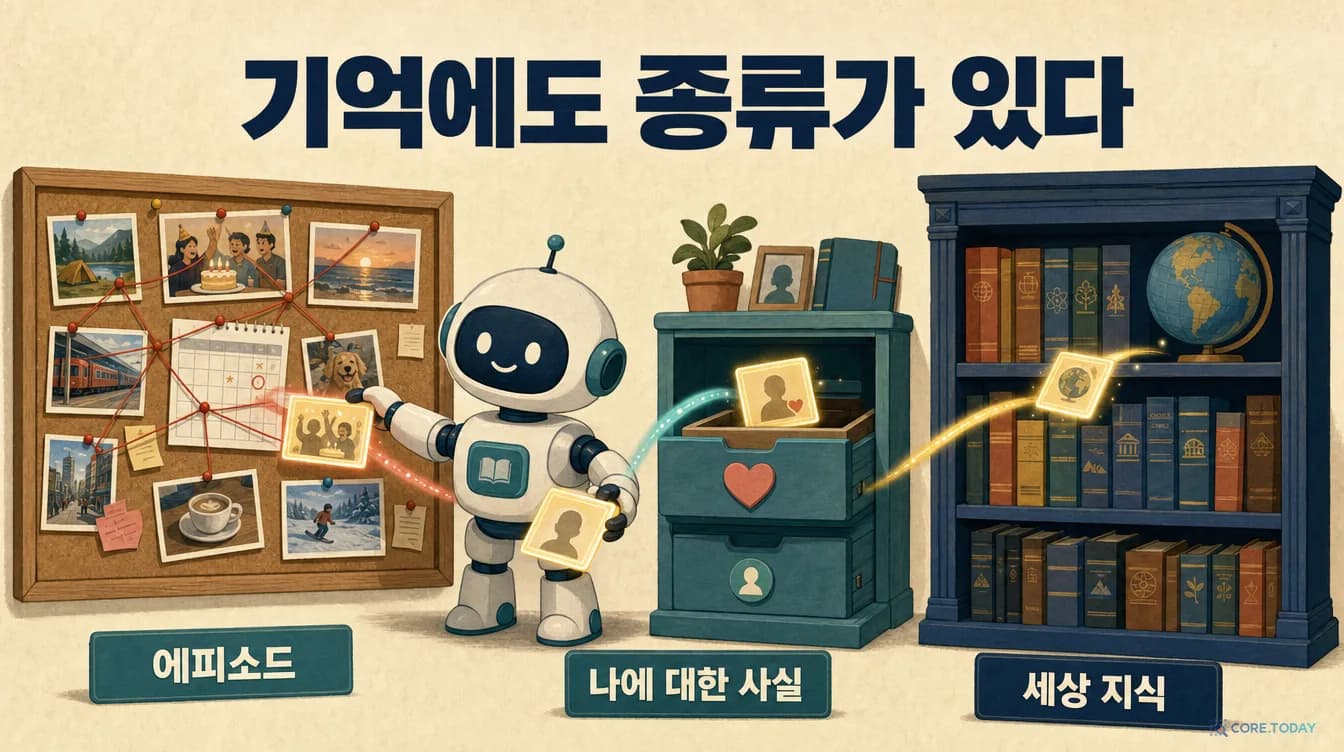
[특집] 기억에도 종류가 있다 — MemoType이 바꾼 질문: 'AI는 무엇을 기억하나'에서 '어떤 기억을, 어떻게 찾나'로
"지난달 조지랑 태산 다녀왔어"라고 말해 둔 AI에게 4주 뒤 "조지는 어디 갔었지?"라고 물으면 왜 엉뚱한 답이 돌아올까. 2026년 10월 8일 arXiv에 올라온 NeurIPS 2026 채택 논문 「Memory Type Varies」는 원인을 '모든 기억을 같은 방식으로 찾기 때문'이라고 진단한다. 1972년 심리학자 엔델 털빙이 나눈 일화 기억과 의미 기억을 대화 AI에 맞게 세 갈래(에피소드·개인 의미·일반 의미)로 다시 나누고, 6,000개 대화에 라벨을 단 TriMEM 데이터셋으로 1.7B 라우터를 학습시켜, 기억의 종류마다 다른 검색법을 쓰는 MemoType을 만들었다. 단일 검색 전략에는 넘을 수 없는 천장이 있다는 정리, 기억 구축 비용을 최대 248분의 1로 줄인 비용표까지 — 논문의 그림과 표를 하나씩 읽고, 털빙에서 ChatGPT·Claude·Gemini의 2026년 메모리까지 이어지는 계보와 함께 인터랙티브 다섯 개로 풀어 본다.
에이전트 네이티브 메모리, 준비됐나? — 12개 AI 기억 시스템을 데이터베이스의 눈으로 해부한 2026년 보고서
ChatGPT도, Claude도, Copilot도 이제 '기억'을 판다. 그런데 어떤 기억이 좋은 기억인지 아무도 같은 자로 재 본 적이 없었다. 상하이교통대·칭화대·MemTensor 연구진이 12개 메모리 시스템을 11개 데이터셋에서 같은 조건으로 돌리고, 기억을 '표현·추출·검색·유지보수' 네 모듈로 뜯어 한 부품씩 바꿔 가며 측정했다. 결론은 불편하다. 만능 챔피언은 없고, 요약은 정보를 지우며, 정밀한 사실 추출은 추론을 무너뜨리고, 그래프는 정확하지만 100배 느리다. 역사·개념·실험·실무 가이드까지, 인터랙티브 위젯과 함께 완전 해부한다.