
#편집 거리
2개의 포스트
‘23% 틀렸다’와 ‘4% 틀렸다’는 같은 받아쓰기다 — WER·CER, 한국어는 왜 글자로 재나 (특집)
WER(단어 오류율)과 CER(글자 오류율)은 음성 인식기의 받아쓰기를 채점하는 표준 성적표다. 정답과 받아쓰기를 나란히 놓고 대체·삭제·삽입의 수를 세어 정답 길이로 나눈다. 1965년의 편집 거리에서 출발해 1988년 DARPA 벤치마크에서 지금의 모습을 갖췄고, 2016년 ‘사람 수준’ 논쟁을 거쳐 지금도 모든 음성 인식 모델의 성적이 이 숫자로 매겨진다. 이 글은 한국어가 왜 단어가 아니라 글자로 재는지를 띄어쓰기와 어절에서 풀고, 공개 모델 Whisper 6종을 한국어 시험 세트 두 개로 직접 재서 어절 WER 22.6%와 CER 4.3%가 같은 받아쓰기에서 나온다는 것, 어절 오류의 64%가 띄어쓰기 차이라는 것, 숫자 표기 규칙 하나로 CER이 26% 달라진다는 것을 보여 준다. 무음에 뉴스 앵커의 인사를 지어내는 환각, 같은 점수 속의 다른 피해까지 따라간다. 인터랙티브 위젯 6종, 코어닷투데이 실측, 삽화 12장.
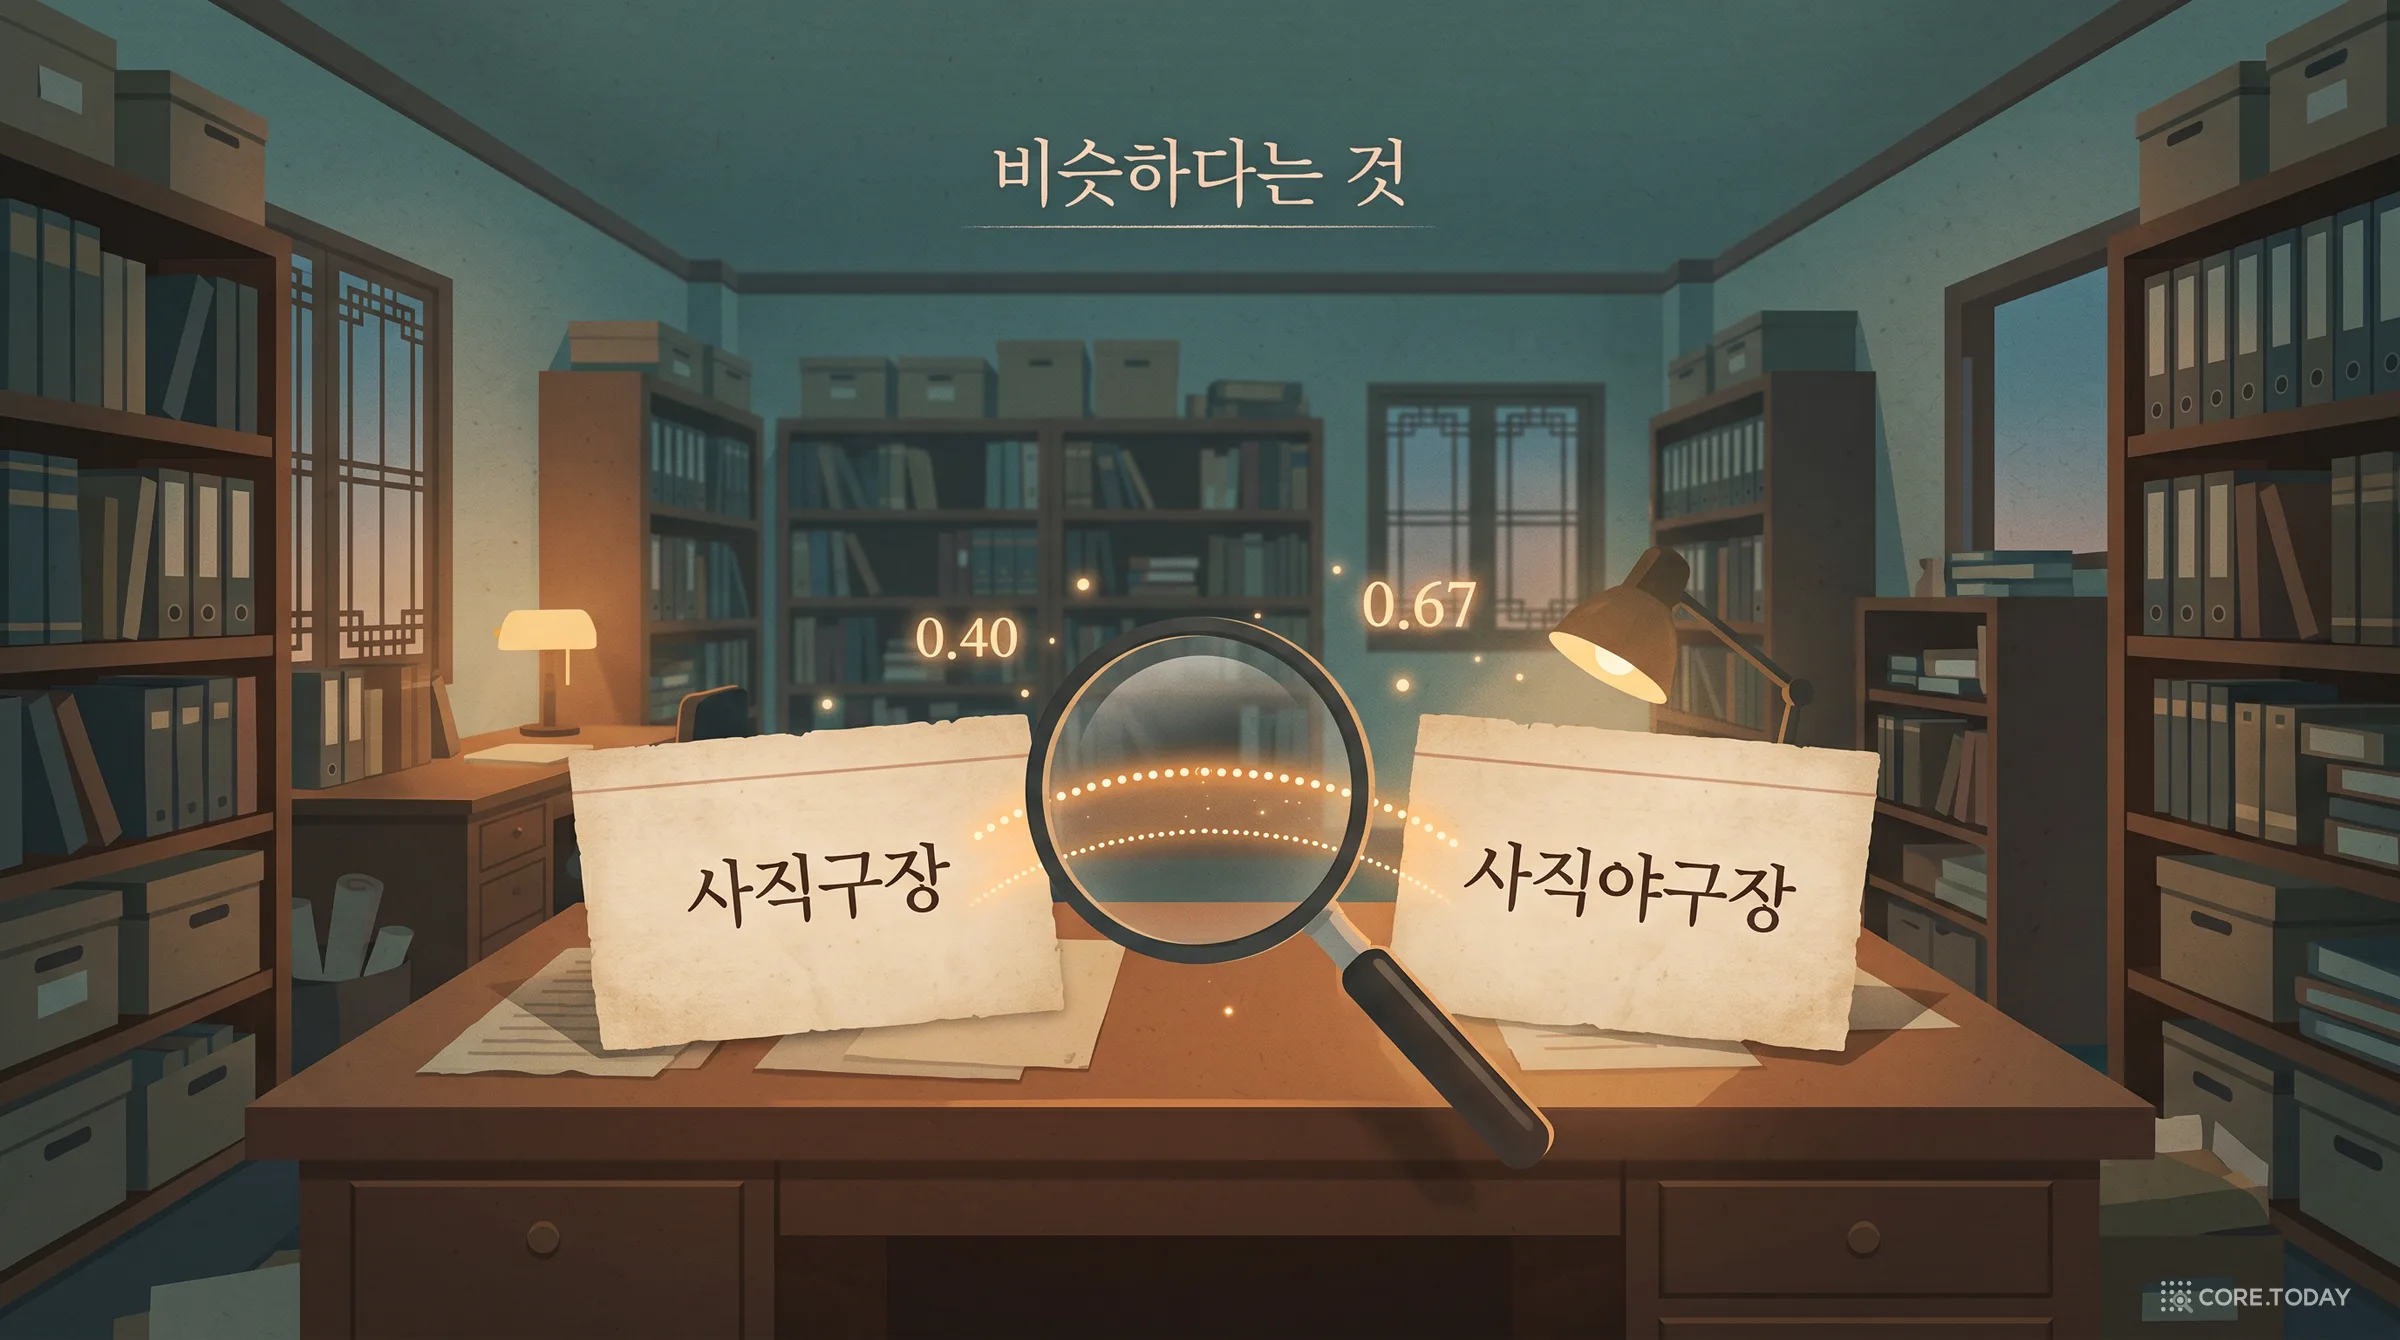
‘비슷하다’는 네 가지 질문이다 — 알프스 꽃밭의 자카드에서 2026년 한국어 사실탐색기까지, 유사도 125년
2026년 10월, 코어닷투데이 사실탐색기는 부산 조례 부칙의 '1981년 1월 1일부터 시행'과 '1984년 1월 1일부터 시행'을 같은 값으로 묶었습니다. 두 문장이 71% 비슷하다는 계산 때문이었습니다. 이 글은 '비슷하다'를 재는 기술이 왜 생겨났는지부터 시작합니다. 1901년 알프스 식물 목록을 비교한 자카드, 인구조사 이름을 소리로 묶은 사운덱스, 단어를 벡터로 바꾼 설턴과 IDF의 스파크 존스, 뜻을 좌표로 만든 임베딩까지요. 그리고 같은 기술이 한국어 공적 기록 앞에서 어디서 미끄러지는지, 2026년 임베딩 14종 실측과 최신 논문으로 따라갑니다. 결론은 하나입니다. '비슷하다'는 같은 대상·같은 값·같은 사건·비슷한 사안이라는 네 가지 다른 질문이고, 질문마다 도구가 다릅니다.