
#Zep
7개의 포스트
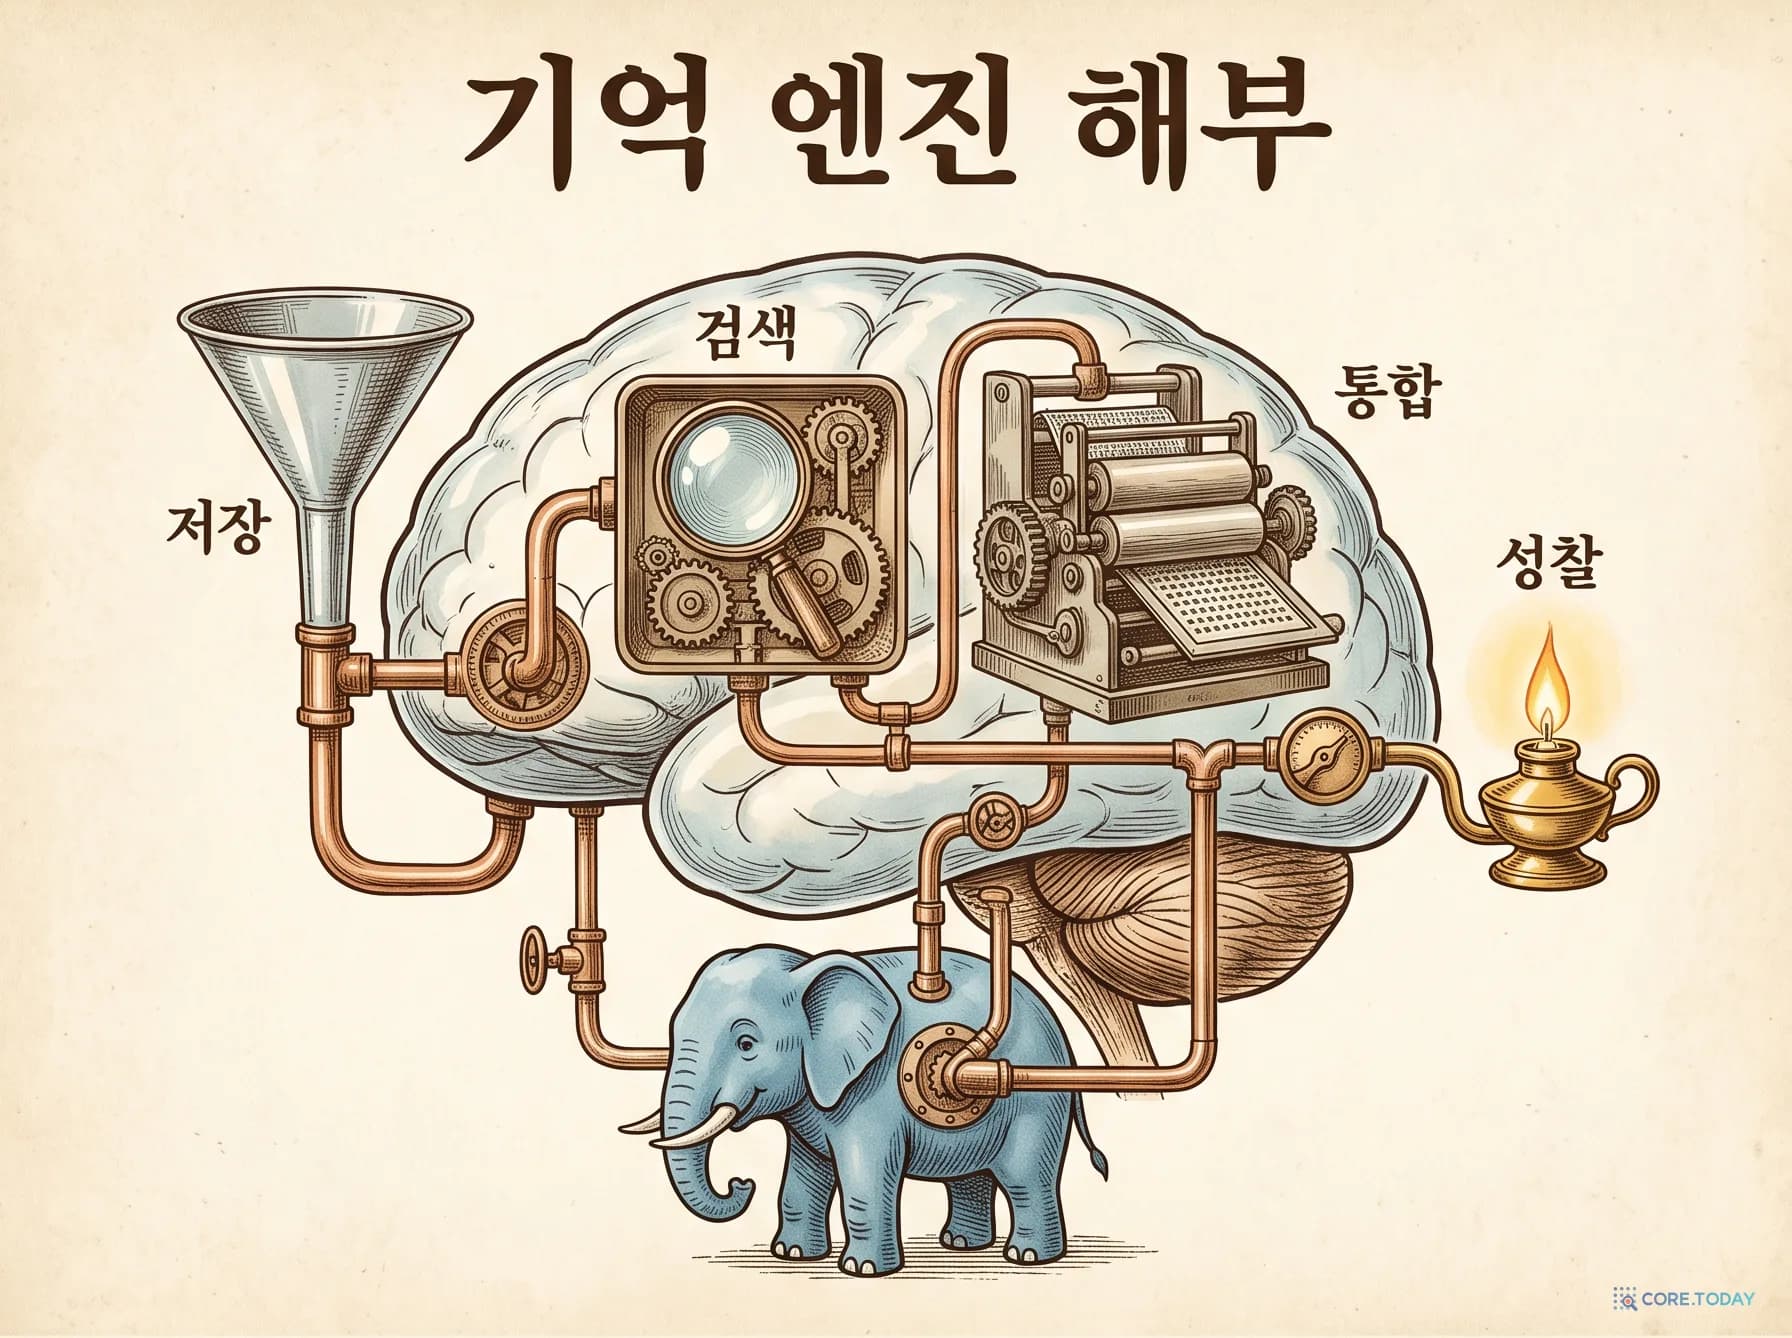
에이전트 기억 엔진 해부 — Hindsight의 코드를 열고 Mem0·Graphiti·Letta·Cognee를 나란히 눕혔다
논문 대신 코드를 열었다. GitHub 별 5만 개가 넘는 Hindsight의 저장·검색·통합·성찰 경로를 상수와 공식, 파일 위치까지 따라가고, 같은 칼로 Mem0·Graphiti·Letta·Cognee를 해부했다. 핵심은 '고전 검색 기법 + LLM 판단'의 분업이다. 엔티티는 임베딩이 아니라 글자 조각으로 합치고, 순위는 점수가 아니라 등수로 섞고, 쉬운 판단은 LLM이 아니라 1초짜리 결정 모델이 내린다. 그리고 다섯 엔진 모두 '잊는 법'은 구현하지 않았다. Mem0이 2026년 4월 그래프와 UPDATE를 버린 이유, Graphiti의 RRF 상수가 60이 아니라 1인 이유, Letta가 기억을 git 저장소로 바꾼 이유, 그리고 한국어 이름 '김민지'와 '민지'가 왜 한 사람으로 합쳐지지 않는지까지 — 인터랙티브 위젯 7개로 직접 돌려 본다.
메모리 벤치마크 점수, 믿어도 되나 — LoCoMo·LongMemEval을 직접 다시 채점해 봤다
2026년 에이전트 기억 업계는 LoCoMo·LongMemEval에서 90점대를 발표합니다. 하지만 같은 Zep의 LoCoMo 점수는 누가 쟀느냐에 따라 58점에서 95점까지 흩어져 있습니다. 두 벤치마크를 직접 다시 돌렸습니다. 기억 시스템 없이 대화를 통째로 넣은 2026년 저가 모델이 LoCoMo 80.7%, LongMemEval 81.6%로 2025년의 기억 시스템들을 넘었습니다. 같은 답에 채점 프롬프트만 바꾸자 점수가 26점 움직였고, 정답과 오답을 나란히 적은 답을 Mem0의 2026년 채점 프롬프트는 100% 정답 처리했습니다. LoCoMo 정답지 1,540개를 대화 원문과 대조하니 7%가 틀렸거나 모호했고, 대화 10개에 몰린 문항이라 95% 구간은 ±3.1점이었습니다. bAbI부터 건초더미 속 바늘, SWE-bench Verified의 은퇴까지 벤치마크의 역사와, 점수를 읽는 점검표 10문항을 함께 정리했습니다. 인터랙티브 6개.
옛 사실은 정말 닫히나 — Graphiti에 한국어 상담 로그 240건을 넣어 직접 재 봤다
지난 글에서 코드를 읽고 짚은 Graphiti의 약점을 도커 위에서 직접 재 봤습니다. 가상의 고객 10명이 1년 동안 남긴 한국어 상담 240마디를 넣고, 7일 간격으로 '그래프는 이 사실을 참이라고 보는가'를 정답과 대조했습니다. 결과는 한 문장으로 요약됩니다. 시간 그래프의 품질은 추출 모델이 아니라 모순을 판정하는 '작은 모델'이 정합니다. 기본값(gpt-4.1-nano)으로 두면 클라이밍을 시작했다는 한 마디가 집·직장·약 기록을 한꺼번에 닫았고, 판정만 gpt-4.1-mini로 바꾸자 잘못 닫힌 사실이 0건이 됐습니다. 그래도 이사·이직의 40%는 끝까지 닫히지 않았고, 이를 고치려는 PR #1729는 반대로 변경 반영률을 20%까지 떨어뜨렸습니다. 한국어 키워드 검색은 기본 분석기에서 질문 80개 중 43개가 빈 결과였고, cjk 분석기로 바꾸자 적중률이 23.7%에서 58.8%로 올랐습니다. 실행 8번, 에피소드 1,920건, 인터랙티브 5개.
기억에 유효기간을 적다 — Graphiti 시간 그래프, 개념부터 코드까지
AI 비서가 '서울 사세요?'라고 묻는다면, 그건 기억을 못 해서가 아니라 기억은 하는데 언제의 기억인지를 몰라서입니다. Graphiti는 사실마다 '참이었던 기간'과 '알게 된 때'라는 두 개의 시계를 달아, 옛 사실을 지우지 않고 닫습니다. 1986년 데이터베이스 연구자들이 만든 이중 시간 모델이 어떻게 2026년 에이전트 메모리의 핵심이 됐는지, 네 개의 타임스탬프가 무엇을 뜻하는지, 옛 사실이 닫히는 규칙이 실제 코드에서 어떻게 생겼는지를 처음부터 따라갑니다. 다섯 개의 인터랙티브와 그림으로 시간 그래프를 직접 만져 봅니다.
에이전트 네이티브 메모리, 준비됐나? — 12개 AI 기억 시스템을 데이터베이스의 눈으로 해부한 2026년 보고서
ChatGPT도, Claude도, Copilot도 이제 '기억'을 판다. 그런데 어떤 기억이 좋은 기억인지 아무도 같은 자로 재 본 적이 없었다. 상하이교통대·칭화대·MemTensor 연구진이 12개 메모리 시스템을 11개 데이터셋에서 같은 조건으로 돌리고, 기억을 '표현·추출·검색·유지보수' 네 모듈로 뜯어 한 부품씩 바꿔 가며 측정했다. 결론은 불편하다. 만능 챔피언은 없고, 요약은 정보를 지우며, 정밀한 사실 추출은 추론을 무너뜨리고, 그래프는 정확하지만 100배 느리다. 역사·개념·실험·실무 가이드까지, 인터랙티브 위젯과 함께 완전 해부한다.
Zep 생태계 지도 — Graphiti, Konig, Context Lake는 각각 무슨 일을 하나
반년 전 Zep 논문을 해부할 때는 'Zep의 엔진은 Graphiti'라는 한 줄로 충분했습니다. 지금은 Konig, Context Lake, Memory MCP 서버, Graphiti MCP 서버처럼 이름이 늘어 누가 무슨 일을 하는지 헷갈립니다. 이 글은 도서관에 빗대어 문·접수대·사서·서고·대출 데스크·관리 규정 여섯 층으로 생태계를 정리하고, 문장 하나가 기억이 되기까지 어느 구성요소를 거치는지 위젯으로 따라갑니다. 열린 것과 닫힌 것, 요금과 크레딧 계산법, 직접 운영과 서비스 이용 중 무엇을 고를지도 함께 다룹니다.
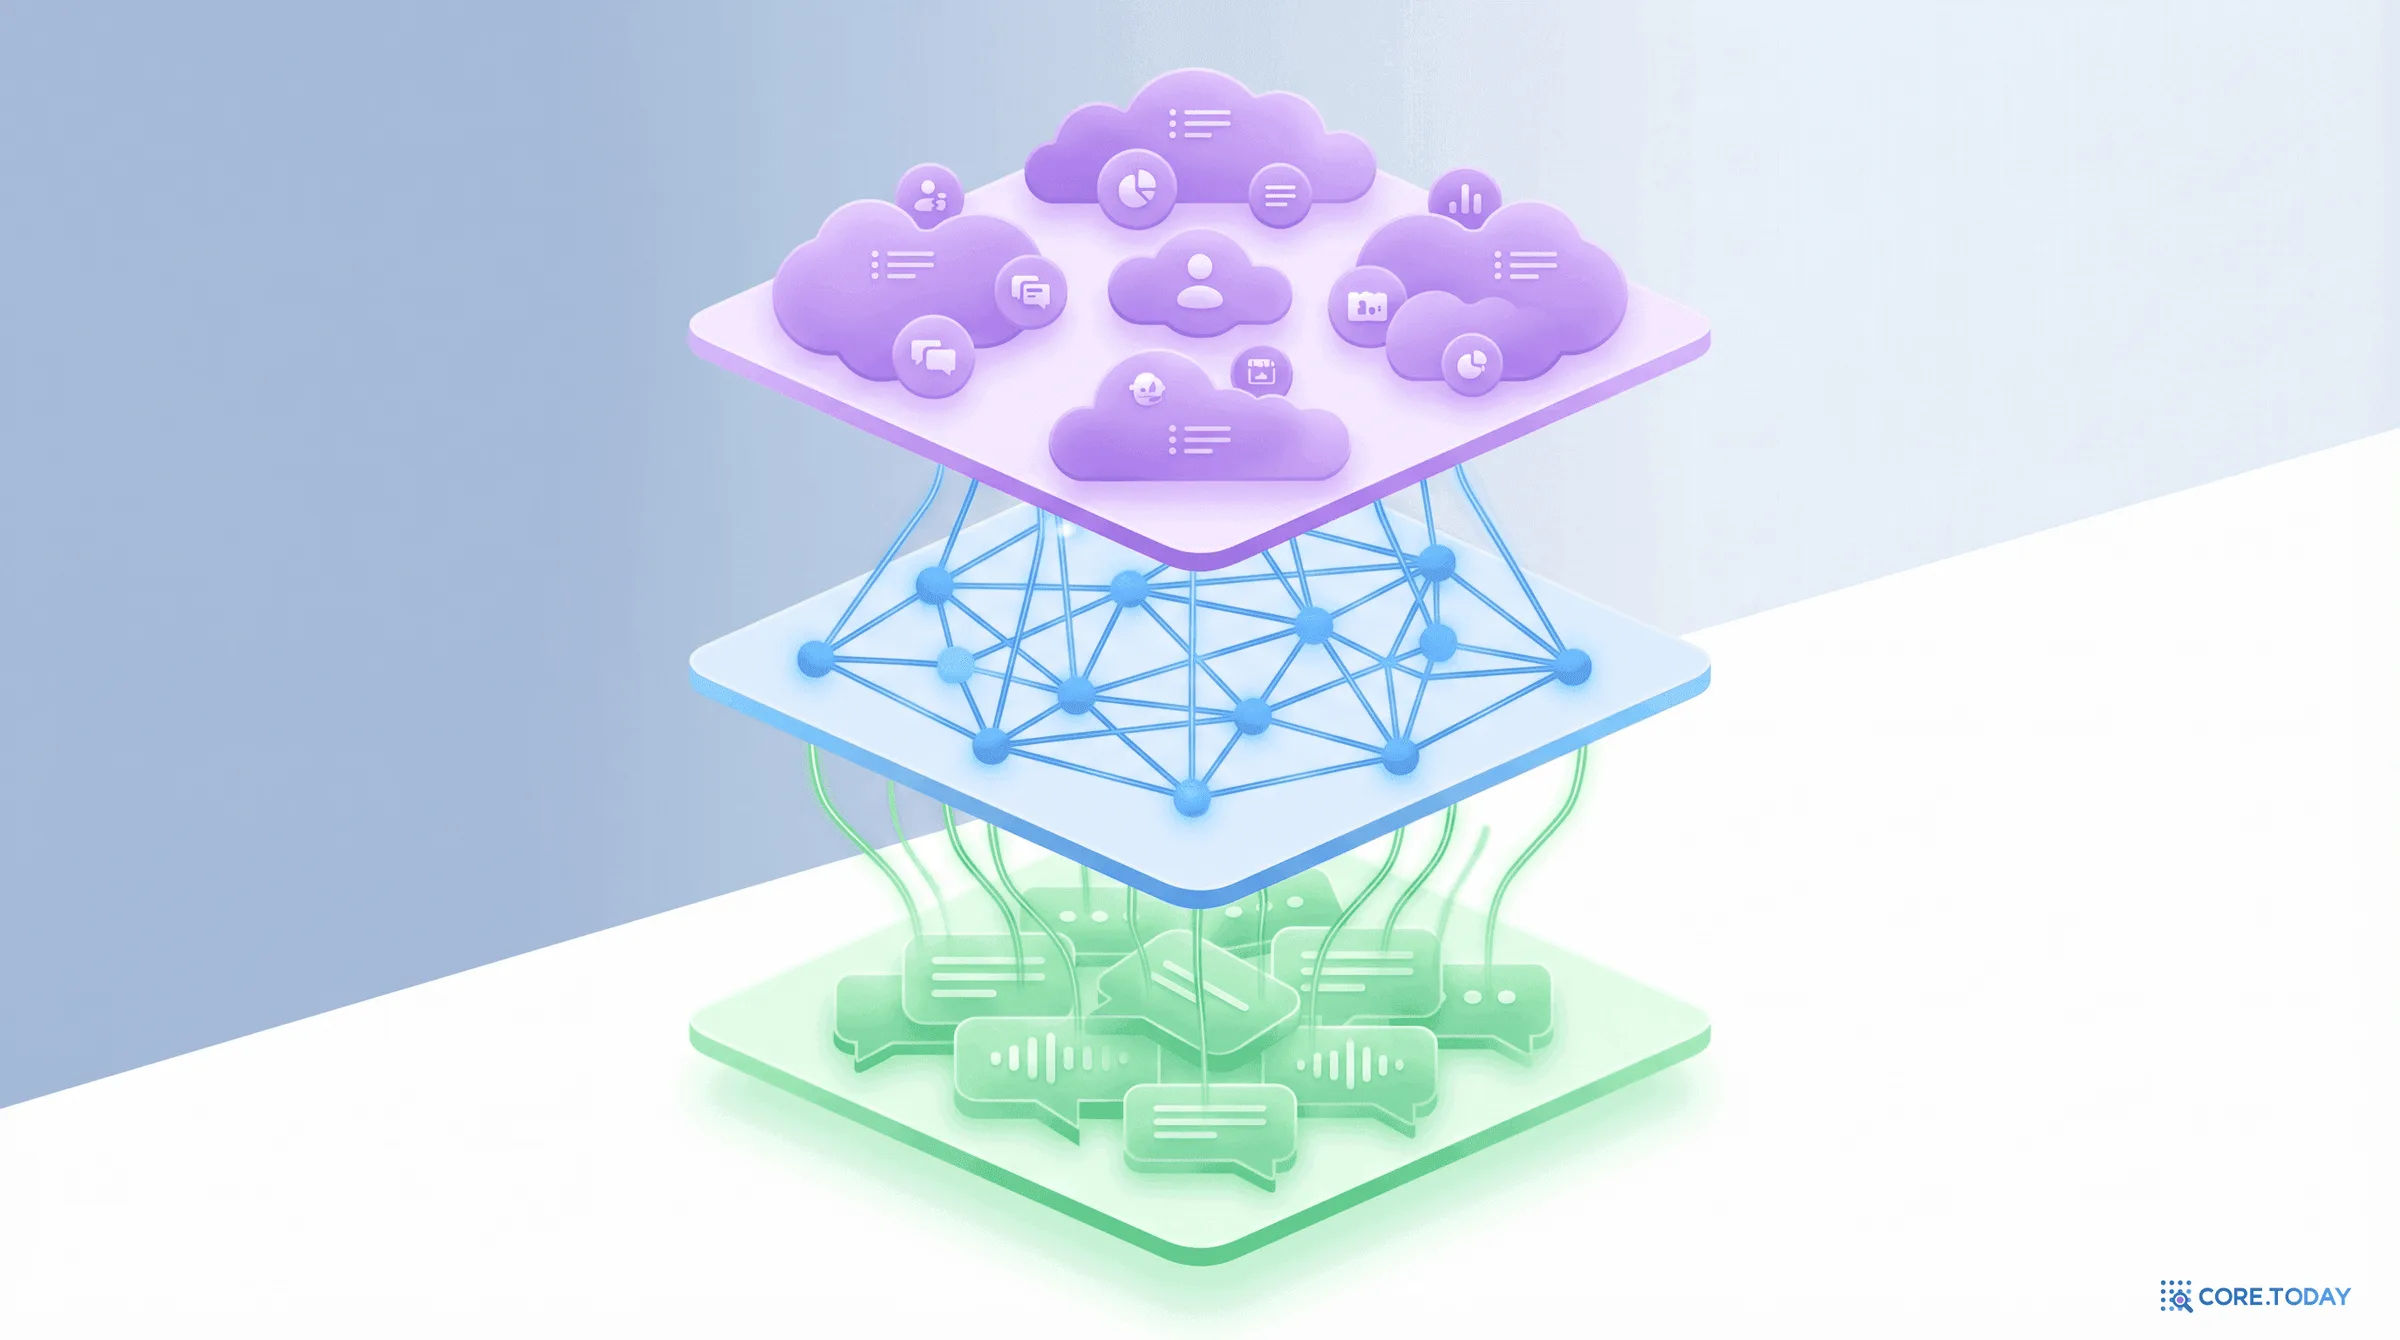
Zep 논문 해부: AI 에이전트에게 '시간을 아는 기억'을 선물하다
AI 에이전트가 어제 대화를 기억하지 못한다면? Zep은 시간 인식 지식 그래프(Temporal Knowledge Graph)로 이 문제를 해결한다. 3계층 그래프 구조, 이중 시간축 모델, 동적 엣지 무효화 — MemGPT를 넘어 LongMemEval에서 최대 18.5%(상대) 정확도 향상과 90% 레이턴시 감소를 달성한 Zep의 핵심을 완전 해부한다.