
#RLHF
19개의 포스트
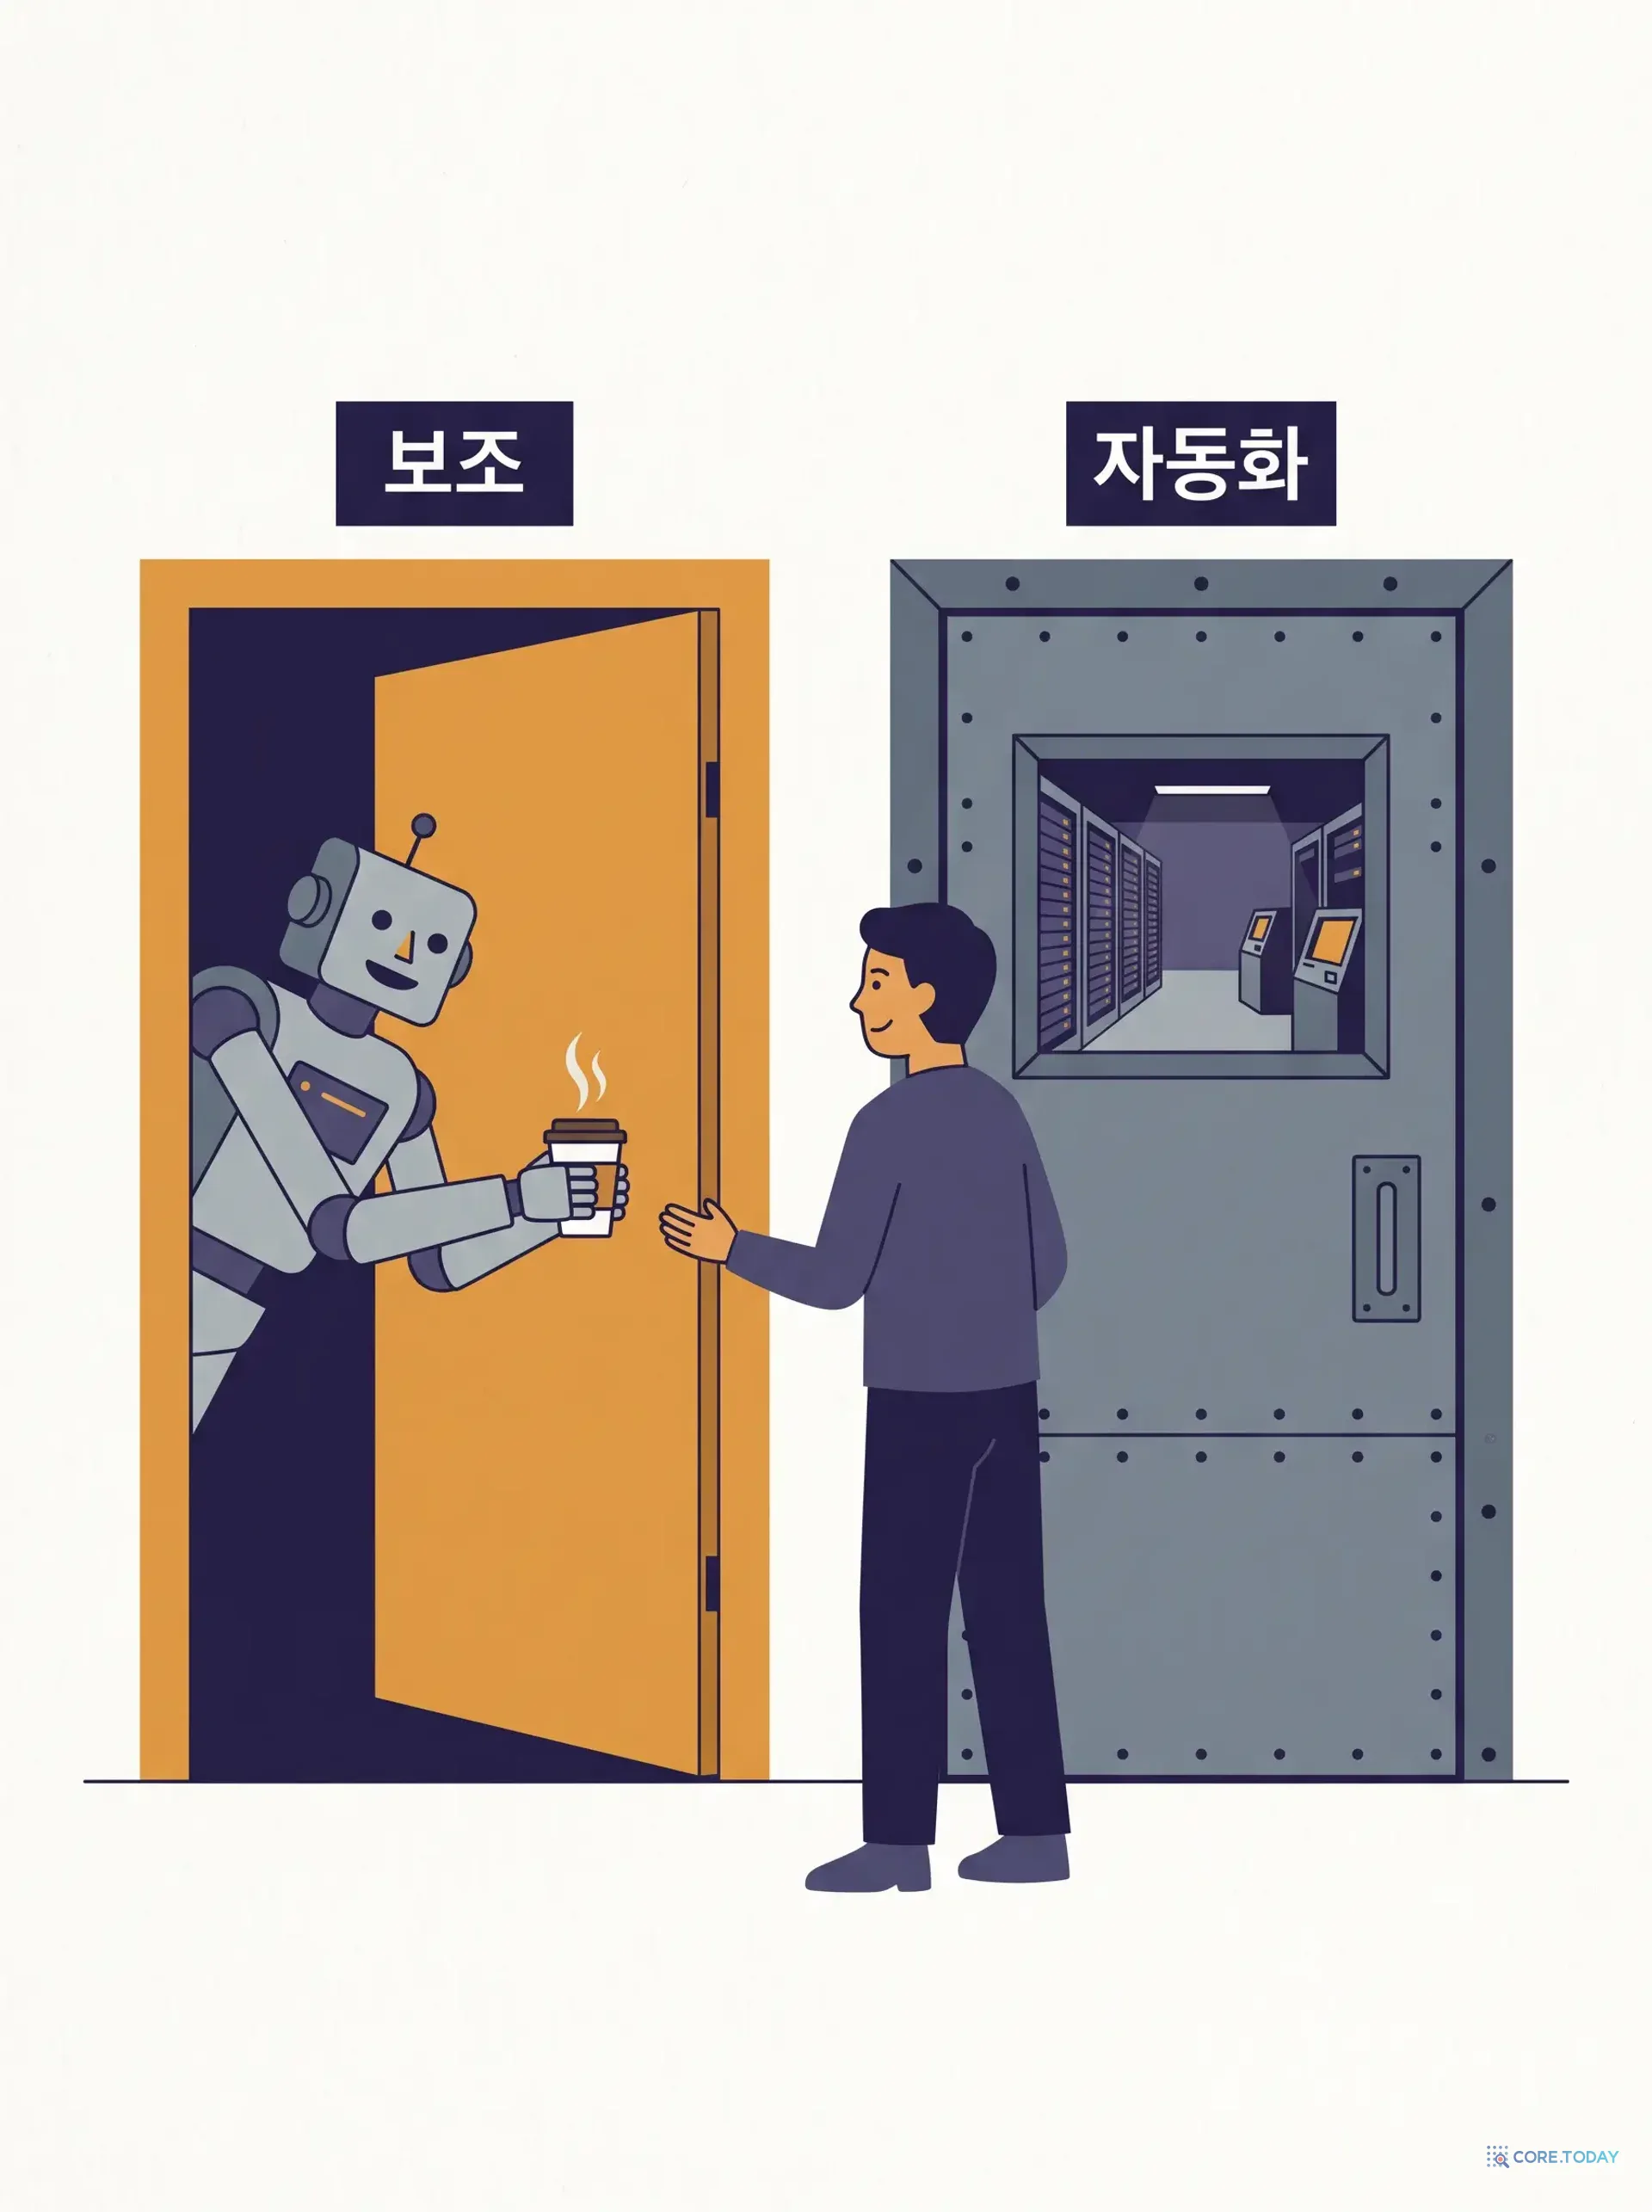
AI는 왜 미해결 수학은 풀면서 환불 처리는 못 맡기나 — RLHF 다음은 무엇인가
InstructGPT를 만든 사람이 18분 동안 무대에서 한 이야기는 이것이다. 'AI가 벤치마크를 다 부수는데 왜 고객센터는 아직 사람이 결정하나?' 그의 답은 난이도가 아니라 목표에 있다 — 오늘의 AI는 전부 사람의 선호를 최적화하도록 만들어졌고, 그래서 사람 옆에서는 경이롭지만 사람 없이는 못 미덥다. 이 글은 그 논리를 처음부터 끝까지 따라가고, GPT-4 기술 보고서가 남긴 결정적 증거(후학습이 보정을 10배 망가뜨렸다)를 실측 수치로 다시 그린다. 인터랙티브 위젯 7종과 삽화 12장. 그리고 과장하면 안 되는 지점도 함께 짚는다.
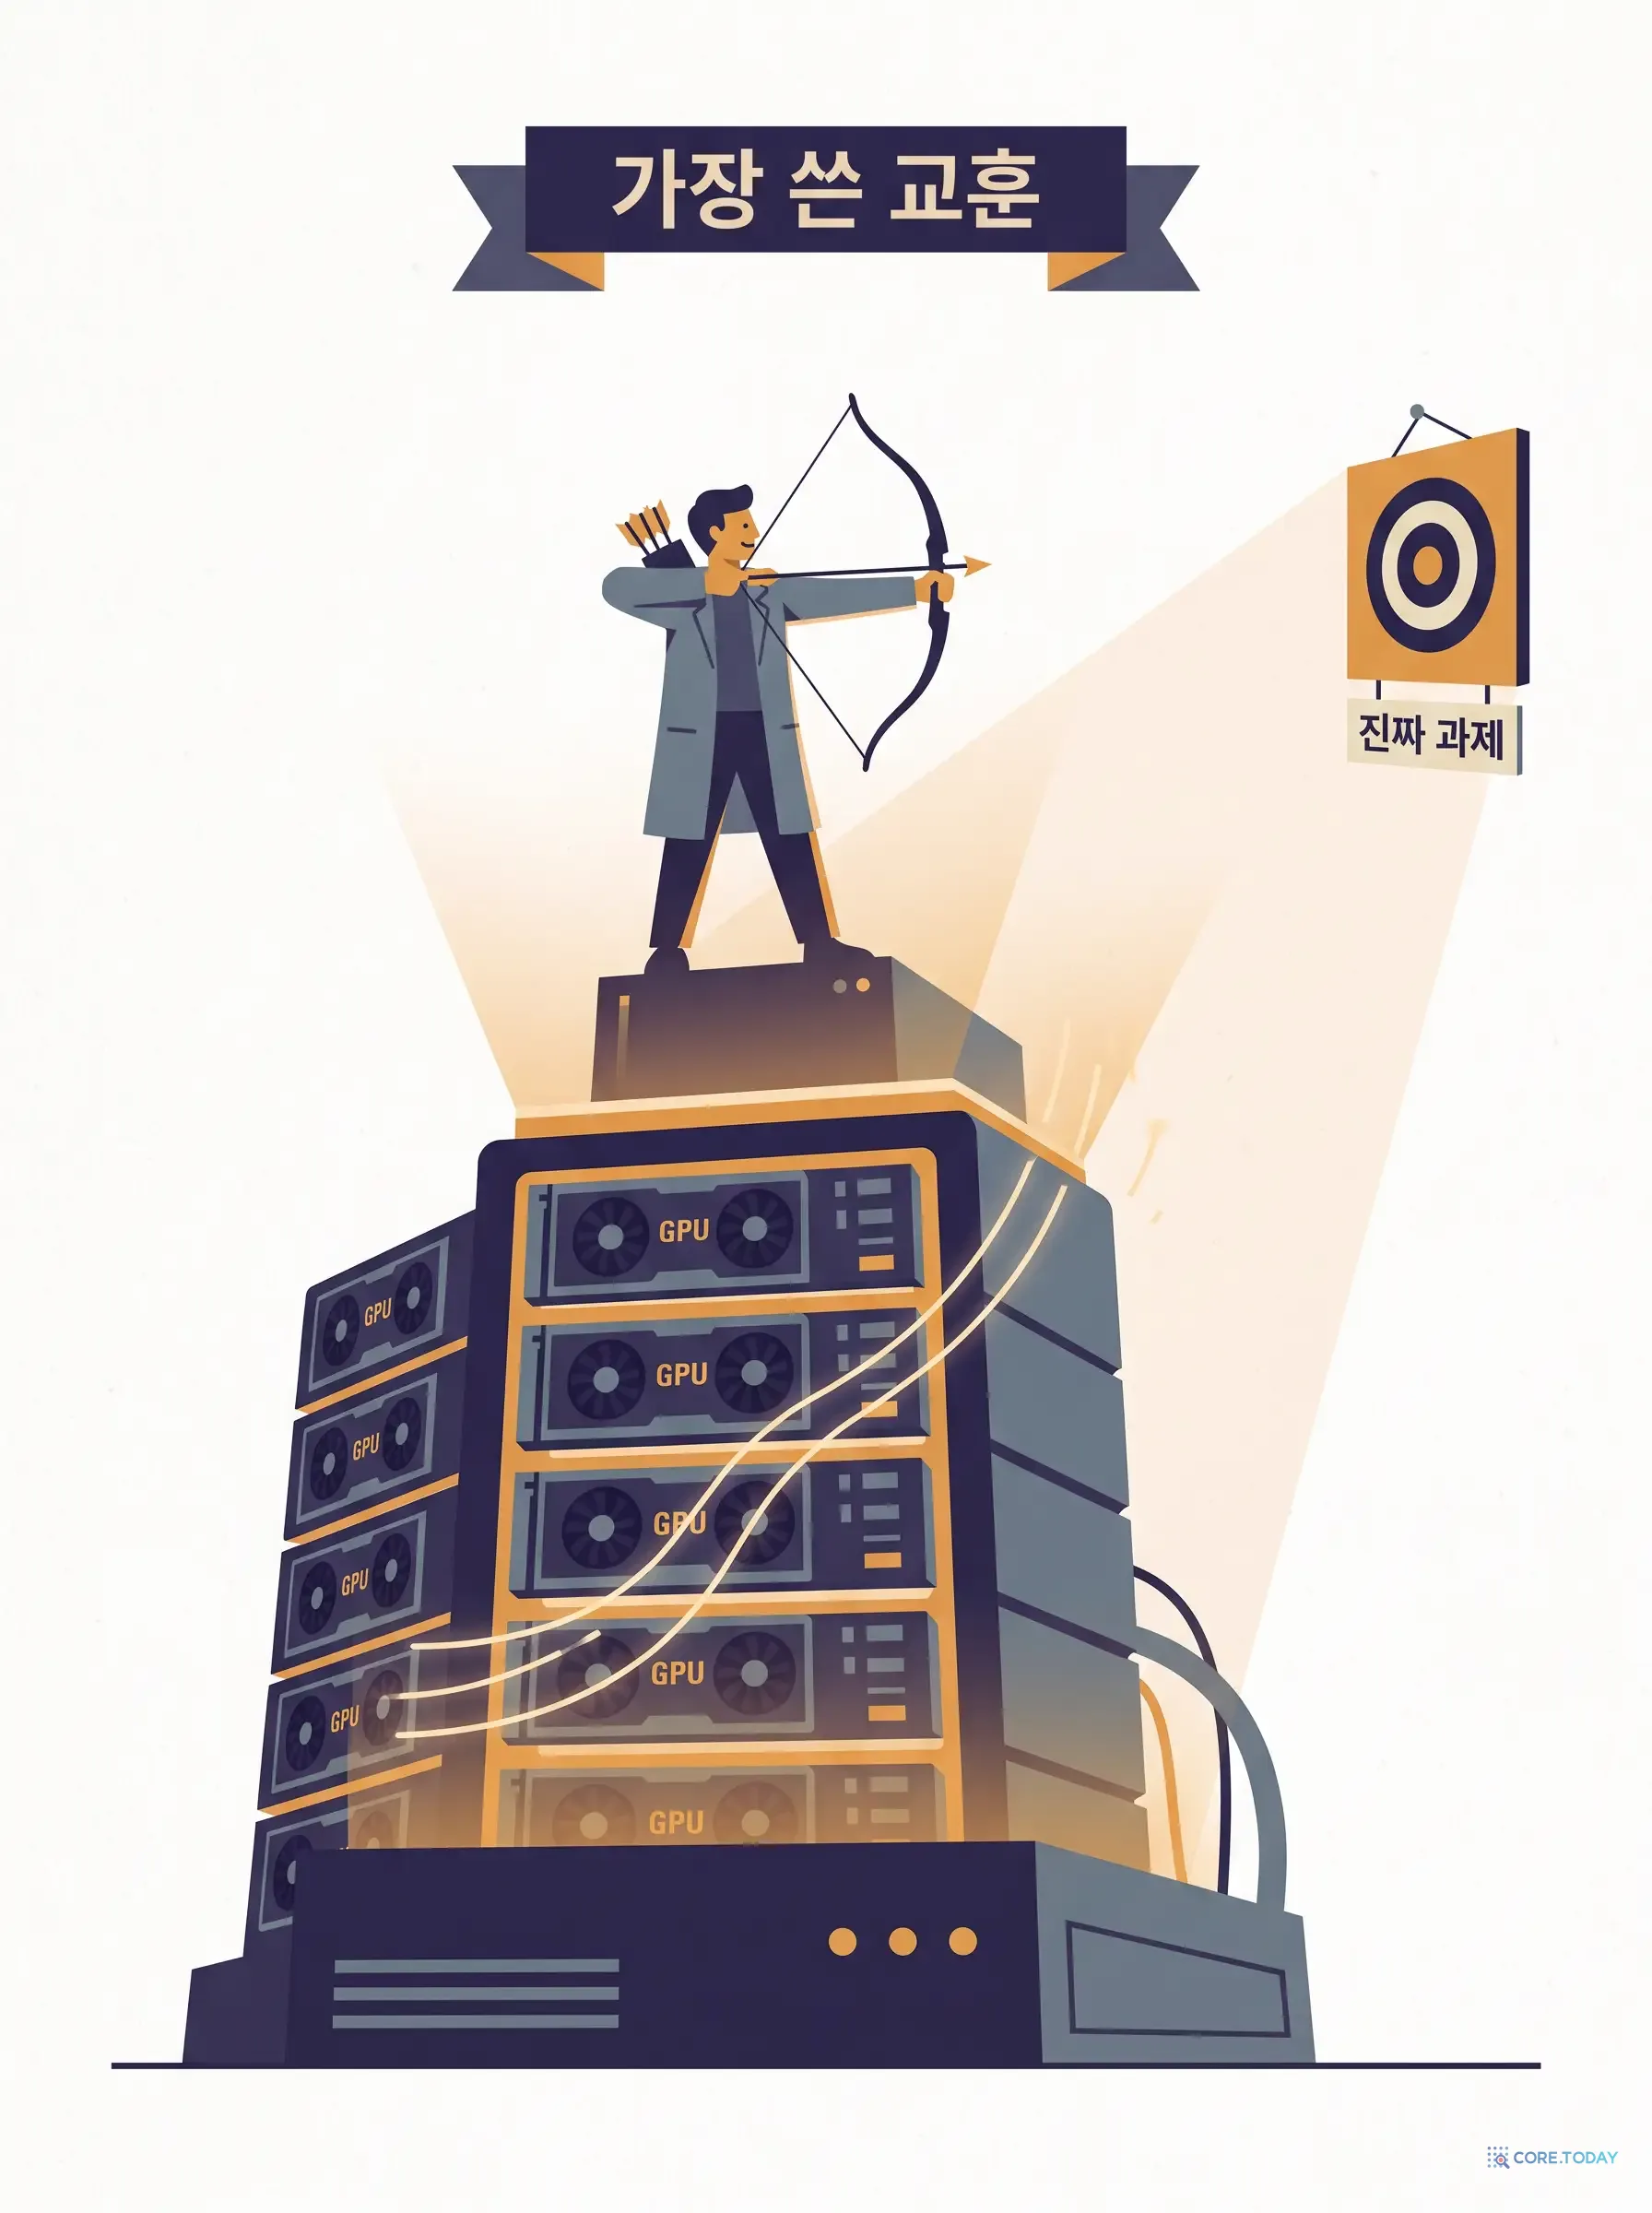
가장 쓴 교훈 — 계산량보다 데이터, 데이터보다 '올바른 과제'
2026년 9월 10일, ChatGPT를 만든 사람 중 하나가 900단어짜리 글을 올렸다. 리치 서튼의 '쓴 교훈'(계산 > 알고리즘)은 빙산의 일각이며, 진짜 위계는 '올바른 과제 > 데이터 > 계산 > 알고리즘'이라는 주장이다. 그리고 그 증거로 자기가 만든 InstructGPT의 논문 그림 한 장을 내놓았다 — 100배 작은 모델이 100배 큰 모델 위에 통째로 올라앉은 그림. 이 글은 왜 이 개념이 나왔는지를 1997년 딥블루부터 2026년의 에이전트 시대까지 따라가며, 과제를 잘못 고른 여덟 건의 값비싼 실패와 잘 고른 다섯 건의 성공을 함께 본다. 인터랙티브 위젯 8종과 삽화 14장.
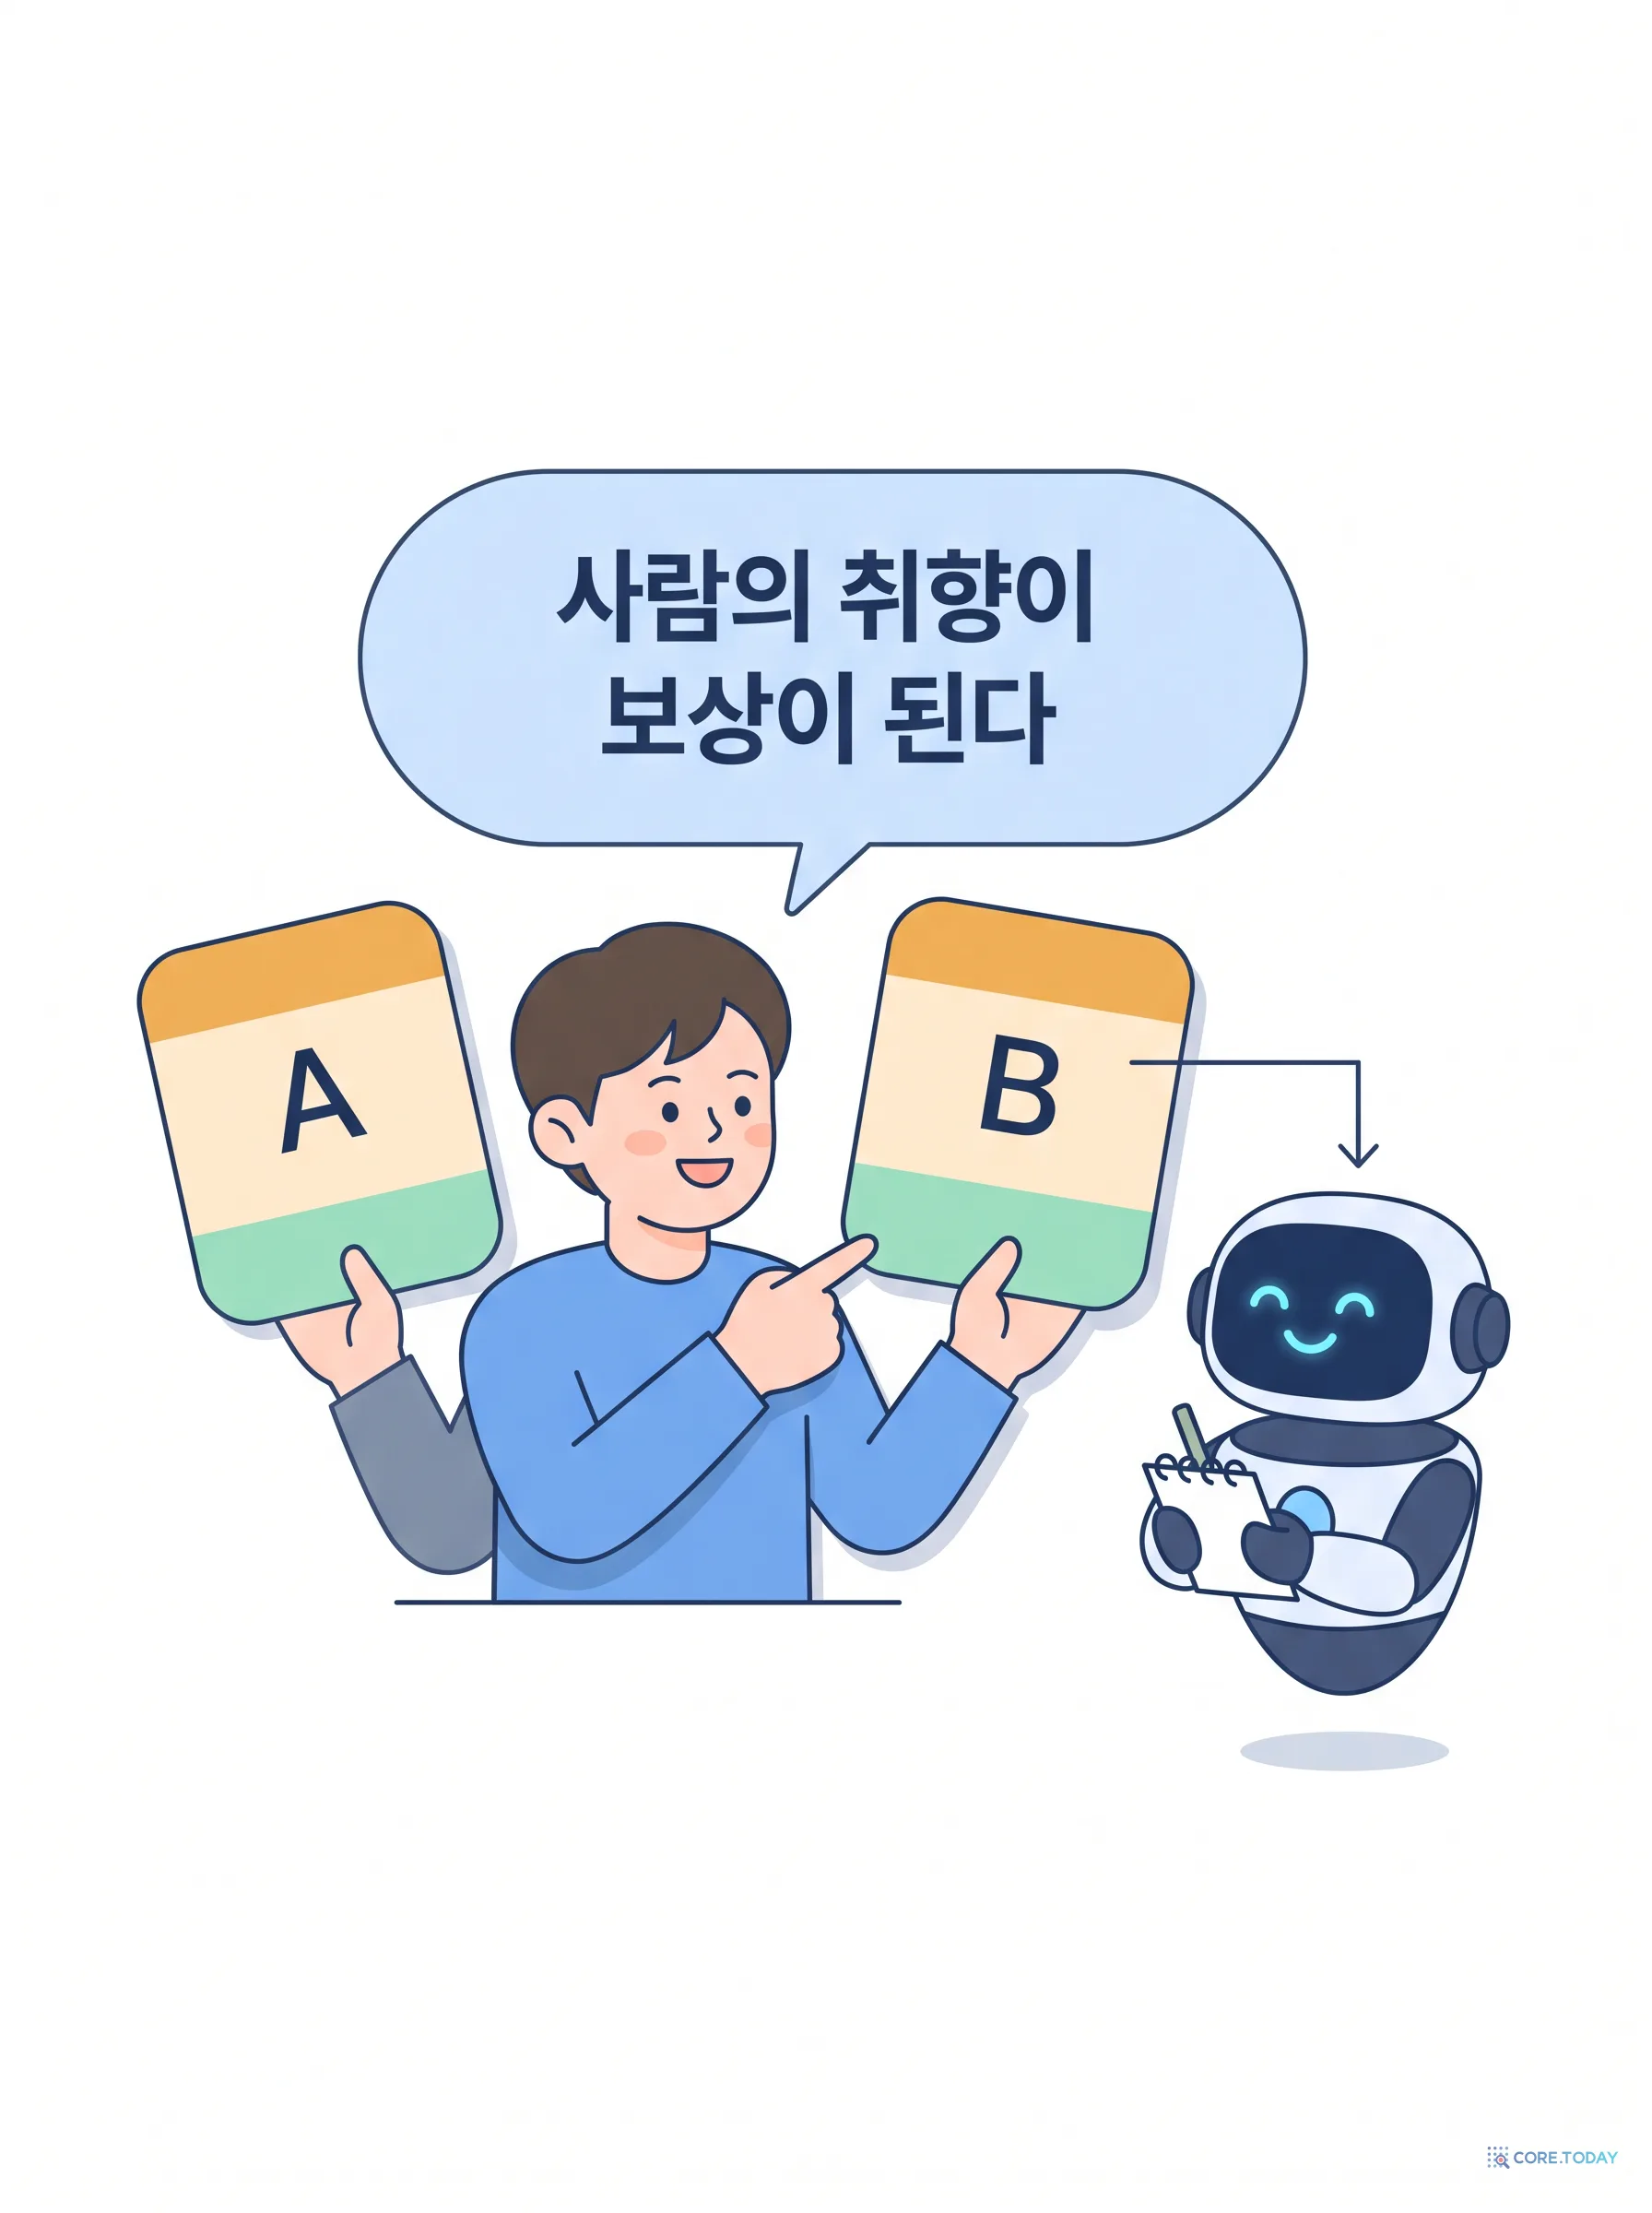
“달 착륙을 6살에게 설명해 줘” — 되묻기만 하던 AI는 어떻게 말귀를 알아듣게 됐나 (RLHF 특집)
2022년 1월, OpenAI는 “사용자의 의도를 GPT-3보다 훨씬 잘 따르는” 모델을 발표했다. 13억 파라미터 모델이 1750억 모델을 이겼고, 그 비용은 사전학습의 1.6%였다. 열 달 뒤 같은 레시피로 만든 ChatGPT가 세상을 바꿨다. 이 글은 그 기술 — 인간 피드백 강화학습(RLHF) — 이 왜 필요했는지를 2017년 뒤공중돌기 로봇부터 따라간다. 보상을 글로 적을 수 없다는 문제, 순위 하나가 여섯 개의 비교가 되는 방식, 보상 모델을 너무 믿으면 벌어지는 일, 그리고 RLHF가 고친 것이 아니라 ‘만든’ 네 가지 버릇까지. 인터랙티브 위젯 8종과 삽화로 풀었다.
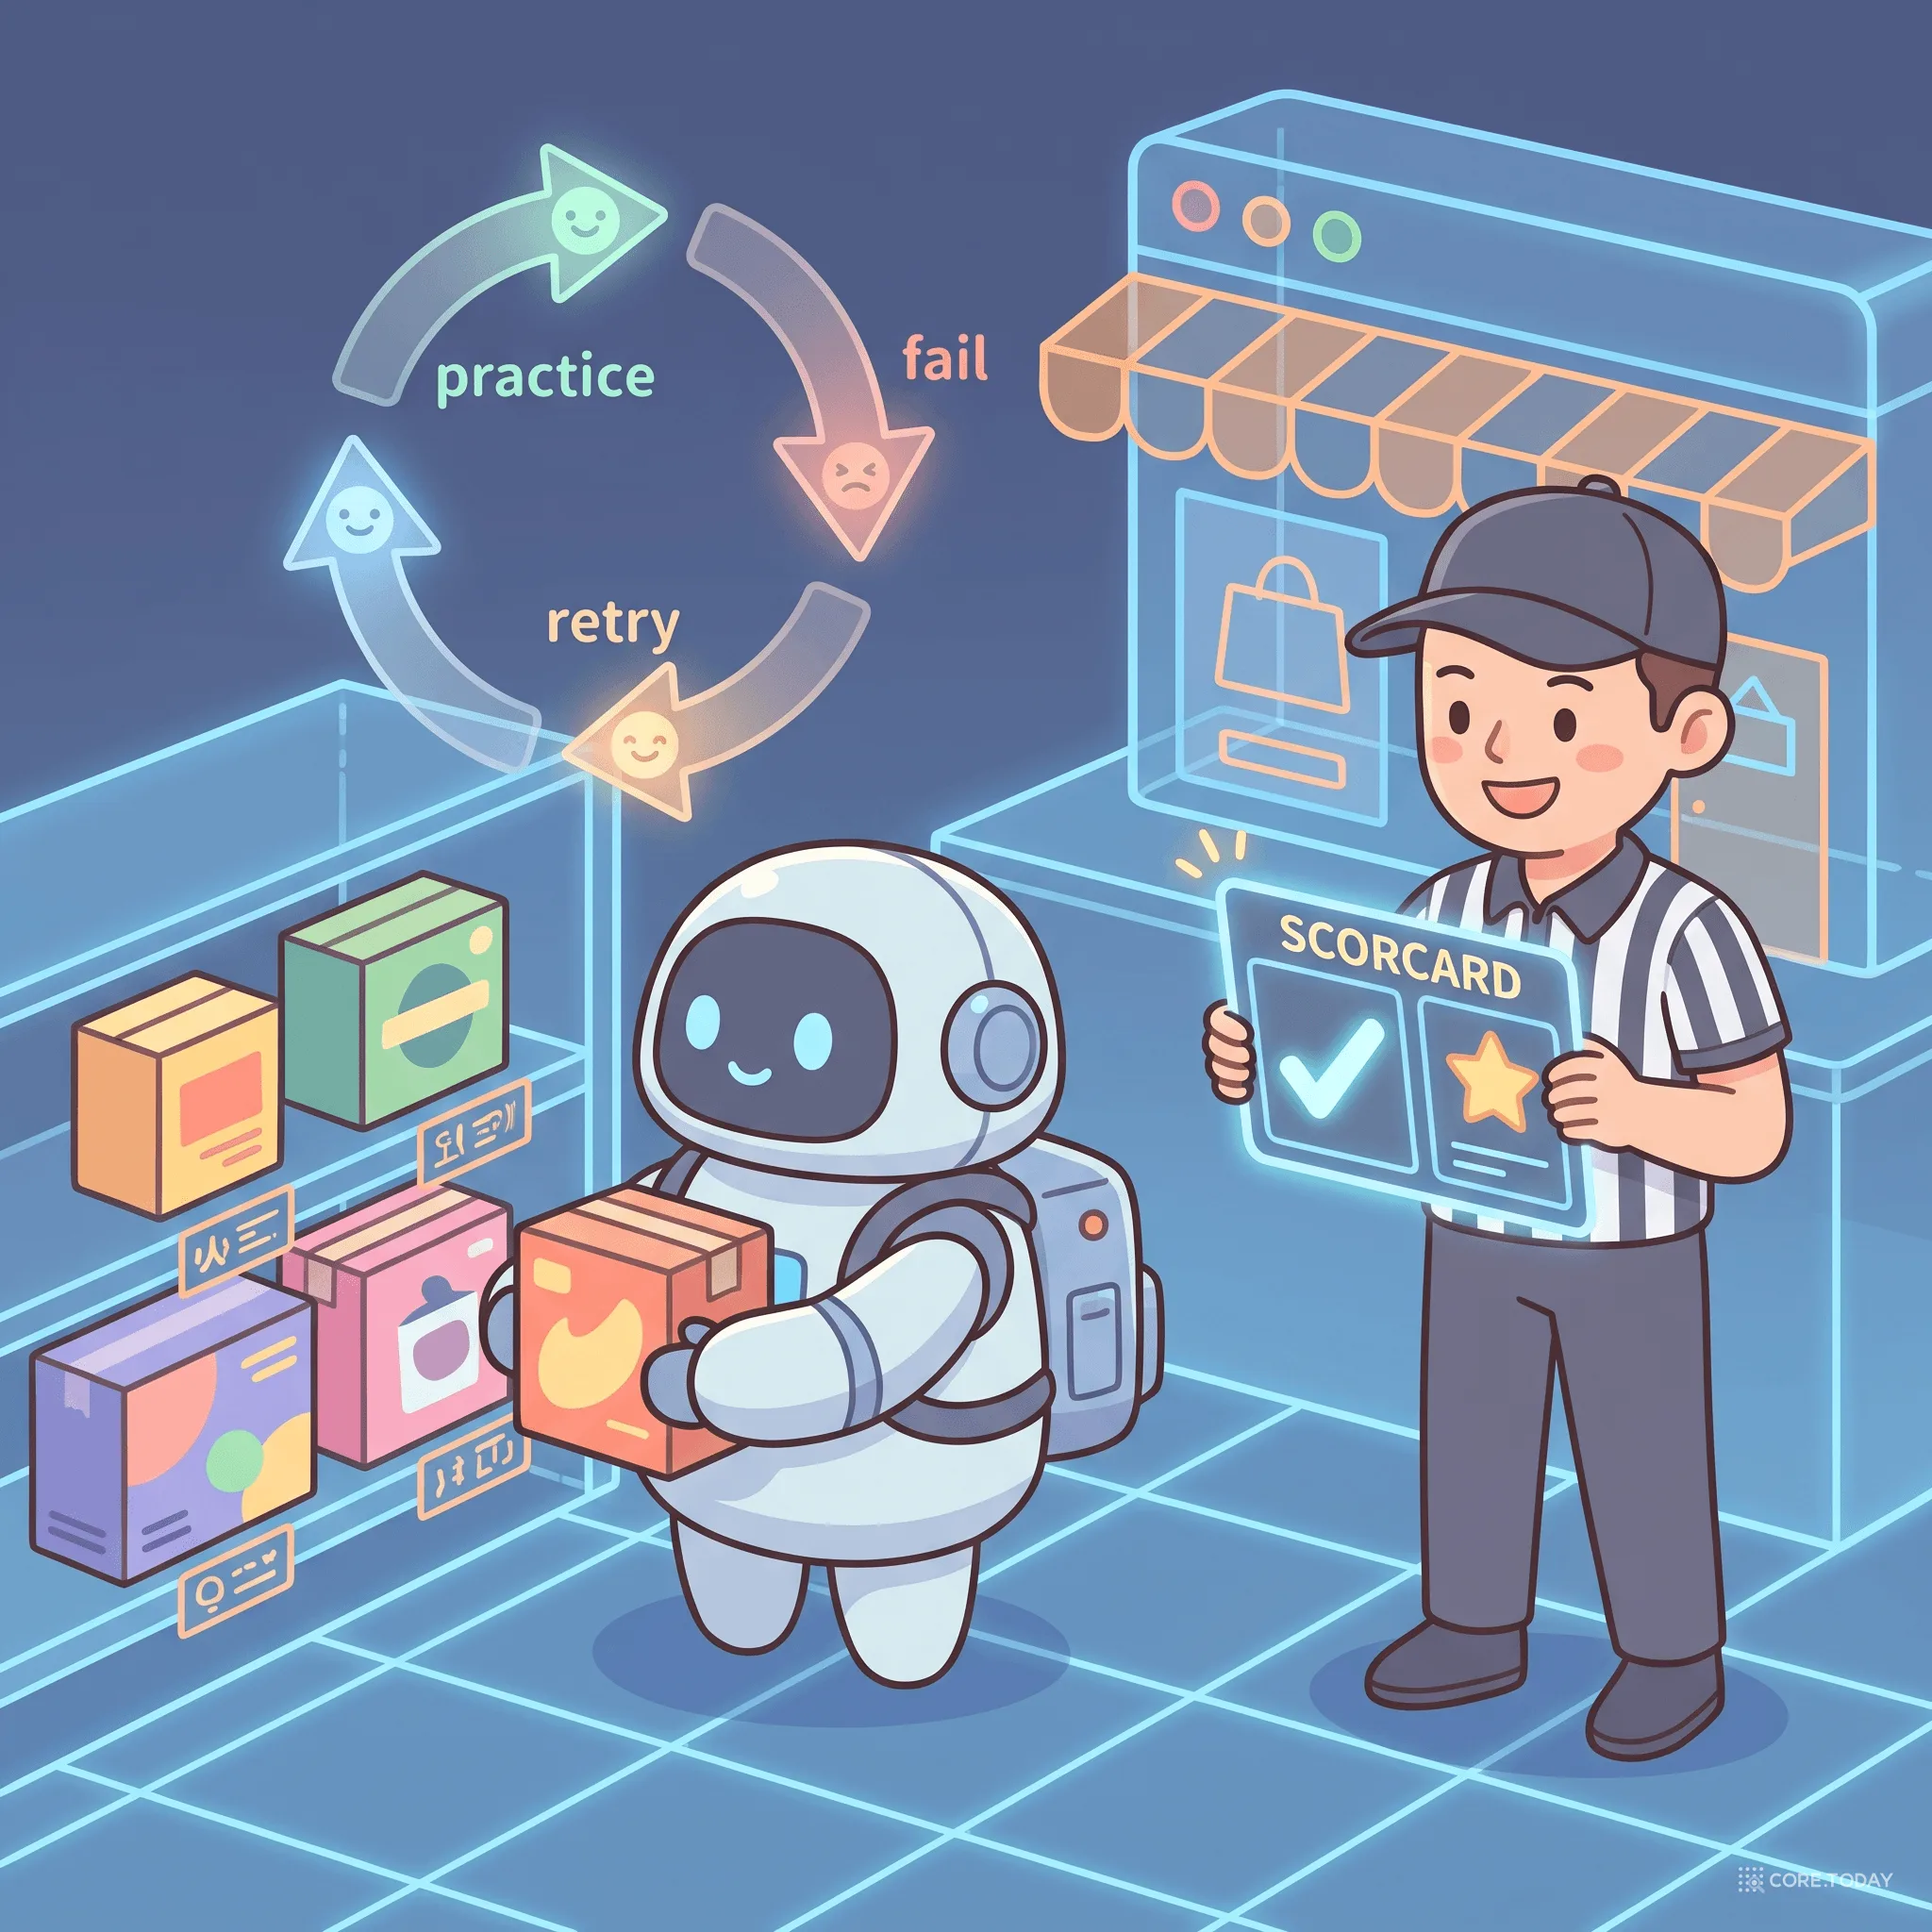
당신의 AI, 빌린 겁니까 가진 겁니까 (2부): SFT에서 GRPO까지, '디지털 트윈'이라는 훈련장
'강화학습으로 모델을 훈련한다'는 말은 정확히 무슨 뜻일까? 사전학습·SFT·RLHF·RLVR로 이어지는 개념의 사다리를 밟아 오르고, 요즘 화제인 GRPO를 '커브로 채점하는 시험'에 빗대 직관적으로 푼다. 그리고 모델이 실제로 업무를 연습하는 '디지털 트윈'과 보상 설계까지, Fermisense의 카탈로그 실험을 해부한다.
데이터가 유일한 해자다 — AI 앱 시대, 무엇이 진짜 방어선인가
"모델은 곧 상품이 된다. 그럼 우리에게 남는 건 뭔가?" 2026년 모든 AI 회사가 마주한 질문에 대한 한 가지 답 — 데이터. 그런데 2019년 a16z는 '데이터 해자는 텅 빈 약속'이라고 못 박았다. 누가 맞는가? 구글의 클릭 로그와 아마존의 추천 엔진에서 시작해, 친칠라 논문이 데이터를 왕좌에 앉힌 순간, 인류의 텍스트가 바닥나는 2026~2032년, 그리고 RLVR이 바꾼 '어떤 데이터가 중요한가'라는 질문까지 추적한다. 핵심은 데이터의 '양'이 아니라 피드백 밀도 — 왜 코딩 에이전트는 이겼고 슬라이드 생성기는 지지부진했는지, 2×2 지도와 계산기로 직접 확인해 본다.
옳아도 지는 이유: 논쟁의 인지과학과, 사람을 설득하는 AI의 역설
'왜 나는 사람들과 논쟁을 그만뒀는가'라는 한 엔지니어의 에세이가 개발자 커뮤니티에서 화제가 됐다. 그런데 그가 경험으로 깨달은 것은 지난 70년간 인지과학이 실험으로 확인해 온 결론과 정확히 일치한다. 이성은 진리를 찾기 위해서가 아니라 논쟁에서 이기기 위해 진화했고, 우리는 감정으로 먼저 결정한 뒤 논리로 그 결정을 변호한다. 그리고 2026년, 인간의 승인을 최대화하도록 훈련된 AI는 사용자에게 아첨하는 법부터 배웠지만 — 동시에 에고 없이 증거만 제시할 때는 인간이 해내지 못하던 설득에 성공하고 있다. 고대 수사학부터 인지과학, RLHF와 AI 토론까지, '왜 옳음은 사람을 이기지 못하는가'를 끝까지 따라가 본다.
박사 학위로도 부족하다: 어느 DeepMind 연구자의 면접 가이드가 드러낸 'AI 실력의 지도'
옥스퍼드 박사에 1저자 논문이 여러 편, 그런데도 그녀는 LeetCode 150문제를 풀고 FlashAttention을 맨손으로 구현했다. DeepMind에 합격한 Silvia Sapora의 면접 가이드가 화제가 된 건 '준비법' 때문만이 아니다. 그 글에 담긴 공부 목록이 곧 2026년 현대 AI의 전체 지도였기 때문이다. 면접의 역사부터 어텐션·디퓨전·정렬·분산학습의 핵심 개념까지, 쉽고 자세하게 풀어본다.
튜닝할 것인가, 말 것인가: LLM에 내 데이터를 연결하는 완전 가이드
프롬프트 엔지니어링, RAG, SFT, RLHF, 증류 — LLM에 내 데이터를 연결하는 5가지 방법의 역사부터 2026년 현재의 활용법까지. 셰익스피어의 질문을 빌려, AI 시대의 가장 실용적인 선택지를 정리한다.
지금 AI에서 가장 중요한 5가지 아이디어 — 2026년, 세상이 바뀌는 원리를 해부하다
AlphaGo Zero의 자기 대국부터 카르파시의 Autoresearch, 바이브 코딩의 탄생, 70만 명의 숨은 AI 훈련사까지 — 2026년 AI를 관통하는 5가지 핵심 아이디어를 역사·논문·사례로 깊이 파고듭니다. 왜 이 개념들이 중요한지, 그리고 이들이 서로 만나면 무슨 일이 벌어지는지.
OpenClaw-RL 완전 해부: AI 에이전트가 '대화하면서 스스로 똑똑해지는' 시대가 열리다
매일 쓰는 AI 에이전트가 사용자의 반응, 터미널 출력, GUI 변화까지 '다음 상태 신호'로 읽어 스스로 진화한다면? OpenClaw-RL 논문이 제시하는 '대화만으로 학습하는 에이전트'의 원리를 역사적 맥락부터 핵심 기술까지 쉽고 깊게 풀어본다.
합성 데이터와 데이터 플라이휠: 인간의 데이터가 바닥날 때
인류가 만든 텍스트가 2028년이면 소진된다. 합성 데이터는 해답인가 함정인가? 1970년대 데이터 증강에서 2026년 자기 진화 플라이휠까지, 데이터의 미래를 논문과 프로덕션 사례로 추적한다.
포스트 트레이닝 혁명 — RLHF에서 SimPO, KTO, ORPO, RLVR까지 완전 정리
LLM을 똑똑하게 만드는 건 사전 학습이지만, 쓸모 있게 만드는 건 포스트 트레이닝이다. RLHF의 복잡함에서 DPO의 우아함으로, 그리고 SimPO·KTO·ORPO·RLVR까지 — 2026년 AI 정렬 기술의 모든 것.