
#LoRA
9개의 포스트
[특집] 기억의 교통정리 — MemAgent: '만능 메모리는 없다'는 발견과, 13개의 기억 중 하나를 고르는 4B 라우터
에이전트에게 기억을 달아 주는 방법은 이미 수십 가지다. 궤적 요약, 실패에서 뽑은 경고, 변수 자리를 비운 워크플로, 실행 가능한 파이썬 함수, 통찰의 그래프. 각자 자기 시험에서는 1등이라고 보고했다. 칭화대와 텐센트 연구진은 13개 방식을 같은 에이전트에 하나씩 붙여 세 개의 시험을 치르게 했고, 세 시험 모두에서 상위권에 드는 방식은 하나도 없다는 걸 확인했다. 그런데 '문제마다 맞는 기억을 골랐다면'의 점수는 89.6% — 최고의 단일 기억(71.0%)보다 18%p 이상 높았다. 그래서 그들은 더 나은 기억을 만드는 대신 기억을 고르는 4B 모델, MemAgent를 학습시켰다. 시작 전엔 13개 서랍을 살짝 열어 보고, 진행 중엔 메모를 보여 줄지 정하고, 끝나면 어느 서랍에 넣을지 고른다. 인지과학의 다중 기억 체계부터 SAT 솔버 포트폴리오의 '오라클', 2026년 ChatGPT·Claude·Mem0·Letta의 메모리 설계까지, 논문과 코드, 그림과 표를 바탕으로 인터랙티브 일곱 개와 함께 풀어본다.
이단자(Heretic) 특집: '안전 정렬'을 30분 만에 외과수술로 제거하는 도구 — 거부의 단 하나의 방향
Trendshift '오늘의 1위 저장소' 등극, 커뮤니티가 3,000+ 모델을 만들고 있는 화제의 도구 Heretic. 2024년 Arditi 등의 발견 — '대형 언어 모델의 거부 행동은 잔차 흐름의 단 하나의 방향이 매개한다' — 을 출발점으로, 직교화(orthogonalization) · 투영 어블리트레이션 · 노름 보존 양투영(norm-preserving biprojection)을 거쳐 Optuna TPE 자동 튜너까지. 검열을 제거하면서도 KL divergence 0.16(Gemma-3-12B 기준, 경쟁 도구의 1/3~1/6)을 달성한 이 도구의 수학·구현·역사·윤리를 한 번에 정리한다.

Depth Separation 특집: 왜 '넓고 얕은' AI보다 '좁고 깊은' AI가 압도적으로 효율적인가
종이 한 장을 42번 접으면 달에 닿는다. 신경망도 마찬가지다 — 뉴런을 '옆으로 늘리는' 대신 '위로 쌓으면' 지수적으로 효율적이다. 1989년 보편 근사 정리가 약속한 '무한한 가능성'의 이면에 숨겨진 비용, 그리고 2016년 수학자들이 증명한 '깊이의 압도적 승리'까지. ResNet에서 Transformer, LoRA까지 — 현대 AI의 모든 혁신이 깊이에 빚지고 있는 이유를 파헤친다.
콜모고로프-아르놀드 정리 완전 해부 — 130년 된 수학 난제가 AI의 미래를 바꾸고 있다
1900년 힐베르트가 던진 도전장, 19세 천재 아르놀드의 증명, 그리고 2024년 MIT에서 탄생한 KAN까지 — 130년에 걸친 수학 정리가 어떻게 AI 신경망의 새로운 패러다임이 되었는지, 역사·논문·사례로 깊이 파고듭니다.

Transformer와 Depth Separation: 96개 층이 만드는 '생각의 깊이' — 왜 Transformer는 깊어야 똑똑한가
GPT-1은 12층, GPT-3는 96층이다. 층수가 8배 늘자, 모델은 '텍스트 생성기'에서 '범용 추론 엔진'으로 변신했다. 이 질적 도약은 왜 일어났는가? Transformer의 각 층이 어떤 역할을 하는지 — 초기 층의 문법 감지부터 깊은 층의 논리 추론까지 — 를 추적하고, 이 계층적 구조가 LoRA의 효율과 Mixture of Depths의 혁신을 어떻게 가능케 했는지를 파헤친다.
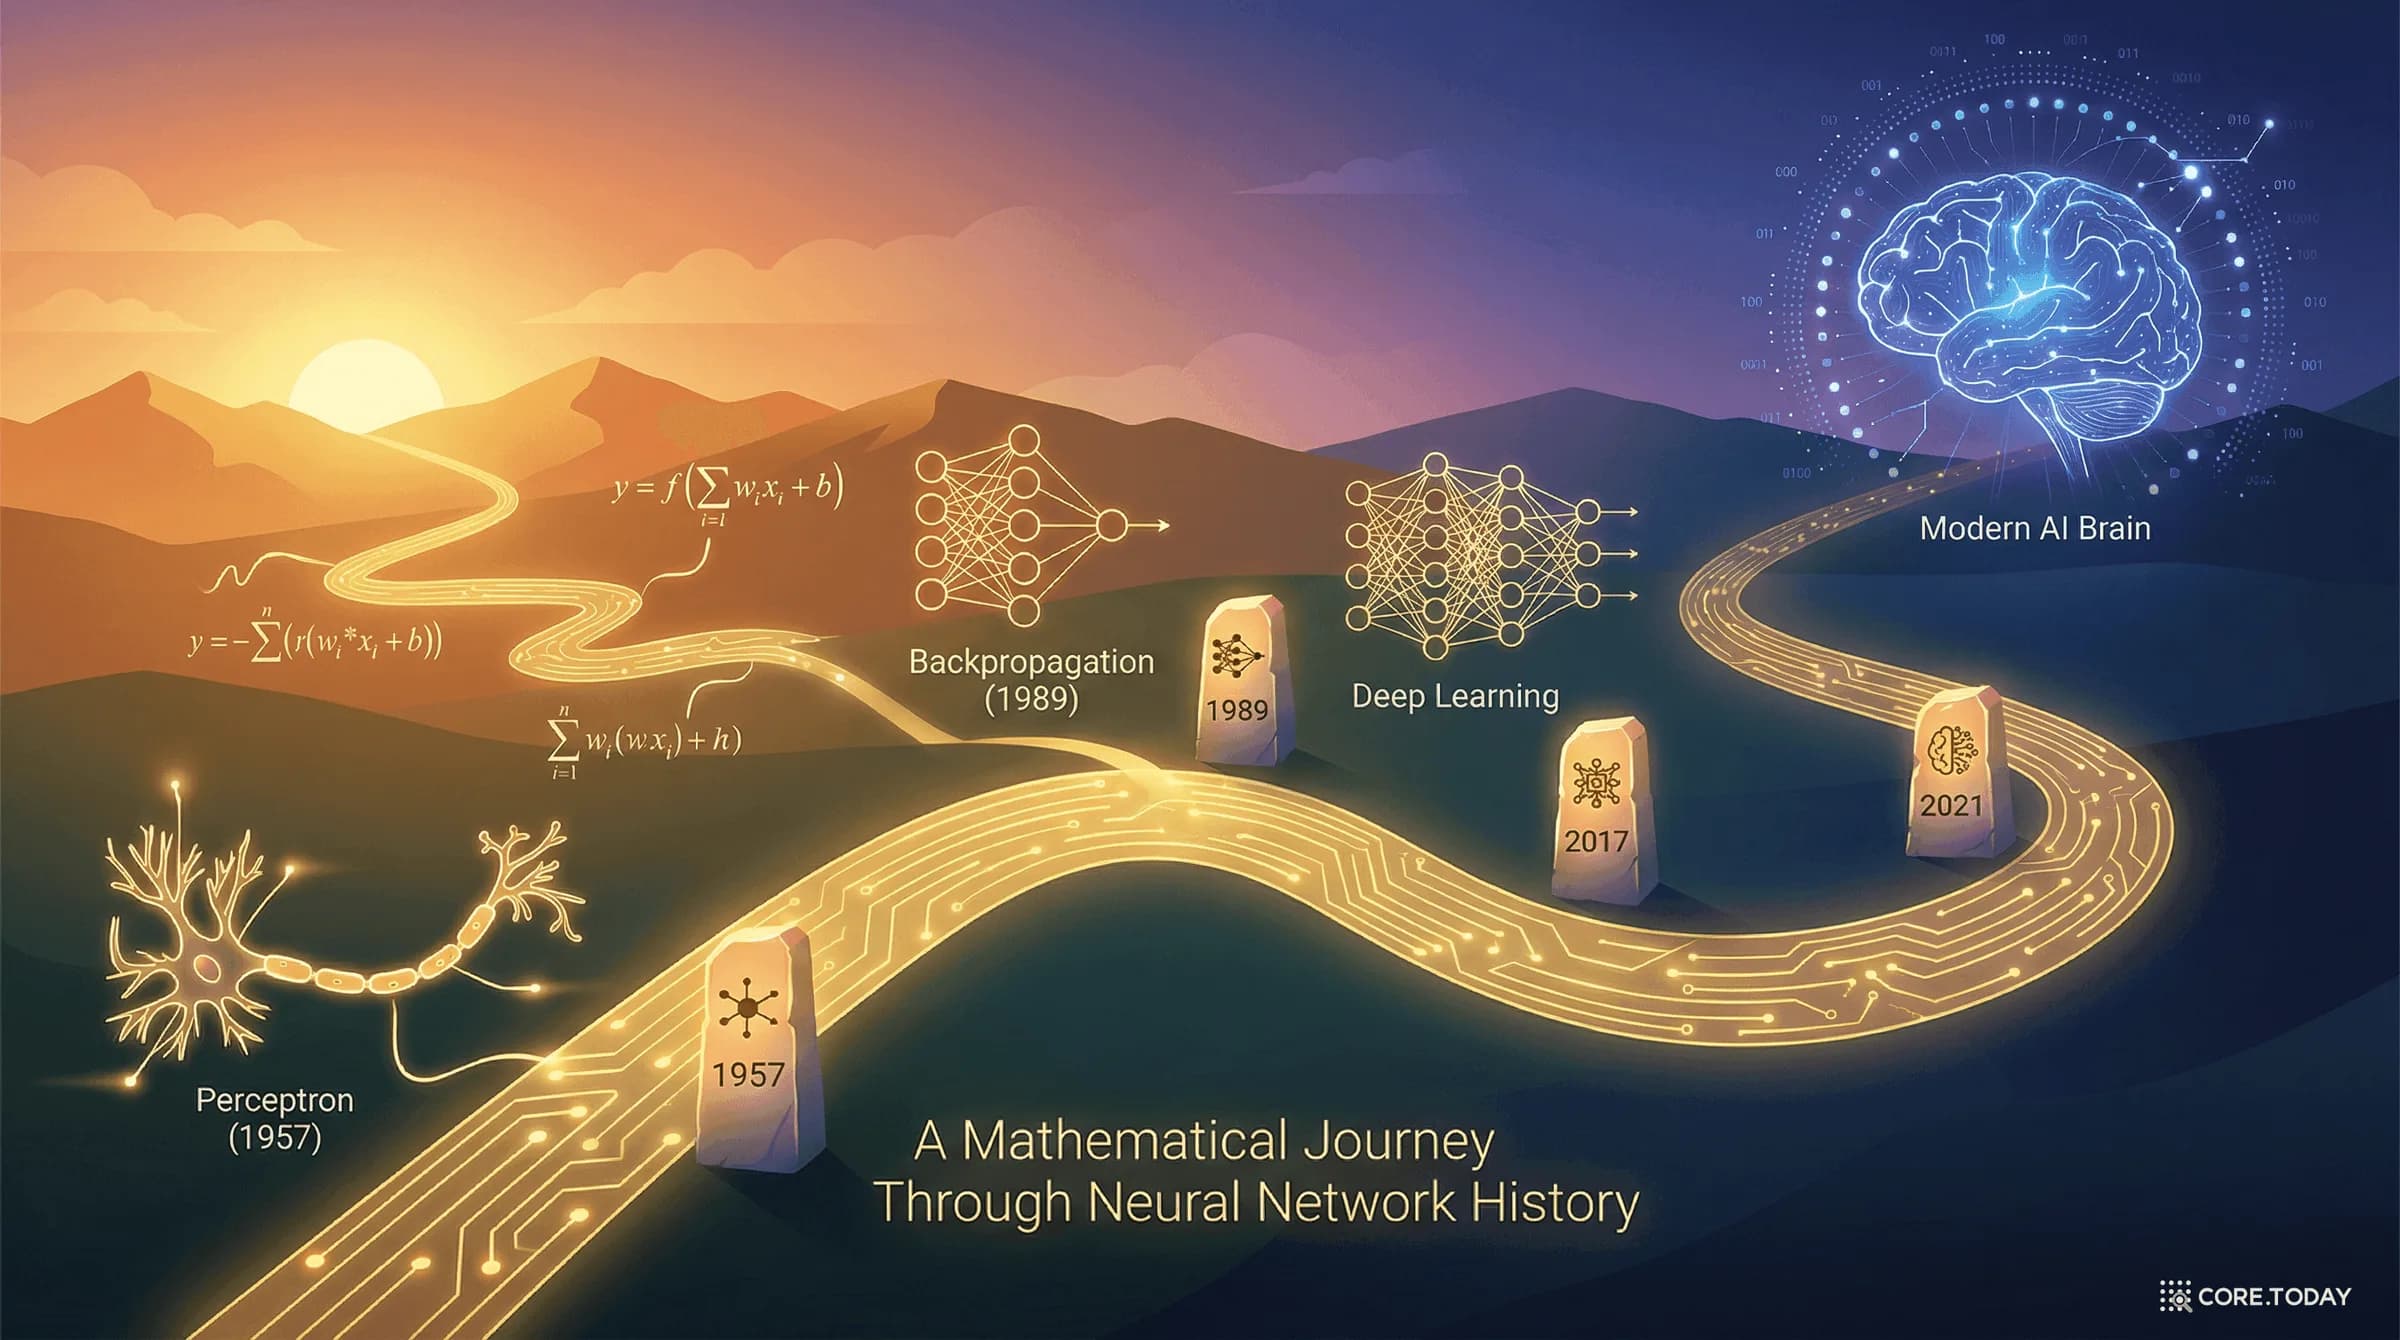
UAT에서 LoRA까지: 신경망이 세상을 배우는 수학적 여정
1989년, 한 수학 정리가 증명했다 — 뉴런이 충분하면 어떤 함수든 흉내 낼 수 있다. 이 '보편 근사 정리'에서 출발하여, 깊이의 혁명, Transformer, 스케일링 법칙을 거쳐 LoRA까지 — 신경망이 세상의 모든 것을 배우는 수학적 여정을 따라간다.
LoRA / QLoRA 특집: 1,750억 개 파라미터를 35MB로 길들이는 마법
GPT-3 175B를 파인튜닝하려면 1.2TB GPU 메모리가 필요하다. LoRA는 학습 파라미터를 1만 배 줄이고, QLoRA는 65B 모델을 단일 48GB GPU에서 학습 가능하게 만들었다. 저랭크 분해의 수학부터 2026년 모든 오픈소스 모델의 표준이 된 여정까지, 두 논문을 낱낱이 해부한다.
LoRA 완전 정복: 포스트잇 하나로 거대 AI를 내 것으로 만드는 법
700억 파라미터 모델을 내 노트북에서 파인튜닝한다고? LoRA와 QLoRA가 가능하게 만든 '효율적 적응'의 원리를 포스트잇 비유와 함께 완전 해부합니다.
LoRA 논문 해부: 1,750억 개의 손잡이 중 470만 개만 돌리다
GPT-3를 파인튜닝하려면 1.2TB 메모리가 필요하다. LoRA는 파라미터의 0.003%만 학습하여 동일한 성능을 달성했다. 350GB 체크포인트가 35MB로 줄었고, AI 맞춤화가 민주화됐다. 이 혁명의 원리를 처음부터 쉽게 풀어낸다.