
#Llama
3개의 포스트
정답보다 오답이 더 많이 가르친다 — 지식 증류와 ‘어두운 지식’ (특집)
지식 증류는 큰 모델(교사)이 내놓은 확률 분포를 작은 모델(학생)이 따라 배우게 하는 기술이다. 2006년 앙상블 압축에서 출발해 2015년 힌턴·비냘스·딘이 ‘온도’와 ‘어두운 지식’이라는 이름을 붙였고 — 이 논문은 NeurIPS에서 떨어졌다 — 지금은 Gemma·Llama·Qwen 같은 작은 모델의 기본 공정이자 DeepSeek-R1 이후 추론 능력을 옮기는 방법, 그리고 2026년 ‘증류 공격’ 분쟁의 이름이 됐다. 이 글은 BMW와 쓰레기차와 당근의 비유로 어두운 지식을 설명하고, 힌턴의 MNIST 실험을 직접 재현해 숫자 3을 한 장도 보지 못한 학생이 3을 98.2% 맞히는 모습, 작은 학생에게 높은 온도가 독이 되는 이유, 라벨 1,000장과 교사 한 명이 라벨 1만 장보다 나은 결과를 보여 준다. Qwen3 형제 모델로 언어 모델의 소프트 라벨과 증류의 효과도 쟀다. 라벨 스무딩의 역설, 용량 격차, 모방의 거짓 약속, KL의 방향, 온폴리시 증류까지 짚고 실무 체크리스트로 마무리한다. 인터랙티브 위젯 6종, 코어닷투데이 실측 2건, 삽화 16장.
SLM 완전 가이드: 작은 AI가 큰 AI를 이기는 시대 — 비용 100분의 1, 성능 80%
프로덕션 AI의 80%는 노트북에서 돌리는 작은 모델로 충분하다. 비용은 100분의 1, 프라이버시는 완벽. DistilBERT에서 Phi-4 Mini까지 — SLM이 LLM을 대체하는 이유와 방법.
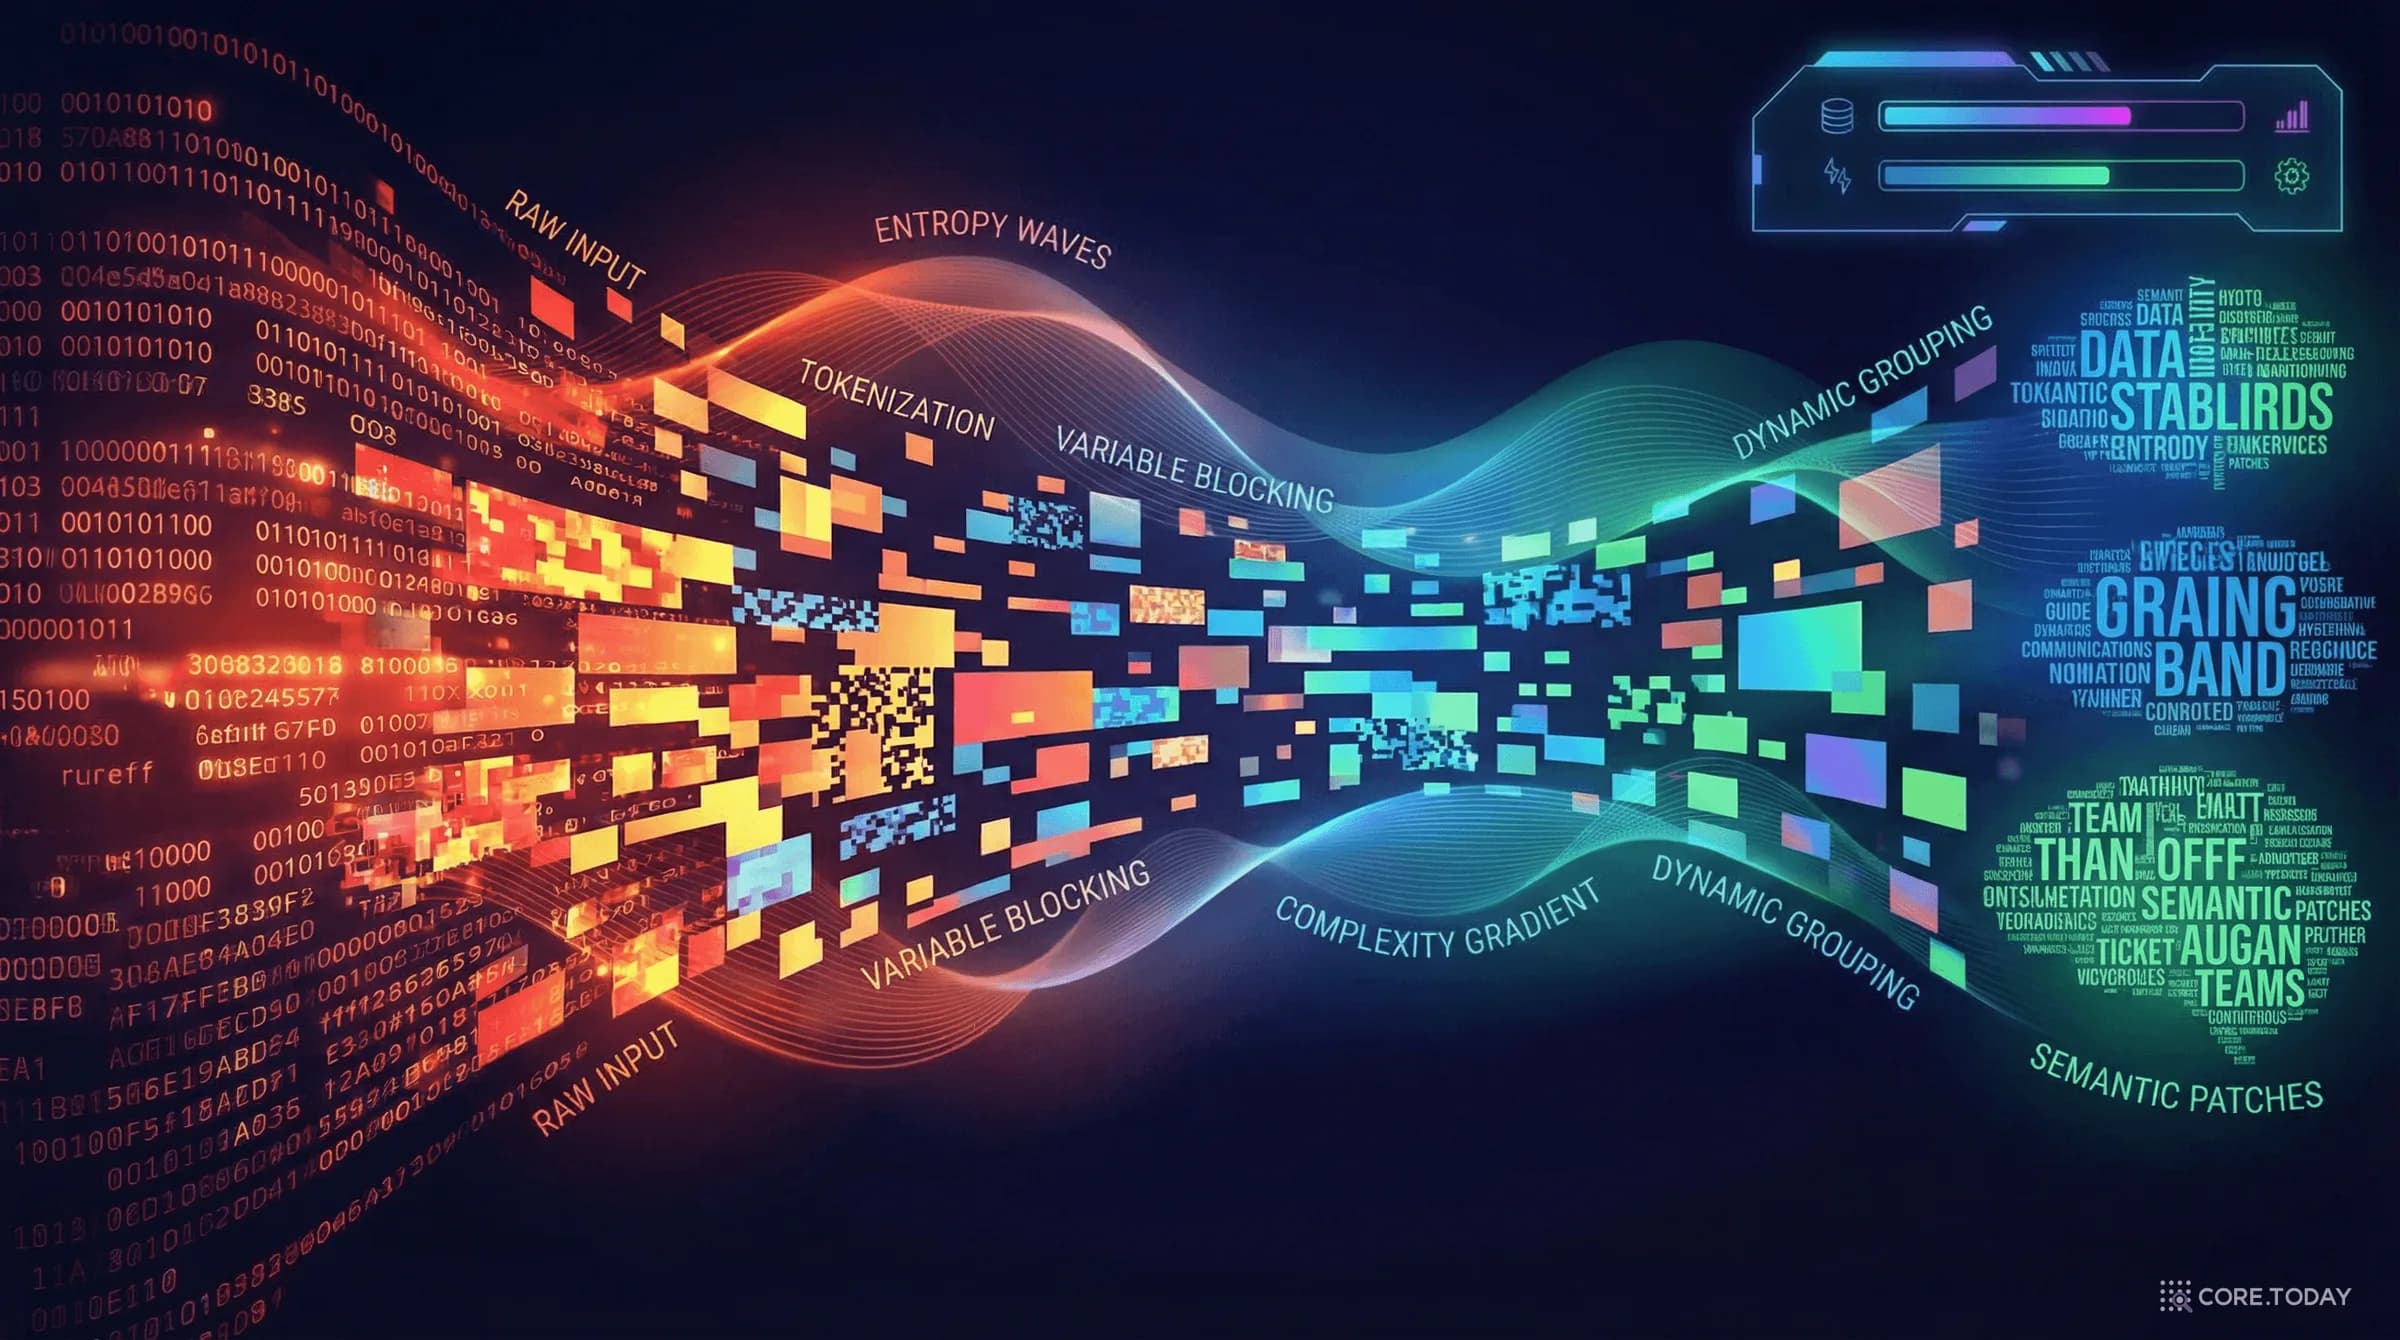
Byte Latent Transformer: 토큰을 버리고 바이트로 돌아간 AI의 반란
GPT부터 Llama까지, 모든 LLM은 '토크나이저'라는 전처리 단계에 의존한다. Meta AI의 BLT는 이 관행을 뒤집었다 — 바이트를 직접 처리하되, 엔트로피 기반으로 '어려운 곳에 더 많은 연산'을 동적 할당하여 80억 스케일에서 Llama 3에 필적하는 성능을 달성했다.