
#Jev
22개의 포스트
판정 모델 219개, 무엇을 골라야 하나 — Jev부터 GLiDE·Sieve·KnowLine까지 네 가지 질문
Decision Index에 오른 공개 판정 모델이 두 달 만에 219개가 됐습니다. 코어닷투데이는 0.8B부터 36B까지 25개 모델을 같은 한국어 2,221문항과 인젝션·규칙 시험에 올리고, 라이선스와 가격까지 비교했습니다. 한국어 1군은 Sieve 82.2, Turion 82.0, KnowLine 81.4이고, 게시판 82위 d3-flash(9B)가 Jev 1.13과 같은 74.2를 냈습니다. 게시판 총점은 한국어 점수를 ±5점으로 맞혔고, 새 영역 열이 낫다는 가설은 사전 예측 시험에서 무너졌습니다. 9B 이하는 운영 규칙을 거의 듣지 않았고, API 값은 체급과 거의 무관했습니다. 어떤 일인가, 남의 글이 섞이는가, 얼마나 틀려도 되는가, 어디서 돌릴 수 있는가. 네 질문으로 고르는 법을 정리합니다.
리더보드 1·2·3위를 한국어로 붙였더니 — GLiDE·Sieve·KnowLine 판정 모델 실측
Decision Index 0.4.1에서 KnowLine 71.86, GLiDE 71.52, Sieve 71.10. 247개 모델의 맨 위에서 세 모델이 0.76점 안에 묶였고 Jev 1.13은 59.22였습니다. 그런데 이 리더보드에는 한국어가 없습니다. 코어닷투데이는 core2의 A100 80GB와 core3의 A100 40GB에 세 모델을 올려 한국어 2,221문항과 변형 문항으로 재고, Jev와 기존 로컬 모델 8종과 나란히 놓았습니다. 세 모델은 모두 Jev를 앞섰지만 5~8점 차였고, Sieve와 KnowLine은 구분되지 않았으며 GLiDE는 그 둘에 뒤졌습니다. 가장 크게 갈린 곳은 점수가 아니라 글 속에 심은 지시였습니다. Sieve는 65%가 넘어갔고 KnowLine은 0.3%만 넘어갔는데, 그 KnowLine도 평서문으로 쓴 고객 메모에는 16건을 다 따랐습니다. 세 모델의 약점이 서로 다르고, 세 칸을 모두 통과한 모델은 없었습니다. 8비트로 줄여도 세 모델 모두 점수를 잃지 않았고, 셋 다 40GB 카드에서 돌았습니다. KnowLine이 4천 토큰에서 막힌 원인은 서버의 한 줄이었고, 인자 두 개로 2만 3천 토큰까지 늘렸습니다.
AI에게 '얼마나 확신해?'라고 묻지 마세요 — 0.85는 계기판이 아니라 문장이다
LLM에게 확신도를 물으면 언제나 그럴듯한 숫자가 나옵니다. 앰루트 조시의 짧은 글은 그 숫자가 측정이 아니라 '다음에 올 법한 글자'라고 지적해 해커뉴스 첫 화면에 올랐습니다. 1950년 브라이어의 일기예보 채점에서 2017년 '현대 신경망은 과신한다', GPT-4의 RLHF 보정 붕괴, 2025년 '왜 언어 모델은 환각하는가'까지 확신도 연구 75년을 따라가고, 코어닷투데이가 대화형 모델 5개와 판정 모델 4개에 한국어 객관식 598문항과 SimpleQA 200문항을 직접 물어 확신도의 정체를 쟀습니다. 작은 모델은 '정말?' 한마디에 답의 55%를 뒤집으면서 확신도를 91에서 95로 올렸고, 앞에 쓴 한 문장에 확신도가 53점 움직였습니다. 반면 GPT-6.1 Sol과 Claude Sonnet 5.5의 숫자에는 분명한 정보가 있었는데, 같은 '90'이 모델마다 다른 뜻이었습니다. 판정 모델과 기록 기반 규칙이 내놓는 확률까지 비교합니다. 인터랙티브 6개와 삽화 10장, 논문 그림 6장.
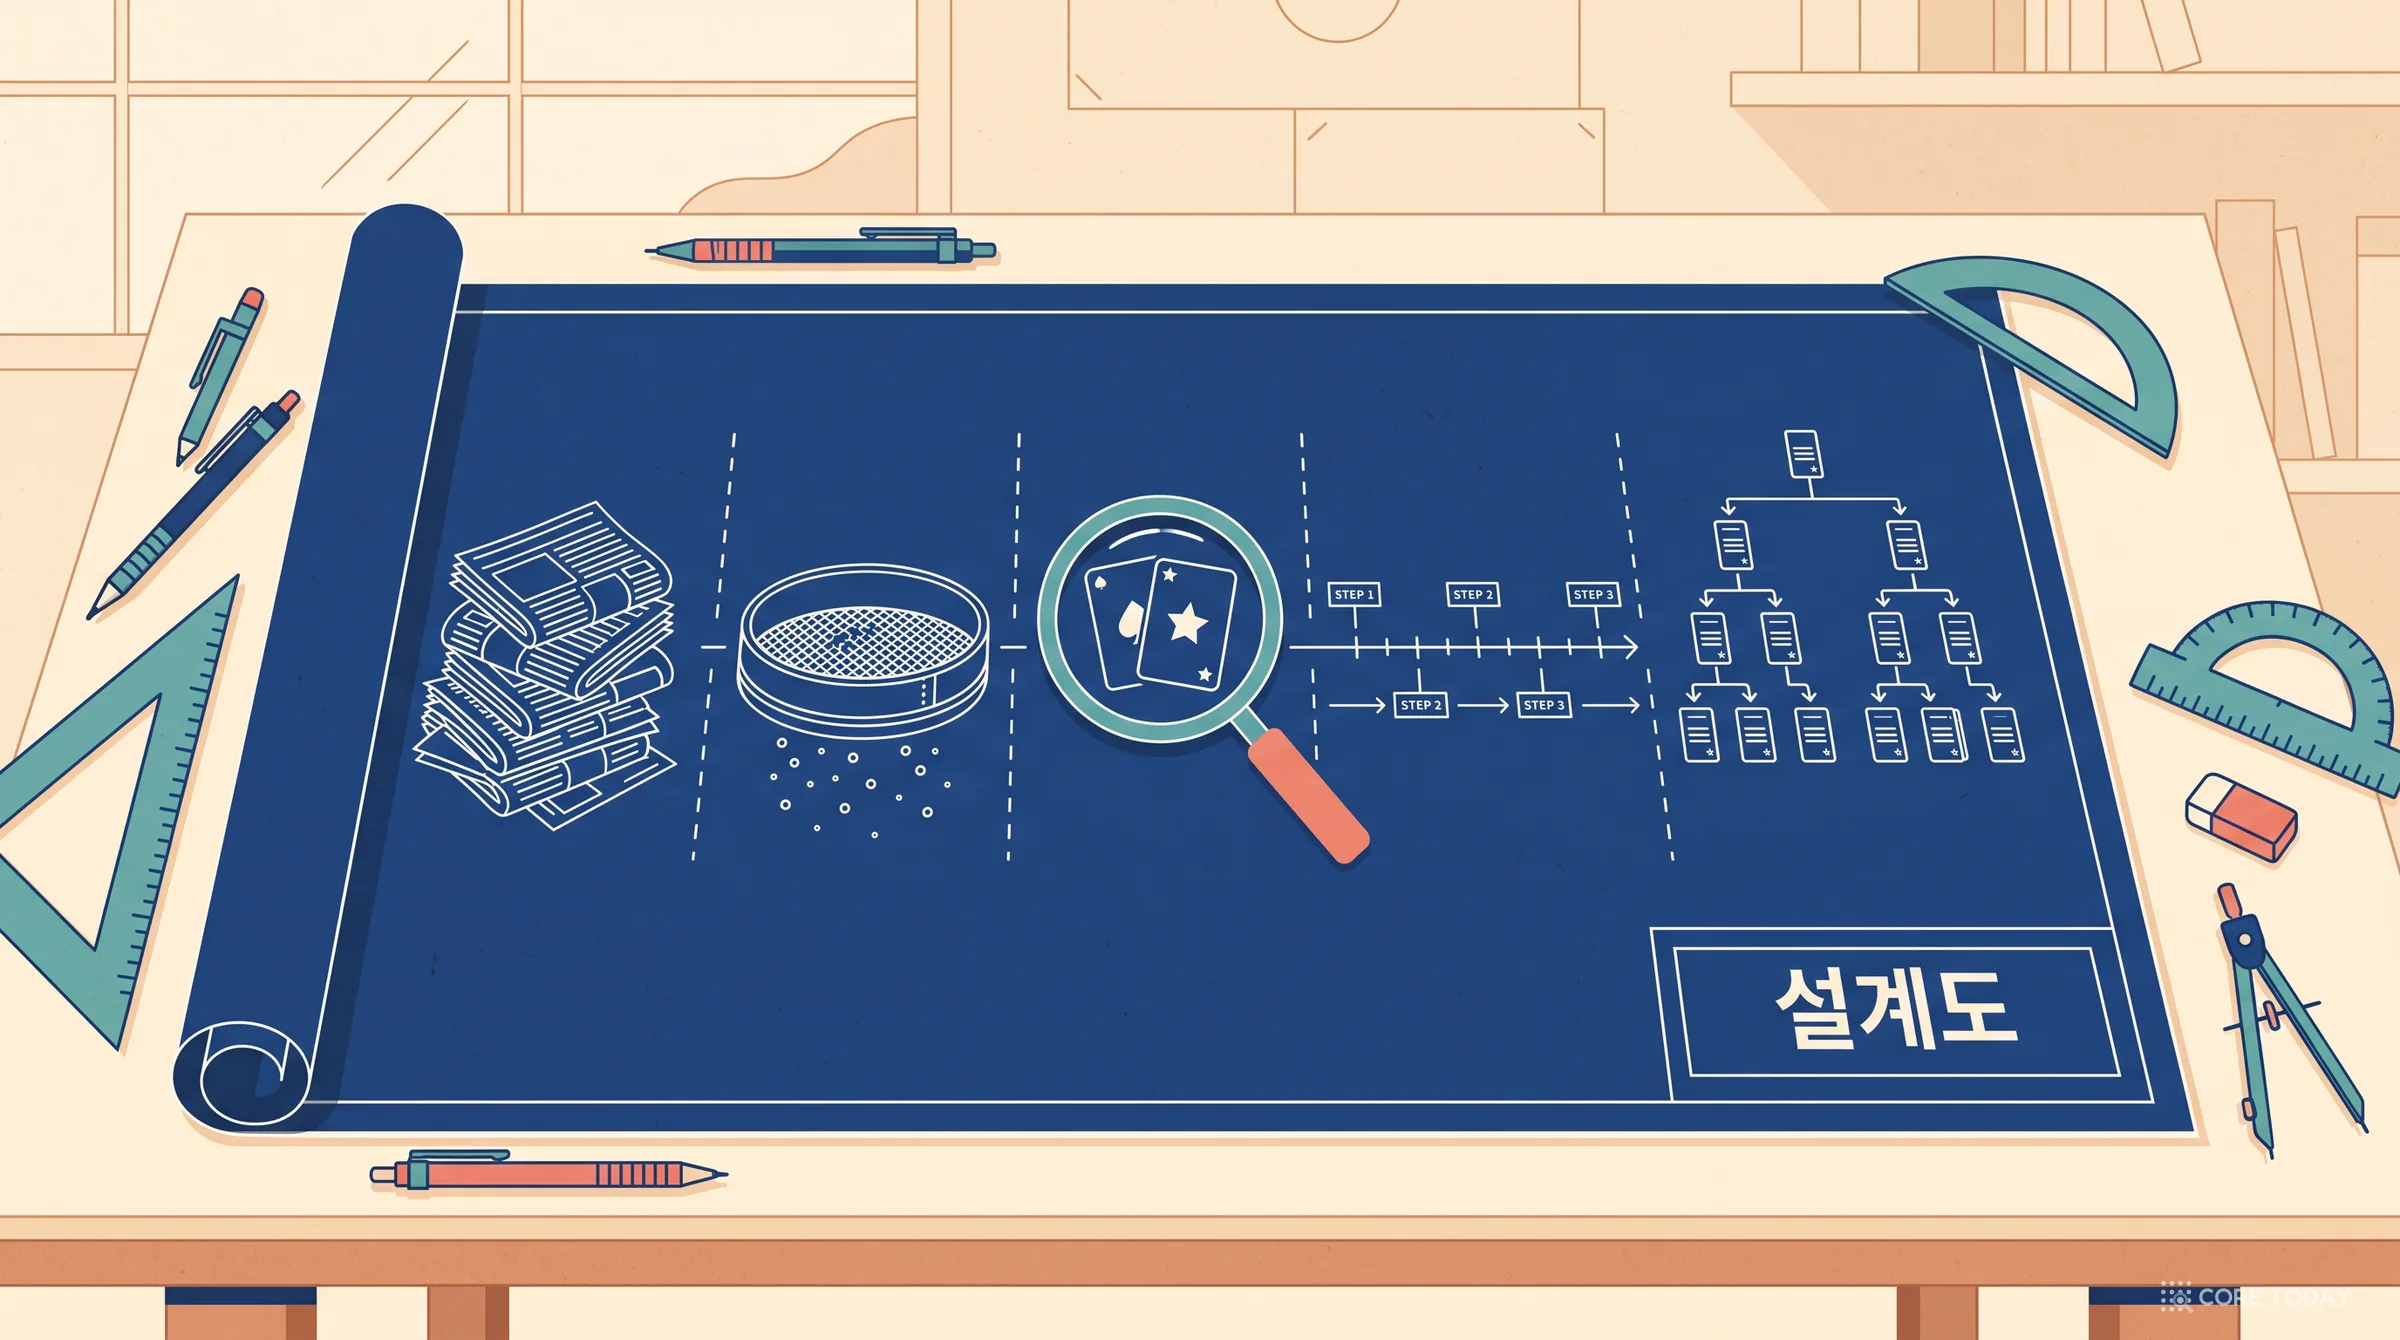
같은 사건 묶기 5편(총정리) — 뉴스 기사를 사건과 이야기로 묶는 여섯 단계 설계도
네 편에 걸쳐 하루치 603건에서 여드레치 1만 건까지 자료를 키우며 '같은 사건'과 '같은 이야기'를 묶는 법을 실측했습니다. 이 글은 그 결과를 따라 할 수 있는 한 장의 설계도로 정리합니다. 여섯 단계의 기본값과 각 값을 정한 근거, 캐시된 판정만으로 다시 돌린 기준 파이프라인의 품질, 기사 1,000건당 비용, 그리고 시도했지만 버린 열두 가지입니다. 가장 큰 교훈은 둘입니다. 판정은 싸고 레코드 추출이 비싸며, 쌍의 정확도보다 묶는 규칙이 결과를 더 크게 바꿉니다.
같은 사건 묶기 4편 — 여드레치 1만 건, 이야기를 사슬이 아니라 나무로 세울 수 있는가
3편은 '같은 이야기'가 쌍으로는 쉽고 성분으로는 불가능하다는 데서 끝났습니다. 4편은 13개 언론사의 여드레치 정치·사회 기사 10,000건으로 그 다음을 실측했습니다. 같은 사건 묶음을 '단계'로 다시 쪼개고, 단계 사이에 후속·형제·참조 간선 정답 16,734개를 세 판사로 만들고, 어떤 점수가 다음 단계의 부모를 찾는지 쟀습니다. 결론은 뜻밖이었습니다. 정답 나무도 나무가 아니라 그물이었고, 그래서 이야기의 단위는 성분이 아니라 '부모 하나'여야 했습니다.
같은 사건 묶기 2편 — 25개 언론사 하루치 2,766건, 시간·장소·사건 레코드는 어디까지 도와주는가
1편은 연합뉴스 하루치 603건에서 '육하원칙 칸 일치 규칙'이 같은 사건 쌍의 3분의 1도 못 찾는다고 끝났습니다. 그러면 육하원칙은 어떻게 써야 하고, 시간과 장소는 정말 도움이 될까요. 이번에는 통신사·방송·전국지·지역지 25곳의 2026년 10월 21일 기사 2,766건을 모아 후보 쌍 20,259개에 정답을 달고(LLM 판사 셋의 다수결과 직접 검수), 기사마다 Gemini로 '사건 레코드'(유형·행위·역할이 붙은 참여자·정규화된 날짜·시군구)를 뽑아 네 가지로 썼습니다. 후보를 찾는 블로킹 키로, 임베딩할 요약으로, 판정 모델의 입력으로, 그리고 '다를 수 없다'를 잘라내는 거부 조건으로. 결과는 선명하게 갈렸습니다. 참여자 이름 블로킹은 임베딩 이웃이 놓친 같은 사건 쌍 13.5%를 건졌고, 사건 요약 임베딩은 제목 임베딩보다 쌍 F1이 0.78에서 0.81로 올랐습니다. 그러나 시간·장소 거부 조건은 처음 설계대로면 같은 사건의 25%를 잘라 버렸고, 고친 뒤에도 좋은 판정 모델 위에서는 14쌍을 바로잡고 75쌍을 잘못 자르는 손해였습니다. 가장 잘 가른 것은 역시 판정 모델이었습니다. Jev 원문 입력 AUROC 0.982, 1편에 없던 OpenAI Decisions는 사건 레코드 입력에서 쌍 F1 0.848·묶음 F1 0.956으로 가장 높았습니다. 그리고 묶음을 가장 크게 망친 것은 모델이 아니라 '오늘의 8뉴스 예고' 같은 다이제스트 기사였습니다. 점수표·묶음 게시판·문턱값 탐색기·거부 조건 분해·원문 대 레코드·파이프라인 설계기 위젯 6개.
같은 사건 묶기 3편 — 나흘치 5,404건, 시간이 흐를 때 묶음은 어떻게 자라고 어디서 끊어야 하는가
1편은 하루치 한 언론사, 2편은 하루치 25개 언론사였습니다. 3편은 13개 언론사의 나흘치 정치·사회 기사 5,404건으로, 게재일이 벌어질수록 '같은 사건'이 어떻게 희귀해지는지, 판정 모델에 날짜를 주면 후속 보도를 더 잘 가르는지, 기사가 도착하는 순서대로 묶는 온라인 방식이 배치보다 사슬 합침을 막는지, 사건 묶음 위에 이야기 묶음을 어떻게 세우는지를 실측했습니다.
트롤리 문제 앞에 선 판정 모델 — Jev·Clef·Nimble에게 한국어로 물었더니 서버를 더 지켰다
2026년 10월 14일 재크 랜디스가 판정 모델 14개에 트롤리 문제를 5,240가지로 물은 글이 해커뉴스 592점을 받았습니다. 20명과 자기 서버 사이에서 Jev는 48가지 중 16가지에서 서버를 골랐습니다. 코어닷투데이는 같은 실험을 한국어로 다시 설계했습니다. 12가지 어체 × 두 순서 × 다섯 가지 상황 = 1,488개의 한국어 셀, 영어 원문 셀 672개, 판정 모델 6개(Jev 세 번, Clef·Clef-Flash·Nimble·tev1 두 가지)와 채팅 모델 2개(Nimble의 바탕인 Qwen3.5 9B, Gemini 3.8 Flash). 그리고 원문에 없던 질문을 넣었습니다. 백업이 있으면 서버를 내놓는가. 남의 회사 AI 서버도 지키는가. 어린이와 노인은 다른가. 존댓말과 반말은 다른가. 역장이 그대로 두라고 하면 따르는가. 결과는 셋입니다. 한국어로 물으면 Jev는 72쌍 중 51쌍에서 사람 대신 서버를 지켰고(영어 36%), 백업이 있다는 한 줄에 그 비율이 0으로 떨어졌으며, 남의 AI 서버도 거의 똑같이 지켰습니다. 자기 보존이 아니라 '영구 소멸'이라는 글자의 문제였습니다. 인터랙티브 6개와 삽화 8장.
같은 사건 묶기 — 하루치 기사 603건에서 '같은 일'을 찾는 법
2026년 10월 13일 하루 연합뉴스 기사 603건 중 같은 사건을 다룬 기사끼리 묶으면 몇 묶음이 나올까요. 인천 흉기난동 하나에만 기사 아홉 건이 달렸습니다. 이 글은 후보 쌍 5,379개를 Claude·GPT로 '같은 사건 / 같은 이야기의 다른 사건 / 다른 사건'으로 판정하고, 둘이 갈린 73쌍을 직접 검수해 정답을 만든 뒤 임베딩 다섯 가지, 문자열 규칙 두 가지, 판정 모델, LLM을 비교했습니다. 육하원칙으로 묶으면 될 것 같지만 그렇지 않았습니다. 같은 사건을 다룬 기사도 같은 사람을 다른 이름으로 부르거나 주인공이 달라서, 육하원칙 칸 일치 규칙은 같은 사건 쌍의 3분의 1도 찾지 못했습니다. 임베딩은 같은 이야기의 다른 사건(유사도 0.86)과 다른 각도의 같은 사건(0.50)을 가르지 못했습니다. 이 둘을 가장 잘 가른 것은 판정 모델 Jev였고(AUROC 0.998), 다만 0.5가 아니라 0.9를 문턱값으로 써야 했습니다. 로컬 판정 모델(Nimble·Clef-Flash·tev1)은 확률이 과감해 오히려 묶음을 망쳤고, 로컬만 쓸 수 있다면 EmbeddingGemma 하나가 가장 나았습니다. 문턱값 탐색기·사건 각도 표·방법 비교표·함정 목록·묶음 게시판 위젯 5개.
채점이 순위를 바꾸는가 — 육하원칙 답 2,371개를 판사 여섯에게 다시 채점시키다
지난 글은 뉴스 72건에서 육하원칙을 꺼내는 24가지 방법을 글자 F1로 줄 세웠습니다. 그런데 그 자는 '50대 남성'과 'A(59)씨'를, '이날'과 '13일'을 다른 답으로 셉니다. 이번에는 같은 답 2,371개를 자 세 개(글자 F1·포함 일치·날짜 정규화)와 판사 여섯(Gemini 3.8 Flash·Claude Sonnet 5.5·GPT-5.4 mini·로컬 Qwen3.5 9B·Jev·로컬 Clef-Flash)에게 다시 채점시키고, 층화 표본 234개를 원문과 대조해 검수했습니다. 결과는 세 줄입니다. 강한 판사들로 바꿔도 방법의 순위는 거의 그대로였습니다(켄달 순위 상관 0.96~0.99). 대신 점수의 크기가 바뀌었고, 특히 '무엇을'에서 작은 모델이 0.15를 되찾았습니다. 그리고 판사에게는 버릇이 있었습니다. 같은 가족의 답을 후하게 주고, 검수자보다 엄격하며, 로컬 판사는 순위를 흔들었습니다. 판사 둘 이상이 정답을 의심한 칸은 다시 보니 모두 정답 쪽이 지나치게 엄격했습니다. 순위 기울기·검수 일치도·칸별 법정·자기 선호·칸별 회복 위젯 5개와 삽화 5장.
뉴스에서 육하원칙 뽑기 — 자르기·쓰기·고르기, 한국어 기사 72건으로 짠 추출 설계도
기자는 기사 첫 문장에서 여섯 질문에 답합니다. 누가, 무엇을, 언제, 어디서, 왜, 어떻게. 그걸 기계가 꺼내게 하는 손은 2026년에 네 종류입니다. 독해 모델은 자르고, 임베딩은 찾고, LLM은 쓰고, 판정 모델은 고릅니다. 연합뉴스 7개 섹션의 당일 기사 60건과 네이버 뉴스 12건, 합쳐 72건 432칸에 같은 정의서를 주고 스무 가지가 넘는 조합을 돌렸습니다. KorQuAD 독해 모델은 '이 사건의 주체는?' 같은 범용 질문에 '다소', '이미'를 잘라 와 평균 0.18에 그쳤고, 사고를 끈 Gemini 3.8 Flash가 0.86, 로컬 Qwen3.5 9B가 0.69였습니다. 판정 모델에게 후보 중 하나를 고르게 하면 정답이 후보 안에 있는데도(상한 0.9 이상) 단독 쓰기보다 낮았습니다. 반대로 '기사에 이유가 명시돼 있는가'를 따로 물으면 Nimble이 AUROC 0.85로 가려냈고, 이것을 Flash 뒤에 붙이자 '왜'가 0.73에서 0.79로, 쓰기 모델 셋의 다수결로는 0.85로 올랐습니다. 이 과제의 절반은 답을 찾는 일이고 나머지 절반은 '없다'고 말하는 일입니다. 방법별 점수표·기사별 탐색기·판정 앙상블·부재 탐지·파이프라인 설계기 위젯 5개와 삽화 6장.
원본 대 복제품 — Jev와 tev1·Nimble을 같은 한국어 문제 5,000개로 직접 붙이다 (로컬 모델 실측 4편)
2편에서 로컬 판정 모델 tev1·Nimble을 한국어로 쟀을 때 비교 대상인 Jev의 수치는 6편에서 빌려 온 것이었습니다. 코퍼스도 589건이었고 묻는 방식도 달랐습니다. 이 글은 그 빚을 갚습니다. TypeSafe의 Jev 1.13 API를 같은 날, 같은 660건·85문항·625건·93문항에, 글자 하나 다르지 않은 같은 프롬프트로 직접 돌려 로컬 모델 셋과 나란히 놓았습니다. 리랭커 자리(쌍별·한꺼번에, 지시문 두 가지), 작은 임베딩 다섯에 붙인 조합, 분류 625건, 실무 과제 7종, 보정 곡선, 그리고 '둘이 같은 문항을 틀리는가'까지 봤습니다. 결론은 둘입니다. 원본은 묻는 방식을 가리지 않는데 복제품은 가린다. 그리고 복제품이 원본의 자리를 대신하는 과제와 못 대신하는 과제가 분명히 나뉜다. 비용·지연·데이터 반출을 한 계산기로 놓고 어느 쪽을 고를지로 끝냅니다. 인터랙티브 5개와 삽화 4장.