
#Cloudflare
4개의 포스트
[특집] PHP2Shell 사흘의 기록 — AI가 바꾼 취약점의 속도, 유출된 엠바고, 그리고 지금 서버 운영자가 할 일
10월 21일 PHP 엔진 자체의 치명적 취약점 두 건이 공개됐습니다. 웹사이트의 약 70%가 쓰는 언어라는 점 때문에 영국 정부 서비스 32개가 내려갔고 한국은 사이버위기 경보를 올렸습니다. 이 글은 결함의 해부가 아니라 사건의 기록입니다. 22년 전 첫 경고, 2024년 감사에서 'DoS'로 분류된 보고, 하루 앞당겨진 공개, 엠바고 논쟁, 아마존 미끼 서버가 공개 나흘 전에 잡은 시도, '70%'라는 숫자의 해석, 그리고 운영자 점검표까지 정리했습니다.
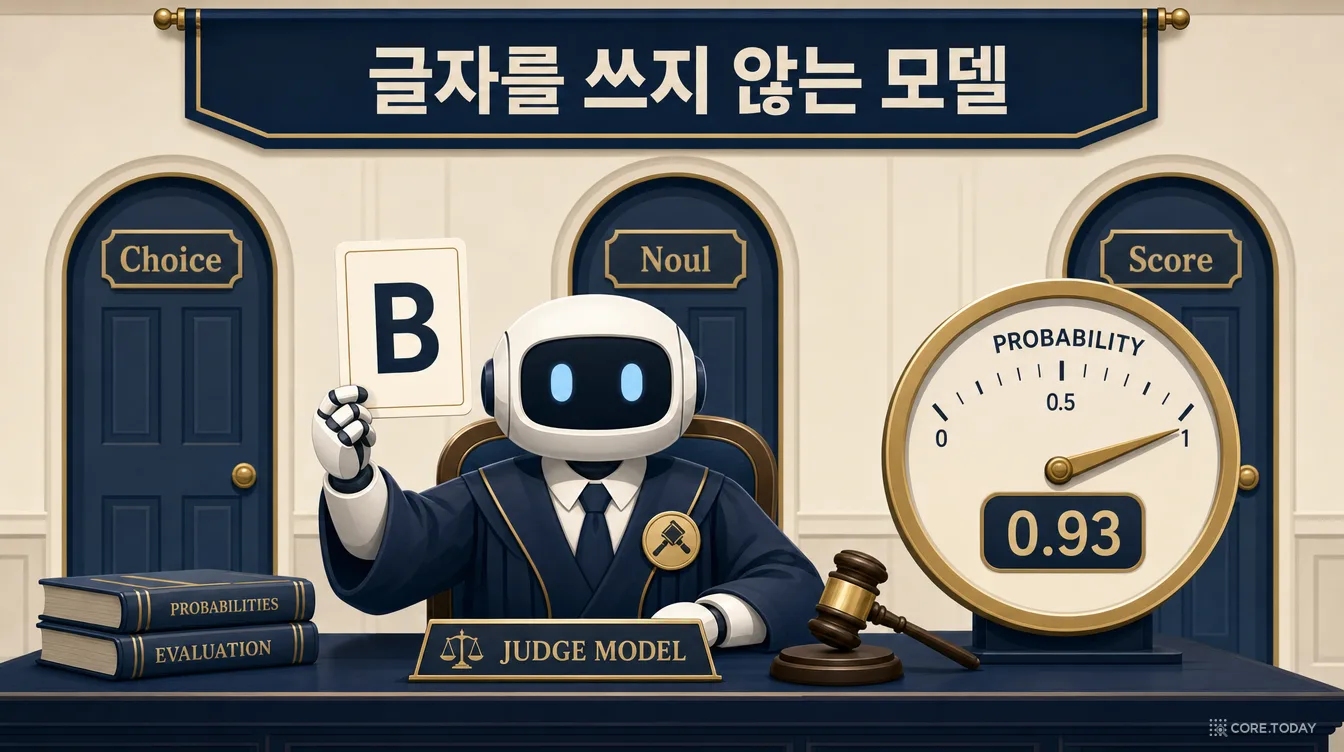
글자를 쓰지 않는 로컬 모델 — Ollama 판정 모델 tev1·Nimble을 한국어로 시험하다 (로컬 모델 실측 2편)
ollama list에 낯선 이름 둘이 있었습니다. tev1:4b와 nimble. ollama show를 쳐 보니 Capabilities에 embedding도 completion도 아닌 'decision'이 적혀 있고, 시스템 프롬프트는 '선택지 중 하나를 고르고 글자 하나만 돌려줘라'였습니다. 9월 15일 TypeSafe가 Jev를 내놓은 뒤 2주 만에 Bespoke Labs(Nimble 9B)와 Together AI(tev1 4B·0.8B)가 열린 가중치로 같은 모양의 모델을 냈고, 9월 29일 Ollama가 /v1/systemone 엔드포인트로 그것을 받아들였고, 10월 1일 클라우드플레어가 27B짜리 Clef를 보탰습니다. 이 글은 그 판정 모델이 무엇이고 왜 빠른지(한 번의 전방 패스에서 선택지 글자의 확률만 읽는다)를 그림으로 풀고, 세 모델의 출신과 학습 레시피를 뜯어본 뒤, 1편과 같은 한국어 코퍼스로 리랭커 자리(85문항 × 10문서)와 분류 자리(625건)에 세워 TypeSafe의 Jev(4편에서 같은 조건으로 직접 실측), 임베딩 이웃 투표, 27B 채팅 모델과 비교했습니다. 결론은 '9B Nimble은 한국어로도 Jev의 자리를 대신하고, 0.8B는 아직 아니다'입니다. 확률이 얼마나 믿을 만한지, 한 번 호출에 몇 ms인지, 한국어 문의 라우팅·규정 적용·감정 점수 같은 실무 과제 7종의 성적도 함께 적었습니다. 인터랙티브 6개와 삽화 7장.
[특집] '쉬우면 베껴도 된다'는 없다 — Thomson Reuters v. ROSS 항소심과 RAG·리걸테크 저작권 지도
9월 29일 미국 제3순회항소법원이 AI와 공정이용에 관한 첫 항소심 판결을 냈습니다. 법률 리서치 스타트업 ROSS가 웨스트로의 판례 요지(헤드노트)로 AI를 훈련한 것은 공정이용이 아니라는 결론입니다. 판결문을 읽어 보면 핵심은 'AI 학습이냐'가 아니라 '원본 시장을 대체하느냐'와 '꼭 필요했느냐'에 있었습니다. 법원은 원본 판례는 자유롭게 쓸 수 있었는데 편해서 헤드노트를 베꼈다며 이렇게 썼습니다. '필요와 달리 편의는 복제의 정당화 사유가 아니다.' 생성형 학습을 공정이용으로 본 Bartz·Kadrey 판결, 독일 GEMA v. Suno, 한국의 지상파 3사 v. 네이버 소송과 개인정보 AI 특례까지 엮어, 검색·요약형 AI 서비스가 어디서 위험해지는지 지도로 그렸습니다.
제로클릭 시대 — AI가 웹의 오래된 계약을 파기했다
2026년 8월, 프랑스 신문협회가 구글을 경쟁당국에 제소했다. AI 요약이 언론사 트래픽을 최대 38% 깎아냈다는 규제기관의 추정이 근거였다. 30년간 웹을 지탱해 온 암묵적 계약 — '콘텐츠를 긁어가는 대신 방문자를 돌려보낸다' — 이 깨지고 있다. 구글은 크롤 5번에 방문자 1명을 돌려보내지만, AI 크롤러는 수천, 수만 번을 긁고 1명을 돌려보낸다. Stack Overflow의 질문은 76% 줄었고, 한국의 네이버 블로거들은 수익 급감을 호소한다. 이 글은 이 계약이 어떻게 만들어졌고 왜 깨졌는지, 지금 무슨 일이 벌어지고 있는지, 그리고 콘텐츠를 만드는 조직이 실무적으로 무엇을 해야 하는지를 정리한다.