
#Best-of-N
2개의 포스트
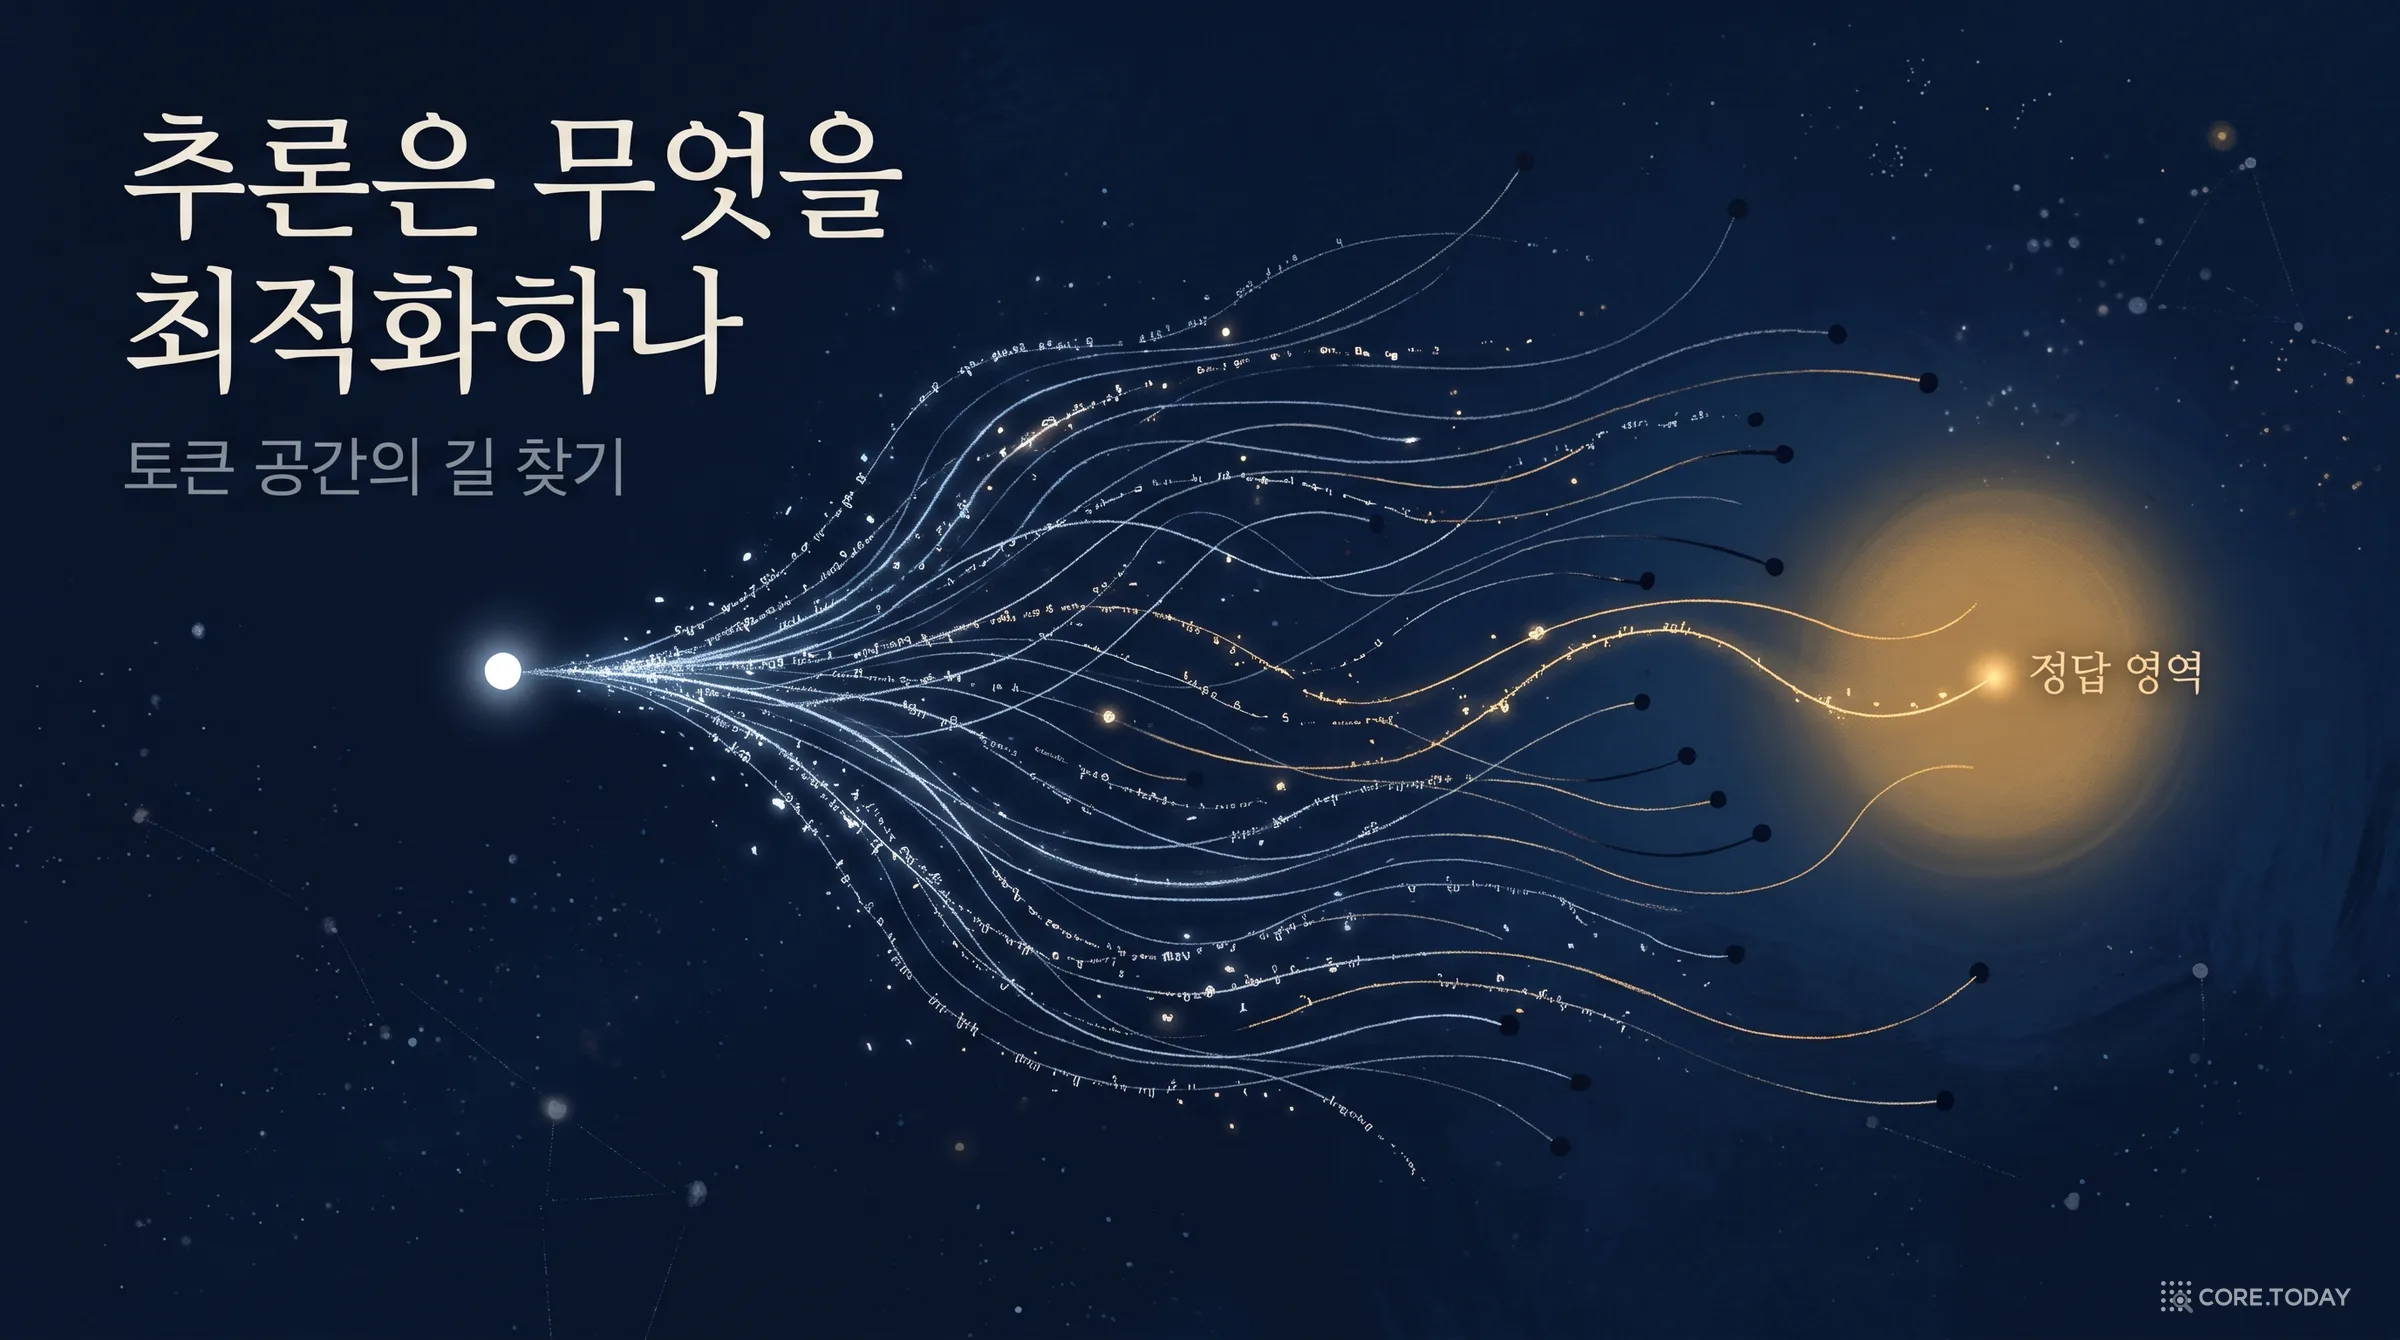
[특집] 추론은 무엇을 최적화하나 — 토큰 공간의 길 찾기로 다시 읽는 추론 모델, 강화학습, 그리고 보상 해킹
추론 모델을 강화학습으로 훈련하면 생각이 길어지고 정확도가 오른다. 그런데 이미 훈련된 모델에게 억지로 더 오래 생각시키면 좋아지다가 멈추고, 때로는 나빠진다. 알렉스 왕(Alex Wang)은 2026년 11월 8일 글 「추론은 어떤 목적함수를 푸는가」에서 이 수수께끼를 '토큰 공간의 길 찾기'라는 그림 하나로 푼다. 생각의 사슬 하나는 프롬프트에서 정답 집합으로 가는 길 하나이고, 강화학습이 올리는 것은 개별 길의 품질이 아니라 길들의 분포가 정답에 닿을 확률 pₓ라는 것이다. 이 글은 원문의 수식을 한 줄씩 풀고, 1956년 논리 이론가에서 AlphaZero, STaR, 「대형 언어 원숭이」, DeepSeek-R1, s1까지 '추론 = 탐색'의 계보를 따라가며, 그 관점이 설명하는 세 가지(생각 길이의 한계, 생각의 사슬이 진짜 이유가 아닌 이유, 보상 해킹)를 논문 그림과 사례로 확인한다. 로컬 모델(qwen3.5 4B)로 같은 답에 이르는 서로 다른 길, k번 뽑기의 힘, 생각 예산을 자르고 늘렸을 때의 정답률을 직접 재고, 위젯 6개로 길 찾기·k번 뽑기·REINFORCE=RFT·상각·불완전한 검증기를 만져 본다.
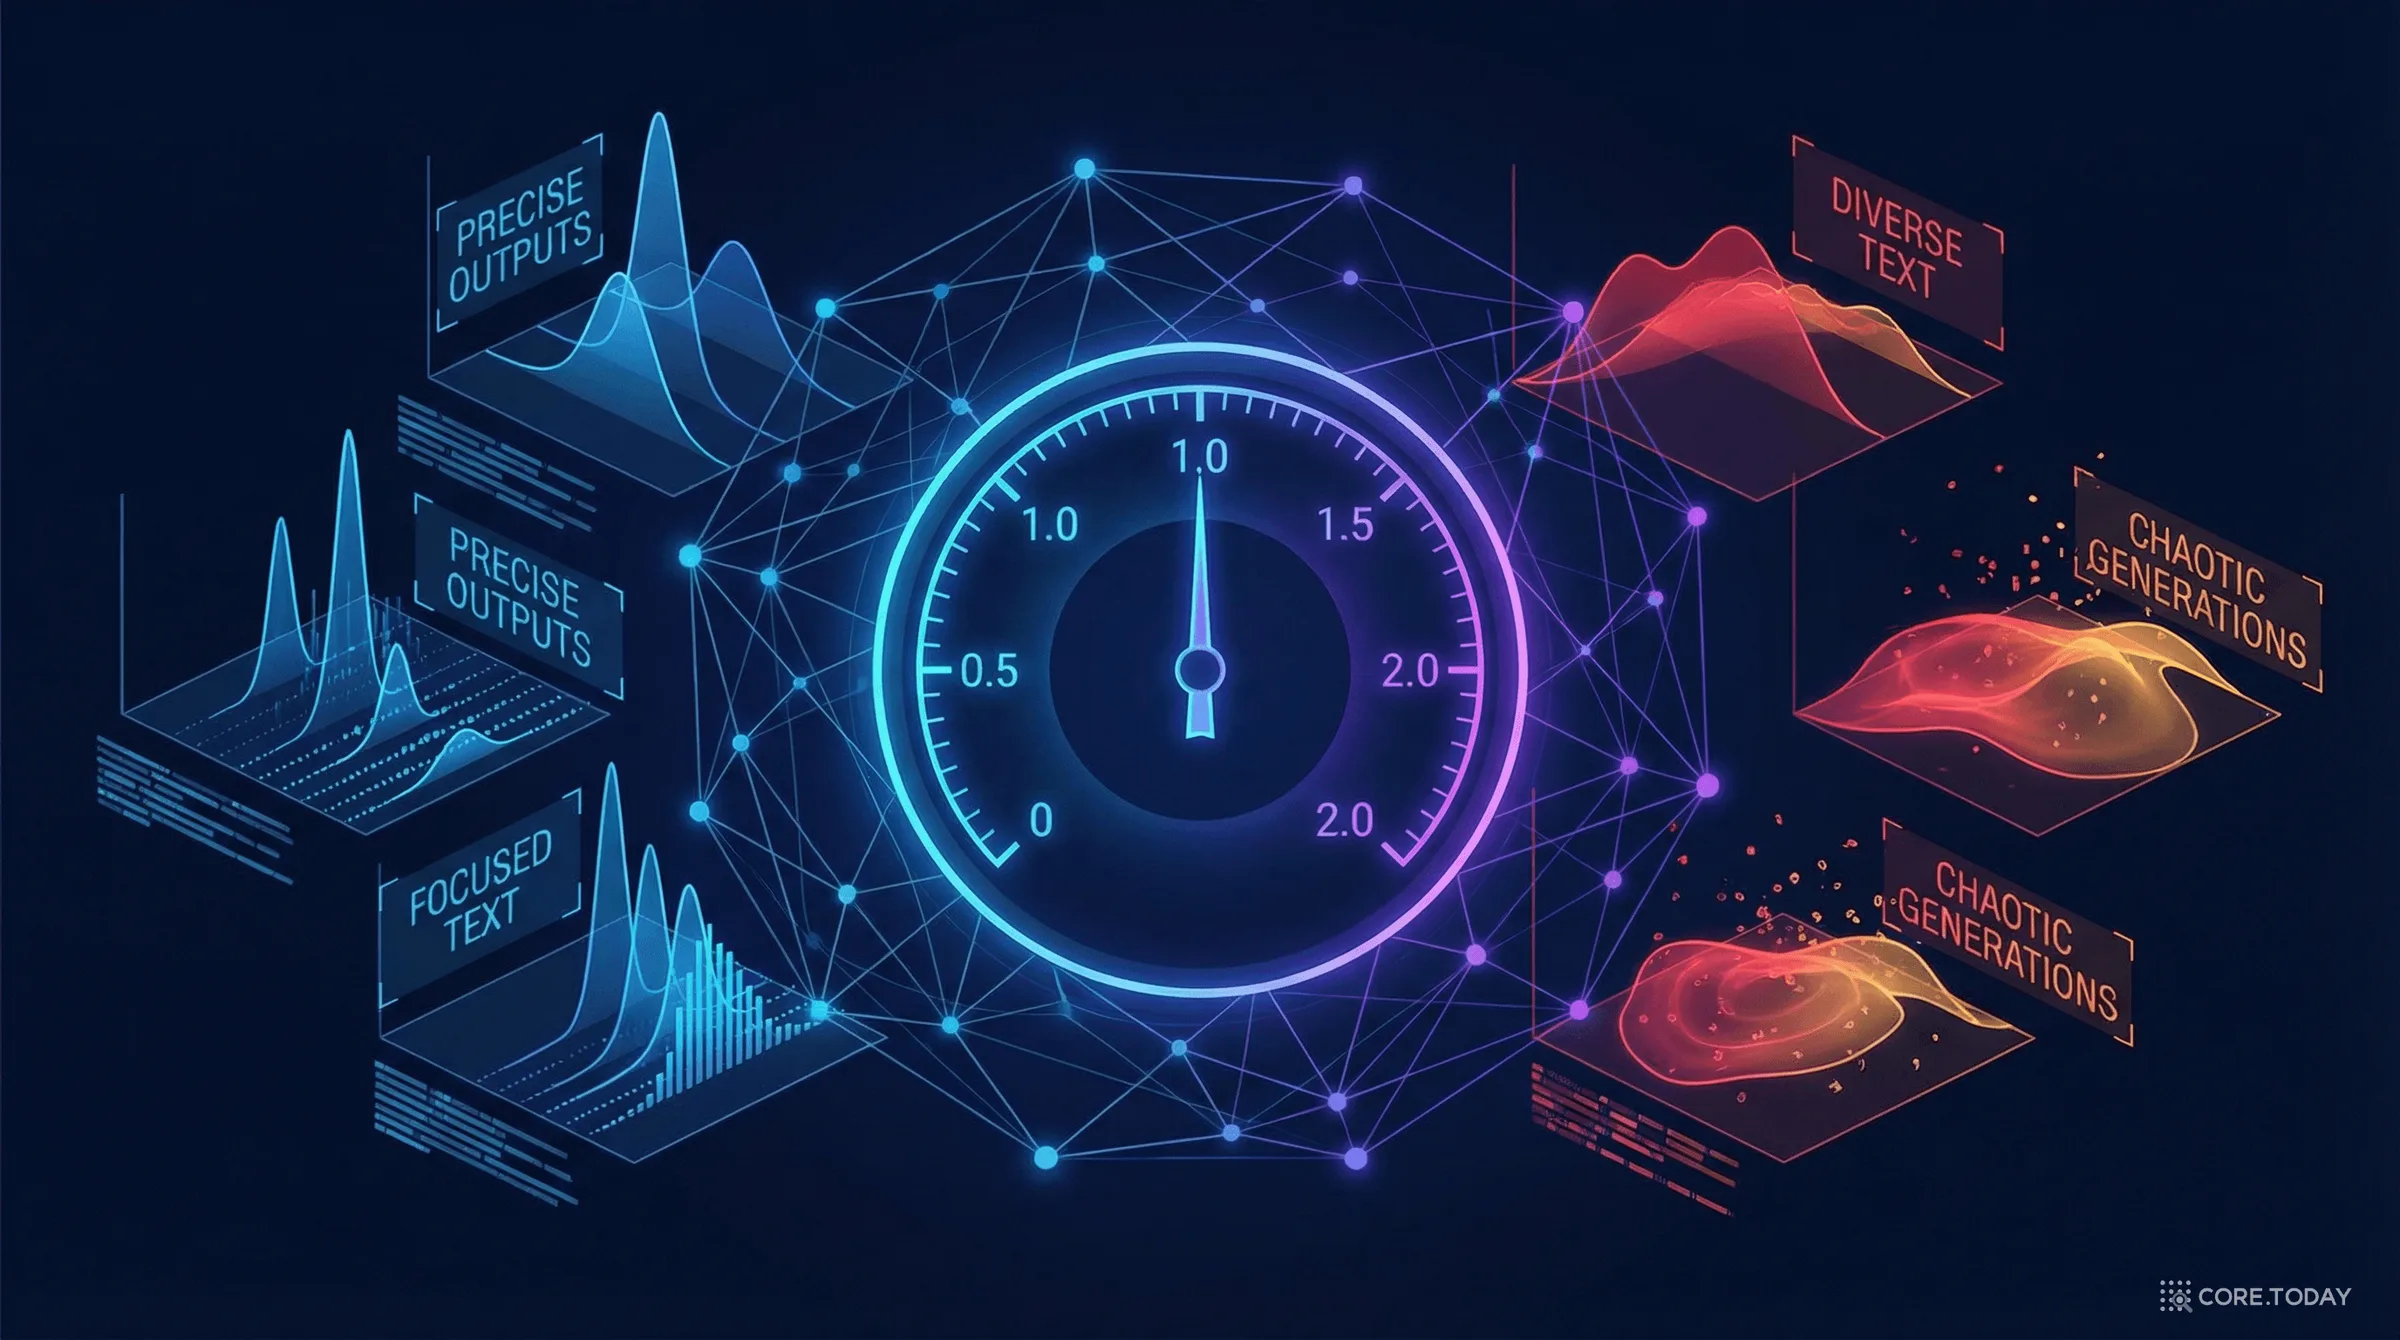
Temperature 특집: AI의 '창의성 다이얼'을 과학적으로 돌리는 법 — TURN 알고리즘과 멀티샘플 추론의 최적 온도
ChatGPT에 같은 질문을 여러 번 하면 매번 다른 답이 나온다. 이 '랜덤함'을 조절하는 핵심 파라미터가 Temperature다. 2025년 ICML에서 발표된 TURN 알고리즘은 라벨 데이터 없이 모델별 최적 Temperature를 자동으로 찾아내는 방법을 제시했다. 요리사의 불 조절처럼, AI도 '딱 맞는 온도'가 있다.