
#하이브리드 검색
9개의 포스트
도구는 넷, 자리는 넷 — BM25·임베딩·Jev·코드를 적재적소에 쓰는 한국어 검색 실측 (한국어 검색 스택 8편)
6편에서 Jev는 리랭커로 강했고, 7편에서는 환각 검문소로 강했습니다. 그렇다면 검색의 모든 단계를 Jev에 맡기면 될까요? 이 글은 한국어 질문 134개를 다섯 가족(키워드·의미·제외 조건·두 주제·날짜·카테고리)으로 나눠 BM25, 임베딩 둘, 하이브리드, Jev, 그리고 정규식 몇 줄짜리 코드 필터를 열세 가지 방식으로 조합해 실측했습니다. 질문의 종류가 바뀌면 이기는 도구가 바뀌었습니다. '쿠버네티스는 빼고'라고 하면 임베딩과 BM25는 쿠버네티스 글을 상위 10개의 절반쯤 가져왔고 Jev가 그것을 19%로 줄였습니다. 날짜 질문에서는 Jev가 날짜 판정 807쌍을 전부 맞혔는데도 코드 필터에 졌습니다. 판정이 아니라 후보가 문제였기 때문입니다. 각 도구를 제자리에 둔 설계는 모든 질문에 Jev를 쓰는 방식보다 점수가 높으면서 Jev 호출은 40%였습니다. Jev 9,521회 호출에 0.26달러. 인터랙티브 5개와 삽화 7장.
BM25는 한국어를 어떻게 쪼개나 — 조사·복합명사·영한 혼용, 토크나이저가 검색을 결정한다 (한국어 검색 스택 5편)
2편에서 BM25는 '약한 고리'였습니다. 왜 약했을까요. 이 글은 그 질문을 파고듭니다. 같은 문서, 같은 질문, 같은 BM25 공식에 토크나이저만 여덟 가지로 바꿔 보니 nDCG@10이 0.42에서 0.62까지 벌어졌습니다. 띄어쓰기로 자르면 '청년취업을'과 '청년취업'이 다른 단어가 되고, 형태소 분석기로 조사를 떼면 같은 단어가 되며, 글자 2-gram을 겹쳐 색인하면 사전에 없는 말까지 받아 줍니다. 한국어에서 어휘 검색이 어려운 세 가지 이유(교착어의 조사와 어미, 복합명사, 영한 혼용)를 예시 문장의 실제 토큰으로 보여 주고, 엘라스틱서치 nori의 decompound 모드와 불용 품사 기본값, Kiwi의 사용자 사전, BM25의 k1·b 다이얼을 실측으로 짚습니다. 결론은 BM25 자체가 약한 것이 아니라 한국어를 잘못 쪼갠 BM25가 약하다는 것입니다. 인터랙티브 4개와 삽화 8장.
[특집] 벡터 데이터베이스는 죽었다? — 터보퍼퍼가 벡터를 '색인 하나'로 내린 이유와 2026년 검색 인프라의 지각변동
2026년 9월 30일, 커서·노션·앤트로픽의 검색을 떠받치는 터보퍼퍼가 「RIP, vector database」라는 글을 올렸습니다. 3년 동안 모든 데이터를 벡터 클러스터 주소 아래 저장해 온 구조를 버리고, 벡터 색인을 '또 하나의 보조 색인'으로 내린다는 선언입니다. 벡터 하나가 이사하면 문서 전체와 색인이 따라 움직이는 쓰기 증폭, 토큰마다 문서를 복사하는 저장 증폭, 100~200개 상자에 갇힌 CPU — 원문이 밝힌 세 가지 이유를 키-값 예시 그대로 풀고, 2016년 우버가 포스트그레스를 떠난 이유와 InnoDB의 클러스터드 인덱스까지 거슬러 올라갑니다. 그리고 이 글이 터보퍼퍼만의 이야기가 아닌 이유 — 모든 DB가 벡터를 품고, S3가 벡터를 저장하고, 파인콘이 BM25를 붙이고, 클로드 코드가 grep을 고른 2025~2026년의 흐름을 검증된 숫자로 짚습니다. 인터랙티브 6개와 삽화 11장.
키워드와 의미, 둘 다 쓴다 — BM25·벡터·RRF·리랭커, 논문과 실측으로 보는 하이브리드 검색 (한국어 검색 스택 2편)
원문 메모의 그림은 이랬습니다. BM25와 벡터 검색을 나란히 돌리고, 결과를 RRF로 합치고, 리랭커로 다시 고른다. 이 글은 그 그림의 각 칸을 논문과 실측으로 채웁니다. 2009년 SIGIR의 두 쪽짜리 논문이 제안한 RRF는 점수 대신 등수만 쓰는 단순한 공식인데 왜 통하는지, k=60은 어디서 왔는지, 2023년 TOIS 논문은 왜 '점수 융합이 RRF보다 낫다'고 했는지, 2025년의 '약한 고리' 발견은 무엇인지. 그리고 1편의 한국어 코퍼스로 직접 재 보니, 등가중 RRF는 벡터 단독보다 오히려 나빴고 이유는 BM25가 약한 고리였기 때문이었습니다. 반면 강한 임베딩 둘(Qwen3-8B + BGE-M3)을 RRF로 합치자 어느 쪽 단독보다 좋아졌습니다. 리랭커는 '따로 읽고 비교'하는 바이 인코더와 '같이 읽고 판정'하는 크로스 인코더의 차이로 풀고, 로컬 LLM을 리랭커로 써서 상위 10개의 순서가 얼마나 바뀌는지 잽니다. 인터랙티브 5개와 삽화 8장.
문서를 한 점으로 누르지 않는다 — KURE-v2와 한국어 late interaction 검색 (RAG 특집 7편)
154M 파라미터짜리 한국어 검색 모델이 MTEB 한국어 검색 9과제 평균에서 7.6B·27B 단일 벡터 모델을 앞섰다. 비결은 크기가 아니라 비교 방식이다. 문서 전체를 벡터 하나로 누르는 대신 토큰마다 128차원 벡터를 남겨 두고, 질의 토큰마다 가장 잘 맞는 문서 토큰을 찾아 더한다(MaxSim). 2026년 8월 29일 공개된 KURE-v2는 이 late interaction 방식을 한국어·영어에 적용한 첫 본격 모델이다. 이 특집은 단일 벡터가 무엇을 잃는지, 조사·형태소·영한 혼용이 많은 한국어에서 토큰 단위 비교가 왜 유리할 수 있는지, 평균 1위 뒤에 숨은 과제별 승패, 문서마다 벡터 수백 개를 저장하는 대가와 그것을 1.7GB로 줄이는 법, 그리고 Qwen3 임베딩과 공정하게 비교하는 실험 설계를 위젯 5종으로 따라간다. 결론은 3편과 같다 — 기본은 하이브리드, late interaction은 고가치 한국어 질의에만.
질문마다 다른 검색기, 다른 모델, 다른 예산 — 동적 라우팅과 DRAG (RAG 특집 3편)
HotpotQA 질의의 22%는 BM25만으로 검색해도 정답이 나온다. 가장 비싼 구성이 꼭 필요한 질의는 15.6%다. 그런데 대부분의 RAG는 모든 질의에 같은 검색기와 같은 모델을 쓴다. 2026년 9월 15일 공개된 DRAG는 검색기 4단계 × 생성기 추론 강도를 전부 조합해 잰 뒤 두 가지를 보여 줬다 — 더 강한 검색이 더 많은 추론보다 크게 이기지만 단조롭게 좋아지지는 않는다는 것, 그리고 정답을 아는 오라클 라우터는 최고 정적 구성보다 정확하면서 지연은 절반이라는 것. 이 특집은 1편의 5경로 라우팅을 8경로로 확장하고, 라우터가 경로와 함께 정해야 하는 8가지 결정, 오라클 대비 손실(router regret)을 재는 법, 그리고 같은 날 나온 추론형 임베딩(CoFree)·추론형 재랭커(MERIT-Rank)가 라우터의 선택지를 어떻게 늘렸는지를 위젯 5종으로 따라간다. 결론은 하나다 — 추론형 부품은 맨 위 한 단이고, 대부분의 질의는 아래에서 끝나야 한다.
검색은 파이프라인이 아니라 에이전트가 되었다 — Agentic Search 완전 해부 (RAG 특집 1편)
‘1953년 월별 국방비 지출 합계는?’ 스캔된 재무부 회보 8만 9천 쪽에서 이 질문에 답하는 one-shot RAG의 정답률은 6.3%였다. 같은 모델에 search·open·navigate·read·grep 다섯 도구를 쥐여 주자 51.9%가 됐다. 2026년의 RAG는 더 좋은 임베딩 하나를 고르는 일이 아니라, 질문과 현재 상태를 보고 증거를 찾고 문서 안을 이동하고 충분한지 판단하고 예산 안에서 멈추는 에이전트를 설계하는 일로 바뀌고 있다. 이 특집은 A-RAG·LLM-Wiki·DCI 세 연구와 Mistral의 제품화를 따라가며, 왜 도구가 늘었는데 토큰은 줄었는지, 어느 질의를 어느 경로로 보내야 하는지, 몇 스텝에서 끊어야 하는지를 인터랙티브 위젯 6종으로 직접 만져 본다. RAG 특집 시리즈의 첫 글이다.
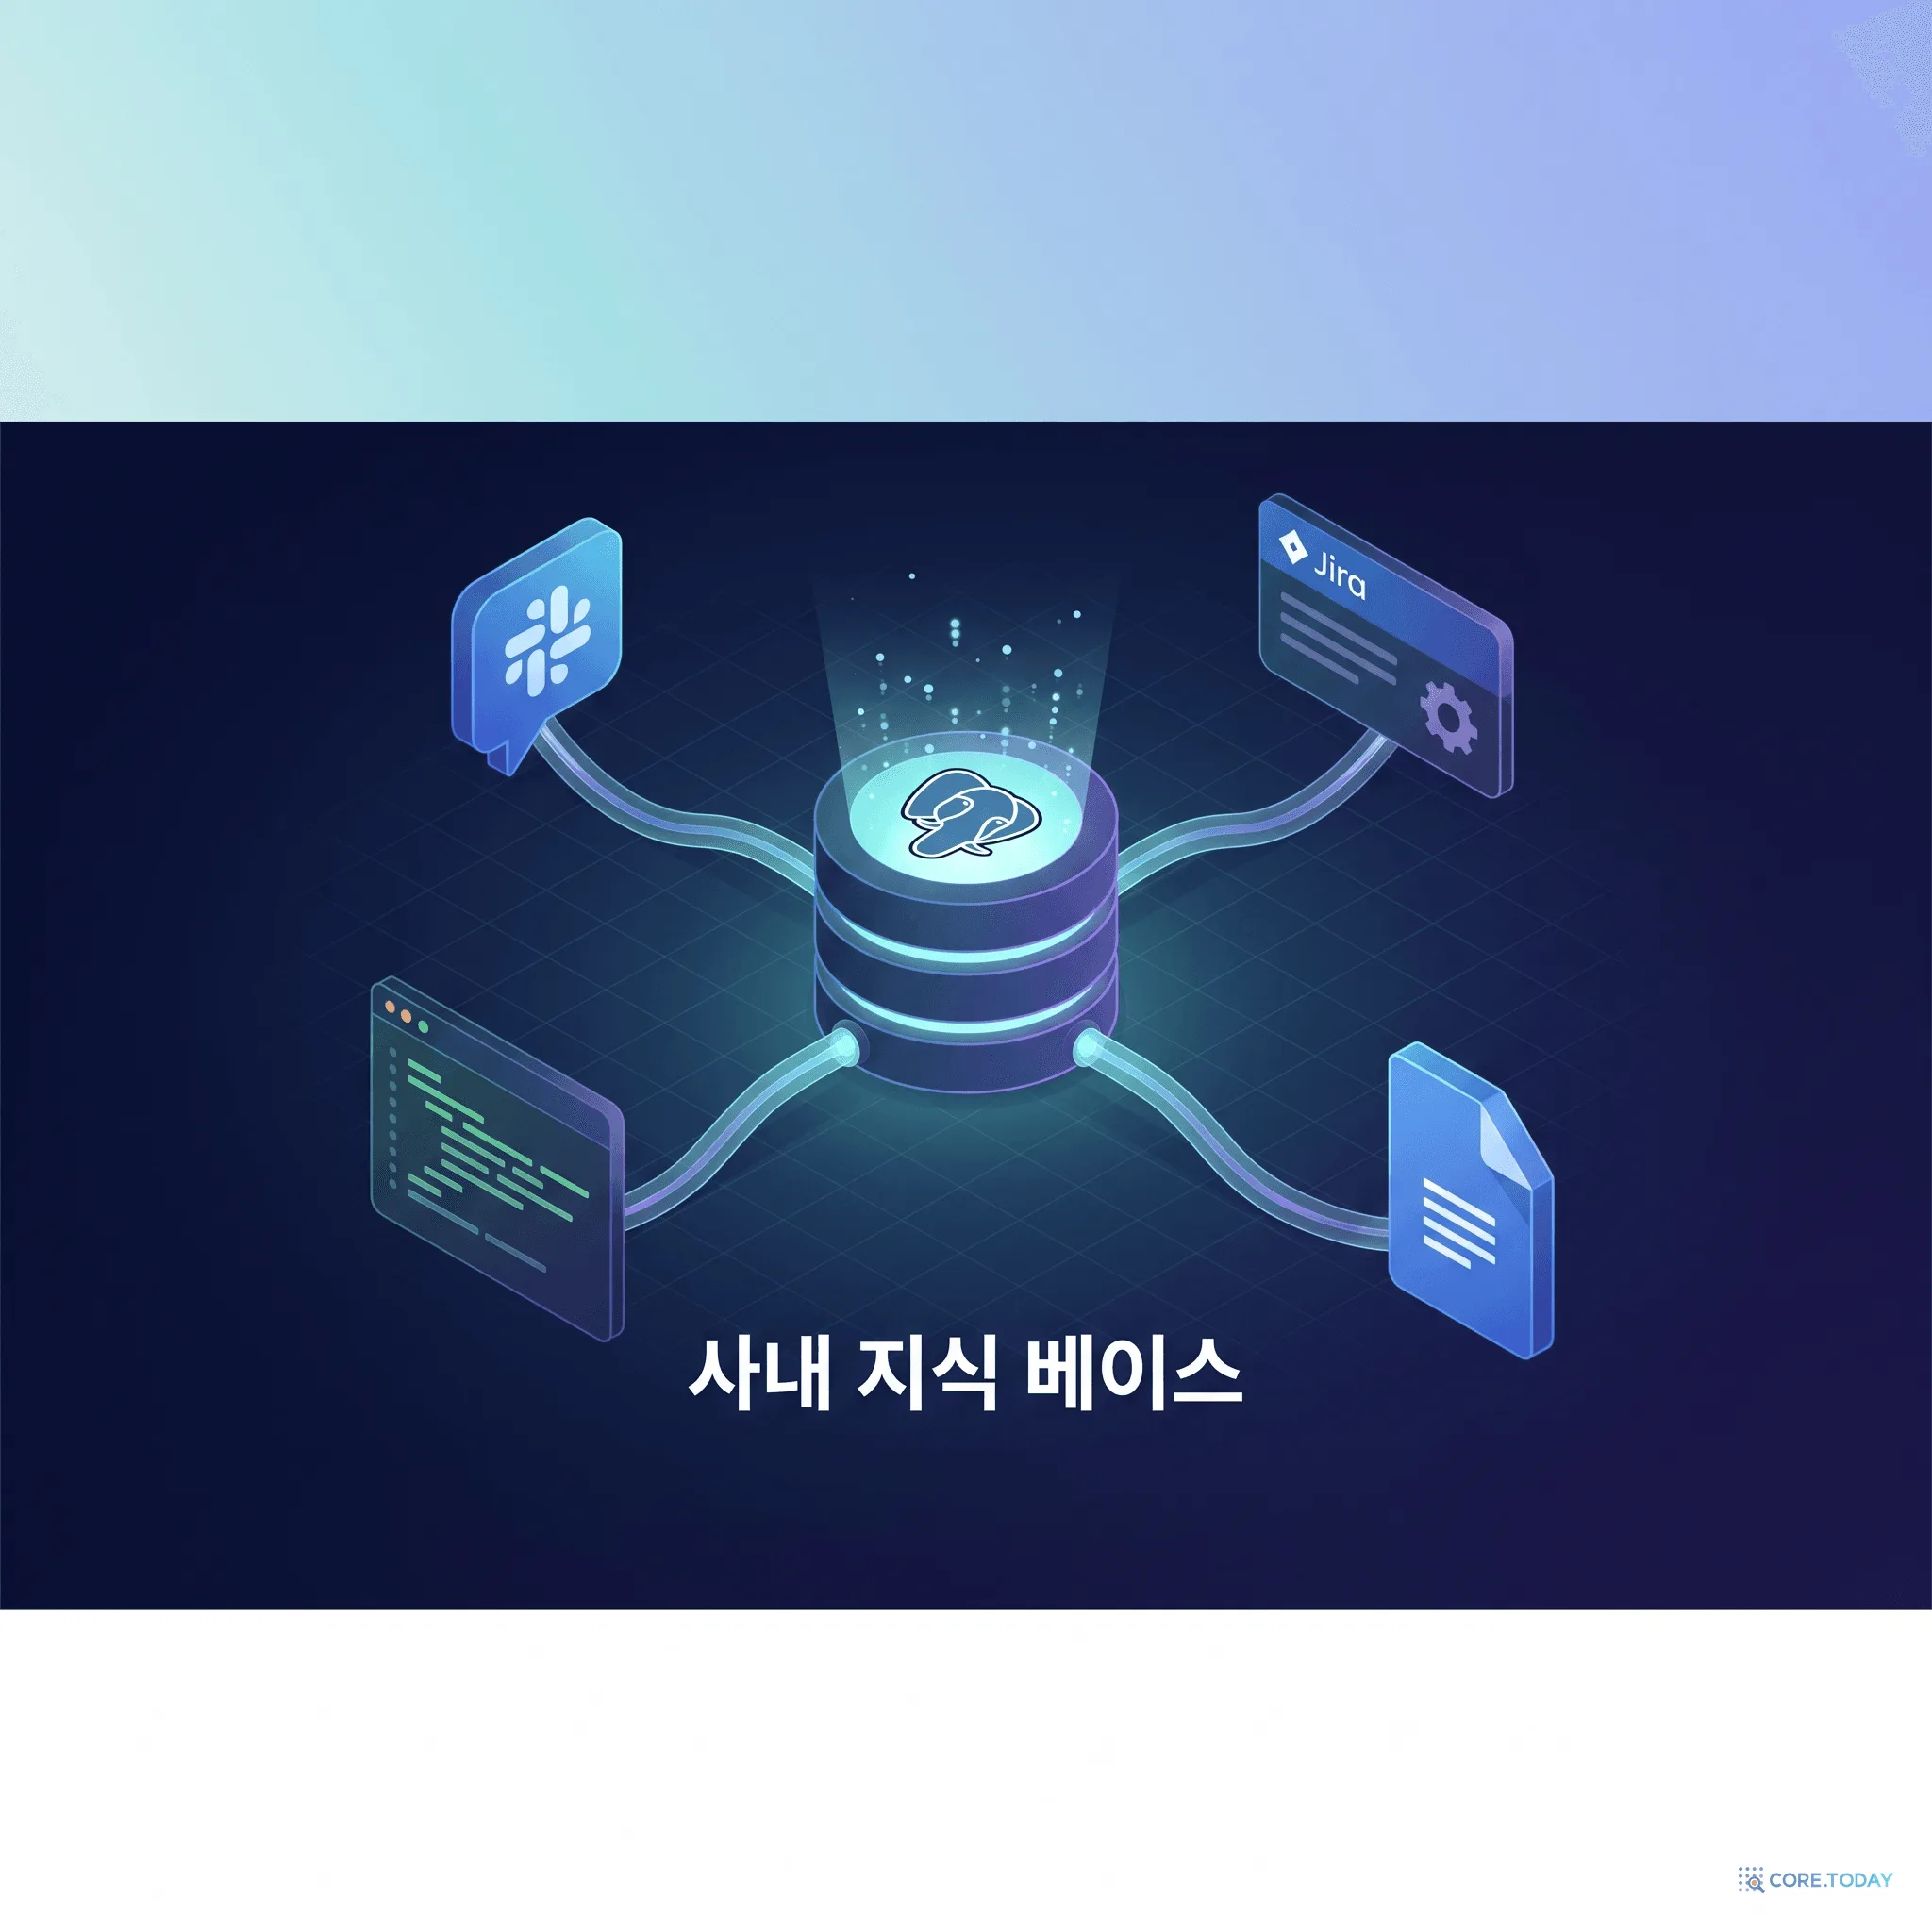
하루 15,000개의 질문에 답하는 사내 AI — Cerebras는 지식 베이스를 어떻게 만들었나
"그거 어디 있죠?" "이거 누가 담당이죠?" — 회사가 커질수록 정보는 흩어지고, 같은 질문이 반복된다. Cerebras는 Slack·코드·문서를 하나의 임베딩 테이블로 모아 하루 15,000개 질문에 답하는 사내 지식 베이스를 만들었다. 그 안에는 반세기 검색의 역사가 응축돼 있다. 키워드 검색에서 BM25, 임베딩, HNSW, 하이브리드, 그리고 에이전트 검색까지 — 왜 이런 개념들이 하나씩 필요해졌는지, 인터랙티브하게 만져보며 이해한다.
Advanced RAG: 기본 RAG의 한계를 넘는 실전 개선 기법 7가지
기본 RAG를 실전에 배포하면 마주치는 문제들 — 엉뚱한 문서가 검색되고, 핵심이 잘려나가고, 답변 품질이 들쭉날쭉하다. 청킹 전략부터 하이브리드 검색, 리랭킹까지, 실무에서 바로 적용할 수 있는 개선 기법을 하나씩 풀어본다.