
#프롬프트
4개의 포스트
한 줄만 틀려도 버린다 — 뉴스 4만 7천 묶음을 읽힐 LLM, 7종 12가지 설정을 같은 검증기로 재다
사실탐색기는 같은 사건을 다룬 기사 묶음 4만 7,300개에서 주장·시점·같은 사건 관계를 원문 인용과 함께 뽑아야 합니다. 어느 모델에 맡길지 정하려고 Claude 3종, DeepSeek Flash, Muse Spark, 무료 K-EXAONE, 사내 A100에 올린 Qwen3.8-27B까지 7종 12가지 설정을 같은 지시문과 같은 검증기로 쟀습니다. 검증기는 행 하나만 틀려도 이야기 전체를 거부합니다. 그래서 순위는 ‘통과하면 얼마나 잘하나’보다 ‘긴 이야기에서 끝까지 버티나’로 갈렸습니다. Claude Haiku 5.5는 7개를 모두 통과하며 기준 주장의 89%를 회수했습니다. DeepSeek·EXAONE·Qwen은 통과한 이야기에서는 72~88%를 회수하고도 긴 이야기를 거의 다 잃어, 판본에 남은 양이 14~29%였습니다. 지시문 한 줄은 Sonnet 5.5의 회수율을 34%에서 68%로 두 배 올렸지만 DeepSeek에는 독이 됐고, 생각 모드는 답 대신 생각만 남겼습니다. 무료와 할인의 조건, 사내 GPU로 돌리는 데 드는 시간, 주장 하나당 비용까지 정리했습니다. 위젯 3종, 코어닷투데이 실측, 삽화 6장.
예시 네 개, 순서만 바꿨을 뿐인데 — GPT-3의 퓨샷부터 유도 헤드, 예시 수천 개까지, 문맥 내 학습의 모든 것 (특집)
언어 모델에게 예시 몇 개를 보여 주면, 다시 학습시키지 않아도 새 일을 한다. 2020년 GPT-3가 ‘문맥 내 학습’이라 이름 붙인 이 능력은 지금 모든 프롬프트의 기본기다. 이 글은 GPT-2의 ‘TL;DR:’, GPT-3의 퓨샷, 순서만 바꿔도 54%와 93%를 오간 2021년 실험, 정답 라벨을 무작위로 바꿔도 거의 그대로였다는 2022년 연구, 큰 모델만 뒤집힌 라벨을 따른다는 2023년 연구, 모델 안의 ‘유도 헤드’, 예시 수천 개를 넣는 many-shot과 그 그림자인 탈옥 공격, 그리고 예시가 오히려 해롭다는 추론 모델까지 따라간다. 그리고 직접 쟀다. Qwen3 0.6B부터 14B, 카카오 Kanana를 한국어·영어 과제 셋에 돌렸고, 피티아 학습 체크포인트를 거슬러 올라가며 유도 헤드가 생기는 순간을 다시 찾았다. 같은 예시 네 개의 순서만 바꿔도 작은 모델의 한국어 감정 분류는 21%포인트 흔들렸고, 큰 모델에서는 그 폭이 줄었다. 라벨을 전부 뒤집으면 8B까지의 Qwen3 베이스 모델은 대부분 한쪽 라벨로 몰아 답했지만, 14B는 영어에서 뒤집힌 규칙을 따라 정확도가 28.5%로 떨어졌다. 인터랙티브 위젯 7종, 코어닷투데이 실측, 삽화 13장.
HTML의 비합리적인 효과 — 왜 Claude Code는 Markdown을 버리고 HTML로 갔나
Anthropic Claude Code 팀의 글 한 편이 X에서 800만 뷰를 찍으며 'Markdown은 끝났는가'라는 논쟁에 불을 붙였습니다. 제목의 계보(Wigner의 수학 → Halevy의 데이터 → 2026의 HTML)부터, 왜 에이전트 시대에 Markdown이 족쇄가 됐는지, 왜 LLM은 HTML을 '비합리적으로' 잘 만드는지, 그리고 그대로 써먹는 5가지 프롬프트까지 — 인터랙티브 데모와 일러스트로 쉽게 풀었습니다.
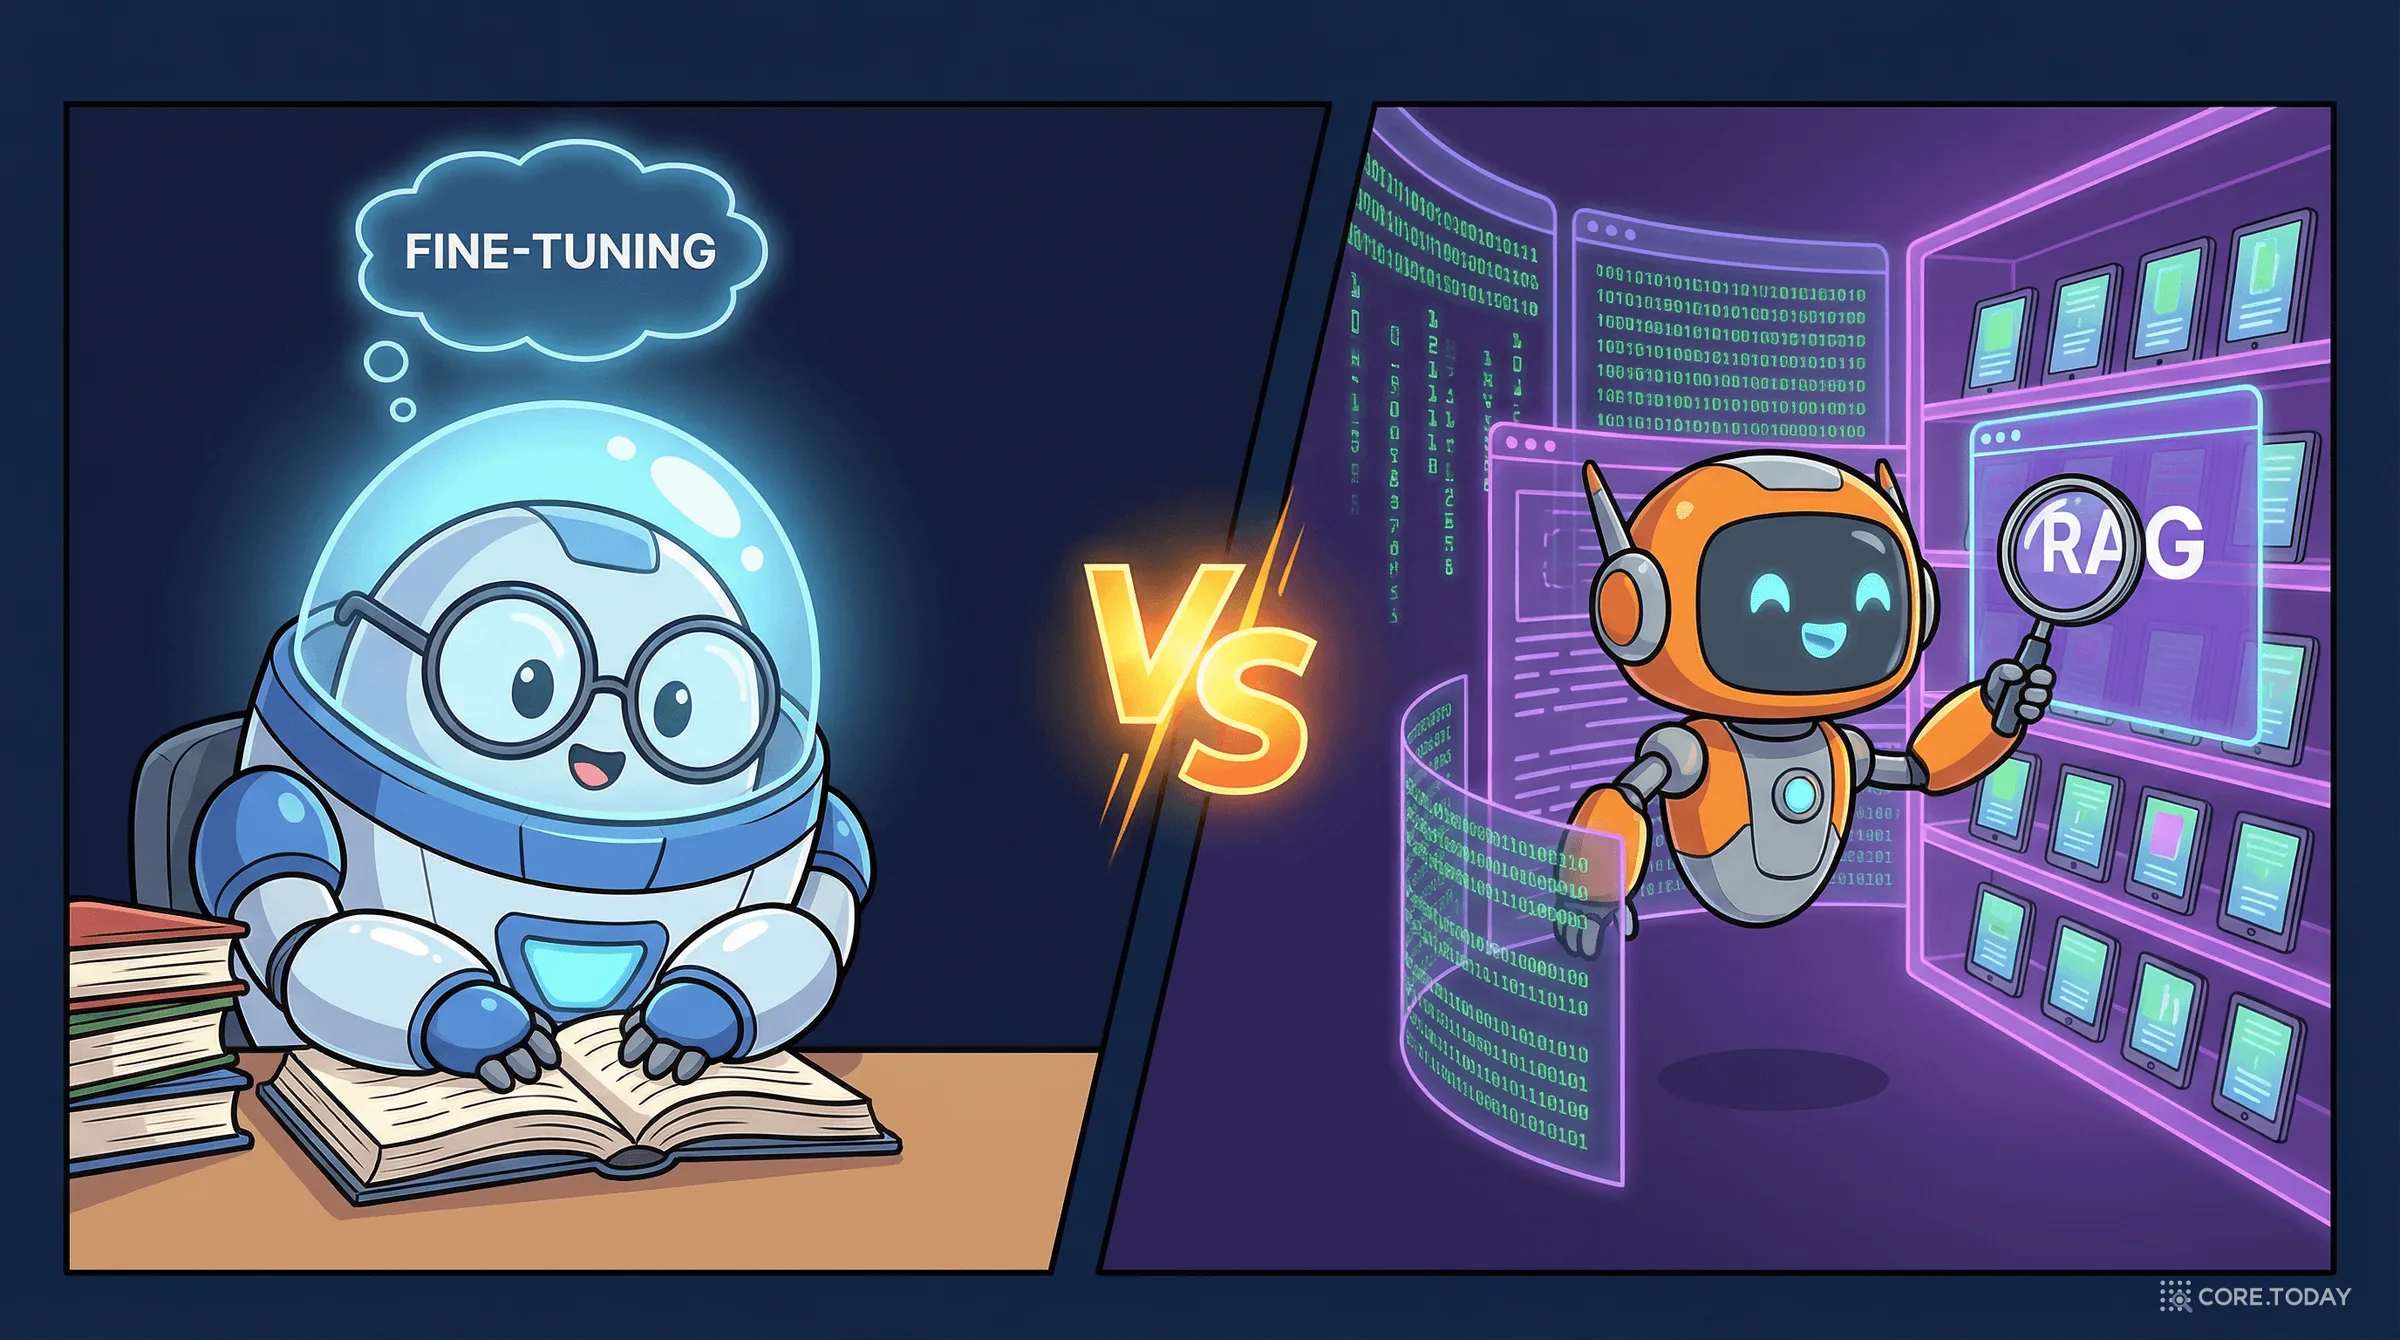
RAG vs Fine-tuning: AI에게 새로운 지식을 가르치는 두 가지 방법
ChatGPT에게 우리 회사 데이터를 알려주고 싶다면? RAG와 Fine-tuning, 2026년 실무에서 가장 많이 마주치는 이 선택지를 요리사 비유와 일러스트로 명쾌하게 정리합니다.