
#특집
67개의 포스트
LLM은 정말 도약하지 못하는가 — 「LLMs can't jump」를 증거의 법정에 세우다
「LLMs can't jump」는 고립된 비관론이 아니다. 과학철학의 조작적 가추, 기호 접지 문제, '쉬운 문제와 어려운 문제', 그리고 2026년까지 쏟아진 실증 연구가 한 점에서 만난다. 6,749명의 과학자가 평가한 25,139세트의 아이디어, 43명이 100시간씩 실행해 본 결과, cap set과 48회 행렬곱을 찾아낸 FunSearch·AlphaEvolve, 그리고 '신체 없는 가추'라는 정면 반론까지 — 찬성과 반례를 다섯 단계의 저울에 올린다.
Seedance 2.5 생성 노하우 — 한 줄 프롬프트가 30초 광고가 되기까지
ByteDance의 Seedance 2.5는 한 번에 30초, 레퍼런스 자산 50개, 타임스탬프 편집과 확장까지 지원한다. 그러나 기능이 늘어난 만큼 '어떻게 써야 원하는 결과가 나오는가'가 어려워졌다. 공식 프롬프트 가이드를 뼈대로, 같은 주제를 한 줄로 쓸 때와 구조화해서 쓸 때의 실제 생성 결과를 나란히 놓고 비교한다. 이미지 레퍼런스, 영상 확장, 영상 편집까지 직접 돌려 본 결과와 실패한 부분을 함께 기록한다.
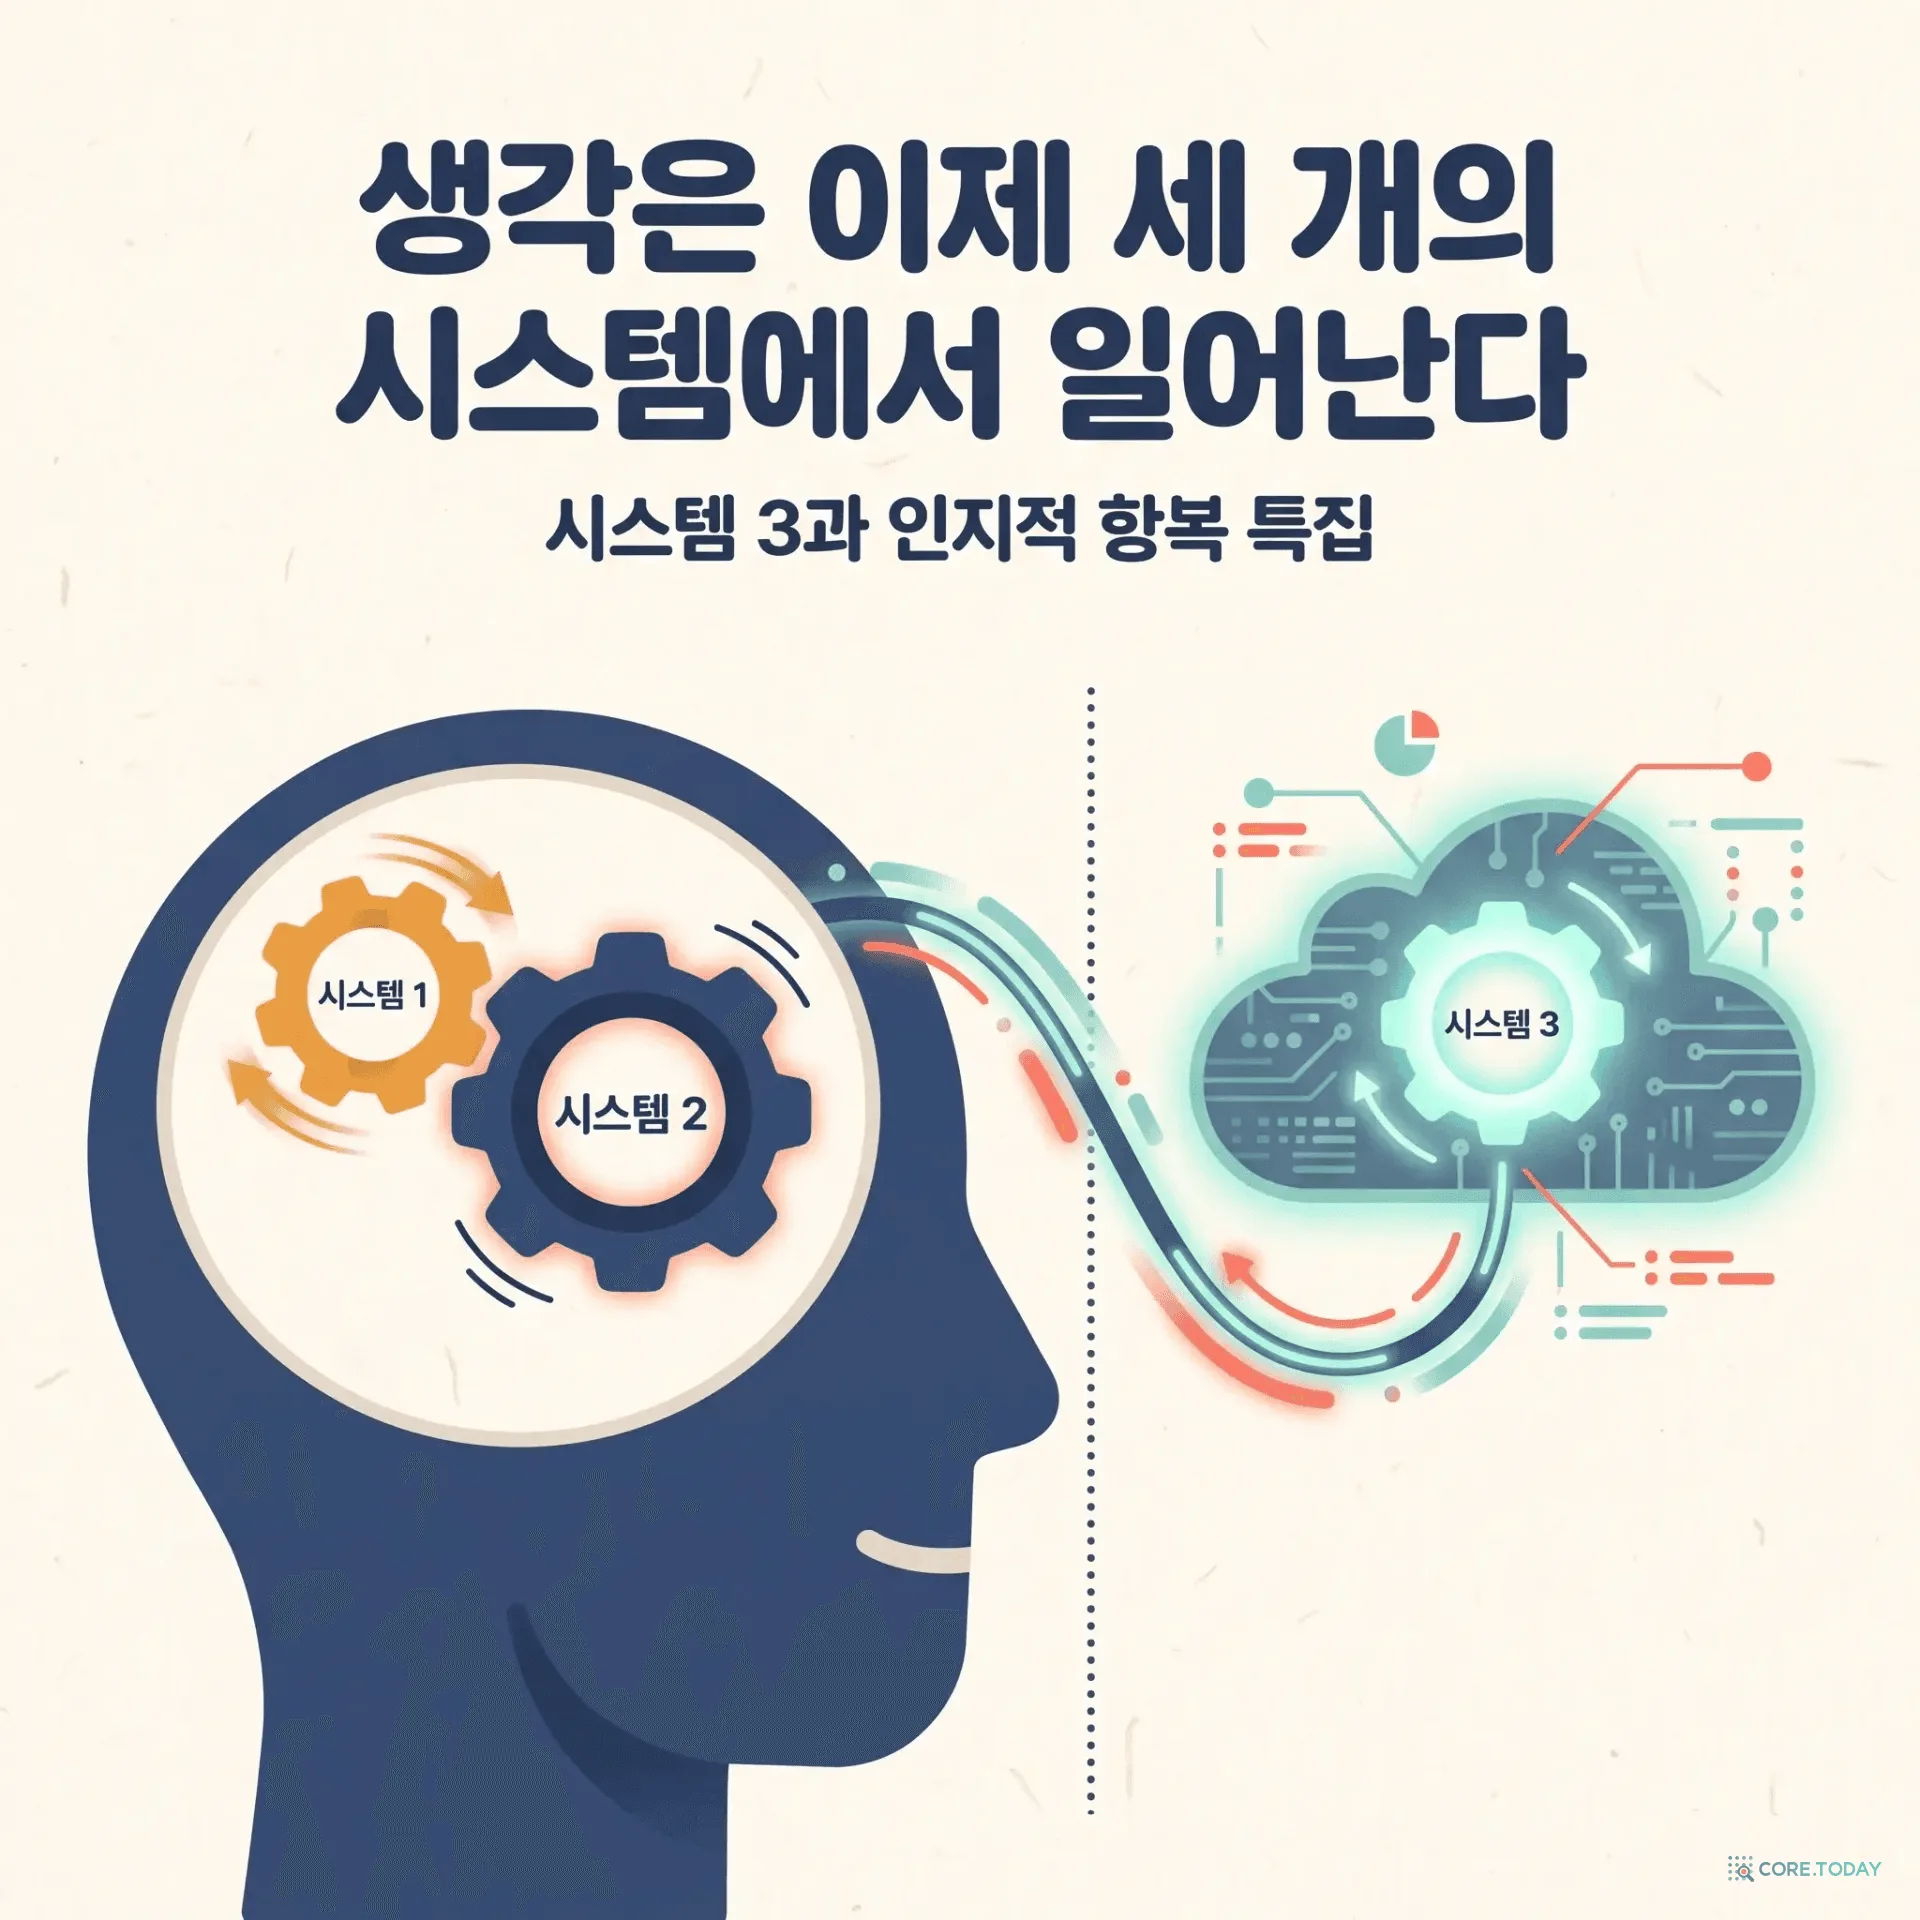
[특집] 생각은 이제 세 개의 시스템에서 일어난다 — 시스템 3과 '인지적 항복'의 역사, 사례, 그리고 2026년
카너먼의 '빠른 생각·느린 생각'에 와튼스쿨 연구팀이 세 번째 단어를 붙였습니다 — Artificial. 1974년 휴리스틱 연구에서 2012년 바다로 들어간 렌터카, 2023년 가짜 판례를 낸 변호사, 2025년 AI를 끄자 실력이 떨어진 내시경 의사까지, '생각을 기계에 넘기는 순간' 무슨 일이 벌어지는지를 역사와 사례로 풀고, 논문의 설계도와 데이터를 그대로 가져와 2026년의 우리에게 무엇을 뜻하는지 따져봅니다.
AI가 빨라졌다는 착각을 어떻게 재나 — 89%가 '빨라졌다'는데 6%만 증명하는 생산성의 역설, 그리고 DX Core 4
경영진의 89%가 'AI 덕분에 일이 빨라졌다'고 말한다. 그런데 그 성과를 조직 차원에서 실제로 짚어낼 수 있다고 답한 사람은 단 6%였다. AI는 분명 무언가를 빠르게 만들었는데, 그 무언가가 '가치'인지 '착각'인지 아무도 확신하지 못한다. 이 글은 앞선 n00b 편에서 흘깃 본 SPACE 프레임워크를 정면으로 끌어와, METR의 39%p 인식격차, GitClear가 잰 코드 품질의 숨은 청구서(리뷰 대기 4.6배·재작업 급증·보안 취약점 2.74배), DORA 2025의 'AI는 증폭기'라는 거울 효과, 그리고 이 혼란을 정리하려 나온 DX Core 4(속도·효과·품질·임팩트)까지 — '측정할 수 없으면 관리할 수 없다'는 오래된 진실을 AI 시대의 데이터로 다시 증명한다.
부러진 사다리 — 오늘 주니어를 안 뽑으면, 2031년엔 시니어가 없다: AI가 끊어버린 견습의 고리
지난 글에서 우리는 주니어에게 '태스크를 끝내는 사람 말고, 판단하는 사람이 되라'고 했다. 그런데 정작 회사들은 그 주니어를 아예 뽑지 않기 시작했다. LeadDev 조사에서 엔지니어링 리더의 54%가 2026년 주니어 채용을 줄이겠다고 답했다. AI 코파일럿이 시니어의 손을 늘려주니, 굳이 신입을 데려와 가르칠 이유가 없다는 것이다. 문제는 시니어가 하늘에서 떨어지지 않는다는 것 — 견습 지연은 5~7년이고, 2024~26년에 주니어를 안 뽑으면 2031년엔 시니어가 없다. 이 글은 '부러진 사다리(broken ladder)' 논쟁을 중세 길드 도제부터 페어 프로그래밍까지의 견습의 역사, 하버드의 내부노동시장 논문, 그리고 '견습 미화론'·'역방향 멘토링' 같은 정직한 반론까지 짚으며, AI가 끊어버린 세대 전수의 고리를 어떻게 다시 이을지 끝까지 쉽게 풀어낸다.
토큰값이 67% 떨어졌는데, 왜 AI 청구서는 3배가 됐나 — 제번스의 역설과 추론 경제학
2026년, AI 모델의 토큰 단가는 1년 만에 67% 떨어졌다. GPT-4 기준으로는 3년간 99.7%가 빠졌다. 그런데 기업의 73%가 'AI 지출이 예상을 초과했다'고 답했고, 우버는 2026년 AI 예산을 4월에 다 태웠다. 값은 폭락하는데 청구서는 폭발하는 이 역설의 이름은 1865년 경제학자 윌리엄 스탠리 제번스가 석탄에서 발견한 '제번스의 역설'이다. 이 글은 왜 추론이 싸질수록 총지출이 늘어나는지 — 에이전트 한 작업이 챗의 1,000배 토큰을 먹는 배수의 폭발, 효율이 하드웨어 부족을 부르는 악순환의 고리 — 를 데이터로 해부하고, 'best model wins'가 'best fit wins'로 바뀐 시대의 생존 무기인 모델 라우팅과 비용 통제 플레이북까지 실무적으로 정리한다.
우리는 네가 '태스크를 끝내라고' 뽑은 게 아니야 — AI가 태스크를 삼킨 시대, 주니어 엔지니어의 진짜 값어치
2026년 5월, 켄트 벡이 신입 개발자들에게 던진 한 문장이 개발자 커뮤니티를 뒤흔들었다 — '아무도 네가 태스크를 몇 개 끝냈는지 신경 쓰지 않는다.' 왜 하필 지금 이 말이 폭발했을까? AI 에이전트가 '태스크 완료'를 공짜로 만들어버린 시대이기 때문이다. 이 글은 벡의 화제작을 처음부터 끝까지 정독하며, 주니어를 '네가 앞으로 될 엔지니어에 대한 옵션 프리미엄'으로 보는 그의 논리를 실물옵션 이론·SPACE 프레임워크로 풀고, 주니어 채용 -60%·스탠퍼드 카나리아·하버드 6,200만 명 연구 같은 2026년 데이터로 붕괴의 현장을 짚는다. 그리고 METR의 '19% 더 느렸다'는 충격 실험과 오스마니의 '70%의 벽'을 통해, 왜 AI 시대에 남는 값어치가 '태스크 완료'가 아니라 '판단·취향·옵션'인지 끝까지 쉽게 설명한다.