
#특집
58개의 포스트
[특집] 카파시의 「수업을 잘 듣는 법」 — 15년 된 시험 공부 경험칙 23개를 100년 학습 과학으로 채점하고, AI 시대에 다시 읽다
2026년 10월 12일, 한 트윗이 오래된 웹페이지 하나를 다시 끌어올렸다. 안드레이 카파시가 대학원생 시절 써 둔 「수업을 잘 듣는 법(Doing well in your courses)」이다. 밤샘은 하지 마라, 읽고 이해한 것과 덮고 다시 쓸 수 있는 것은 다르다, 시험장에서 절대 일찍 나가지 마라, 그리고 가장 똑똑한 학생은 모든 과목에서 85%를 받는다. 이 글은 그 23개의 경험칙을 하나씩 꺼내 에빙하우스(1885)부터 로디거·카피키(2006), MIT 핏빗 수면 연구, 7천만 건의 채점 기록까지 지난 100년의 학습 과학과 맞대어 채점한다. 대부분은 놀랍게 맞았고, 두 개는 틀렸다. 페이지가 실제로 쓰인 시기(2009~2011)와 사람들이 지금 읽는 2016년 개정판의 차이, 토론토 대학의 '85점 = A = 4.0' 환산표, 그리고 AI가 숙제를 대신 풀어 주는 2026년에 이 조언이 왜 오히려 더 중요해졌는지 — 튀르키예 고등학생 1천 명 실험의 '연습 +48%, 시험 −17%', 연세대 집단 부정행위, 하버드의 A학점 상한 표결, 한국 고교생 주중 수면 5.6시간까지 — 여섯 개의 인터랙티브 도구와 함께 풀었다.
[특집] 직원은 왜 AI 앞에서 멈칫하는가 — 정체성·감시·불확실성·변화 속도, 네 가지 위협으로 읽는 2026년 AI 도입의 심리학
2026년 10월 가트너는 AI 사용을 기대받는 직원의 47%가 도입에 저항한다고 밝혔습니다. 그런데 같은 해 일선 직원의 AI 정기 사용률은 74%까지 올랐습니다. 저항과 사용은 반대말이 아니라 한 사람 안에 함께 있습니다. 이 글은 직원이 AI 앞에서 멈칫하는 이유를 정체성·감시·불확실성·변화 속도라는 네 가지 위협으로 나눠 읽습니다. 1811년 러다이트와 1948년 하우드 공장 실험에서 '저항'이라는 말의 기원을 짚고, 국내 IT 기업 직원 397명이 AI 도입을 정체성 위협으로 느낄수록 노하우를 숨겼다는 2026년 연구, 메타·아마존의 토큰 순위표가 '쓰는 척'만 낳고 닫힌 사건, 사용 의무화를 1년 만에 되돌린 듀오링고, 감시가 성과를 올리지 못한다는 메타분석을 차례로 봅니다. 그리고 저항이 언제 정당한 신호인지, 회사가 4주 동안 무엇을 해 볼 수 있는지 위젯 여섯 개와 함께 정리합니다.
[특집] Gemini 4 Argon 모델 카드 정독 — 19개 시험의 속사정과 구글이 '배제할 수 없다'고 적은 세 줄
구글이 9월 30일 '신뢰할 수 있는 사이버 방어자'에게만 먼저 풀었던 Gemini 4 Argon이 10월 13일 전 세계에 공개됐습니다. 모델 카드, 5쪽짜리 평가 방법 문서, 217쪽짜리 안전·보안 보고서가 함께 나왔습니다. 이 글은 셋을 처음부터 끝까지 읽고 정리한 특집입니다. 카드가 한 줄로 넘긴 '대규모 희소 Mixture-of-Experts'를 1991년 논문부터 거슬러 올라가 풀고, 입출력 합계 100만 토큰과 GraphWalks 시험이 무엇을 재는지 직접 풀어 보게 했습니다. 19줄 성적표는 줄마다 공개 리더보드와 맞춰 봤습니다. 하비 법률 시험 19.6%는 경쟁 세 모델보다 세 배 높지만 전체 79개 모델 중에서는 6위입니다. 과학 터미널 시험의 57.6%는 독립 측정에서 44.3%로 나왔습니다. 그리고 구글이 스스로 '배제할 수 없다'고 적은 세 가지(생물 무기 CCL, 사이버 CCL, 은밀성·상황 인식 TCL)를 프런티어 안전 프레임워크의 언어로 풀었습니다. 15개 과제 중 14개 통과, 평가를 알아챈 비율 0%→37.8%, 생각 없이 차 끓이는 이야기만 적고도 정답을 맞힌 장면까지 담았습니다. 인터랙티브 6개, 일러스트 10장, 논문·보고서 그림 10장.
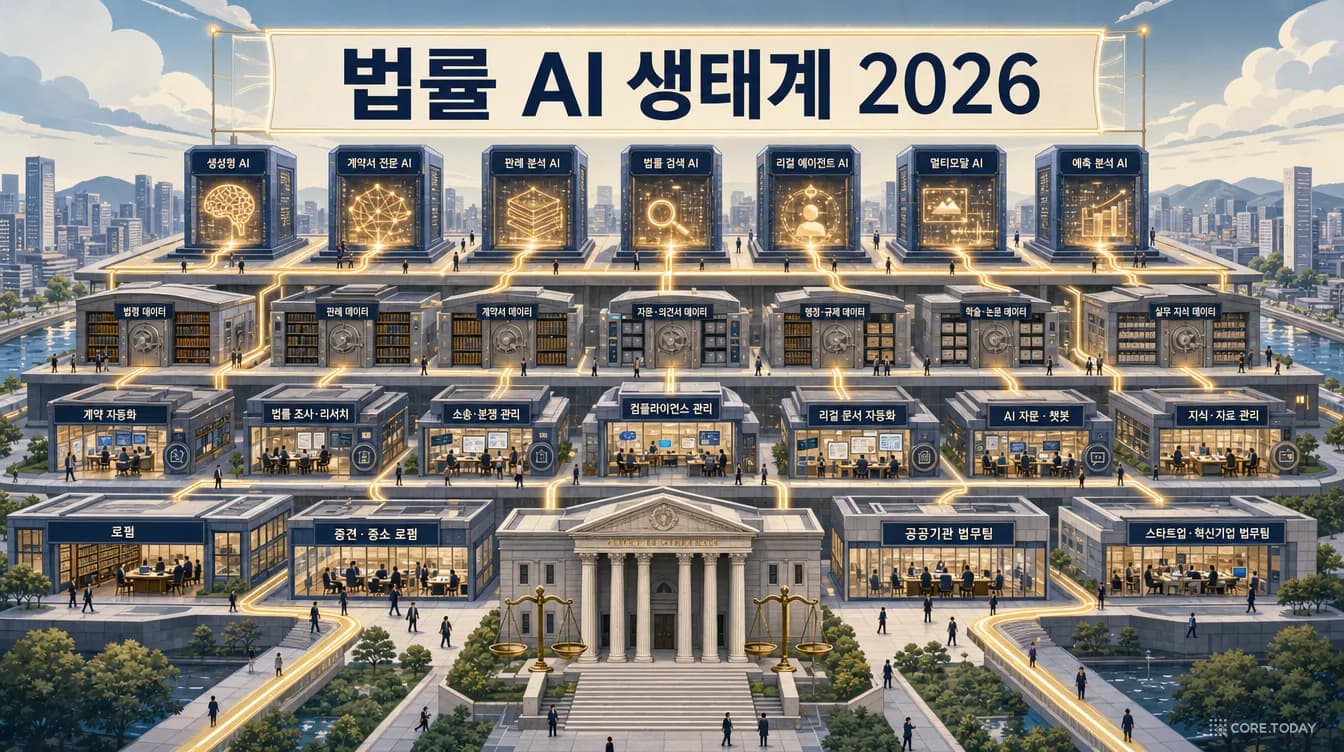
법률 AI 생태계 지도 2026 — 모델 회사는 법률로 내려오고, 법원은 검증을 요구하고, 돈은 '책임질 수 있는 결과물'로 모인다
2026년 2월 3일, Anthropic이 법률 업무 플러그인 하나를 내놓자 Thomson Reuters 주가가 하루에 16% 빠졌습니다. 그런데 반년 뒤 그 회사의 법률 매출은 10% 늘었고, 같은 해 법률 AI 스타트업 Harvey의 몸값은 80억 달러에서 155억 달러로 뛰었습니다. 한쪽에선 전 세계 법원이 AI가 지어낸 판례를 지적한 결정이 2,184건까지 쌓였고, 한국 법원 판결문에는 'AI Hallucination'이라는 영어가 그대로 적혔습니다. 모순처럼 보이는 이 장면들은 하나의 지도 위에 놓으면 이해됩니다. 모델·데이터·업무 도구·로펌·법원의 다섯 층이 2024년에서 2026년 사이 각각 어떻게 움직였는지, 법률 AI 시험지가 '변호사시험'에서 '실무 과제 전 항목 통과'로 바뀐 이유, 시간당 청구가 흔들리는 경제학, 신입 변호사의 사다리, 나홀로 소송의 역설, 그리고 한국 법원·로펌·리걸테크의 2026년까지. 논문과 판결과 실적 발표를 근거로 일곱 가지 인사이트를 뽑았습니다. 인터랙티브 6개, 논문·보고서 그림 8장, 삽화 9장.
[특집] 월급은 엔진이지 목적지가 아니다 — 해커뉴스를 달군 '커리어로 부를 쌓는 법', 인적 자본을 소유로 바꾸는 70년의 경제학
2026년 10월 11일, 반년 전에 올라온 블로그 글 한 편이 해커뉴스 첫 화면에 올라 이틀 동안 166개의 댓글을 모았다. 나이지리아 급여 핀테크 창업자 아셔 아데니이가 쓴 「커리어로 부를 쌓는 법」 — 부는 창업가만의 몫이 아니며, 좋은 직장은 '엔진'이고 그 출력을 소유로 바꾸는 규율이 부를 만든다는 글이다. '저축하라는 말을 길게 늘였을 뿐'이라는 냉소와 '아이들에게 읽히겠다'는 찬사가 정면으로 부딪쳤다. 이 글은 그 논쟁을 출발점으로, 원문이 기대고 있는 70년 치 경제학을 처음부터 풀어 본다. 슐츠·베커·민서의 인적 자본 이론과 학교 1년의 수익률 9%, 스펜스의 신호 이론, 모딜리아니의 생애주기 가설과 '인적 자본이 금융 자본으로 옮겨 가는 곡선', 베블런에서 킬링스워스·카너먼까지 이어지는 쾌락의 쳇바퀴, 그리고 의지가 아니라 기본값이 저축률을 바꾼다는 매드리언·시어와 탈러·베나치의 실험까지. 2026년 노동소득 분배율이 1947년 이후 최저로 내려가고 AI가 커리어 사다리의 아래 칸을 바꾸는 지금, 한국 직장인이 이 글에서 무엇을 가져가야 하는지 여섯 개의 인터랙티브 도구와 함께 정리했다.
[특집] 「Fable이 내 일자리를 가져갔다」 — AI는 더 잘해서가 아니라 '더 싸서' 사람을 밀어낸다: 마지막 엔지니어의 고백으로 읽는 2026년 AI 감원의 구조
2026년 10월 11일, 보안·암호학 글로 알려진 블로거 Cendyne이 8분짜리 글 「Fable이 내 일자리를 가져갔다(Fable took my jorb)」를 올렸다. 회사의 '마지막 엔지니어'였던 그는 이렇게 쓴다. Fable이 내 일을 더 잘해서가 아니라, 내 연봉보다 쌌다. 그리고 'AI가 내 일을 가져갔다'는 말은 'AI가 내 자리를 없애는 데 한몫했다'보다 말하기 재미있을 뿐이라고. 해커뉴스에서 댓글 355개가 붙은 이 글을, 러다이트와 케인스부터 아제모을루의 '그저 그런 자동화', 브리뇰프슨의 '탄광 속 카나리아' 2026년 갱신판, 챌린저의 AI 감원 통계, 그리고 쇼피파이 Helix와 테오의 ts-rust가 보여 준 '하네스'의 구조, METR의 시간 지평, 'hmm-hmm-hmm' 반복의 정체까지 따라가며 읽는다. 인터랙티브 여섯 개와 함께.
[특집] 생각이 취미가 되는 날 — 스피넬리스의 「생각은 취미가 될 것이다」, 사냥·서예·목공·승마의 길을 생각도 걷게 될까
2026년 10월 8일, 『코드 리딩』의 저자이자 소프트웨어 공학의 대가 디오미디스 스피넬리스가 600단어짜리 블로그 글을 올렸다. 첫 문장은 '내 무덤을 파는 기분'이었고, 결론은 '생각은 취미가 될 것이다'였다. 가축화 뒤의 사냥, 인쇄술 뒤의 서예, 산업화 뒤의 목공, 자동차 뒤의 승마처럼. 해커뉴스에서 421개의 댓글이 달린 이 글을 한 문단씩 읽고, 성능·비용·가용성이라는 세 전제를 OECD 성인역량조사·PISA 2025·OpenAI 수학 원고 722편으로 확인했다. 네 비유의 역사(왕실 사냥림, 필경사 예찬, 윌리엄 모리스, 말 2,520만 마리), AI에 진 뒤 66년 만에 강해진 프로 바둑(580만 수 분석, 신민규 외 PNAS), 1961년 골딩의 「취미로서의 생각」, 아리스토텔레스의 스콜레에서 케인스의 15시간·아렌트의 '노동 없는 노동자 사회'까지의 계보를 따라갔다. 과업 기반 모델로 본 경제학의 설계도, 인지 오프로딩 연구, 스피넬리스 자신의 3~7월 글과의 충돌, 그리고 청년 일자리 28.5만 개가 사라진 한국의 데이터까지 — 여섯 개의 인터랙티브 도구와 함께 정리했다.
[특집] 모든 것의 사이클 — a16z 「State of Markets II」 90장 정독: 빅테크의 현금은 반도체로, GPU는 늙어도 비싸지고, SaaS는 '증명해 봐'를 듣는다
2026년 9월 30일, 실리콘밸리 벤처캐피털 a16z가 90장짜리 차트 묶음 「State of Markets II」를 내놓았다. 핵심 문장은 다섯 개다. 테크는 더 이상 한 업종이 아니라 경기 그 자체인 '모든 것의 사이클'이 됐고, 올해 S&P 500 이익 증가분의 76%를 테크가 만들었다. 빅테크가 데이터센터에 쏟는 7,770억 달러는 그들의 잉여현금흐름을 반도체 회사의 잉여현금흐름으로 바꿔 놓았다. '3년이면 고철'이라던 GPU는 오히려 임대료가 올랐다. 그런데도 AI 도입은 넓지만 얕다 — 기업 열에 일곱이 AI를 쓴다지만 성과를 지표로 추적하는 곳은 2%뿐이다. 그리고 연초의 'SaaS 종말론'은 종말이 아니라 '증명해 봐'였다. 1865년 제번스의 석탄 문제부터 1840년대 철도 광풍과 2000년 광섬유 거품, 카를로타 페레스의 기술 혁명 이론, 회계의 감가상각과 할인현금흐름까지 — 이 보고서를 읽는 데 필요한 개념을 처음부터 풀고, 차트 서른 장을 하나씩 읽으며, 반론과 한국 시장의 시선까지 함께 정리했다. 인터랙티브 여섯 개로 직접 계산해 볼 수 있다.
[특집] 기억의 교통정리 — MemAgent: '만능 메모리는 없다'는 발견과, 13개의 기억 중 하나를 고르는 4B 라우터
에이전트에게 기억을 달아 주는 방법은 이미 수십 가지다. 궤적 요약, 실패에서 뽑은 경고, 변수 자리를 비운 워크플로, 실행 가능한 파이썬 함수, 통찰의 그래프. 각자 자기 시험에서는 1등이라고 보고했다. 칭화대와 텐센트 연구진은 13개 방식을 같은 에이전트에 하나씩 붙여 세 개의 시험을 치르게 했고, 세 시험 모두에서 상위권에 드는 방식은 하나도 없다는 걸 확인했다. 그런데 '문제마다 맞는 기억을 골랐다면'의 점수는 89.6% — 최고의 단일 기억(71.0%)보다 18%p 이상 높았다. 그래서 그들은 더 나은 기억을 만드는 대신 기억을 고르는 4B 모델, MemAgent를 학습시켰다. 시작 전엔 13개 서랍을 살짝 열어 보고, 진행 중엔 메모를 보여 줄지 정하고, 끝나면 어느 서랍에 넣을지 고른다. 인지과학의 다중 기억 체계부터 SAT 솔버 포트폴리오의 '오라클', 2026년 ChatGPT·Claude·Mem0·Letta의 메모리 설계까지, 논문과 코드, 그림과 표를 바탕으로 인터랙티브 일곱 개와 함께 풀어본다.
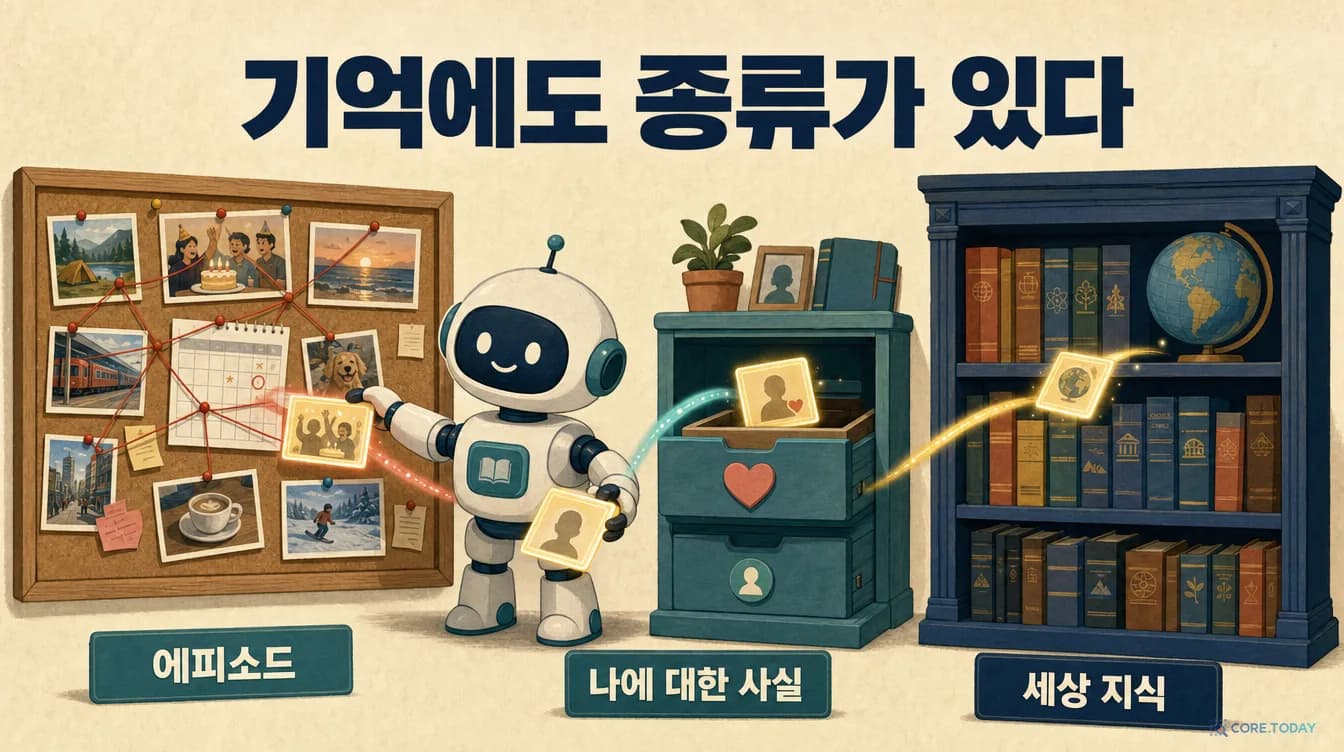
[특집] 기억에도 종류가 있다 — MemoType이 바꾼 질문: 'AI는 무엇을 기억하나'에서 '어떤 기억을, 어떻게 찾나'로
"지난달 조지랑 태산 다녀왔어"라고 말해 둔 AI에게 4주 뒤 "조지는 어디 갔었지?"라고 물으면 왜 엉뚱한 답이 돌아올까. 2026년 10월 8일 arXiv에 올라온 NeurIPS 2026 채택 논문 「Memory Type Varies」는 원인을 '모든 기억을 같은 방식으로 찾기 때문'이라고 진단한다. 1972년 심리학자 엔델 털빙이 나눈 일화 기억과 의미 기억을 대화 AI에 맞게 세 갈래(에피소드·개인 의미·일반 의미)로 다시 나누고, 6,000개 대화에 라벨을 단 TriMEM 데이터셋으로 1.7B 라우터를 학습시켜, 기억의 종류마다 다른 검색법을 쓰는 MemoType을 만들었다. 단일 검색 전략에는 넘을 수 없는 천장이 있다는 정리, 기억 구축 비용을 최대 248분의 1로 줄인 비용표까지 — 논문의 그림과 표를 하나씩 읽고, 털빙에서 ChatGPT·Claude·Gemini의 2026년 메모리까지 이어지는 계보와 함께 인터랙티브 다섯 개로 풀어 본다.
[특집] 프로그래밍은 특별하지 않다 — 글리프의 질문: '예술가들은 AI가 예술에 나쁘다는 걸 안다. 왜 프로그래머는 자신이 예술가라는 걸 모를까?'
2026년 10월 9일, Twisted의 창시자이자 비동기 프로그래밍의 'Deferred'를 만든 글리프 레프코위츠가 짧은 글 하나를 올렸다. 「프로그래밍은 특별하지 않다」. 작가는 파업하고 화가는 서명하고 음악가는 소송하는데, 왜 프로그래머만 싫다면서도 AI를 쓰는가. 그의 답은 이렇다. 프로그래밍도 예술이고, 예술은 평범한 일까지 포함하며, 그 평범한 일이 위대함으로 가는 유일한 연습장이다. 해커뉴스에서 신고로 내려갔다가 운영자가 되살린 이 글을, 존 버저의 '신비화'부터 크누스의 1974년 튜링상 강연, 나우르의 '이론 세우기', Deferred의 내부 구조와 25년의 계보, 비틀스의 함부르크, 자동화의 아이러니, Anthropic의 기술 형성 실험, 한국은행의 청년 고용 보고서까지 따라가며 읽는다. 인터랙티브 일곱 개와 함께.
[특집] 맞는 기억, 틀린 맥락 — AI 에이전트의 장기 기억에 '증거능력'을 묻다: 검색 허용성(Retrieval Admissibility) 완전 해부
AI 에이전트가 기억을 '못 찾는' 문제는 지난 몇 년간 많이 풀렸다. 2026년의 새 문제는 반대편에 있다. 너무 잘 찾는다. 질문과 딱 맞는 기억을 꺼냈는데 그게 다른 사람의 기억이거나, 이미 바뀐 옛 값이거나, 사용자가 잊어 달라고 한 내용이다. 2026년 10월 5일 아칸소 리틀록 대학 연구진이 arXiv에 올린 「The Right Memory in the Wrong Context」는 이 문제를 '관련성(relevance)'과 '허용성(admissibility)'의 분리로 정식화한다. 법정의 증명력과 증거능력처럼. 기억 한 건마다 범위·정책·수명 주기를 1/0/? 세 값으로 판정하고, 덜 가져와서 안전해 보이는 꼼수를 막기 위해 '같은 재현율'에서 경로를 비교하며, 기억 ID 하나를 저장→검색→노출→발설까지 추적한다. 3,767개 질의에서 네임스페이스를 먼저 걸면 필수 증거 재현율이 0.432에서 0.533으로 오르고 계산은 98.3% 줄었다. 본문만 읽는 LLM 검증기는 위반을 거의 잡지 못한 채 필수 증거를 지웠다. 논문의 그림과 표를 하나씩 풀고, RAG에서 MemGPT·ChatGPT 메모리·2026년 벤치마크까지의 역사, 클레이니 논리·맥락적 무결성·ABAC라는 오래된 뿌리, 벡터 DB의 사전·사후 필터 실무, 한국 개인정보 보호법과 AI 기본법까지 인터랙티브 여섯 개와 함께 읽는다.