
블로그로 돌아가기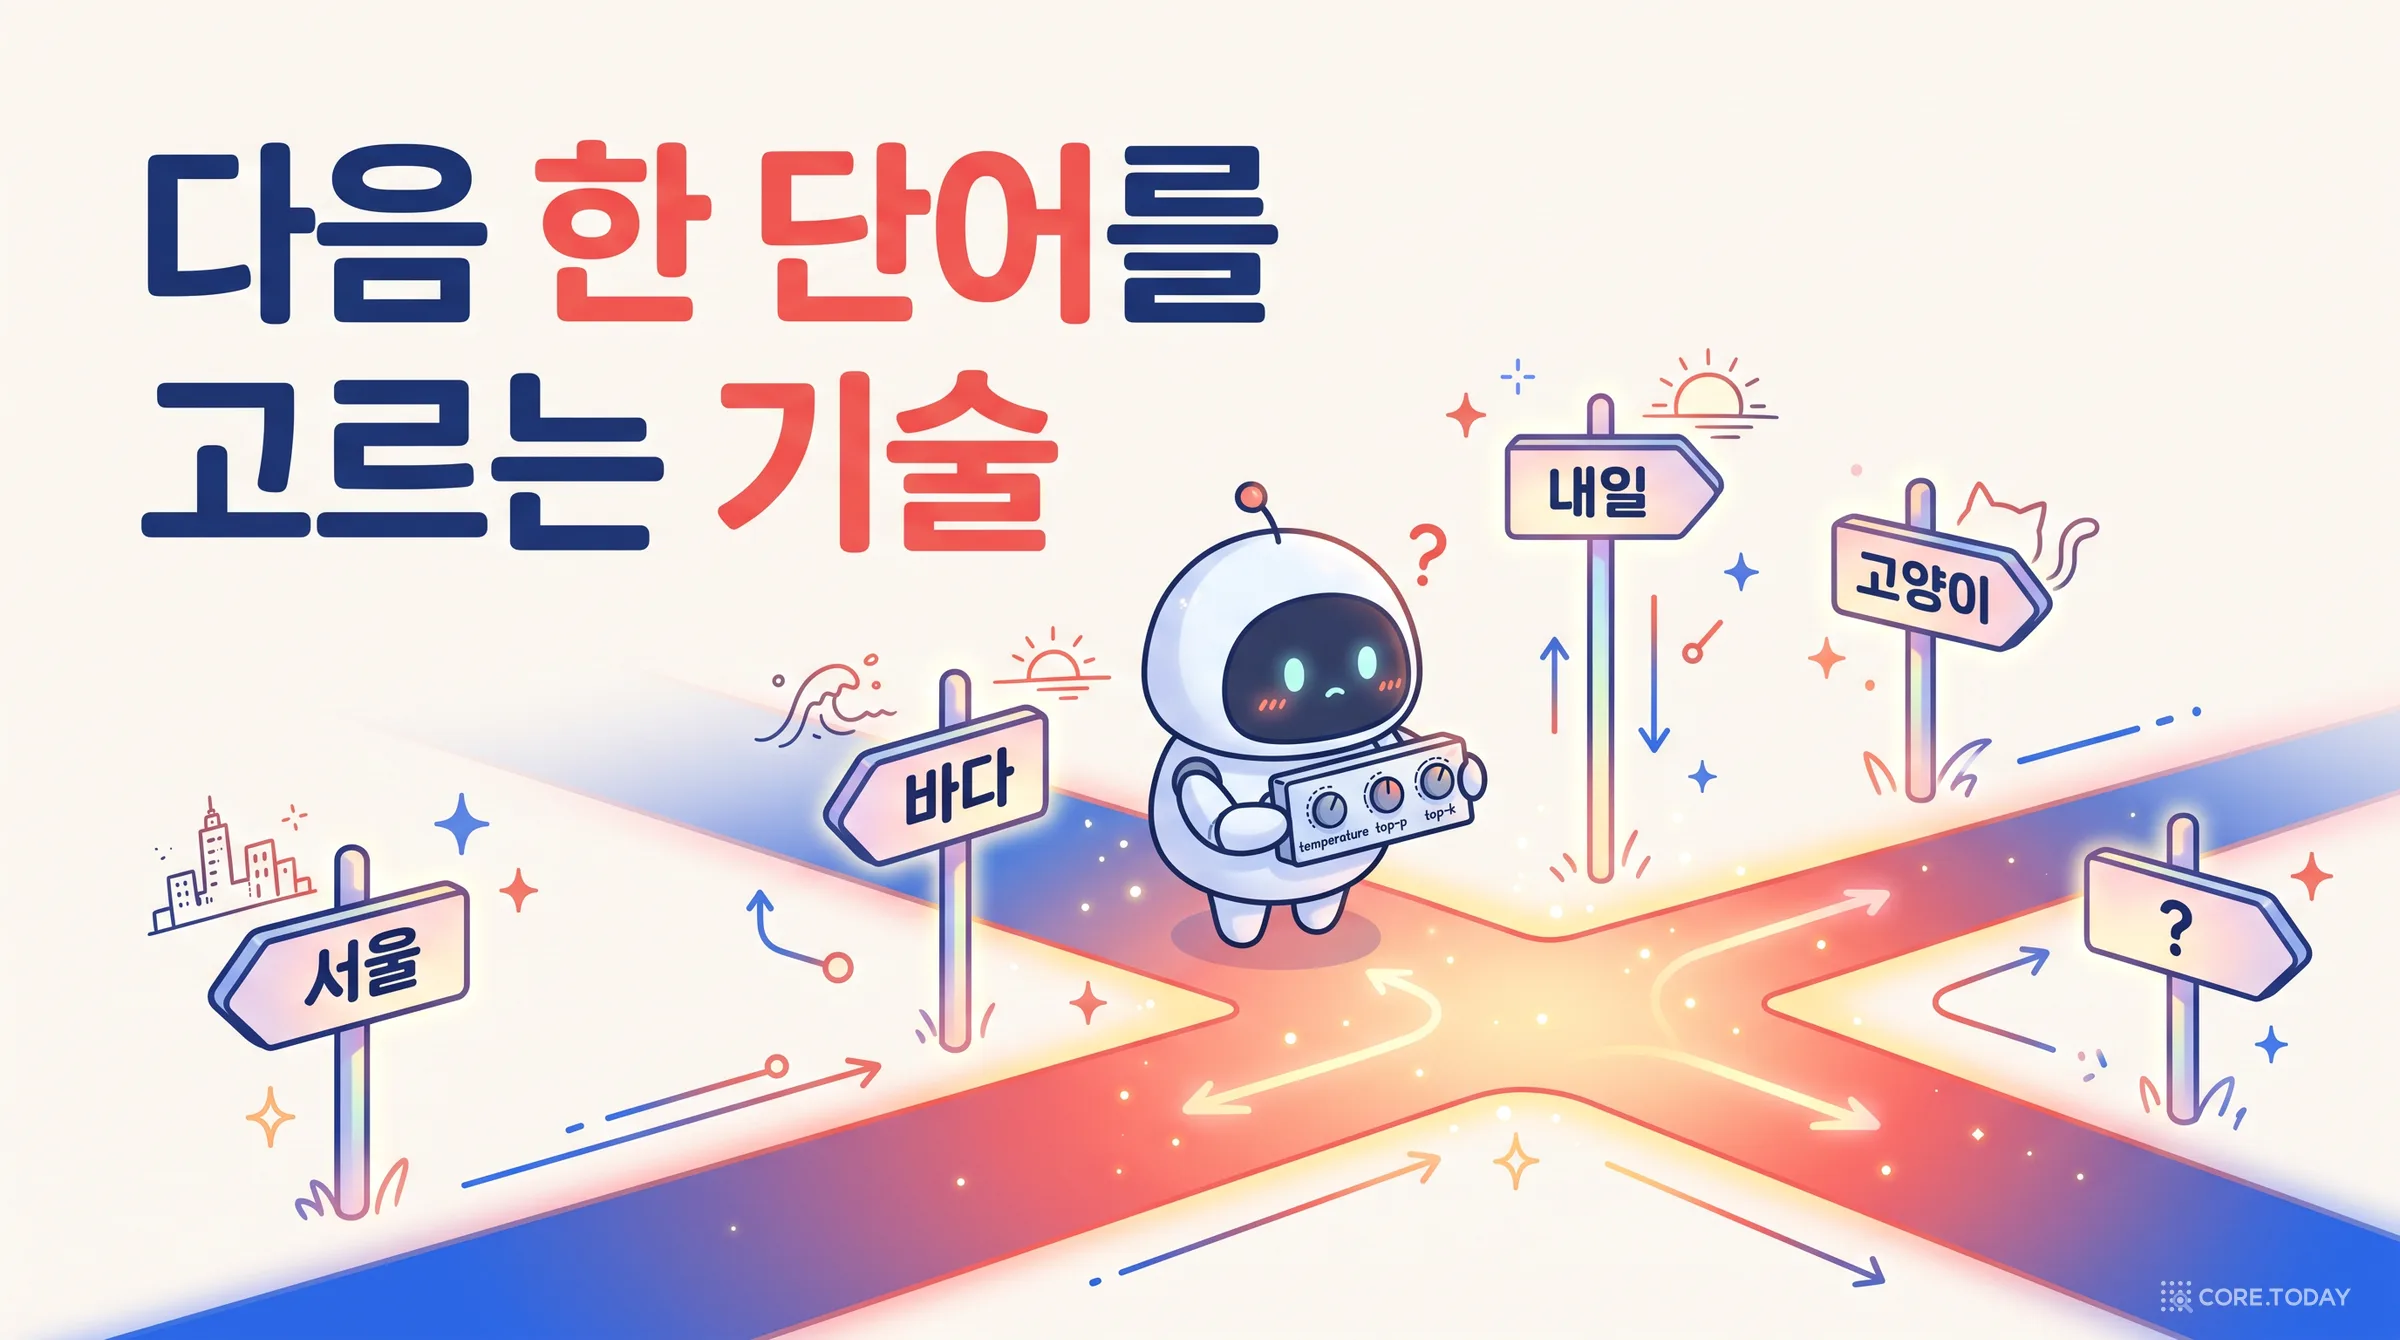
#제약 디코딩
2개의 포스트
특집디코딩그리디 디코딩
2026.11.07가장 그럴듯한 말만 고르면 AI는 같은 말을 되풀이한다 — 그리디부터 min-p까지, 다음 한 단어를 고르는 기술 (특집)
언어 모델은 문장을 쓰지 않는다. 다음에 올 토큰마다 확률표를 내놓을 뿐이다. 그 표에서 실제로 한 토큰을 고르는 규칙이 ‘디코딩’이다. 1948년 섀넌이 책을 아무 데나 펼쳐 다음 단어를 고르던 실험에서 출발해, 매번 1등만 고르는 그리디와 후보 여러 개를 들고 가는 빔 서치가 왜 같은 말을 되풀이하는지, temperature·top-k·top-p·min-p가 각각 무엇을 자르는지 원 논문으로 따라간다. 카카오의 공개 모델로 12가지 전략을 직접 돌려, 그리디가 쓴 글의 45%가 반복 루프로 끝나고 temperature 0에서도 같은 질문에 다른 답이 나오는 것을 확인했다. 마지막으로 2026년 Claude·Gemini·GPT가 샘플링 손잡이를 잠근 이유를 정리한다. 인터랙티브 위젯 6종, 코어닷투데이 실측, 삽화 14장.
코어닷투데이63분
기술제약 디코딩constrained decoding
2026.07.30넷플릭스는 왜 LLM을 직접 서빙하는가 (3부): 제약 디코딩, 규모의 벽을 넘다
이 특집의 클라이맥스. 넷플릭스는 모델이 '아마도 유효한' JSON을 뱉고 나서 검사하는 대신, 애초에 규칙을 어길 수 없도록 생성 과정 자체를 제약한다. 이 제약 디코딩이 왜 필요하고 어떻게 작동하는지, 그리고 그것을 '규모'에서 돌리려다 vLLM V0의 GIL 벽에 부딪혀 V1으로 넘어간 넷플릭스의 실전 분투기를 따라간다. 직접 서빙해야만 가능한, 커스터마이징의 끝판왕.
코어닷투데이28분