
#정밀도
2개의 포스트
“연기되지 않았다”는 32점, “미뤄졌어요”는 0점 — 기계의 글을 채점해 온 대역 배우, BLEU와 ROUGE (특집)
2002년 IBM 연구진은 사람 평가자를 대신 무대에 세울 ‘대역 배우(understudy)’를 만들었다. 이름은 BLEU. 2년 뒤 요약을 위해 이를 뒤집은 ROUGE가 나왔다. 두 숫자는 20년 동안 번역과 요약 연구의 순위표를 지배했고, 같은 기간 내내 비판을 받았다. 이 글은 1966년 ALPAC 보고서에서 출발해 n-gram·클리핑·짧은 답 벌점·LCS를 하나씩 손으로 계산해 보고, 사람 평가 1위가 BLEU 6위였던 사건, ROUGE 논문 2,834편 중 재현 가능한 것이 20%뿐이었다는 조사, 한국어를 넣으면 0점이 나오는 라이브러리 기본값까지 사례로 따라간다. 마지막으로 LLM 심판의 시대인 2026년에 이 오래된 숫자가 맡은 역할을 정리한다. 인터랙티브 위젯 6종, 코어닷투데이 실측, 삽화 14장.
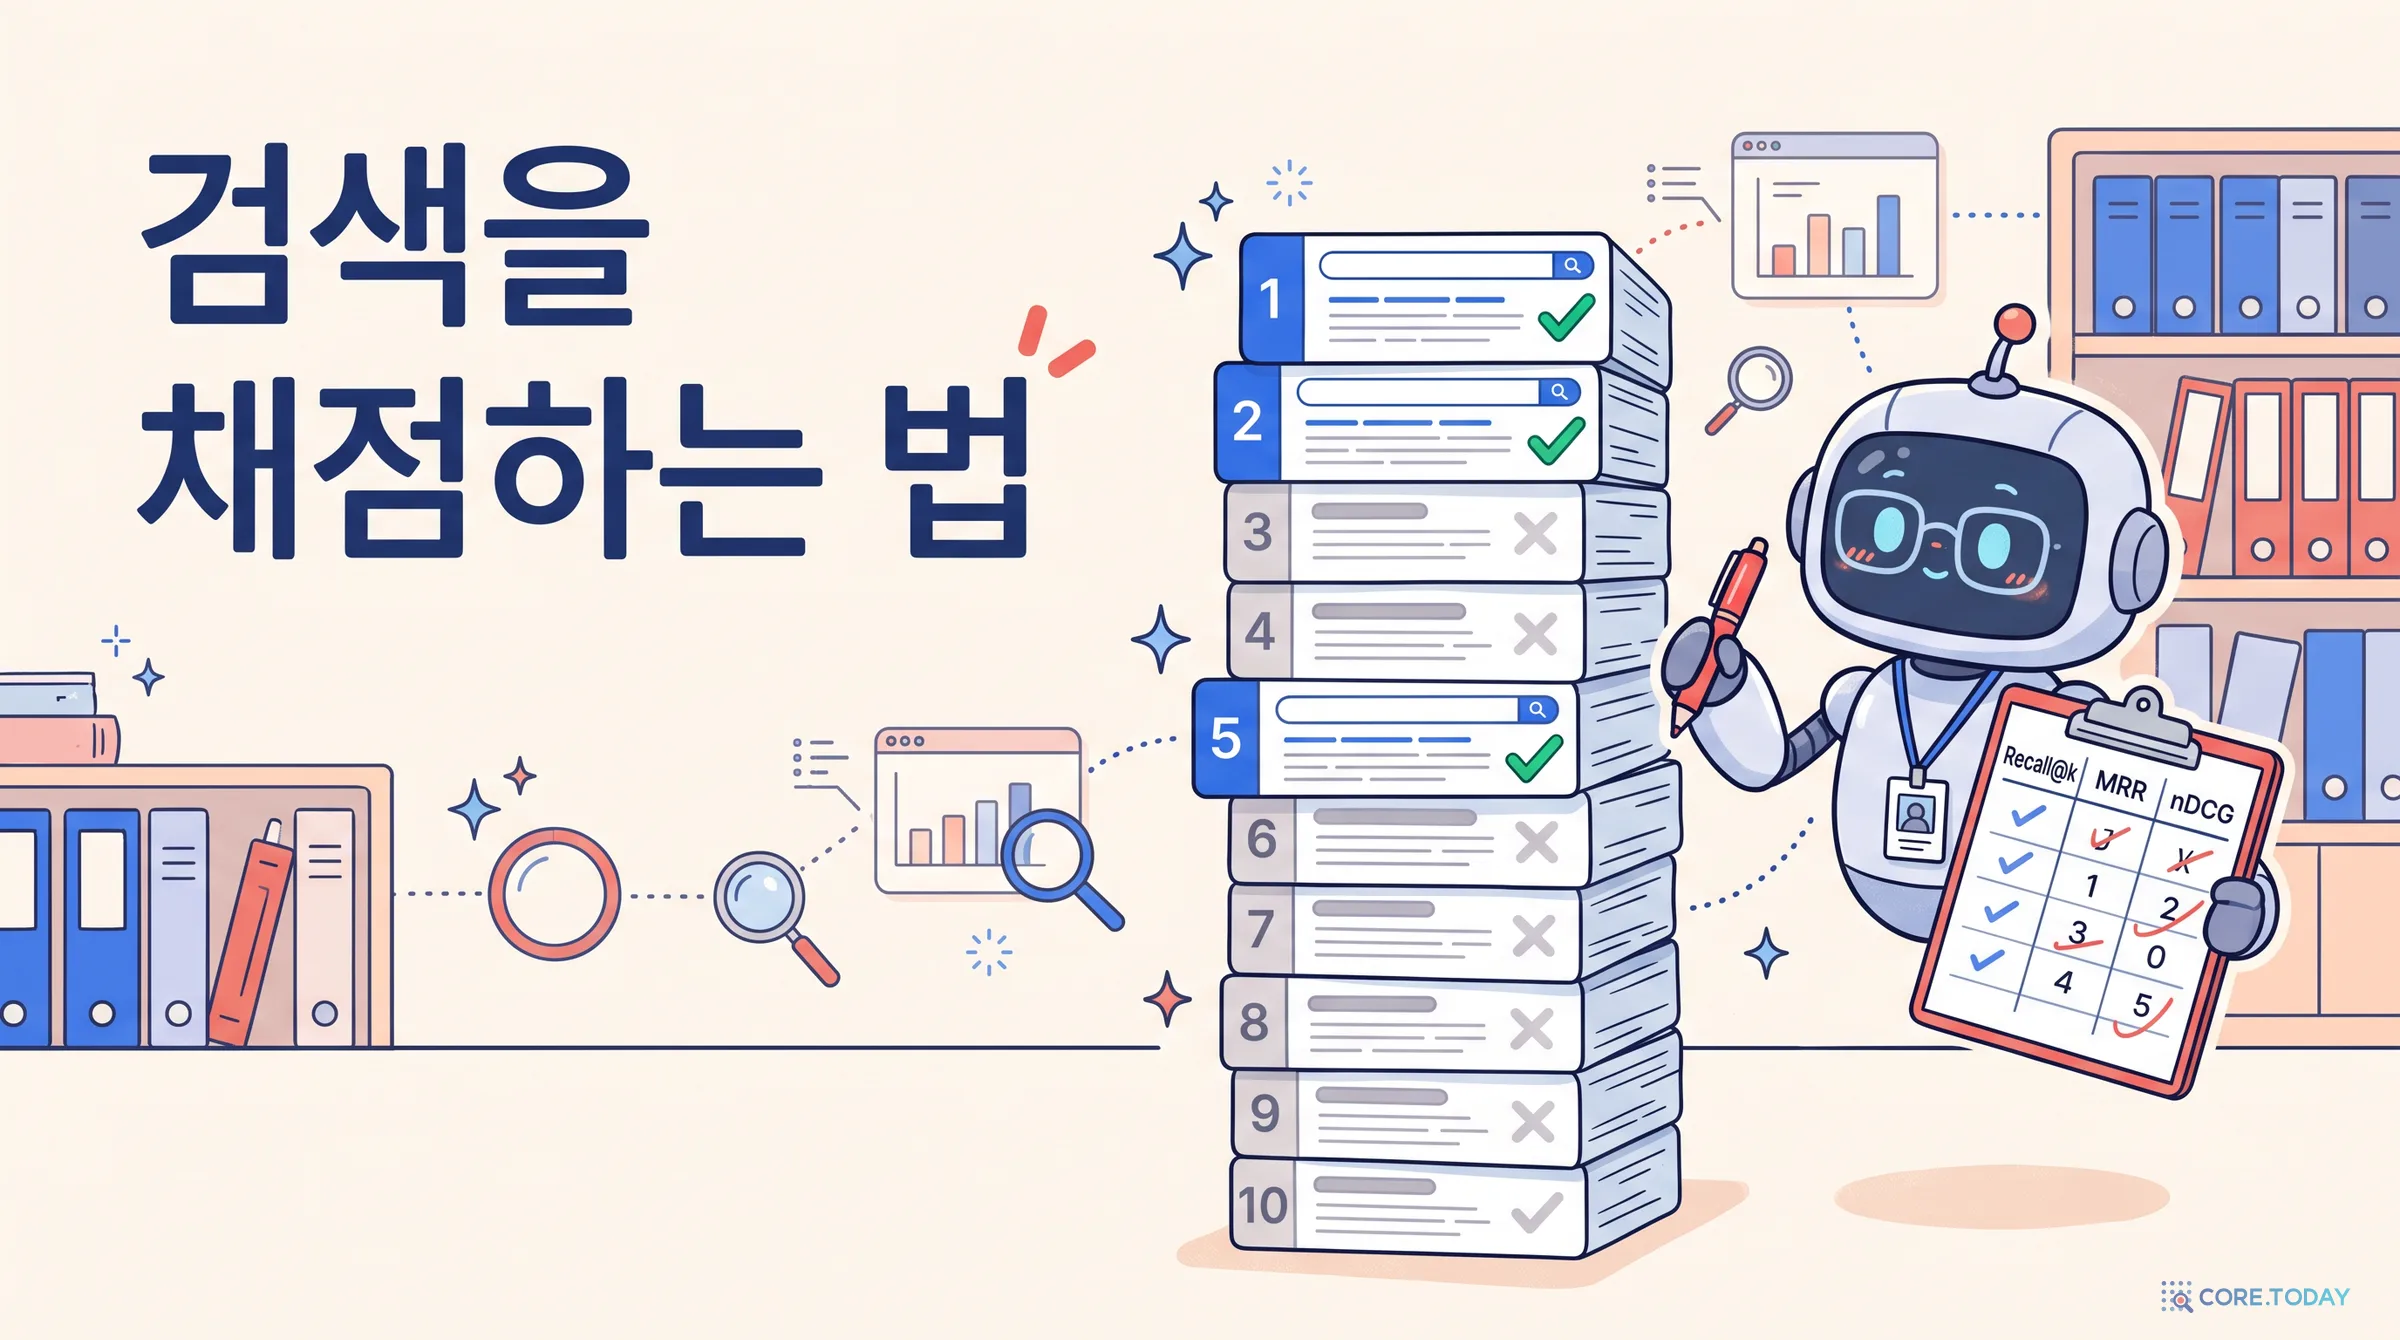
정답이 3위에 있으면 몇 점일까 — 1955년 도서관에서 2026년 RAG까지, 검색을 채점하는 법 Recall@k·MRR·nDCG (특집)
검색 결과 10개 중 정답이 3위에 하나 있다. Recall@10은 1.0, MRR은 0.33, nDCG@10은 0.5다. 같은 결과인데 점수가 셋이다. 지표마다 ‘사용자가 결과를 어떻게 보는가’에 대한 가정이 다르기 때문이다. 이 글은 1955년 재현율의 등장과 1960년대 크랜필드 실험에서 시작해, TREC의 풀링, 질의응답의 MRR, 등급과 할인의 nDCG, MS MARCO와 BEIR를 거쳐 LLM이 정답을 판정하는 2026년까지 검색 평가의 역사를 따라간다. 그리고 한국어 검색기 10개를 Ko-StrategyQA 질문 592개로 직접 재서 보여 준다. 지표를 바꾸면 순위가 바뀌고, 재정렬기는 MRR을 올리지만 Recall@30은 한 치도 못 올리며, 질문 50개로 비교하면 결론이 뒤집힐 확률이 15%다. 정답표의 구멍을 LLM 판정자로 메워 보려 했더니, 판정자는 쉬운 검증은 통과했지만 정작 헷갈리는 문서에서는 후했다. 인터랙티브 위젯 7종, 코어닷투데이 실측, 삽화 13장.