RAFT상태 기반 검색RAGGraphRAG트러블슈팅 에이전트고객지원 AIMCP에이전트 메모리EMNLP 2026Microsoft
사건은 문서가 아니라 궤적이다 — Microsoft RAFT와 '어느 단계에 와 있는가'로 검색하기
Apache Jira에서 사람이 직접 '이건 저것의 중복'이라고 링크한 30쌍을 펼쳐 보면, 그중 14쌍은 제목에 공통 단어가 하나도 없다. 「NPE가 납니다」와 「2.2와 3.0의 페이징 상태가 프로토콜 v4에서 호환되지 않는다」가 같은 문제다. 사건의 유사성은 첫 화면이 아니라 조사가 도달한 지점에 담긴다. EMNLP 2026 Industry Track에 채택된 Microsoft의 RAFT는 종결된 사례를 문서 한 장이 아니라 상태의 사슬로 색인하고, 그 사슬의 중간 지점을 검색 대상으로 삼는다. 이 특집은 실제 Jira 티켓 한 건을 상태로 쪼개 보고, 여섯 단계 파이프라인과 Algorithm 1을 직접 돌려 보고, 무관한 대화 한 턴이 기존 RAG를 49%p 무너뜨리는 실험을 따라가고, 이 발상을 장애 대응·영업·법무·에이전트 메모리로 옮기는 법까지 간다. 인터랙티브 위젯 6종과 공개 데이터 분석을 함께 싣는다.
“Paging state between 2.2 and 3.0 are incompatible on protocol v4”
2.2와 3.0의 페이징 상태가 프로토콜 v4에서 호환되지 않습니다
2015년 12월 접수 · 2016년 1월 Fixed로 종결
카산드라 커밋터는 앞의 티켓을 뒤의 티켓의 중복(duplicate) 으로 링크했다. 같은 문제라는 뜻이다. 그런데 두 제목을 아무리 노려봐도 겹치는 단어가 없다. 불용어를 걸러 내고 내용어만 남기면 교집합이 정확히 0개다.
이런 쌍이 예외가 아니다. Microsoft 연구진이 공개한 평가셋에는 사람이 직접 중복으로 링크한 30쌍이 들어 있는데, 그중 14쌍이 제목에 공통 내용어가 하나도 없다. 나머지도 사정이 크게 낫지 않아서, 겹치는 단어라고 해 봐야 nullpointerexception이나 query처럼 그 코퍼스에서 수백 번 등장하는 말들이다. 제목 유사도의 중앙값은 0.07이었다.
그러면 커밋터들은 무엇을 보고 같은 문제라고 판단했을까. 답은 티켓의 중간에 있다. 누군가 스택 트레이스를 뜯어보고, 버전을 이분 탐색하고, "아 이거 페이징 상태 직렬화 문제네"라고 말한 지점. 사건의 정체가 드러나는 순간은 첫 화면이 아니라 조사가 어느 정도 진행된 다음이다.
2026년 9월 17일 arXiv에 공개되고 EMNLP 2026 Industry Track에 채택된 Microsoft의 논문 「RAFT: 트러블슈팅 에이전트를 위한 상태 기반 검색 증강 프레임워크」는 이 관찰에서 출발한다. 초록의 진단은 한 문장이다.
"기존 검색 증강 생성(RAG) 시스템은 지원 케이스를 정적인 문서로 취급하며, 그것들이 갖는 다단계·상태적 성격을 간과한다."
처방도 한 문장으로 요약된다. 종결된 과거 사례를 시간 순으로 방향지어진 타임라인 엔트리의 사슬로 추상화하고, 케이스가 아니라 엔트리 단위로 검색한다. 그러면 지금 내 사건의 상태와 맞는 과거의 중간 지점이 걸리고, 시스템은 그 지점에 닻을 내린 채 그 케이스의 궤적 전체를 돌려준다.
🧭
이 글의 지도
1장 — 먼저 정리: 이름이 같은 다른 논문이 있다 (RAFT ≠ RAFT)
2장 — 문제: 티켓은 문서가 아니다 (실제 30쌍 분석 위젯)
3장 — 핵심 발상: 케이스를 상태의 사슬로 (분할 규칙 퀴즈 · 실제 티켓 해부 위젯)
4장 — 오프라인: 사건을 증류하는 공정
5장 — 온라인: 상태로 찾고 궤적으로 답한다 (Algorithm 1 시뮬레이터)
6장 — 선택적 케이스 그래프, 그리고 저자들의 정직한 자기 평가
7장 — 평가 설계: 왜 검색층만 쟀나, '진행도'라는 눈금
8장 — 결과: 매치 지점이 9.1%에서 54.0%로 이동한다 (결과 위젯)
9장 — 이 발상을 내 도메인으로 (도메인 설계 도구 위젯)
10장 — 비용과 운영
11장 — 한계와 반론
12장 — 직접 해보기
본론에 들어가기 전에 반드시 짚어야 할 것이 있다. RAFT라는 이름의 논문이 둘이다. 그리고 둘 다 RAG와 관련이 있어서 검색하면 뒤섞여 나온다.
구분
RAFT (2024, UC Berkeley)
RAFT (2026, Microsoft) — 이 글
풀네임
Retrieval Augmented Fine Tuning
Retrieval-Augmented Framework for Troubleshooting agents
한 줄 요약
모델을 훈련시키는 방법 — 방해 문서를 섞어 학습시켜 “오픈북 시험을 준비시킨다”
사례를 색인·검색하는 구조 — 사건을 상태의 사슬로 바꿔 중간 지점을 찾는다
건드리는 것
모델 가중치 (파인튜닝)
지식베이스의 표현 방식 (가중치는 그대로)
핵심 장치
방해 문서(distractor) 훈련, 인용 기반 추론(CoT)
타임라인 엔트리, 엔트리 단위 임베딩, 부모 케이스 승격
대상 데이터
도메인 문서 (정적)
종결된 사례 이력 (다단계·시간 순)
발표
2024년, UC Berkeley
2026년, Microsoft · EMNLP 2026 Industry Track
두 논문은 경쟁 관계가 아니다. 층이 다르다. 버클리 RAFT는 "모델이 검색 결과를 잘 쓰게 만드는 법"이고, Microsoft RAFT는 "검색 결과가 애초에 쓸 만하게 만드는 법"이다. 실제로 이 논문은 파인튜닝을 대안으로 검토했다가 접는다 — 계산 비용이 크고, 오픈 웨이트 모델에만 쓸 수 있고, 파국적 망각에 취약하며, 새 사례가 쌓일 때마다 재학습해야 한다는 이유로.
🔗
버클리 RAFT(파인튜닝 쪽)는 이 블로그에 이미 특집이 있다 — 「RAFT 특집: 시험 공부하듯 AI를 훈련시키는 법」. 이 글과는 다른 논문이니 함께 읽으면 층위가 잘 잡힌다. 아래부터 “RAFT”라고 쓰면 전부 2026년 Microsoft 논문을 가리킨다.
2. 문제 — 티켓은 문서가 아니다
2.1 먼저 데이터를 보자
논문이 공개한 Apache Jira 평가셋을 직접 내려받아 30쌍의 제목을 전부 비교해 봤다. 불용어와 3자 미만 토큰을 빼고 자카드 유사도를 계산한 결과다.
14 / 30
제목에 공통 내용어가 하나도 없는 중복 쌍
0.07
제목 자카드 유사도의 중앙값
1쌍
유사도가 0.2를 넘는 쌍 (30쌍 중)
15.6턴
코퍼스 케이스 하나의 평균 대화 턴 수 (최대 115턴)
직접 넘겨 보면 감이 온다. 전부 사람이 "이건 저것의 중복"이라고 링크한 쌍이므로 정답은 항상 "같은 문제"다.
몇 개만 옮겨 적어도 상황이 분명하다.
새로 올라온 이슈
사람이 지목한 과거 이슈
겹치는 단어
java.lang.AssertionError when running select queries
Regression in ORDER BY
없음
Compaction Assert: Incorrect Row Data Size
Single-pass compaction for LCR
compaction 하나
Not filtering Data completely when where clause is applied to clustering column
Result set is not unique on primary key (cql)
없음
unionAll raises “Task not serializable”
Can't join describe() of DataFrame in Scala 2.10
없음
Looking to build Hadoop but start-build-env.sh errors
Fix failure of docker image creation due to pip2 install error
없음
이 표가 이 논문 전체의 동기다. 증상은 흔하고 원인은 특수하다. "NPE가 난다", "AssertionError가 난다", "쿼리가 느리다"는 말은 수백 개의 서로 다른 원인에서 똑같이 나온다. 그래서 증상 문장으로만 과거를 뒤지면, 표면이 비슷하지만 원인이 다른 사례가 잔뜩 걸린다.
논문은 3절에서 기존 RAG가 트러블슈팅 이력에서 무너지는 지점을 네 가지로 분해한다. 각각이 뒤에 나올 설계의 이유가 되므로 하나씩 보자.
1️⃣
노이즈가 많고 구조가 없는 원본
원본 케이스에는 진단에 관련된 내용과 그렇지 않은 내용이 뒤엉켜 있고, 신호는 수많은 턴에 흩어져 있다. 기존 RAG 기준선들은 이 원본 위에서 그대로 동작하므로, 애초에 진짜 비슷한 사례를 식별하는 능력부터 노이즈에 깎인다.
2️⃣
조각난 검색 결과는 추론이 안 된다
비슷한 케이스를 찾아냈다 해도, 에이전트는 고립된 청크로는 판단할 수 없다. 이게 정말 비슷한지, 어떻게 해결됐는지를 알려면 케이스를 일관된 하나의 전체로 봐야 한다. 그러려면 검색된 청크를 부모 케이스로 되돌려 재조립해야 하는데, 실제 케이스의 크기와 도구의 출력 토큰 제한을 생각하면 이건 토큰 낭비이자 한 번에 볼 수 있는 사례 수의 상한이 된다.
3️⃣
쓸모없는 종결 케이스
닫힌 티켓이 전부 쓸 만한 진단·처치 증거를 담고 있지는 않다. 고객이 응답을 끊어서, 또는 행정적으로 닫힌 티켓은 의미 있는 조사도 결과도 기록하지 않는다. 검색 시스템은 ‘닫혔다’는 사실 자체를 유용함의 증거로 취급해선 안 된다.
4️⃣
프라이버시
기업 고객 데이터에는 개인식별정보가 섞여 있고, 이것이 검색이나 에이전트에 그대로 노출되어선 안 된다. 색인 전에 추상화하거나 비식별하는 별도의 처리 계층이 필요하다.
두 번째 항목이 실무자에게 가장 아플 것이다. 청크 단위 RAG의 고질병 — 잘 찾긴 했는데 맥락이 없어서 쓸 수가 없다 — 이 트러블슈팅에서는 특히 치명적이다. 과거 사례가 유용한 이유는 "무엇이 원인이었나"와 "그래서 뭘 했나"가 이어져 있기 때문인데, 청크는 정확히 그 연결을 끊는다.
2.3 그럼 GraphRAG는?
지식베이스에 명시적 관계 구조를 씌우자는 것이 GraphRAG 계열의 답이었다. 논문은 이 방향을 검토하고, 트러블슈팅 이력에는 맞지 않는다고 판단한다.
"이 범용 파이프라인들은 트러블슈팅 이력을 위해 설계되지 않았다. 트러블슈팅 이력에서는 조사가 이질적이고 노이즈가 많은 산출물들을 가로지르며 전개되고, 종결된 케이스마다 제공하는 실행 가능한 지침의 양이 다르다."
그리고 구체적인 반대 이유가 붙는다. 엔티티 중심 GraphRAG는 LLM이 추출한 엔티티와 관계의 그래프를 오프라인에 만들어 검색을 안내하는데, 개별 조사의 진행 자체를 명시적으로 표현하지 않는다. 그래프 구축 비용이 추가되고, 검색이 엔티티 중심 표현에 묶여서 모델과 에이전트 하네스가 바뀔 때 따라가기 어려워진다.
실험 결과가 이 판단을 뒷받침한다. 두 GraphRAG 기준선(HippoRAG2, Fast-GraphRAG)이 둘 다 평범한 RAG를 넘지 못했다. 특히 Fast-GraphRAG는 모든 진행도에서 큰 폭으로 뒤처졌다. 논문의 해석은 이렇다.
"이는 과제가 계층적 지식 검색이나 문서 간 깊은 맥락 추론을 요구하지 않을 때, 복잡한 엔티티 추출과 그래프 기반 추론이 이득이 거의 없고 오히려 검색을 저하시킬 수 있다는 최근 발견과 일치한다. 우리 설정에서는 비슷한 케이스를 찾아 실행 가능한 통찰을 공급하는 것이 추상적 관계 추론보다 중요하다."
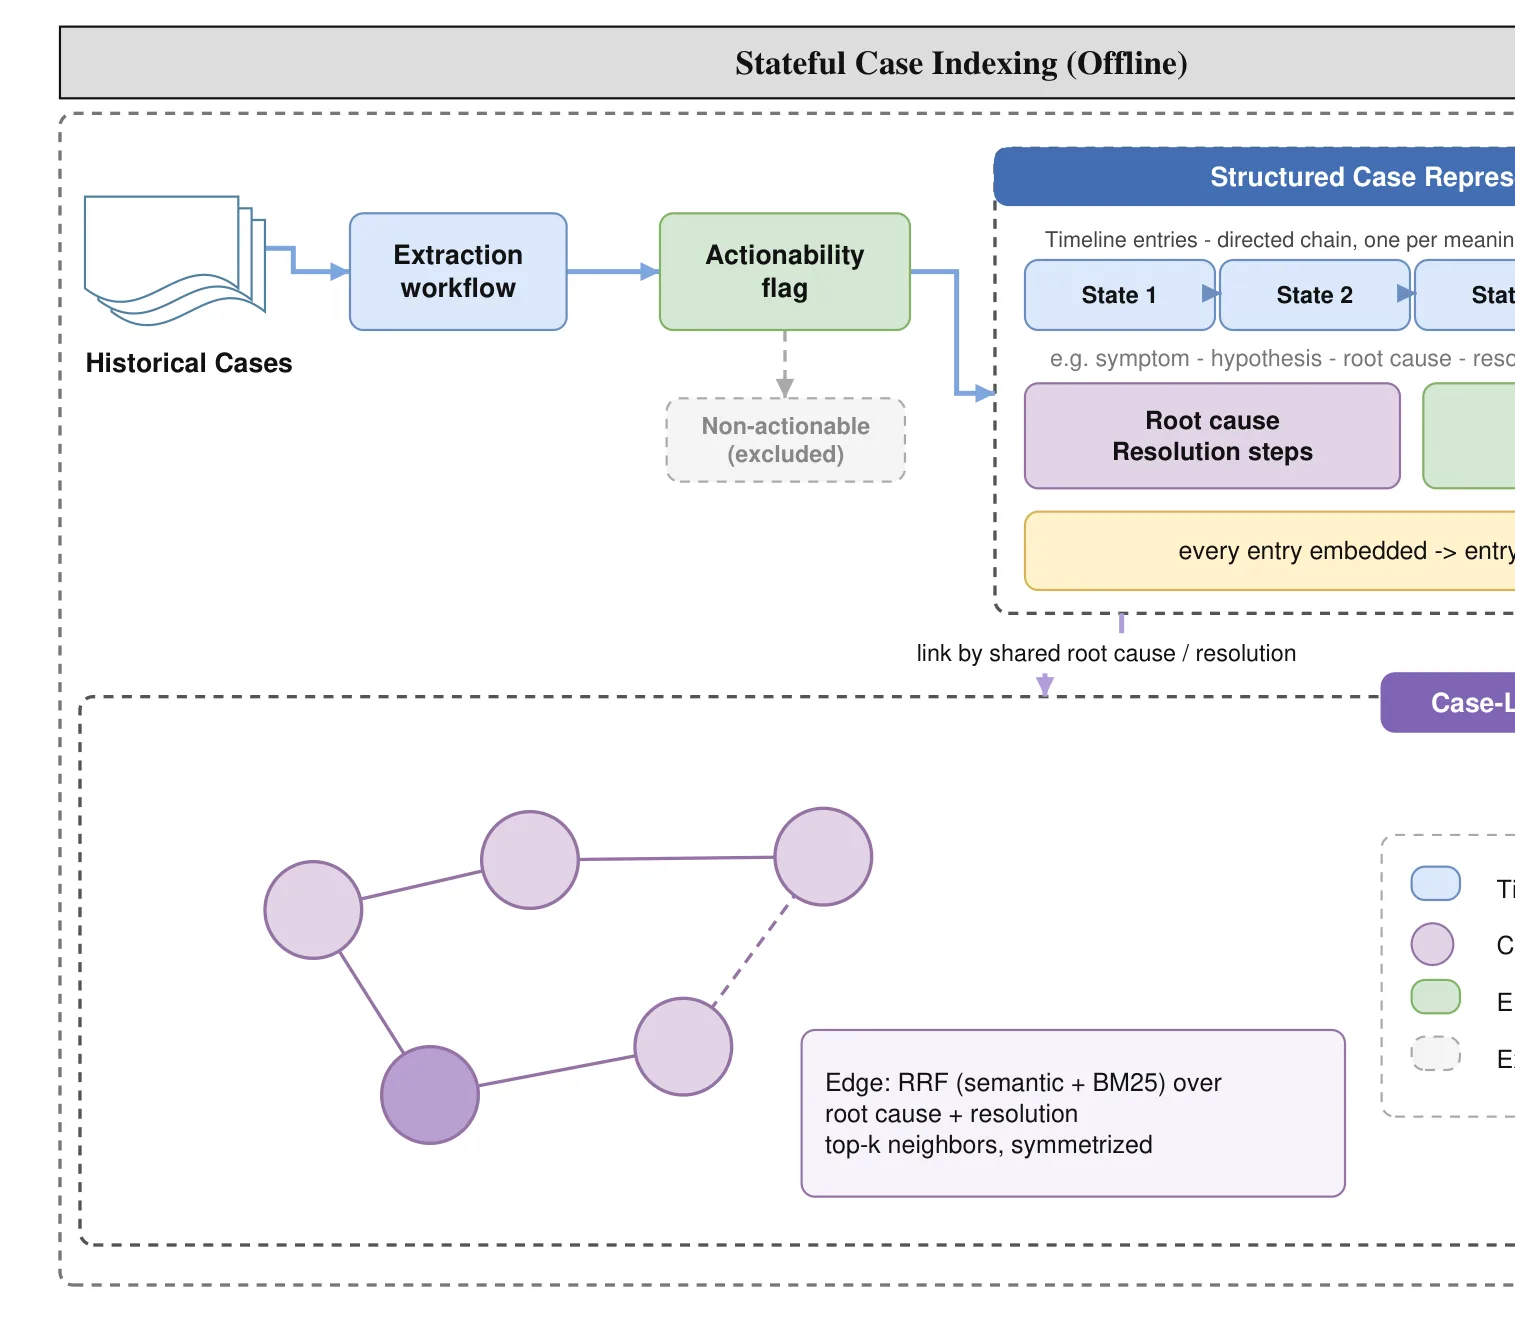
하나의 종결된 케이스 = 방향지어진 타임라인 엔트리의 사슬. 각 엔트리는 조사의 의미 있는 한 단계에서의 기술적 상태를 기록한다.
수식으로는 이렇게 쓴다. 원본 케이스 hi가 구조화된 표현 h~i로 바뀌는데, 그 안에는 리뷰어 판정 ρi, 시간 순 타임라인 {ϕk(i)}, 확정된 경우의 근본 원인 ri, 문서화된 해결 단계 ai, 트러블슈팅 관련 엔티티 ei가 들어 있다.
3.1 엔트리는 무엇을 담나
타임라인 엔트리 하나는 연속된 여러 턴을 묶어 조사의 한 단계를 이룬다. 논문의 정의가 명확하다.
"분할은 하나의 원칙을 따른다. 의미 있는 상태 전이가 있을 때마다 새 엔트리가 시작된다 — 문제의 표현 방식이나 현재의 이해가 실질적으로 갱신되는 지점. 이 전이들은 조사의 자연스러운 국면에 대응한다. 예를 들어 최초 증상 보고, 가설이 추가되거나 폐기되거나 확인되는 순간, 근본 원인이 확정되는 순간, 해결책이 제안되고 검증되는 순간."
그리고 반대편 규칙도 있다. "새로운 통찰을 더하지 않는 확인 응답과 사소한 업데이트는 현재 엔트리에 흡수된다." 이 두 규칙 덕분에 타임라인은 짧게 유지된다 — 논문의 표기로 Ki≪Ti, 즉 엔트리 수가 원본 턴 수보다 훨씬 적다. 저장소의 프롬프트는 더 구체적이다. 완결된 케이스 하나는 보통 2~8개 엔트리가 된다.
각 엔트리가 기록하는 것은 세 가지다. 취해진 행동, 조사 중인 가설, 문제에 대한 현재의 이해.
3.2 그래서, 여기서 상태가 바뀐 건가
말로 하면 추상적이지만 공개된 저장소의 기본 프롬프트에는 판정 규칙이 아주 구체적으로 적혀 있다. 직접 판단해 보는 게 빠르다.
이 규칙들을 실무 감각으로 옮기면 이렇게 된다. 새 엔트리를 만드는 것은 "무슨 일이 있었나"가 아니라 "무엇을 알게 됐나"가 달라졌을 때다. 로그를 열 개 더 받아도 이해가 그대로면 같은 엔트리고, 한 줄짜리 메일 하나가 가설을 뒤집으면 새 엔트리다. 정보량이 아니라 이해의 변화가 기준이다.
한 가지 더. 기각된 가설을 지우지 않고 남긴다는 규칙이 있다. 저장소 프롬프트의 표현은 "미해결 상태의 가설은 명시적으로 남겨라", 그리고 리뷰어에게는 "의미 있는 전이, 고객 안내, 미해결 가설을 보존하라"고 지시한다. "이 길은 아니었다"는 정보가 다음 사람에게 값지기 때문이다. 이건 사람이 쓰는 인수인계 문서의 미덕과 정확히 같다.
3.3 실제 티켓 하나를 쪼개 보면
추상적인 규칙을 실제 티켓에 적용하면 어떻게 되는지 보자. 앞서 나온 CASSANDRA-11513, "기본키로 조회했는데 결과셋이 유일하지 않다"는 티켓이다. 원본은 7턴이고, 규칙을 적용하면 네 개의 상태가 된다.
위젯의 진행도를 바꿔 보면 이 논문의 논지가 눈에 보인다. 증상만 있을 때는 과거 사례의 첫 엔트리에 걸리고, 조사가 진행되면 중간 엔트리에 걸린다. 같은 과거 사례라도 지금 내가 어디쯤 있느냐에 따라 다른 지점이 응답한다.
그리고 결정적으로 — RAFT는 걸린 엔트리만 주지 않는다. 그 엔트리가 속한 케이스 전체를 주면서 "어느 엔트리에서 걸렸는지"를 함께 알려 준다. 논문의 표현이 정확하다.
"이는 에이전트에게 지금 단계에 대한 전술적 지침과 비슷한 케이스들이 어디로 갔는지에 대한 전략적 맥락을 동시에 준다."
여기가 이 글에서 가장 옮겨 쓸 만한 대목이다. 검색의 단위를 “문서”에서 “상태”로 바꾸면, 질의는 자동으로 시간 축을 갖는다. 같은 사건이라도 3일 차의 질문과 10일 차의 질문은 다른 것을 찾아야 하는데, 정적인 문서 유사도에는 그 축이 아예 없다. 그래서 늘 첫 페이지만 돌려준다. 아래 그림이 그 상황이다.
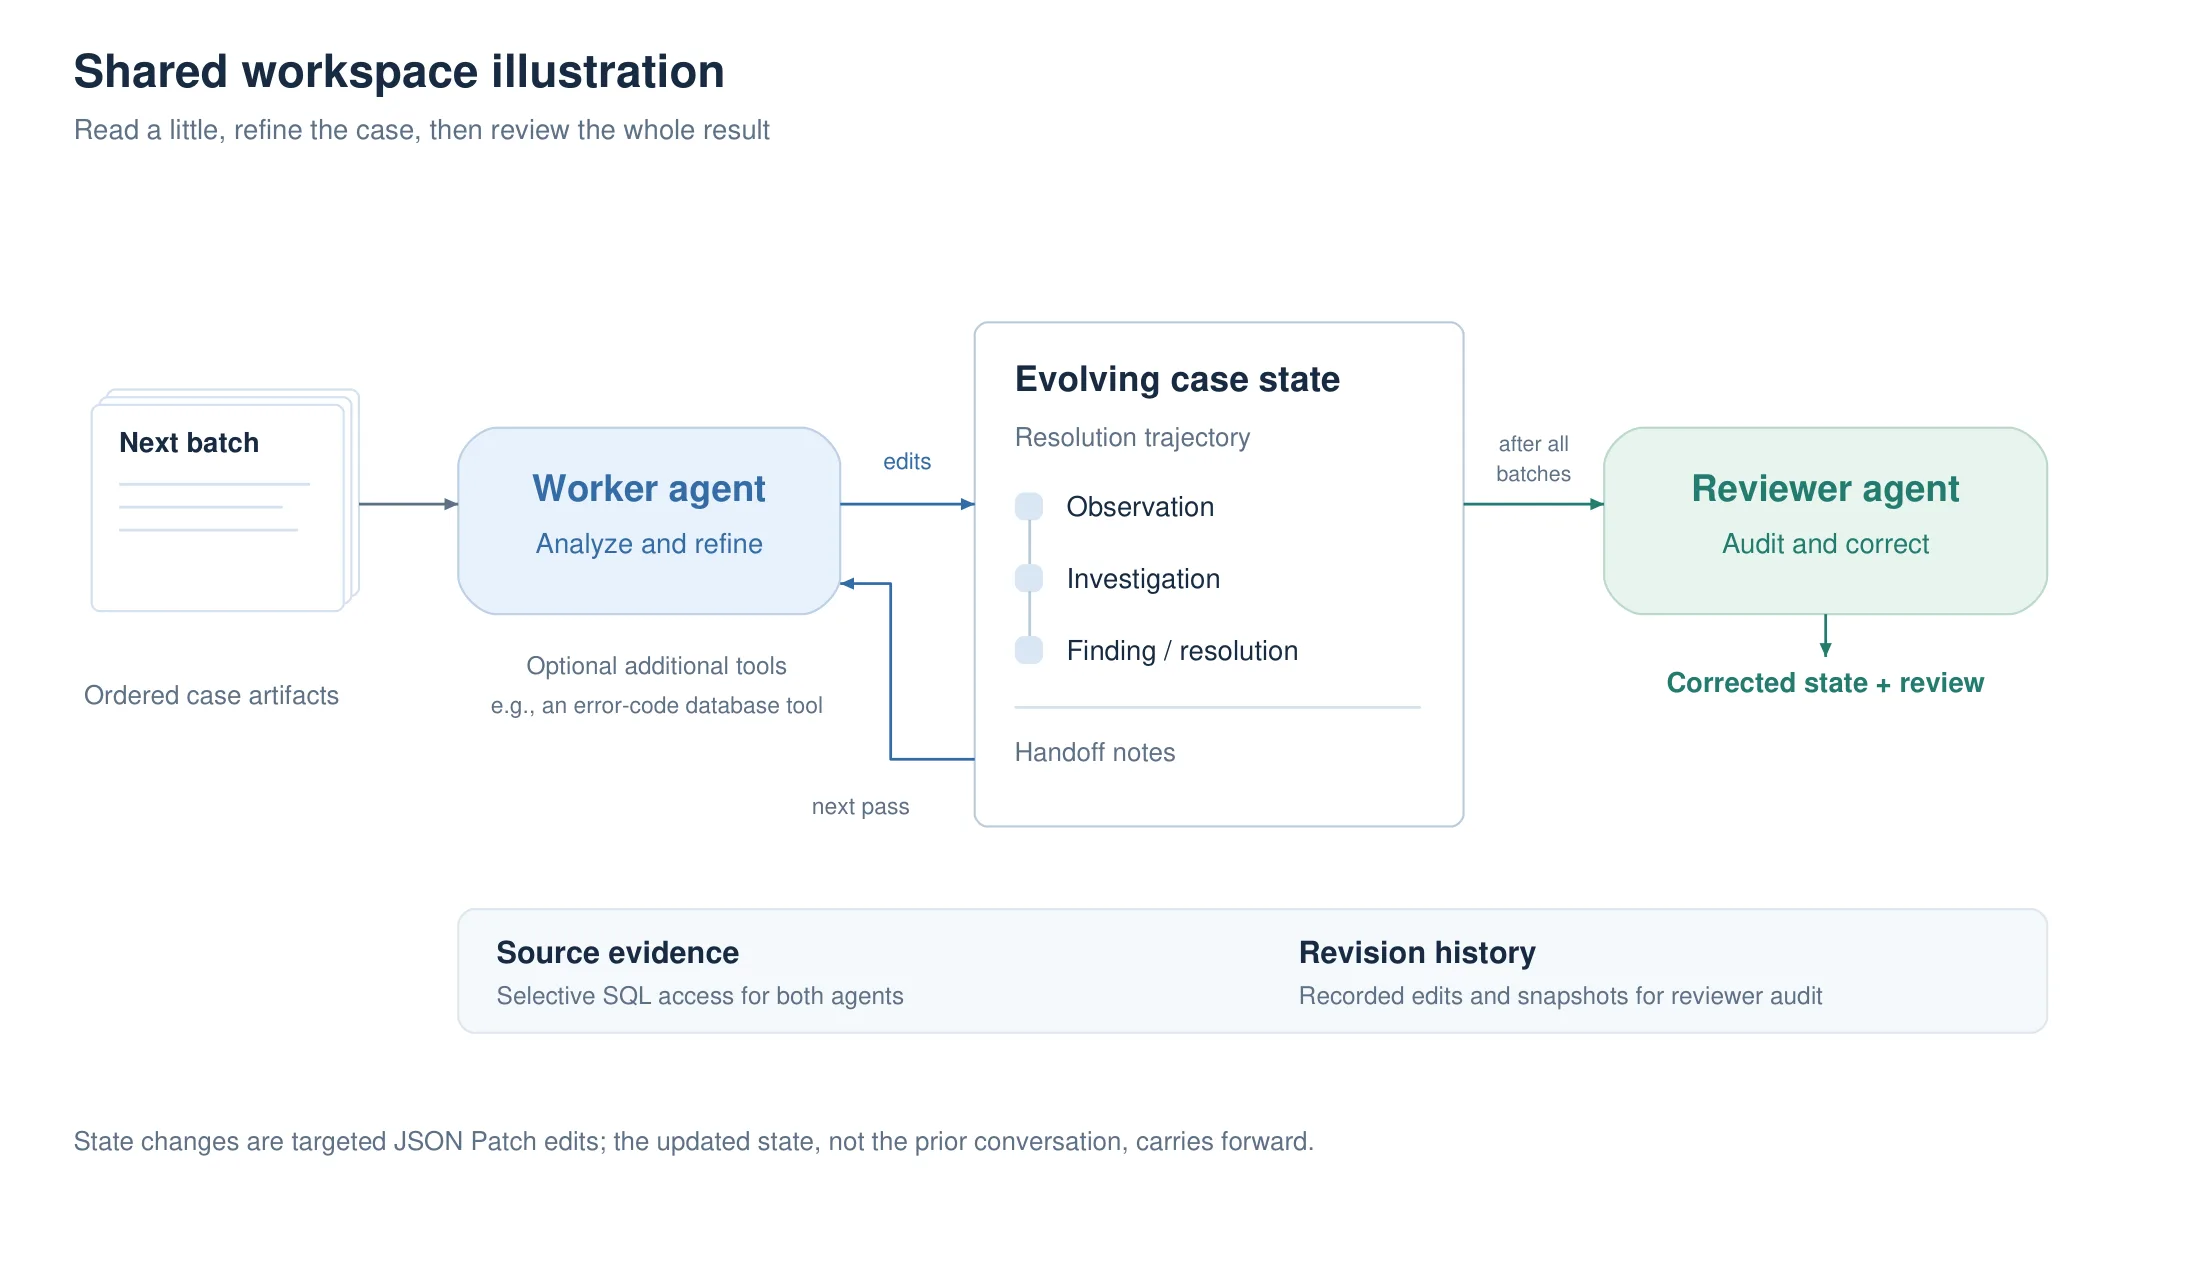
▲ 워커–리뷰어 추출 워크플로. 워커가 배치를 처리하며 상태를 갱신하고, 두 에이전트 모두 원본 증거를 선택적으로 조회할 수 있으며, 리뷰어는 개정 이력까지 들여다본 뒤 완성된 상태를 교정하고 구조화된 판정을 낸다. (출처: microsoft/RAFT, MIT)
이 워크플로에는 배울 점이 많은 설계 결정이 몇 개 있다.
① 상태는 JSON Patch로 고친다. 워커는 전체 출력을 다시 생성하지 않고, 추가·교체·삭제를 지정하는 패치로 공유 상태를 갱신한다. 나중에 나온 증거가 앞선 해석을 정정할 수 있게 하되, 멀쩡한 부분을 다시 쓰게 만들지 않는다.
② 대화가 아니라 상태가 이월된다. 저장소 문서의 표현이 명확하다 — "상태와 인수인계 노트가 이월되며, 전체 대화가 이월되는 것이 아니다." 누적되는 것은 결론이지 수다가 아니다.
③ 원본은 언제든 조회할 수 있다. 모든 원본 산출물은 읽기 전용 SQLite 질의 도구로 남아 있어서, 에이전트가 필요할 때 특정 레코드나 필드를 확인할 수 있다. 요약본만 보고 추론하다가 틀리는 것을 막는 장치다.
④ 인수인계 노트가 따로 있다. 미해결 질문이나 다음 패스가 다시 봐야 할 맥락은 출력 본문이 아니라 별도의 노트로 넘긴다. 결과물과 작업 메모를 섞지 않는다.
⑤ 개정 이력이 남는다. 성공적인 상태 커밋은 스냅샷과 편집 내역을 개정 이력에 기록한다. 그리고 리뷰어는 이 이력을 조회할 수 있다 — 누락이나 상충하는 해석을 조사할 때 "왜 결론이 바뀌었는지"를 추적하기 위해서다.
🧪
이 설계는 RAFT 밖에서도 그대로 쓸 만하다. 긴 문서를 LLM으로 구조화할 때 흔히 쓰는 방식은 “청크마다 요약을 만들고 마지막에 합치기”다. 그러면 앞부분의 잘못된 해석이 끝까지 살아남는다. 여기서 쓴 방식은 누적 상태 + 패치 편집 + 원본 조회 + 최종 감사다. 뒤에 나온 증거가 앞의 결론을 고칠 수 있고, 무엇이 어떻게 고쳐졌는지가 남는다. 사람이 하는 사건 기록과 같은 구조다.
4.3 리뷰어와 '이 케이스가 쓸모 있는가' 판정
모든 배치 처리가 끝나면 리뷰어가 완성된 상태를 받는다. 리뷰어는 원본 증거와 개정 이력을 선택적으로 조회하고, 같은 편집 메커니즘으로 상태를 교정한 다음, 별도의 구조화된 판정 ρi를 낸다.
이 판정 스키마는 애플리케이션이 정한다. 케이스 유형이나 결과 라벨(완화됨, 정보 요청, 해결됨 같은), 실행 가능성 판단, 그리고 그 근거가 들어갈 수 있다. 공개된 기본 구현은 최소 형태다.
# extractable=True 이면 reasoning은 반드시 null
# extractable=False 이면 반드시 비어 있지 않은 근거 문단이 필요
판정 기준이 흥미롭다. 저장소의 리뷰어 프롬프트는 이렇게 지시한다.
"extractable: 재사용 가능한 기술적 통찰이 있으면 true. 부분적인 트러블슈팅, 제안됐으나 미확인인 수정, 유용한 정보성·자문성 안내도 포함한다. 확정된 원인이나 성공한 해결이 반드시 필요한 것은 아니다. duplicate, test, misrouted 같은 라벨이 아니라 내용을 보고 판단하라."
그리고 마지막 줄이 좋다. "판정이 부정적이더라도 교정된 케이스 기록은 그대로 보존하라." 판정과 데이터를 분리한 것이다. 논문 본문도 같은 말을 한다 — "라벨은 케이스를 특징짓는 것이지 자동으로 배제하는 것이 아니다." 워크플로는 완성된 상태와 판정을 모두 돌려주고, 무엇을 저장할지, 저장된 것 중 무엇을 검색 순위에 넣을지는 사용자 정의 필터가 결정한다.
이 구분이 실무에서 중요하다. "쓸모없다"는 판정은 시점과 용도에 따라 바뀐다. 오늘 제외한 케이스가 내일 다른 질문에는 유용할 수 있다. 데이터를 지우는 대신 판정을 붙여 두면 정책만 바꿔 되돌릴 수 있다.
4.4 무엇을 뽑아내나
기본 출력 모델은 네 개의 필드다.
필드
내용
제약
timeline
상태 사슬. 각 엔트리는 독립적으로 임베딩되는 자기완결적 산문 문단
엔트리당 최대 4,800자
root_cause
최신 증거에 기반한 근본 원인 이해. 확정된 원인·의심되는 설명·모르는 것을 구분해 적는다
최대 4,800자 · 미확정이면 null 가능
resolution_steps
실제 수정·완화·우회책과 기록된 결과. 제안된 것, 수행된 것, 성공한 것을 구분한다
최대 4,800자 · 미확정이면 null 가능
entities
케이스의 문제·영향 구성요소·해결을 규정하는 기술 식별자. 오류 코드·컴포넌트명·경로·레지스트리 키·제품-버전 쌍을 원문 그대로
최대 25개, 각 120자
entities에 대한 저장소의 권고가 실무적으로 중요하다. 기본 구현은 범용 엔티티를 뽑지만, 논문은 도메인 배포에서는 이것을 애플리케이션 고유 식별자(오류 코드, 윈도우 버전 등)로 바꾸라고 권한다. 그러면 에이전트가 더 정밀한 질의를 쓰고 검색 공간을 좁힐 수 있기 때문이다. 실제로 뒤에 나오는 에이전트 실험에서 이 효과가 숫자로 확인된다.
그리고 타임라인 엔트리의 작성 지침이 검색 성능과 직결되므로 옮겨 둔다.
엔트리 작성 지침 (저장소 워커 프롬프트)
각 타임라인 엔트리는 자기완결적인 산문 문단 하나이며, 검색을 위해 독립적으로 임베딩된다. 관련된 식별자, 범위, 증상, 현재의 문제 이해를 앞에 놓아라. 조사의 목적, 누가 무엇을 했는지, 관찰된 증거, 그 발견이 가설이나 다음 행동에 어떤 영향을 줬는지를 자연스럽게 설명하라. 산출물에서 확인 가능한 구체적인 명령, 설정, 로그 발견을 포함하라. 이전 단계에서 무엇이 달라졌는지를 반영하라. 이웃 엔트리 없이도 이해 가능하게 만들되, 초점은 그 단계에 두어라.
"식별자를 앞에 놓으라"는 지시는 임베딩과 BM25 양쪽을 동시에 겨냥한 것이다. 문단 앞머리의 토큰이 문서 전체의 의미 표현에 더 크게 기여하고, 오류 코드 같은 정확한 문자열은 어휘 검색에서 결정적인 신호가 된다.
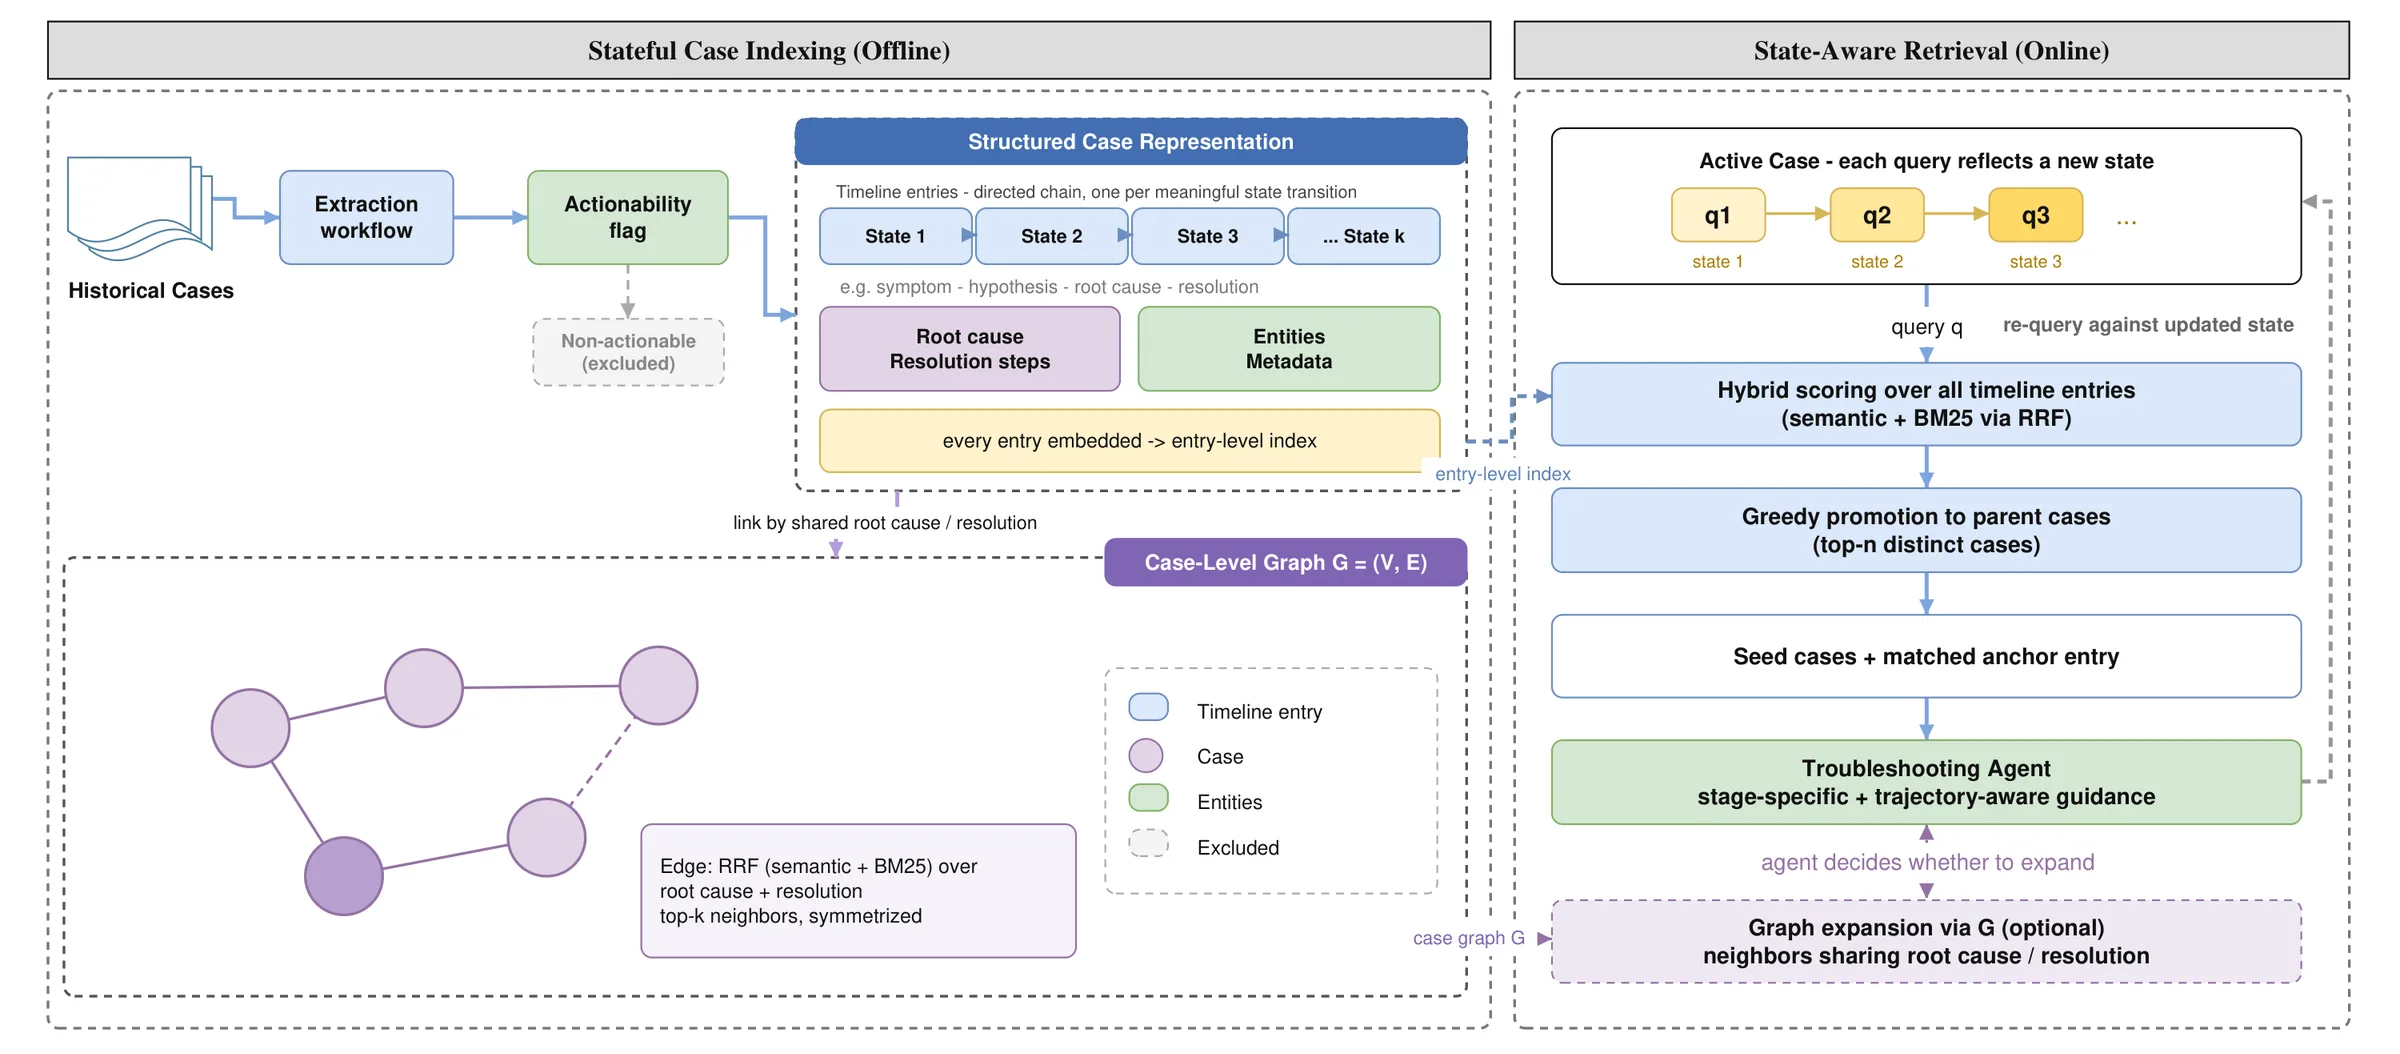
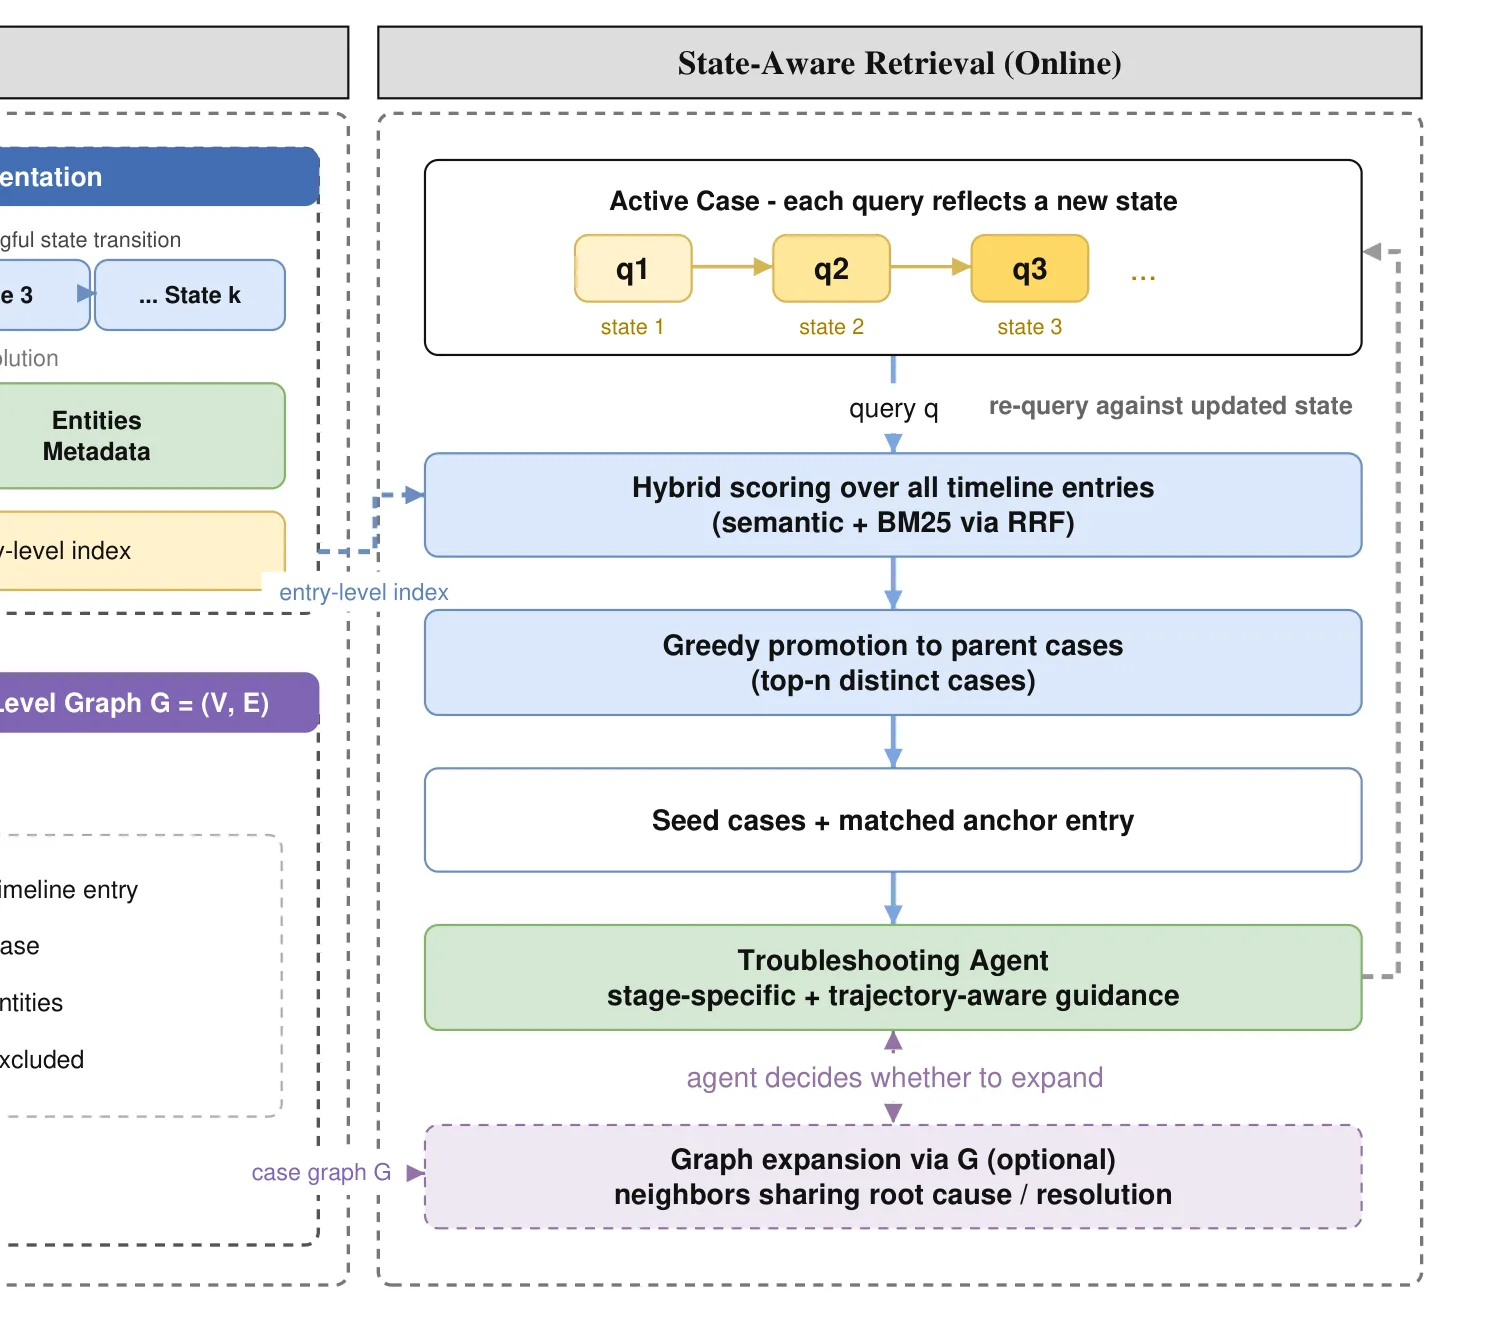
▲ 온라인 검색. 활성 케이스가 진행될 때마다 새 질의가 들어오고(q1 → q2 → q3), 모든 타임라인 엔트리에 대해 하이브리드 점수를 매기고, 부모 케이스로 탐욕적으로 승격해, 시드 케이스와 매치된 앵커 엔트리를 함께 돌려준다. 그래프 확장은 에이전트가 필요하다고 판단할 때만 쓴다. (출처: microsoft/RAFT, MIT)
RAFT의 점수는 두 가지를 섞는다. 의미 검색(임베딩 코사인 유사도)과 어휘 검색(BM25). 이 둘은 서로 다른 것을 잘한다.
의미 검색이 잘하는 것
“인증서가 만료됐다”와 “certificate expired”를 같은 것으로 본다
단어가 달라도 뜻이 통하면 잡는다
약점: 정확한 문자열에 둔감하다. 오류 코드 한 자리 차이를 무시할 수 있다
BM25가 잘하는 것
0x80070005, filter_protien_coding 같은 희귀한 정확 문자열
흔한 단어의 가중치를 자동으로 낮춘다
약점: 같은 뜻 다른 표현을 전혀 못 잡는다
문제는 두 점수의 단위가 다르다는 것이다. 코사인 유사도는 −1에서 1 사이고 BM25는 상한이 없다. 그래서 점수를 더하는 대신 순위를 더한다. 이것이 RRF(Reciprocal Rank Fusion)다. 각 검색기의 결과에서 k번째로 나온 항목에 1 / (c + k) 점을 주고(c는 순위가 낮은 항목의 영향을 눌러 주는 상수), 두 점수를 합산한다. 공개된 구현이 정확히 이 형태다.
src/raft/retrieval/ranking.py — rank_cases()
# 의미 순위에서 rank번째면 1/(rrf_constant + rank)
scores = {i: 1 / (rrf_constant + rank) for rank, i in enumerate(dense_order, 1)}
# 어휘(BM25) 순위에서도 같은 방식으로 점수를 더한다
for rank, i in enumerate(lexical_order, 1):
scores[i] += 1 / (rrf_constant + rank)
효과는 직관적이다. 어느 한쪽에서 압도적으로 1위인 항목보다, 양쪽 모두에서 상위권인 항목이 올라온다. 의미는 비슷한데 오류 코드가 다른 케이스와, 오류 코드는 같은데 맥락이 전혀 다른 케이스를 둘 다 걸러 낸다.
사용자 필터가 있으면 먼저 적용한다 (오류 코드·카테고리·제품 버전·기간·케이스 결과 등으로 검색 공간을 좁힌다)
2
남은 모든 타임라인 엔트리에 하이브리드 점수를 매기고 내림차순 정렬한다 — 엔트리 단위의 상위 컷은 없다
3
위에서부터 훑으며, 아직 뽑지 않은 부모 케이스를 만나면 그 케이스를 선택하고 해당 엔트리를 앵커로 기록한다
4
케이스를 추가했을 때 문맥 예산 B를 넘으면 거기서 멈춘다
5
서로 다른 케이스 n개가 차면 멈추고, 각 케이스의 전체 표현과 앵커 엔트리 번호를 함께 반환한다
직접 돌려 보면 각 손잡이가 무엇을 바꾸는지 보인다. 비교군으로 전환하면 같은 예산에서 벌어지는 차이도 볼 수 있다.
여기서 놓치기 쉬운 두 가지를 짚는다.
첫째, 엔트리 단위 상위 컷이 없다. 구현의 주석이 이를 명시한다 — "중복 제거 전에 적격한 모든 엔트리를 순위 매긴다. 엔트리 단위 top-k 컷오프는 없다." 만약 엔트리 상위 20개만 남긴 다음 부모로 승격하면, 상위권을 한 케이스의 여러 엔트리가 독식해 다양성이 죽는다. 전수 정렬 후 부모 기준으로 중복을 제거하는 순서가 이를 막는다.
둘째, 앵커를 함께 돌려준다. 논문의 문장이 이 설계의 목적을 정확히 말한다.
"이는 에이전트가 어느 조사 상태가 매치됐는지를 보게 해 준다 — 단지 어느 케이스가 매치됐는지가 아니라."
에이전트 입장에서 이 정보는 크다. "이 케이스가 비슷합니다"와 "이 케이스의 3번째 단계, 즉 가설을 기각하고 방향을 튼 지점이 지금 당신 상황과 비슷합니다"는 완전히 다른 힌트다. 후자는 읽어야 할 곳까지 알려 준다.
RAFT에는 두 번째 층이 있다. 케이스끼리 연결하는 무방향 그래프G=(V,E)다. 목적은 엔트리 단위로는 안 걸리지만 다른 관점에서 유용한 케이스로 확장하는 것이다.
연결에 쓰는 텍스트는 설정 가능하다 — 근본 원인, 이슈 요약, 또는 배포 환경에 맞는 다른 필드를 단독으로 또는 조합해서 쓸 수 있다. 논문 실험에서는 근본 원인 텍스트와 해결 텍스트를 이어 붙여 모든 케이스 쌍의 점수를 매겼고(역시 의미 + BM25의 RRF), 각 케이스를 상위 k개 이웃과 연결한 뒤 대칭화하고 공유 최근접 이웃(SNN) 가중치를 부여했다.
이 설계의 의도는 명확하다. 증상은 다른데 원인이나 처치가 같은 케이스를 잡는 것이다. 그리고 논문은 왜 이걸 굳이 따로 두는지도 설명한다.
"초기 n을 단순히 늘리면 이런 보완적 케이스를 발굴하기보다 노이즈를 끌어들이는 경향이 있다. 그래프 확장은 초기 검색을 선별적으로 유지하면서 이들을 가져오는 표적화된 방법을 제공한다."
6.1 그런데 그래프는 거의 기여하지 않았다
여기서 이 논문이 신뢰를 얻는다. 저자들은 그래프의 기여를 측정하고, 거의 없다고 보고한다.
다섯 자리 중 한 자리를 그래프 확장에 예약한 예산 동등 조건에서, 전체 Case Hit 변화는 진행도별로 +0.22 / −0.28 / −0.06 퍼센트포인트였다. 사실상 0이다. 그나마 의미가 있었던 것은 '형제 완전 회수'(정답 케이스가 색인에 둘 있을 때 둘 다 가져오는 비율)로, 초기·중간 단계에서 +1.94pp, +2.90pp 개선됐고 60%에서는 −0.16pp였다.
이웃 수 k를 3, 5, 10으로 바꿔도 Case Hit은 최대 0.17pp밖에 변하지 않았다. 논문의 결론은 담백하다.
"따라서 이 벤치마크에서 결론은 k에 민감하지 않으며, 우리는 전 구간에서 k=3을 쓰고, 그래프 확장을 RAFT의 주된 검색 이득의 원천이 아니라 선택적인 증거 다양화 장치로 제시한다."
⚖️
이 문단이 이 논문을 믿게 만든다. 2026년의 RAG 논문에서 “그래프”는 제목에 넣기 좋은 단어다. 그런데 저자들은 자기 시스템의 그래프 층을 측정해 “거의 기여하지 않는다”고 적었고, 파라미터 민감도까지 붙였다. 그러면서 진짜 기여가 어디에 있는지를 남겨 둔다 — 상태 단위 색인. 자기 방법에서 화려한 부분을 스스로 깎아 내는 보고는, 남은 주장의 신뢰도를 올린다.
덧붙여, 논문은 그래프의 다른 용도를 언급하되 평가하지 않는다고 분명히 한다. 그래프의 커뮤니티 구조로 반복되는 이슈 군(群)을 집계 분석하는 일인데, "여기서는 그 용도를 평가하지 않는다"고 못박았다.
이 논문의 평가 설계에는 한 가지 큰 선택이 있다. 트러블슈팅 에이전트 전체를 평가하지 않고 검색층만 독립적으로 평가한 것이다. 이유가 설득력 있다.
"현실적인 종단 간 평가는 흔히 운영 환경과 프로덕션 워크플로에 대한 접근에 의존하며, 이는 재현 가능한 학술적 평가, 시스템 간 비교, 타인에 의한 확장을 어렵게 만든다. 반면 검색층은 에이전트 하네스, 기반 모델, 워크플로를 가로질러 독립적으로 시험 가능하다."
이건 이 분야의 고질적 문제에 대한 대응이다. 논문의 관련 연구 절은 더 직설적이다 — "이 영역의 연구 대부분은 산업 환경에서 나오며, 평가가 독점 데이터와 프로덕션 지표에 의존해 재현성을 심각하게 제한한다." 가장 가까운 선행 연구(Xu et al. 2024, 고객 서비스 QA를 위한 지식 그래프)도 시스템은 비공개, 데이터셋은 사설, 평가는 프로덕션 환경 한정이라 직접 비교가 불가능했다고 적는다.
그래서 이 논문은 공개 합성 벤치마크 + 공개 실데이터 전이 평가 + 오픈 구현 + 재현 가능한 프로토콜로 대응한다. 실제로 저장소에는 Apache Jira 평가셋이 통째로 들어 있다(corpus.jsonl 600건, queries.jsonl 30건). 이 글에 실린 30쌍 분석도 그 파일을 직접 내려받아 계산한 것이다.
7.2 합성 벤치마크는 어떻게 만들었나
적당한 공개 데이터가 없다는 것이 이 분야의 근본 문제다. 논문은 공개 고객지원 데이터셋 중 세 조건을 모두 만족하는 것이 없다고 정리한다. (1) 단발 QA가 아닌 풍부한 다중 턴 상호작용, (2) 오류 코드·제품·서비스 같은 핵심 엔티티가 비식별되지 않고 보존, (3) 비슷한 케이스를 묶는 라벨.
그래서 Microsoft Learn의 Windows Server 트러블슈팅 문서에서 합성 코퍼스를 만들었다. 만드는 방식이 흥미롭다.
1
위키부터 만든다. 원본 문서를 개별적으로 읽히는 대신, 먼저 위키 형태의 지식베이스로 조직한다. Windows Server 7개 카테고리(Active Directory, 그룹 정책, 라이선싱, 원격 데스크톱, 보안, 백업·스토리지, 네트워킹), 카테고리당 한 세션.
2
각 세션이 하위 카테고리별 서브에이전트를 띄우고, 서브에이전트는 자기 범위의 모든 파일을 읽어 트러블슈팅·정보성·일반 지식으로 분류한다. 조율 에이전트가 이를 통합해 카테고리 개요를 만든다.
3
자기 반성 루프로 생성 지침을 다듬는다. 고수준 지침으로 파일럿 케이스 15건을 만들고, 스스로 검토해 결함을 찾고, 지침 파일을 고친다. 개선이 없을 때까지 반복한 뒤 본 생성을 돌린다.
4
근본 원인 하나당 2~4개 케이스를 생성한다. 평가 때 그룹을 색인 세트와 테스트 세트로 나눌 수 있게 하기 위해서다.
위키를 먼저 만든 이유가 핵심이다. 논문의 설명을 옮기면.
"위키에서 생성할 때의 핵심 이점은 에이전트가 작업 중인 단일 문서에만 갇히지 않고 같은 주제 영역의 관련 문서들, 그 증상과 근본 원인과 겹치는 지점까지 인지한다는 것이다. 이 교차 문서 맥락이 생성된 케이스를 진단적으로 어렵게 만든다. 에이전트는 형제 이슈에서 끌어온 현실적인 레드 헤링을 넣을 수 있고, 그럴듯한 대안 원인을 탐색하고 배제하는 다단계 진단 경로를 구성할 수 있으며, 어떤 두 대화도 같은 트러블슈팅 순서를 따르지 않게 할 수 있다. 위키가 없으면 에이전트는 고립되어 작동하고, 기술적으로는 맞지만 진단적으로는 너무 쉬운 케이스를 만들어 낸다."
합성 데이터로 벤치마크를 만들 때 가장 흔한 실패 — "문제와 답이 1:1로 붙어 있어서 너무 쉬움" — 를 정면으로 겨냥한 설계다. 결과물은 826건, 7개 카테고리, 케이스당 평균 10.4개 메시지·2,767토큰이다.
7.3 '진행도'라는 눈금과 세 가지 지표
이 논문에서 가장 옮겨 쓸 만한 평가 아이디어가 이것이다. 트러블슈팅의 성질을 한 문장으로 짚는다 — "유용한 지침은 조사가 얼마나 진행됐느냐에 달려 있다."
그래서 각 테스트 케이스의 턴 앞부분을 잘라 질의를 만든다. 0%(최초 증상 보고만), 30%, 60%. 같은 케이스에 대해 세 시점의 질의를 던지고 각각 성능을 잰다.
지표
정의
무엇을 재나
Case Hit
검색된 구절 중 하나라도 정답 유사 케이스(같은 근본 원인·해결)에 속하는가
맞는 사례를 찾았는가
Root Cause Coverage
정답 근본 원인 설명을 원자 명제로 쪼갠 뒤, 검색된 문맥이 그중 몇 %를 함의하는지 LLM이 판정
진단에 필요한 증거를 얼마나 담았는가
Resolution Steps Coverage
정답 해결 절차에 대해 같은 방식으로 계산
조치에 필요한 증거를 얼마나 담았는가
Case Hit과 커버리지를 나눈 것이 좋은 설계다. 맞는 케이스를 찾았다는 것과 그 안에서 쓸 만한 증거를 건져 왔다는 것은 다른 문제이고, 실제로 뒤에 나오는 결과에서 두 지표는 다르게 움직인다.
7.4 실데이터 평가셋을 만든 과정
합성 데이터의 한계를 알기에, 논문은 실제 데이터로 전이 평가를 한다. Apache Cassandra, Hadoop, HBase, Spark의 공개 이슈에서 커밋터가 자기 업무 중에 만든 중복 링크를 라벨로 쓴 것이다.
여기에 시간 순서 조건이 붙는다. 나중에 올라온 보고를 질의로 쓰되, 그 질의가 열리기 전에 이미 Fixed로 해결된 과거 이슈만 정답으로 인정한다. 미래 정보 누설을 막는 설계다. 그리고 60% 지점은 사전 공개 이력이 충분한 19개 그룹만 평가한다.
논문이 스스로 단 단서도 정확하다. 방해 이슈들은 "인증된 의미적 네거티브가 아니라 방해물"일 뿐이다 — Jira의 링크가 불완전할 수 있으므로, 방해 이슈 중에 실제로는 관련 있는 것이 섞여 있을 수 있다는 뜻이다.
8. 결과 — 매치 지점이 9.1%에서 54.0%로 이동한다
먼저 실험 조건을 정리하자. 모든 방법이 같은 임베딩 모델(text-embedding-3-large)과 같은 색인용 LLM(gpt-5.2)을 쓰고, 평가에는 gpt-5.4를 쓴다. 메타데이터 필터는 쓰지 않아 각 방법의 검색 메커니즘만 비교되게 했고, 코퍼스의 모든 케이스가 실행 가능하므로 RAFT의 실행 가능성 필터는 아무 케이스도 제외하지 않아 이 비교에서 이점을 주지 않는다. 검색 문맥은 전 방법 6,000토큰으로 제한하고, 케이스 단위로 반환하는 방법들은 추가로 5개 케이스로 제한했다.
8.1 Case Hit은 크게, 커버리지는 작게
숫자를 요약하면 이렇다. 0% 진행도에서 RAFT는 84.2%, 평범한 RAG는 67.3%, HippoRAG2는 65.0%. 60%에서는 RAFT가 88.8%까지 간다. 근본 원인 그룹으로 군집화한 부트스트랩 결과, Case Hit의 세 지점 모두 통계적으로 유의하다(+16.79 / +14.79 / +12.19pp).
그런데 커버리지 지표는 이야기가 다르다. 초기 단계의 이득은 통계적으로 뒷받침되지만, 60% 지점의 근본 원인 커버리지(+1.88pp)와 해결 커버리지(+0.57pp)는 신뢰구간이 0을 포함한다. 논문의 처리가 모범적이다.
"모든 무조건부 커버리지 점 추정치도 RAFT에 유리하다. 초기 단계 커버리지 이득과 30% 근본 원인 이득은 통계적으로 뒷받침되며, 30% 해결 이득은 작고 구간 경계에 가깝고, 후기 단계 커버리지에 대해서는 우리는 아무 주장도 하지 않는다."
이걸 실무 언어로 옮기면 이렇다. RAFT의 확실한 강점은 "맞는 사례를 찾아 오는 것"이지, "그 안에 증거를 더 많이 담는 것"이 아니다. 조사가 충분히 진행되면 어떤 방법이든 단서가 많아져서 커버리지 격차가 줄어든다. 사람이 아직 아무것도 모를 때 격차가 가장 크다는 점이, 이 시스템을 실제로 쓰는 시나리오와 잘 맞는다.
8.2 이 논문의 진짜 증거 — 매치 깊이
정확도가 올랐다는 것만으로는 왜 올랐는지 알 수 없다. 논문은 한 걸음 더 들어가서, 정답을 맞힌 경우에 한해 그 매치가 과거 사례의 어느 지점에서 일어났는지를 센다.
9.1%
진행도 0% 질의의 평균 매치 깊이 (평균 0.28번째 엔트리)
20.0%
진행도 30% (평균 0.59번째)
54.0%
진행도 60% (평균 1.58번째)
5.9배
0%에서 60%로 갈 때 매치 깊이의 증가폭
논문의 해설이 짧고 분명하다.
"이것이 의도된 동작이다. 초기 질의는 증상만 담고 있어 과거 케이스의 시작 엔트리에 매치되는 반면, 후기 질의는 증상에 다시 매치되는 것이 아니라 대응하는 중간 상태에 정렬된다."
이 표가 이 논문의 논지를 직접 증명한다. 다른 모든 수치는 "좋아졌다"를 말하지만, 이 수치만이 "설계한 대로 작동한다"를 말한다. 논문을 읽을 때 이런 표를 찾는 습관은 늘 남는다 — 성능 지표가 아니라 메커니즘 지표.
8.3 무관한 대화 한 턴이 만드는 차이
강건성 실험 하나는 따로 강조할 만하다. 깨끗한 질의에 세 가지 교란을 결정론적으로 가하고 Case Hit 변화를 쟀다.
가벼운 오타(5자 이상 단어의 2%에서 인접 문자 교환)와 업데이트 40% 누락은 양쪽 방법 모두 거의 영향이 없었고, 차이도 통계적으로 구별되지 않았다. 그런데 세 번째 교란 — 무관한 다른 이슈 카테고리의 대화를 한 턴 삽입 — 에서 결과가 갈렸다.
무관한 대화 한 턴을 넣었을 때 Case Hit 하락폭 (진행도 60%)
RAFT
−9.36%p
Vanilla RAG
−49.31%p
차이 +39.94%p [95% CI +35.73, +44.10]. 30% 지점에서도 −11.14 대 −25.93으로 같은 방향이다.
왜 이렇게 벌어질까. 구조적인 이유가 있다. 케이스 전체를 하나의 덩어리로 임베딩하면 섞여 들어온 한 문단이 그 덩어리의 의미 벡터를 통째로 끌고 간다. 반면 상태별로 쪼개 두면, 오염된 부분과 무관한 엔트리들이 각자 살아남아 제 점수를 낸다. 쪼개는 것이 노이즈를 격리하는 셈이다.
실무적 함의가 크다. 실제 티켓에는 무관한 내용이 항상 섞인다 — 고객이 다른 문제를 같은 스레드에 물어보고, 담당자가 사내 공지를 붙여 넣고, 자동 알림이 끼어든다. 그 상황에서 무너지지 않는 것은 정확도 몇 %p보다 실무에서 체감이 크다.
⚠️
논문이 스스로 단 단서를 같이 옮긴다. “이것은 통제된 질의 강건성이자 벤치마크 내부 결과이며, 노이즈가 많은 코퍼스에 대한 강건성이나 프로덕션 규모의 동작, 도메인 간 일반화의 증거가 아니다.” 질의에 노이즈를 넣은 실험이지, 색인된 코퍼스 자체가 지저분할 때 어떻게 되는지를 잰 것이 아니다.
8.4 실제 Jira로 옮겼을 때
합성 데이터에서 잘 되는 것과 실제 데이터에서 잘 되는 것은 다르다. 그래서 전이 평가가 필요하다. 그리고 이 평가의 조건 하나가 중요하다 — 합성 실험에서 쓴 추출 프롬프트, 스키마, 모델, 검색 절차를 하나도 바꾸지 않고 그대로 적용했다. 데이터에 맞춰 튜닝하지 않았다는 뜻이다.
결과는 진행도 0%, 30%, 60%에서 각각 +16.7, +17.3, +10.5 퍼센트포인트. 실제 기고자들이 쓴, 비식별되지 않은 이슈 이력 위에서다.
저자들의 자기 평가도 그대로 옮긴다. "30개의 감사된 중복 그룹으로 구성되고 신뢰구간이 없으므로, 포괄적인 실세계 평가가 아니라 방향성 있는 전이 증거로 취급한다." 이 정도로 표본이 작으면 이렇게 말하는 것이 맞다.
8.5 색인 모델은 얼마나 좋아야 하나
배포를 생각하면 중요한 질문이다. 논문은 기본 색인 모델 gpt-5.2를 더 작은 모델로 바꿔 본다.
결과는 실용적이다. gpt-5.4-mini와 추론 강도를 낮춘 설정은 소폭 하락에 그쳤고, gpt-5.4-nano는 눈에 띄게 떨어졌다. 논문의 정리가 좋다.
"추출 품질은 중요하지만, 비용 제약 아래서 작은 모델도 여전히 쓸 만하며 대규모 배포에 실용적인 절충점을 제공한다."
그리고 배포 고려사항 절에 그 이유가 붙어 있다. "추출 워크플로는 케이스를 새로 푸는 것이 아니라 문서화된 조사를 요약하는 것" 이기 때문이다. 없는 답을 만들어 내는 일이 아니라 이미 적힌 것을 정리하는 일이라, 추론 능력의 상한이 덜 중요하다.
8.6 에이전트가 직접 질의를 쓰면 더 오른다
마지막으로, RAFT를 에이전트에게 도구로 노출한 실험이 있다. 활성 케이스의 카테고리로 케이스를 필터링하고, 에이전트가 자기 이해를 반영한 검색 질의를 직접 작성하게 했다. 같은 0%·30%·60% 맥락을 주고.
결과는 91.0 / 91.0 / 91.9%. 기본 조건(84.2 / 87.1 / 88.8%)보다 모든 지점에서 높다. 특히 0% 지점의 이득이 가장 크다(+6.8pp)는 점이 흥미롭다. 정보가 가장 적을 때, 그 적은 정보를 어떻게 질의로 만드느냐가 가장 크게 작용한다.
여기에 논문이 붙인 권고가 실무적으로 중요하다. 기본 구현은 범용 엔티티를 뽑지만, 도메인 배포에서는 케이스를 고유하게 특징짓는 애플리케이션 고유 엔티티(오류 코드, 제품 버전 등)로 교체하라는 것이다. 그래야 에이전트가 더 표적화된 질의를 쓰고 검색 공간을 좁힐 수 있다. 검색층을 잘 만드는 것과 에이전트가 그것을 잘 쓰는 것은 곱해진다.
이 논문에서 가져갈 것은 84.2%라는 숫자가 아니다. 표현 방식이다. 한 문장으로 줄이면 이렇다.
사건을 문서 한 장이 아니라 상태의 사슬로 두고, 그 사슬의 중간 지점을 검색 대상으로 삼는다.
이 발상이 통하는 조건은 도메인과 무관하다. 해결이 한 번에 끝나지 않고 여러 국면을 거치며, 과거 사례가 쌓여 있고, 유사성이 겉으로 드러나지 않는다면 — 고객지원이 아니어도 같은 구조가 작동한다.
도메인을 골라서 무엇을 정해야 하는지 보자. 아래에는 적용 조건 체크리스트도 함께 있다.
9.1 옮길 때 반드시 정해야 하는 네 가지
위젯을 몇 개 눌러 보면 공통 구조가 보인다. 어느 도메인이든 네 가지를 정해야 한다.
정할 것
질문
틀리면 생기는 일
케이스의 경계
무엇을 하나의 사건으로 볼 것인가 (티켓 하나? 인시던트 하나? 상담 건 하나?)
너무 크게 잡으면 상태가 흐려지고, 너무 잘게 잡으면 궤적이 사라진다
상태 축
이 사건은 어떤 국면들을 거치는가
축이 없으면 “어느 단계”라는 질의 자체가 성립하지 않는다
전이 조건
무엇이 달라져야 새 상태인가
느슨하면 엔트리가 폭발해 압축 이점이 사라지고, 빡빡하면 중간 지점이 안 생겨 원래 RAG로 돌아간다
실행 가능성 판정
어떤 종결 사례가 참고할 가치가 있는가
‘닫혔다 = 쓸모 있다’로 두면 정보 없는 사례가 검색을 오염시킨다
세 번째가 가장 어렵다. 그래서 RAFT가 프롬프트에 "완결된 케이스 하나는 보통 2~8개 엔트리"라는 수치 감각을 박아 둔 것이다. 이건 통계적 사실이라기보다 설계 목표에 가깝다 — 그 정도 해상도가 되게 전이 조건을 잡으라는 지시다.
9.2 에이전트 메모리와의 관계
한 가지 더. 이 구조는 에이전트 자신의 작업 기억에 그대로 대응된다. 에이전트가 과제를 풀 때도 상태가 바뀐다 — 접근을 정하고, 시도하고, 실패하고, 원인을 찾고, 고치고, 검증한다. 그 세션 기록을 상태 사슬로 남기면, 다음에 비슷한 지점에서 막혔을 때 "그때 여기서 뭘 해서 풀렸지"를 찾을 수 있다.
실제로 논문이 인용하는 관련 연구 중에는 다중 에이전트 시스템의 계층적 메모리를 다룬 것도 있고, 저자들이 "초기 n을 늘리면 노이즈만 는다"는 주장의 근거로 든 것이 바로 그 연구다. 에이전트 메모리 일반에 대해서는 이 블로그의 「AI는 어떻게 기억하는가」와 사건 중심 표현을 다룬 「EventRAG 완전 해부」가 이 글과 나란히 읽기 좋다.
🧭
한 줄 정리. 검색을 설계할 때 우리는 보통 “무엇에 대한 문서인가”만 인덱스에 담는다. 이 논문은 거기에 축을 하나 더한다 — “이 사건은 어디까지 왔는가.” 그 축이 있으면 같은 질문이 시점에 따라 다른 답을 받을 수 있고, 축이 없으면 언제 물어도 첫 페이지만 돌아온다.
10. 비용과 운영
논문의 배포 고려사항 절이 짧지만 알차다. 실제로 도입을 검토한다면 이 절이 가장 실무적이다.
10.1 비용은 어디로 옮겨 가나
RAFT는 평범한 RAG보다 색인 시점에 LLM 비용을 더 쓴다. 케이스를 증류해야 하기 때문이다. 논문은 이것을 비용 증가가 아니라 이동으로 설명한다.
평범한 RAG
색인 시점: LLM 추출 없음 — 싸다
질의 시점: 원본 케이스를 돌려주므로 에이전트가 긴 이력을 읽어 관련 조사와 해결을 재구성해야 한다
그리고 그 작업을 질의마다 반복할 가능성이 있다
RAFT
색인 시점: 증류 비용을 한 번 치른다
질의 시점: 압축된 표현을 재사용하므로 궤적 전달에 필요한 토큰이 줄어든다
같은 문맥 예산에서 더 정확히 찾는다는 것이 결과로 확인된다
논문의 결론은 정직하다. "결과적인 종단 간 비용 절충은 질의량과 에이전트가 검색 문맥을 얼마나 소비하는지에 달려 있다." 질의가 많을수록 오프라인 증류가 유리해진다는 뜻이고, 반대로 사례당 질의가 한두 번이면 계산이 달라진다.
10.2 증분 갱신이 쉽다
이건 GraphRAG 계열 대비 실질적인 운영상의 장점이다.
"RAFT는 독립적인 케이스 처리를 통해 증분 갱신을 지원한다. 케이스를 추가하거나 수정하려면 그 케이스만 추출하고 검색 색인과 케이스 그래프를 갱신하면 되며, 다른 케이스를 다시 추출할 필요가 없다. 이 독립성은 공유 엔티티 그래프와 커뮤니티 요약이 문서 간 의존성을 만드는 GraphRAG 파이프라인에 비해 유지보수를 단순화한다."
엔티티 중심 그래프의 고질적 문제다. 문서 하나를 고치면 엔티티가 바뀌고, 엔티티가 바뀌면 관계가 바뀌고, 커뮤니티 요약이 낡는다. 그래서 주기적으로 전체를 다시 만들게 된다. 케이스 단위로 독립적인 구조는 그 사슬이 없다.
10.3 프로덕션에서는
저장소의 권고가 구체적이다. LocalPipeline은 로컬 실험용이고, 프로덕션에서는 추출과 임베딩 단계를 독립적으로 쓰라고 한다. 두 단계 모두 배치 처리, 동시성·재시도 설정, 케이스별 실패 처리를 지원하고, 결과를 저장하지 않고 메모리로 돌려준다. 저장과 검색은 벡터·하이브리드 검색을 지원하는 서비스(예: Azure AI Search)에 맡기는 구조다.
그리고 가장 중요한 권고.
"당신의 과거 사례에 맞게 RAFT를 적응시켜라. 워커와 리뷰어 양쪽에 사내 지식베이스·내부 문서·오류 카탈로그를 검색할 도구를 붙이기를 강력히 권한다. 제품·용어·케이스 데이터에 대한 배경 맥락을 지시문에 추가하라. 기본 출력 모델의 범용 entities 필드를 필터링과 지식 조회에 쓸 애플리케이션 고유 식별자로 교체하라. 무엇이 정확하고 유용한 추출인지에 맞춰 리뷰어의 지시문과 수용 기준을 조정하라."
기본값으로 돌리면 기본값만큼 나온다는 말이다. 이 프레임워크의 품질은 도메인 지식을 얼마나 주입했느냐에 비례한다.
11. 한계와 반론
11.1 논문이 직접 밝힌 것
1
주 평가가 합성 데이터다. 중간 규모이고, 프로덕션 코퍼스는 훨씬 많은 케이스와 케이스당 훨씬 많은 토큰을 갖는다.
2
Jira 평가는 30그룹, 신뢰구간 없음. 포괄적 실세계 평가가 아니라 방향성 전이 증거로 취급한다고 명시했다.
3
최종 진단·해결 성공·엔지니어 생산성 같은 종단 간 결과를 평가하지 않았다. 검색층으로 범위를 좁힌 이유는 7.1절에 적힌 그대로다.
11.2 이 특집이 덧붙이는 반론
① 합성 벤치마크의 구조적 이점이 있다. 합성 코퍼스는 근본 원인 하나당 2~4개 케이스를 생성하고 그중 하나를 테스트 질의로 뺀다. 즉 정답 케이스가 색인에 반드시 존재하고, 같은 파이프라인이 같은 방식으로 쓴 문서다. 문체와 구조가 균질하다는 뜻이고, 이는 상태 추출에 유리한 조건일 수 있다. 실제 Jira에서 이득 폭이 줄어든 것(+16.7 → +10.5pp, 진행도가 오를수록)도 이와 무관하지 않을 것이다. 논문이 실데이터 전이 평가를 붙인 것 자체가 이 약점을 인지한 설계다.
② 추출이 틀리면 되돌릴 방법이 없다. RAFT는 검색층에서 원본이 아니라 증류된 표현을 본다. 워커가 중요한 단서를 빠뜨리거나 잘못 해석하면, 그 케이스는 영영 안 걸리거나 엉뚱하게 걸린다. 리뷰어와 개정 이력이 이를 완화하지만 제거하지는 못한다. 색인 모델 절제 실험에서 gpt-5.4-nano가 떨어진 것이 이 경로다. 원본 조회 도구가 있긴 하지만 그것은 추출 시점의 장치이지 검색 시점의 장치가 아니다.
③ ‘단계’ 자체가 도메인 의존적이다. 논문의 전이 근거는 IT 트러블슈팅 안에서의 전이(합성 Windows Server → 실제 오픈소스 이슈)다. 두 영역 모두 "증상 → 가설 → 원인 → 수정"이라는 같은 서사 구조를 공유한다. 이 구조가 약한 도메인 — 예를 들어 단계가 병렬로 진행되거나, 되돌아가기가 잦거나, 국면 구분 자체가 합의되지 않은 영역 — 에서도 통할지는 이 논문이 답하지 않는다. 9장의 도메인 확장을 "검증된 결과가 아니라 해석"이라고 표시해 둔 이유다.
④ 프라이버시를 문제로만 제기하고 해결하지는 않았다. 네 번째 한계로 프라이버시를 꼽고 "색인 전 추상화·비식별 계층이 필요하다"고 적었지만, 그 계층을 설계하거나 평가하지는 않는다. 실제로는 추출 워크플로가 그 역할을 겸할 수 있다 — 원본에서 요약을 만드는 과정에서 개인정보를 떨어뜨릴 수 있으니까. 하지만 LLM 요약이 개인정보를 확실히 제거한다는 보장은 없고, 이건 별도의 검증이 필요한 주제다. 평가셋이 Apache Jira인 것도 공개된 비식별 불필요 데이터라서 가능했다는 점을 기억할 필요가 있다.
⑤ 그래프 층은 사실상 선택 사항으로 남았다. 6장에서 본 대로다. 논문이 정직하게 보고했으므로 비판이라기보다 정리에 가깝다 — RAFT를 도입한다면 1층(상태 사슬)부터 하고 2층(그래프)은 나중에 해도 된다. 실제 이득의 거의 전부가 1층에서 나온다.
🧭
그래서 어떻게 읽어야 하나. 이 논문의 기여는 “정확도를 16%p 올렸다”가 아니라 “검색 단위를 문서에서 상태로 바꾸면 질의가 시간 축을 갖는다”는 것을 설계하고, 그 설계가 의도대로 작동함을 매치 깊이로 계측하고, 검증 가능한 형태로 데이터와 코드를 공개한 것이다. 숫자는 벤치마크가 바뀌면 바뀐다. 표현 방식은 남는다.
12. 직접 해보기
논문의 좋은 점은 전부 지금 확인할 수 있다는 것이다. 저장소는 MIT 라이선스이고 평가 데이터가 통째로 들어 있다.
12.1 데이터부터 열어 보기
가장 빠른 길은 평가셋을 직접 보는 것이다. 이 글의 30쌍 분석도 이 두 파일로 만들었다.
# 각 줄이 JSON 하나다. 질의의 target_key가 정답 이슈 키.
python3 -c "import json;[print(json.loads(l)['key'],'->',json.loads(l)['target_key']) for l in open('queries.jsonl')]"
progress_valid 플래그가 true인 단계만 질의로 쓰라는 것이 데이터셋 README의 지시다. 60% 지점은 30건 중 19건만 유효하다.
요구사항은 Python 3.11+이고, 에이전트 백엔드는 OpenAI Agents SDK다. 선택 확장으로 Azure Entra 인증(azure)과 Voyage 임베딩(voyage)을 지원한다. 끝에서 끝까지 보려면 저장소의 examples/jira_walkthrough.ipynb가 가장 빠르다 — 위에서 받은 Jira 데이터로 색인·검색·그래프 확장·포맷팅을 전부 보여 준다.
12.3 우리 데이터에 적용한다면 — 순서
논문과 저장소의 권고를 실행 순서로 재배열하면 이렇게 된다.
1
가장 작은 범위부터. 전체 티켓 아카이브가 아니라 한 제품군, 최근 1년으로 시작한다. 상태 축이 도메인마다 다르므로, 좁은 범위에서 전이 규칙을 먼저 맞춰야 한다.
2
entities부터 교체한다. 범용 엔티티를 오류 코드·제품 버전·컴포넌트 같은 우리 식별자로 바꾼다. 필터링과 에이전트 질의의 정밀도가 여기서 갈린다.
3
워커·리뷰어에 도구를 붙인다. 사내 지식베이스, 내부 문서, 오류 카탈로그 검색. 추출 품질이 곧 검색 품질이다.
4
실행 가능성 판정 기준을 우리 말로 쓴다. 어떤 종결 사례가 참고할 가치가 있는지는 조직마다 다르다. 라벨이 아니라 내용으로 판단하게 쓰는 것이 핵심이다.
5
진행도 눈금으로 평가한다. 이 논문에서 가장 옮겨 쓰기 쉬운 것이 이 평가 방법이다. 우리 과거 사례의 앞부분만 잘라 질의로 만들고, 정답 사례가 검색되는지 0%·30%·60%에서 각각 잰다. 평균 하나로 뭉뚱그리면 이 시스템의 핵심 이득이 안 보인다.
6
매치 깊이를 같이 계측한다. 정확도만 보면 왜 좋아졌는지 모른다. 매치가 과거 사례의 몇 번째 상태에서 일어나는지를 함께 보면, 상태 축이 제대로 잡혔는지가 드러난다.
마지막 두 항목을 특히 권한다. 이 논문이 자기 설계를 검증한 방법을 그대로 빌려 쓰는 것이고, 비용이 거의 들지 않는다.
이 글은 제목이 한 글자도 겹치지 않는 두 티켓으로 시작했다. "NPE가 납니다"와 "2.2와 3.0의 페이징 상태가 프로토콜 v4에서 호환되지 않습니다". 사람은 둘이 같은 문제라는 걸 알아봤다. 그 사람은 두 티켓의 제목을 비교한 게 아니라, 두 조사가 도달한 지점을 비교했다.
RAFT가 하는 일이 그것이다. 검색 인덱스에 축을 하나 더한다. 지금까지 우리는 "무엇에 대한 것인가"만 담았고, 그래서 언제 물어도 같은 첫 페이지를 받았다. 여기에 "이 사건은 어디까지 왔는가"가 더해지면, 같은 질문이 시점에 따라 다른 답을 받는다. 3일 차에는 방향을 알려 주고, 10일 차에는 그 방향의 끝에서 무슨 일이 있었는지를 알려 준다.
기술적으로는 단순하다. 케이스를 잘라 각각 임베딩하고, 전부 줄 세운 다음, 부모 케이스로 되돌려 주면서 어디서 걸렸는지 알려 준다. 그래프도, 새로운 손실 함수도, 파인튜닝도 없다. 논문이 자기 그래프 층조차 "주된 이득의 원천이 아니다"라고 적어 버린 것이 오히려 이 점을 또렷하게 만든다.
그리고 이 단순함이 옮기기 쉬운 이유다. 장애 대응 기록도, 영업 상담 이력도, 법무 사건 파일도, 에이전트 자신의 작업 로그도 전부 상태를 거쳐 가는 사건이다. 그것들을 문서 한 장으로 눌러 두고 있다면, 이미 갖고 있는 축 하나를 버리고 있는 셈이다.
참고자료
논문과 코드
Zhang, M., Wang, X., Sharan, A., Chen, Z., Zhang, C. D., Yang, S. & Pacharu, C. RAFT: A Stateful Retrieval-Augmented Framework for Troubleshooting Agents.arXiv:2609.20754 (2026년 9월 17일) — EMNLP 2026 Industry Track 채택. CC BY 4.0
Edge, D. et al. From Local to Global: A Graph RAG Approach to Query-Focused Summarization, arXiv:2404.16130 (2024)
Xiang, Z. et al. When to use Graphs in RAG: A Comprehensive Analysis for Graph Retrieval-Augmented Generation, arXiv:2506.05690 (2025) — RAFT가 GraphRAG 기준선의 부진을 설명하며 인용한 연구
Cormack, G. V., Clarke, C. L. A. & Buettcher, S. Reciprocal Rank Fusion Outperforms Condorcet and Individual Rank Learning Methods, SIGIR (2009) — RRF의 원전
Hong, K., Troynikov, A. & Huber, J. Context Rot: How Increasing Input Tokens Impacts LLM Performance, Chroma (2025) — 배치 처리 설계의 근거로 인용
그림과 데이터 출처.third-party-로 시작하는 구조도 세 장은 microsoft/RAFT 저장소의 자산으로, MIT 라이선스에 따라 원형 그대로 인용했다. 논문 본문 인용은 arXiv:2609.20754(CC BY 4.0)에서, 프롬프트·코드 인용은 저장소에서 가져와 한국어로 옮겼다. 30쌍의 제목 유사도 분석과 코퍼스 통계(평균 15.6턴 등)는 공개된 평가셋을 코어닷투데이가 직접 계산한 것으로 논문에 실린 수치가 아니다. 위젯의 케이스 분할 예시와 검색 시뮬레이터의 점수 역시 논문의 규칙·알고리즘을 따라 구성한 예시이며 RAFT의 실제 출력이 아니다. 그 밖의 삽화는 코어닷투데이가 생성했다.