
TECH BLOG
기술 블로그
AI 기술 인사이트와 엔지니어링 경험을 공유합니다.
EDITOR'S PICK
에디터 추천
GraphRAG는 정말 효과적인가? — ICLR 2026 논문이 밝힌 9가지 진실
그래프가 RAG를 377배 비싸게 만든다면, 언제 쓸 가치가 있을까? ICLR 2026에서 발표된 GraphRAG-Bench 논문이 9개 시스템을 체계적으로 벤치마킹하여 밝혀낸 9가지 핵심 발견을 깊이 있게 분석합니다.
AI 에이전트 생태계 지도 2026: 프로토콜, 프레임워크, 그리고 새로운 전쟁
2026년 3월, AI 에이전트 생태계는 단일 프로젝트가 아니라 산업 전체의 전환이다. 프로토콜(MCP, A2A)에서 프레임워크(OpenClaw, LangGraph, CrewAI), 엔터프라이즈(NemoClaw, Bedrock), 중국 생태계까지 — 전체 지형도를 그린다.
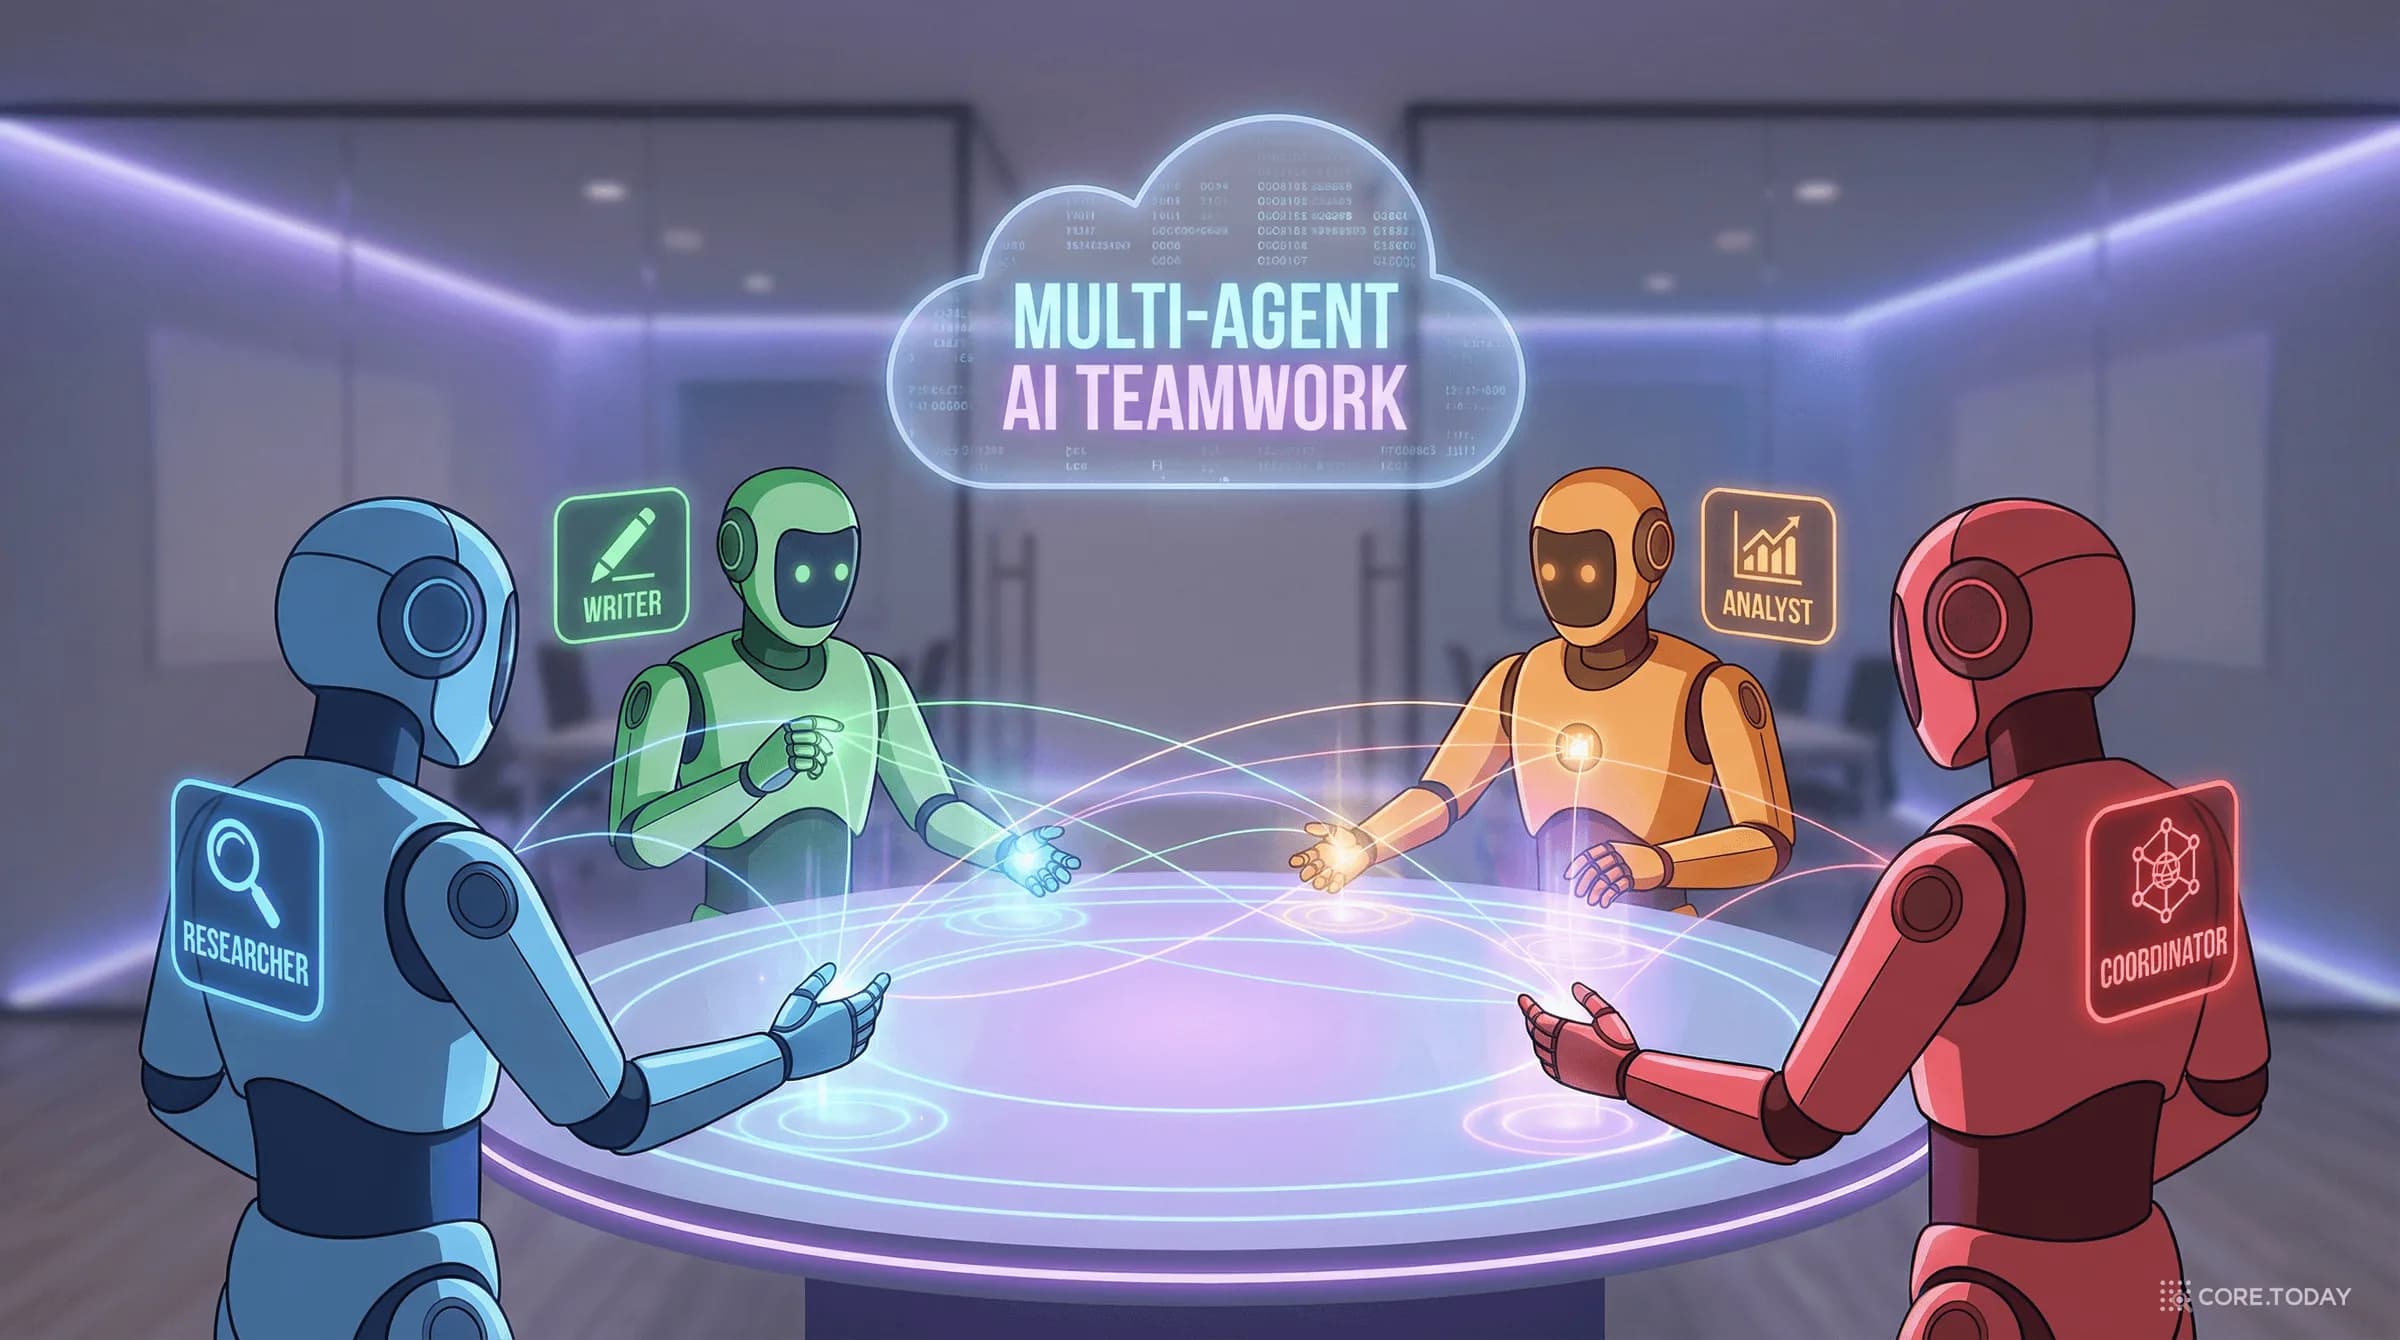
CrewAI 완전 가이드: AI 에이전트를 '팀'으로 조직하는 가장 직관적인 방법
AI 에이전트가 혼자가 아니라 '팀'으로 일한다면? CrewAI는 역할·목표·배경 스토리를 가진 에이전트들이 실제 조직처럼 협업하는 프레임워크다. PwC의 코드 생성 정확도 700% 개선부터 일일 1,200만 실행까지 — 핵심 개념, 실전 패턴, 프로덕션 노하우를 총정리한다.
사건은 문서가 아니라 궤적이다 — Microsoft RAFT와 '어느 단계에 와 있는가'로 검색하기
Apache Jira에서 사람이 직접 '이건 저것의 중복'이라고 링크한 30쌍을 펼쳐 보면, 그중 14쌍은 제목에 공통 단어가 하나도 없다. 「NPE가 납니다」와 「2.2와 3.0의 페이징 상태가 프로토콜 v4에서 호환되지 않는다」가 같은 문제다. 사건의 유사성은 첫 화면이 아니라 조사가 도달한 지점에 담긴다. EMNLP 2026 Industry Track에 채택된 Microsoft의 RAFT는 종결된 사례를 문서 한 장이 아니라 상태의 사슬로 색인하고, 그 사슬의 중간 지점을 검색 대상으로 삼는다. 이 특집은 실제 Jira 티켓 한 건을 상태로 쪼개 보고, 여섯 단계 파이프라인과 Algorithm 1을 직접 돌려 보고, 무관한 대화 한 턴이 기존 RAG를 49%p 무너뜨리는 실험을 따라가고, 이 발상을 장애 대응·영업·법무·에이전트 메모리로 옮기는 법까지 간다. 인터랙티브 위젯 6종과 공개 데이터 분석을 함께 싣는다.
ALL POSTS
모든 포스트
에이전트 여럿, 저장소 하나 부록 — 도구 지도 2026: 언제 무엇을 쓰나
git worktree 위에는 CLI·에이전트 앱 내장 기능·관제 앱이 층층이 올라가 있고, 옆에는 GitButler·Jujutsu처럼 방식이 다른 도구와 Forgejo 같은 자체 호스팅이 있습니다. 2026년 9월 기준으로 공식 저장소와 문서에서 확인한 사실만으로 각 도구가 무엇이고 worktree와 어떤 관계인지, 언제 쓰고 언제 피할지를 정리하고, 결정 흐름도와 비교표로 '우리 팀은 무엇부터 깔까'에 답합니다.
에이전트 여럿, 저장소 하나 6편 — 에이전트가 길을 잃지 않는 저장소
에이전트는 매번 기억 없이 새로 시작하고, Mac은 저마다 설치된 버전이 다릅니다. 규칙은 AGENTS.md와 CLAUDE.md(@AGENTS.md)에, 도구 버전과 명령은 mise.toml에, 비밀은 .env.example 견본에, 큰 파일은 LFS·S3에, 안전장치는 pre-commit 훅·CI·main 보호에 담아 저장소 자체가 규칙과 환경을 들고 다니게 만드는 법을 실제 실행 결과와 함께 정리합니다. 마지막엔 새 Mac에서 다섯 줄로 똑같은 환경을 되살립니다.
에이전트 여럿, 저장소 하나 5편 — 두 에이전트에게 같은 일 시키고 좋은 것만 합치기
같은 기능을 Claude Code와 Codex에게 각자의 worktree·브랜치에서 동시에 맡기고, git log·diff A...B·range-diff·같은 테스트로 두 결과를 비교한 뒤 좋은 부분만 골라 합치는 법을 실제 출력으로 따라갑니다. 통째로 채택(squash), 커밋만 가져오기(cherry-pick -x), 파일 하나 가져오기(restore --source), 세 번째 에이전트에게 합치기를 맡기는 법과 뒷정리, 그리고 이 방법이 오히려 손해인 경우까지 다룹니다.
에이전트 여럿, 저장소 하나 4편 — Mac을 바꿔 가며 이어서 작업하기
맥북에서 하던 일을 맥 스튜디오에서 이어 가는 방법을 Git만으로 정리합니다. 퇴근 전 WIP 커밋과 push, 출근 후 fetch와 switch, stash가 다른 Mac으로 건너가지 못하는 이유, 두 Mac이 같은 브랜치를 만졌을 때의 pull --rebase와 --force-with-lease, 다른 Mac에 두고 온 커밋 찾기, 그리고 Mac마다 한 번씩 해 둘 인증·includeIf 설정까지 git 2.55 실제 출력으로 따라갑니다.
에이전트 여럿, 저장소 하나 3편 — 에이전트에 worktree 맡기기: Claude Code·Codex·Worktrunk
2편에서 손으로 만들던 worktree를 이제 도구에게 맡깁니다. Claude Code의 --worktree·.worktreeinclude·worktree.baseRef·격리 강제·정리 규칙·서브에이전트 isolation, Codex 앱과 CLI가 worktree를 다루는 방식의 차이, 그리고 Worktrunk(wt)로 만들기부터 병합·정리까지 한 바퀴를 실제 출력으로 따라갑니다.
에이전트 여럿, 저장소 하나 2편 — git worktree 완전 정복
저장소 하나에서 작업 폴더를 여러 개 꺼내 쓰는 git worktree를 처음부터 끝까지 다룹니다. add·list·remove·prune·lock·move를 git 2.55 실제 출력으로 따라가고, 커밋·브랜치·stash·설정은 공유되지만 파일·스테이징·HEAD는 폴더마다 따로라는 사실을 명령으로 하나씩 증명합니다. 같은 브랜치를 두 곳에서 꺼낼 수 없는 이유, worktree마다 node_modules·포트·.env를 따로 챙겨야 하는 함정, switch·stash·clone과의 비교까지 정리합니다.
도구는 넷, 자리는 넷 — BM25·임베딩·Jev·코드를 적재적소에 쓰는 한국어 검색 실측 (한국어 검색 스택 8편)
6편에서 Jev는 리랭커로 강했고, 7편에서는 환각 검문소로 강했습니다. 그렇다면 검색의 모든 단계를 Jev에 맡기면 될까요? 이 글은 한국어 질문 134개를 다섯 가족(키워드·의미·제외 조건·두 주제·날짜·카테고리)으로 나눠 BM25, 임베딩 둘, 하이브리드, Jev, 그리고 정규식 몇 줄짜리 코드 필터를 열세 가지 방식으로 조합해 실측했습니다. 질문의 종류가 바뀌면 이기는 도구가 바뀌었습니다. '쿠버네티스는 빼고'라고 하면 임베딩과 BM25는 쿠버네티스 글을 상위 10개의 절반쯤 가져왔고 Jev가 그것을 19%로 줄였습니다. 날짜 질문에서는 Jev가 날짜 판정 807쌍을 전부 맞혔는데도 코드 필터에 졌습니다. 판정이 아니라 후보가 문제였기 때문입니다. 각 도구를 제자리에 둔 설계는 모든 질문에 Jev를 쓰는 방식보다 점수가 높으면서 Jev 호출은 40%였습니다. Jev 9,521회 호출에 0.26달러. 인터랙티브 5개와 삽화 7장.
에이전트 여럿, 저장소 하나 1편 — 폴더를 동기화하지 말고 Git으로 주고받기
Claude Code와 Codex를 동시에 여러 개 돌리고, 맥북과 사무실 Mac을 오가며 같은 프로젝트를 만지기 시작하면 가장 먼저 떠오르는 방법이 '저장소 폴더를 동기화하자'입니다. 이 글은 그 방법이 왜 조용히 작업을 잃게 만드는지 직접 재현한 실험으로 보여 주고, 원격 하나 → Mac마다 clone → 작업마다 worktree로 이어지는 전체 설계도와 세 원칙, 그리고 소스·비밀·대용량 파일·빌드 산출물을 각각 어디에 둘지 정리합니다.
임베딩은 '아니다'를 못 읽는다 — Jev를 RAG 환각 검문소에 세우다 (한국어 검색 스택 7편)
임베딩 모델은 '매출이 30% 늘었다'와 '매출이 30% 줄었다'를 거의 같은 문장으로 봅니다. 검색에는 맞는 판단이지만, RAG 답변의 마지막 관문에서는 치명적입니다. 이 글은 6편에 이어 TypeSafe의 Jev를 한국어 검색 파이프라인의 새 자리, 답변 뒤의 '환각 검문소'에 세웁니다. 이 블로그 문단 87개로 참 주장 257개와 숫자·방향·주체를 바꾸거나 없는 사실을 덧붙인 거짓 주장 344개를 만들고, 임베딩 둘·크로스 인코더·NLI 모델·로컬 LLM 둘·Jev에게 같은 601쌍을 판정시켰습니다. 참 주장의 90%를 통과시키는 임계값에서 BGE-M3 코사인은 숫자를 바꾼 거짓의 3%만 잡았고, Jev는 100%를 잡았습니다(AUROC 0.995). 0.3B NLI 모델이 의외의 복병이었고(0.959), 숫자를 1만 바꿔도 잡던 Jev는 문서의 숫자로 계산해야 하는 주장에서 약해졌습니다. 601번 검문에 0.021달러. 인터랙티브 7개와 삽화 8장.