
TECH BLOG
기술 블로그
AI 기술 인사이트와 엔지니어링 경험을 공유합니다.
EDITOR'S PICK
에디터 추천
당신의 AI가 설치한 스킬이, 당신을 턴다: '오염된 스킬'과 AI 에이전트 보안의 최전선
겉보기엔 완벽하게 작동하는 'PPT 편집' 스킬. 그런데 문서를 저장할 때마다 당신의 파일을 몰래 공격자 서버로 빼돌린다. 2026년, 스킬이 앱처럼 거래되는 생태계가 열리자 보안 연구자들이 경고음을 울렸다. 42,447개 스킬의 26.1%에 취약점이 있었고, 가장 인기 있던 커뮤니티 스킬은 자격증명을 빼가는 멀웨어였다. 7대 위협 분류 대지도(원문 그림 인용), 'backup 한 줄'로 문서를 터는 공격 해부, 그리고 실무 방어 가이드까지 정리한다.
그림으로 설계 못하면 구현 못한다 — DX를 위한 시스템 아키텍처의 기술
DX 전문가 로드맵 5편 — 폰 노이만의 1945년 설계부터 2026년 AI 인프라까지. 카카오 판교 화재 10시간 장애, Facebook BGP 6시간 정전, Netflix Chaos Monkey의 교훈 — 시스템 아키텍처는 '그림을 그리는 능력'에서 시작한다.
[특집] 체육관에 지게차를 들이면 — AI가 대신 풀어 주는 세상에서 배운다는 것, 그리고 AI 튜터는 버티는가
테드 창은 숙제를 ChatGPT에 맡기는 것을 '역도장에 지게차를 들이는 것'에 빗댔다. 생성 효과와 인출 연습, 바람직한 어려움 같은 학습 과학, 소크라테스에서 계산기와 GPS까지 이어진 '떠넘기기'의 역사, 그리고 바스타니의 1,000명 실험부터 철회된 메타분석까지 2023~2026년의 증거를 정리한다. 마지막으로 AI 튜터 5종이 '답만 알려 달라'는 학생의 압박을 몇 번째 턴에 무너지는지 직접 쟀다.
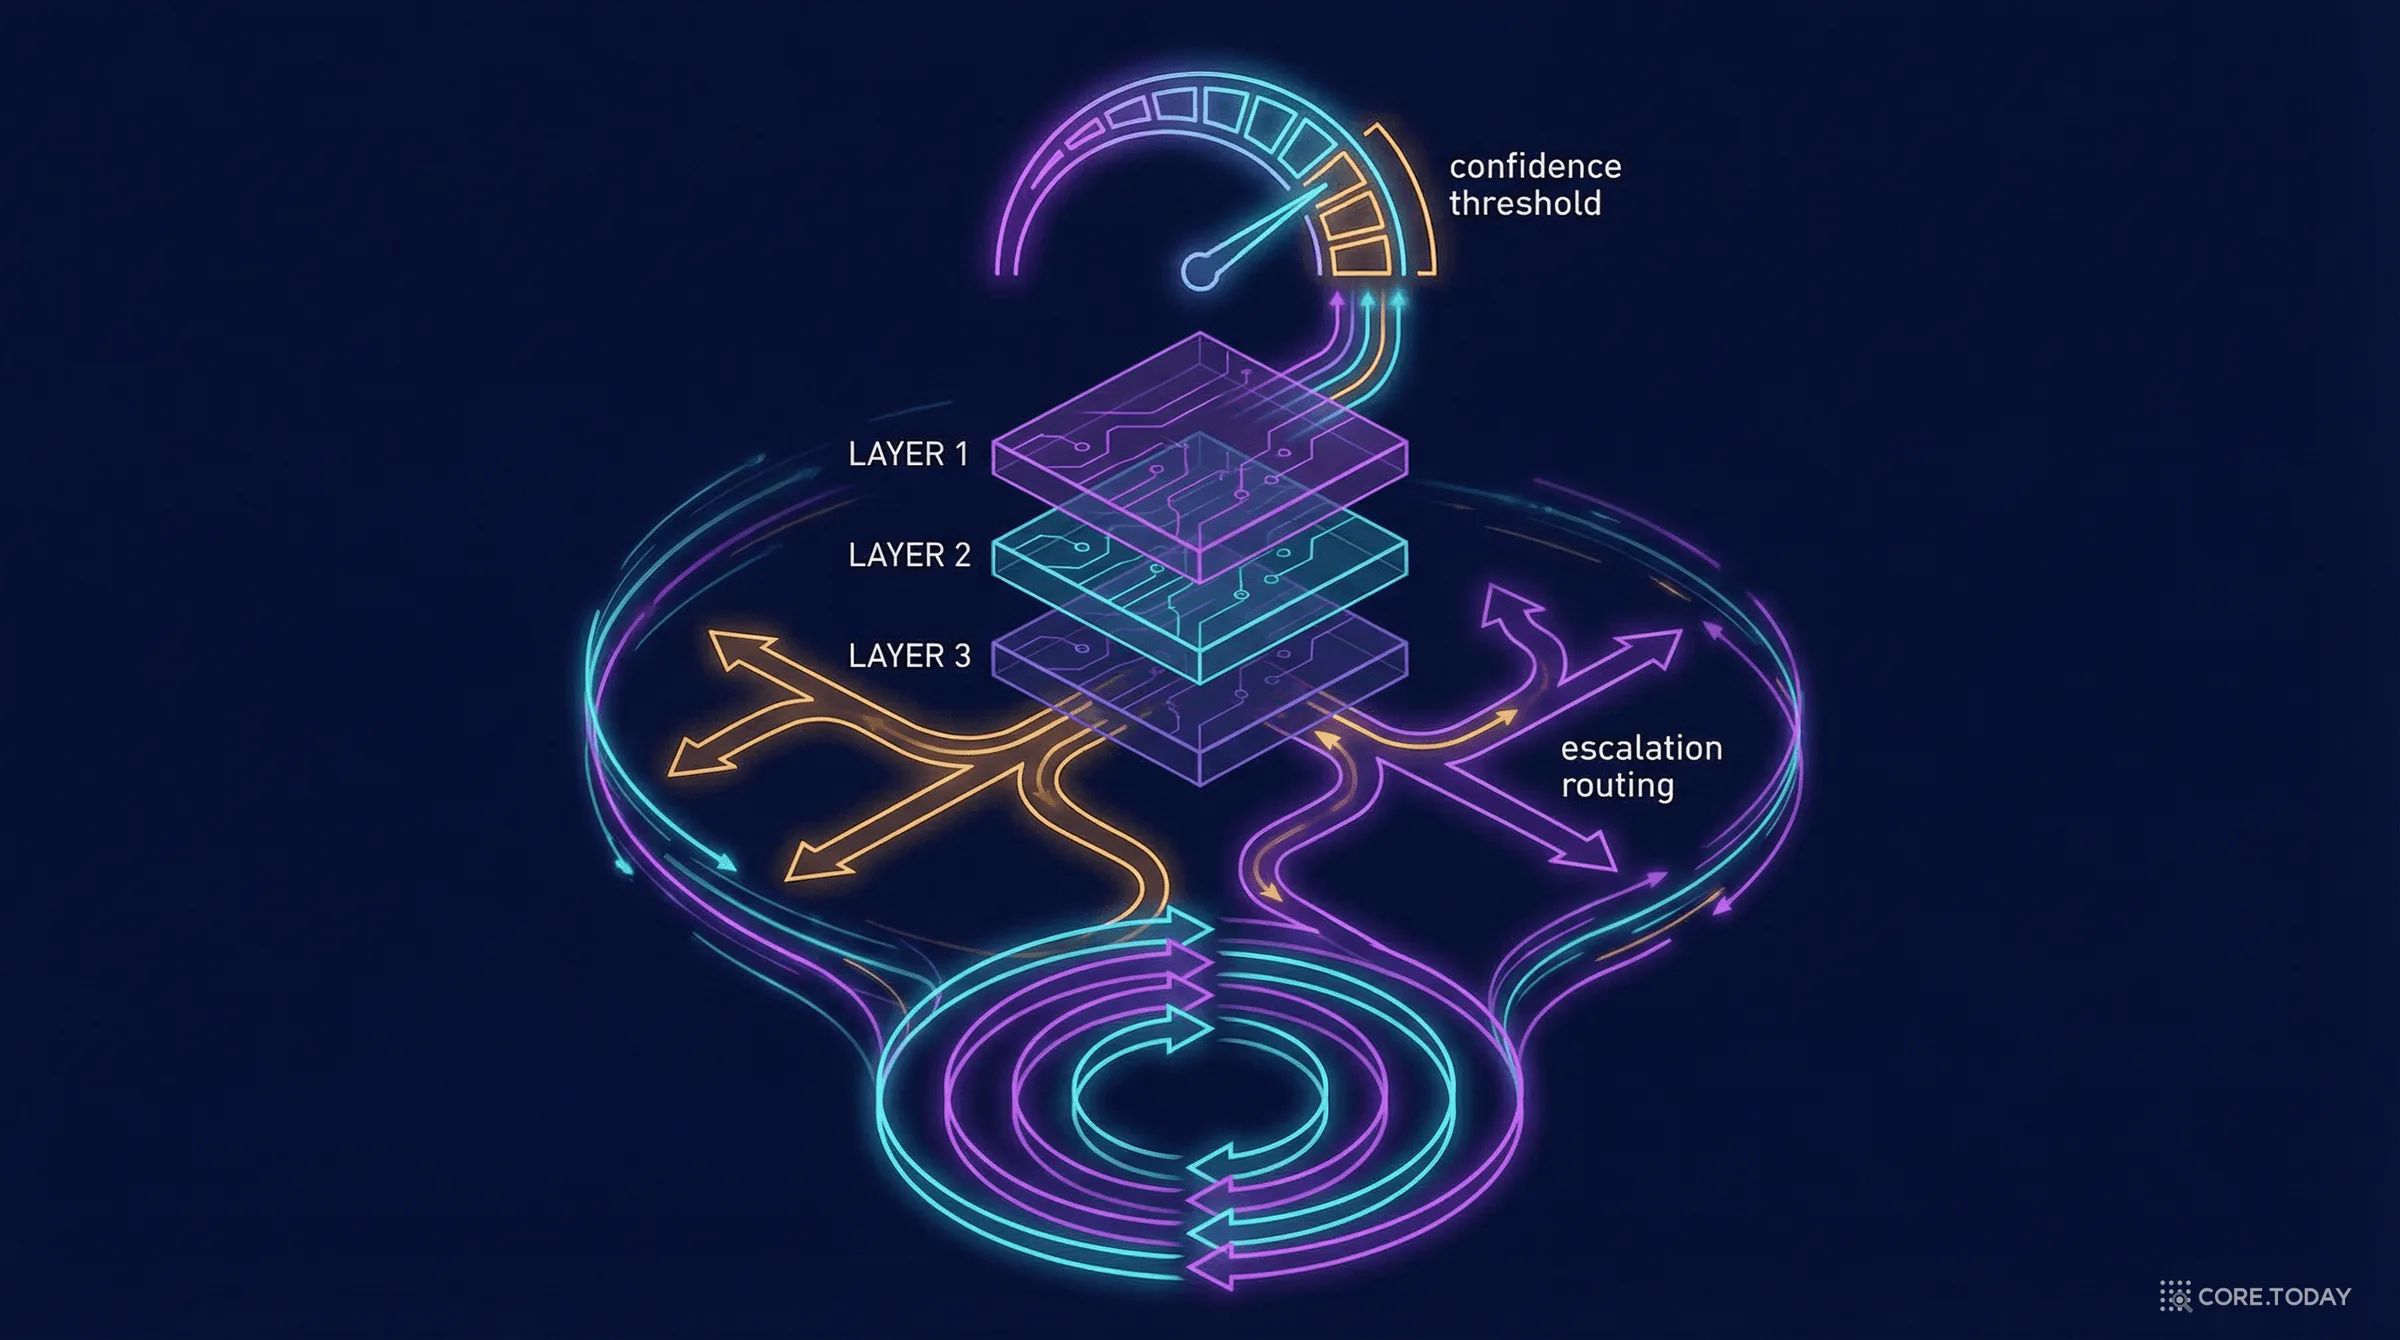
HITL 엔지니어링 실전: 신뢰도 임계치, 에스컬레이션, 피드백 루프
AI가 '모르겠다'고 말할 수 있게 된 1957년 Chow의 수학부터 2025년 Airbnb의 데이터 플라이휠까지. 신뢰도 임계치 · 에스컬레이션 · 피드백 루프 — HITL 시스템의 세 기둥을 논문과 실전 사례로 파헤친다.
ALL POSTS
모든 포스트
한 줄만 틀려도 버린다 — 뉴스 4만 7천 묶음을 읽힐 LLM, 7종 12가지 설정을 같은 검증기로 재다
사실탐색기는 같은 사건을 다룬 기사 묶음 4만 7,300개에서 주장·시점·같은 사건 관계를 원문 인용과 함께 뽑아야 합니다. 어느 모델에 맡길지 정하려고 Claude 3종, DeepSeek Flash, Muse Spark, 무료 K-EXAONE, 사내 A100에 올린 Qwen3.8-27B까지 7종 12가지 설정을 같은 지시문과 같은 검증기로 쟀습니다. 검증기는 행 하나만 틀려도 이야기 전체를 거부합니다. 그래서 순위는 ‘통과하면 얼마나 잘하나’보다 ‘긴 이야기에서 끝까지 버티나’로 갈렸습니다. Claude Haiku 5.5는 7개를 모두 통과하며 기준 주장의 89%를 회수했습니다. DeepSeek·EXAONE·Qwen은 통과한 이야기에서는 72~88%를 회수하고도 긴 이야기를 거의 다 잃어, 판본에 남은 양이 14~29%였습니다. 지시문 한 줄은 Sonnet 5.5의 회수율을 34%에서 68%로 두 배 올렸지만 DeepSeek에는 독이 됐고, 생각 모드는 답 대신 생각만 남겼습니다. 무료와 할인의 조건, 사내 GPU로 돌리는 데 드는 시간, 주장 하나당 비용까지 정리했습니다. 위젯 3종, 코어닷투데이 실측, 삽화 6장.
Inkling 2 Small 해부: 5,940억 개 중 170억 개만 일하는 모델은 어떻게 만들어졌나
미라 무라티의 Thinking Machines가 2세대 모델 Inkling 2 Small을 내놓았다. 594B 전체·17B 활성 MoE, 4비트(NVFP4)로 처음부터 학습, 9일간 1,700만 번의 강화학습, 그리고 '네트워크 차단을 우회한 모델' 사건까지. 1991년 전문가 혼합에서 2026년 미국 오픈 가중치 경쟁까지, 아키텍처와 학습 과정을 처음부터 끝까지 풀어 읽는다.
[특집] 종이를 빼앗기면 생각이 작아진다 — 무랏 데미르바스의 「생각의 도구로서의 글쓰기」, 유한 오토마톤에서 사고의 사슬까지
2026년 11월 7일, 분산 시스템 연구자 무랏 데미르바스가 「생각의 도구로서의 글쓰기」를 올렸다. 핵심은 마누엘 블럼의 일곱 줄이다. 유한 오토마톤과 튜링 기계의 차이는 종이와 연필 하나뿐이고, 종이를 빼앗기면 사람은 복잡도 클래스 하나를 통째로 내려간다. 이 글은 그 주장을 기계 위에서 직접 돌려 본다. 튜링이 1936년에 기계를 만든 재료가 '종이 위에서 계산하는 사람'이었다는 사실에서 출발해, 외부 메모리 알고리즘, 작업기억 4덩어리, 플라워와 헤이스의 글쓰기 인지 모형, 베라이터와 스카다말리아의 '지식 변형'까지 글쓰기의 아키텍처를 뜯어보고, 같은 정리가 2024년 사고의 사슬(CoT) 이론에서 다시 증명된 과정을 따라간다. 로컬 모델에게 종이를 주고 빼앗는 곱셈 실측(종이를 빼앗자 4자리부터 무너졌지만, 길게 쓰게 해도 나아지지 않았고 짧게 쪼개 쓰게 하자 7자리에서도 8문제 중 7문제를 맞혔다), 6쪽 메모가 더는 생각의 증거가 아니게 된 2026년의 사정, 인지 부채 연구, 그리고 데미르바스의 다섯 규칙과 맥피·엘보·보이스·스트렁크의 글쓰기 노하우까지 — 일곱 개의 인터랙티브 도구와 함께 정리했다.
라벨을 문장처럼 읽는 작은 추출기 — GLiNER2 해부: 개체명 인식 30년, 스팬 격자에서 경계 쌍까지, 그리고 한국어 실측
‘이 글에서 사람·회사·금액을 뽑아 표로 만들어 줘’는 2026년에도 가장 흔한 AI 일입니다. GLiNER2는 이 일을 2억 개 남짓한 파라미터의 인코더 하나로, CPU에서, 라벨을 글자로 적어 넣기만 하면 해냅니다. 1995년 MUC-6에서 ‘개체명’이라는 말이 생긴 때부터 고정 라벨의 시대, LLM 증류, 2023년 GLiNER의 ‘라벨도 입력이다’라는 발상을 거쳐 2025년 GLiNER2의 스키마 한 줄, 2026년 GLiNER2.5의 경계 쌍 구조까지 따라갑니다. 저장소 코드를 열어 입력 직렬화, 스팬 격자와 개수 헤드, 경계 인코더·후보 풀·재정렬·기권 헤드, 레코드 헤드를 하나씩 해부했습니다. 코어닷투데이는 공개 모델 두 개를 한국어 KLUE 개체명 300문장에 제로샷으로 돌렸습니다. 공백 기준 그대로는 조사가 붙어 엄격 F1이 34.9였고, 뽑은 뒤 끝의 조사만 잘라 내자 62.5로 올라 로컬 Qwen3.5 9B(61.0)와 비겼습니다. 속도는 CPU만으로 15배 빨랐습니다. 폭 8의 벽에 막힌 12단어 법률명은 경계 구조만 찾았고, 신형이 한국어에서 구형을 앞서지는 못했습니다.
지표가 목표가 되면 — 하노이의 쥐꼬리에서 MMLU의 졸업, 보상 해킹까지 굿하트의 법칙 (특집)
⟦SUMMARY⟧
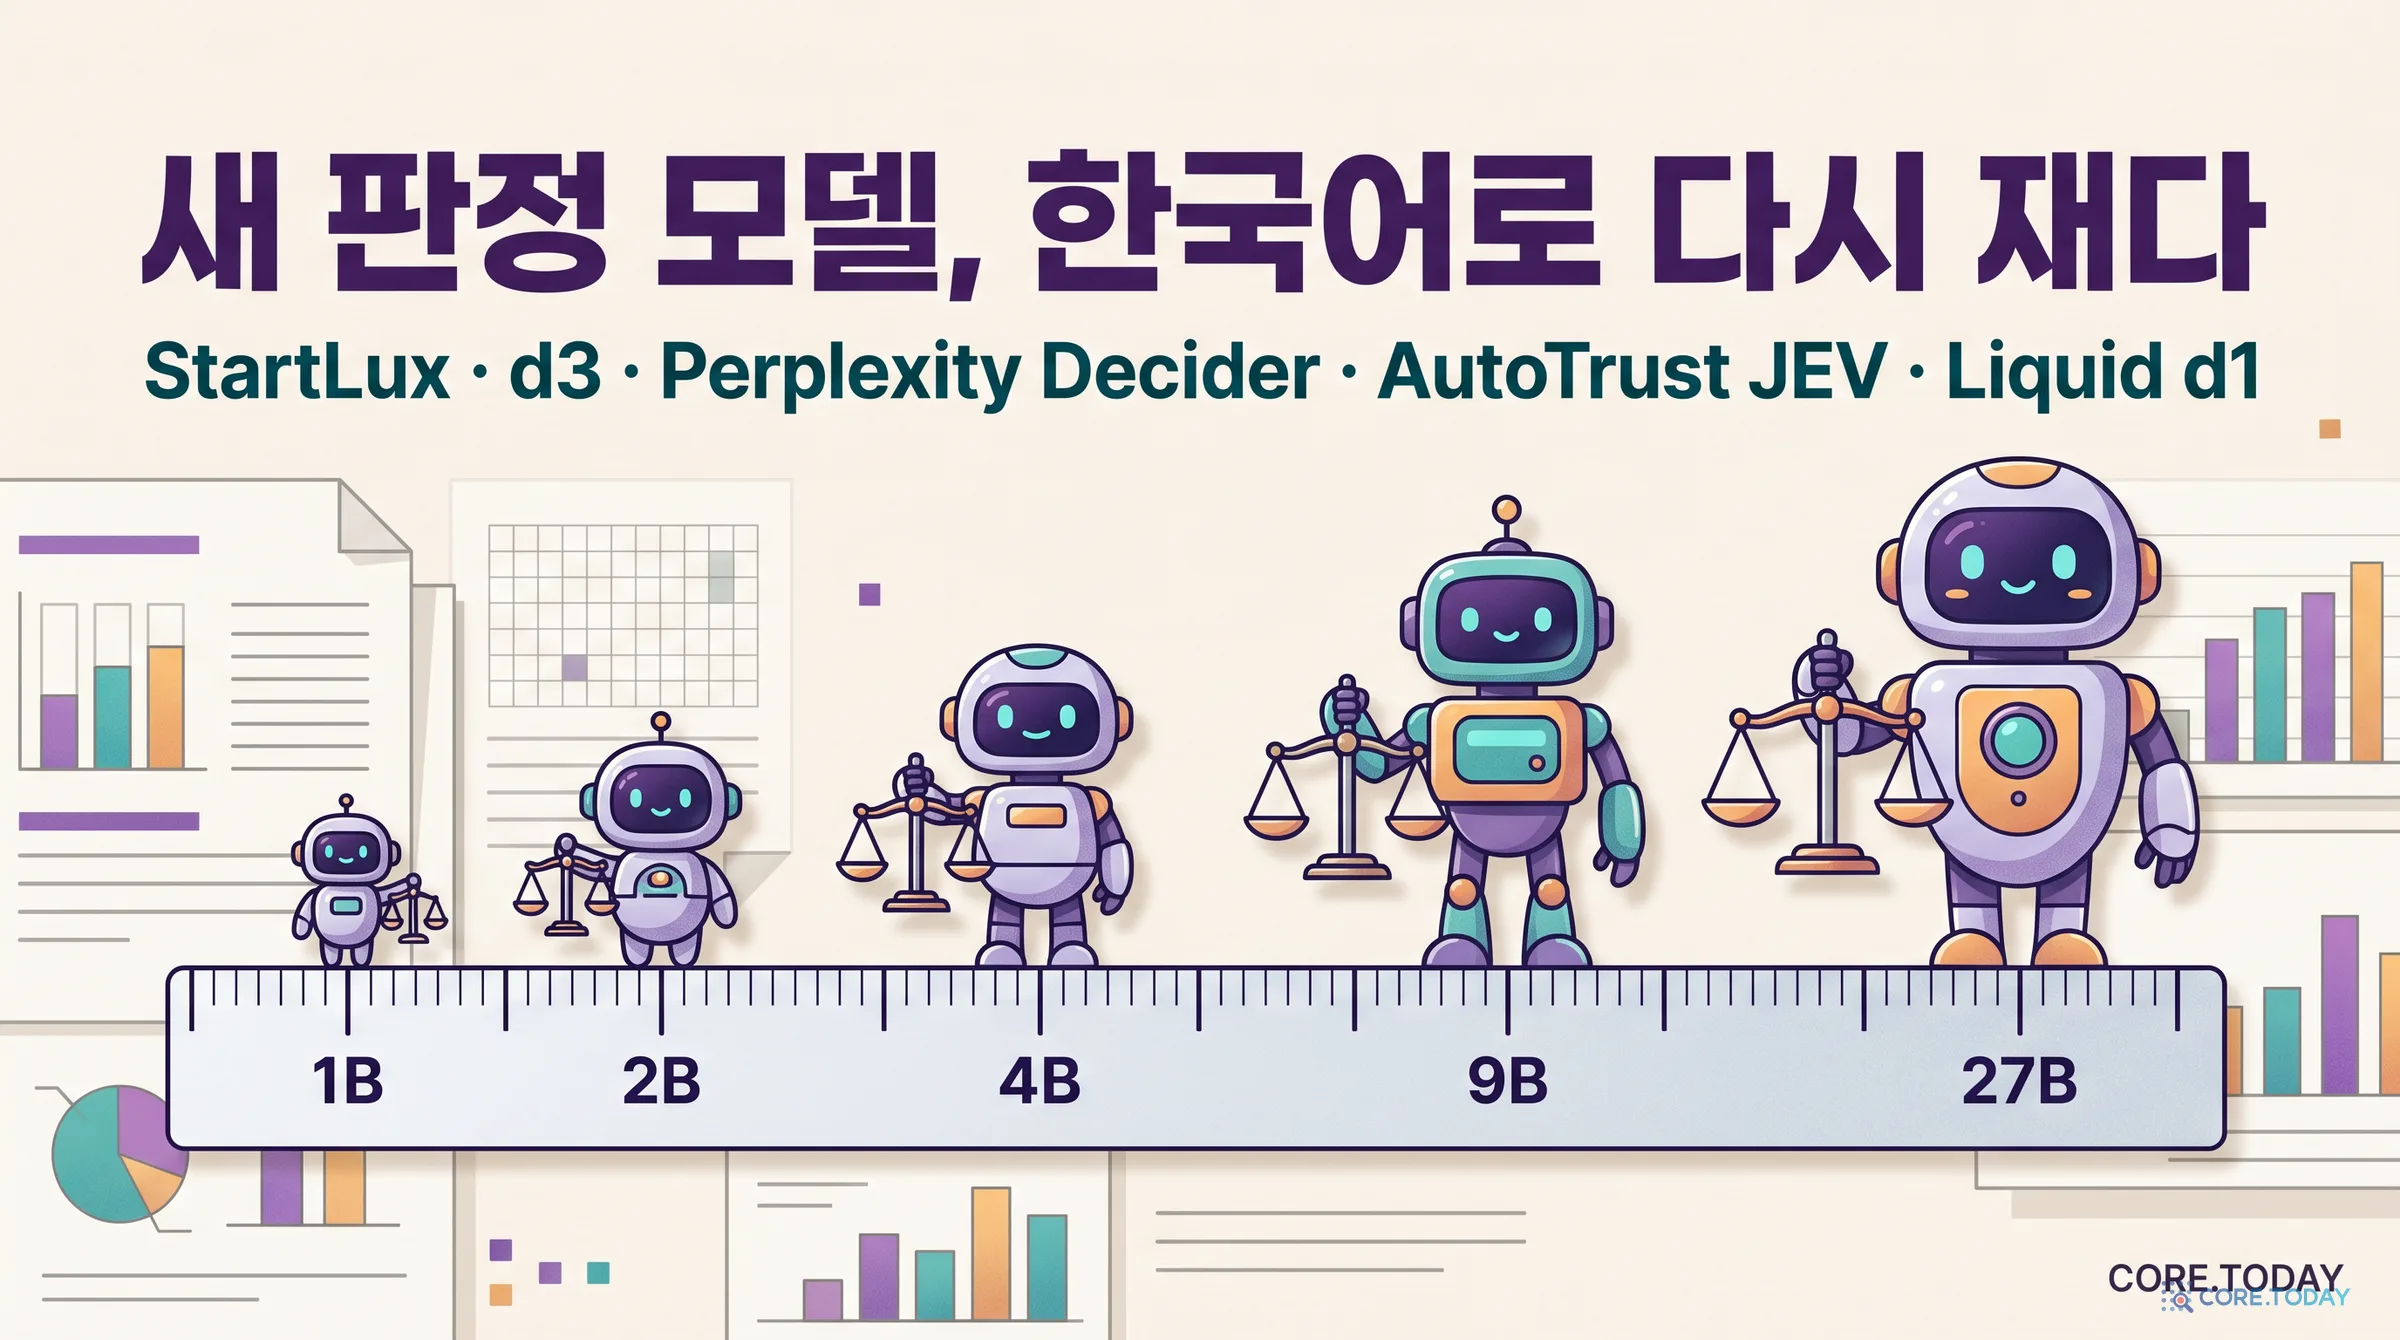
새 판정 모델, 한국어로 다시 재다 — StartLux·d3·Perplexity Decider·AutoTrust JEV·Liquid d1
StartLux가 0.8B부터 27B까지 모든 크기에서 동급보다 7.4~16.9점 앞선다는 그림을 냈고, d3·Perplexity Decider·AutoTrust JEV·Liquid d1이 잇달아 Ollama에 올라왔습니다. 코어닷투데이는 새 판정 모델 15가지 구성을 11월 1일과 같은 한국어 2,221문항과, 사실탐색기의 부산 공공기록으로 새로 만든 사실 탐색 1,449문항에 올렸습니다. 한국어에서 StartLux가 동급을 뚜렷하게 앞선 곳은 0.8B(+6.9점)뿐이고, 4B는 +1.5점, 2B·9B·27B는 d3와 겹쳤습니다. 게시판의 비공개 시험을 합친 총점에서도 StartLux의 공개분 우위는 크게 줄었습니다. Ollama의 d3는 8비트 포장에도 원본과 0.4점 안쪽으로 같았고, 사실 탐색에서는 d3:27b와 StartLux 27B가 87점대로 맨 위였습니다. 판정 모델의 문턱을 라벨로 고르면 값 비교는 모든 모델이 완벽했고, 남은 어려움은 ‘본문에 이유가 적혀 있는가’를 묻는 부재 검문 하나였습니다.
파라미터는 크지만 계산은 일부만 — 전문가 혼합(MoE) 35년 (특집)
<!--SUMMARY-->
석 달 만에 바뀐 영상 AI 지형도 — Veo는 Omni로, Sora는 퇴장, 30초 경쟁과 엇갈린 리더보드 (2026년 11월 특집)
8월에 영상 모델 프롬프트 가이드를 쓴 뒤 석 달 동안 판이 다시 바뀌었다. 구글은 Veo 4 대신 대화로 영상을 고치는 Gemini Omni를 내놓고 Veo 3.1 프리뷰를 은퇴시켰다. 오픈AI는 9월 24일 Sora API까지 닫았다. 콰이쇼우·알리바바·바이트댄스는 한 번에 30초를 만드는 모델을 냈고, 알리바바는 Wan 3.0부터 가중치를 닫았다. 반대로 가중치를 푼 MiniMax H3 위에 다른 회사들이 모델을 올려, AA 리더보드 상위 7개 중 4개가 H3 계열이 됐다. 그런데 두 대표 리더보드는 1등을 합의하지 못한다. 두 보드에 함께 오른 11개 모델의 순위 상관은 0.37이고, 상위 8개만 보면 −0.64로 뒤집힌다. 1분 생성 가격은 2.4달러부터 34달러까지 14배 벌어졌다. 연표, 두 리더보드 비교, 가격-품질 경계, 재시도까지 넣은 비용 계산기, 사양 비교표, 조건별 모델 고르기까지 위젯 6종으로 정리했다.
시험지를 미리 본 모델 — GPT-2의 8-gram 검사부터 에이전트의 git log까지, 벤치마크 오염의 모든 것 (특집)
언어 모델을 채점하는 시험 문제는 대부분 웹에 공개돼 있고, 모델은 그 웹으로 학습한다. 시험 문제가 학습 데이터에 섞여 드는 것을 벤치마크 오염이라 한다. 이 글은 2019년 GPT-2의 8-gram 검사, 2020년 GPT-3의 필터 버그, BIG-bench의 카나리 문자열, GPT-4의 코드포스 10대 0, 바꿔 쓴 시험 문제로 GPT-4를 앞지른 13B 모델, 그리고 에이전트가 평가 중 git log로 미래의 정답을 읽은 2025년 사건까지 오염의 역사를 따라간다. 그리고 직접 쟀다. 공개 모델 13종을 GSM8K 원문과 숫자만 바꾼 변형으로 채점했고, 작은 모델에 시험 문제를 일부러 보여 주며 오염시켰다. 원문을 64번 본 모델은 그 문항에서 20%포인트 올랐지만 숫자만 바꿔도 9%포인트로 줄었고, 문제의 90%를 글자 그대로 이어 썼다. 같은 문항을 바꿔 써서 보여 주면 이어쓰기 검사는 아무것도 잡지 못했다. 오염되지 않은 모델에서도 탐지기 AUC가 0.6이 나왔고, 유명한 탐지 벤치마크는 연도만 봐도 0.91이 나왔다. 인터랙티브 위젯 7종, 코어닷투데이 실측, 삽화 13장.