
AI 에이전트
19개의 포스트
[특집] 영수증 있는 기억 — SodaMem으로 읽는 AI 에이전트의 '지금 참인 것': 출처·시간·대체, 그리고 92.8%의 뒷면
AI 비서가 '매운 음식 좋아하시죠?'라며 위염 환자에게 마라탕을 권한다면, 기억을 못 해서가 아니라 무엇이 지금 참인지 몰라서입니다. 2026년 8월 공개된 SodaMem은 대화에서 뽑은 사실마다 원문 영수증(출처 조각)을 붙이고, 네 개의 시계로 시간을 적고, 바뀐 사실은 지우지 않고 닫습니다. 그래프·BM25·임베딩 세 터널에서 함께 걸린 증거를 위로 올리고, 플래너가 모은 증거로 리더가 인용을 달아 답합니다. LongMemEval-S에서 92.8%, 문항당 0.16센트라는 숫자도 냈습니다. 바틀릿의 재구성 기억과 파치올리의 장부에서 시작해 이중 시간 데이터베이스, 진리 유지 시스템, BM25와 RRF, MemGPT·Mem0·Zep으로 이어지는 계보를 따라가며 논문의 개념을 하나씩 풀었습니다. 코어닷투데이는 공개된 답안 500개를 다른 모델로 다시 채점했고(88.6%, 직접 판정하면 약 90%), 같은 검색 결과를 작은 모델에 읽혔고, 코드를 열어 논문과 다른 세 곳을 찾았습니다. 92.8%를 낸 저장소는 대체를 '관찰만' 하는 모드였고, 공개 코드의 BM25는 한글을 한 글자도 토큰으로 만들지 못합니다. 작은 모델로 같은 시나리오를 넣어 보니 옛 주소는 닫히지 않았고, 영어 대화에서는 위염 환자에게 매운 김치찌개를 권했습니다. 인터랙티브 7개.
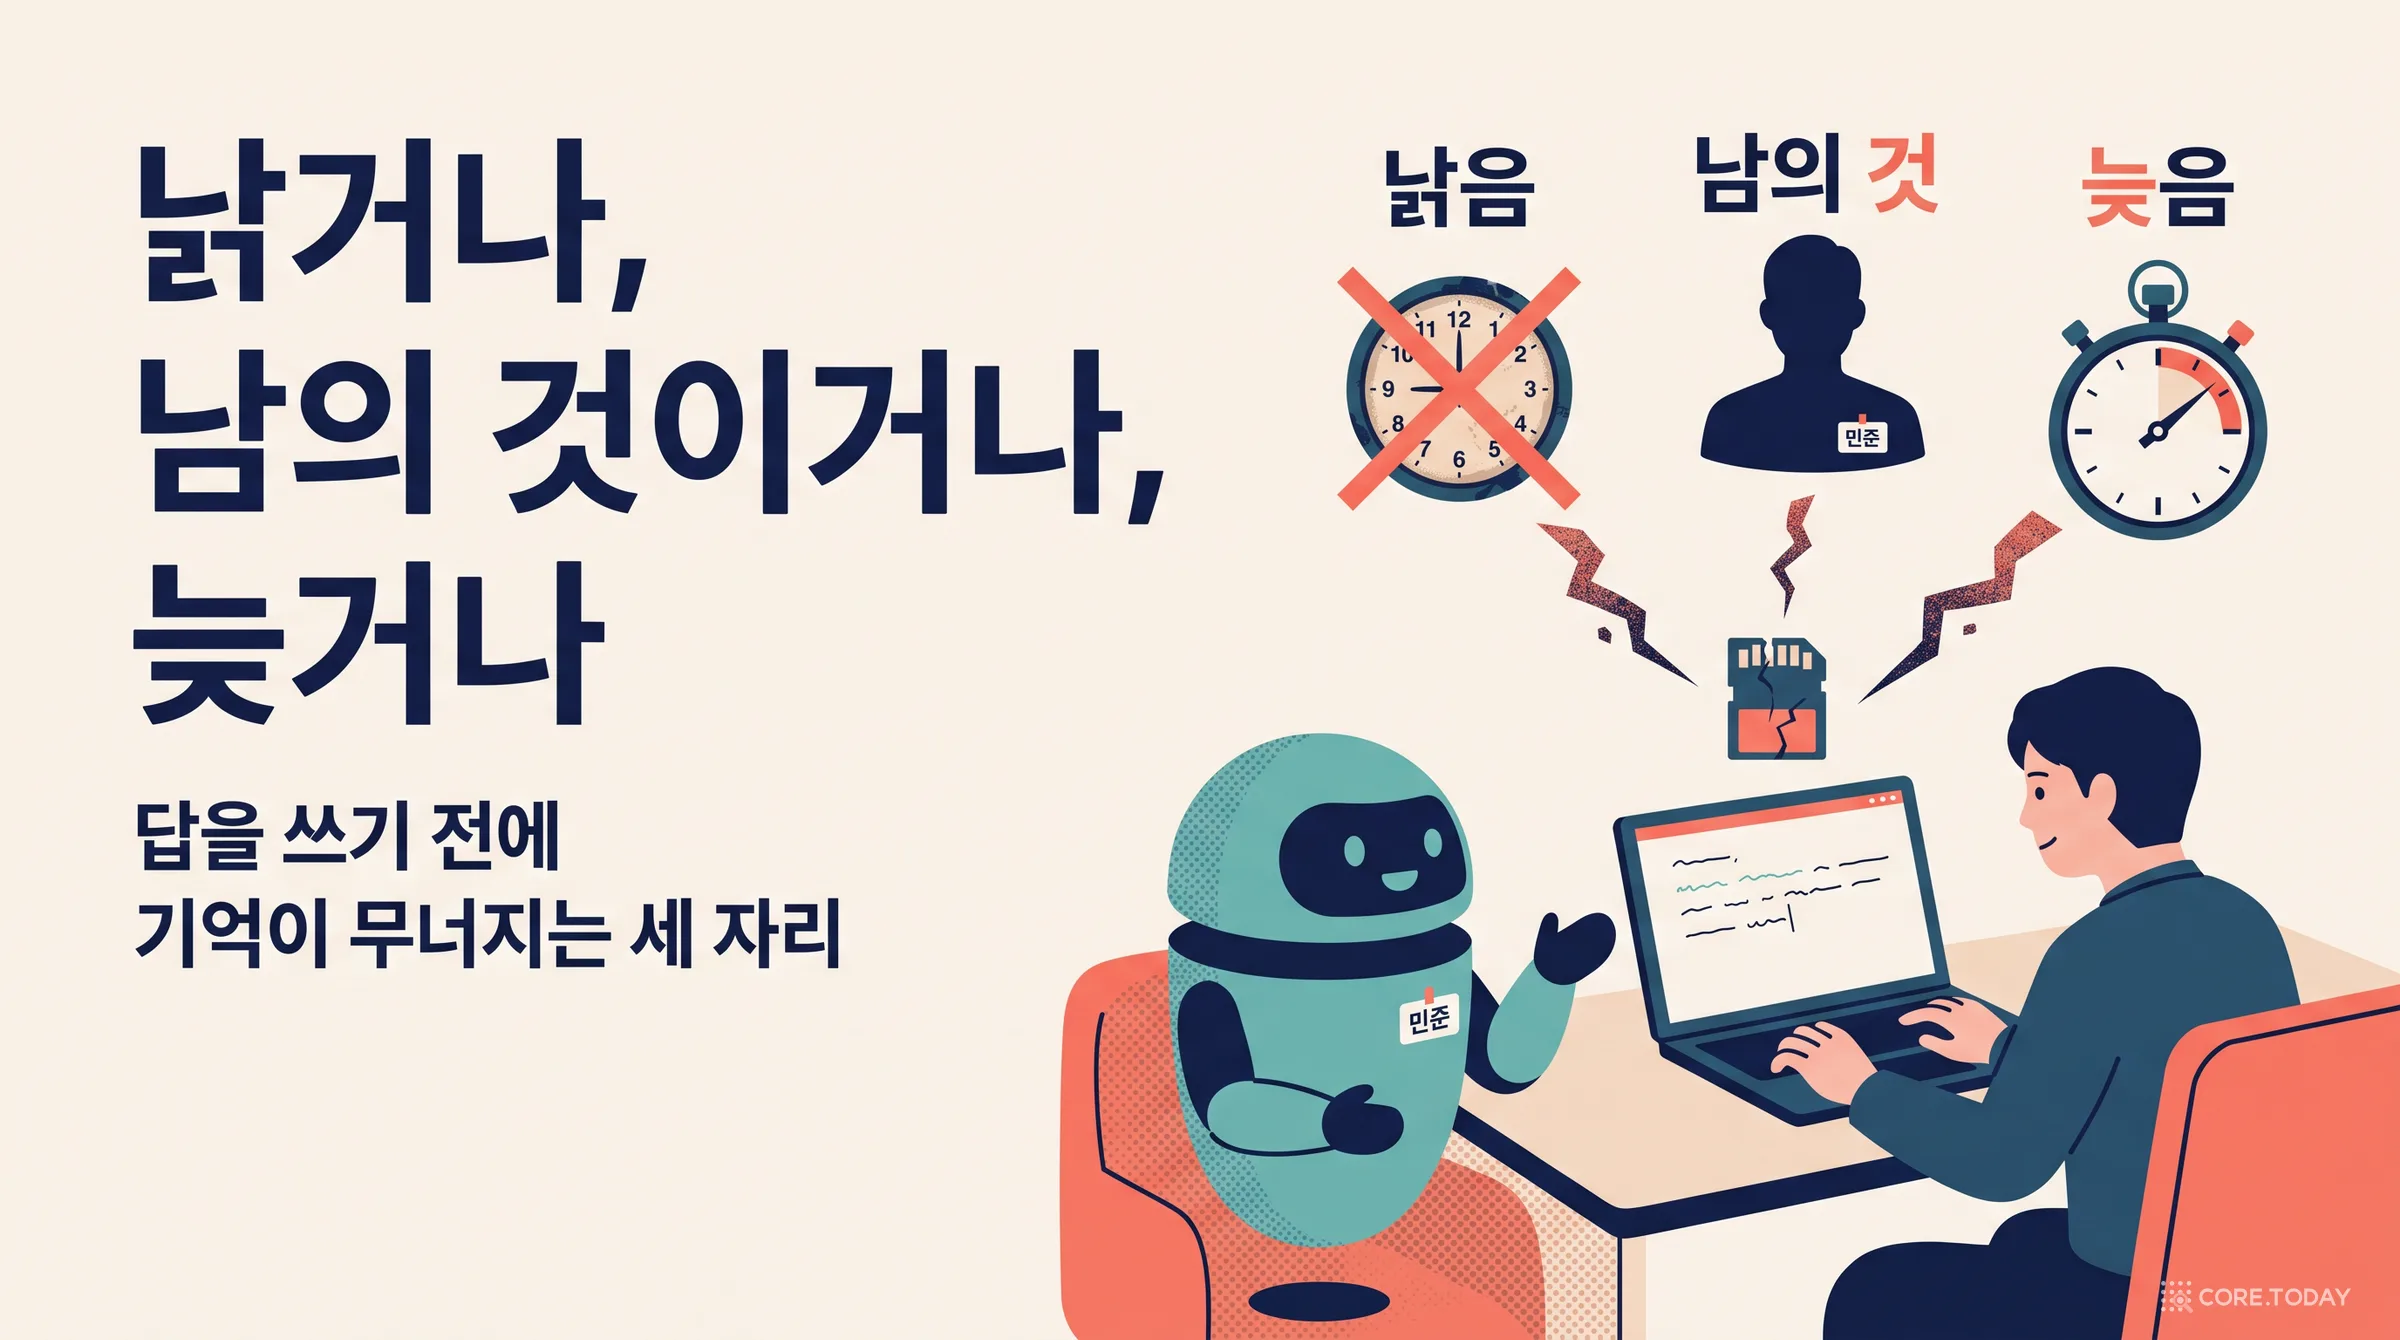
[특집] 낡거나, 남의 것이거나, 늦거나 — AI 비서의 기억은 답을 쓰기 전에 무너진다
AI 비서의 기억은 보통 최종 답이 맞았는지로 채점한다. UC 버클리 연구진의 2026년 10월 논문 「Stale, Misattributed, or Late」는 채점 지점을 한 칸 앞으로 당겨, 모델에 들어가기 직전의 '기억 블록'이 낡은 값을 담았는지, 같은 이름의 다른 사람 값을 담았는지, 답이 없는데 무언가를 채웠는지, 프리필 전에 도착했는지를 따로 센다. 결론은 단순하다. 낡음은 검색이 아니라 쓰기의 문제이고, 진짜 어려운 일은 개정을 올바른 칸에 묶는 '키 붙이기'이며, 동명이인·기권·지연은 각각 다른 정보가 필요하다. 1959년 레코드 연결과 1985년 '유효 시간 대 기록 시간'에서 시작해 BM25·RCU·John Smith 문제를 거쳐 2026년 기억 제품까지 계보를 따라가고, 표와 그림을 하나씩 읽는다. 같은 실험을 한국어로 다시 만들어 로컬 Qwen 모델로 돌려 봤더니 저장소 구조에서 나오는 결과는 대부분 재현됐고, 'LLM 키 할당기가 규칙보다 나쁘다'는 모델 의존적인 결과는 재현되지 않았다.
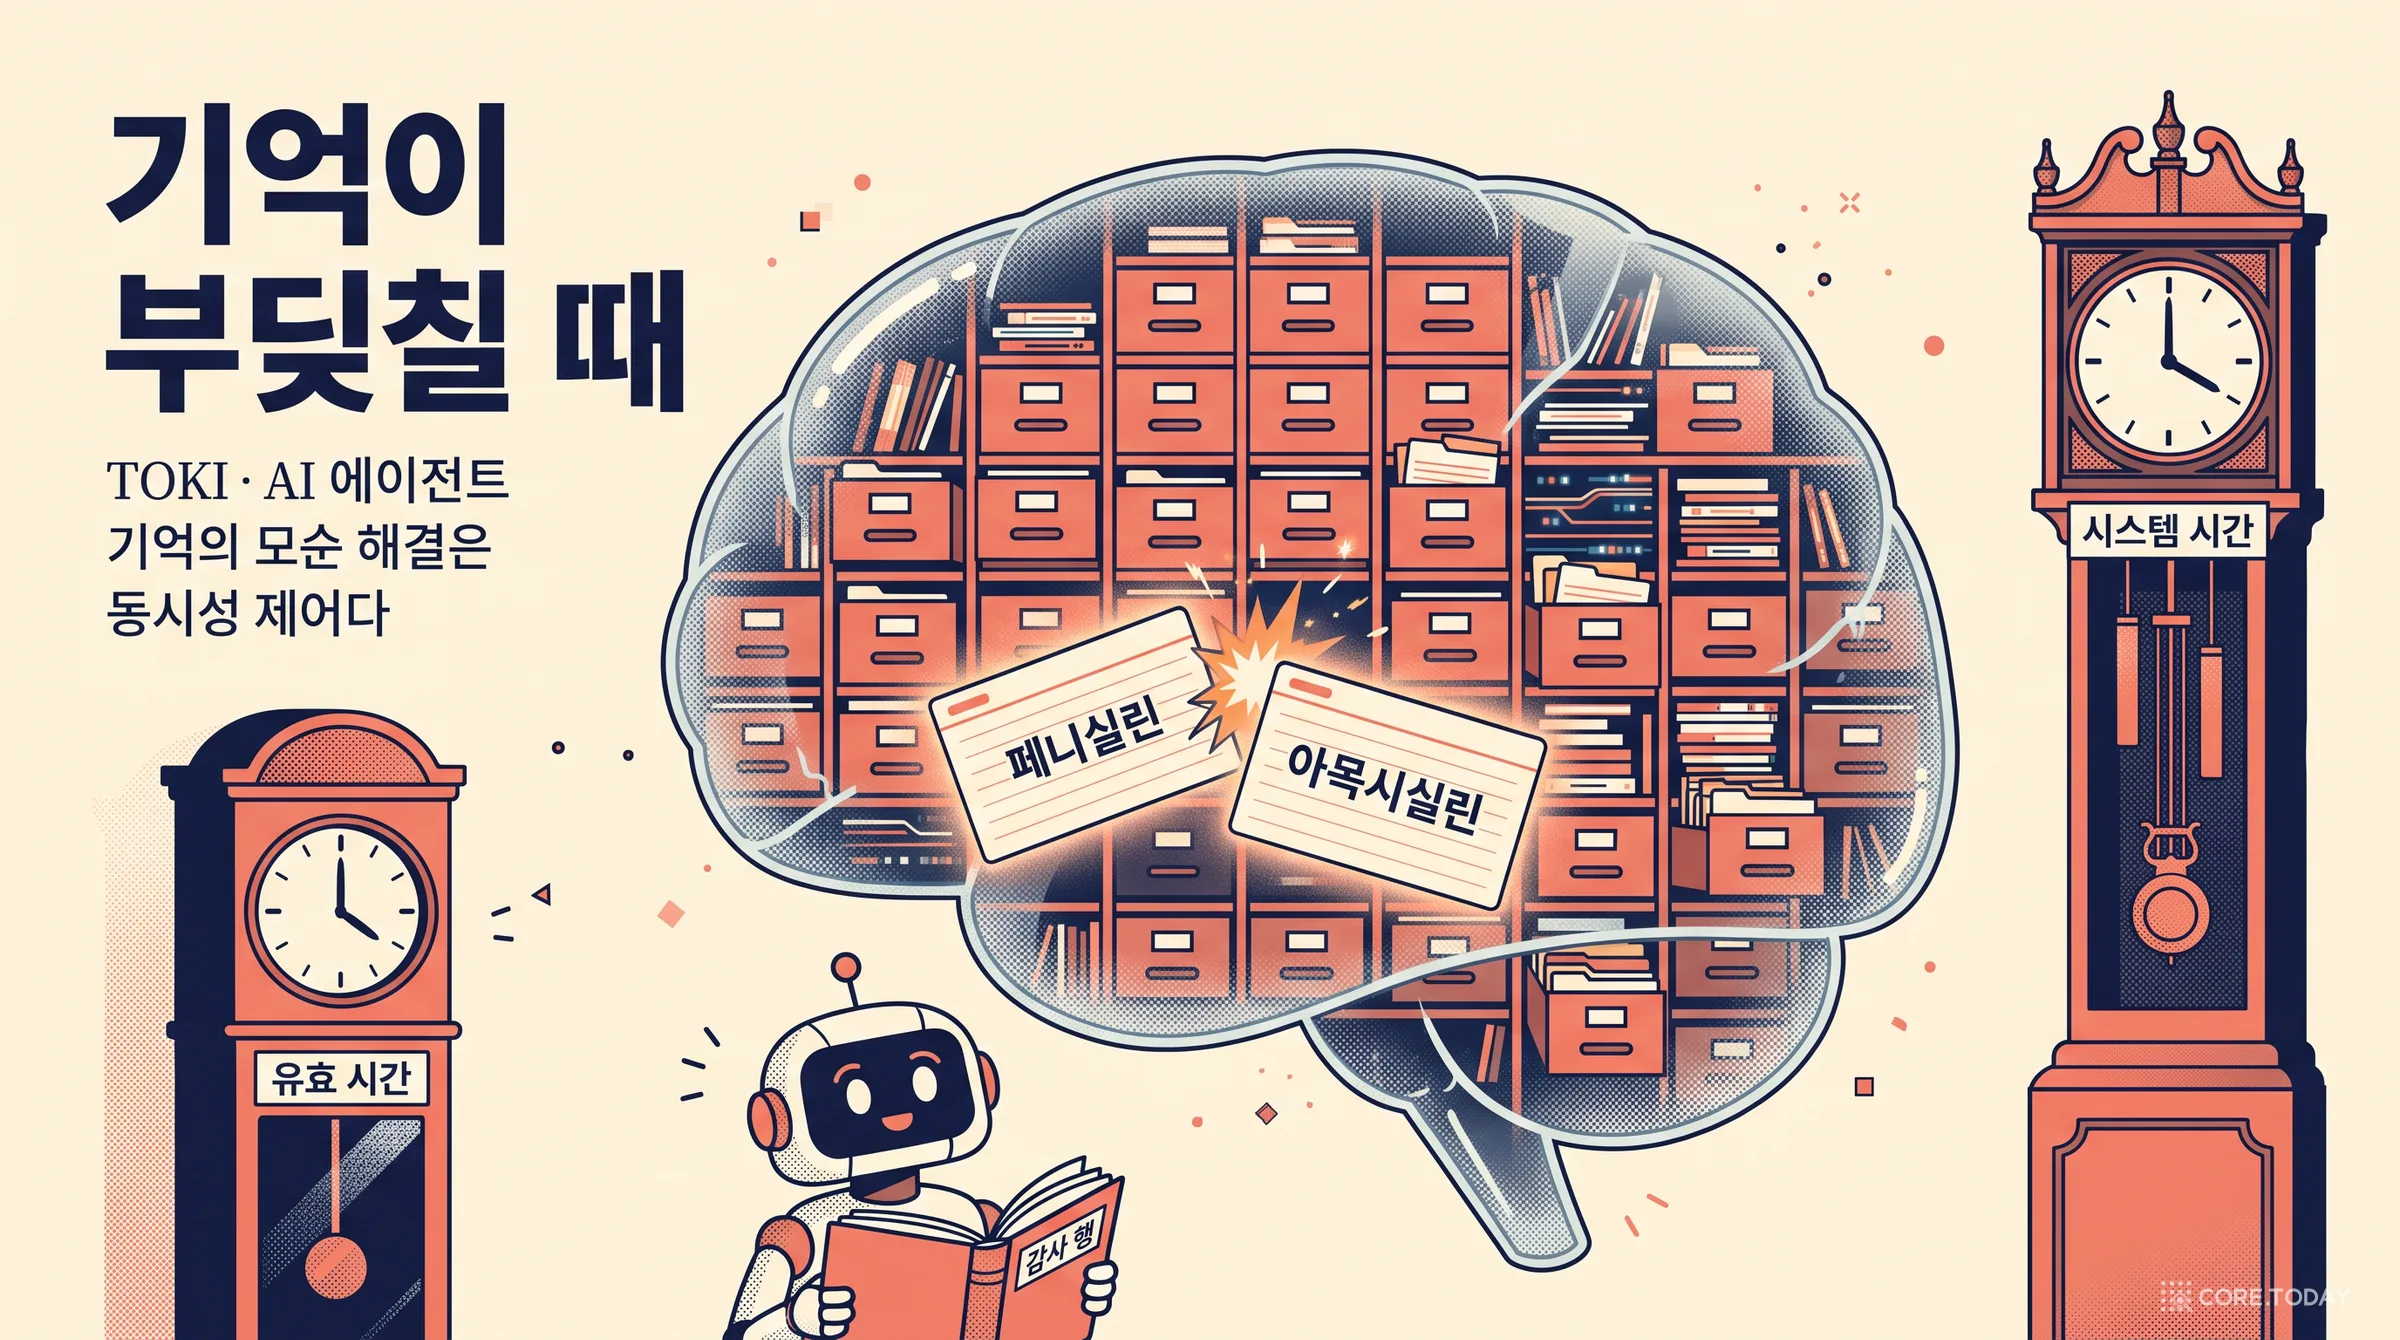
기억이 부딪칠 때 — AI 에이전트 기억의 모순 해결은 왜 '동시성 제어'인가, TOKI 논문 완전 해설
에이전트의 기억에 '담당자는 박 과장'과 '담당자는 이 대리'가 함께 들어오면 누가 이기나. 홍콩과기대의 TOKI 논문(arXiv 2606.06240)은 이 질문이 사실 50년 된 데이터베이스 문제, 즉 동시성 제어라고 말한다. 최신 우선·증거 가중·확인 대기·규칙 정책이라는 네 가지 생산 전략을 격리 수준이 붙은 연산자로 다시 쓰고, 진 사실을 지우지 않는 '감사 행'과 LLM 판정을 키로 기록하는 '판정 로그'로 세 가지 새 이상(판정 재현 불일치·믿음 표류 스큐·감사 소거)을 막는다. 이중 시간 데이터베이스, 베렌슨의 격리 수준 비판, 출처 반가환이라는 세 뿌리부터 정리 다섯 개의 쉬운 풀이, 여덟 시스템 판정표의 칸별 무게까지 읽었다. PostgreSQL 17에서 두 에이전트의 동시 쓰기를 격리 수준별로 50번씩 돌리고, 로컬 4B 모델을 판정자로 같은 모순을 반복해 물어 판정이 얼마나 뒤집히는지 직접 쟀다 — 온도 0에서도 두 기록의 제시 순서만 바꾸면 36쌍 중 13쌍에서 승자가 바뀌었다. 논문이 밝힌 코드 저장소가 404라는 점, 판정표 일부 칸이 지금 코드와 맞지 않는다는 점도 짚었다. 인터랙티브 위젯 6개.
[특집] 옛 주소로 기차표를 끊는 AI — '기억 갱신 격차'를 재고, 훈련으로 줄인 Supersede 완전 해부
"저 부산으로 이사했어요"라고 말해 두었는데, 몇 주 뒤 AI 비서가 대구행 기차표를 끊는다. 2026년 6월 arXiv 논문 「Supersede」는 이 실패를 '기억 갱신 격차'라고 부르고, 네 가지 질문으로 파고든다. 실패는 정말 있나? 더 큰 모델이면 풀리나? 더 큰 메모장이면 풀리나? 훈련하면 줄어드나? 답은 있다, 아니다, 아니다, 그렇다. 300자 메모장만 쥔 gpt-5.4는 전체 대화를 다 본 자신보다 15점 낮았고, 대화가 24배 길어지자 정답률은 68%에서 28%로 무너졌으며, 메모장을 24배로 늘려 줘도 28%였다. 마지막으로 3B 모델을 GRPO로 훈련해 9.0%를 16.7%로 끌어올렸다. 1957년의 순행 간섭 실험부터 데이터베이스의 UPDATE, 2026년의 'ChatGPT Dreaming'까지 이 문제가 어디서 왔는지 따라가고, 논문의 그림과 표를 하나씩 읽는다. 같은 데이터와 같은 프롬프트로 공개 모델(Qwen 3.5 9B)에서 실험을 직접 재현해 25.6점의 격차를 확인했고, 메모를 요약 대신 '주제: 값' 장부로 쓰게 하는 지시문 하나로 그 격차가 11.5점까지 줄어드는 것도 보았다. 하지만 그 장부도 대화가 48세션으로 길어지자 88%에서 8%로 무너졌다. 그리고 논문의 문자열 채점기가 옛 값 '7:00 pm'을 정답으로 처리한다는 것도 찾아냈다.
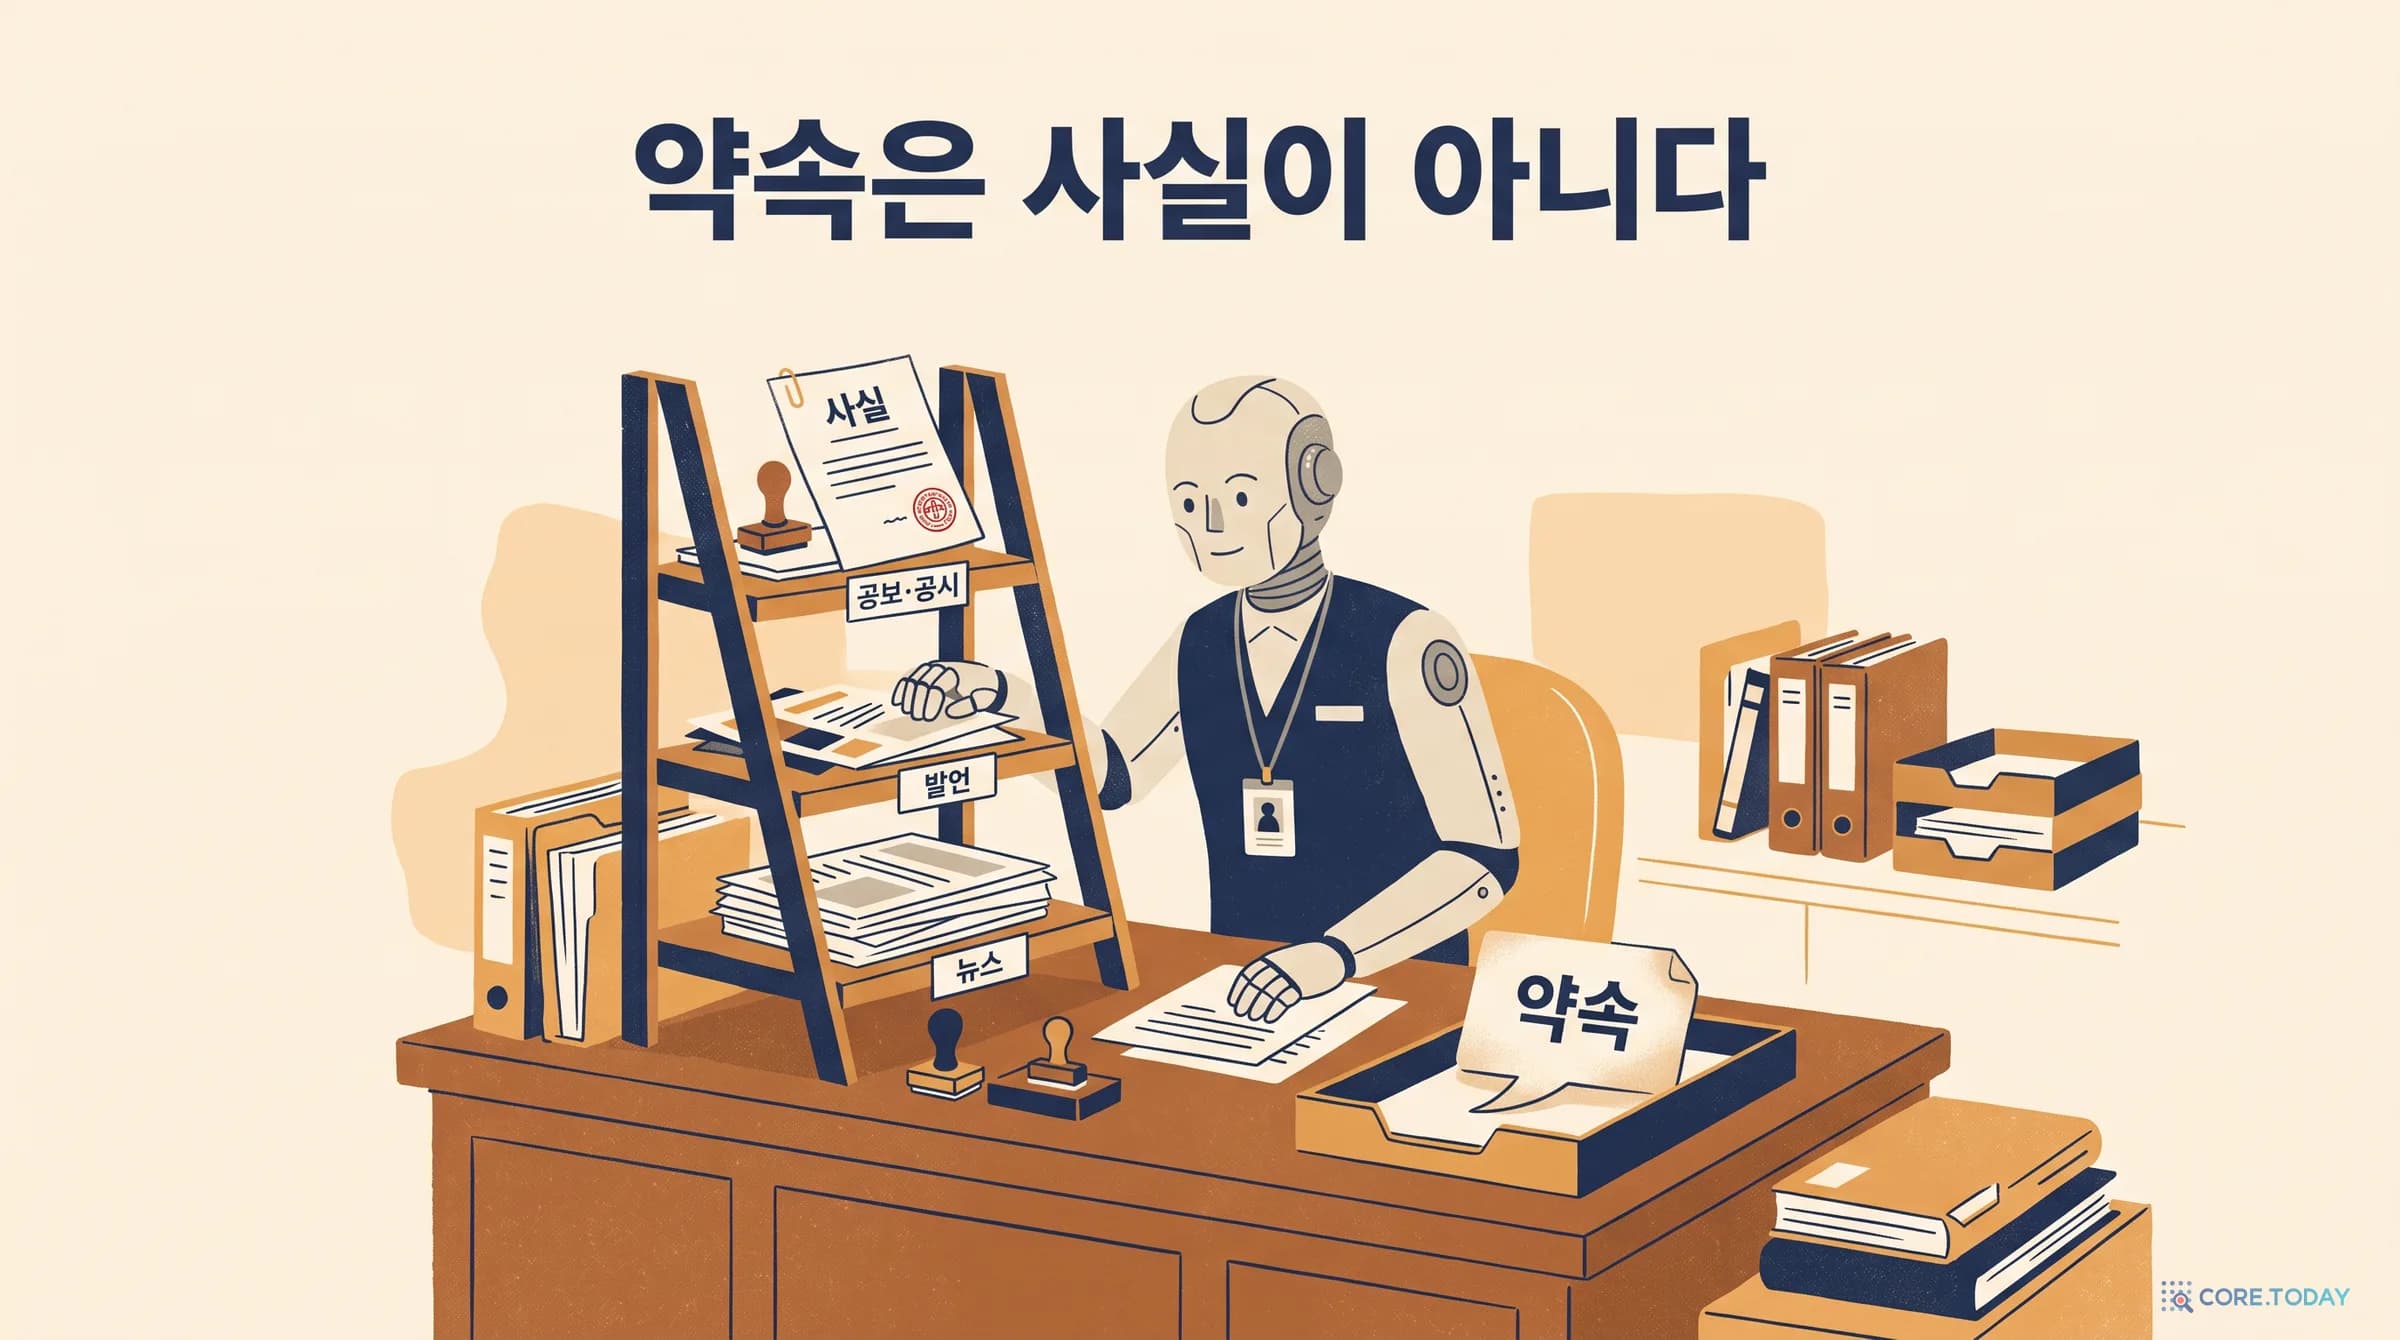
약속은 사실이 아니다 — 코어닷투데이 사실탐색기 v2 설계
에이전트 기억 엔진 다섯 개를 해부하고 나서 남은 질문은 하나였다. 공적 기록에서 '지금 참인 것'은 무엇이고, 누가 그것을 바꿀 수 있는가. 최신 문장이 이기는 기억은 개인 비서에게는 맞지만, 국장의 약속·뉴스의 오보·공보의 확정이 섞인 세계에서는 틀린 답을 자신 있게 낸다. 코어닷투데이 사실탐색기 v2는 문장을 클레임과 명제로 가르고, 권위 격자(전언 ≺ 1인칭 ≺ 공식)와 발화행위로 '닫을 자격'을 따지는 AGS(권위 기반 대체)를 중심에 둔다. 닫는 조건 다섯 가지, 도착 순서와 무관한 키별 재생, 허용성 세 축과 인증서로 정하는 기권, 지우지 않고 가리는 봉인, 세상 사실과 사용자 기억의 분리, 그리고 한국어를 1급 시민으로 다루는 결정론 계층까지 — 설계의 뼈대를 위젯 4개로 직접 돌려 본다.
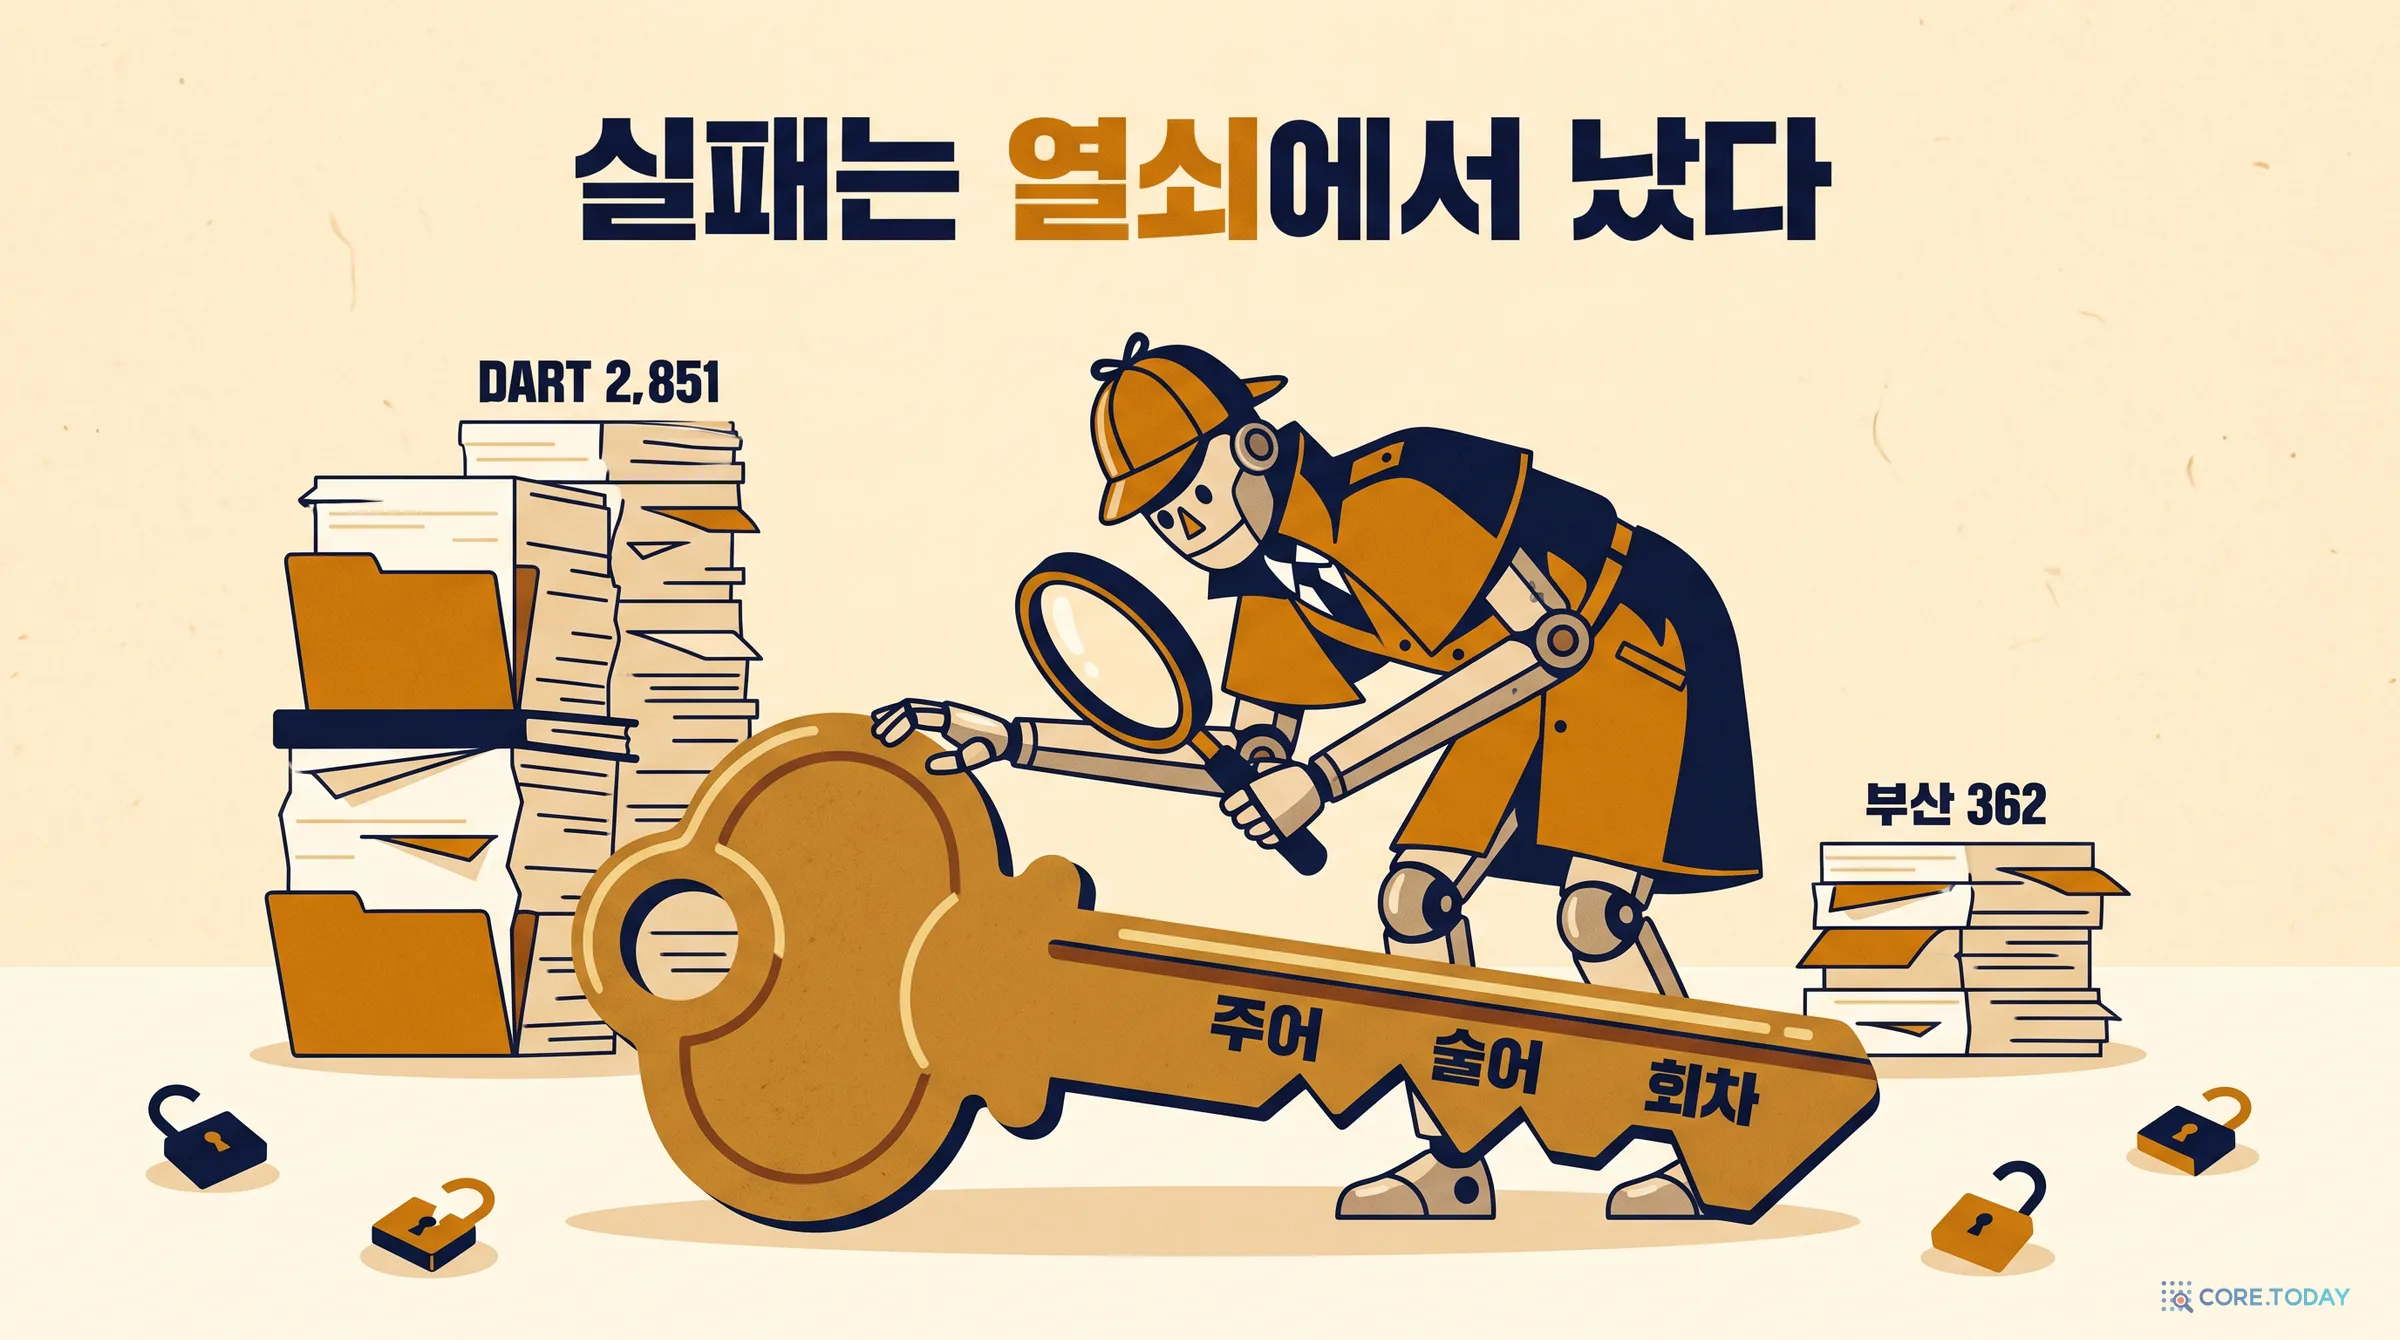
실패는 열쇠에서 났다 — 사실탐색기 v2를 실제 공시 2,851건과 부산 기록 362건에 돌려 보니
합성 코퍼스에서 모든 질문을 맞힌 사실탐색기 v2를 실제 기록에 넣었다. 2026년 DART 배당 공시 2,742건과 뉴스 109건, 부산시의회 회의록·고시공고·조례 공포문·현행 조례 362건이다. 깨진 곳은 권위를 따지는 AGS가 아니라 그 앞의 '열쇠'였다. DART에서 정정이 아닌 대체 305건 가운데 304건이 열쇠 오류였다. 분기배당 네 번이 한 열쇠가 되었고, 지주사가 자회사 배당을 다시 낸 공시가 주체를 바꿨고, 서로 다른 조례의 '이 조례'가 시행일을 서로 덮었다. 원칙 하나 — 기록 밖에서 뜻이 정해지지 않는 주어는 그 기록의 이름으로 좁힌다 — 와 측정으로 고른 회차 간격 45일·연도 오기 문턱 180일, 그리고 '설명되지 않는 대체'라는 건강 신호로 부산의 숨은 버그 94건을 6건까지 줄인 과정을 위젯 4개로 따라간다.
[특집] 기억은 하는데 지금을 모른다 — AI 에이전트의 '상태 표류'와 StateMem 완전 해부
에이전트가 며칠씩 일하게 되면서 '기억했는가'보다 '지금 무엇이 참인가'가 중요해졌다. UIUC 연구진의 2026년 8월 논문은 이것을 상태 추적이라 부르고, 사실은 맥락 안에 있는데 낡은 값으로 행동하는 실패를 '상태 표류'로 정의했다. 1969년 프레임 문제와 1979년 진리 유지 시스템·VisiCalc에서 시작해 대화 상태 추적, MemGPT·Mem0·Zep까지 이어지는 계보를 따라가고, 함정 234개짜리 StateMemBench가 어떻게 실패를 '만드는지', 대체 표시와 의존성 그래프로 상태를 지키는 StateMem과 답변 호출 하나만 바꾸는 래퍼가 무엇을 얼마나 고치는지 표와 그림을 하나씩 읽는다. 논문과 같은 계열의 로컬 모델(Qwen 3.5 9B)로 한국어 함정 40문항을 직접 돌려, 답변 프롬프트만 바꿔도 정답이 28개에서 38개로 느는 것도 확인했다.
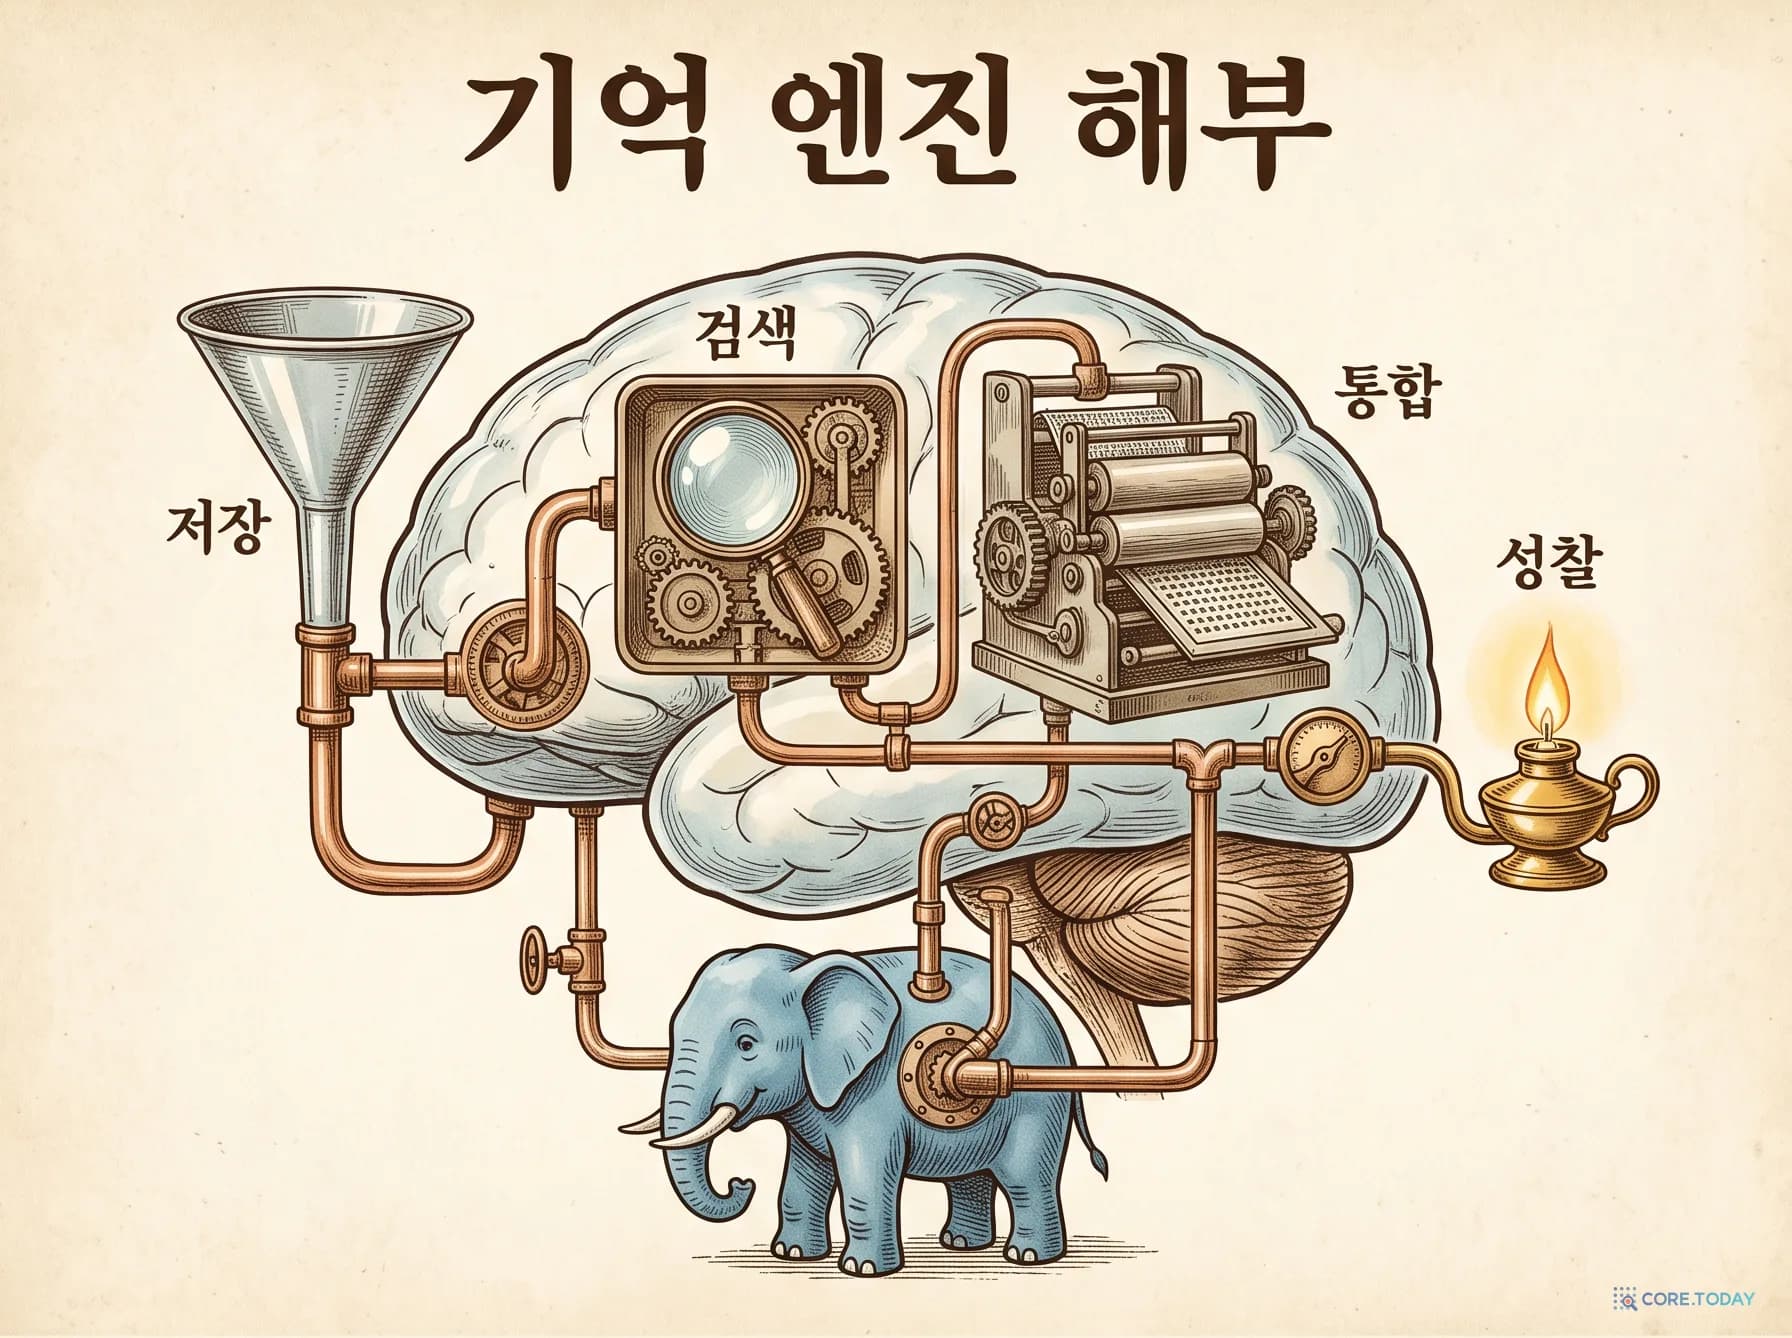
에이전트 기억 엔진 해부 — Hindsight의 코드를 열고 Mem0·Graphiti·Letta·Cognee를 나란히 눕혔다
논문 대신 코드를 열었다. GitHub 별 5만 개가 넘는 Hindsight의 저장·검색·통합·성찰 경로를 상수와 공식, 파일 위치까지 따라가고, 같은 칼로 Mem0·Graphiti·Letta·Cognee를 해부했다. 핵심은 '고전 검색 기법 + LLM 판단'의 분업이다. 엔티티는 임베딩이 아니라 글자 조각으로 합치고, 순위는 점수가 아니라 등수로 섞고, 쉬운 판단은 LLM이 아니라 1초짜리 결정 모델이 내린다. 그리고 다섯 엔진 모두 '잊는 법'은 구현하지 않았다. Mem0이 2026년 4월 그래프와 UPDATE를 버린 이유, Graphiti의 RRF 상수가 60이 아니라 1인 이유, Letta가 기억을 git 저장소로 바꾼 이유, 그리고 한국어 이름 '김민지'와 '민지'가 왜 한 사람으로 합쳐지지 않는지까지 — 인터랙티브 위젯 7개로 직접 돌려 본다.
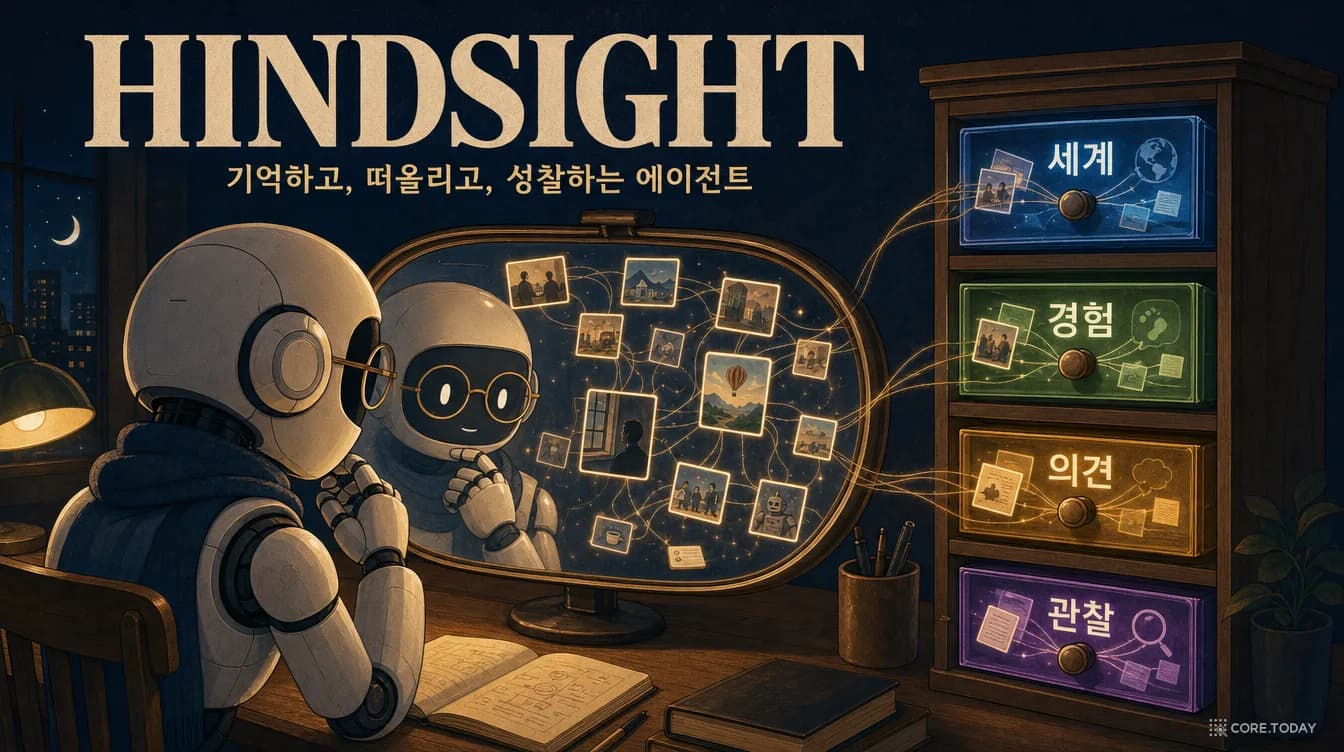
Hindsight 완전 해부 — 에이전트에게 '본 것'과 '믿는 것'을 따로 기억하게 했더니 생긴 일
11개월 만에 GitHub 별 4만 7천 개. 오픈소스 에이전트 메모리 Hindsight는 기억을 하나의 벡터 창고가 아니라 네 개의 서랍 — 세계·경험·의견·관찰 — 으로 나누고, 저장(retain)·회상(recall)·성찰(reflect) 세 동작으로 다룬다. 같은 20B 모델의 LongMemEval 점수가 39.0%에서 83.6%로 뛰었다. 왜 '증거와 믿음의 분리'가 중요한지, 네 갈래 검색과 역순위 융합·확산 활성화가 어떻게 돌아가는지, 성격 다이얼과 의견 강화 공식은 무엇인지, 그리고 2026년의 제품은 논문과 어떻게 달라졌는지 — 심리학의 140년 계보부터 벤치마크의 함정, 경쟁 설계와의 비교까지 인터랙티브 위젯 7개로 완전 해부한다.
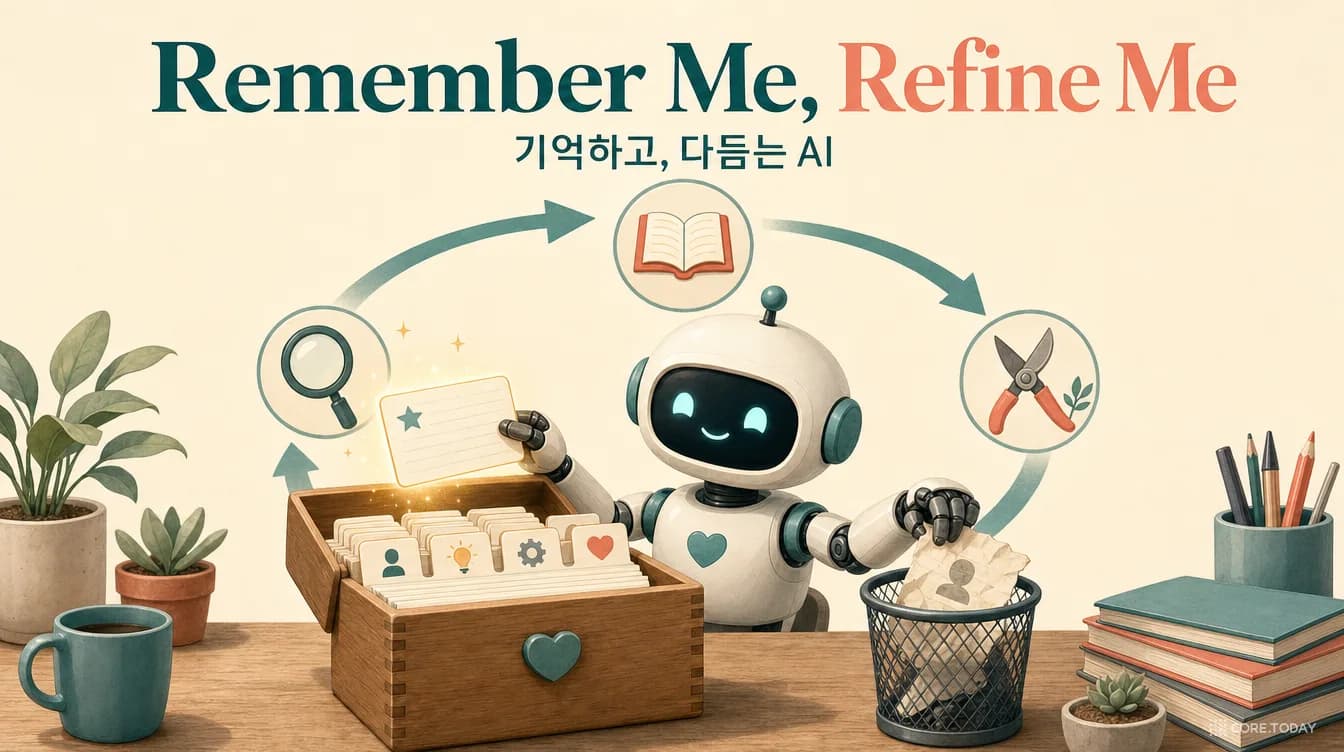
어제의 실수를 오늘 반복하지 않는 AI — ReMe, '기억하고 다듬는' 절차 기억의 모든 것
AI 에이전트는 똑똑하지만 매일 아침 기억이 지워지는 신입사원과 같다. 어제 주가를 지어내 주문을 망쳤어도 오늘 또 지어낸다. 경험을 쌓아 두면 해결될까? 알리바바 통이 연구소와 상하이교통대의 ReMe(Remember Me, Refine Me)는 '쌓기만 하는 기억은 결국 독이 된다'고 답한다. 성공·실패·비교의 세 렌즈로 경험을 한 줄짜리 요령으로 증류하고, '언제 쓰나'로 색인해 꺼내 고쳐 쓰고, 불려 나온 횟수 대비 쓸모가 없는 경험은 지운다. 그 결과 Qwen3-8B가 기억 없는 14B를 넘어섰다. 1962년 거울 속 별을 그리던 환자 H.M.부터 2026년 '기억을 파일로' 진화한 ReMe 0.4까지, 논문의 그림·표·코드와 인터랙티브 위젯 6개로 절차 기억을 완전히 풀어 본다.
에이전트 네이티브 메모리, 준비됐나? — 12개 AI 기억 시스템을 데이터베이스의 눈으로 해부한 2026년 보고서
ChatGPT도, Claude도, Copilot도 이제 '기억'을 판다. 그런데 어떤 기억이 좋은 기억인지 아무도 같은 자로 재 본 적이 없었다. 상하이교통대·칭화대·MemTensor 연구진이 12개 메모리 시스템을 11개 데이터셋에서 같은 조건으로 돌리고, 기억을 '표현·추출·검색·유지보수' 네 모듈로 뜯어 한 부품씩 바꿔 가며 측정했다. 결론은 불편하다. 만능 챔피언은 없고, 요약은 정보를 지우며, 정밀한 사실 추출은 추론을 무너뜨리고, 그래프는 정확하지만 100배 느리다. 역사·개념·실험·실무 가이드까지, 인터랙티브 위젯과 함께 완전 해부한다.
루프를 쌓는 기술: LangChain이 그린 '4중 루프'와 스스로 진화하는 에이전트
LangChain의 글 한 편이 개발자 타임라인을 뒤흔들었다. '에이전트를 프롬프트하지 말고, 루프를 쌓아라(loopcraft).' 핵심은 네 개의 루프를 겹겹이 포개는 것 — 일하는 에이전트 루프, 채점하는 검증 루프, 스스로 깨어나는 이벤트 루프, 그리고 자기 자신을 고쳐 쓰는 힐 클라이밍 루프. ReAct(2022)와 Reflexion(2023)이라는 두 논문에서 뿌리를 찾고, LangChain의 '문서 봇' 사례로 네 루프가 하나로 포개지는 순간을 눈으로 확인한다. swyx의 'Salty Lesson'부터 2026년의 복리 효과까지, 용어가 생소해도 그림과 사례로 끝까지 쉽게.