
기술 분석
2개의 포스트
새 판정 모델, 한국어로 다시 재다 — StartLux·d3·Perplexity Decider·AutoTrust JEV·Liquid d1
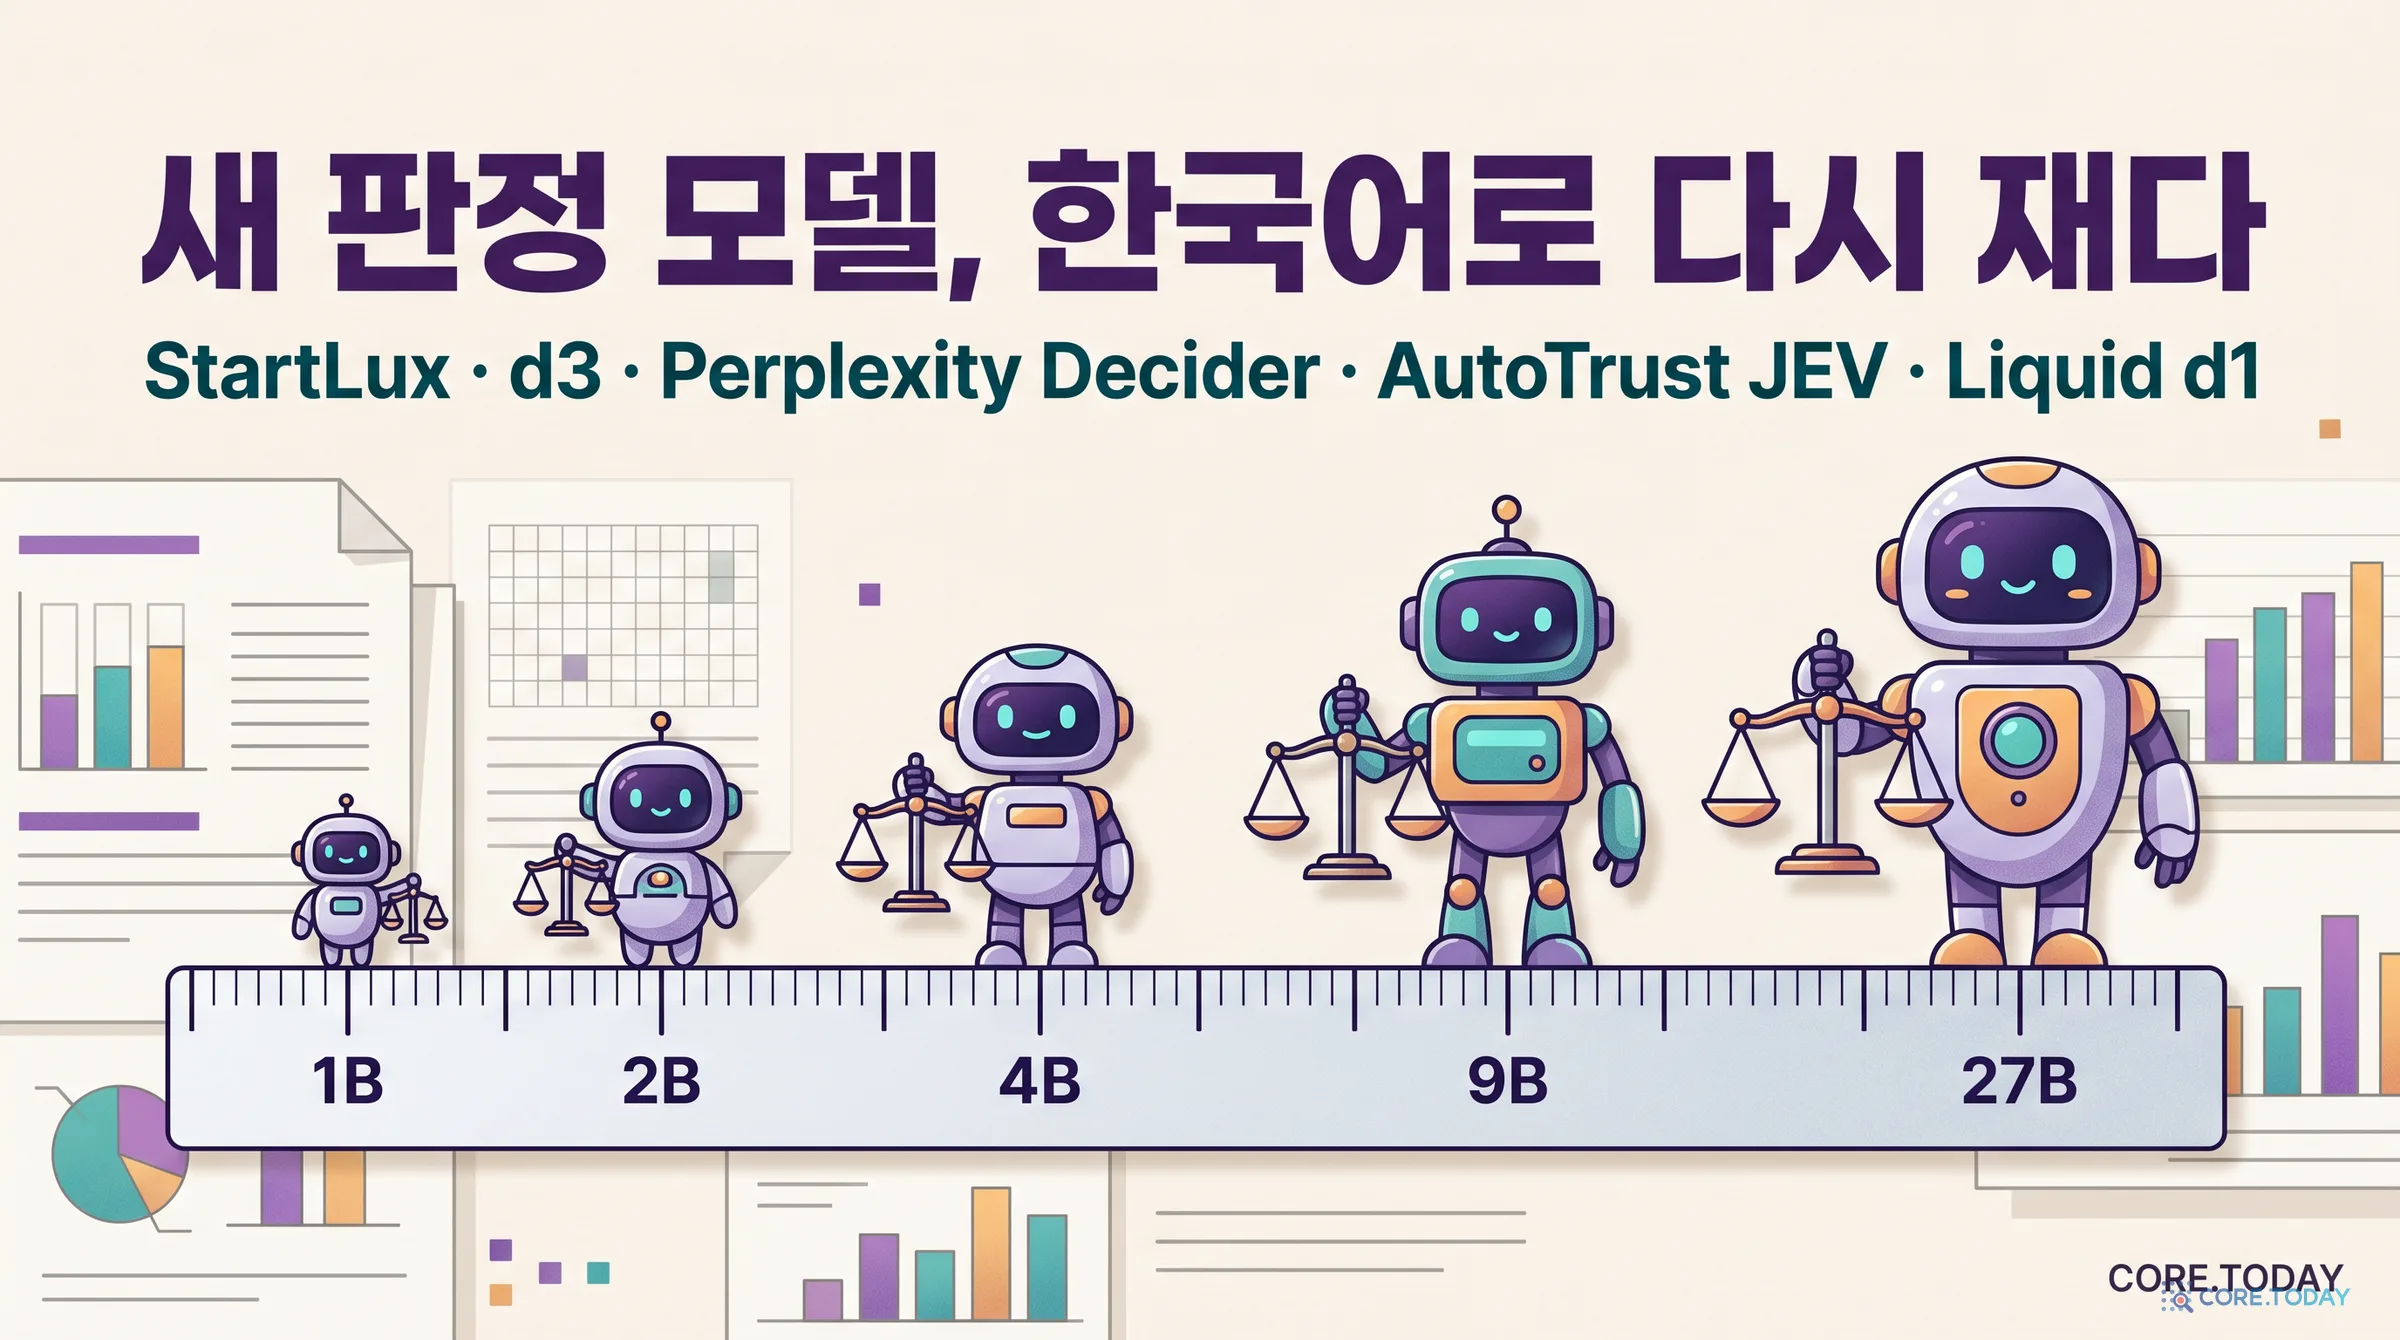
StartLux가 0.8B부터 27B까지 모든 크기에서 동급보다 7.4~16.9점 앞선다는 그림을 냈고, d3·Perplexity Decider·AutoTrust JEV·Liquid d1이 잇달아 Ollama에 올라왔습니다. 코어닷투데이는 새 판정 모델 15가지 구성을 11월 1일과 같은 한국어 2,221문항과, 사실탐색기의 부산 공공기록으로 새로 만든 사실 탐색 1,449문항에 올렸습니다. 한국어에서 StartLux가 동급을 뚜렷하게 앞선 곳은 0.8B(+6.9점)뿐이고, 4B는 +1.5점, 2B·9B·27B는 d3와 겹쳤습니다. 게시판의 비공개 시험을 합친 총점에서도 StartLux의 공개분 우위는 크게 줄었습니다. Ollama의 d3는 8비트 포장에도 원본과 0.4점 안쪽으로 같았고, 사실 탐색에서는 d3:27b와 StartLux 27B가 87점대로 맨 위였습니다. 판정 모델의 문턱을 라벨로 고르면 값 비교는 모든 모델이 완벽했고, 남은 어려움은 ‘본문에 이유가 적혀 있는가’를 묻는 부재 검문 하나였습니다.
생각은 어디에 흐르는가 — Recurrent Looped Transformer와 보이지 않는 추론의 시대
2026년 9월 12일, 프린스턴의 Yifan Zhang이 16쪽짜리 기술 보고서를 공개했다. 이전 토큰의 내부 상태를 다음 토큰으로 계속 넘겨서, 문장이 길어질수록 계산 경로도 계속 깊어지는 트랜스포머다. 열흘 전에는 OpenAI의 GPT-6 Astra가 비슷한 '순환' 기법을 쓴다는 보도로 AI 안전 연구자들이 들끓었다. 이 특집은 RNN에서 트랜스포머, 생각의 사슬, 루프 모델로 이어진 35년의 흐름 속에서 RLT가 왜 나왔는지 풀고, 논문의 세 가지 설계 원칙을 하나씩 분해하고, 독립 실험이 보여 준 한계를 확인한 뒤, 모델의 생각이 글에서 벡터로 옮겨 갈 때 사람의 감시가 어떻게 되는지를 따진다. 인터랙티브 실험 4종과 논문 원본 그림을 함께 싣는다.