Common LispLisp피드백 루프REPL이미지 기반 개발조건 시스템재시작매크로동형성DSL에이전트 코딩LLMClaude Code토큰 경제컨텍스트 창공급망 보안npmQuicklisp폴 그레이엄매카시Vivien Henz특집
코드를 쓰는 시간이 사라지면 무엇이 남나 — 「왜 Common Lisp가 이제 최고의 언어인가」 특집
2026년 10월, 「왜 Common Lisp가 이제 최고의 프로그래밍 언어인가」라는 짧은 글이 해커뉴스와 X를 뒤흔들었습니다. 논거는 단순합니다. LLM이 코드를 쓰는 시간은 몇 초로 줄었는데, 빌드하고 재시작하고 크래시 로그를 읽는 시간은 그대로이니, 이제는 피드백 루프의 길이가 개발 속도를 정한다는 것입니다. 그리고 돌아가는 프로그램을 멈추지 않고 함수를 바꾸고, 에러가 나면 죽는 대신 멈춰서 선택지를 내미는 언어가 이미 1994년에 완성돼 있었다는 것입니다. 이 글은 1960년 매카시의 논문에서 시작해 Lisp 머신, 조건 시스템, ANSI 표준, 폴 그레이엄의 Viaweb까지 글이 기대는 네 가지 성질의 역사를 되짚고, 아키텍처를 그림으로 풀고, 해커뉴스의 반론과 2026년 데이터(저자원 언어 벤치마크, 토큰 가격, npm 공급망 사고)로 주장을 검증합니다. 브라우저에서 도는 미니 Lisp, 피드백 루프 시뮬레이터, 조건 시스템 체험, 토큰 계산기, 연표 위젯 5개와 일러스트 8장.
어떤 프로그래밍 언어가 다른 언어보다 낫다는 데 동의하는가? 그렇다면 그중 하나는 최고여야 한다. 그리고 그건 사실 Common Lisp다. 특히 LLM이 코드를 쓰게 된 지금은.
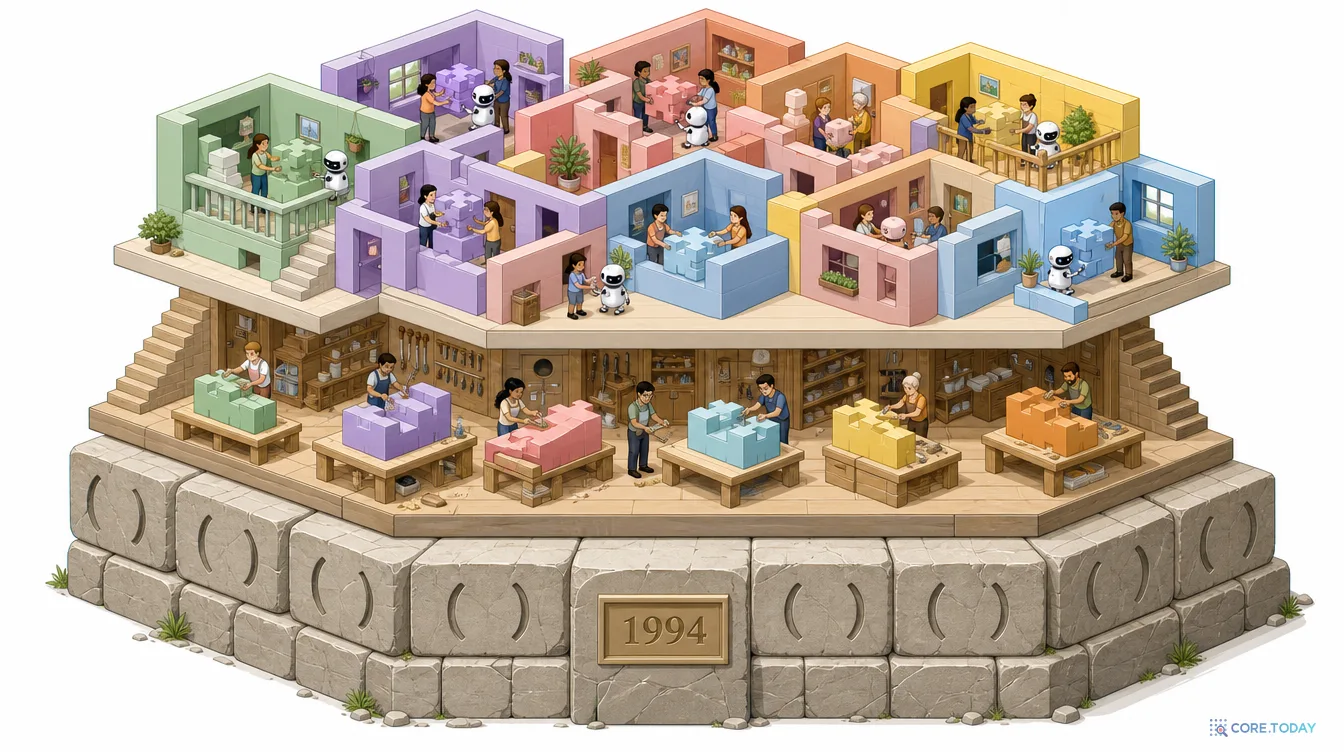
Common Lisp는 1994년에 ANSI 표준이 확정된 뒤 한 번도 개정되지 않은 언어입니다. 1958년에 설계가 시작됐으니 포트란 다음으로 오래된 고수준 언어이고, 스택오버플로 설문에서는 '쓰고 싶은 언어' 목록 끝자락에 간신히 이름을 올립니다. 그런 언어가 "이제" 최고라는 주장이 왜 이렇게 널리 읽혔을까요.
이유는 글이 Lisp 자랑을 하지 않기 때문입니다. 글의 진짜 주제는 "코드를 쓰는 시간이 0에 가까워지면 소프트웨어 개발의 병목은 어디로 옮겨 가는가"입니다. Lisp는 그 질문에 대한 하나의 답으로 등장할 뿐입니다. 그래서 Lisp를 한 줄도 써 본 적 없는 개발자, 심지어 Lisp가 싫은 개발자도 이 글을 읽고 자기 언어와 도구를 돌아보게 됩니다. 이 특집은 그 질문을 따라가되, 글이 당연하게 전제하는 개념들(이미지, REPL, 조건 시스템, 매크로)을 처음 듣는 분도 끝까지 따라올 수 있도록 역사와 그림, 직접 만져 볼 수 있는 위젯으로 풀어 보겠습니다.
✅
바쁜 분을 위한 요약.
① 글의 핵심 논증은 한 문장이다. LLM이 코드를 쓰는 시간은 몇 초가 됐는데, 빌드·재시작·크래시 로그 해석 시간은 그대로다. 그러니 이제 피드백 루프의 길이가 개발 속도를 정한다.
② Common Lisp는 프로그램이 메모리에 살아 있는 '이미지'다. 함수 하나를 다시 정의하면 재시작 없이 다음 호출부터 바뀐다. 에러가 나면 프로그램이 죽는 대신 스택과 변수를 그대로 둔 채 디버거가 열리고, '값을 바꿔 계속' 같은 재시작(restart)을 고를 수 있다. 이 둘이 LLM 에이전트의 루프를 극단적으로 짧게 만든다는 것이 글의 1차 주장이다.
③ 2차 주장은 매크로다. 코드가 곧 리스트(데이터)라서 프로그램이 프로그램을 고칠 수 있고, 그래서 회사는 자기 제품의 '도메인 언어'를 만들 수 있다. 사용자가 LLM으로 제품을 직접 바꾸는 시대에, 그 변경이 회사의 의견 위에서 이뤄지게 하는 장치라는 것이다.
④ 3차 주장은 경제다. 저자의 경험상 Lisp 앱은 Python 버전보다 6~7배 짧다. 토큰이 적으니 싸고, 프로그램 전체가 컨텍스트 창에 들어가니 LLM이 '다른 부분을 못 본 채 한 부분을 고치는' 실수를 덜 한다.
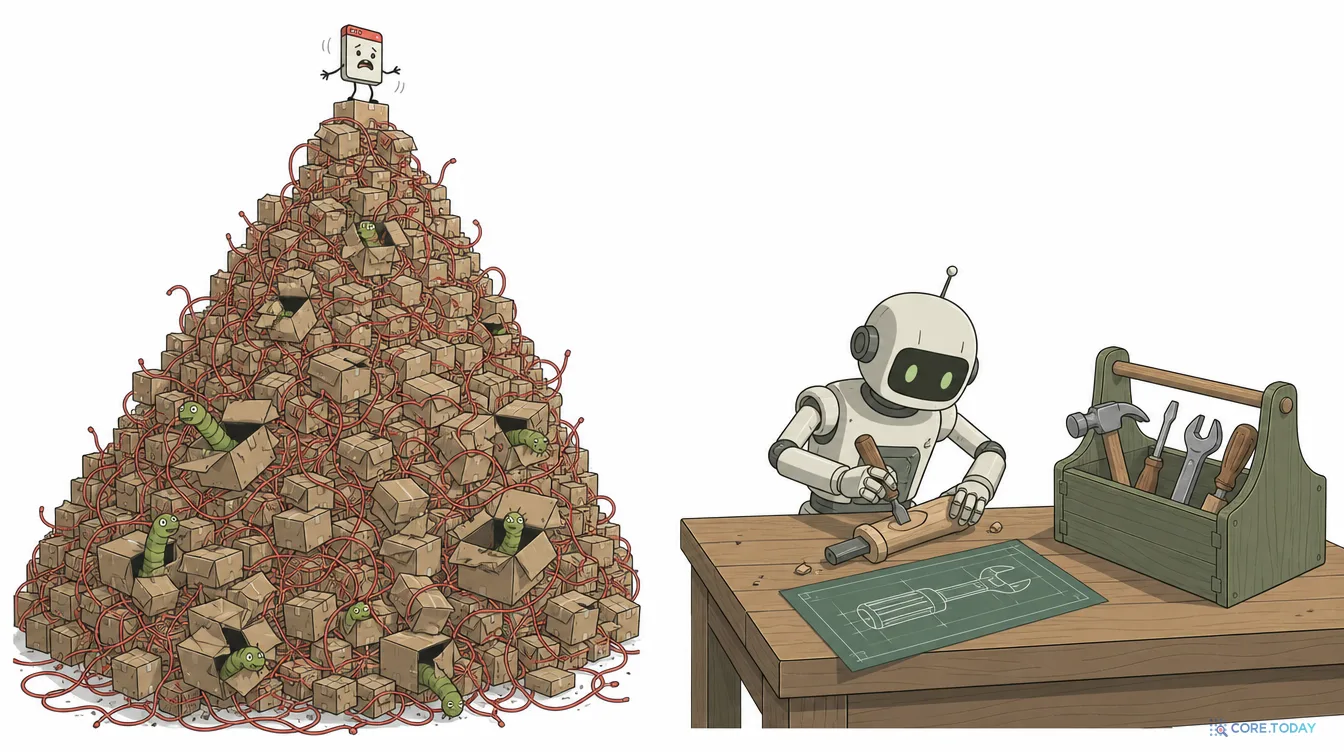
⑤ 약점으로 꼽히던 것(1994년에 멈춘 표준, 수천 개뿐인 라이브러리, 구인난)을 글은 전부 장점으로 뒤집는다. 표준이 안 바뀌니 사용자가 쌓은 것이 안 깨지고, 의존성이 적으니 공급망 공격에 덜 노출되며, LLM이 라이브러리를 옮겨 주고, 면접에서 Lisp를 배우게 하면 학습 능력이 걸러진다.
⑥ 이 성질들은 새것이 아니다. 코드=데이터는 1960년, 살아 있는 이미지는 1970~80년대 Interlisp·Lisp 머신, 조건 시스템은 1983~88년, 표준은 1994년에 완성됐다. 새것은 '코드를 쓰는 비용'이 사라진 2026년의 환경이다.
⑦ 반론도 강하다. LLM은 학습 데이터가 적은 언어에서 약하고(저자원 언어 벤치마크), Clojure·Smalltalk·Erlang·Elixir에도 라이브 코딩이 있으며, 6~7배라는 숫자는 저자 한 사람의 경험이다.
⑧ 그래서 이 글의 실용적 결론은 'Lisp로 갈아타라'가 아니다. 어떤 언어를 쓰든 에이전트의 한 바퀴를 재고, 재시작 없는 수정·상태를 보존하는 에러 처리·전체가 창에 들어가는 코드 크기를 확보하라는 것이다. 2026년의 도구(REPL 도구 호출, MCP로 연결한 nREPL·Swank, 핫 리로드)로 상당 부분 흉내 낼 수 있다.
1. 글이 실제로 말하는 것 — 다섯 문단으로 압축하기
원문은 1,200단어 남짓입니다. 그런데 논증이 촘촘해서 요약하면 오히려 길어집니다. 글의 흐름을 다섯 덩어리로 나눠 보겠습니다. 각 덩어리는 뒤에서 한 장씩 따로 다룹니다.
① 전제
"LLM은 코드를 정말 빨리 쓴다. 그래서 많은 것이 바뀌는데, 코드를 쓰는 것이 예전엔 느린 부분이었기 때문이다. 이제 느린 부분은 프로그램이 실제로 동작하는지 알아내는 일이고, 그 전에 다시 빌드해야 하며 그건 몇 분이 걸릴 수 있다." → 피드백 루프의 길이가 속도를 정한다.
② 이미지와 디버거
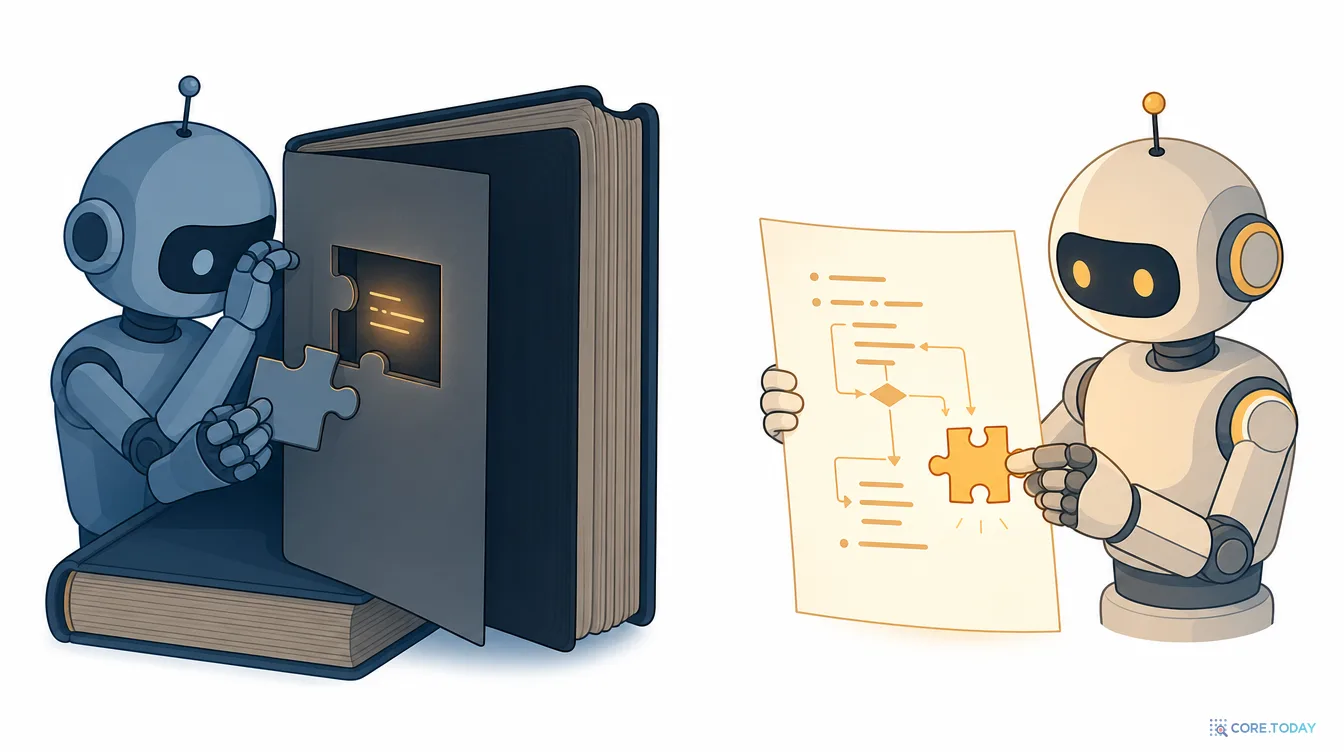
Common Lisp에서는 읽기 시점·컴파일 시점·실행 시점의 구분이 사실상 없고, 프로그램은 메모리에 살아 있는 이미지라서 새 함수가 옛 함수를 즉시 대체한다. 에러는 크래시가 아니라 스택과 변수가 보존된 디버거를 연다. "LLM을 디버거에 겨누면, 고치고, 프로그램을 재개한다."
③ 코드=데이터, 매크로, 도메인 언어
(+ 1 2)는 프로그램이면서 세 칸짜리 리스트다. 리스트를 다루는 모든 도구가 코드에도 먹힌다. 그래서 매크로가 가능하고, 언어를 문제 쪽으로 쌓아 올릴 수 있다. 사용자가 LLM으로 제품을 바꾸는 시대에, 회사의 '의견'이 담긴 도메인 언어가 있으면 그 변경은 제품을 깨지 않고 제품에 맞는다(ERP 예).
④ 경제
매크로로 반복 패턴을 언어에 흡수하니 프로그램이 짧다(저자 경험 6~7배). 토큰이 적어 싸고, 프로그램 전체가 컨텍스트 창에 들어가 LLM이 의도를 통째로 본다. "LLM 버그의 상당수는 나머지를 보지 않고 한 부분을 바꾸는 데서 온다."
⑤ 약점의 반전
1994년 이후 안 바뀐 표준은 사용자가 쌓은 것이 안 깨진다는 뜻. 수천 개뿐인 라이브러리는 "계속 뚫리는 수백만 줄"을 안 들이는 것이고, 필요한 건 LLM이 써 주거나 옮겨 준다. 구인은 면접에서 Lisp를 배우게 해 "배우는 데 뛰어난 사람"을 고르면 된다. 결론: "다음에 프로그램을 쓸 땐 Common Lisp를 쓰라."
주목할 점은 ②~④가 전부 ①의 전제가 참일 때만 의미가 있다는 것입니다. 사람이 10분 걸려 코드를 쓰던 시절에는 빌드 2분이 별 문제가 아니었고, 디버거가 열리든 크래시 로그가 남든 어차피 사람이 읽었습니다. 글의 모든 논거는 "쓰는 시간이 20초가 됐다"는 2026년의 조건 위에 서 있습니다. 그래서 먼저 그 조건부터 봐야 합니다.
2022년까지 이 바퀴에서 압도적으로 긴 구간은 '코드 쓰기'였습니다. 그래서 개발 생산성 논의는 대부분 그 구간을 줄이는 데 집중했습니다. 더 좋은 언어, 더 좋은 IDE, 자동 완성. 빌드가 3분 걸리는 것은 짜증 나지만, 30분 동안 코드를 쓴 뒤의 3분이라 전체의 10%였습니다.
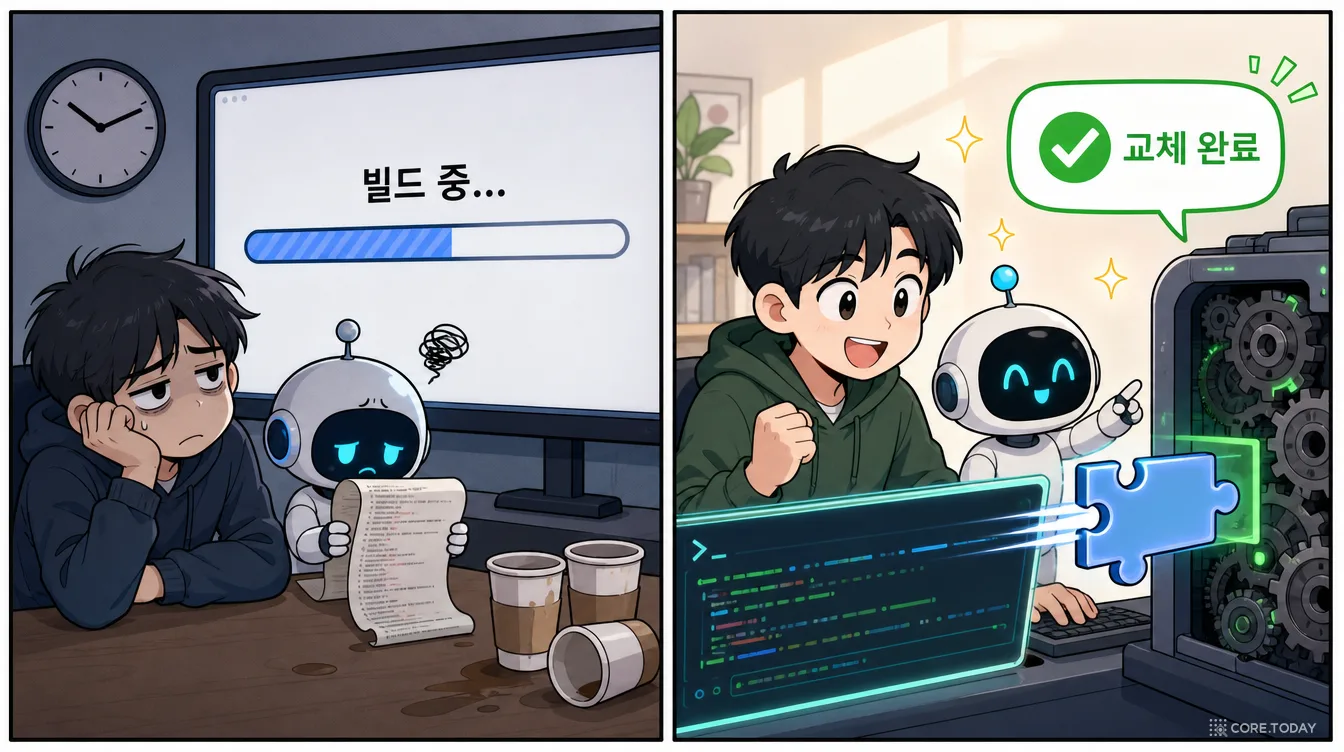
2026년의 에이전트 코딩은 그 비율을 뒤집었습니다. Claude Code나 Codex 같은 에이전트에게 "주문 가격 파싱이 쉼표 들어간 금액에서 깨진다. 고쳐라"라고 말하면, 코드 수정 자체는 수십 초 안에 나옵니다. 그 다음 에이전트는 빌드를 돌리고, 프로세스를 다시 띄우고, 문제가 났던 상황까지 다시 재현하고, 실패하면 터미널에 쏟아진 트레이스백을 읽어 상황을 머릿속에서 재구성한 뒤, 다시 고칩니다. 코드 쓰기 20초, 나머지 3분. 바퀴의 90%가 기다림과 재구성입니다.
헨즈의 글은 이 지점을 정확히 찌릅니다.
사람이 코드를 쓸 때는 이게 별로 중요하지 않았다. 코드를 쓰는 데 컴파일하고 실행을 기다리는 것보다 훨씬 오래 걸렸으니까. 그런데 지금은 중요하다. 그래서 피드백 루프가 얼마나 긴지가 얼마나 빨리 만들 수 있는지를 정한다.
이것은 새로운 통찰이라기보다 오래된 원리의 재발견입니다. 1960년대 시분할 시스템이 천공 카드 일괄 처리를 밀어낸 이유, 1980년대 Turbo Pascal이 1초 컴파일로 시장을 가져간 이유, 2010년대 웹 개발이 핫 모듈 교체(HMR)에 매달린 이유가 전부 같습니다. 사람에게도 피드백 루프는 늘 중요했습니다. 다만 사람은 기다리는 동안 다른 생각을 하고, 빌드가 도는 동안 커피를 마시며 다음 수정을 머릿속에서 준비합니다. 에이전트는 그러지 않습니다. 에이전트는 한 바퀴가 끝나야 다음 바퀴를 시작하고, 한 바퀴의 비용이 곧 토큰과 시간으로 청구됩니다.
아래 시뮬레이터에서 '사람이 코드 한 번 쓰는 시간'과 'LLM이 코드 한 번 쓰는 시간'을 번갈아 조절해 보세요. 세 가지 환경의 차이가 사람 기준에서는 1.5배 안팎이다가 LLM 기준에서는 수 배로 벌어지는 것을 볼 수 있습니다. 숫자는 편집자의 추정값이며, 요점은 절대값이 아니라 비율이 뒤집히는 지점입니다.
그렇다면 피드백 루프를 극단적으로 짧게 만드는 환경이란 무엇일까요. 글은 세 가지를 꼽습니다. 빌드가 없을 것, 재시작이 없을 것, 실패가 상태를 날리지 않을 것. 그리고 "내가 아는 한 이 셋을 다 하는 주류 언어는 Common Lisp뿐"이라고 말합니다. 그 말이 맞는지 보려면 Lisp가 어떻게 생겼는지부터 알아야 합니다. 1960년으로 갑니다.
S-식(S-expression). 모든 데이터는 '원자'이거나 '두 S-식의 쌍'이다. 쌍을 이어 붙이면 리스트가 된다. (A B C)는 사실 (A . (B . (C . NIL)))이라는 쌍의 사슬이다.
조건식.if … then … else …를 값으로 쓰는 표현. 매카시는 이것을 ALGOL 60에도 넣게 했다.
재귀 함수 정의와 가비지 컬렉션. 더 이상 쓰이지 않는 쌍을 자동으로 거둬들이는 아이디어가 이 논문에서 처음 구현됐다.
그리고 논문의 백미, eval. 매카시는 "Lisp 프로그램을 S-식으로 적으면, 그 S-식을 읽어 실행하는 함수 eval을 Lisp 자체로 반 페이지에 쓸 수 있다"는 것을 보였다.
마지막 항목은 원래 이론적 장난에 가까웠습니다. 튜링의 보편 기계처럼 "Lisp는 자기 자신을 해석할 수 있을 만큼 보편적이다"를 보이려는 것이었죠. 그런데 매카시의 대학원생 스티브 러셀(Steve Russell)이 "이걸 그냥 IBM 704 기계어로 옮기면 해석기가 되는 거 아닌가요?"라고 물었고, 매카시는 훗날 이렇게 회고했습니다.
스티브 러셀이 말했다. "이봐요, 이 eval을 프로그램으로 만들어 볼까요?" 나는 "넌 이론과 실제를 혼동하고 있어, 이 eval은 읽으라고 쓴 거지 계산하라고 쓴 게 아니야"라고 했다. 하지만 그는 가서 그걸 했다. 즉 내 논문의 eval을 IBM 704 기계 코드로 컴파일했고, 버그를 고쳤고, 그걸 Lisp 해석기라고 광고했다. 실제로 그랬다. 그 시점에 Lisp는 본질적으로 지금의 형태를 갖췄다.
여기서 중요한 것은 eval이 프로그램을 데이터로 받는다는 사실입니다. eval의 입력은 문자열이 아니라 리스트입니다. 즉 매카시의 Lisp에서 프로그램은 처음부터 "리스트라는 자료구조"로 존재했고, 해석기는 그 자료구조를 걷는 함수였습니다. 프로그램을 읽어 리스트로 만드는 read, 리스트를 실행하는 eval, 결과를 찍는 print를 무한 반복하면 그것이 곧 REPL(Read-Eval-Print Loop)입니다. 표준 문서는 이 이름을 문자 그대로 설명합니다. "이 루프는 표현식을 읽고, 평가하고, 결과를 인쇄하는 끝없는 루프로 이루어진다."
💡
car와 cdr는 왜 그런 이름인가. 쌍의 앞 칸을 꺼내는 car, 뒷 칸을 꺼내는 cdr는 IBM 704의 36비트 워드에서 'Contents of the Address part of Register', 'Contents of the Decrement part of Register'를 줄인 것입니다. 1960년의 하드웨어 이름이 2026년의 코드에 그대로 남아 있는 셈인데, 글이 말하는 "표준이 안 움직인다"의 극단적인 예이기도 합니다.
3.2 동형성: 안과 밖의 모양이 같다
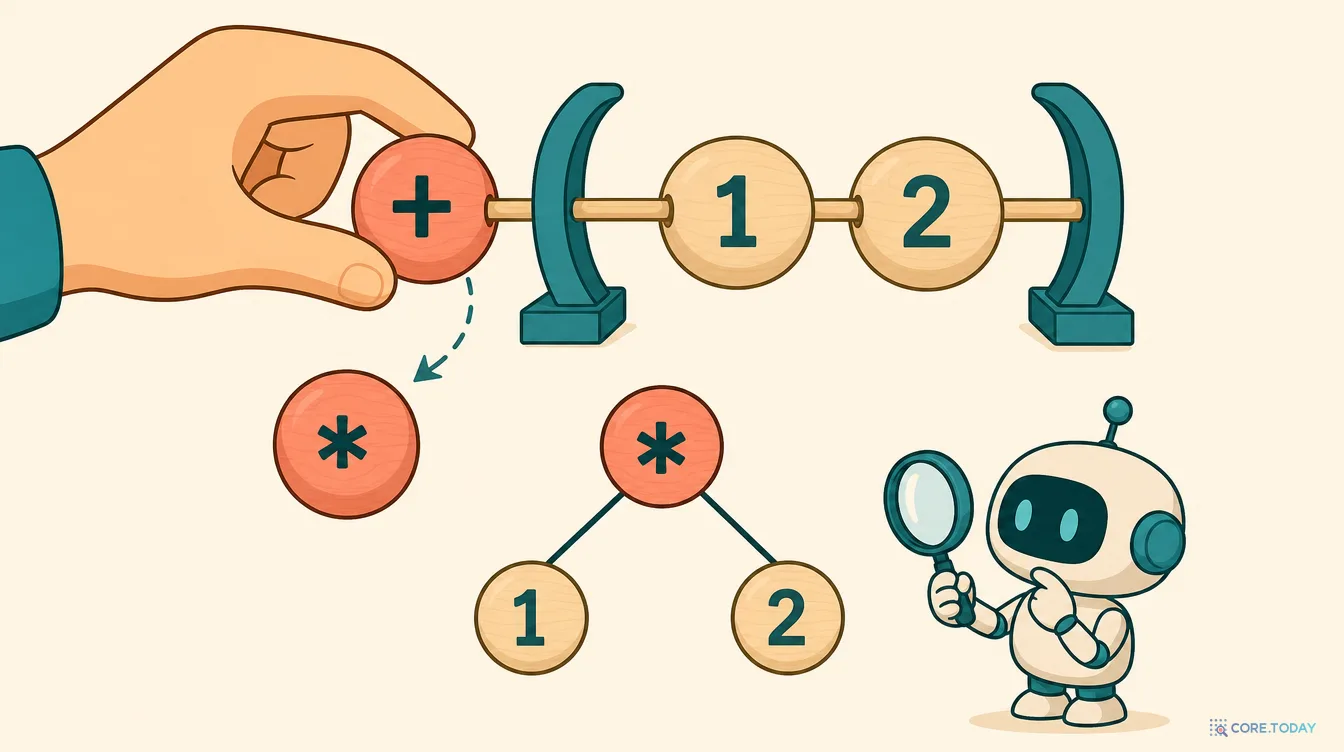
(+ 1 2)를 봅시다. 사람 눈에는 "1 더하기 2"입니다. 그런데 Lisp의 read가 이것을 읽으면 메모리에는 원소가 세 개인 리스트가 생깁니다. 첫 칸에 기호 +, 둘째 칸에 숫자 1, 셋째 칸에 숫자 2. eval은 "첫 칸이 함수 이름이면 나머지 칸을 평가해서 그 함수를 부른다"는 규칙으로 3을 돌려줍니다.
그런데 같은 리스트를 앞에 따옴표를 붙여 '(+ 1 2)라고 쓰면 eval은 평가하지 말고 리스트 그대로 돌려줍니다. 이제 이건 그냥 데이터입니다. (car '(+ 1 2))는 +이고 (cdr '(+ 1 2))는 (1 2)입니다. 글의 예처럼 첫 칸을 *로 바꿔 끼우고((cons '* (cdr '(+ 1 2)))) 다시 eval에 넣으면 2가 나옵니다. 프로그램이 프로그램을 리스트 연산으로 고쳐서 바로 실행한 것입니다.
이 성질을 동형성(homoiconicity)이라고 부릅니다. 어원은 '같은'(homo)과 '표현'(icon)입니다. 이 말은 1965년 캘빈 무어스(Calvin Mooers)가 자기 언어 TRAC을 설명하며 만들었고, 1969년 앨런 케이(Alan Kay)가 박사 논문에서 "대화형 LISP와 TRAC은 내부 표현과 외부 표현이 본질적으로 같다는 점에서 '동형적'이다"라고 쓰며 Lisp에 붙였습니다. 파이썬도 ast 모듈로 코드를 트리로 만져 볼 수 있고, 자바스크립트도 Babel로 AST를 변환합니다. 차이는 Lisp에서는 그 트리가 곧 소스 코드의 모양 그대로이고, 변환 도구가 언어의 일반 리스트 함수 그 자체라는 데 있습니다. 별도의 AST 라이브러리를 배울 필요가 없습니다. car, cdr, cons, mapcar면 됩니다.
아래 미니 Lisp는 이 글을 위해 브라우저 안에 만든 장난감입니다. 예제 ①~③을 차례로 평가해 보세요. 예제 ④~⑤는 다음 장의 주제인 '살아 있는 이미지'를 미리 체험하는 것인데, 1초마다 뛰는 심장박동 프로그램을 멈추지 않고 함수를 다시 정의하면 다음 박동부터 바뀝니다.
3.3 매크로: 코드를 받아 코드를 돌려주는 함수
동형성이 실용적으로 폭발하는 지점이 매크로입니다. 보통 언어에서 함수는 값을 받아 값을 돌려줍니다. Lisp의 매크로는 코드(리스트)를 받아 코드(리스트)를 돌려주는 함수이고, 컴파일러는 소스를 컴파일하기 전에 매크로를 먼저 불러 그 결과를 대신 컴파일합니다.
표준 문서의 예를 그대로 가져오면 이렇습니다.
lisp
(defmacro mac1 (a b) "Mac1 multiplies and adds"
  `(+ ,a (* ,b 3)))

(mac1 4 5)                       ; ⇒ 19
(macroexpand-1 '(mac1 4 5))      ; ⇒ (+ 4 (* 5 3))
역따옴표(`)는 "이 틀은 그대로 두되, 쉼표가 붙은 자리만 값을 끼워 넣어라"는 뜻입니다. (mac1 4 5)를 컴파일러가 만나면 mac1이 함수가 아니라 매크로임을 알고, a=4, b=5로 매크로를 실행해 (+ 4 (* 5 3))이라는 새 코드를 얻은 뒤 그것을 컴파일합니다. macroexpand-1은 그 변환 결과를 눈으로 보여 주는 도구입니다.
이게 왜 대단한가는 "언어에 없는 구문을 라이브러리로 추가할 수 있다"는 데 있습니다. Common Lisp에는 while 반복문이 표준에 없습니다. 하지만 세 줄이면 만듭니다.
lisp
(defmacro while (test &body body)
  `(do () ((not ,test)) ,@body))
,@는 리스트를 '펼쳐서' 끼우라는 뜻입니다. 이제 (while (< i 10) (incf i))라고 쓰면 컴파일러가 알아서 do 반복문으로 바꿔 줍니다. 파일 열고 닫기(with-open-file), 자원 잠금, 트랜잭션 묶기, 테스트 케이스 선언, HTML 생성, 심지어 객체 시스템 CLOS까지 Common Lisp의 많은 '구문'이 이 방식으로 만들어졌습니다. 1980년대에 Lisp 머신 회사들이 loop라는 영어 문장 같은 반복 구문((loop for x in list when (evenp x) collect x))을 매크로로 만들어 넣었고, 그것이 표준에 들어갔습니다.
매크로에는 함정도 있습니다. 매크로가 만든 임시 변수 이름이 호출하는 쪽의 변수 이름과 겹치면 조용히 엉뚱한 값을 잡는 변수 포획(capture) 문제입니다. Common Lisp는 gensym으로 절대 겹치지 않는 이름을 만들어 피하고, 1986년 콜베커(Kohlbecker) 등의 「Hygienic Macro Expansion」 논문 이후 Scheme·Racket·Rust·Julia는 컴파일러가 이름을 자동으로 구별하는 위생적 매크로를 택했습니다. 이 차이는 뒤에서 "LLM이 매크로를 잘 다룰 수 있나"를 따질 때 다시 나옵니다.
3.4 폴 그레이엄: 언어를 문제 쪽으로 쌓아 올린다
매크로의 철학을 가장 잘 요약한 사람은 폴 그레이엄(Paul Graham)입니다. 헨즈의 글이 유일하게 인용하는 문헌이 그의 2002년 에세이 「What Made Lisp Different」이고, 글의 3번째 주장은 그레이엄의 1993년 책 『On Lisp』 서문을 거의 그대로 잇습니다.
Lisp에서는 프로그램을 언어 쪽으로 내려 쓰기만 하는 것이 아니라, 언어를 프로그램 쪽으로 쌓아 올리기도 한다. 언어와 프로그램이 함께 진화한다. … 결국 프로그램은 마치 언어가 그것을 위해 설계된 것처럼 보이게 된다.
그레이엄은 말로만 한 것이 아닙니다. 1995년 그와 로버트 모리스는 Common Lisp로 온라인 상점 빌더 Viaweb을 만들었고, 1998년 야후에 팔렸습니다. 2001년 에세이 「Beating the Averages」에서 그는 "우리의 비밀 무기는 괄호가 가득한 괴상한 문법의 이상한 AI 언어로 소프트웨어를 쓴 것"이었고, "Viaweb 편집기의 소스 코드는 아마 20~25%가 매크로였다"고 썼습니다. 경쟁사가 기능을 따라 만드는 데 몇 주 걸릴 때 자기들은 하루면 됐다는 것입니다.
헨즈의 글은 이 '쌓아 올린 언어'에 2026년의 새 역할을 줍니다. 1990년대에 그 언어를 쓰는 사람은 회사 내부 개발자였습니다. 2026년에는 고객이 LLM을 시켜 그 언어로 제품을 고칩니다. 이 전환이 왜 중요한지는 6장에서 ERP 사례로 돌아오겠습니다. 그 전에 글의 1차 주장, '살아 있는 이미지'와 '죽지 않는 에러'가 실제로 어떻게 구현돼 있는지 아키텍처를 봐야 합니다.
4. 살아 있는 이미지: 아키텍처를 그림으로
4.1 '이미지'란 무엇인가
보통 언어에서 프로그램은 파일입니다. 소스를 고치면 컴파일하고, 실행 파일을 띄우고, 끝나면 사라집니다. 실행 중의 상태(열어 둔 연결, 캐시, 사용자 세션)는 프로세스가 죽으면 날아가고, 다음 실행은 다시 맨바닥에서 시작합니다.
Lisp에서 프로그램은 메모리에 살아 있는 세계입니다. 이 세계를 이미지(image)라고 부릅니다. 이미지 안에는 컴파일러, 디버거, 검사기(inspector), 지금까지 정의한 모든 함수와 클래스, 만들어진 모든 객체, 돌아가는 스레드가 함께 들어 있습니다. 소스 파일은 이 세계를 만들기 위한 레시피일 뿐이고, 개발은 이 세계 안에서 함수를 하나씩 바꿔 끼우며 진행됩니다. SBCL에서는 (save-lisp-and-die "my-app.core") 한 줄로 현재 세계를 통째로 디스크에 저장할 수 있고, 다음에 그 파일로 Lisp를 띄우면 저장한 순간 그대로 깨어납니다. 서버라면 열어 둔 함수 정의와 데이터가 모두 그대로입니다.
이 발상은 Lisp만의 것이 아닙니다. 1970년대 BBN과 Xerox PARC의 Interlisp는 'sysout'이라는 이름으로 세션 전체를 저장했고, 1980년 Smalltalk-80은 아예 '이미지'라는 이름을 썼으며 지금도 Pharo 같은 Smalltalk는 이미지 파일을 주고받으며 개발합니다. 그리고 1978년 MIT의 CADR에서 시작해 Symbolics·LMI·TI가 상용화한 Lisp 머신은 이 발상을 하드웨어와 운영체제 수준으로 밀어붙인 기계였습니다. Symbolics의 Genera 환경에서는 화면에 보이는 모든 것이 Lisp 객체였고, 어떤 객체든 클릭해서 검사하고, 운영체제의 함수까지 돌아가는 중에 다시 정의할 수 있었습니다. 1980년대 AI 붐이 꺼지면서 이 회사들은 사라졌지만, 그 경험은 SBCL과 SLIME 같은 오픈소스 도구로 내려왔습니다.
4.2 읽기 시점·컴파일 시점·실행 시점이 '한 곳'에 있다
헨즈의 글이 폴 그레이엄에게서 인용한 유일한 문장이 "읽기 시점, 컴파일 시점, 실행 시점 사이에 실질적인 구분이 없다"입니다. 그레이엄은 이것을 Lisp를 다르게 만든 아홉 가지 아이디어 중 마지막, "언어 전체가 항상 거기에 있다"로 꼽았습니다. 다른 언어에서는 세 시점이 서로 다른 프로그램(전처리기, 컴파일러, 실행 파일)에서 일어나지만 Lisp에서는 셋이 같은 이미지 안의 함수입니다. 그래서 각 시점에 코드를 끼워 넣을 수 있습니다.
한 이미지 안에서 일어나는 네 시점 — 어디서든 Lisp 코드를 실행할 수 있다
읽기 시점 (read)
문자열 → 리스트
리더 매크로가 개입. #.(…)는 읽는 도중에 Lisp를 실행해 그 결과를 끼워 넣고, #+linux는 조건부로 코드를 건너뛴다
매크로 전개 시점
리스트 → 리스트
defmacro로 정의한 함수가 코드를 받아 코드를 돌려준다. 3장의 while, loop, with-open-file이 여기서 펼쳐진다
컴파일 시점 (compile)
리스트 → 네이티브 코드
SBCL은 REPL에 친 한 줄도 기계어로 컴파일한다. 함수 하나는 수 ms. eval-when으로 컴파일 중에 실행할 코드를 지정
실행 시점 (run)
함수 호출 · 조건 발생
실행 중에도 compile·eval·defun을 부를 수 있다. 새 정의는 다음 호출부터 쓰인다
이 그림에서 LLM 에이전트에게 결정적인 칸은 세 번째입니다. SBCL은 1980년대 CMU의 CMUCL에서 갈라져 나온 구현으로, 'Python'이라는 이름의 네이티브 컴파일러(프로그래밍 언어 Python과는 무관합니다)를 물려받았습니다. 이 컴파일러는 함수 하나를 단위로 기계어를 만들고, 만든 코드를 이미지 안의 기존 심볼에 연결합니다. 에디터에서 defun 하나를 다시 컴파일하면 수 밀리초 뒤 그 함수의 다음 호출부터 새 코드가 돕니다. 이미 그 함수 안에서 돌고 있던 호출은 옛 코드를 마저 끝내고, 그 함수를 부르던 다른 함수들은 고칠 필요가 없습니다. 재빌드도, 링크도, 프로세스 재시작도 없습니다. 심지어 클래스 정의를 바꿔도 CLOS는 기존 객체들을 다음 접근 때 새 정의로 갱신합니다(update-instance-for-redefined-class라는 표준 함수가 그 규칙을 정합니다). 데이터베이스 연결 100개를 열어 둔 서버의 주문 클래스에 필드를 하나 추가하는 일이, 재시작 없이 됩니다.
🛰️
실제로 이렇게 쓴 두 사례. 1999년 5월 NASA JPL의 탐사선 Deep Space 1은 Common Lisp로 쓴 'Remote Agent'가 이틀간 자율 제어를 맡았는데, 비행 중 경쟁 조건(race condition) 버그가 드러났습니다. 지구에서 1억 마일 떨어진 탐사선의 Lisp 이미지에 REPL로 접속해 고쳤고, 담당자 론 가렛(Ron Garret)은 "우주선 위에서 돌아가는 REPL이 문제를 찾고 고치는 데 더없이 귀중했다"고 썼습니다. 2016년 Grammarly는 문법 엔진의 핵심이 Common Lisp이고 초당 1,000문장 이상을 SBCL로 처리하며, 운영 서버에 SLIME으로 원격 접속해 SBCL 런타임의 경쟁 조건 버그를 돌아가는 서버에서 함수를 재정의해 고친 경험을 공개했습니다.
4.3 에디터와 에이전트는 어떻게 이미지에 말을 거나
이미지가 살아 있어도 바깥에서 말을 걸 통로가 없으면 소용이 없습니다. Common Lisp 공동체가 2003년부터 다듬어 온 통로가 SLIME(Emacs 쪽)과 Swank(Lisp 쪽)입니다. 구조는 단순합니다.
살아 있는 이미지에 접속하는 구조 — 2003년의 Emacs와 2026년의 에이전트가 같은 자리에 선다
클라이언트
Emacs(SLIME·Sly) · VS Code(Alive) · LLM 에이전트(MCP)
"이 defun을 컴파일해", "이 식을 평가해", "3번 프레임의 지역 변수를 보여 줘", "2번 재시작을 골라"
Swank 서버 (이미지 안에서 돈다)
TCP 소켓 위의 S-식 메시지
요청을 받아 이미지 안의 컴파일러·디버거·검사기를 부르고 결과를 S-식으로 돌려준다. Clojure의 nREPL, 2025년의 clojure-mcp·lisply-mcp가 같은 자리
컴파일러
함수 단위 네이티브
ms 단위 재정의
디버거 (SLDB)
프레임 · 지역 변수 · 재시작
5장 참조
검사기 (Inspector)
어떤 객체든 들여다보기
슬롯 값 수정 가능
돌아가는 프로그램
스레드 · 소켓 · 데이터
전부 살아 있음
2026년의 변화는 맨 위 칸에 에이전트가 들어왔다는 것입니다. 해커뉴스의 한 Clojure 개발자는 에이전트에게 "JVM을 띄우고 nREPL을 열고 아무 식이나 평가하는 도구"를 주었더니 "에이전트가 nREPL을 제2의 천성처럼 쓴다"고 썼고, Common Lisp 쪽에서는 SBCL의 REPL·디버거·핫 리로드를 MCP로 노출하는 서버들(cl-mcp, cl-tron-mcp, lisply-mcp 등)과, 아예 자기 자신이 돌아가는 이미지를 고치는 에이전트 Autolith가 나왔습니다. 헨즈가 글에서 "LLM을 디버거에 겨눈다"고 쓴 것은 비유가 아니라 이 구조의 문자 그대로의 묘사입니다.
4.4 '살아 있음'의 등급: 타니모토의 여섯 단계
"라이브 코딩"이라는 말은 느슨하게 쓰입니다. 자바스크립트의 핫 모듈 교체도, 파이썬의 importlib.reload도, 자바의 HotSwap도 라이브라고 불립니다. 이 차이를 정리한 틀이 워싱턴대 스티븐 타니모토(Steven Tanimoto)가 1990년에 제안하고 2013년 「A Perspective on the Evolution of Live Programming」에서 여섯 단계로 확장한 라이브니스 등급입니다.
등급
뜻
예
1 정보적
표현이 설계를 돕기만 한다
플로차트, 다이어그램
2 실행 가능
표현이 곧 프로그램이고, 손으로 실행한다
보통의 소스 코드 + 컴파일
3 편집 반응
편집하면 시스템이 즉시 다시 실행해 결과를 보여 준다
스프레드시트, JS HMR, 저장 시 테스트 자동 실행
4 완전 라이브
돌아가는 프로그램을 편집하면 중단 없이 새 버전으로 계속 실행된다
Common Lisp 이미지, Smalltalk, Erlang 핫 스왑, 라이브 음악 코딩
5 전술적 예측
시스템이 다음 편집을 예측해 제안한다
코드 자동 완성, Copilot
6 전략적 예측
시스템이 목표를 추론해 더 큰 코드를 합성한다
2026년의 코딩 에이전트
이 표를 보면 헨즈 글의 위치가 보입니다. 2026년의 에이전트는 5~6등급(예측·합성)에 와 있는데, 그 에이전트가 작업하는 환경은 대부분 2~3등급(저장하면 재빌드)에 머물러 있습니다. 글의 주장은 6등급짜리 작성자에게 4등급짜리 실행 환경을 주라는 것입니다. 다른 언어의 핫 리로드가 왜 4등급에 못 미치는지는 아래 표가 설명합니다.
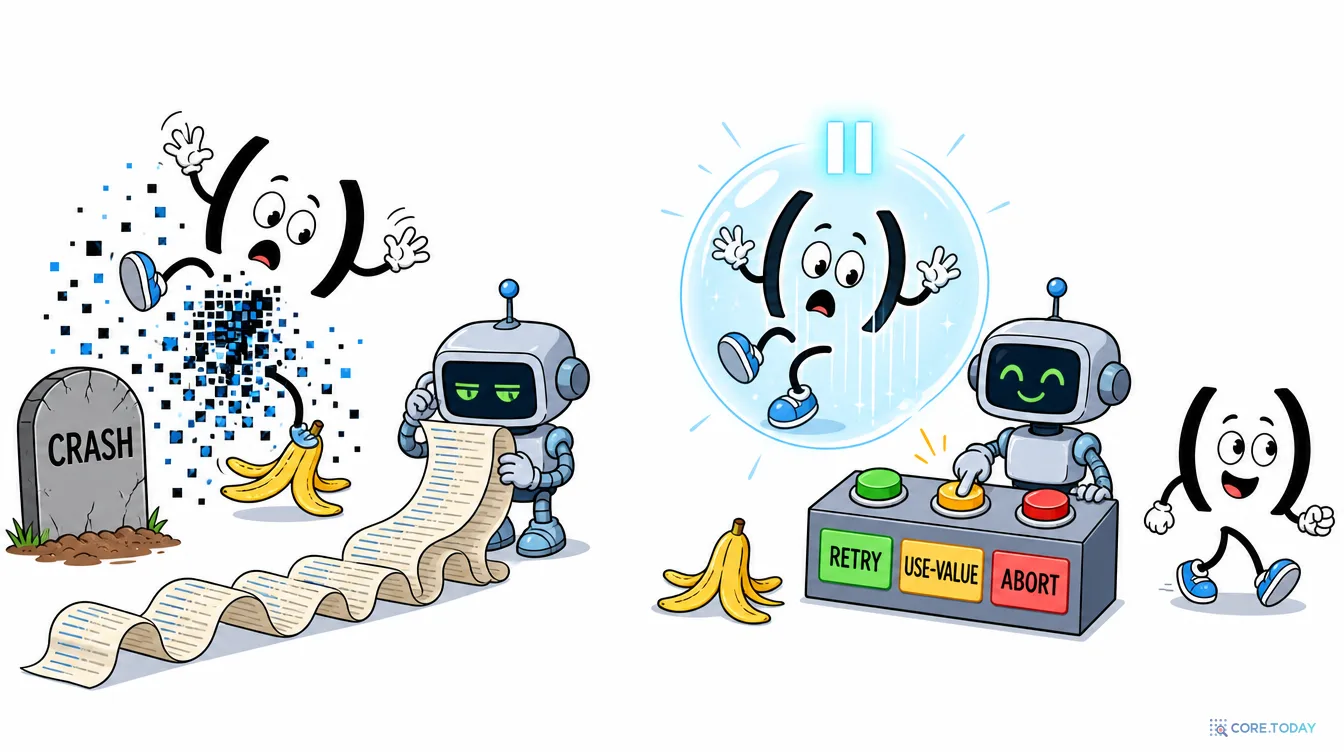
대부분의 언어에서 에러는 프로그램을 죽인다. 그래서 LLM과 코드를 쓰면 LLM은 크래시 로그를 읽고, 뭔가 고치고, 프로그램을 다시 돌려야 한다. Common Lisp에서는 프로그램이 죽지 않는다. 멈추고, 전체 스택과 모든 변수가 보이는 디버거를 연다. LLM을 디버거에 겨누기만 하면, 고치고, 프로그램을 재개한다.
이 동작을 가능하게 하는 것이 Common Lisp의 조건 시스템(condition system)입니다. 설계자 켄트 피트먼(Kent Pitman)은 2001년 논문 「Condition Handling in the Lisp Language Family」에서 그 계보와 철학을 정리했습니다. 뿌리는 1960~70년대 Multics의 PL/I 조건 메커니즘이고, 그것을 1983년 Symbolics의 대니얼 와인렙·데이비드 문·버나드 그린버그가 Lisp 머신의 Zetalisp에 '새 에러 시스템'으로 옮겼으며, 피트먼이 1980년대 후반 Common Lisp 표준에 넣으면서 재시작(restart) 개념을 더했습니다.
피트먼이 꼽는 근본 통찰은 한 문장입니다. "에러를 발견하는 쪽은 그것을 어떻게 고칠지 모른다." 가격 문자열을 숫자로 바꾸는 함수는 "12,000원"을 받았을 때 그것이 치명적인지, 쉼표를 빼고 다시 하면 되는지, 그 주문만 건너뛰어도 되는지 모릅니다. 그걸 아는 것은 열 단계 위에서 주문 100건을 돌리는 함수, 혹은 그 위의 사람(또는 에이전트)입니다. 전통적 예외 처리는 이 문제를 스택을 풀어서 해결합니다. 발견한 곳에서 던지고, 아는 곳에서 잡습니다. 그런데 잡는 순간 그 사이의 모든 프레임은 이미 사라졌습니다. 36건을 처리한 루프 변수도, 37번 주문 객체도, 문제의 문자열도 없습니다. 남은 것은 메시지 한 줄과 트레이스백 텍스트뿐입니다.
5.2 스택을 풀지 않는다
조건 시스템은 순서를 바꿉니다. 에러가 발생하면(이를 '조건을 시그널한다'고 합니다) 시스템은 스택을 그대로 둔 채 안쪽에서 바깥쪽으로 핸들러를 찾아 그 자리에서 부릅니다. 핸들러는 에러가 난 프레임 위에서 실행되므로 모든 지역 변수가 살아 있습니다. 핸들러가 할 수 있는 일은 세 가지입니다.
① 조건 발생
parse-price가 (error 'type-error …)를 시그널한다. 스택은 그대로. 이 시점에 process-orders는 아직 '돌아가는 중'이다.
② 핸들러 탐색
handler-bind로 걸어 둔 핸들러를 안쪽부터 찾아 스택을 풀지 않고 부른다. 핸들러는 조건 객체를 보고, 지금 선택 가능한 재시작 목록을 조회할 수 있다.
③ 재시작 선택
핸들러가 (invoke-restart 'use-value 12000)처럼 재시작을 고르면, 그 재시작을 걸어 둔 지점(parse-price 안일 수도, process-orders 안일 수도 있다)으로 제어가 옮겨 가 계속 실행된다. 핸들러가 아무것도 안 하고 돌아오면 다음 핸들러로 넘어간다.
④ 핸들러가 없으면
디버거가 열린다. 역시 스택은 그대로다. 사람이나 에이전트가 프레임을 훑고, 변수를 보고, 함수를 고쳐 다시 컴파일하고, 재시작을 고른다. 이것이 글이 말한 "LLM을 디버거에 겨눈다"의 실체다.
핵심 어휘는 셋입니다. 조건(condition)은 예외 상황을 나타내는 객체, 핸들러(handler)는 그 조건에 반응하는 함수, 재시작(restart)은 "여기서부터 이렇게 계속할 수 있다"고 미리 걸어 둔 이름 붙은 복구 지점입니다. 피트먼은 재시작을 "이름 붙은 continuation"이라고 부릅니다. 에러를 발견하는 쪽(parse-price)은 재시작을 제공하고, 고칠 줄 아는 쪽(process-orders나 디버거 앞의 에이전트)은 재시작을 선택합니다. 둘 사이의 약속이 곧 프로토콜이고, 피트먼은 조건 시스템이 "근본적으로 프로토콜에 관한 것"이라고 씁니다. 따로 개발된 코드들이 합쳐졌을 때 서로의 복구 방법을 모르고도 협력할 수 있게 하는 장치라는 뜻입니다. 그의 한 줄 정의는 이렇습니다. "프로그래밍이란 모든 상황에서 무엇을 할지를 말하는 일이다."
표준은 자주 쓰는 재시작을 미리 정해 두었습니다. abort(최상위로), continue(경고 무시하고 계속), use-value(이번만 이 값으로), store-value(이 값을 저장하고 계속), muffle-warning(경고 끄기). 그리고 handler-case라는 전통적 try/catch식 구문도 함께 제공합니다. 즉 Common Lisp 프로그래머는 "스택을 풀고 잡을지, 풀지 않고 그 자리에서 고칠지"를 상황마다 고를 수 있습니다.
5.3 디버거 화면은 실제로 이렇게 생겼다
SBCL에 SLIME을 붙이고 위의 주문 처리를 돌리면 에러 순간에 에디터에 이런 버퍼가 뜹니다(위젯의 화면은 이것을 단순화한 것입니다).
text
The value "12,000원" is not of type INTEGER
   [Condition of type TYPE-ERROR]

Restarts:
 0: [USE-VALUE] Use a different value instead of "12,000원".
 1: [SKIP-ORDER] 이 주문만 건너뛴다
 2: [RETRY] Retry SLIME REPL evaluation request.
 3: [*ABORT] Return to SLIME's top level.
 4: [ABORT] abort thread (#<THREAD "repl-thread" RUNNING {1004A8C0A3}>)

Backtrace:
 0: (PARSE-PRICE "12,000원")
      Locals:
        S = "12,000원"
 1: (PROCESS-ORDER #<ORDER 37 "김민수">)
 2: (PROCESS-ORDERS #(100 orders))
      Locals:
        DONE = 36
        ORDERS = #(…)
 3: (MAIN)
여기서 사람이 할 수 있는 일을 에이전트도 그대로 할 수 있습니다. v를 눌러 프레임의 소스로 가고, 쉼표와 '원'을 벗겨 내도록 parse-price를 고친 뒤 C-c C-c로 그 함수만 다시 컴파일하고, 0번 프레임에서 r(restart frame)을 눌러 같은 인자로 그 프레임을 다시 실행합니다. 37번 주문이 통과하고 루프는 38번으로 넘어갑니다. 처리된 36건은 그대로입니다. 아래 위젯에서 두 세계의 차이를 단계별로 밟아 보세요.
5.4 다른 언어는 왜 이렇게 안 하나
Java·Python·C++·Go·Rust의 예외(또는 Result 타입)는 모두 먼저 풀고 나중에 처리합니다. 설계가 단순하고, 핸들러가 실행될 때 스택이 얕아 메모리와 추론이 쉽기 때문입니다. 파이썬의 사후 디버거(pdb.pm())는 죽은 뒤의 스택을 보여 주지만 거기서 값을 고쳐 재개할 수는 없습니다. Erlang은 아예 반대 철학, "죽게 두고 감독자가 다시 띄워라"를 택했는데, 이것은 수천 개의 독립 프로세스가 있는 통신 장비에서는 옳지만 하나의 긴 트랜잭션 안에서는 "처음부터 다시"를 뜻합니다. 재개 가능한 예외를 가진 언어는 Smalltalk와 Dylan 정도이고, 둘 다 Lisp 머신 문화의 영향권에 있습니다. 주류 언어가 이 길을 버린 데는 이유가 있습니다. C++ 설계자 비야네 스트롭스트룹은 재개형 예외를 거부한 근거로 Xerox의 Cedar/Mesa 경험을 들었습니다. 50만 줄짜리 시스템에서 10년 뒤 남은 재개 사용처는 단 하나였고, 그것마저 빼자 성능이 좋아졌다는 것입니다. Common Lisp의 답은 재개를 '이름 붙고 열거 가능하며 디버거에 보이는' 재시작으로 구조화했다는 것이지만, 운영 환경에서는 다른 문제도 있습니다. 해커뉴스의 한 Lisp 사용자는 "운영 서버에 디버거를 달아 두면 에러에서 멈춘 채 타임아웃이 날 뿐"이라며, 운영에서는 결국 핸들러로 자동 복구하거나 로그를 남기고 요청을 끊는 식으로 쓴다고 지적했습니다. 디버거에서 재개하는 흐름은 개발과 디버깅의 도구이지 운영의 기본값이 아닙니다.
2026년에 이 차이가 갑자기 중요해진 이유는 디버거 앞에 앉는 것이 사람만이 아니기 때문입니다. 마이크로소프트 연구소의 debug-gym 실험(2025년 3월)에서 에이전트에게 pdb를 주자 Claude 3.7 Sonnet의 SWE-bench Lite 해결률이 37.2%에서 48.4%로 11포인트 올랐습니다. 실패 지점의 상태를 볼 수 있다는 것만으로 그렇습니다. 2026년 4월의 후속 연구(ADI, FSE 2026)는 함수 단위의 실행 흔적을 에이전트에게 주는 '에이전트 중심 디버깅 인터페이스'로 기존 최고 에이전트들의 해결률을 6~18포인트 더 끌어올렸습니다. 조건 시스템은 거기에 "보고 → 고치고 → 그 자리에서 계속"까지 더합니다. 다만 같은 실험은 약한 모델은 디버거를 주면 오히려 나빠진다는 것도 보였습니다. 디버거는 도구이지 마법이 아니고, 에이전트에게 그 사용법을 가르쳐야 합니다. 헨즈가 "agent.md 없이는 멍청한 짓을 한다"고 한 것과 같은 이야기입니다.
3장에서 본 매크로는 1990년대에는 '개발자의 생산성 도구'였습니다. 글은 여기에 2026년식 역할을 하나 더 얹습니다. 원문의 해당 문단을 그대로 옮기면 이렇습니다.
그게 지금 훨씬 더 중요해졌다. 프로그램을 가치 있게 만드는 것은 그 뒤에 있는 의견이기 때문이다. 그리고 우리는 소프트웨어 회사가 사용자에게 제품을 직접 바꾸게 하는 세상으로 가고 있다. LLM이 있으면 그게 쉬우니까. 그러니 회사가 자기 제품을 위한 좋은, 의견이 담긴 도메인 언어를 만들어 두면, 사용자가 그 위에 만드는 모든 것이 훨씬 나아진다. 회사의 의견에서 출발하지, 맨바닥에서 출발하지 않기 때문이다.
6.1 ERP 사례: 왜 모든 회사가 ERP를 뜯어고치는가
글이 고른 예는 ERP(전사적 자원 관리)입니다. 좋은 선택입니다. ERP는 "모든 회사가 조금씩 다르게 돌아가서 거의 모두가 결국 고쳐 써야 하는" 소프트웨어의 대명사이기 때문입니다. SAP 도입 프로젝트에서 커스터마이징과 '애드온' 개발이 라이선스 비용을 넘기는 일은 흔하고, 그 커스터마이징 코드는 업그레이드 때마다 깨져서 기업들을 구버전에 묶어 둡니다. 한국의 중견 제조업체가 2010년대에 도입한 ERP를 2026년에도 못 바꾸는 이유의 상당 부분이 그 위에 쌓인 수천 개의 맞춤 로직입니다.
2026년에 그 맞춤 작업을 LLM이 하게 됐다고 합시다. 두 가지 시나리오가 있습니다.
상황
도메인 언어 없이
도메인 언어 위에서
고객의 요청
"우리 회사는 발주 금액이 500만 원을 넘으면 팀장 승인 뒤 재무팀 승인까지 받아야 해. 그런데 긴급 발주는 팀장만으로 끝내고 사후 보고로 처리해."
LLM이 만지는 것
Java/Python 소스 수천 줄 속의 승인 워크플로 클래스, DB 스키마, UI 핸들러. 어디에 승인 단계가 '하드코딩'돼 있는지부터 찾아야 한다.
회사가 정의한 (approval-rule …) 구문. 금액·조건·단계·예외를 선언하는 몇 줄.
변경이 제품을 깨뜨릴 가능성
높다. 긴급 발주의 '사후 보고'를 어디서 기록할지 LLM이 임의로 정하고, 감사 로그를 빠뜨리거나 기존 승인 흐름의 불변 조건을 어긴다.
낮다. 도메인 언어가 '모든 승인에는 감사 기록이 남는다' 같은 회사의 의견을 전개 결과에 자동으로 넣는다.
업그레이드 시
제품 코드가 바뀌면 맞춤 코드가 깨진다.
도메인 언어의 의미가 유지되는 한 고객의 선언은 그대로 돈다.
LLM에게 필요한 맥락
제품 전체 구조
도메인 언어 설명서 몇 쪽 + 고객의 기존 선언
핵심은 오른쪽 열의 "회사의 의견이 전개 결과에 자동으로 들어간다"입니다. 매크로는 사용자가 쓴 짧은 선언을 받아 회사가 정한 방식으로 긴 코드를 만들어 냅니다. 감사 로그, 권한 검사, 트랜잭션 경계 같은 것들은 사용자가 잊어도 매크로가 넣습니다. 글이 "의견에서 출발한다"고 말한 것이 바로 이 메커니즘입니다.
6.2 이 생각은 글만의 것이 아니다: 가소성 있는 소프트웨어
'사용자가 제품을 직접 바꾼다'는 비전은 2025~26년에 여러 곳에서 동시에 나왔습니다.
Ink & Switch의 「Malleable Software」(2025년 6월). 제프리 릿(Geoffrey Litt) 등이 쓴 이 에세이는 "소프트웨어는 완성품(앱)이 아니라 사용자가 고쳐 쓰는 도구여야 한다"고 주장하며 세 원칙을 제시합니다. 완만한 경사(작은 수정은 작게), 앱이 아닌 도구, 공동 창작. 흥미롭게도 이들은 "AI 코드 생성만으로는 가소성의 장벽이 다 풀리지 않는다"고 못 박습니다. 푸드코트에 훌륭한 수셰프를 데려와 봤자 메뉴가 푸드코트라는 비유입니다. 헨즈의 글은 바로 그 빈자리, 즉 LLM이 고칠 수 있는 '재료'를 어떻게 설계하느냐에 답하려는 시도로 읽을 수 있습니다.
Anthropic의 Agent Skills(2025년 10월). 폴더 하나에 담긴 지침서와 스크립트로 에이전트의 행동을 확장하는 체계입니다. 헨즈 자신이 해커뉴스 댓글에서 "LLM이 Common Lisp에 갑자기 능숙해진 게 아니라, 내가 쓴 스킬 파일과 agent.md를 읽고 추론하는 능력이 좋아진 것"이라고 말했는데, 스킬이 곧 '회사의 의견을 담는 그릇' 역할을 하는 셈입니다.
카파시의 「Software 3.0」(2025년 6월). "프롬프트가 프로그램"인 시대에 소프트웨어를 사람이 아니라 에이전트를 위해 설계하라는 제안(llms.txt 같은)도 같은 줄기입니다.
제약된 언어가 LLM을 돕는다는 연구. 2023년 NeurIPS의 「Grammar Prompting」은 DSL의 문법(BNF)을 프롬프트에 넣으면 LLM의 DSL 생성 정확도가 오른다는 것을 보였고, 2025년 PLDI의 「Type-Constrained Code Generation」은 타입 규칙으로 생성을 제약하면 컴파일 오류가 절반 이하로 준다고 보고했습니다. 좁고 잘 정의된 언어일수록 LLM이 덜 틀린다는 것은 이제 꽤 단단한 결과입니다.
그러니 글의 2차 주장은 "Lisp여야 한다"보다 "제품에 도메인 언어라는 층을 두라"로 읽는 것이 정확합니다. 그 층을 만드는 데 Lisp 매크로가 가장 싸고 자연스러운 도구라는 것이 글의 입장이고, Ruby의 DSL 문화나 TypeScript의 타입 수준 프로그래밍, 설정 언어(Cue, Dhall), 심지어 잘 설계된 JSON 스키마로도 그 층의 일부는 만들 수 있다는 것이 반론입니다. 다만 "LLM이 쓴 선언을 받아 회사의 의견대로 전개한다"를 언어 안에서 공짜로 하는 것은 매크로가 유일합니다.
글의 3차 주장은 가장 숫자에 가깝고, 그래서 가장 많이 공격받았습니다. 원문은 이렇습니다.
Lisp 프로그램은 매크로가 반복 패턴을 언어의 일부로 추상화해 주기 때문에 훨씬 간결한 경우가 많다. 프로그램이 커질수록 차이도 커진다. 내 경험으로는 Common Lisp로 만든 앱이 Python 버전보다 6~7배 짧게 끝난다. LLM에게 코드가 적다는 것은 토큰이 적다는 것이고, 토큰은 돈이니 개발비가 준다. 그리고 프로그램의 더 큰 부분이 컨텍스트 창에 들어간다.
7.1 '6~7배'는 어디서 온 숫자인가
저자 한 사람의 경험입니다. 글은 어떤 앱인지, 몇 줄인지 밝히지 않았고, 해커뉴스에서 가장 많이 요구된 것도 "데이터를 보여 달라"였습니다. 그렇다면 공개된 연구는 뭐라고 할까요.
에란 갓(Erann Gat), 「Lisp as an Alternative to Java」(2000). 프레첼트(Prechelt)가 같은 문제를 C·C++·Java·Perl·Python·Rexx·Tcl로 풀게 한 2000년 비교 연구에 Lisp 프로그램 16개를 추가해 비교했습니다. 개발 시간은 Lisp 2~8.5시간, C/C++ 3~25시간, Java 4~63시간이었고, 코드 길이는 Lisp 중앙값 134줄 대 C/C++/Java 중앙값 244줄, 실행 시간 중앙값은 Lisp 30초 대 C/C++ 54초였습니다. 즉 Lisp가 짧고 빠르긴 했지만 길이로는 2배 안팎이지 6~7배는 아닙니다. Python은 이 비교에 없었습니다.
난츠·푸리아(Nanz & Furia), 「A Comparative Study of Programming Languages in Rosetta Code」(ICSE 2015). 로제타 코드의 745개 과제를 푼 8개 언어 7,087개 프로그램을 비교했습니다. Java 프로그램은 함수형·스크립트 언어보다 평균 2.2~2.9배 길었고, Python은 함수형 언어보다도 1.2~1.6배 짧아 가장 간결한 언어였습니다. Lisp는 비교 대상에 없었습니다. Gat의 1.8~2.3배를 이 척도에 얹으면 Common Lisp는 Python·Haskell과 같은 띠에 들어갑니다. 즉 "Common Lisp가 Python보다 수 배 짧다"를 뒷받침하는 공개 연구는 없습니다.
커밋당 줄 수(RedMonk, 2013). 오픈소스 커밋 데이터로 언어별 '커밋당 변경 줄 수'를 매겨 표현력을 추정한 분석에서 Clojure는 7위로 상위였지만 Common Lisp는 23위, Python은 27위로 거의 같은 자리였습니다.
토큰 관점. 코드는 대체로 줄당 10토큰 안팎이고, 산문보다 문자당 토큰이 많습니다(코드 약 3자/토큰, 영어 산문 약 4자/토큰). 괄호가 토큰을 낭비한다는 통념은 틀렸습니다. 저희가 OpenAI 토크나이저(cl100k·o200k)로 재 보니 닫는 괄호는 1~4개가 붙어 있어도 토큰 1개였습니다. 다만 함수 하나 크기에서는 Common Lisp가 Python보다 짧지 않았습니다.
같은 함수를 관용적으로 썼을 때 (토큰 수)
Python
Common Lisp
JavaScript
피보나치
30
32
36
퀵소트
74
80
74
단어 빈도 세기
40
88
73
즉 토큰 이점이 있다면 그것은 문법이 아니라 프로그램 규모에서 매크로가 반복을 흡수하는 데서 나와야 하고, 그 크기를 잰 사람은 아직 없습니다. 2024년 「AI Coders Are Among Us」 논문은 Python 문법을 LLM용으로 다시 설계한 SimPy로 같은 AST를 10~13% 적은 토큰으로 표현했는데, 이것이 '문법만 바꿔서' 얻을 수 있는 절감의 현실적인 크기입니다.
해커뉴스에서 이 대목을 가장 날카롭게 요약한 사람은 사이트 운영자 dang이었습니다. "더 적은 토큰으로 프로그램을 쓰는 것은 Lisp의 오래된 장점이다. 다만 여기서 토큰은 옛 뜻, 즉 줄 수가 아니라 AST 크기로 잰 프로그램 크기를 말한다." 즉 Lisp 공동체가 수십 년간 주장해 온 '간결함'과 LLM 청구서의 '토큰'이 같은 단위인지는 따져 봐야 한다는 것입니다.
7.2 그래도 창에 들어가는가는 중요하다
그렇다면 글의 3차 주장은 과장일까요. 비율의 숫자는 과장일 수 있지만 방향은 맞고, 그 이유는 비용이 아니라 시야에 있습니다.
2026년 10월 현재 주요 모델의 컨텍스트 창은 100만 토큰이 표준이 됐습니다(Claude Opus·Sonnet 5.5, Gemini 3.1 Pro, DeepSeek V4가 100만, GPT-5.5는 표준 요금 구간이 27만 2천). 10만 줄짜리 Python 프로젝트는 약 100만 토큰이니 이론상 들어갑니다. 그런데 2025년 7월 Chroma의 「Context Rot」 보고서가 보였듯, 18개 모델 모두 창이 남아 있어도 입력이 길어질수록 정확도가 꾸준히 떨어졌고, 긴 문맥에 묻힌 사실은 30% 넘게 놓쳤습니다. 2023년의 「Lost in the Middle」은 정답이 입력 가운데 있을 때 성능이 U자로 꺼지는 것을 보였습니다. 저희도 작년에 긴 맥락이 독이 된다에서 다뤘습니다.
그러니 "창에 들어간다"는 필요조건일 뿐이고, 진짜 목표는 모델이 실제로 소화할 수 있는 양에 가깝게 만드는 것입니다. 글이 든 버그의 원인, "나머지를 보지 못한 채 한 부분을 바꾼다"는 창을 넘어서 생기기도 하지만 창 안에서도 생깁니다. 코드가 반으로 줄면 그 확률이 반으로 주는 것이 아니라, 모델이 '전체를 한 번에 붙들 수 있는' 경계 안으로 들어오느냐 마느냐가 갈립니다.
아래 계산기에서 Python 기준 줄 수, 압축 비율, 모델을 바꿔 가며 그 경계를 찾아보세요. 비율을 글의 6~7배가 아니라 보수적인 1.5~2배로 두어도, 중형 코드베이스에서 '전체가 한 번에 들어가는가'가 뒤집히는 구간이 있습니다. 가격은 2026년 10월 8일 각 사 공개 요금(입력, 캐시 미적용)입니다.
⚠️
비용 계산에서 흔히 빠뜨리는 것 둘. 첫째, 프롬프트 캐시. Claude의 캐시 히트는 입력 요금의 5~10%라서, 같은 코드베이스를 반복해서 읽는 에이전트의 실제 비용은 계산기의 '캐시 미적용' 값보다 훨씬 낮습니다. 둘째, 토크나이저 변화. Anthropic은 Claude 4.7 이후 모델이 새 토크나이저로 같은 텍스트에서 약 30% 더 많은 토큰을 만든다고 공지했습니다. 언어 선택보다 모델 세대가 토큰 수를 더 크게 바꿀 수 있습니다.
글의 마지막 세 문단은 Common Lisp의 전통적 약점 세 가지를 뒤집습니다. 하나씩 사실 확인을 곁들여 봅니다.
8.1 "표준이 1994년 이후 안 바뀌었다. 나는 이 기능이 좋다."
사실입니다. Common Lisp 표준은 1981년 DARPA의 주도로 MacLisp 계열 방언들을 합치는 작업에서 시작해, 1984년 가이 스틸의 『Common Lisp the Language』, 1986년 ANSI X3J13 위원회를 거쳐 1994년 ANSI X3.226-1994로 확정됐습니다. 이후 1999년과 2018년에 '재확인'만 됐고 개정은 없었습니다. 32년 전 코드가 오늘의 SBCL에서 그대로 돕니다.
다른 언어라면 이것은 치명적 약점입니다. 유니코드도, 스레드도, 네트워크도 표준에 없습니다. 그런데 Lisp에서는 두 가지 이유로 치명적이지 않았습니다. 첫째, 매크로 덕에 새 '구문'은 라이브러리로 추가되므로 언어 개정 없이도 언어가 자랍니다. 둘째, 구현체들이 사실상의 확장(스레드, 소켓, FFI)을 거의 같은 모양으로 제공하고, 그 위에 이식성 계층(bordeaux-threads, usocket, CFFI)이 깔려 있습니다.
글은 여기에 2026년식 이유를 하나 더 붙입니다. 사용자가 LLM으로 제품을 고치는 세상에서는 그 아래 언어가 절대 움직이지 않아야 사용자가 쌓은 것이 안 깨진다는 것입니다. Python 2에서 3으로의 10년짜리 이주, Node의 연 2회 메이저 릴리스, React의 패러다임 교체를 떠올리면 "안 바뀌는 것이 기능"이라는 말이 억지만은 아닙니다.
8.2 "Quicklisp에는 수천 개뿐, npm에는 수백만 개"
숫자는 이렇습니다.
생태계
규모 (2026년 10월 8일 기준)
npm 레지스트리
약 446만 패키지
Quicklisp
2,382 프로젝트(6,207 시스템), 배포판 마지막 갱신 2026년 1월 1일
Ultralisp (5분마다 갱신되는 대안 배포)
약 2,400 프로젝트
ocicl (OCI 레지스트리 기반 대안, 활발히 개발 중)
별도
글의 "수천 개 대 수백만 개"는 맞습니다. 그리고 글은 그것이 더 이상 문제가 아니라고 주장하며 두 가지 근거를 댑니다. 하나는 공급망 위험이고, 다른 하나는 LLM이 라이브러리를 써 주거나 옮겨 준다는 것입니다.
첫 번째 근거는 2025년에 아주 구체적인 얼굴을 얻었습니다.
2025.8.26
Nx 's1ngularity'. 주간 설치 600만 건의 빌드 도구 Nx에 악성 버전이 올라갔다. 설치 후 스크립트가 개발자 PC의 비밀 정보를 긁어 공개 GitHub 저장소로 올렸는데, 특이하게도 로컬에 설치된 Claude·Gemini CLI를 이용해 파일을 뒤졌다. 4시간 동안 살아 있었다.
2025.9.8
chalk·debug 탈취. 피싱으로 관리자 계정을 뺏어 주간 다운로드 합계 20억 건이 넘는 패키지 18개(debug 3.6억, chalk 3억)에 브라우저 암호화폐 지갑 가로채기 코드를 심었다. 2시간 만에 발견됐지만 그 사이 npm install을 돌린 모든 빌드가 감염됐다.
2025.9.15
Shai-Hulud 1차. 자기복제 웜. 감염된 패키지가 개발자의 npm 토큰으로 그 개발자의 다른 패키지에 자신을 퍼뜨렸다. 187개 이상 패키지, CrowdStrike 네임스페이스 포함.
2025.11.21
Shai-Hulud 2.0. 약 800개 악성 패키지, 훔친 자격 증명이 올라간 GitHub 저장소 2만 5천 개, GitHub 토큰 775개·AWS 373개·GCP 300개·Azure 115개. Zapier·PostHog·Postman·AsyncAPI처럼 스캔한 클라우드 환경의 27%가 쓰는 라이브러리가 표적이었다.
2026년 1월 Sonatype의 연례 보고서는 2019년 이후 누적 악성 패키지가 123만 개, 오픈소스 악성코드가 전년 대비 75% 증가했다고 집계했고, 덧붙여 GPT-5에게 의존성을 추천하게 했을 때 버전의 27.8%를 지어냈으며 그중에는 실제 악성 패키지도 있었다고 보고했습니다. 글의 문장 "오늘날 대부분의 프로그램은 계속 뚫리는 패키지에서 온 수백만 줄에 의존한다"는 2025년 하반기 기준으로 과장이 아닙니다. 2019년 USENIX Security의 「Small World with High Risks」가 경고했던 구조, 즉 소수 관리자 계정이 npm 패키지 다수에 코드를 넣을 수 있는 구조가 그대로 현실이 됐습니다.
두 번째 근거는 흥미롭지만 아직 증거가 약합니다. "LLM은 코드 이식에 정말 뛰어난 것 같다"는 저자의 관찰은 많은 개발자의 경험과 일치하지만, 이식된 라이브러리를 누가 검증하고 유지하느냐는 질문이 남습니다. 해커뉴스의 한 댓글은 이렇게 짚었습니다. "빠른 재정의는 빠른 검증이 아니고, 디버거에 들어가는 것이 복구의 보장이 아니며, 생성된 코드가 자동으로 검증된 라이브러리가 되는 것은 아니다." 다만 방향은 분명합니다. 2026년에 '의존성 수'는 비용 절감의 지표에서 공격 표면의 지표로 바뀌었고, 그 기준으로 보면 수천 개짜리 생태계는 약점이기만 한 것이 아닙니다.
8.3 "면접에서 Common Lisp를 배우게 하라"
글의 마지막 반전은 구인입니다. "Lisp를 아는 사람이 없다"는 반론에 글은 "어차피 배우는 데 뛰어난 사람을 뽑고 싶은 것 아니냐, 면접에서 Lisp를 배우게 하면 그게 걸러진다"고 답합니다.
이것은 폴 그레이엄이 2001년에 했던 주장의 반복이고, 반론도 그때와 같습니다. 그레이엄 자신이 「Beating the Averages」에서 썼듯 Viaweb은 "경쟁사가 못 쓰는 언어"로 이겼지만, 야후에 인수된 뒤 그 코드는 C++와 Perl로 다시 쓰였습니다. 소수 천재의 언어는 소수일 때만 유리합니다. 다만 2026년에는 변수가 하나 더 있습니다. 배우는 쪽이 사람만이 아니라는 것입니다. 헨즈가 댓글에서 밝혔듯 그는 스킬 파일로 에이전트에게 Lisp 작업법을 가르쳤고, 그것이 통했습니다. 구인난이 '사람을 못 구한다'에서 '에이전트에게 가르칠 설명서를 써야 한다'로 바뀐다면, 글의 주장은 겉보기보다 덜 무모합니다.
9. 반론: 394개의 댓글이 따진 것
글은 2026년 10월 6일 새벽(UTC) 해커뉴스에 올라와 이틀 만에 291점, 댓글 394개를 모았습니다. 올린 사람은 저자 본인이었고, 첫 댓글도 "토론 환영"이라는 저자의 것이었습니다. 반면 같은 날 Lobsters에 올라간 링크는 음수 점수에 네 번 신고당해 사실상 거부됐습니다. 두 공동체의 반응 차이 자체가 이 글의 성격을 말해 줍니다. 논쟁적이고, 증거가 얇고, 그런데도 생각하게 만드는 글. 댓글의 반론을 유형별로 정리하면 다섯 가지입니다.
9.1 "다들 자기 언어가 LLM 시대의 최고라고 한다"
가장 큰 하위 스레드(답글 61개)는 이 메타 비판이었습니다.
모두가 "LLM이 더 잘 다루니까 내 애완 언어가 이제 최고"라는 나름의 이유를 갖고 있는 것 같다. JavaScript/Python은 코드가 가장 많아서, Rust는 컴파일러 피드백이 좋아서, Go는 단순해서. 이쯤 되면 어떤 언어도 "LLM 때문에" 최고는 아니라고 본다.
실제로 2025년 8월에는 「타입 언어가 바이브 코딩에 더 맞다」(Rust 옹호, 해커뉴스 274점)가 있었고, 2026년 8월에는 구글이 「Go는 AI 보조 소프트웨어 공학에 이상적인 언어」라는 글을 냈으며(444점, "시니어가 쓰든 주니어가 쓰든 LLM이 쓰든 코드가 똑같이 생겼다"는 것이 논거였습니다), 같은 달 D 언어 블로그는 「언어의 가소성이 그 어느 때보다 중요하다」를 썼으며, 조 마셜(Joe Marshall)의 「왜 Lisp로 바이브 코딩하나」(155점)가 있었습니다. 헨즈의 글은 마셜의 여덟 가지 이유 중 4~8번(동형성, 매크로=컨텍스트 압축, REPL 내성, 조건 시스템, 재시작 없음)을 두 달 뒤 거의 그대로 반복합니다. 인용은 없었습니다.
이 비판은 옳지만 글을 무효화하지는 않습니다. 모든 언어 옹호자가 "LLM 시대의 병목이 어디인가"를 자기 언어의 강점에 맞춰 정의하고 있다면, 독자가 할 일은 병목의 정의 자체를 따져 보는 것입니다. 글의 정의(피드백 루프)는 Go 진영의 정의(단순성·일관된 스타일)나 Rust 진영의 정의(컴파일러의 명확한 오류)와 양립 가능합니다. 셋 다 맞을 수 있고, 어느 것이 더 큰지는 프로젝트에 따라 다릅니다.
9.2 "LLM은 학습 데이터가 적은 언어에서 약하다"
가장 실증적인 반론입니다. 데이터가 뒷받침합니다.
모델 (MultiPL-T, OOPSLA 2024)
Racket 기본
Racket 보강 학습 후
Lua 기본
Julia 기본
StarCoderBase 15B
11.8
21.0
26.6
21.1
Code Llama 34B
15.9
29.1
38.1
31.8
Code Llama 70B
21.9
33.1
41.7
41.9
표는 카사노(Cassano) 등의 「Knowledge Transfer from High-Resource to Low-Resource Programming Languages for Code LLMs」(OOPSLA 2024)에서 가져온 HumanEval 통과율(pass@1, %)입니다. Lisp 계열인 Racket은 같은 모델에서 Lua나 Julia의 절반 수준이었습니다. 앞선 MultiPL-E 연구(2022)에서는 Codex가 Racket 문제에 아예 마크다운을 생성하는 일이 잦았는데, 첫 줄의 #lang racket이 마크다운 제목처럼 보였기 때문입니다. 이유는 단순합니다. 학습 말뭉치 The Stack에서 Python은 64GB, Scheme과 Racket을 합쳐도 0.5GB였습니다. 연구진이 Python 코드를 Racket으로 번역해 4만 개 함수를 더 학습시키자 점수가 거의 두 배가 됐는데, 이는 격차가 언어의 본질이 아니라 데이터 양의 문제라는 뜻이기도 합니다.
2026년 프런티어 모델에서 이 격차가 얼마나 남아 있는지는 공개 벤치마크가 없습니다. Aider의 폴리글랏 벤치마크도, AutoCodeBench의 20개 언어도 Lisp 계열을 포함하지 않습니다. 남은 것은 상반된 증언입니다. 한쪽에는 Claude Code 저장소에 2025년 10월 올라온 이슈 「Lisp 코드 생성에서 잦은 괄호 오류」(응답 없이 자동 닫힘), "괄호 하나 짝을 못 맞춘다", "매크로를 만드는 매크로에서 (let ((( 같은 여섯 손가락을 만들었다"는 보고가 있고, 다른 쪽에는 "Sonnet 3.7 이후로 그런 문제는 없다", "agents.md에 몇 줄 넣으면 사라진다", 2026년 10월에도 갱신되는 cl-mcp(괄호 자동 수리와 스택 프레임 열람을 제공하는 Common Lisp용 MCP 서버)를 쓰면 "괄호 문제를 겪은 적이 없다", 사이트 운영자 dang의 "요즘 LLM은 Common Lisp에 뛰어나고, 롱테일 끝자락의 Arc마저 잘 쓴다"는 증언이 있습니다. 헨즈 본인의 진단이 가장 균형 잡혀 보입니다. "LLM이 CL을 더 잘하게 된 게 아니라, 내 스킬 파일과 agent.md를 읽고 추론하는 능력이 훨씬 좋아졌다."
9.3 "그건 Lisp만의 것이 아니다"
살아 있는 이미지와 재개 가능한 디버거가 Common Lisp 고유의 것이냐는 반론입니다. 댓글에서 거론된 후보만 해도 Smalltalk(특히 Pharo), Clojure, Erlang/Elixir, Julia, Racket, Forth, 그리고 "Visual Studio는 90년대부터 C++에서 '편집 후 계속'을 지원했다", "Python과 Node도 예외에서 스택을 풀지 않고 멈출 수 있다"가 있었습니다.
부분적으로 맞습니다. 4장과 5장에서 봤듯 이미지 기반 개발의 원조는 Smalltalk와 Interlisp이고, Erlang의 핫 코드 스왑은 통신 장비에서 수십 년 검증됐으며, Clojure 공동체는 nREPL을 에이전트에 연결하는 데서 Common Lisp 공동체보다 앞서 있습니다(2025년 5월 공개된 clojure-mcp는 해커뉴스 202점을 받았고, 한 댓글은 에이전트가 "nREPL을 제2의 천성처럼 쓴다"고 썼습니다). 다만 "셋을 다 하는가"로 좁히면 후보가 줄어듭니다. 재시작 없는 재정의, 스택을 풀지 않는 조건 처리와 재시작, 그리고 함수 단위 네이티브 컴파일을 표준 언어 명세 안에서 다 갖춘 것은 Common Lisp와 Smalltalk 정도입니다. Erlang은 "죽게 두고 다시 띄워라"는 반대 철학이고, Python의 사후 디버거(pdb.pm())는 스택을 볼 수는 있지만 그 자리에서 값을 고쳐 재개하지는 못합니다.
9.4 "이미지는 숨은 상태다"
가장 깊은 기술적 반론입니다. "Common Lisp가 이미지 기반이라는 것은 곧 코드에 나타나지 않는 암묵적 상태가 잔뜩 있다는 뜻이고, 그것은 LLM과 일하는 데 큰 단점이다. 시스템의 상태를 프로그램 텍스트에서 재현할 수 없기 때문이다."
이것은 Lisp 공동체 안에서도 오래된 논쟁입니다. 이미지에서 함수를 지우고, 변수를 바꾸고, 클래스를 재정의하다 보면 "소스 파일을 처음부터 로드하면 안 도는" 상태가 됩니다. 사람도 헷갈리는데 에이전트는 더 헷갈립니다. 실용적인 답은 Clojure 공동체가 정리한 "REPL은 실험실, 파일은 진실" 규율입니다. 이미지에서 실험하되, 통한 것은 반드시 파일에 쓰고, 주기적으로 이미지를 새로 띄워 파일만으로 재현되는지 확인합니다. 헨즈가 "agent.md 없이 이미지 작업을 시키면 멍청한 짓을 한다"고 한 것도 이 규율을 에이전트에게 가르쳐야 한다는 뜻입니다.
9.5 "매크로는 읽기를 해친다"와 "글쓴이가 누구인가"
D 언어를 만든 월터 브라이트(Walter Bright)는 "이래서 Lisp가 퍼지지 못한다. 프로그래머마다 매크로라는 형태로 자기만의 임시방편 언어를 만든다"고 썼고, 한 Clojure 사용자는 "LLM에게 매크로는 못 쓰게 한다. 불투명해진다"고 했습니다. 6장의 ERP 논증은 정확히 이 비판의 뒷면입니다. 매크로가 '회사의 의견'을 담는 그릇이 되려면, 그 매크로는 소수가 신중하게 설계하고 문서화한 것이어야 합니다. 모두가 매크로를 쓰는 코드베이스는 글이 말한 도메인 언어가 아니라 방언의 난립입니다.
마지막으로 저자에 대한 공격이 있었습니다. 하버드 학부생이고, 공개된 Common Lisp 프로젝트가 없으며, 글의 커밋에 Claude가 공동 저자로 올라 있다는 것입니다(사이트 저장소의 커밋 메시지가 공개돼 있습니다). 저자가 발행 당일 '병원 사례'를 삭제하는 등 글을 고친 것도 확인됩니다. 반대로 Lobsters의 한 독자가 AI 탐지기를 돌려 "100% 사람이 쓴 글"이라는 결과를 얻기도 했습니다. 이 글은 그 논쟁에 끼어들지 않겠습니다. 다만 두 가지는 적어 둡니다. 글의 논증은 저자의 이력과 무관하게 검증 가능한 것들이고, 저희가 이 특집에서 한 일이 그 검증입니다. 그리고 2026년에 "Claude와 함께 쓴 글"이라는 사실은 더 이상 글의 가치를 정하는 기준이 아닙니다. 이 특집도 그렇게 쓰였습니다.
이 글이 화제가 된 진짜 이유는, Lisp가 아니라 2026년의 조건을 정확히 짚었기 때문입니다. 그 조건은 이렇습니다.
Anthropic은 2026년 9월, 사내에서 합쳐지는 코드의 약 80%를 Claude가 쓰고, 6개월 사이 CI 작업량이 25배, 분기당 출하 코드가 2021~25년 평균의 8배가 됐다고 공개했습니다. 그리고 CI가 병목이 되어 테스트 영향 분석을 다시 설계해야 했다고 썼습니다.
프로젝트 관리 도구 Linear는 2026년 9월, 연초 이후 테스트 스위트가 4배 가까이 커지고 주당 2,000개씩 테스트가 늘어 PR 대기 시간이 6분을 넘자 CI를 재설계했다고 밝혔습니다. "에이전트 덕에 코드를 내는 속도는 기하급수적으로 빨라졌지만 검증은 따라오지 못했다"는 것이 그들의 진단입니다.
Cursor는 2026년 8월 클라우드 에이전트의 환경 부팅 시간을 줄이는 '빌드' 기능을 내며 "에이전트는 자기가 도는 환경만큼만 유능하다"고 썼습니다.
메타 연구 기관 METR의 2025년 7월 무작위 대조 실험에서는 숙련 오픈소스 개발자가 AI 도구를 쓸 때 오히려 19% 느려졌고, 2026년 2월의 후속 설계에서도 유의미한 속도 향상을 확인하지 못했습니다. 코드를 쓰는 시간이 줄어도 검증·대기·수정 루프가 그 이득을 먹어 치운다는 해석이 가능합니다.
마이크로소프트 연구소의 debug-gym(2025년 3월)은 에이전트에게 Python 디버거(pdb)를 도구로 주자 SWE-bench Lite에서 Claude 3.7 Sonnet의 해결률이 37.2%에서 48.4%로 올랐다고 보고했습니다. 반면 약한 모델은 디버거를 주면 오히려 나빠졌습니다. "실패 지점에서 상태를 볼 수 있는가"가 에이전트 성능을 바꾼다는 글의 2번 주장에 대한 가장 직접적인 증거이자, "모델이 그걸 쓸 줄 알아야 한다"는 단서입니다.
Anthropic의 2025년 11월 「Code execution with MCP」는 도구 호출 결과를 모델에 그대로 흘리는 대신 코드 실행 환경 안에서 처리하게 하면 한 워크플로의 토큰이 15만에서 2천으로 줄었다고 보고했습니다. 에이전트에게 REPL을 주는 것이 토큰 경제에서도 유리하다는 뜻입니다.
이 조건 아래에서 글의 네 가지 성질을 Lisp 밖에서 얼마나 가져올 수 있는지 정리하면 이렇습니다.
pdb/ipdb 사후 디버거(보기만), VS 'Edit and Continue', Elixir IEx의 pry, 시간 여행 디버거(rr)
'고친 뒤 그 자리에서 재개'는 대부분 불가
도메인 언어
매크로로 언어 안에서
Ruby DSL, TypeScript 타입 수준 프로그래밍, 설정 언어, 그래머 프롬프팅, Agent Skills
사용자 선언을 '회사 의견대로 전개'하는 층을 따로 만들어야 함
전체가 창에 들어가는 코드
간결함(정도는 논쟁 중)
모듈 경계 정리, 코드맵·요약 제공, 프롬프트 캐시, 1M 창
Context Rot는 언어와 무관하게 남음
세 번째 열이 꽤 채워진다는 것이 이 표의 요점입니다. Lisp로 갈아타지 않아도 글의 논증 대부분은 도구와 규율로 가져올 수 있습니다. 그리고 둘째 행의 격차, 즉 '고친 뒤 그 자리에서 재개'만이 2026년 현재 Common Lisp(와 Smalltalk)가 거의 독점하는 성질입니다. 글이 "내가 아는 한 이 셋을 다 하는 주류 언어는 Common Lisp뿐"이라고 한 것은 이 한 칸 때문입니다.
한국의 맥락에서
한국 개발 생태계에서 Lisp 계열은 사실상 보이지 않습니다. 스택오버플로 2025년 설문에서 Lisp 사용률은 전 세계 2.4%였고, TIOBE 2026년 9월 지수에서 Lisp는 0.42%로 30위 밖, Clojure·Scheme·Racket은 50위 밖입니다. 국내에서는 그린랩스가 Clojure를 주력으로 써 clojure.org의 도입 기업 목록에 오른 유일한 한국 회사이고, 'Lisp Korea' GitHub 조직이 SICP·On Lisp 스터디 기록을 남겨 둔 정도입니다. 이 글도 국내에는 조용히 들어왔습니다. 긱뉴스에 10월 7일 「Common Lisp이 이제 최고의 프로그래밍 언어인 이유」로 소개됐지만 댓글은 하나였고, 그 댓글은 해커뉴스의 결론을 그대로 옮겼습니다. "누구나 자기가 좋아하는 언어가 LLM 시대에 최고인 이유를 찾아내는 듯하다."
그러나 글이 전제한 조건은 한국에도 그대로 옵니다. 스택오버플로 2026년 설문에서 개발자의 80%가 하루 1시간 이상 AI 도구를 쓴다고 답했고, 87%가 그 결과를 어느 정도 신뢰하지만 48%는 '검증할 수 있을 때만' 신뢰한다고 했습니다. 검증이 병목이라는 뜻입니다. 그러니 이 글을 "Lisp를 도입하자"로 읽는 한국 팀은 거의 없을 것이고, 그래야 합니다.
대신 이렇게 읽기를 권합니다. 2026년 국내 대기업과 스타트업이 에이전트 코딩을 전면 도입하면서 가장 먼저 부딪히는 것이 CI 비용과 대기 시간입니다. 코드를 쓰는 시간이 사라진 자리에 빌드·테스트·재현 시간이 그대로 남아 있고, 에이전트는 그 시간에 토큰을 태웁니다. 글의 질문, "당신의 피드백 루프 한 바퀴는 몇 초인가"는 언어와 무관하게 모든 팀이 올해 답해야 할 질문입니다.
11. 실무 체크리스트: 어떤 언어를 쓰든
⏱
에이전트의 한 바퀴를 재라
에이전트 로그에서 '코드 생성 → 결과 확인'까지 한 바퀴의 벽시계 시간을 재고, 그중 생성이 차지하는 비율을 구한다. 생성이 30% 미만이면 병목은 언어 모델이 아니라 빌드·테스트·재현이다. 거기에 투자한 1분이 모델 교체보다 싸다.
🔁
재시작 없는 수정 경로를 하나는 만들어라
Jupyter 커널, nREPL, HMR, 핫 스왑, 무엇이든 좋다. 에이전트가 '프로세스를 죽이지 않고' 함수를 바꿔 다시 부를 수 있는 길을 열고, 그 길을 agent.md에 적어라. 단, "파일이 진실"이라는 규율도 함께 적어라.
🩺
실패를 로그가 아니라 상태로 넘겨라
예외가 나면 트레이스백 텍스트만 돌려주지 말고, 실패 지점의 지역 변수와 입력을 구조화해 에이전트에게 넘겨라. debug-gym의 결과처럼 강한 모델은 이것으로 해결률이 10포인트 이상 오르고, 약한 모델은 오히려 헷갈린다. 모델 등급에 맞춰 켜라.
🧱
사용자가 고칠 '층'을 설계하라
제품의 어떤 부분을 고객이 LLM으로 바꾸게 할지 정하고, 그 부분을 선언적 DSL·스킬·스키마로 좁혀라. 매크로가 없어도 '선언을 받아 회사 규칙대로 전개하는 코드'는 쓸 수 있다. 감사 로그·권한·트랜잭션처럼 고객이 잊어도 되는 것을 그 전개기에 넣어라.
📏
의존성 수와 코드 크기를 보안·비용 지표로 보라
npm audit의 취약점 수가 아니라 전이 의존성 '개수'를 대시보드에 올려라. 2025년의 공급망 웜은 취약한 패키지가 아니라 많은 패키지를 노렸다. 그리고 에이전트가 한 번에 붙드는 모듈의 토큰 수를 재서, 모델이 소화하는 경계 안에 두어라.
맺으며: "항상 그랬다"
해커뉴스 댓글 하나가 이 글의 운명을 요약했습니다. 두 우주비행사가 지구를 내려다보는 밈을 빌려, "우주비행사 1: 그러니까… 이제 Lisp가 최고의 언어라고? 우주비행사 2: 항상 그랬어."
Lisp 공동체는 60년 동안 같은 말을 해 왔습니다. 코드는 데이터다, 프로그램은 살아 있다, 에러는 대화다, 언어는 쌓아 올리는 것이다. 세상은 대체로 듣지 않았습니다. 리처드 가브리엘이 1991년 「Worse is Better」에서 분석했듯, 단순하고 거친 쪽이 완전하고 올바른 쪽을 이겼습니다. 사람이 코드를 쓰는 세상에서는 그랬습니다.
헨즈의 글이 던진 질문은 그 조건이 바뀌었느냐는 것입니다. 코드를 쓰는 비용이 0에 가까워지면, 이기는 것은 '쓰기 쉬운 언어'가 아니라 '쓴 것을 가장 빨리 확인하고 고칠 수 있는 환경'일지 모릅니다. 그 환경을 Common Lisp가 1994년에 이미 표준으로 갖고 있었다는 것은 역사의 농담이고, 그것을 2026년에 다시 꺼내 보게 된 것은 LLM의 공입니다.
다음에 프로그램을 쓸 때 Common Lisp를 쓸지는 여러분의 몫입니다. 다만 다음에 에이전트가 빌드를 기다리는 3분 동안, 이 글을 떠올리시기 바랍니다.
Erann Gat, Lisp as an Alternative to Java, Intelligence 11(4), 2000; Lutz Prechelt, "An Empirical Comparison of Seven Programming Languages," IEEE Computer, 2000; Sebastian Nanz, Carlo A. Furia, "A Comparative Study of Programming Languages in Rosetta Code," ICSE 2015.