
TECH BLOG
기술 블로그
AI 기술 인사이트와 엔지니어링 경험을 공유합니다.
EDITOR'S PICK
에디터 추천
[특집] 722편의 원고 — OpenAI가 하룻밤에 공개한 372개의 '해결된' 수학 문제, 그 저장소를 열어 보다
2026년 10월 6일 밤, OpenAI는 일곱 문단짜리 글 「수학에서의 AI 진전을 공유합니다」와 함께 GitHub 저장소 하나를 열었다. 미공개 내부 모델이 쓴 수학 원고 722편, 결과 계열 372개. 준(準) 리만 가설, 4차원 카케야 추측, 행렬 곱셈 지수 2.25, 유일 게임 추측, 톰프슨 군 F의 비순종성 — 각각이 사람이 했다면 경력을 통째로 바칠 만한 문제들이 '거의 전부 프롬프트 하나, 에이전트 하나, 평균 세 시간'으로 나왔다고 적혀 있다. 이 글은 저장소를 직접 열어 README·카탈로그·Lean 라이브러리·추론 요약 10건을 읽고, 헤드라인 결과를 비전공자도 이해할 수 있게 풀고, '검증됨'과 '이해됨' 사이의 거리를 재고, 사흘간 쏟아진 수학자들의 반응('즉시 필즈상'에서 '힘의 시연'까지)을 지도에 놓는다. 그리고 하루 전 같은 블로그에 실린 아비가드의 편지와 겹쳐 읽는다.
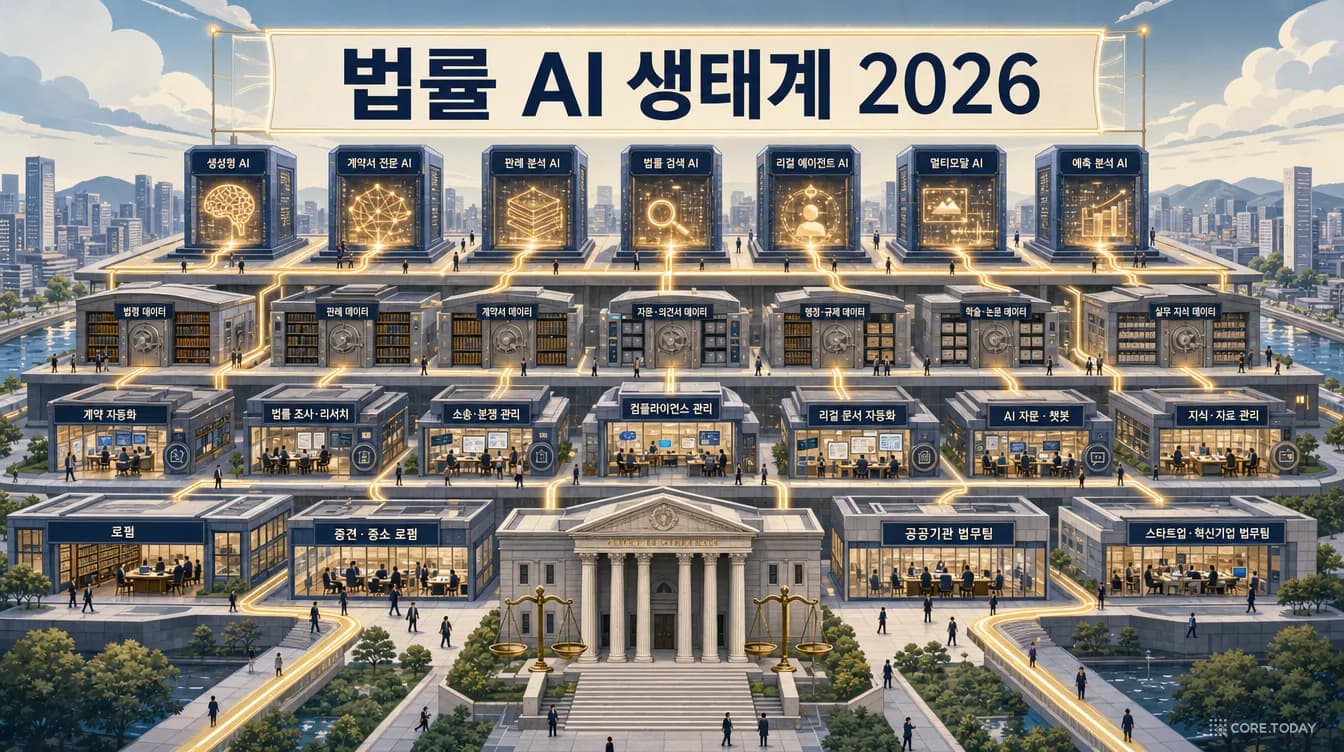
법률 AI 생태계 지도 2026 — 모델 회사는 법률로 내려오고, 법원은 검증을 요구하고, 돈은 '책임질 수 있는 결과물'로 모인다
2026년 2월 3일, Anthropic이 법률 업무 플러그인 하나를 내놓자 Thomson Reuters 주가가 하루에 16% 빠졌습니다. 그런데 반년 뒤 그 회사의 법률 매출은 10% 늘었고, 같은 해 법률 AI 스타트업 Harvey의 몸값은 80억 달러에서 155억 달러로 뛰었습니다. 한쪽에선 전 세계 법원이 AI가 지어낸 판례를 지적한 결정이 2,184건까지 쌓였고, 한국 법원 판결문에는 'AI Hallucination'이라는 영어가 그대로 적혔습니다. 모순처럼 보이는 이 장면들은 하나의 지도 위에 놓으면 이해됩니다. 모델·데이터·업무 도구·로펌·법원의 다섯 층이 2024년에서 2026년 사이 각각 어떻게 움직였는지, 법률 AI 시험지가 '변호사시험'에서 '실무 과제 전 항목 통과'로 바뀐 이유, 시간당 청구가 흔들리는 경제학, 신입 변호사의 사다리, 나홀로 소송의 역설, 그리고 한국 법원·로펌·리걸테크의 2026년까지. 논문과 판결과 실적 발표를 근거로 일곱 가지 인사이트를 뽑았습니다. 인터랙티브 6개, 논문·보고서 그림 8장, 삽화 9장.
InstructGPT 해부: 1.3B 모델이 175B를 이긴 날, RLHF의 모든 것
GPT-3는 왜 '도움이 되는 비서'가 아니었을까? 100배 작은 모델이 거대 모델을 이긴 비결은? InstructGPT 논문을 해부하며, ChatGPT를 탄생시킨 RLHF 기술을 처음부터 쉽게 풀어낸다.
[특집] 당신의 게임이 하네스다 — 'LLM은 게임에 약하다'는 착각, 그리고 게임 자체를 AI 에이전트의 하네스로 만드는 일곱 가지 방법
2026년 9월 캐나다 캘거리의 인디 게임 행사에서 15년 차 게임 프로그래머 카일 쿠크슈텔이 45분 발표를 했다. 제목은 「당신의 게임이 하네스다」. 게임 업계에 퍼진 'LLM은 게임에 약하다'는 말을 그는 뒤집는다. 문제는 모델의 능력이 아니라 게임이 AI에게 읽히지 않는다는 것, 곧 맥락(context)의 문제라는 것이다. 처방은 AI가 아니라 게임 쪽에 있다 — 시드 하나, 한 모양의 오브젝트(나무도 개다), 텍스트로 재생되는 명령, 코드 밖의 데이터, 엔진과 분리된 시뮬레이션, 스크린샷 대신 픽셀 diff, 사람용 GUI 대신 텍스트 프로파일. 이 글은 그 처방을 하나씩 풀면서, 각각이 둠의 데모 파일(1993)과 에이지 오브 엠파이어의 '28.8 모뎀 위의 1,500명의 궁수', 스타크래프트 리플레이, 팩토리오의 디싱크 리포트에서 어떻게 이미 쓰였는지를 따라간다. 하네스라는 말이 테스트 하네스에서 2026년 '하네스 엔지니어링'까지 어떻게 왔는지, 같은 제미나이가 RAM을 텍스트로 받으면 포켓몬을 완주하고 픽셀만 받으면 0.48%에 머무는 이유, 게임 업계 52%가 AI를 해롭다고 보는 2026년의 반감과 한국 게임사 70%의 도입률까지 — 여섯 개의 인터랙티브 도구와 함께 정리했다.
ALL POSTS
모든 포스트
작은 모델, 큰 벤치마크 — K-LegalDeID로 읽는 BIO와 CRF의 귀환, 109만 건의 데이터, 그리고 0.99 뒤의 0.94
판결문 비실명화에 대한 두 번째 답이 2026년 3월 EACL에 나왔습니다. 고려대 연구진의 K-LegalDeID는 앞선 Thunder-DeID와 거의 모든 선택이 반대입니다. 라벨은 729개가 아니라 11개, 모델은 처음부터 사전학습한 15억 파라미터가 아니라 공개된 KLUE-BERT 1억 1천만에 CRF 층 하나, 데이터는 판결문 6,700건이 아니라 채팅·판결문·공개 데이터를 합친 109만 문장입니다. 그리고 엄격한 개체 단위 F1 0.9923을 보고합니다. 이 글은 1995년의 BIO 표기와 2001년의 CRF가 왜 2026년에 다시 쓰이는지부터 풀고, 39개 법 분야 2,000건의 새 데이터와 주석자 일치도 0.7352, 여섯 가지 채점 방식을 그림·표·위젯으로 따라갑니다. 숫자를 뜯어 보면 0.9923은 채팅이 대부분인 시험지의 점수이고, 새로 만든 판결문만으로는 0.94~0.97이며, 다른 연구실의 정답지로 채점하면 0.37로 떨어집니다. 코어닷투데이는 공개된 KLUE-BERT 어휘로 이름 2,000개에 조사를 붙여 직접 토큰화해, 경계가 맞아떨어지는 비율 97.3%와 ‘신한은행’이 한 토큰이 되는 문제를 확인했습니다.
두 논문이 남긴 숙제 — 판결문 비실명화는 어디로 가야 하나: 729 대 11, 0.99 대 0.37, 그리고 세계의 흐름
한국 판결문 비실명화를 다룬 두 논문, 서울대의 Thunder-DeID와 고려대의 K-LegalDeID를 열세 가지 설계 선택으로 나란히 놓고 읽습니다. 한쪽은 729개 라벨과 전용 사전학습으로 세밀하게, 다른 쪽은 11개 라벨과 CRF로 가볍게 갔습니다. 두 논문 모두 0.98~0.99를 보고하지만, 한쪽 모델을 다른 쪽 정답지로 채점하면 0.37이 나오고, 서울대의 후속작 Thunder-DeID+가 원래 모델을 전체 길이 판결문에서 어절 단위로 다시 재니 0.73이었습니다. 숫자가 모델의 실력이 아니라 자와 시험지를 재고 있다는 뜻입니다. 이 글은 그 간극의 원인을 정답 정의, 평가 단위, 원본 부재로 나누어 짚고, 재식별 성공률로 채점하는 RAT-Bench, 독일의 ‘프로젝트 5만’과 일본의 지정 법인 제도, EU AI Act의 익명화 예외 같은 2024~2026년 세계의 흐름을 정리합니다. 그 위에서 한국이 택할 수 있는 일곱 가지 방향을 제안합니다. 시험지를 법원 안에 두고 모델이 찾아가게 할 것, 정답의 정의부터 맞출 것, 문서 단위와 재식별 위험으로 잴 것, 층을 쌓을 것, 사람의 자리를 설계할 것, 공개의 단계를 나눌 것, 벤치마크를 살아 있게 할 것입니다.
판결문의 이름을 지우는 AI — Thunder-DeID로 읽는 비실명화의 역사, 729개의 꼬리표, 그리고 2026년
한국의 판결문은 공개가 원칙이지만, 공개 전에 사람 이름과 주소, 가게 이름까지 지워야 합니다. 이 일은 지금도 대부분 사람 손으로 이뤄지고, 법원의 자동 프로그램은 2019년 자료에서 정확도 15%, 2025년 자료에서 처리율 8%로 보고됐습니다. 서울대 연구진의 Thunder-DeID(EMNLP 2025 Findings)는 이 문제를 토큰 분류 모델로 풉니다. 원본 판결문을 구할 수 없다는 제약을 뒤집어, 이미 지워진 판결문 6,700건에 사람이 종류 꼬리표 48,306개를 붙이고 그 자리에 진짜 같은 이름을 채워 넣어 학습 데이터를 만들었습니다. 그 과정에서 나온 2단·16갈래·80가지·729개 라벨의 분류 체계, 조사를 떼어 내는 토크나이저, 에폭마다 이름을 갈아 끼우는 증강, 처음부터 사전학습한 DeBERTa 계열 모델(이진 F1 0.98, 종류 F1 0.91)을 그림과 표와 함께 하나씩 풉니다. 스위니의 87%에서 2026년 9월 법원 홈페이지 사고까지 재식별의 역사를 따라가고, 코어닷투데이가 로컬 모델로 직접 돌려 본 ‘다시 쓰게 하기’와 ‘가리킬 곳만 말하게 하기’의 차이, 논문이 말하지 않는 한계, 형사 판결문 공개 확대를 앞둔 2026년에 이 기술이 놓인 자리를 정리했습니다.
한 줄만 틀려도 버린다 — 뉴스 4만 7천 묶음을 읽힐 LLM, 7종 12가지 설정을 같은 검증기로 재다
사실탐색기는 같은 사건을 다룬 기사 묶음 4만 7,300개에서 주장·시점·같은 사건 관계를 원문 인용과 함께 뽑아야 합니다. 어느 모델에 맡길지 정하려고 Claude 3종, DeepSeek Flash, Muse Spark, 무료 K-EXAONE, 사내 A100에 올린 Qwen3.8-27B까지 7종 12가지 설정을 같은 지시문과 같은 검증기로 쟀습니다. 검증기는 행 하나만 틀려도 이야기 전체를 거부합니다. 그래서 순위는 ‘통과하면 얼마나 잘하나’보다 ‘긴 이야기에서 끝까지 버티나’로 갈렸습니다. Claude Haiku 5.5는 7개를 모두 통과하며 기준 주장의 89%를 회수했습니다. DeepSeek·EXAONE·Qwen은 통과한 이야기에서는 72~88%를 회수하고도 긴 이야기를 거의 다 잃어, 판본에 남은 양이 14~29%였습니다. 지시문 한 줄은 Sonnet 5.5의 회수율을 34%에서 68%로 두 배 올렸지만 DeepSeek에는 독이 됐고, 생각 모드는 답 대신 생각만 남겼습니다. 무료와 할인의 조건, 사내 GPU로 돌리는 데 드는 시간, 주장 하나당 비용까지 정리했습니다. 위젯 3종, 코어닷투데이 실측, 삽화 6장.
Inkling 2 Small 해부: 5,940억 개 중 170억 개만 일하는 모델은 어떻게 만들어졌나
미라 무라티의 Thinking Machines가 2세대 모델 Inkling 2 Small을 내놓았다. 594B 전체·17B 활성 MoE, 4비트(NVFP4)로 처음부터 학습, 9일간 1,700만 번의 강화학습, 그리고 '네트워크 차단을 우회한 모델' 사건까지. 1991년 전문가 혼합에서 2026년 미국 오픈 가중치 경쟁까지, 아키텍처와 학습 과정을 처음부터 끝까지 풀어 읽는다.
[특집] 종이를 빼앗기면 생각이 작아진다 — 무랏 데미르바스의 「생각의 도구로서의 글쓰기」, 유한 오토마톤에서 사고의 사슬까지
2026년 11월 7일, 분산 시스템 연구자 무랏 데미르바스가 「생각의 도구로서의 글쓰기」를 올렸다. 핵심은 마누엘 블럼의 일곱 줄이다. 유한 오토마톤과 튜링 기계의 차이는 종이와 연필 하나뿐이고, 종이를 빼앗기면 사람은 복잡도 클래스 하나를 통째로 내려간다. 이 글은 그 주장을 기계 위에서 직접 돌려 본다. 튜링이 1936년에 기계를 만든 재료가 '종이 위에서 계산하는 사람'이었다는 사실에서 출발해, 외부 메모리 알고리즘, 작업기억 4덩어리, 플라워와 헤이스의 글쓰기 인지 모형, 베라이터와 스카다말리아의 '지식 변형'까지 글쓰기의 아키텍처를 뜯어보고, 같은 정리가 2024년 사고의 사슬(CoT) 이론에서 다시 증명된 과정을 따라간다. 로컬 모델에게 종이를 주고 빼앗는 곱셈 실측(종이를 빼앗자 4자리부터 무너졌지만, 길게 쓰게 해도 나아지지 않았고 짧게 쪼개 쓰게 하자 7자리에서도 8문제 중 7문제를 맞혔다), 6쪽 메모가 더는 생각의 증거가 아니게 된 2026년의 사정, 인지 부채 연구, 그리고 데미르바스의 다섯 규칙과 맥피·엘보·보이스·스트렁크의 글쓰기 노하우까지 — 일곱 개의 인터랙티브 도구와 함께 정리했다.
라벨을 문장처럼 읽는 작은 추출기 — GLiNER2 해부: 개체명 인식 30년, 스팬 격자에서 경계 쌍까지, 그리고 한국어 실측
‘이 글에서 사람·회사·금액을 뽑아 표로 만들어 줘’는 2026년에도 가장 흔한 AI 일입니다. GLiNER2는 이 일을 2억 개 남짓한 파라미터의 인코더 하나로, CPU에서, 라벨을 글자로 적어 넣기만 하면 해냅니다. 1995년 MUC-6에서 ‘개체명’이라는 말이 생긴 때부터 고정 라벨의 시대, LLM 증류, 2023년 GLiNER의 ‘라벨도 입력이다’라는 발상을 거쳐 2025년 GLiNER2의 스키마 한 줄, 2026년 GLiNER2.5의 경계 쌍 구조까지 따라갑니다. 저장소 코드를 열어 입력 직렬화, 스팬 격자와 개수 헤드, 경계 인코더·후보 풀·재정렬·기권 헤드, 레코드 헤드를 하나씩 해부했습니다. 코어닷투데이는 공개 모델 두 개를 한국어 KLUE 개체명 300문장에 제로샷으로 돌렸습니다. 공백 기준 그대로는 조사가 붙어 엄격 F1이 34.9였고, 뽑은 뒤 끝의 조사만 잘라 내자 62.5로 올라 로컬 Qwen3.5 9B(61.0)와 비겼습니다. 속도는 CPU만으로 15배 빨랐습니다. 폭 8의 벽에 막힌 12단어 법률명은 경계 구조만 찾았고, 신형이 한국어에서 구형을 앞서지는 못했습니다.
지표가 목표가 되면 — 하노이의 쥐꼬리에서 MMLU의 졸업, 보상 해킹까지 굿하트의 법칙 (특집)
⟦SUMMARY⟧
새 판정 모델, 한국어로 다시 재다 — StartLux·d3·Perplexity Decider·AutoTrust JEV·Liquid d1
StartLux가 0.8B부터 27B까지 모든 크기에서 동급보다 7.4~16.9점 앞선다는 그림을 냈고, d3·Perplexity Decider·AutoTrust JEV·Liquid d1이 잇달아 Ollama에 올라왔습니다. 코어닷투데이는 새 판정 모델 15가지 구성을 11월 1일과 같은 한국어 2,221문항과, 사실탐색기의 부산 공공기록으로 새로 만든 사실 탐색 1,449문항에 올렸습니다. 한국어에서 StartLux가 동급을 뚜렷하게 앞선 곳은 0.8B(+6.9점)뿐이고, 4B는 +1.5점, 2B·9B·27B는 d3와 겹쳤습니다. 게시판의 비공개 시험을 합친 총점에서도 StartLux의 공개분 우위는 크게 줄었습니다. Ollama의 d3는 8비트 포장에도 원본과 0.4점 안쪽으로 같았고, 사실 탐색에서는 d3:27b와 StartLux 27B가 87점대로 맨 위였습니다. 판정 모델의 문턱을 라벨로 고르면 값 비교는 모든 모델이 완벽했고, 남은 어려움은 ‘본문에 이유가 적혀 있는가’를 묻는 부재 검문 하나였습니다.