
#InstructGPT
4개의 포스트
가장 쓴 교훈 — 계산량보다 데이터, 데이터보다 '올바른 과제'
2026년 9월 10일, ChatGPT를 만든 사람 중 하나가 900단어짜리 글을 올렸다. 리치 서튼의 '쓴 교훈'(계산 > 알고리즘)은 빙산의 일각이며, 진짜 위계는 '올바른 과제 > 데이터 > 계산 > 알고리즘'이라는 주장이다. 그리고 그 증거로 자기가 만든 InstructGPT의 논문 그림 한 장을 내놓았다 — 100배 작은 모델이 100배 큰 모델 위에 통째로 올라앉은 그림. 이 글은 왜 이 개념이 나왔는지를 1997년 딥블루부터 2026년의 에이전트 시대까지 따라가며, 과제를 잘못 고른 여덟 건의 값비싼 실패와 잘 고른 다섯 건의 성공을 함께 본다. 인터랙티브 위젯 8종과 삽화 14장.
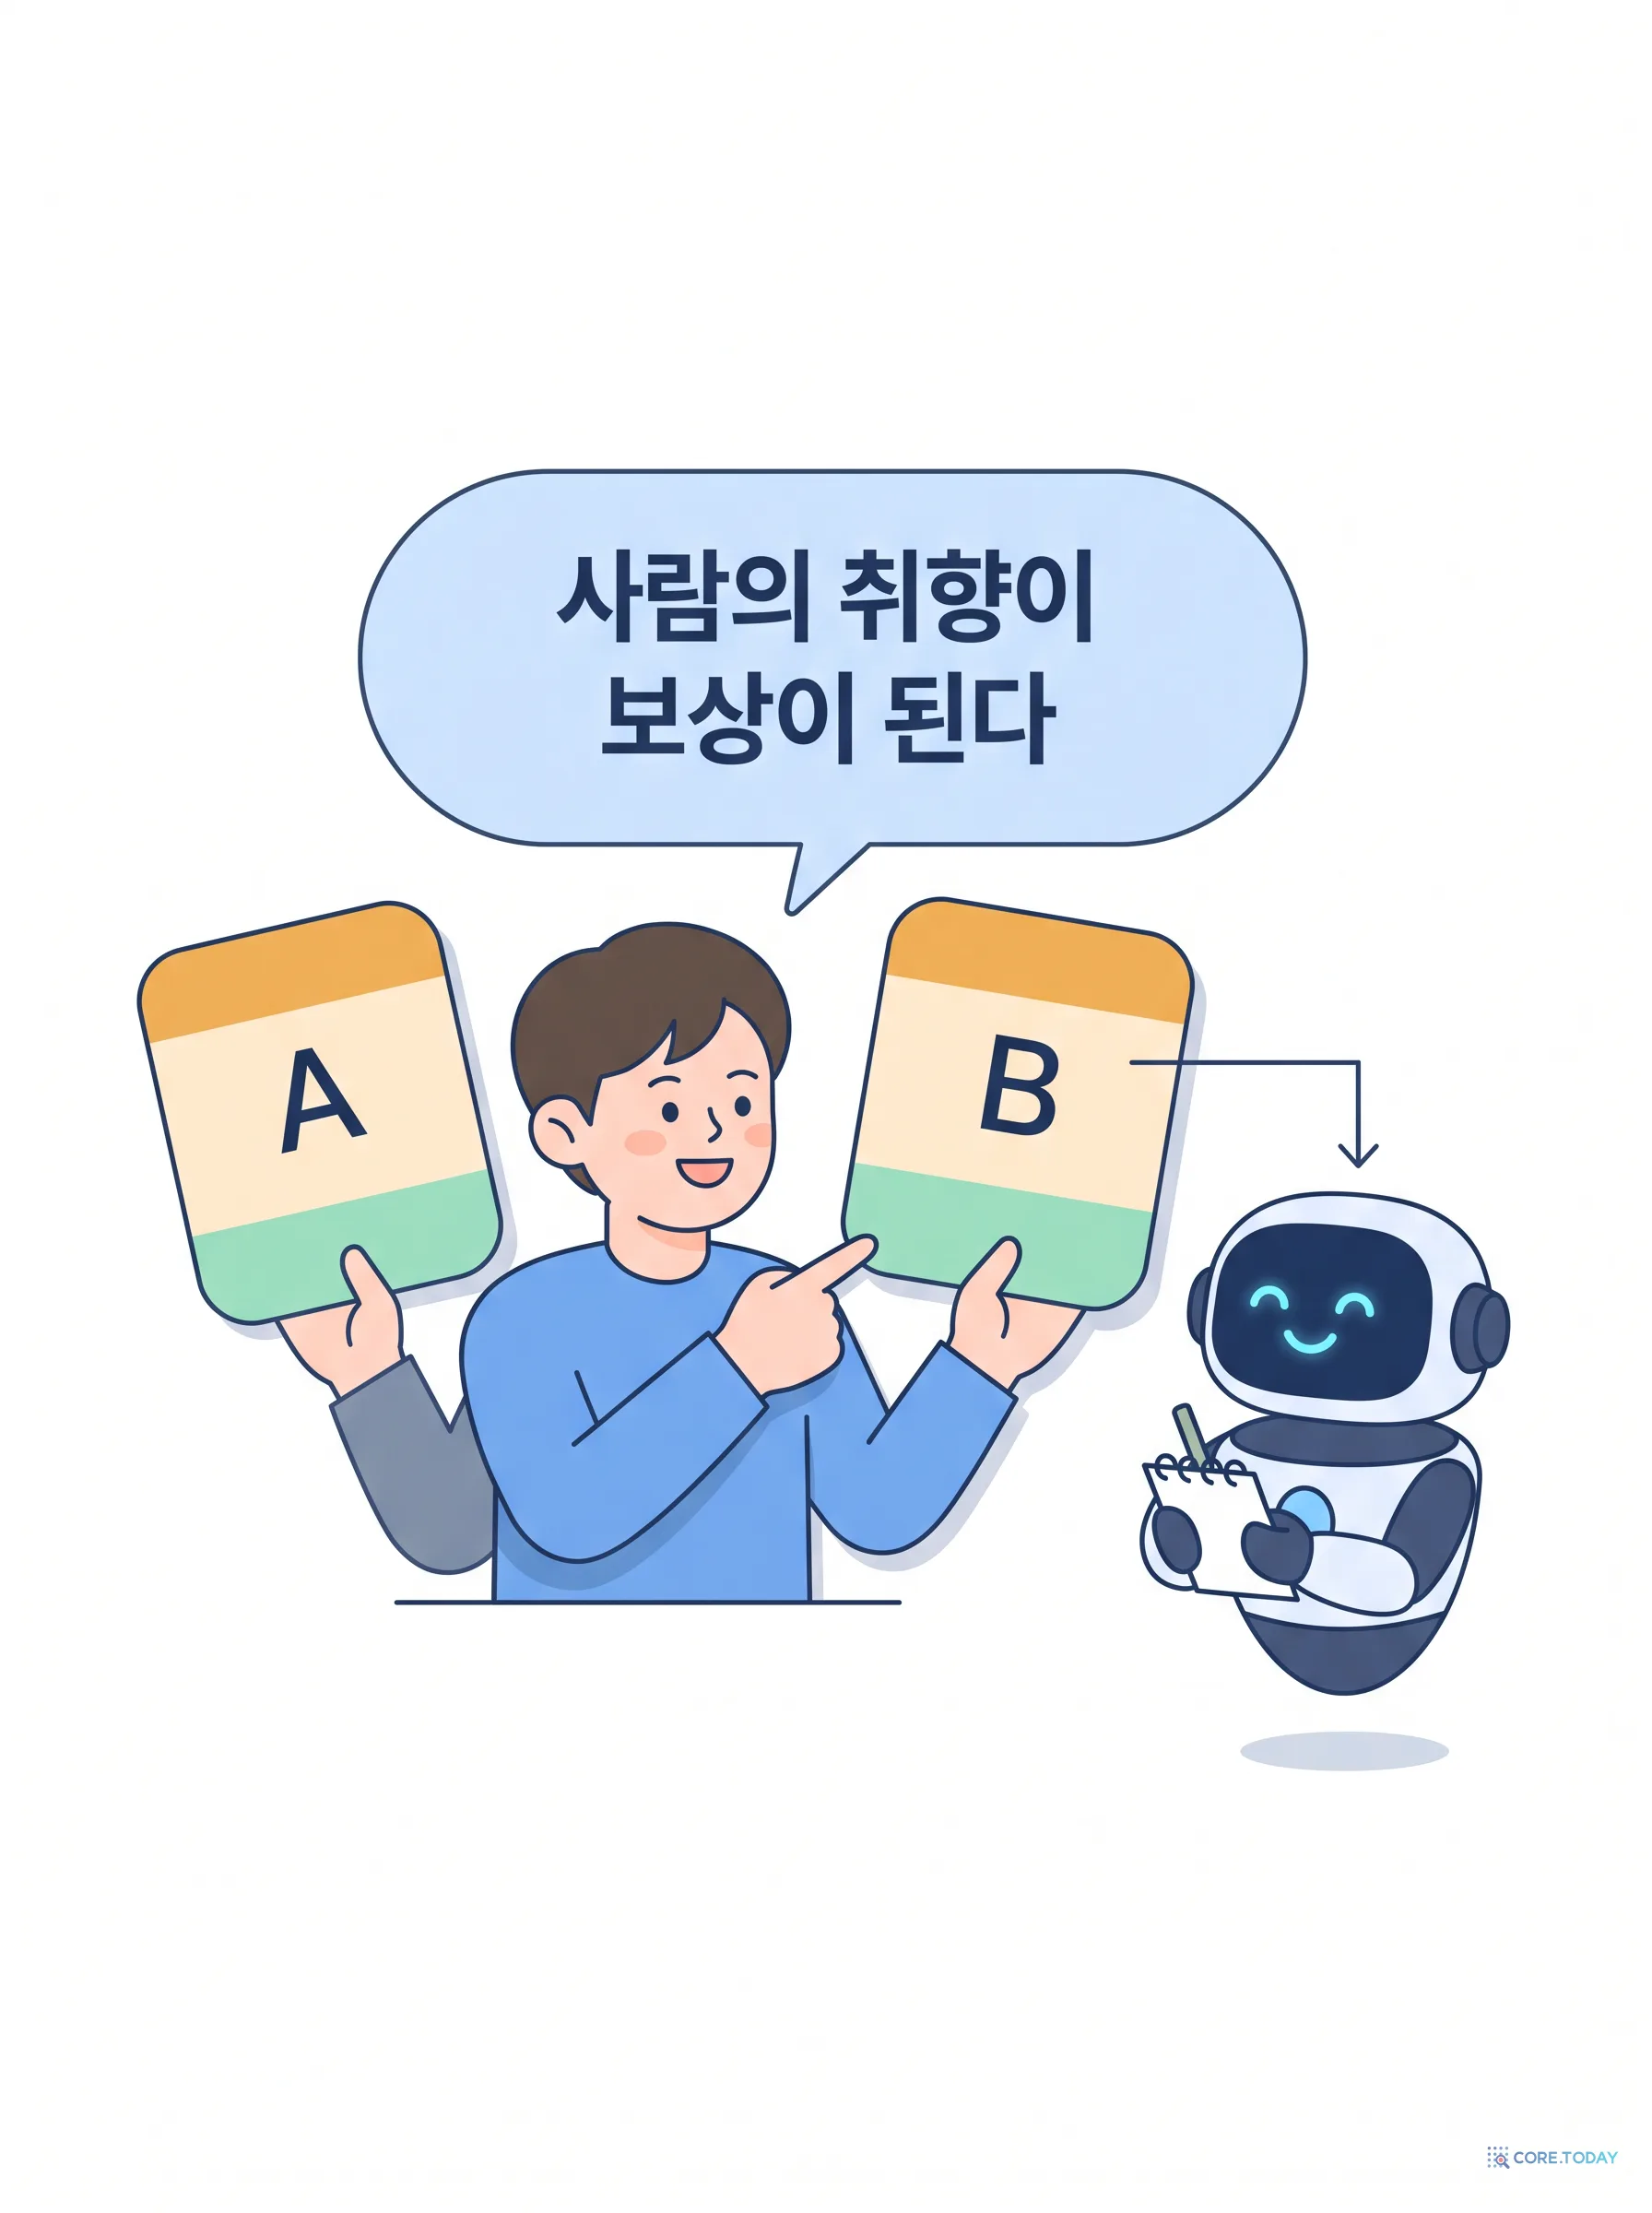
“달 착륙을 6살에게 설명해 줘” — 되묻기만 하던 AI는 어떻게 말귀를 알아듣게 됐나 (RLHF 특집)
2022년 1월, OpenAI는 “사용자의 의도를 GPT-3보다 훨씬 잘 따르는” 모델을 발표했다. 13억 파라미터 모델이 1750억 모델을 이겼고, 그 비용은 사전학습의 1.6%였다. 열 달 뒤 같은 레시피로 만든 ChatGPT가 세상을 바꿨다. 이 글은 그 기술 — 인간 피드백 강화학습(RLHF) — 이 왜 필요했는지를 2017년 뒤공중돌기 로봇부터 따라간다. 보상을 글로 적을 수 없다는 문제, 순위 하나가 여섯 개의 비교가 되는 방식, 보상 모델을 너무 믿으면 벌어지는 일, 그리고 RLHF가 고친 것이 아니라 ‘만든’ 네 가지 버릇까지. 인터랙티브 위젯 8종과 삽화로 풀었다.
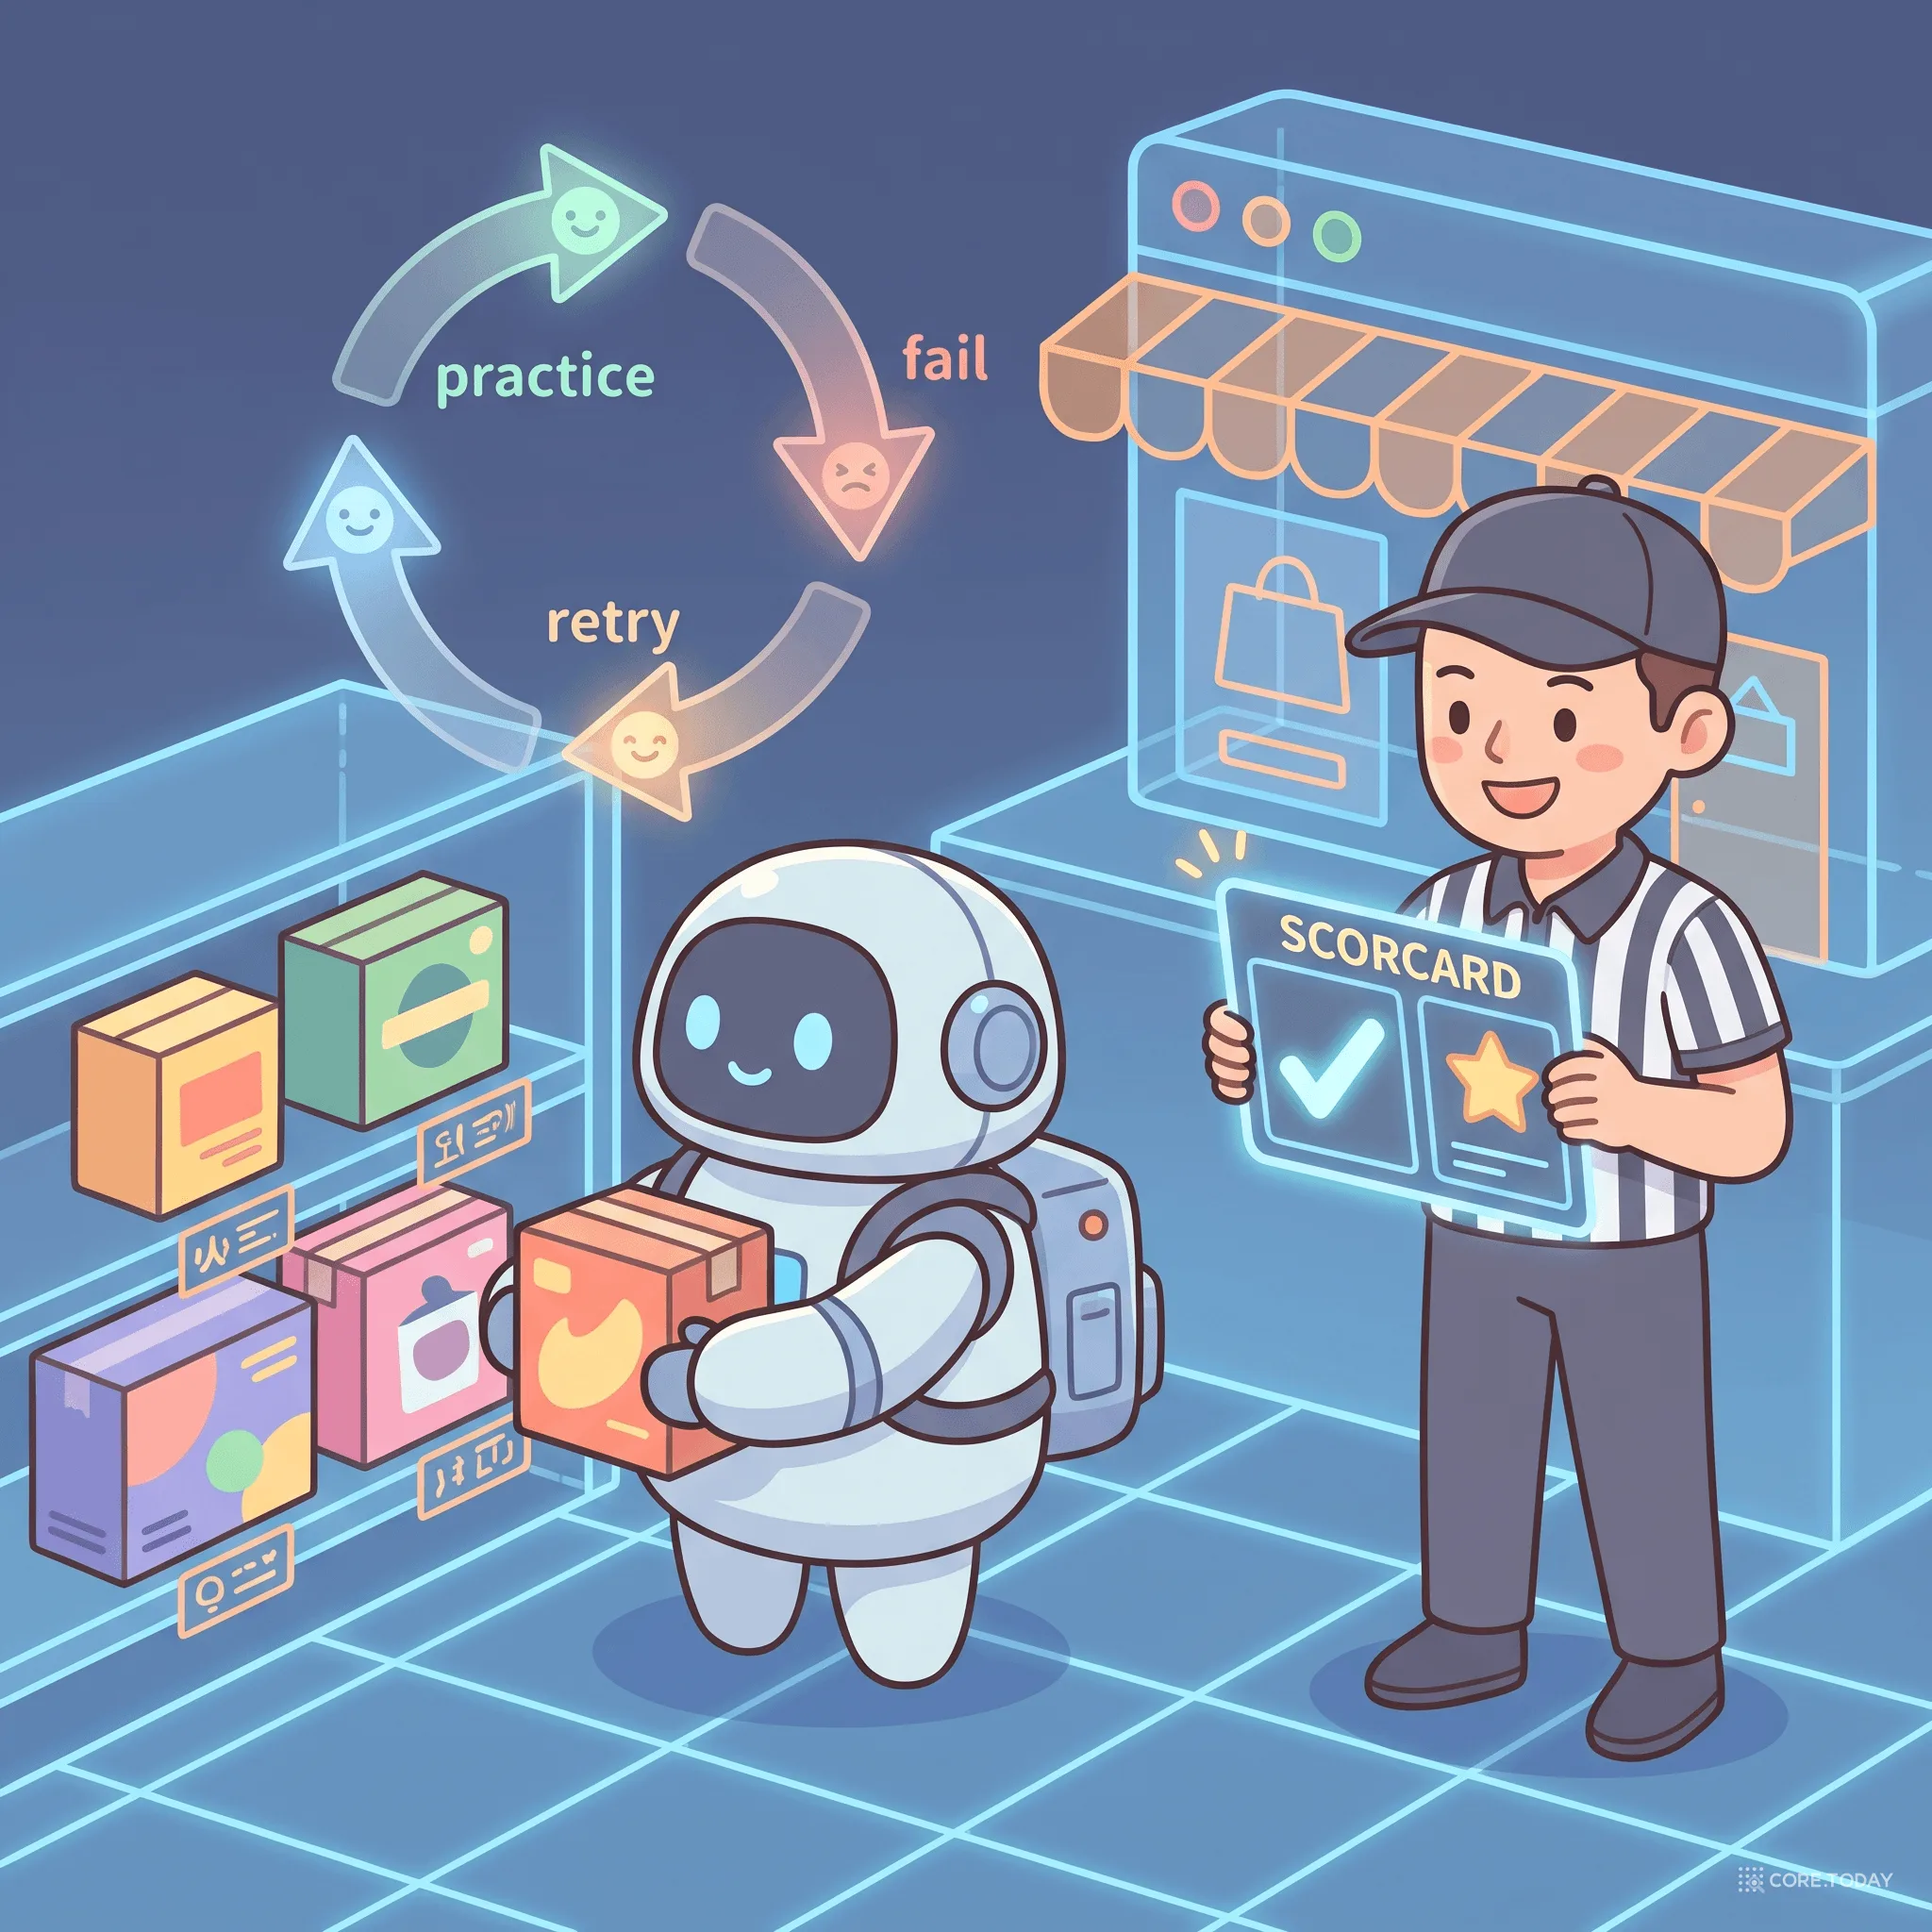
당신의 AI, 빌린 겁니까 가진 겁니까 (2부): SFT에서 GRPO까지, '디지털 트윈'이라는 훈련장
'강화학습으로 모델을 훈련한다'는 말은 정확히 무슨 뜻일까? 사전학습·SFT·RLHF·RLVR로 이어지는 개념의 사다리를 밟아 오르고, 요즘 화제인 GRPO를 '커브로 채점하는 시험'에 빗대 직관적으로 푼다. 그리고 모델이 실제로 업무를 연습하는 '디지털 트윈'과 보상 설계까지, Fermisense의 카탈로그 실험을 해부한다.
InstructGPT 해부: 1.3B 모델이 175B를 이긴 날, RLHF의 모든 것
GPT-3는 왜 '도움이 되는 비서'가 아니었을까? 100배 작은 모델이 거대 모델을 이긴 비결은? InstructGPT 논문을 해부하며, ChatGPT를 탄생시킨 RLHF 기술을 처음부터 쉽게 풀어낸다.