
#GRPO
14개의 포스트
[특집] 요약도 실력이다 — 컨텍스트 압축을 강화학습 안으로 들여온 CompactionRL 완전 해설
코딩 에이전트가 몇 시간째 일하다 보면 컨텍스트 창이 가득 찹니다. 그때 하네스는 지금까지의 대화를 요약으로 접고 새 창에서 일을 이어 가게 합니다. 이것이 컨텍스트 압축(compaction)입니다. 그런데 이 요약은 지금까지 훈련 밖에 있었습니다. 모델은 요약에서 이어 가는 연습을 한 적이 없고, 요약을 잘 쓴다고 보상을 받은 적도 없습니다. 칭화대와 Z.AI의 2026년 7월 논문 CompactionRL은 압축을 강화학습 롤아웃 안에 넣고, 요약 토큰과 실행 토큰을 같은 최종 보상으로 함께 훈련합니다. 이를 위해 세 가지 장치를 씁니다. 조원을 기다리지 않는 단일 롤아웃 PPO, 짧은 요약이 손실을 독차지하지 않게 하는 토큰 단위 손실, 그리고 잘린 구간 너머로 보상의 거리를 되살리는 구간 넘는 GAE입니다. 106B 모델에서 SWE-bench Verified 66.4%, Terminal-Bench 2.0 26.2%로, 추론 때만 압축한 기준 모델보다 6.6점·4.9점 높습니다. 요약 모델만 바꿔도 6.5점이 움직인다는 실험, 요약을 훈련하면 요약이 길어진다는 관찰, 그리고 이 이득이 압축을 켰을 때만 나온다는 한계까지 표와 그림을 하나씩 읽습니다. 직접 돌려 보는 위젯 일곱 개를 함께 실었습니다.
사건을 뽑는 AI에게 채점표를 주다 — EAGER로 읽는 사건 추출 40년과 '검증 가능한 보상'
GPT-5.4에게 기사를 주고 사건을 뽑으라고 하면 평균 F1이 10점 안팎입니다. 독일 DFKI의 EAGER는 70억 매개변수 모델에 '여섯 명의 채점관'과 '문제지마다 다른 오답 보기'를 붙여 평균 30.79점까지 끌어올렸습니다. 사건 추출이 1987년 MUC의 템플릿 채우기에서 어떻게 지금의 코드 생성·강화학습까지 왔는지, 검증 가능한 보상(RLVR)이 수학 밖으로 나오면 무엇이 달라지는지, 그리고 그룹 점수가 모두 같아져 학습이 멈추는 '어드밴티지 붕괴'를 SCAE가 어떻게 푸는지 풀어 씁니다. 본문과 부록 표의 숫자가 엇갈리는 곳, 보상 식을 글자 그대로 구현하면 생기는 문제도 짚었습니다. 한국어 문장 40개로 로컬 4B 모델을 360번 돌려 같은 채점표를 직접 대 봤습니다.
[특집] 옛 주소로 기차표를 끊는 AI — '기억 갱신 격차'를 재고, 훈련으로 줄인 Supersede 완전 해부
"저 부산으로 이사했어요"라고 말해 두었는데, 몇 주 뒤 AI 비서가 대구행 기차표를 끊는다. 2026년 6월 arXiv 논문 「Supersede」는 이 실패를 '기억 갱신 격차'라고 부르고, 네 가지 질문으로 파고든다. 실패는 정말 있나? 더 큰 모델이면 풀리나? 더 큰 메모장이면 풀리나? 훈련하면 줄어드나? 답은 있다, 아니다, 아니다, 그렇다. 300자 메모장만 쥔 gpt-5.4는 전체 대화를 다 본 자신보다 15점 낮았고, 대화가 24배 길어지자 정답률은 68%에서 28%로 무너졌으며, 메모장을 24배로 늘려 줘도 28%였다. 마지막으로 3B 모델을 GRPO로 훈련해 9.0%를 16.7%로 끌어올렸다. 1957년의 순행 간섭 실험부터 데이터베이스의 UPDATE, 2026년의 'ChatGPT Dreaming'까지 이 문제가 어디서 왔는지 따라가고, 논문의 그림과 표를 하나씩 읽는다. 같은 데이터와 같은 프롬프트로 공개 모델(Qwen 3.5 9B)에서 실험을 직접 재현해 25.6점의 격차를 확인했고, 메모를 요약 대신 '주제: 값' 장부로 쓰게 하는 지시문 하나로 그 격차가 11.5점까지 줄어드는 것도 보았다. 하지만 그 장부도 대화가 48세션으로 길어지자 88%에서 8%로 무너졌다. 그리고 논문의 문자열 채점기가 옛 값 '7:00 pm'을 정답으로 처리한다는 것도 찾아냈다.
[특집] 점수 대신 첨삭으로 배운다 — GEPA, 프롬프트가 스스로 진화해 강화학습을 이긴 방법
강화학습은 시도 한 번에 점수 하나를 받는다. 그런데 AI가 일한 흔적은 전부 글이다 — 생각의 과정, 도구 호출, 컴파일러 오류 메시지까지. 그렇다면 점수 대신 그 글을 읽고 배우게 하면 어떨까? UC 버클리·스탠퍼드·MIT 등 17명이 쓴 GEPA(ICLR 2026 구두 발표)는 이 질문에 답한다. 실패한 기록을 언어 모델이 직접 읽고 반성해 프롬프트를 고치고, 고친 프롬프트들을 '문항별 1등'이라는 파레토 기준으로 살려 두며 진화시킨다. 그 결과 여섯 과제에서 가중치를 고치는 강화학습(GRPO, 24,000 롤아웃)보다 평균 6점, 최대 20점 높았고, 롤아웃은 최대 35배 적게 썼다. 이 글은 '생각해 보자, 차근차근'이라는 주문에서 시작한 프롬프트 최적화의 역사, 반성·진화·파레토라는 세 기둥, 논문의 표와 그림, 수학 문제에서는 강화학습에 진 이유, 그리고 에이전트가 경험을 글로 쌓아 가는 2026년에 이 아이디어가 맡는 역할을 인터랙티브 6개와 일러스트 13장으로 풀어 본다.
기억은 미리 만들지 말고, 물어볼 때 지어라 — Just-In-Time 에이전트 메모리(JAM) 완전 해부
석 달 전 회의 요약에는 '가격 협의함'이라고만 적혀 있다. 그런데 오늘 필요한 건 '1,240만 원, VAT 별도'라는 한 줄이다. 대부분의 에이전트 메모리는 질문이 오기 전에 기록을 요약·추출해 두는 AOT(Ahead-of-Time) 방식이고, 그래서 '그때는 사소했던' 디테일을 먼저 버린다. BAAI·베이징대·홍콩이공대 연구진의 JAM은 발상을 뒤집는다. 원본은 폴더에 그대로 두고 README 색인만 미리 만든 뒤, 질문이 오면 작은 Researcher 에이전트가 open·search·browse로 찾아 들어가 그 질문만을 위한 맥락을 짓는다. 4B 모델로 14B 메모리 에이전트를 이기고, 4배 빨랐다. 토요타 공장과 JIT 컴파일러에서 시작해 Memory-Gym 데이터 합성, 힌트를 주는 강화학습, 결과표와 한계, 2026년의 다른 기억 설계와의 비교까지 인터랙티브 위젯 6종과 함께 해부한다.
읽기는 병렬로, 추론은 깊게 — 896K 토큰 문서를 4B 모델이 읽어 내는 법, PARSER 논문 특집
100만 토큰짜리 창을 가진 모델도 긴 문서 앞에서는 정확도가 수십 점씩 떨어집니다. 홍콩중문대 연구진이 2026년 9월에 내놓은 PARSER는 '문서를 읽는 순서는 문서가 정하지만, 질문을 푸는 순서는 질문이 정해야 한다'는 한 문장에서 출발합니다. 문서를 보지 않는 리드 에이전트가 질문을 쪼개 수천 개의 청크 담당 서브에이전트에게 동시에 흩뿌리고, 돌아온 증거로 다음 질문을 다듬습니다. 4B 모델이 896K 토큰에서 순차 메모리 에이전트를 12점 앞서고, 9B 모델이 DeepSeek-V4-Pro를 6.3점 앞섰으며, 지연은 11배 줄었습니다. 이 글은 Transformer의 어텐션 창에서 시작해 'Lost in the Middle'과 Context Rot, MemAgent의 순차 메모리까지 이 논문이 서 있는 자리를 되짚고, 흩뿌리기-모으기 구조와 리드 에이전트만 강화학습하는 설계, 세 가지 통제 실험, 실패 사례와 한계, 그리고 2026년 멀티 에이전트 지형에서의 의미를 사례와 함께 풀어 씁니다. 시뮬레이터·결과 탐색기·접근법 가이드 위젯 3개.
“달 착륙을 6살에게 설명해 줘” — 되묻기만 하던 AI는 어떻게 말귀를 알아듣게 됐나 (RLHF 특집)
2022년 1월, OpenAI는 “사용자의 의도를 GPT-3보다 훨씬 잘 따르는” 모델을 발표했다. 13억 파라미터 모델이 1750억 모델을 이겼고, 그 비용은 사전학습의 1.6%였다. 열 달 뒤 같은 레시피로 만든 ChatGPT가 세상을 바꿨다. 이 글은 그 기술 — 인간 피드백 강화학습(RLHF) — 이 왜 필요했는지를 2017년 뒤공중돌기 로봇부터 따라간다. 보상을 글로 적을 수 없다는 문제, 순위 하나가 여섯 개의 비교가 되는 방식, 보상 모델을 너무 믿으면 벌어지는 일, 그리고 RLHF가 고친 것이 아니라 ‘만든’ 네 가지 버릇까지. 인터랙티브 위젯 8종과 삽화로 풀었다.
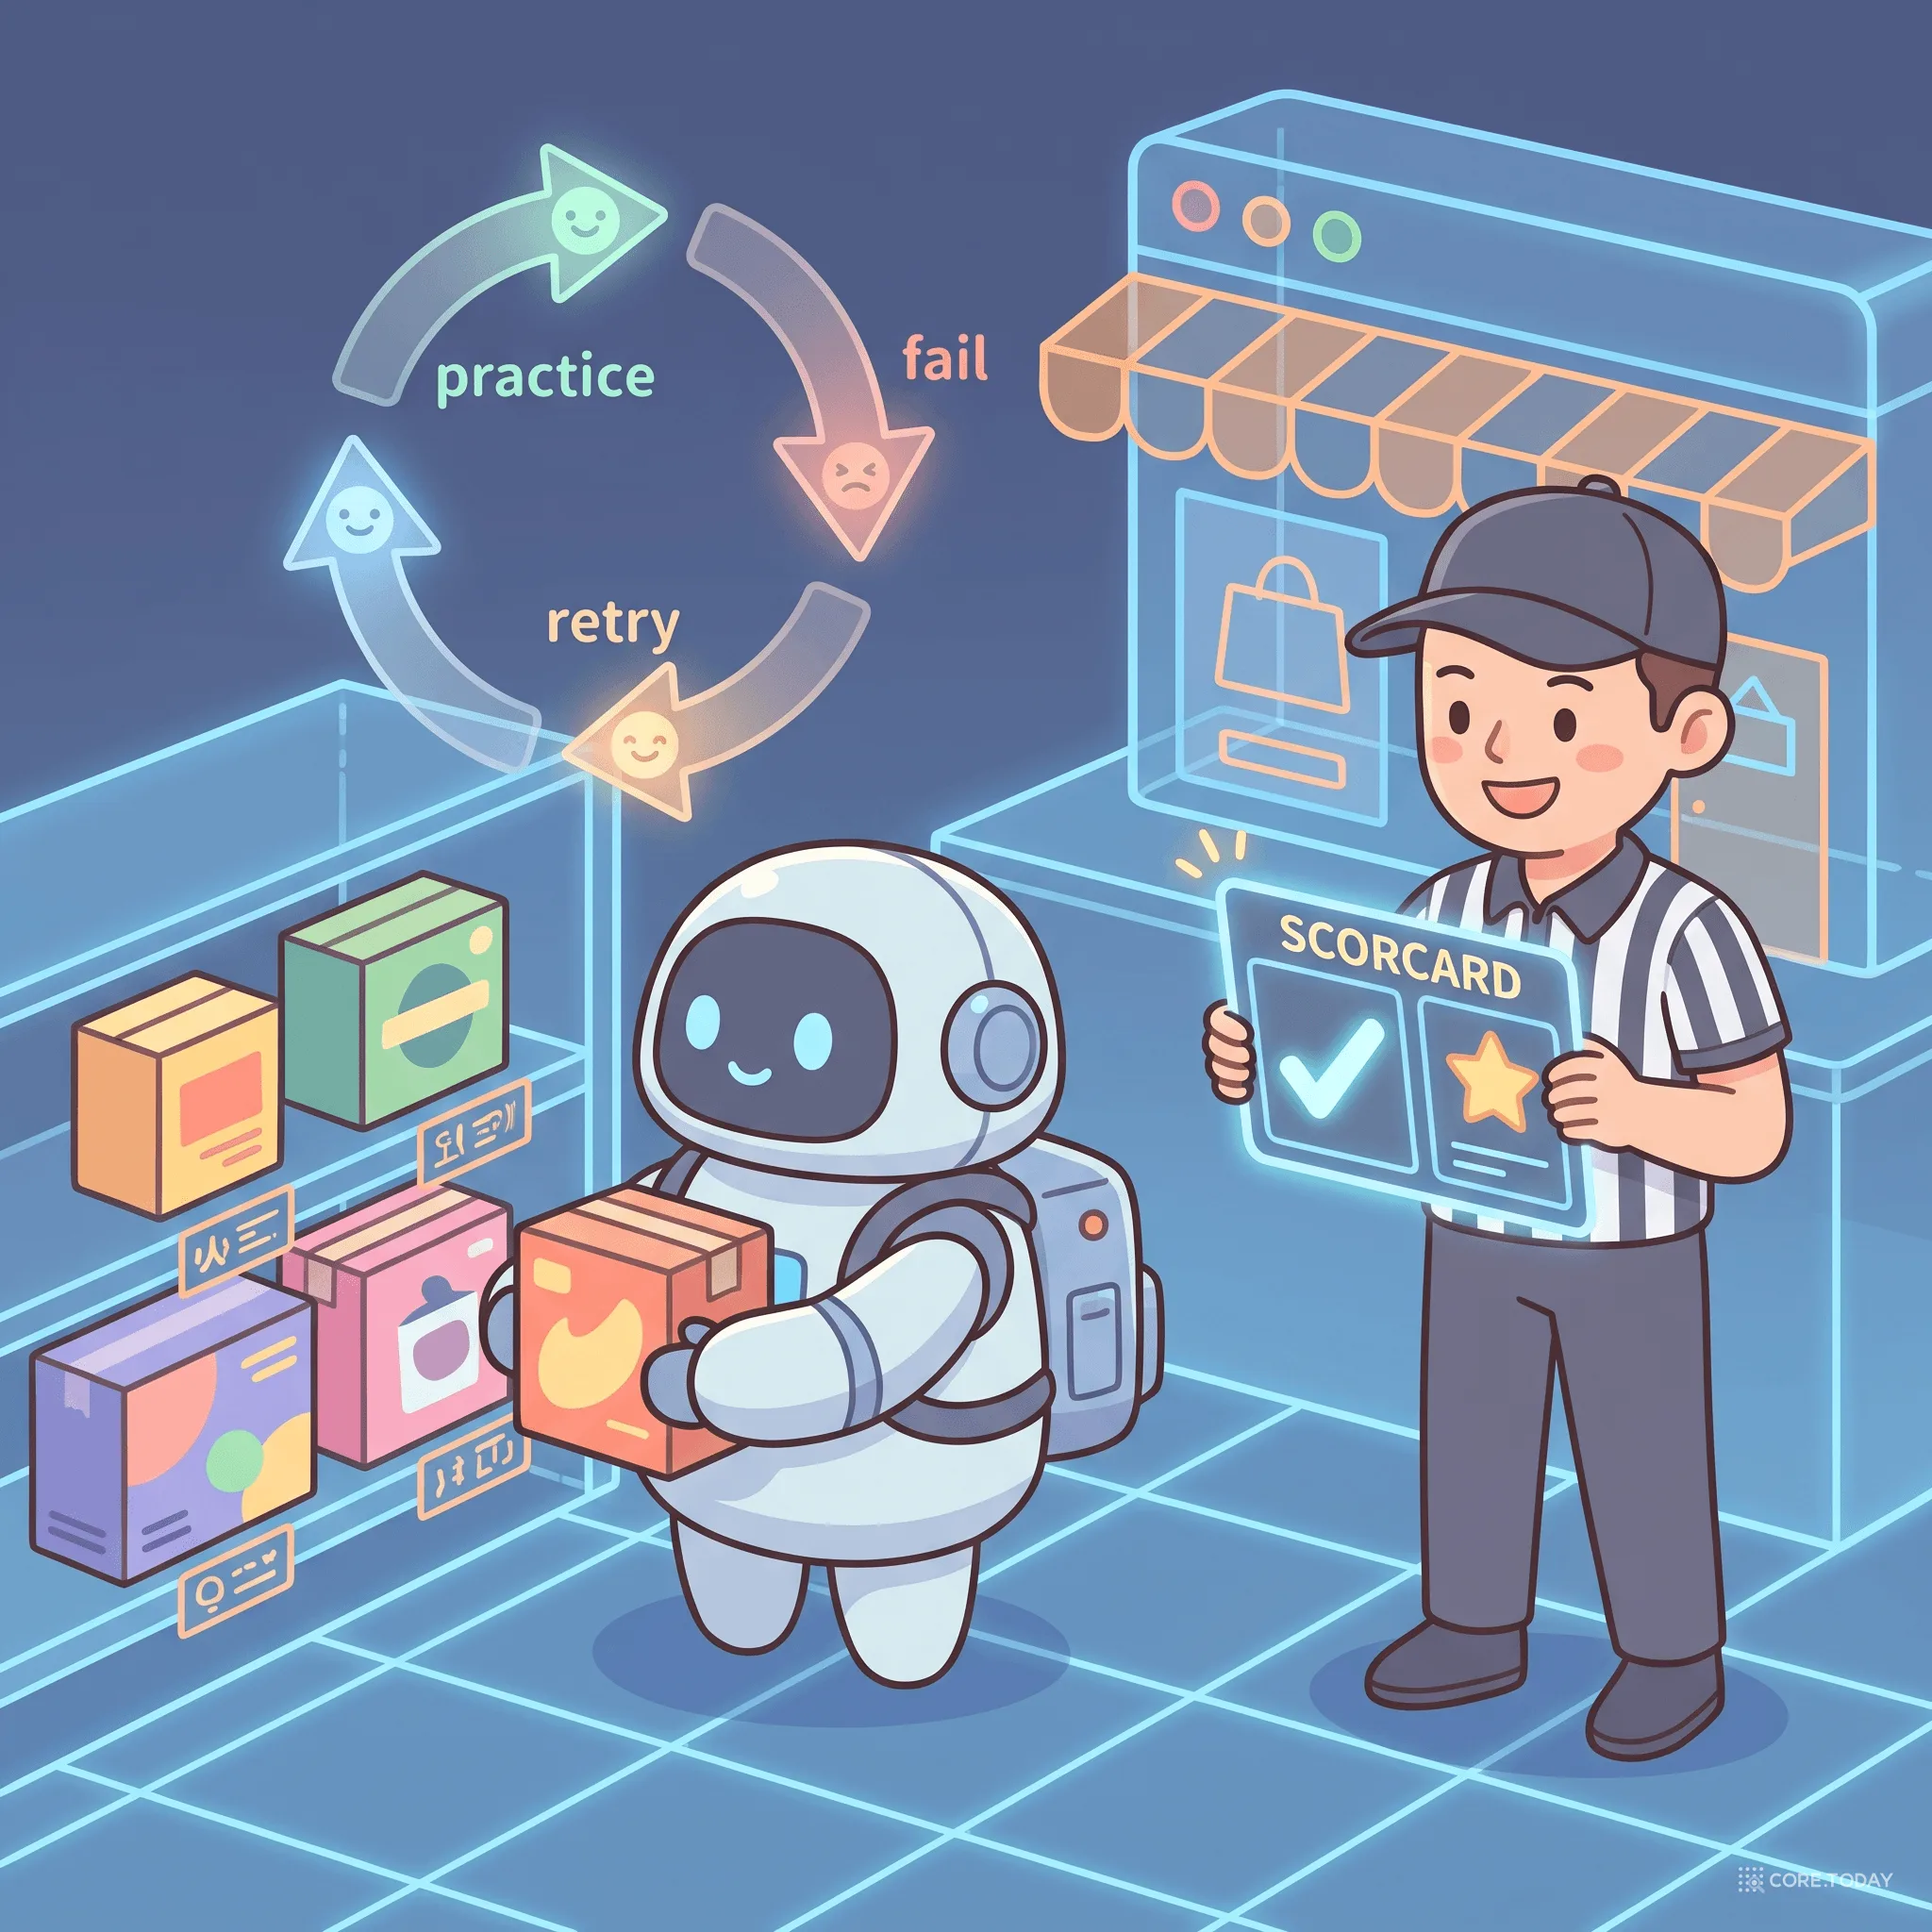
당신의 AI, 빌린 겁니까 가진 겁니까 (2부): SFT에서 GRPO까지, '디지털 트윈'이라는 훈련장
'강화학습으로 모델을 훈련한다'는 말은 정확히 무슨 뜻일까? 사전학습·SFT·RLHF·RLVR로 이어지는 개념의 사다리를 밟아 오르고, 요즘 화제인 GRPO를 '커브로 채점하는 시험'에 빗대 직관적으로 푼다. 그리고 모델이 실제로 업무를 연습하는 '디지털 트윈'과 보상 설계까지, Fermisense의 카탈로그 실험을 해부한다.
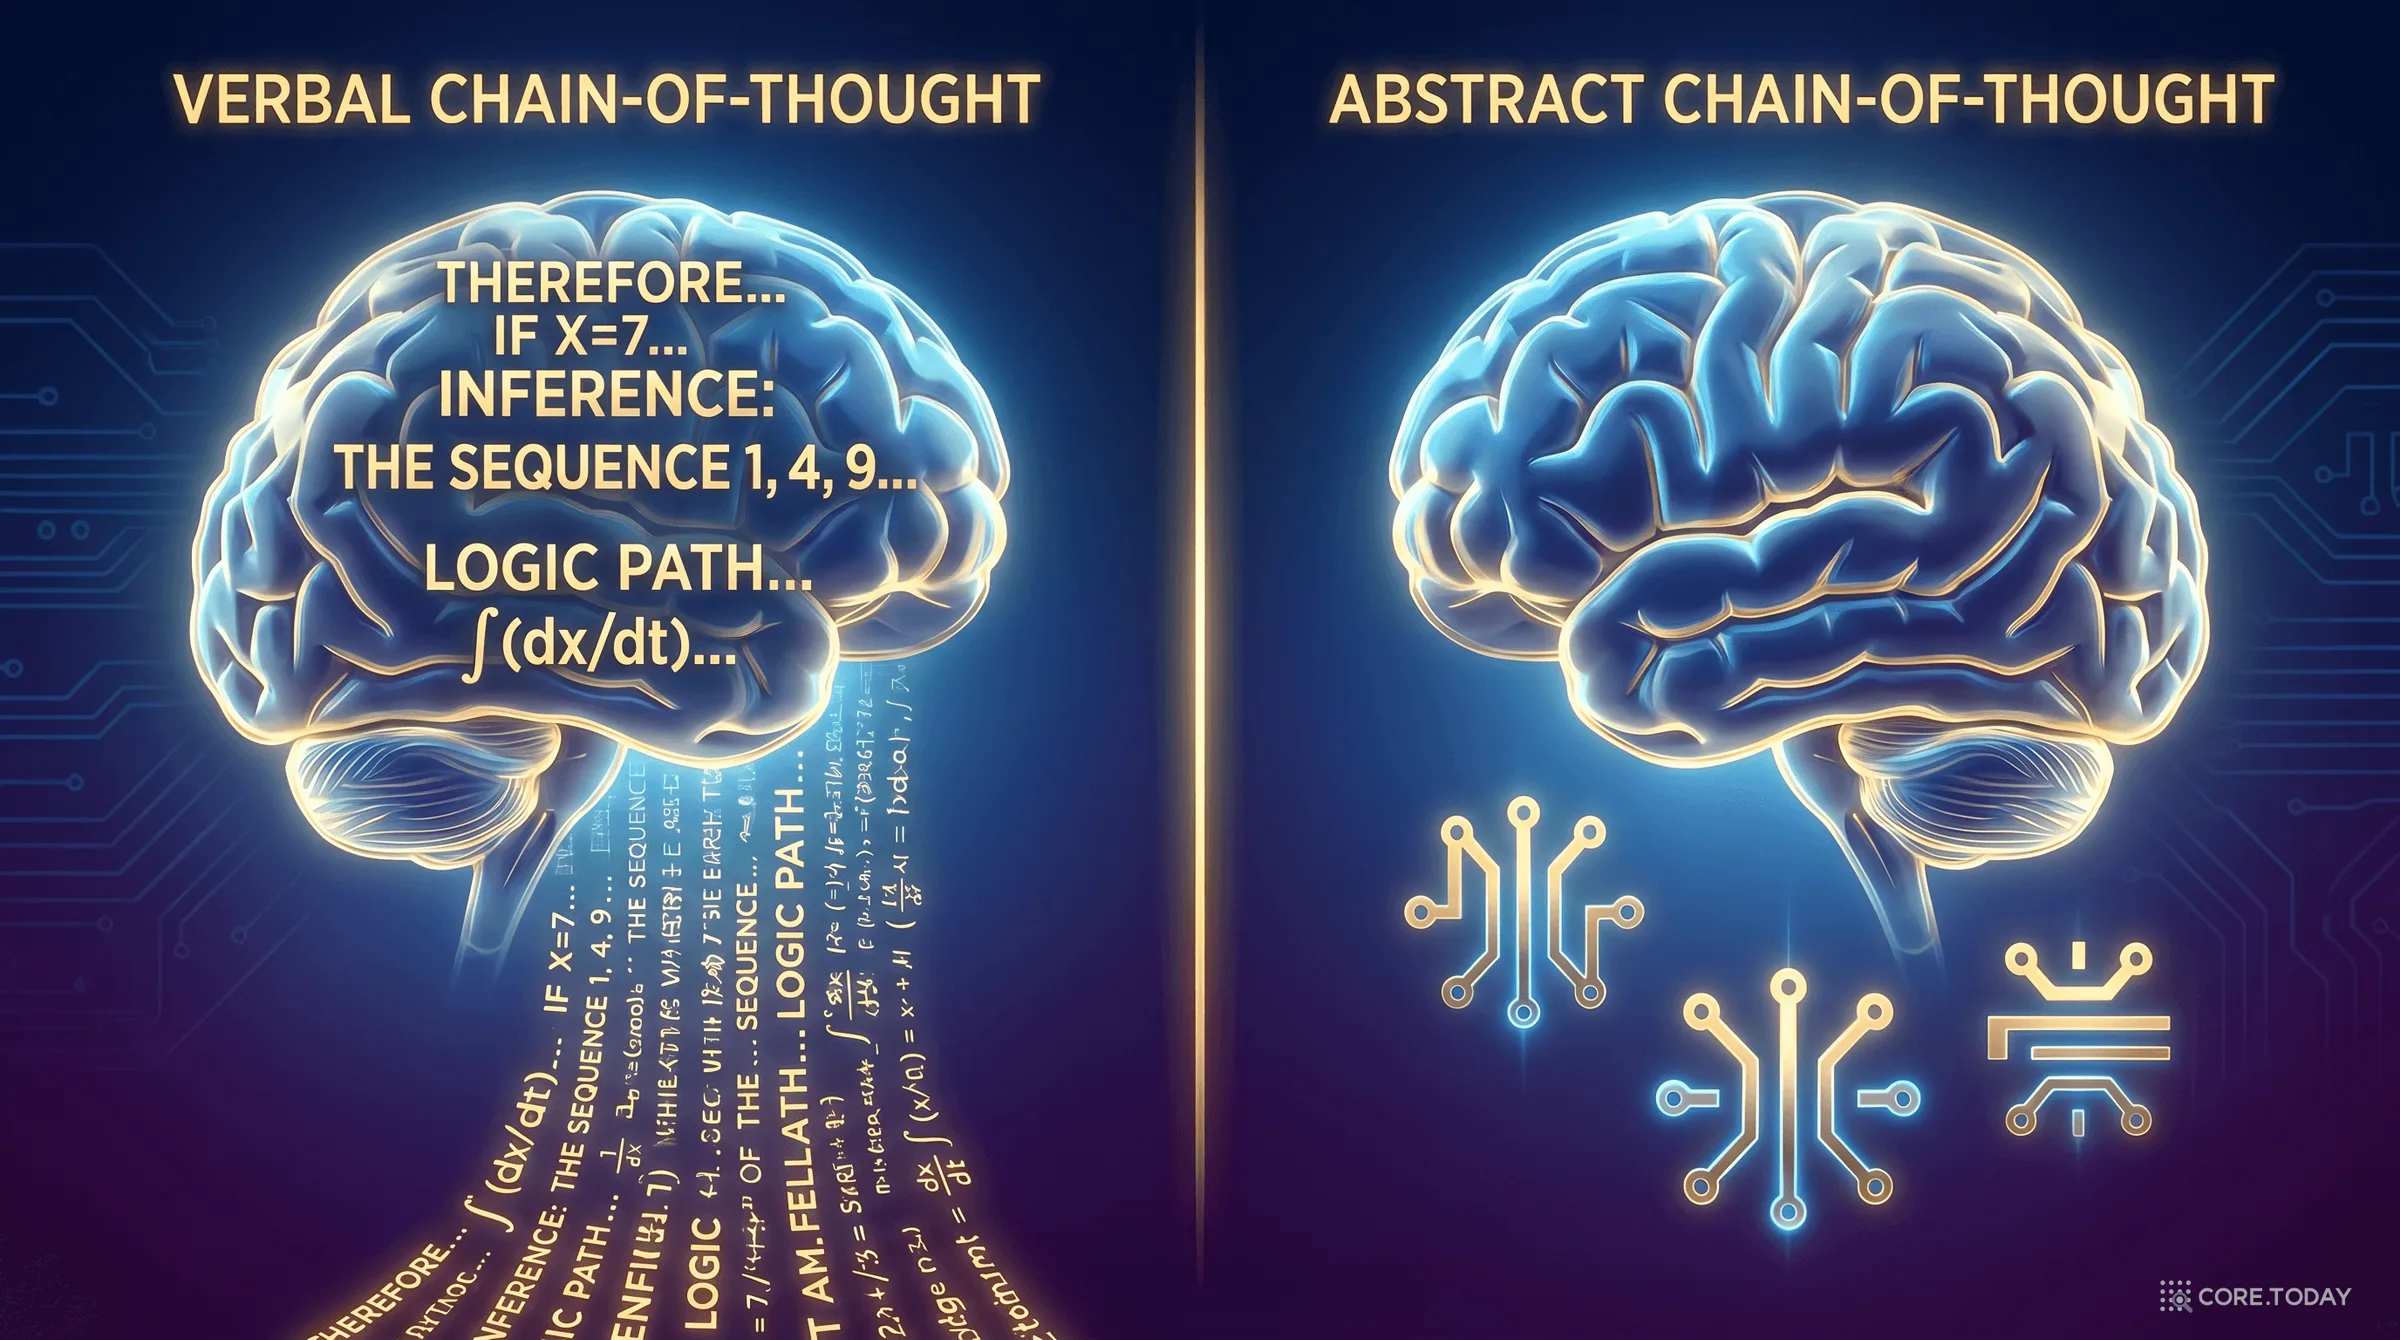
Thinking Without Words: AI가 단어 없이 생각하는 법 — Abstract Chain-of-Thought 완전 분석
IBM Research가 2026년 4월 발표한 'Thinking Without Words'를 깊이 파헤칩니다. 64개의 정체불명 토큰만으로 추론 토큰을 최대 11.6배 줄이고도 동등한 성능을 내는 비밀, 그리고 그 안에서 자연 언어와 똑같이 떠오른 Zipf의 법칙까지 — 'AI가 말 없이 생각한다'는 명제가 현실이 된 순간을 해부합니다.
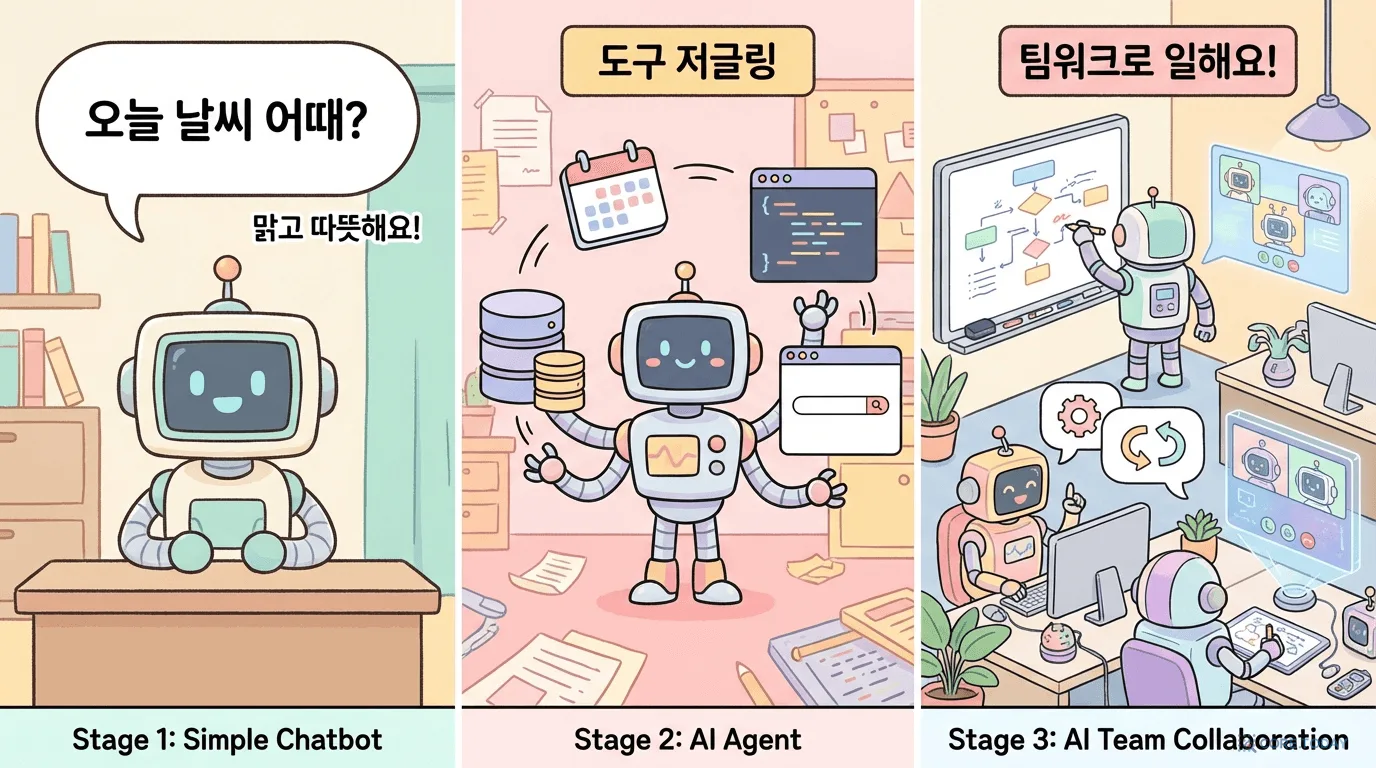
Agent Lightning 완전 가이드 — AI 에이전트를 강화학습으로 훈련시키는 시대가 왔다
Microsoft가 공개한 Agent Lightning은 어떤 AI 에이전트 프레임워크든 강화학습으로 훈련시킬 수 있는 오픈소스 프레임워크다. 왜 에이전트 훈련이 필요한지, 어떤 원리로 작동하는지, 아키텍처의 모든 것을 풍부한 사례와 함께 해부한다.
Vision-R1 특집: AI에게 '눈으로 보고 생각하는 법'을 가르치다 — 과잉사고의 함정부터 점진적 훈련까지
DeepSeek-R1이 텍스트에서 '생각하는 법'을 배웠다면, Vision-R1은 이미지를 보면서 생각하는 법을 배웠다. 하지만 그 과정에서 AI가 '쓸데없이 오래 생각하는' 과잉사고 문제에 빠졌다. ICLR 2026에서 발표된 이 논문이 제시한 점진적 사고 억제 훈련의 원리를, 일러스트와 인터랙티브 요소로 쉽고 깊게 풀어본다.
DAPO 완전 해부: DeepSeek-R1의 비밀을 풀어낸 오픈소스 강화학습의 모든 것
DeepSeek-R1이 강화학습만으로 AI에게 '생각하는 법'을 가르쳤다고 했지만, 핵심 레시피는 비밀이었다. DAPO는 그 비밀을 4가지 기법으로 풀어내고, 절반의 훈련 스텝으로 더 높은 성능을 달성한 뒤 모든 코드를 공개했다. 엔트로피 붕괴부터 동적 샘플링까지, 대규모 RL의 진짜 난관과 해법을 논문 기반으로 풀어본다.