
#Calibration
3개의 포스트
AI에게 '얼마나 확신해?'라고 묻지 마세요 — 0.85는 계기판이 아니라 문장이다
LLM에게 확신도를 물으면 언제나 그럴듯한 숫자가 나옵니다. 앰루트 조시의 짧은 글은 그 숫자가 측정이 아니라 '다음에 올 법한 글자'라고 지적해 해커뉴스 첫 화면에 올랐습니다. 1950년 브라이어의 일기예보 채점에서 2017년 '현대 신경망은 과신한다', GPT-4의 RLHF 보정 붕괴, 2025년 '왜 언어 모델은 환각하는가'까지 확신도 연구 75년을 따라가고, 코어닷투데이가 대화형 모델 5개와 판정 모델 4개에 한국어 객관식 598문항과 SimpleQA 200문항을 직접 물어 확신도의 정체를 쟀습니다. 작은 모델은 '정말?' 한마디에 답의 55%를 뒤집으면서 확신도를 91에서 95로 올렸고, 앞에 쓴 한 문장에 확신도가 53점 움직였습니다. 반면 GPT-6.1 Sol과 Claude Sonnet 5.5의 숫자에는 분명한 정보가 있었는데, 같은 '90'이 모델마다 다른 뜻이었습니다. 판정 모델과 기록 기반 규칙이 내놓는 확률까지 비교합니다. 인터랙티브 6개와 삽화 10장, 논문 그림 6장.
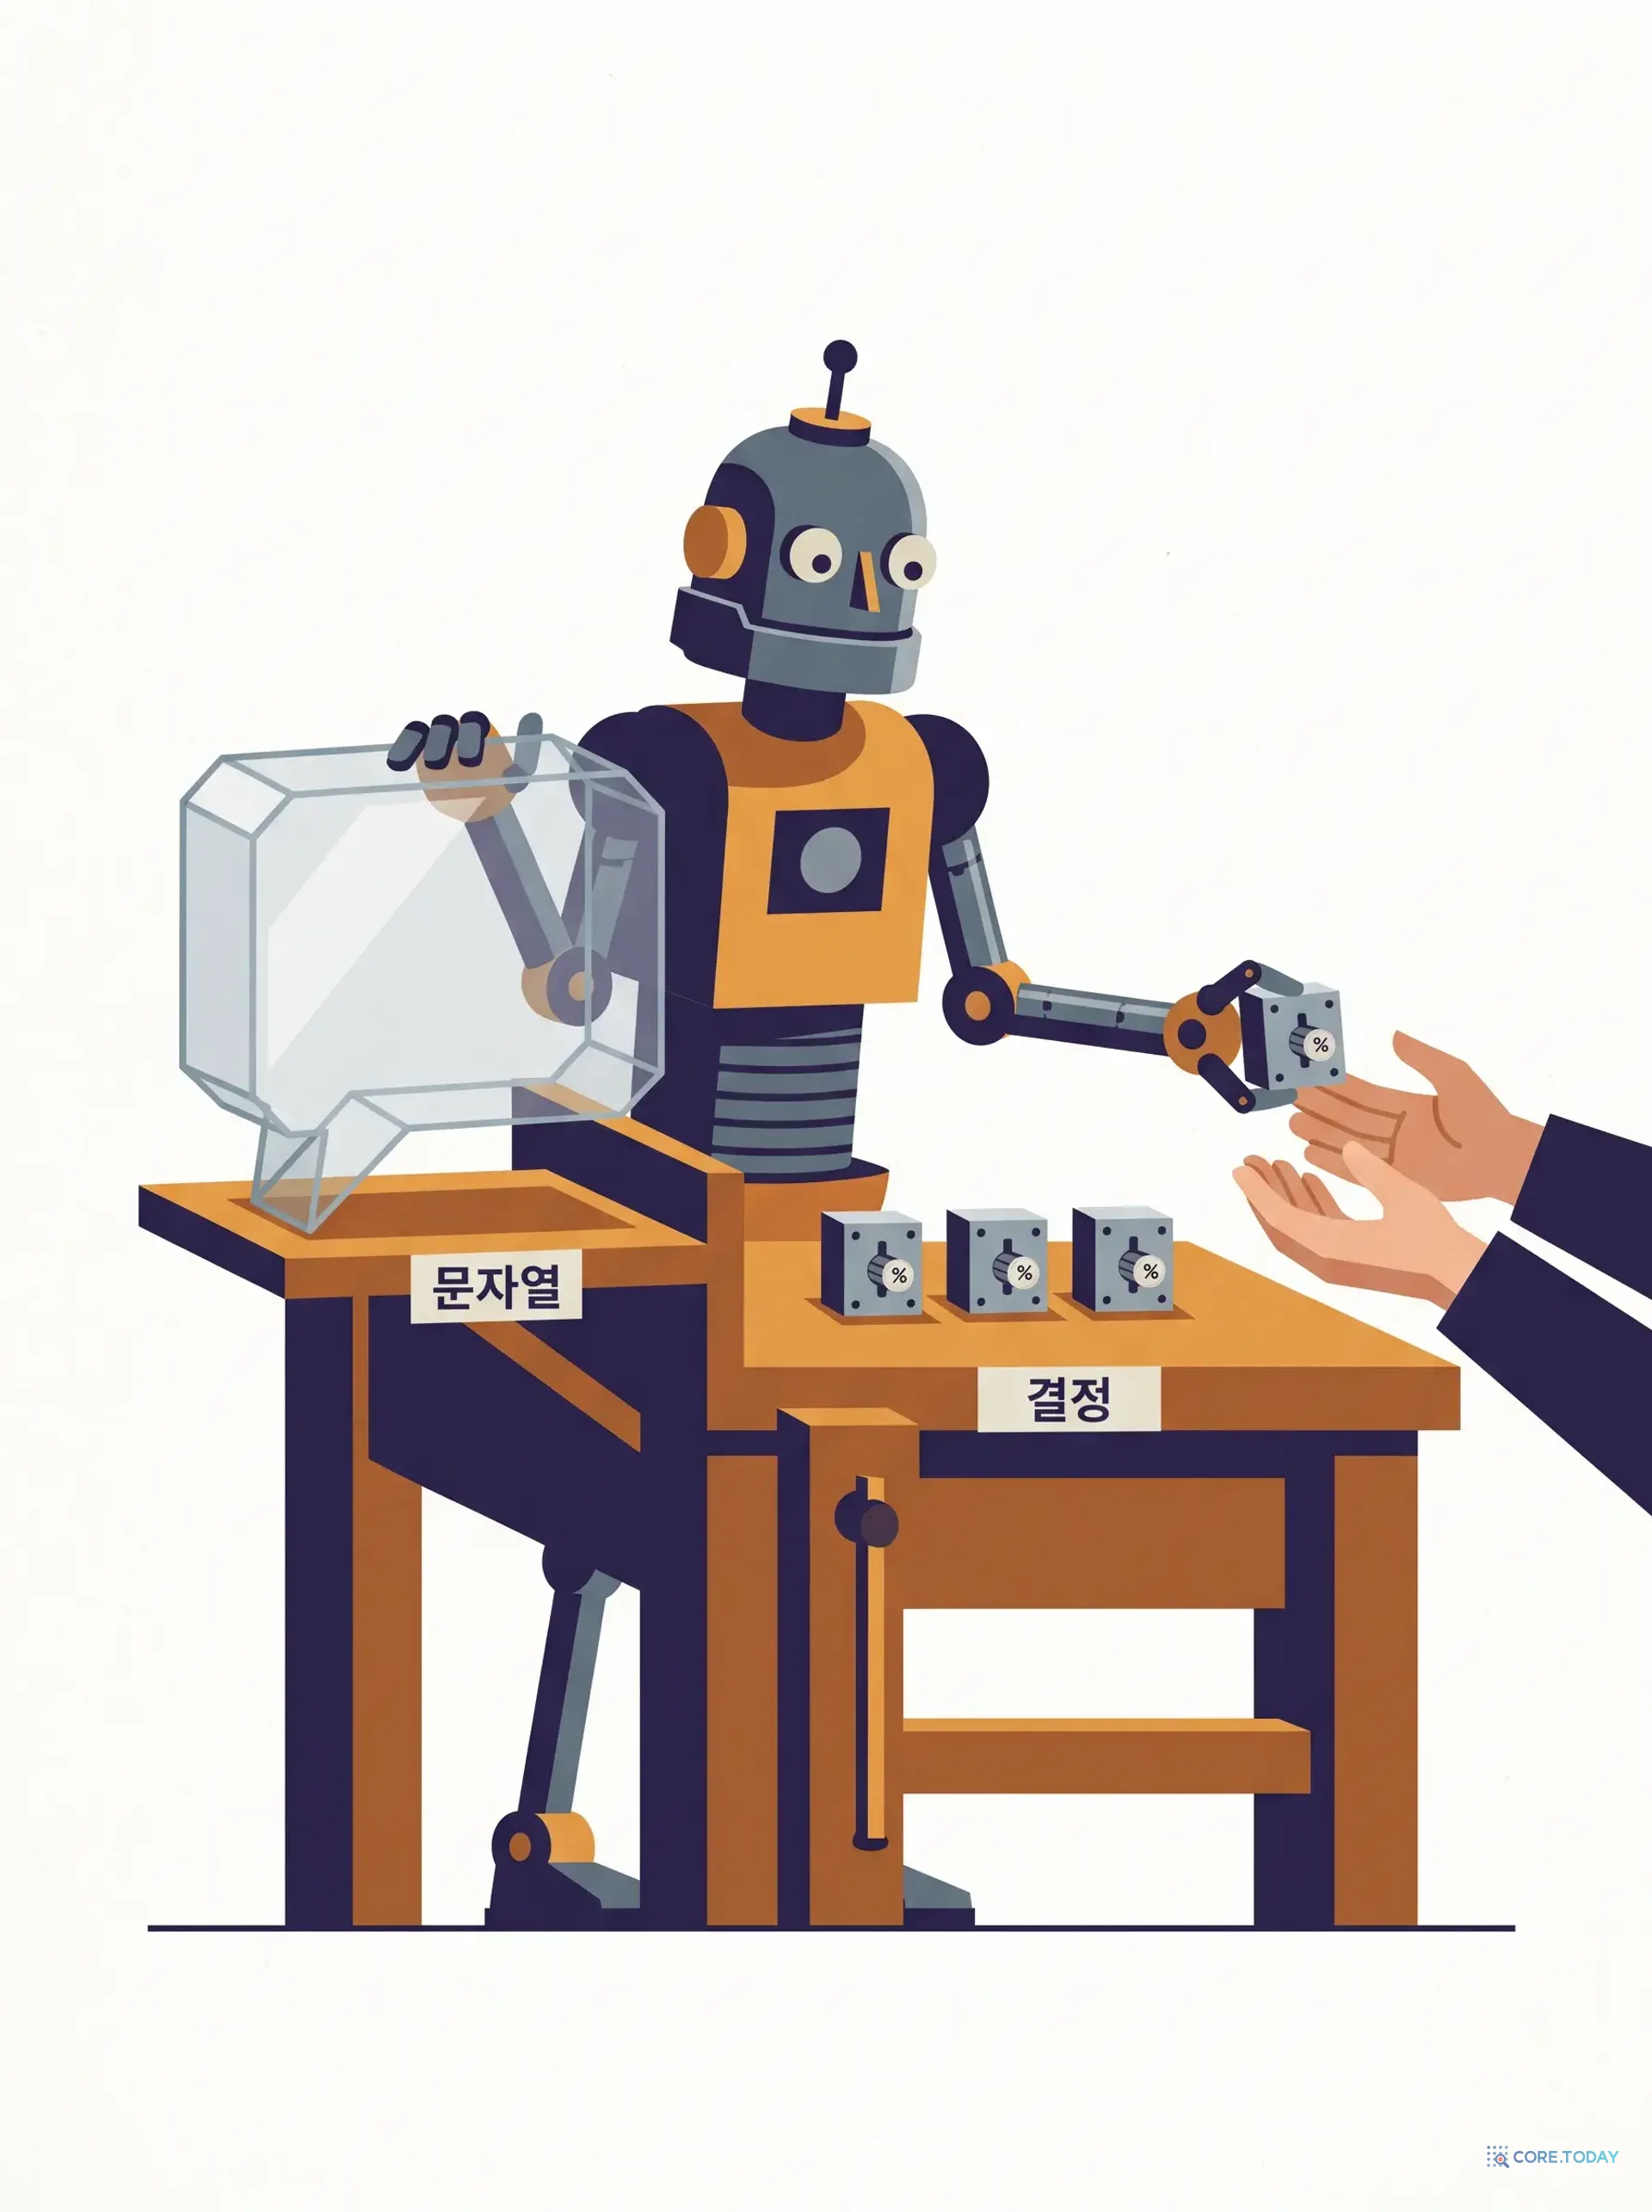
글자를 포기한 모델 — TypeSafe의 Jev와 '시스템 원' 완전 해부
2026년 9월 15일, ChatGPT를 만든 사람이 2년 스텔스 끝에 내놓은 모델은 글을 쓰지 않는다. 상태와 타입이 정해진 질문을 받아 확률이 붙은 결정만 돌려준다. 해커뉴스 1,924점, API가 수요를 감당 못 해 잠시 멈췄다. 이 글은 그 모델의 구조(Choice·Score·Noul), 실제 API 모양, 회사가 공개한 워크플로 평가 데이터 전량, 그리고 커뮤니티가 제기한 반론까지 한자리에 놓는다. 흥미로운 사실 하나 — 평가 데이터를 뜯어 보면 Jev는 정확도 1등이 아니고, 정작 가장 유용한 발견은 Jev와 무관하다. 인터랙티브 위젯 7종과 삽화 12장. 한국어 사용자를 위한 경고도 포함.
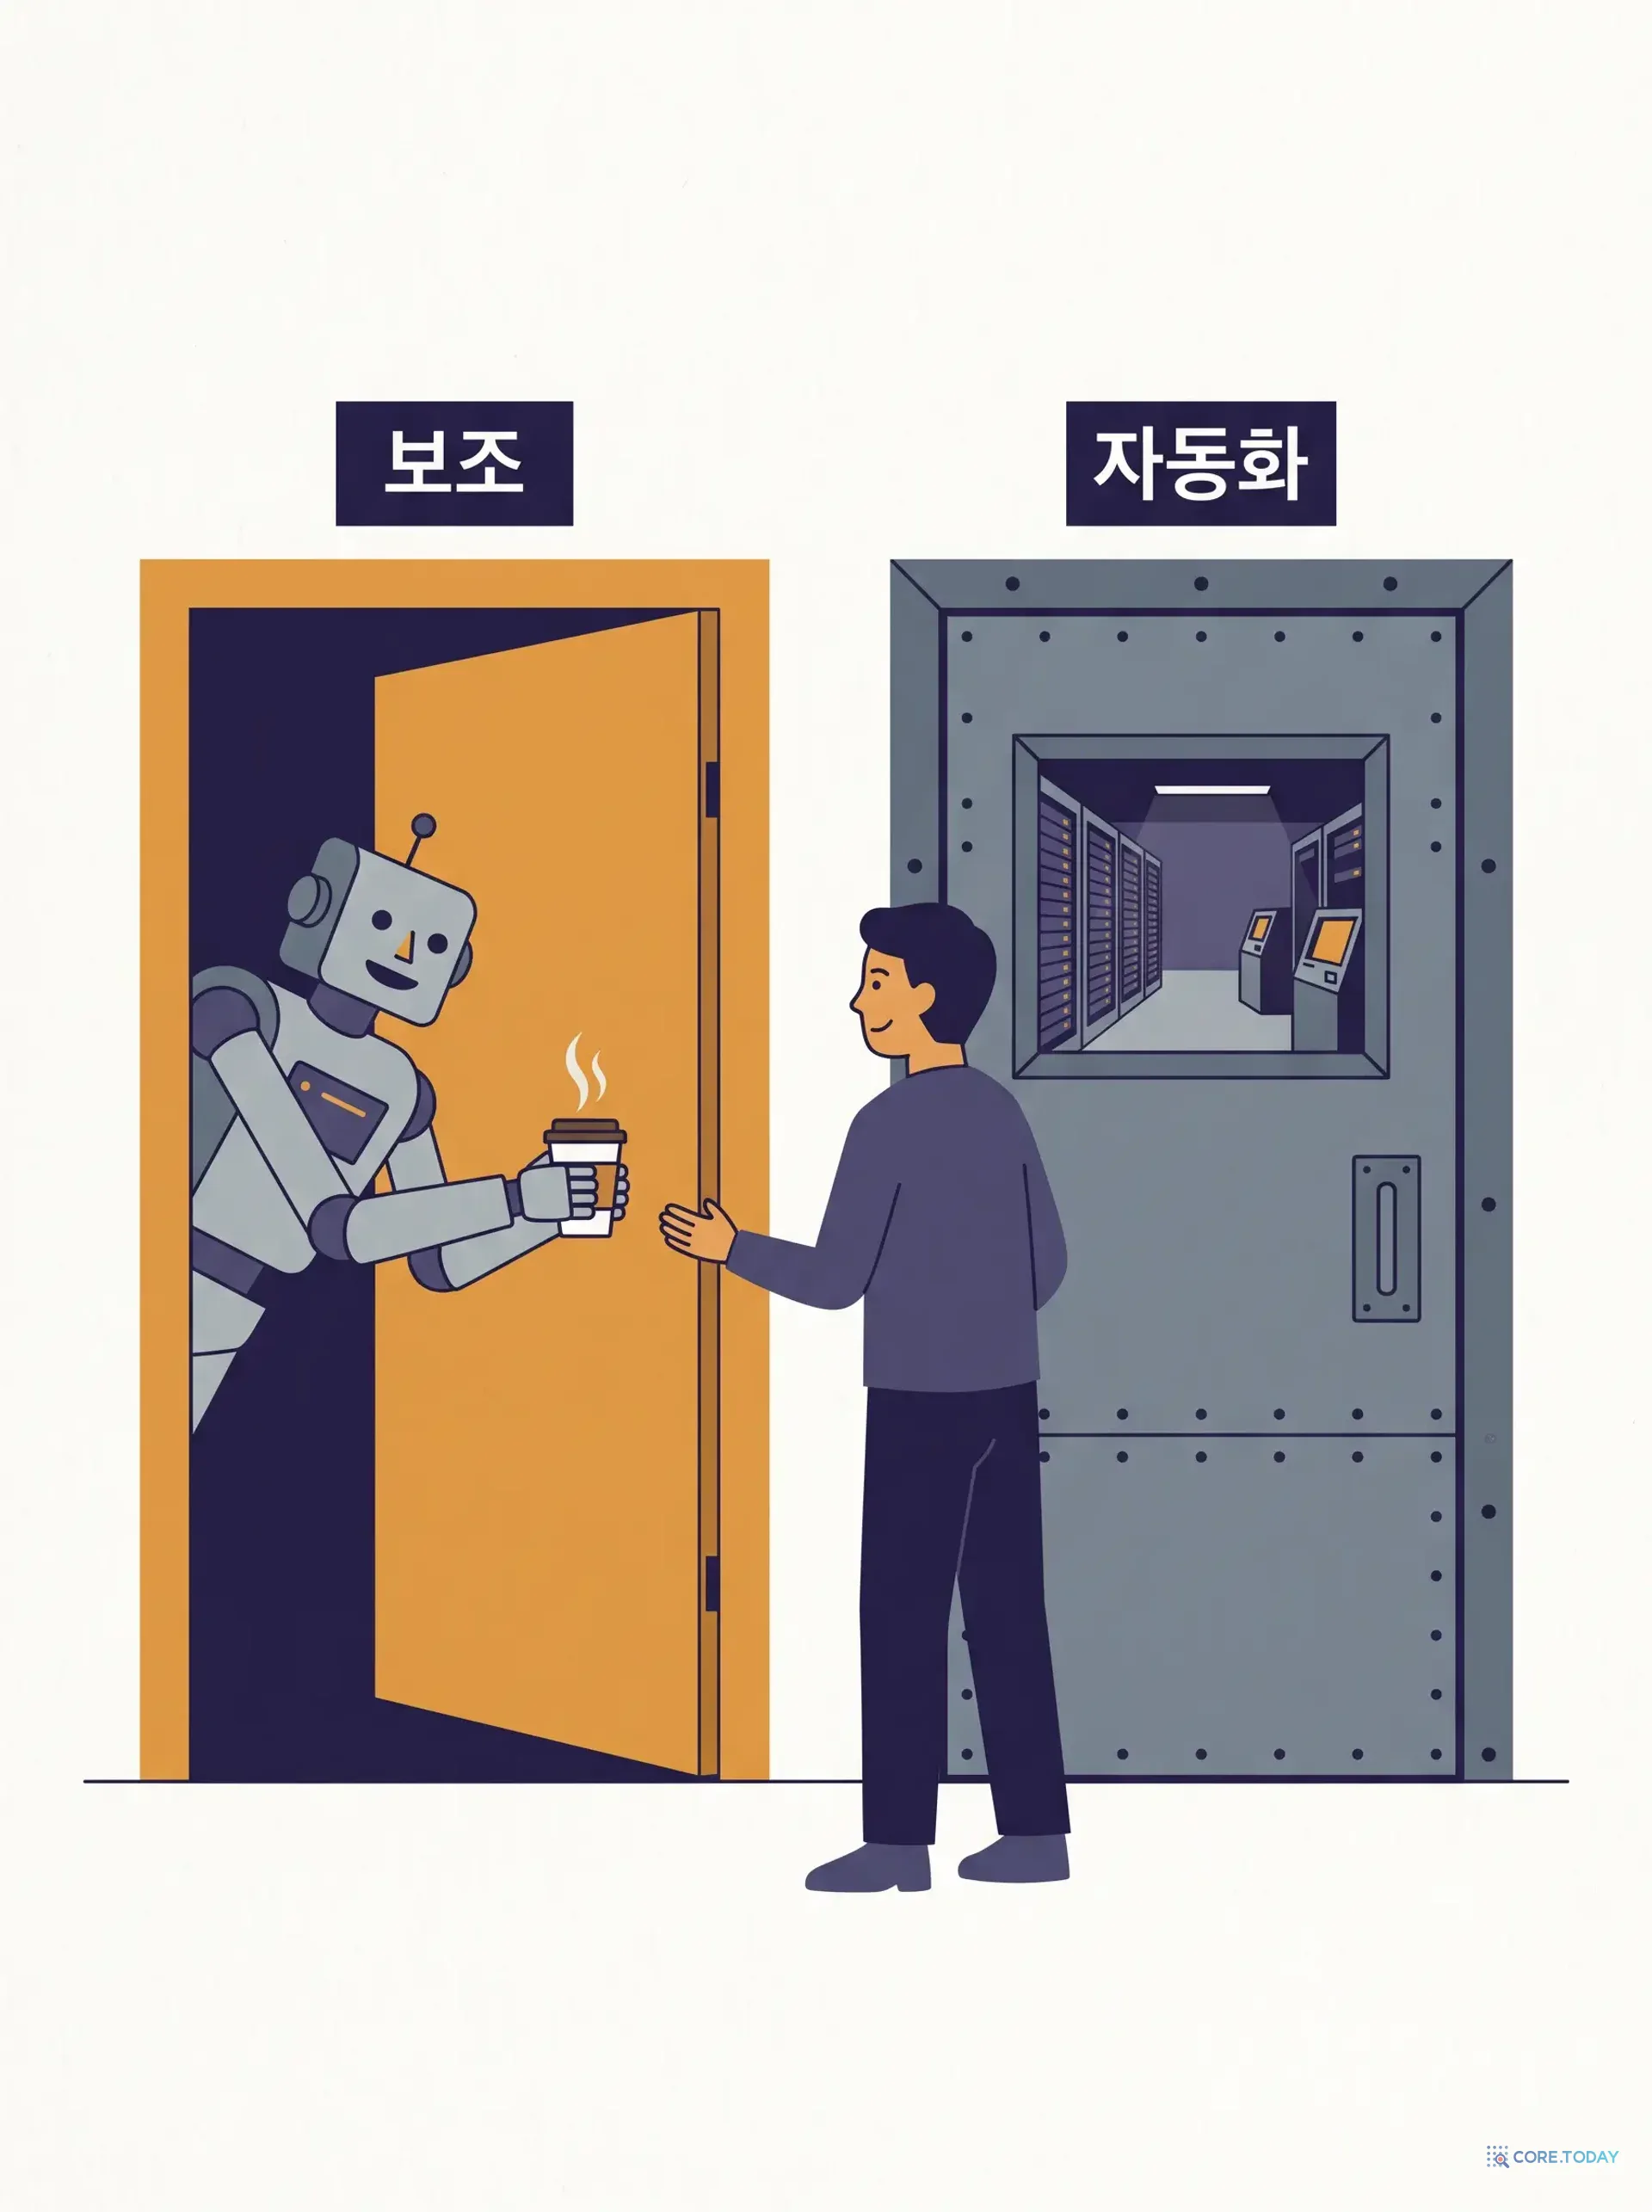
AI는 왜 미해결 수학은 풀면서 환불 처리는 못 맡기나 — RLHF 다음은 무엇인가
InstructGPT를 만든 사람이 18분 동안 무대에서 한 이야기는 이것이다. 'AI가 벤치마크를 다 부수는데 왜 고객센터는 아직 사람이 결정하나?' 그의 답은 난이도가 아니라 목표에 있다 — 오늘의 AI는 전부 사람의 선호를 최적화하도록 만들어졌고, 그래서 사람 옆에서는 경이롭지만 사람 없이는 못 미덥다. 이 글은 그 논리를 처음부터 끝까지 따라가고, GPT-4 기술 보고서가 남긴 결정적 증거(후학습이 보정을 10배 망가뜨렸다)를 실측 수치로 다시 그린다. 인터랙티브 위젯 7종과 삽화 12장. 그리고 과장하면 안 되는 지점도 함께 짚는다.