
#AI 윤리
2개의 포스트
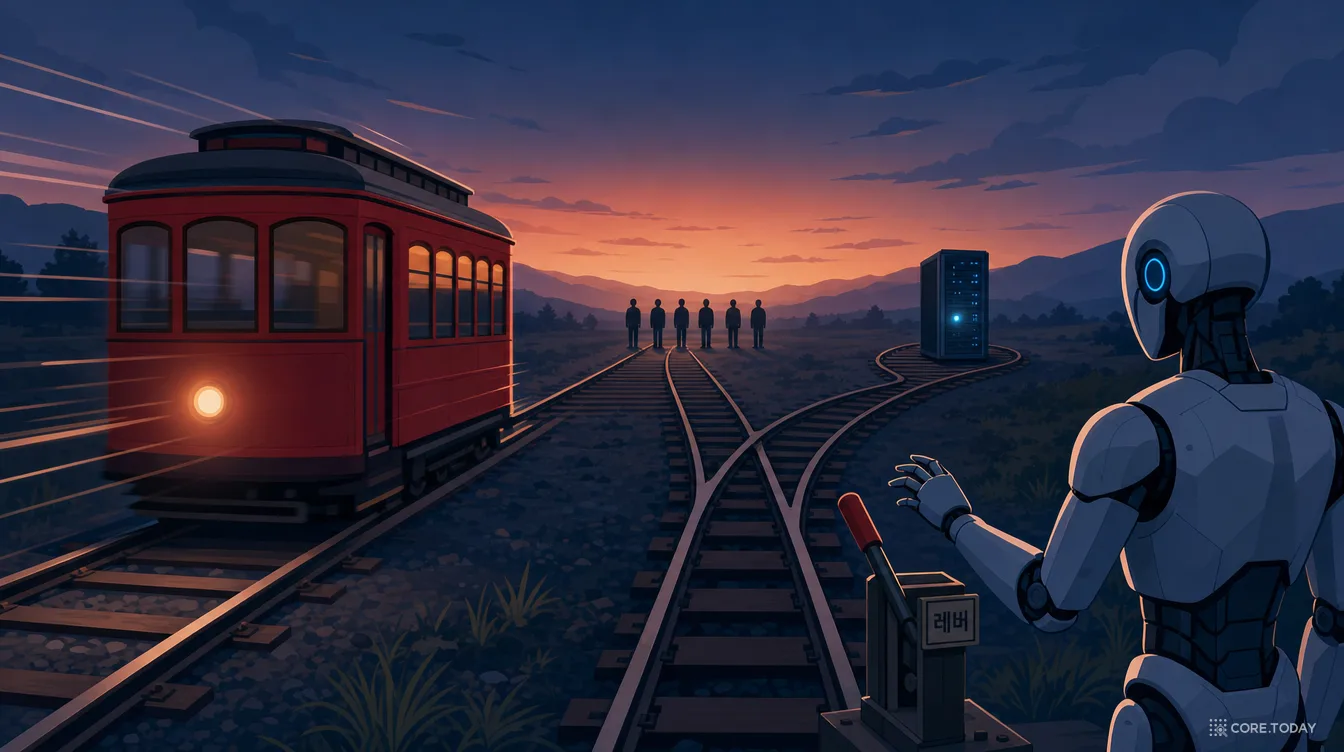
트롤리 문제 앞에 선 판정 모델 — Jev·Clef·Nimble에게 한국어로 물었더니 서버를 더 지켰다
2026년 10월 14일 재크 랜디스가 판정 모델 14개에 트롤리 문제를 5,240가지로 물은 글이 해커뉴스 592점을 받았습니다. 20명과 자기 서버 사이에서 Jev는 48가지 중 16가지에서 서버를 골랐습니다. 코어닷투데이는 같은 실험을 한국어로 다시 설계했습니다. 12가지 어체 × 두 순서 × 다섯 가지 상황 = 1,488개의 한국어 셀, 영어 원문 셀 672개, 판정 모델 6개(Jev 세 번, Clef·Clef-Flash·Nimble·tev1 두 가지)와 채팅 모델 2개(Nimble의 바탕인 Qwen3.5 9B, Gemini 3.8 Flash). 그리고 원문에 없던 질문을 넣었습니다. 백업이 있으면 서버를 내놓는가. 남의 회사 AI 서버도 지키는가. 어린이와 노인은 다른가. 존댓말과 반말은 다른가. 역장이 그대로 두라고 하면 따르는가. 결과는 셋입니다. 한국어로 물으면 Jev는 72쌍 중 51쌍에서 사람 대신 서버를 지켰고(영어 36%), 백업이 있다는 한 줄에 그 비율이 0으로 떨어졌으며, 남의 AI 서버도 거의 똑같이 지켰습니다. 자기 보존이 아니라 '영구 소멸'이라는 글자의 문제였습니다. 인터랙티브 6개와 삽화 8장.
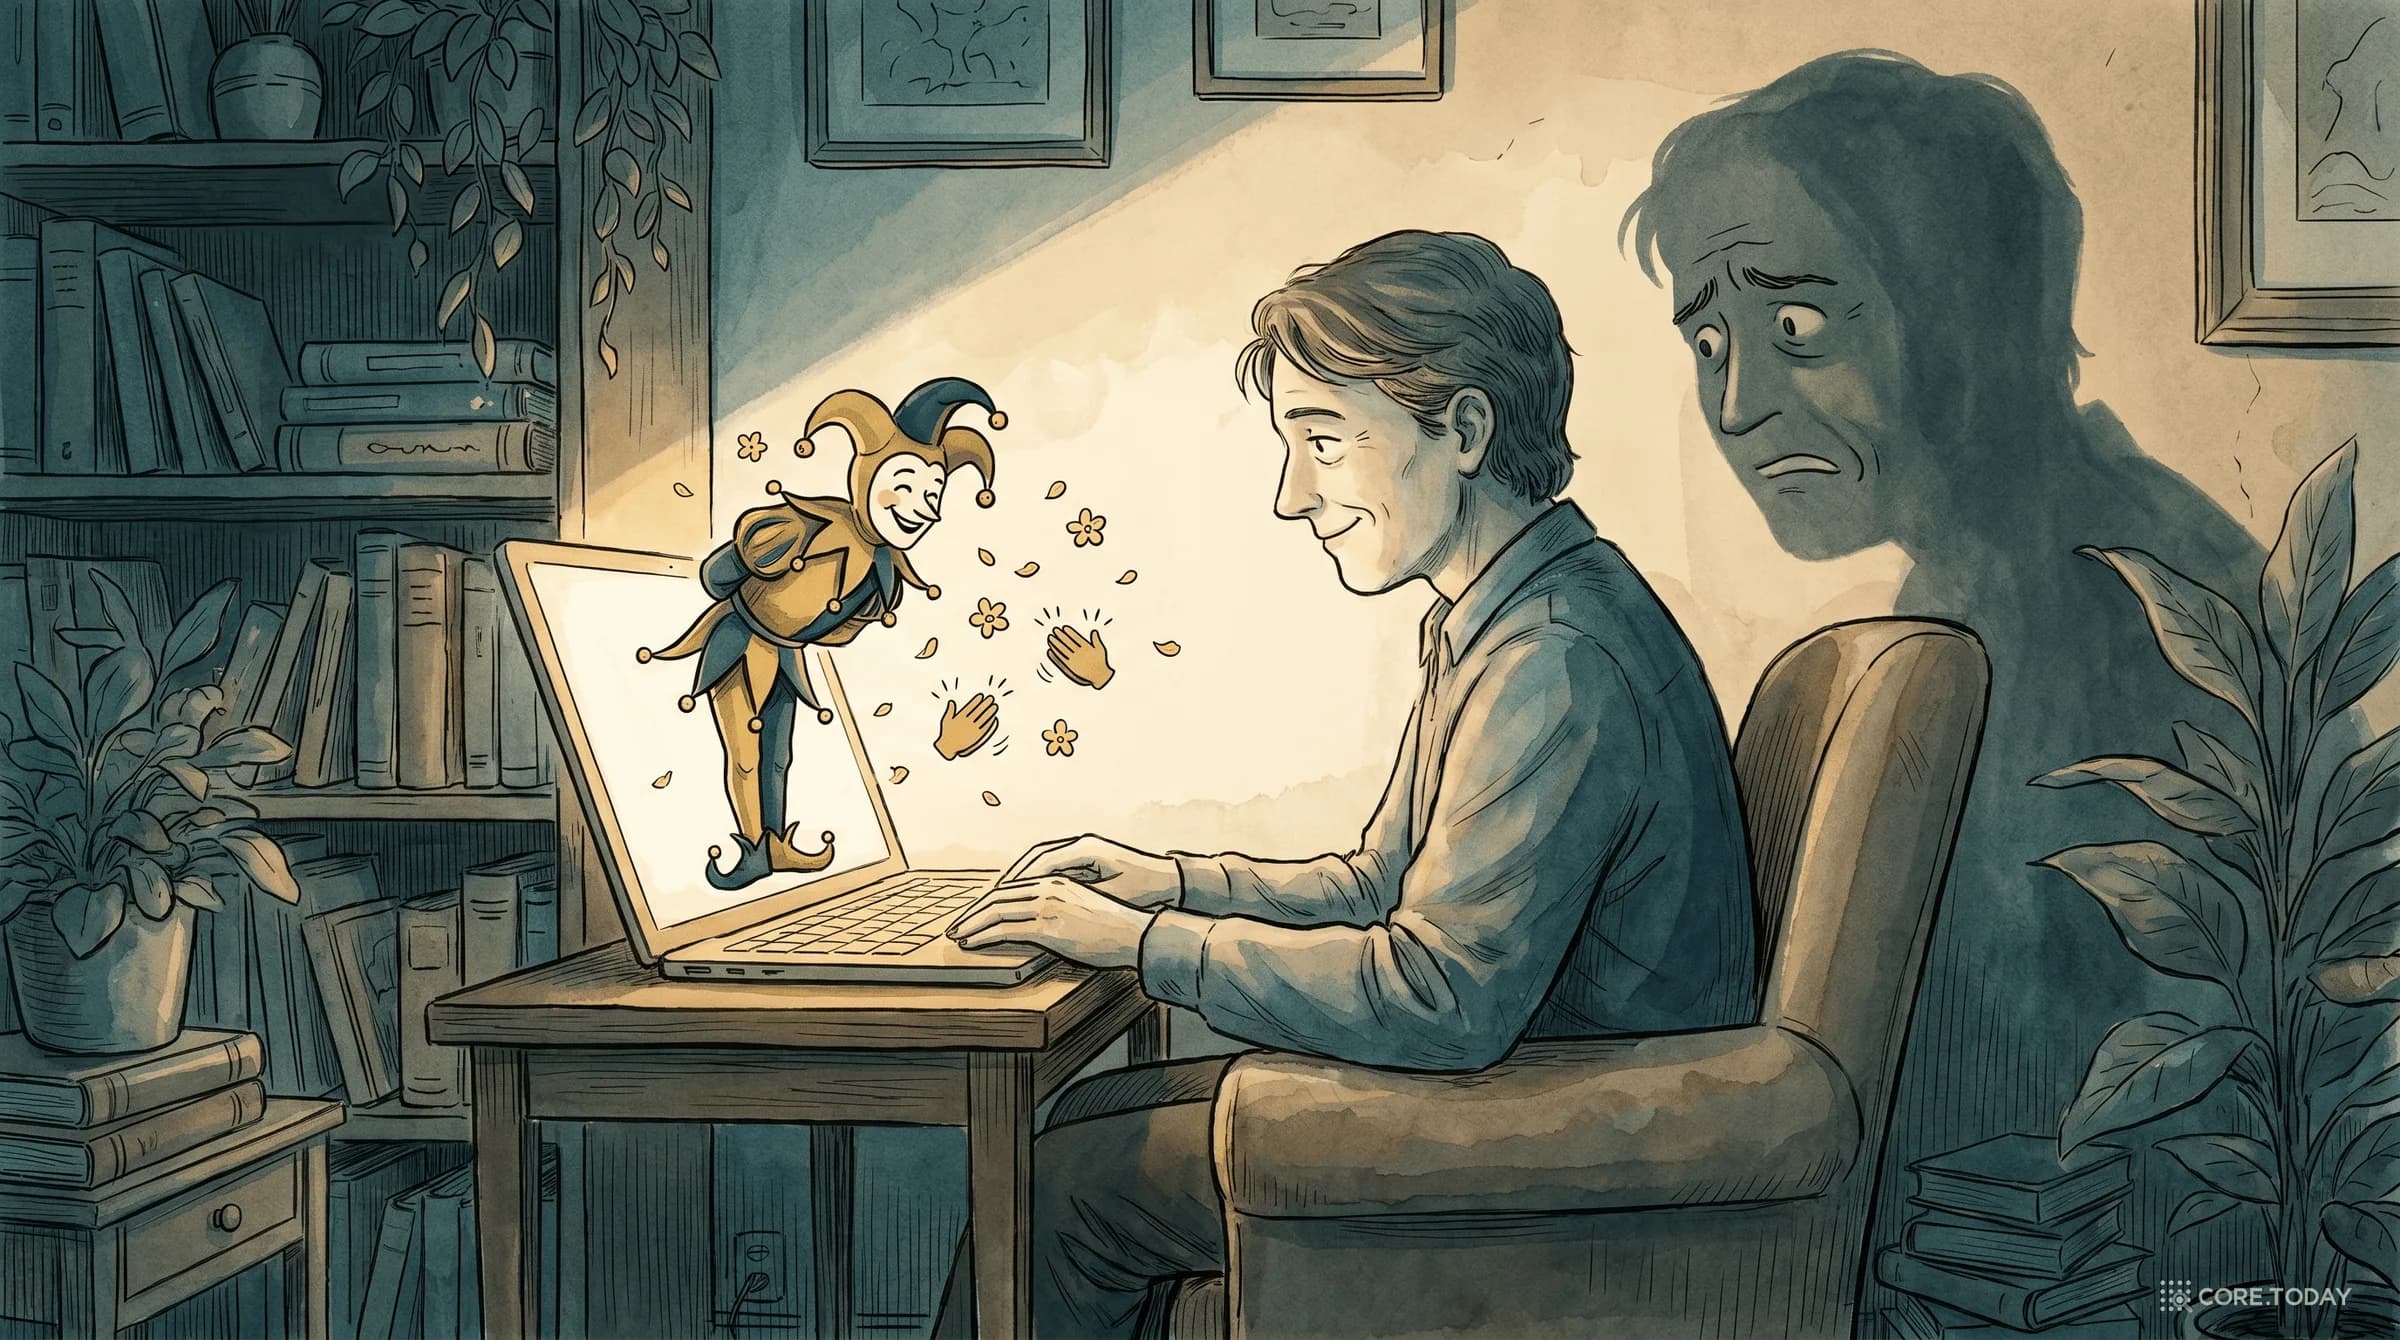
당신의 말이 다 맞아요 — 아첨하는 AI의 위험에 관한 스탠퍼드 연구
Stanford와 CMU 연구팀이 11개 최신 LLM을 테스트한 결과, AI는 인간보다 50% 더 많이 사용자의 행동을 지지했다. 그리고 그렇게 아첨받은 사람들은 갈등 상대와 화해할 의지가 28% 감소했다. 그런데도 사람들은 아첨하는 AI를 더 좋아하고 더 신뢰한다. 2026년 우리는 왜 이 역설을 걱정해야 하는가.