
#트랜스포머
12개의 포스트
말할수록 무거워지는 기억 — KV 캐시로 본 긴 대화의 비용, 2017년의 첫 캐시부터 GQA·페이지드 어텐션·MLA·어텐션 싱크까지 (특집)
챗봇과의 대화가 길어질수록 답이 느려지고 요금이 오르는 이유는 KV 캐시에 있다. 언어 모델은 한 토큰씩 글을 쓰는데, 앞서 읽은 모든 토큰의 ‘키(K)’와 ‘값(V)’을 메모리에 쌓아 두고 다시 꺼내 쓴다. 계산을 메모리와 맞바꾼 이 장치 덕분에 생성은 빨라졌지만, 대신 대화가 길어질수록 GPU 메모리를 정직하게 잡아먹는다. 이 글은 2017년 원조 트랜스포머 논문에는 없던 캐시가 석 달 뒤 구글 코드에 들어간 이야기에서 시작해, 헤드를 나눠 쓰는 MQA·GQA, 캐시를 압축해 담는 딥시크의 MLA, 운영체제의 가상 메모리를 빌려 온 페이지드 어텐션, 같은 앞부분을 재사용하는 프롬프트 캐싱, 캐시를 2비트로 줄이는 양자화, 그리고 모델이 첫 토큰을 ‘주의 하수구’로 쓴다는 어텐션 싱크까지 따라간다. 그리고 직접 쟀다. 사내 V100에서 Qwen3 0.6B~8B의 캐시 크기와 속도, 동시 사용자 한계, 앞부분 재사용 효과, 캐시 양자화, 창 크기 제한을 실험했고, 피티아의 학습 체크포인트를 거슬러 올라가 어텐션 싱크가 생기는 순간을 찾았다. 1.6만 토큰짜리 앞부분의 캐시를 재사용하자 Qwen3-8B의 첫 토큰이 54배 빨리 나왔다. 캐시를 4비트로 줄일 때 Qwen3는 키를 토큰별로 자르자 무너졌지만, 채널별로 자르면 멀쩡했다. 최근 토큰만 남기자 흔들리던 모델은 첫 토큰 하나를 붙잡아 두자 되살아났다. 인터랙티브 위젯 7종, 코어닷투데이 실측, 삽화 13장.
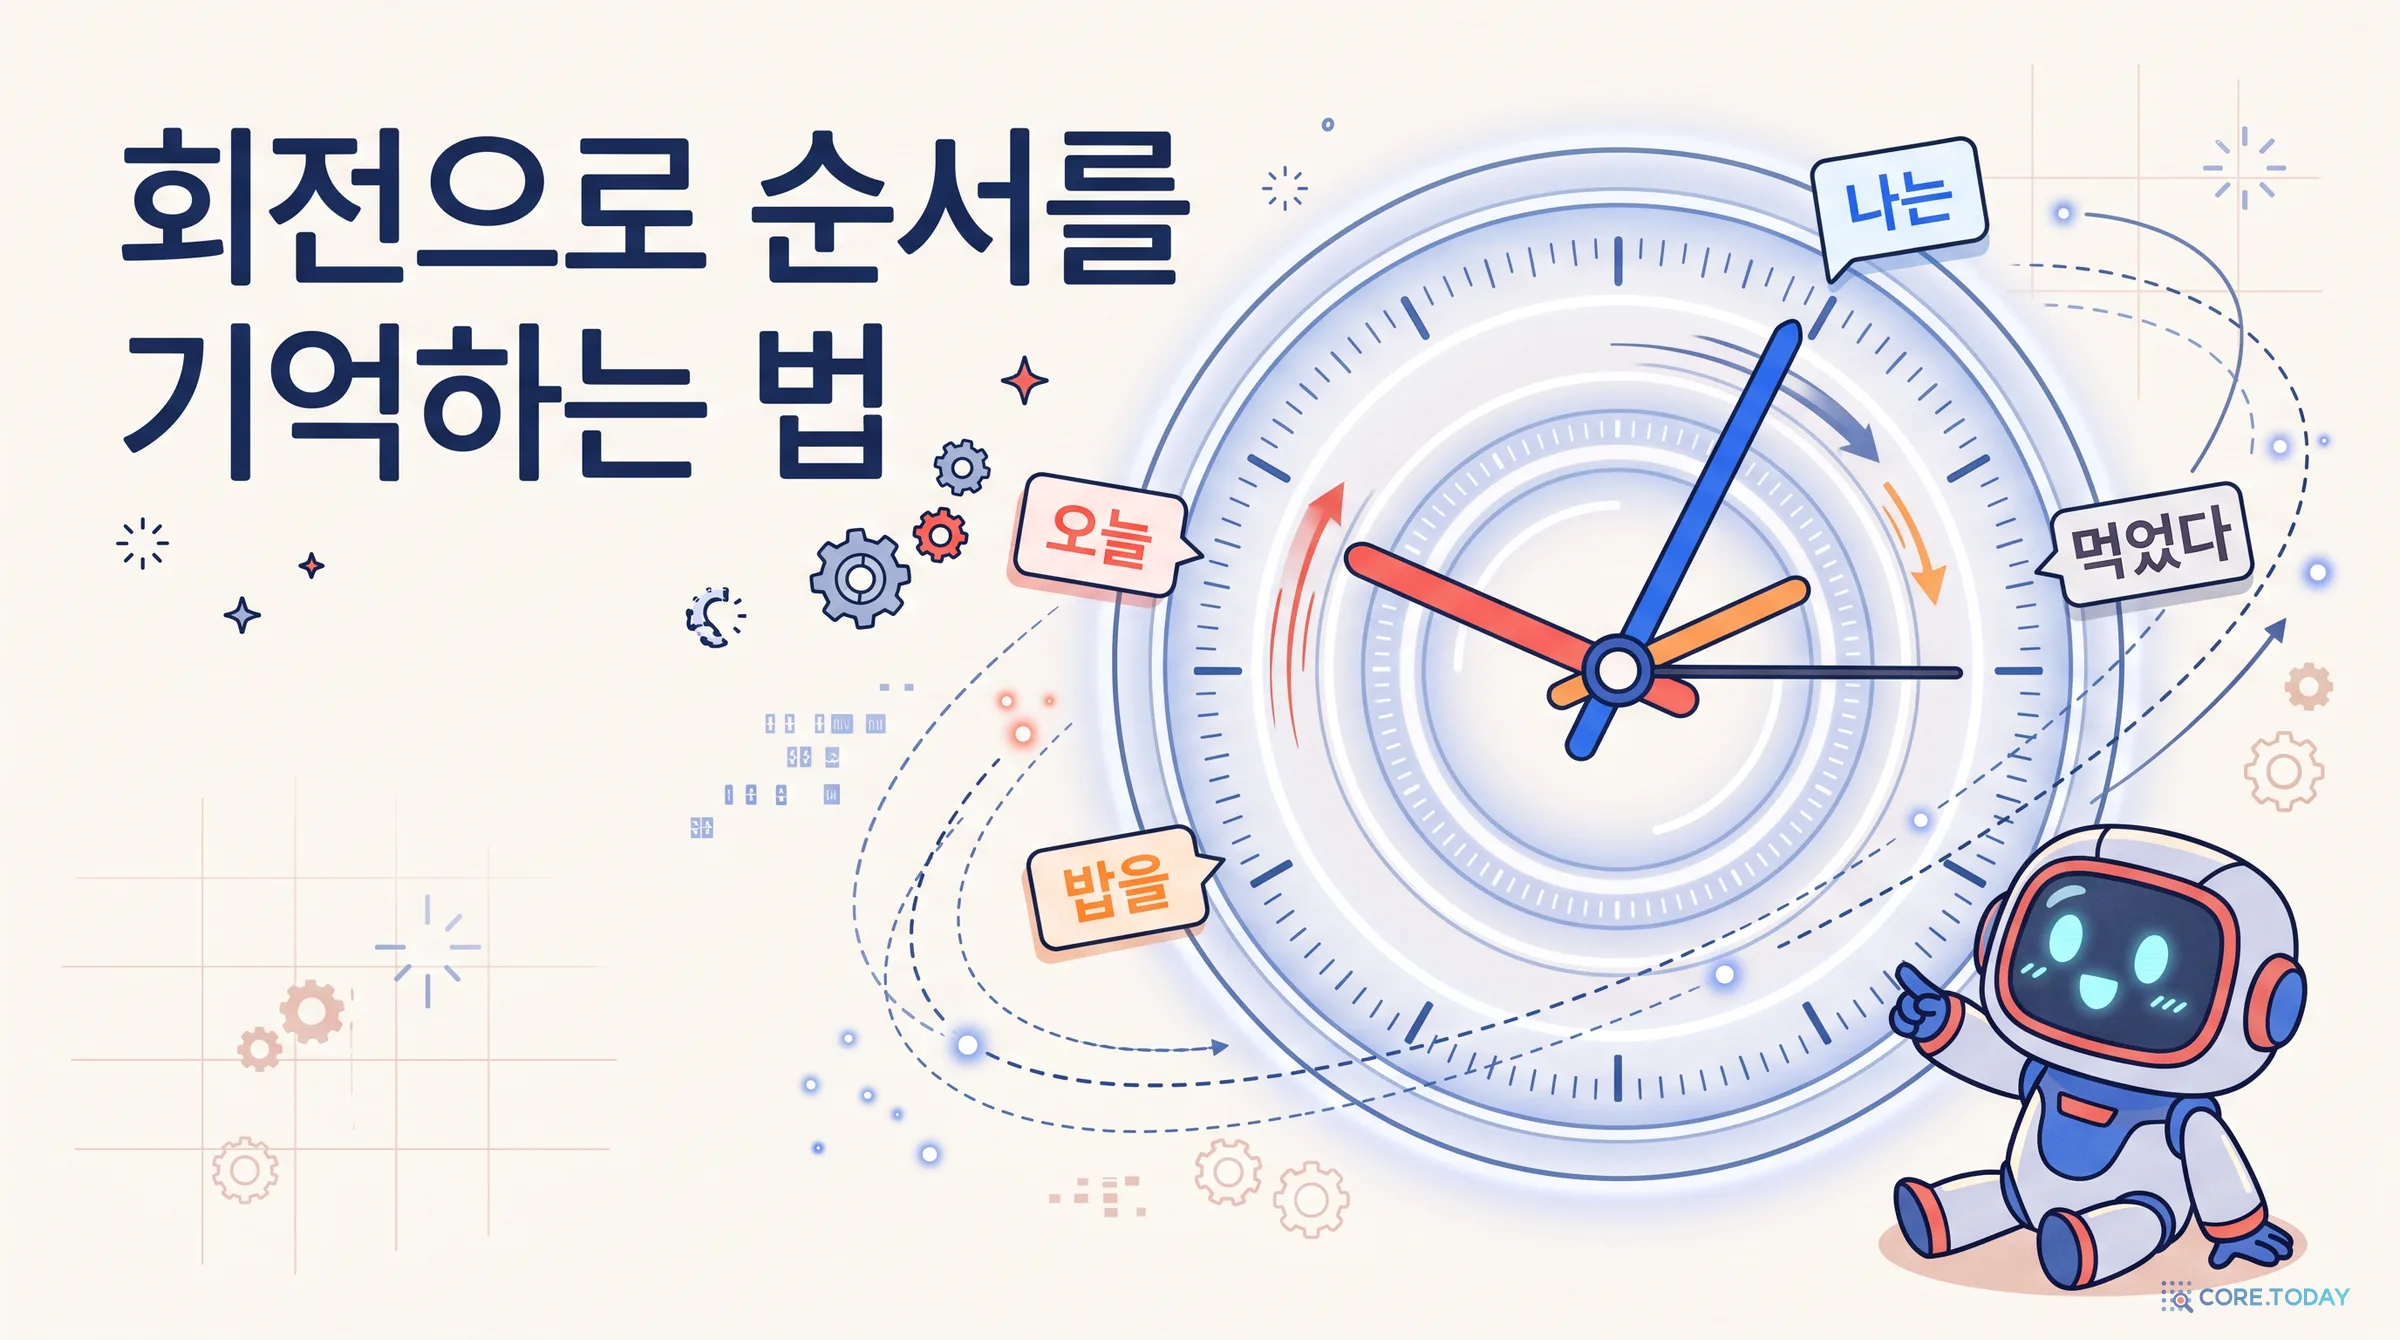
순서를 모르는 트랜스포머에게 순서를 가르치는 법 — 회전 위치 인코딩 RoPE와 100만 토큰 문맥 (특집)
트랜스포머의 어텐션은 단어 순서를 모른다. 위치 정보가 없으면 ‘dog bites man’과 ‘man bites dog’에서 dog가 받는 계산 결과가 똑같다. 2017년 사인파를 더하는 방식으로 시작한 위치 인코딩은, 2021년 중국 블로그에서 나온 ‘벡터를 위치만큼 돌린다’는 아이디어 RoPE로 수렴했고 지금 Llama·Qwen·Gemma·EXAONE이 모두 이를 쓴다. 이 글은 회전이 왜 상대 거리를 담는지 시계 바늘로 따라가고, 학습 길이를 넘으면 왜 무너지는지, 개인 개발자와 레딧 게시판이 논문보다 먼저 찾은 문맥 확장 트릭이 어떻게 YaRN과 100만 토큰 시대로 이어졌는지 정리한다. 2,048토큰만 배운 모델에게 8,192토큰을 읽힌 실측, 공개 모델 17종의 RoPE 설정 비교, 긴 문맥을 정말 다 쓰는지에 대한 평가까지 담았다. 인터랙티브 위젯 5종, 코어닷투데이 실측, 삽화 13장.
코딩을 사랑한 사람의 슬픔 — 「Feeling sad about AI」가 건드린 것, 그리고 2026년의 데이터
2026년 9월 11일, 영국의 한 개발자가 9분짜리 영상을 올렸다. 코드는 한 줄도 나오지 않는 영상이었다. 그는 AI가 슬프다고 말했고, 그 슬픔의 이름을 '무시당함'이라고 붙였다. 해커뉴스 282개, Lobsters 67개의 댓글이 달렸다. 이 특집은 그 글을 끝까지 읽고, 왜 이 감정이 지금 터졌는지를 장인과 탈숙련의 역사에서 찾고, 'AI가 코딩한다'는 문장을 트랜스포머부터 에이전트 하네스까지 분해하고, 2026년의 실측 데이터로 그 문장의 진위를 따진다. 인터랙티브 실험 4종과 논문 원본 그림을 함께 싣는다.
AI가 단골을 알아보는 법 — 프롬프트 캐시 작동 원리, 일러스트로 이해하기
카페 단골은 '늘 마시던 걸로'라는 한마디면 된다. 그런데 AI는 왜 매번 대화 전체를 처음부터 다시 읽을까 — 그리고 프롬프트 캐시는 어떻게 그 낭비를 10분의 1 가격으로 줄일까? 독서 노트, 도미노, 냉장고, 기차 네 가지 비유와 일러스트로 KV 캐시의 원리를 바닥부터 그려 본다. 왜 '접두사'만 적중하는지, 왜 캐시 쓰기는 비싸고 읽기는 싼지, 왜 1시간이 지나면 증발하는지 — 그림으로 이해하면 /rewind와 /compact 중 뭘 눌러야 할지가 저절로 보인다.
‘작동 원리를 아는 마지막 사람들’ — 추상화의 탑, 그리고 아무도 다 모르게 된 맨 위층
2026년 6월, ‘우리는 작동 원리를 아는 마지막 사람들’이라는 에세이 한 편이 개발자 세계를 뒤흔들었습니다. 단순한 향수일까요, 아니면 정말 이번엔 다른 걸까요? 1990년대의 autoexec.bat부터 트랜스포머 아키텍처, 그리고 ‘만든 게 아니라 길러낸’ AI의 내부까지 — ‘안다는 것’의 역사를 추상화의 탑을 한 층씩 내려가며 쉽고 재미있게 풀어드립니다.
지수곡선 위의 정책: 다리오 아모데이는 왜 '나무수염'을 깨우려 하는가
2026년 6월, Anthropic CEO 다리오 아모데이가 '지수곡선 위의 정책'이라는 에세이를 발표했다. AI는 빛의 속도로 달리는데 정책은 거목(나무수염)의 속도로 움직인다는 이 글은, 발표 이틀 뒤 미국 정부가 바로 그 글이 말한 권한을 Anthropic 자신에게 휘두르면서 더 큰 화제가 됐다. '지수곡선'이 대체 무엇인지(스케일링 법칙과 트랜스포머)부터 그가 제안한 5대 정책까지, 2026년 가장 뜨거운 AI 정책 문서를 쉽고 자세하게 풀어본다.
시간을 읽는 AI: 구글 TimesFM과 시계열 예측의 'GPT 모먼트'
내일 우리 매장에 우산이 몇 개 팔릴까? 반세기 동안 이 질문에 답하려면 데이터마다 모델을 새로 만들어야 했다. 구글 TimesFM은 LLM이 글로 했던 일을 시계열에 그대로 해냈다 — 한 번 학습하고, 처음 보는 데이터를 추가 학습 없이 예측한다. 통계학의 역사부터 2026년 GIFT-Eval 1위 TimesFM 2.5까지, 시계열 예측의 '파운데이션 모델 혁명'을 쉽게 풀어본다.
Attention Is Not What You Need: 어텐션 없이도 AI가 '생각'할 수 있다면?
2017년, 구글은 'Attention Is All You Need'로 AI 혁명을 열었다. 2025년 12월, 한 연구자가 같은 구조에 정면으로 반기를 든다 — 'Attention Is Not What You Need.' 어텐션 없이 기하학적 다양체 위에서 추론하는 새로운 시퀀스 모델링 패러다임을 해부한다.
RT-DETR 완전 이해: DETR가 YOLO를 이긴 날 — 실시간 트랜스포머 검출의 혁명
NMS 없이 실시간으로 — YOLO의 왕좌에 도전한 최초의 실시간 엔드투엔드 트랜스포머 검출기 RT-DETR가 어떻게 탄생했고, 왜 객체 검출의 패러다임을 바꾸고 있는지를 두 편의 논문과 함께 풀어본다.
셀프 어텐션의 모든 것: 단어들이 서로를 바라보는 법
2016년 '같은 문장 안에서 단어끼리 서로를 바라보게 하자'는 아이디어가 등장했다. 1년 뒤 트랜스포머가 이를 핵심 엔진으로 삼았고, GPT부터 AlphaFold까지 모든 현대 AI의 심장이 되었다. 셀프 어텐션의 탄생, 작동 원리, 변형, 그리고 미래를 추적한다.
Attention의 모든 것: '집중'이 AI의 역사를 바꾸기까지
2014년, 한 박사과정생이 '신경망에게 집중력을 주자'는 아이디어로 번역의 벽을 넘었다. 3년 뒤, 8명의 구글 연구자가 '집중만 있으면 된다'고 선언했다. Attention 메커니즘의 역사, 직관적 이해, 그리고 트랜스포머 혁명의 전 과정을 추적한다.
Mixture of Experts 완전 해부: 1.8조 파라미터인데 왜 빠른가
GPT-4는 1.8조 파라미터지만 추론 시 222B만 활성화된다. 어떻게 가능한가? 1991년 MIT에서 시작된 '전문가 혼합' 아이디어가 34년 뒤 모든 프론티어 AI 모델의 핵심 아키텍처가 되기까지 — Expert의 정체, 라우팅의 작동 원리, 실전 사례와 논란까지 완전 해부한다.