
#임베딩
7개의 포스트
문서를 한 점으로 누르지 않는다 — KURE-v2와 한국어 late interaction 검색 (RAG 특집 7편)
154M 파라미터짜리 한국어 검색 모델이 MTEB 한국어 검색 9과제 평균에서 7.6B·27B 단일 벡터 모델을 앞섰다. 비결은 크기가 아니라 비교 방식이다. 문서 전체를 벡터 하나로 누르는 대신 토큰마다 128차원 벡터를 남겨 두고, 질의 토큰마다 가장 잘 맞는 문서 토큰을 찾아 더한다(MaxSim). 2026년 8월 29일 공개된 KURE-v2는 이 late interaction 방식을 한국어·영어에 적용한 첫 본격 모델이다. 이 특집은 단일 벡터가 무엇을 잃는지, 조사·형태소·영한 혼용이 많은 한국어에서 토큰 단위 비교가 왜 유리할 수 있는지, 평균 1위 뒤에 숨은 과제별 승패, 문서마다 벡터 수백 개를 저장하는 대가와 그것을 1.7GB로 줄이는 법, 그리고 Qwen3 임베딩과 공정하게 비교하는 실험 설계를 위젯 5종으로 따라간다. 결론은 3편과 같다 — 기본은 하이브리드, late interaction은 고가치 한국어 질의에만.
RAG는 생각보다 단순합니다 — 벡터 DB 없이 시작하는 6단계 레시피
RAG를 어렵게 느끼는 이유는 개념이 아니라 '처음부터 임베딩·벡터 DB·청킹을 다 갖춰야 한다'는 오해 때문입니다. 오픈북 시험 비유로 RAG의 뼈대를 3분 안에 잡고, 라이트하우스 뉴스레터가 정리한 6가지 RAG 레시피를 전문 검색부터 전체 임베딩까지 계단처럼 올라가며 살펴봅니다. 실제 시스템의 60%는 검색기 하나와 프롬프트 한 장으로 충분합니다. 우리 팀에 맞는 출발점을 고르는 진단 도구와, 같은 질문을 세 방식으로 검색해 보는 놀이터를 함께 담았습니다.
하루 15,000개의 질문에 답하는 사내 AI — Cerebras는 지식 베이스를 어떻게 만들었나
"그거 어디 있죠?" "이거 누가 담당이죠?" — 회사가 커질수록 정보는 흩어지고, 같은 질문이 반복된다. Cerebras는 Slack·코드·문서를 하나의 임베딩 테이블로 모아 하루 15,000개 질문에 답하는 사내 지식 베이스를 만들었다. 그 안에는 반세기 검색의 역사가 응축돼 있다. 키워드 검색에서 BM25, 임베딩, HNSW, 하이브리드, 그리고 에이전트 검색까지 — 왜 이런 개념들이 하나씩 필요해졌는지, 인터랙티브하게 만져보며 이해한다.
Contextual Retrieval 완전 정복 — AI가 '맥락'을 되찾는 방법
전통 RAG의 치명적 약점 — 청크가 맥락을 잃어버리는 문제를 Anthropic이 어떻게 해결했는가. 1957년 TF-IDF부터 2026년 Agentic RAG까지, 정보 검색의 역사와 함께 Contextual Retrieval의 원리, 구현, 벤치마크를 완전 해부한다.
Advanced RAG: 기본 RAG의 한계를 넘는 실전 개선 기법 7가지
기본 RAG를 실전에 배포하면 마주치는 문제들 — 엉뚱한 문서가 검색되고, 핵심이 잘려나가고, 답변 품질이 들쭉날쭉하다. 청킹 전략부터 하이브리드 검색, 리랭킹까지, 실무에서 바로 적용할 수 있는 개선 기법을 하나씩 풀어본다.
RAG 완전 이해: LLM은 왜 거짓말을 하고, 검색은 어떻게 이를 바로잡는가
1000권을 외운 천재가 왜 어제 환율을 틀리는지, 그리고 '답하기 전에 먼저 찾아봐'라는 단순한 아이디어가 어떻게 AI의 가장 중요한 아키텍처 패턴이 되었는지를 논문과 사례로 풀어본다.
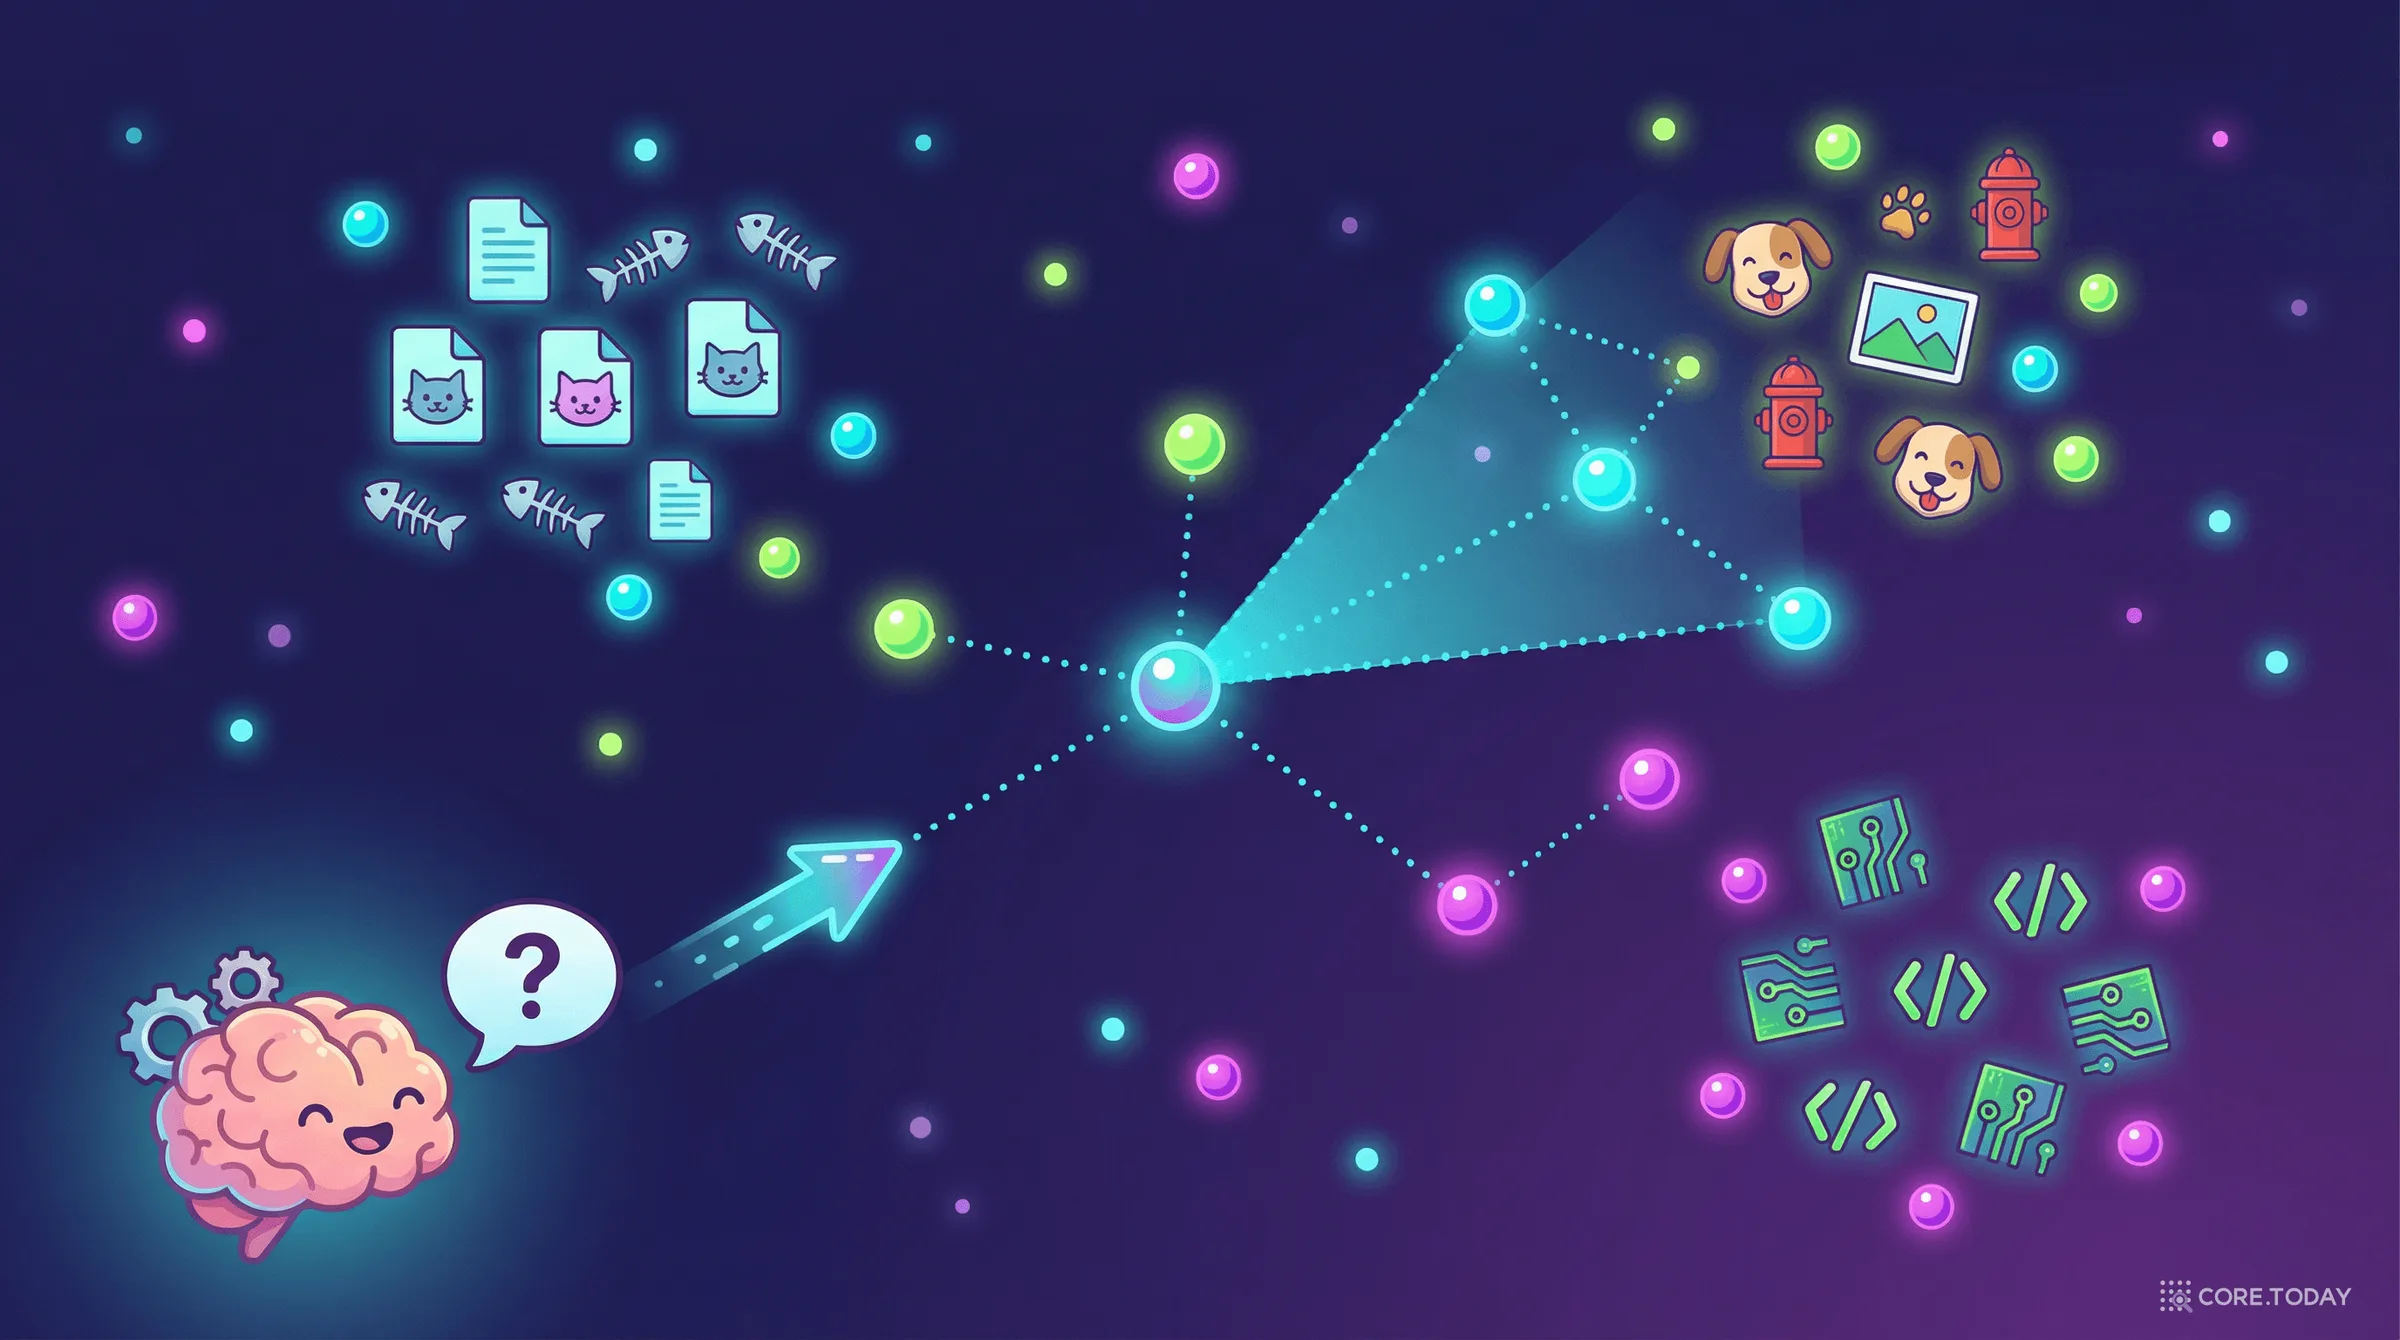
벡터 데이터베이스 완전 정복: AI가 '의미'를 검색하는 시대의 새로운 저장소
'강아지 사진'을 검색하면 'puppy', '댕댕이', '반려견' 사진도 찾아주는 검색. 키워드가 아닌 '의미'로 검색하는 기술의 핵심에 벡터 데이터베이스가 있다. 임베딩이 무엇이고, ANN 알고리즘이 어떻게 작동하며, RAG에서 왜 필수인지를 논문과 실전 사례로 풀어본다.