
#온디바이스 AI
5개의 포스트
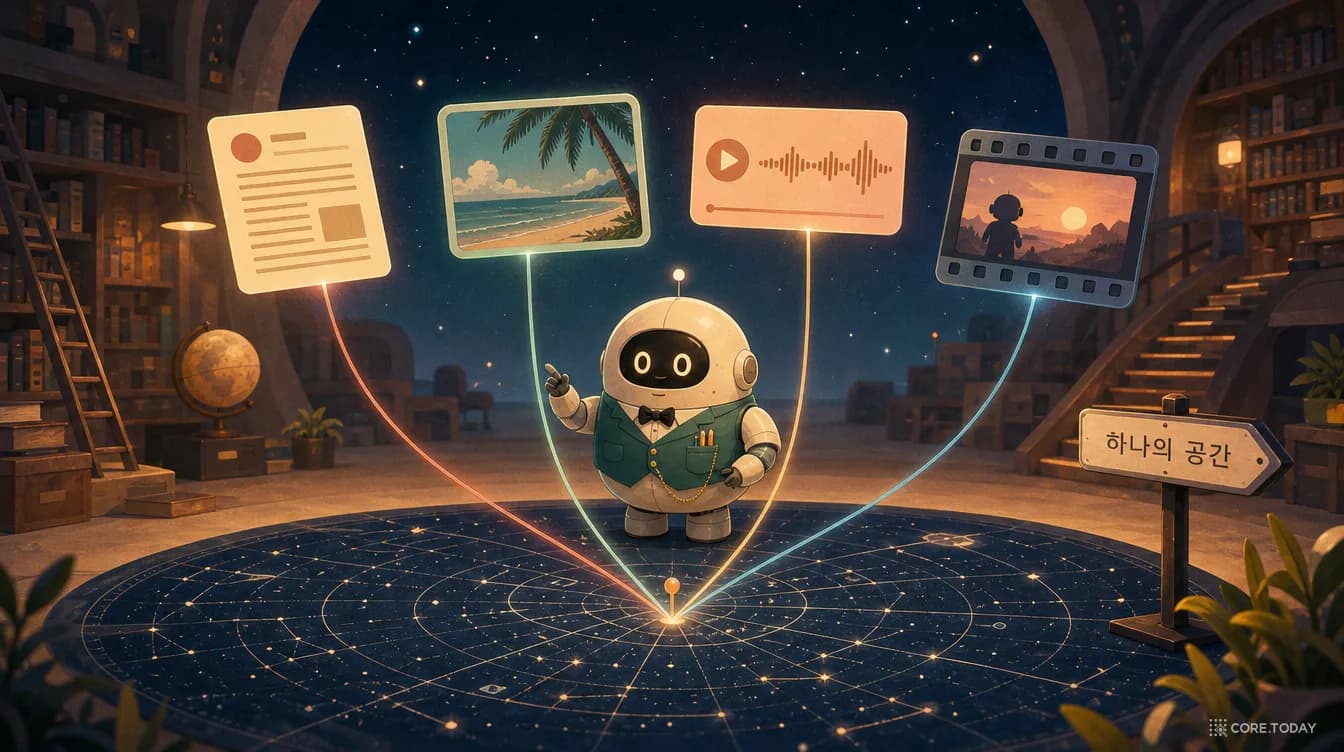
글·사진·소리·영상을 하나의 좌표로 — 내 폰 안에서 도는 740M 임베딩 모델, EmbeddingGemma 2 특집
2026년 10월 6일 구글 딥마인드가 공개한 EmbeddingGemma 2는 텍스트·코드·이미지·비디오·오디오를 하나의 768차원 공간에 놓는 7억 4천만 파라미터짜리 공개 임베딩 모델입니다. 텍스트만 쓰면 191MB, 전부 켜도 567MB로 스마트폰 안에서 돌고, 음성 메모로 영상을 찾고 사진으로 문서를 찾는 일이 서버 없이 가능해집니다. 이 글은 '단어는 친구를 보면 안다'는 1950년대 가설에서 word2vec의 왕−남자+여자=여왕, SBERT의 65시간→5초, CLIP의 N×N 행렬, ImageBind와 Gemini Embedding 2까지 임베딩이 걸어온 길을 되짚고, EmbeddingGemma 2의 모듈 구조·토큰 예산·마트료시카 절단·양자화를 논문 그림과 표로 뜯어봅니다. 구글이 비교하지 않은 경쟁 모델, 해커뉴스의 반론, 한국의 망분리·KURE, 그리고 단일 벡터의 이론적 한계까지 함께 다룹니다. 위젯 5개와 일러스트 9장.
NPU, 2026년 가을의 성적표 — TOPS의 함정부터 국산 NPU 실전 투입까지
3월의 입문 글 이후 반년, NPU를 둘러싼 풍경이 달라졌습니다. 노트북 쪽에서는 TOPS 경쟁이 식고 Copilot+ PC라는 이름이 조용히 물러났습니다. 데이터센터 쪽에서는 엔비디아가 추론 전용 칩(Groq LPU)을 자기 랙 안에 넣었고, 한국에서는 리벨리온과 퓨리오사AI의 칩이 통신사와 포털의 실서비스에서 하루 수억~수십억 토큰을 처리하기 시작했습니다. 이 글은 2026년 10월 3일 기준으로 두 종류의 NPU(주머니 속 NPU와 데이터센터 NPU)를 점검합니다. TOPS가 왜 LLM 속도를 말해 주지 않는지, NPU가 실제로 맡는 일은 무엇인지, 'GPU 대비 몇 배'라는 주장을 어떻게 읽어야 하는지, 전성비의 진짜 쓸모가 전기요금이 아니라 전력 한도라는 점, 그리고 우리 일에 NPU가 맞는지 판단하는 기준까지. 계산기와 점검표 등 위젯 6개가 들어 있습니다.
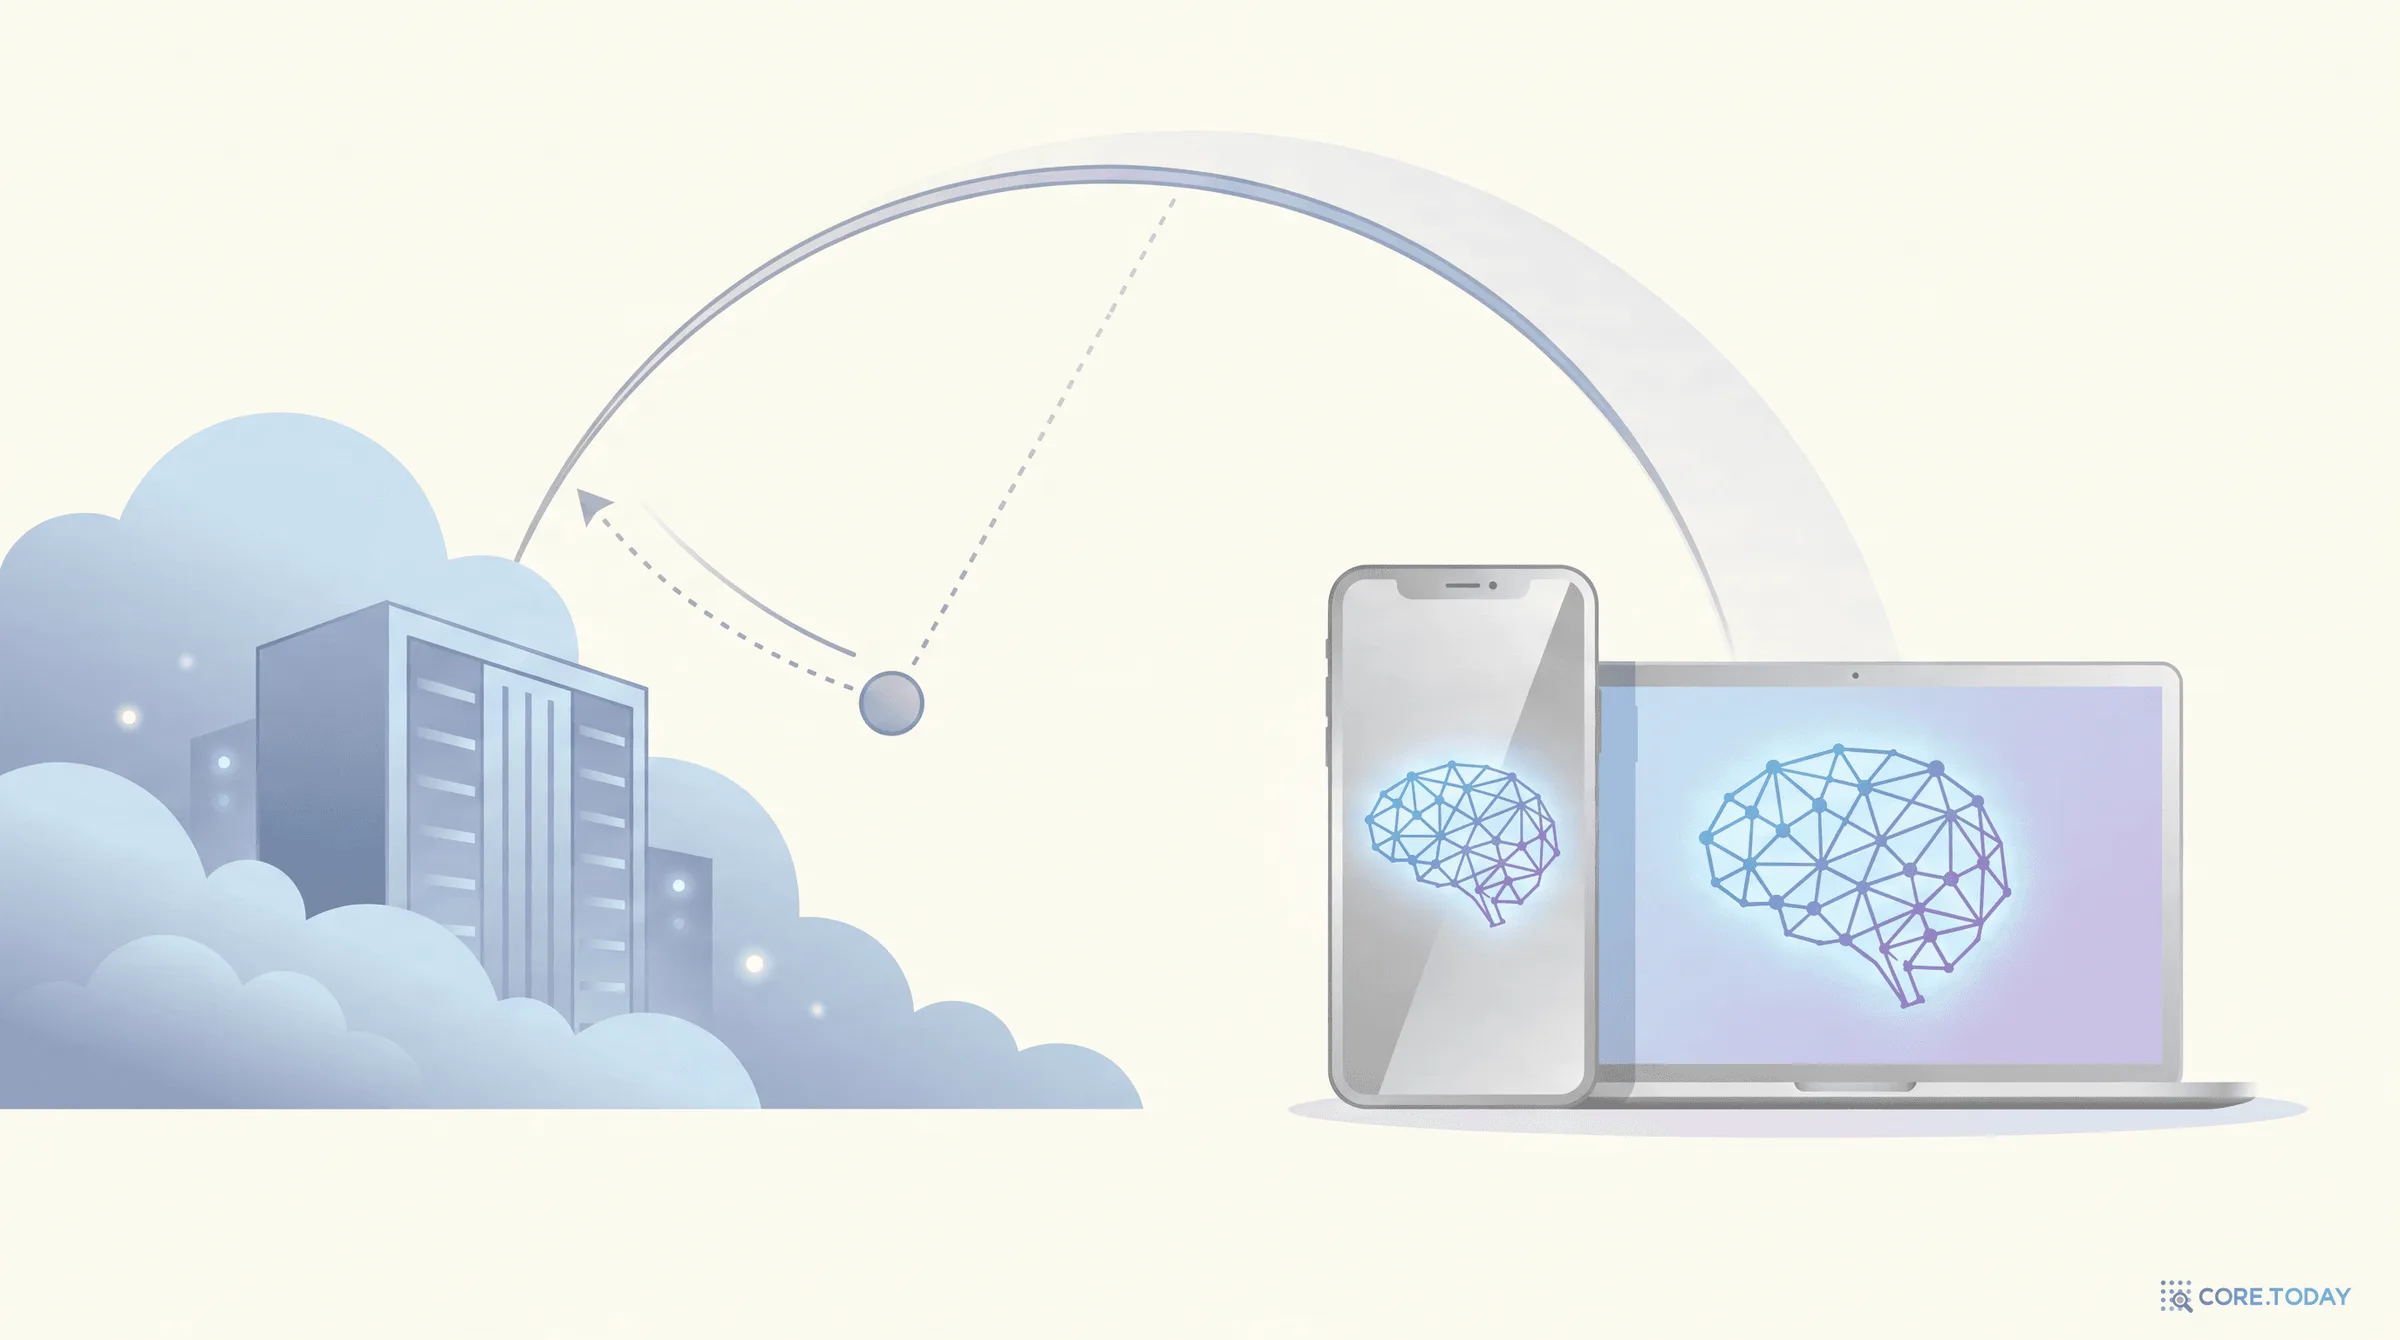
Apple의 역(逆)베팅: 데이터센터 대신 당신의 주머니 — 온디바이스 AI 완전 해부
전 세계 빅테크가 데이터센터에 한 해 $725B를 쏟아붓는 동안, Apple은 정반대로 베팅했다 — 이미 사용자 주머니 속에 있는 수십억 대 기기. 2026년 6월 WWDC를 앞두고 Apple은 15년간 쌓은 자체 실리콘 경험을 무기로 "클라우드 대신 기기에서" AI를 돌리는 온디바이스 전략을 전면에 내세운다. 메인프레임→PC→클라우드→엣지로 도는 컴퓨팅의 진자, A11(0.6 TOPS)에서 M4(38 TOPS)까지 63배 커진 Neural Engine, 통합 메모리로 671B 모델을 Mac에 통째로 올리는 법, Apple Intelligence의 영광과 BBC 헤드라인 참사·Siri 연기·$250M 합의, Private Cloud Compute의 5대 프라이버시 보장, 2026년 Google Gemini 딜과 Nvidia 컨피덴셜 컴퓨트, 증류·양자화·LoRA로 모델을 다이어트시키는 원리, "사용자가 사준 컴퓨팅" $50B 논리, 그리고 개발자·기업을 위한 온디바이스 vs 클라우드 실무 의사결정까지. 인터랙티브 시뮬레이터 3종 포함.
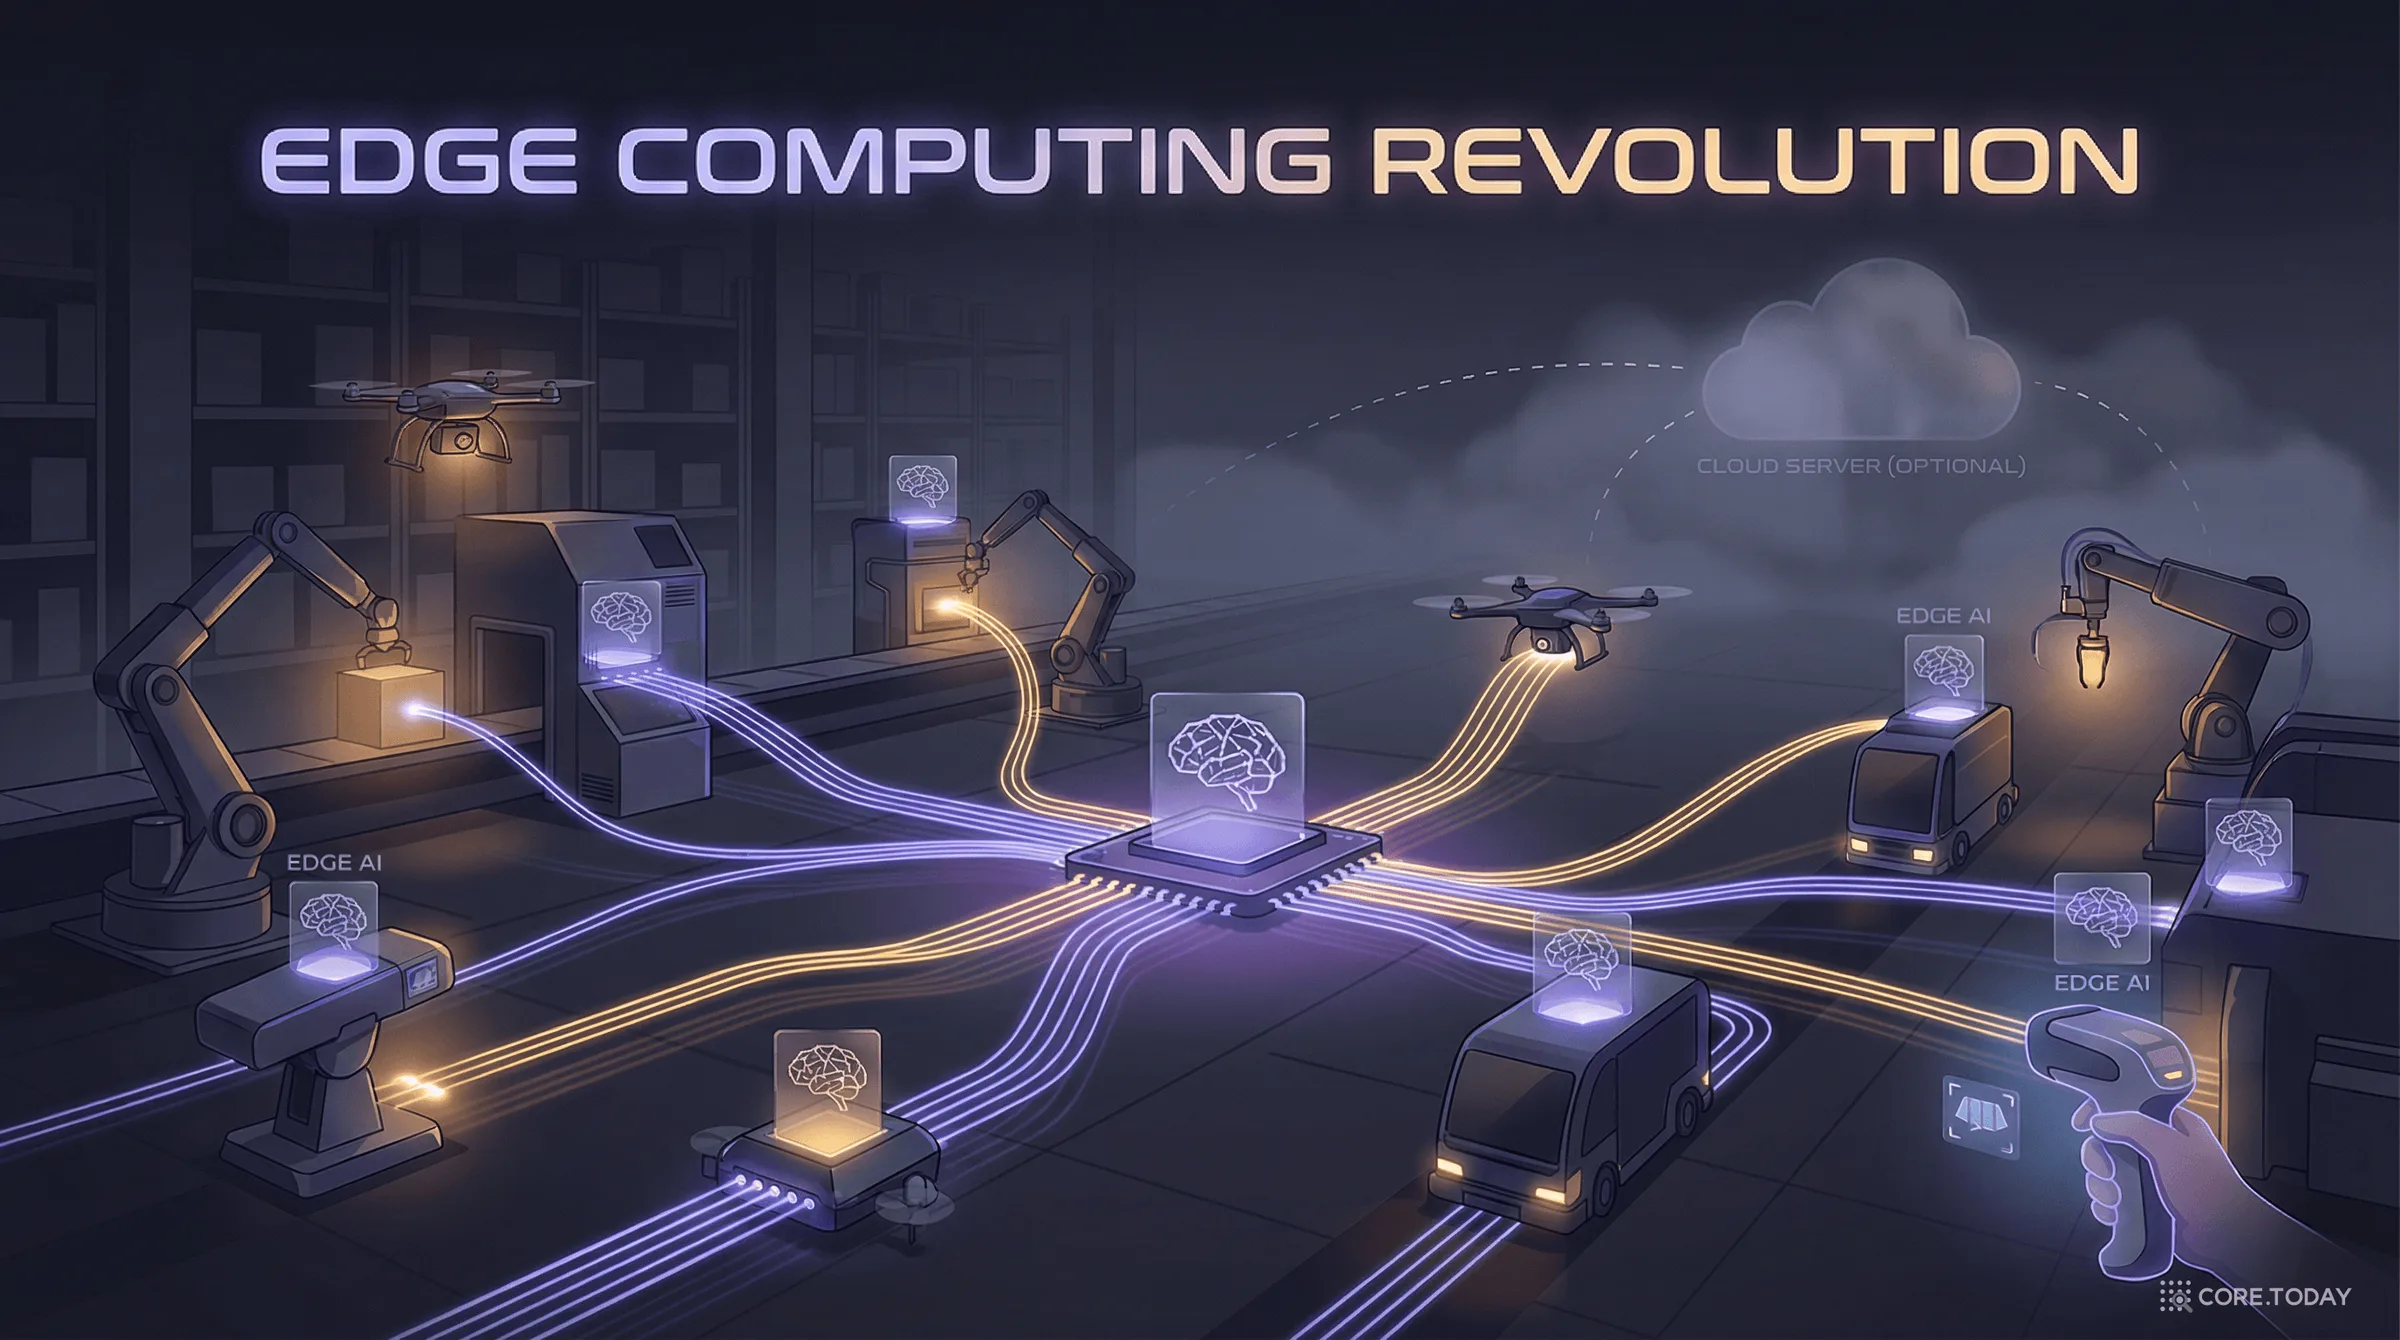
엣지 AI 완전 가이드: 클라우드 없이 현장에서 추론하는 시대가 열렸다
2026년, AI 추론의 55%가 클라우드가 아닌 현장에서 일어난다. 왜 엣지에서 돌려야 하는지(지연 1ms vs 200ms, 프라이버시, 비용 87% 절감), 어떤 하드웨어를 쓰는지(Jetson Thor 2,070 TOPS, Snapdragon 100 TOPS NPU), 그리고 실전에서 어떻게 배포하는지를 총정리한다.
SLM 완전 가이드: 작은 AI가 큰 AI를 이기는 시대 — 비용 100분의 1, 성능 80%
프로덕션 AI의 80%는 노트북에서 돌리는 작은 모델로 충분하다. 비용은 100분의 1, 프라이버시는 완벽. DistilBERT에서 Phi-4 Mini까지 — SLM이 LLM을 대체하는 이유와 방법.