NPUAI 반도체TOPSAI PCCopilot+ PC온디바이스 AI추론 전용 칩리벨리온퓨리오사AIRNGDATOM-MaxRebel100딥엑스하이퍼엑셀모빌린트Groq LPUTPUASIC전성비K-Perf국산 NPU
NPU, 2026년 가을의 성적표 — TOPS의 함정부터 국산 NPU 실전 투입까지
3월의 입문 글 이후 반년, NPU를 둘러싼 풍경이 달라졌습니다. 노트북 쪽에서는 TOPS 경쟁이 식고 Copilot+ PC라는 이름이 조용히 물러났습니다. 데이터센터 쪽에서는 엔비디아가 추론 전용 칩(Groq LPU)을 자기 랙 안에 넣었고, 한국에서는 리벨리온과 퓨리오사AI의 칩이 통신사와 포털의 실서비스에서 하루 수억~수십억 토큰을 처리하기 시작했습니다. 이 글은 2026년 10월 3일 기준으로 두 종류의 NPU(주머니 속 NPU와 데이터센터 NPU)를 점검합니다. TOPS가 왜 LLM 속도를 말해 주지 않는지, NPU가 실제로 맡는 일은 무엇인지, 'GPU 대비 몇 배'라는 주장을 어떻게 읽어야 하는지, 전성비의 진짜 쓸모가 전기요금이 아니라 전력 한도라는 점, 그리고 우리 일에 NPU가 맞는지 판단하는 기준까지. 계산기와 점검표 등 위젯 6개가 들어 있습니다.
지난 3월에 NPU 완전 이해를 썼습니다. CPU도 GPU도 아닌 세 번째 칩이 무엇이고 왜 모든 노트북에 들어가는지를 다룬 입문 글이었습니다. 그로부터 반년, NPU를 둘러싼 풍경이 꽤 달라졌습니다.
노트북과 스마트폰에서는 제조사들이 TOPS 숫자 대신 메모리와 토큰을 말하기 시작했고, 마이크로소프트의 'Copilot+ PC'라는 이름이 9월 신제품에서 조용히 빠졌습니다.
데이터센터에서는 GPU의 최강자 엔비디아가 추론 전용 칩 회사 Groq의 기술을 약 200억 달러에 사들여, 그 칩을 자기 랙 안에 넣었습니다.
한국에서는 "언젠가 GPU를 대체할 유망주"였던 국산 NPU가 통신사와 포털의 실제 서비스에 들어가 하루 수억~수십억 토큰을 처리하고 있습니다.
이 글은 입문을 반복하지 않고, 2026년 10월 3일 시점의 성적표를 씁니다. 제조사 뉴스룸과 제품 문서, 국내외 보도를 직접 확인했고, 제조사의 주장과 실제로 확인된 사실을 구분해 적었습니다. 앞서 올린 GPU 고르는 법의 짝이 되는 글이기도 합니다. GPU 글이 "어떤 GPU를 고를까"였다면 이 글은 "GPU 말고 NPU를 써도 될까"입니다.
✅
바쁜 분을 위한 요약.
① NPU는 둘입니다. 노트북·폰 안의 NPU와, 서버에 꽂는 추론 전용 칩. 이름만 같고 설계도 경쟁 상대도 다릅니다.
② 노트북 NPU의 TOPS 경쟁은 식었습니다. 인텔은 48에서 50으로 사실상 멈췄고 애플은 숫자를 말하지 않습니다. 새 경쟁 축은 메모리입니다.
③ TOPS는 LLM 속도를 말해 주지 않습니다. 글 쓰는 속도는 메모리 대역폭이 정합니다. 퀄컴의 공개 수치에서도 TOPS 1.8배에 속도는 3.8배가 됐고, TOPS를 발표하지 않는 폰 칩이 45 TOPS 노트북 칩보다 빨랐습니다.
④ 지금 NPU가 실제로 맡는 것은 1~4B급 작은 모델과 배경 흐림·자막 같은 상시 기능입니다. 큰 모델은 내장 GPU와 큰 통합 메모리가 돌립니다.
⑤ 데이터센터의 올해 사건은 엔비디아가 추론 전용 칩을 품은 것입니다. 질문이 'GPU냐 NPU냐'에서 '어디까지 GPU, 어디부터 전용 칩'으로 바뀌었습니다.
⑥ 국산 NPU는 실전에 들어갔습니다(SK텔레콤 하루 40억 토큰, 다음 하루 5억 토큰). 다만 모델이 고정된 대량 서비스에 한정되고, 독립 벤치마크는 아직 없습니다.
⑦ NPU의 진짜 장점은 전기요금이 아니라 전력 한도입니다. 전기를 더 끌어올 수 없는 곳이 첫 시장입니다.
NPU 이야기가 헷갈리는 첫 번째 이유는 같은 이름으로 전혀 다른 두 물건을 부르기 때문입니다.
구분
주머니 속 NPU (온디바이스)
데이터센터 NPU (추론 전용 칩)
어디에 있나
스마트폰·노트북의 메인 칩(SoC) 안의 한 구역
서버에 꽂는 독립된 카드, 또는 랙
전력
수 W 이하
카드 한 장에 150~600W
성능을 재는 말
TOPS (초당 1조 번 연산)
초당 토큰, 와트당 토큰
하는 일
배경 흐림, 자막, 사진 분류, 작은 언어 모델
수십~수백 B급 LLM을 많은 사용자에게 서비스
만드는 곳
퀄컴, 인텔, AMD, 애플, 삼성, 미디어텍
리벨리온, 퓨리오사AI, 하이퍼엑셀 (해외는 Groq, Cerebras, 구글 TPU 등)
경쟁 상대
같은 칩 안의 CPU와 내장 GPU
엔비디아 GPU
해외에서 부르는 이름
NPU, Neural Engine
AI accelerator, ASIC, LPU, TPU (NPU라고는 잘 부르지 않음)
"국산 NPU"라고 할 때의 NPU는 대개 오른쪽입니다. 반면 노트북 사양표의 "NPU 50 TOPS"는 왼쪽입니다. 둘은 설계 목표도, 경쟁 상대도, 성적을 매기는 방법도 다릅니다. 공통점은 하나입니다. 범용성을 내주고 AI 추론 한 가지를 전기를 덜 쓰며 한다는 것. 이 글은 두 NPU를 차례로 봅니다.
2. 주머니 속 NPU ①: 2026년 가을의 칩들
먼저 지금 시장에 있는 칩들입니다.
어디에
칩
NPU
눈여겨볼 점
노트북
퀄컴 Snapdragon X2 Elite (기기 2026년 상반기)
80 TOPS
전작 45 TOPS에서 큰 폭 상승. 상위판은 메모리 대역폭 228GB/s
노트북
인텔 Core Ultra 시리즈 3, Panther Lake (1월)
최대 50 TOPS
전작(48 TOPS)과 사실상 같음. 인텔 18A 공정의 첫 제품
노트북
AMD Ryzen AI 400 (1월)
최대 60 TOPS
전작 50 TOPS에서 소폭 상승
맥
애플 M6(8월 발표, 2나노) · M5 Ultra
TOPS 미발표
M6는 뉴럴 엔진을 두 개로. M5 Ultra는 통합 메모리 최대 512GB, 대역폭 1.2TB/s
노트북·데스크톱
엔비디아 RTX Spark (10월 출시 예정)
자료에 NPU 언급 없음
GPU와 통합 메모리(최대 128GB) 중심. "120B 모델"을 내세움
아이폰
애플 A20 Pro (9월, 2나노)
뉴럴 엔진 두 개, "AI 처리 2배"
메모리 대역폭 50% 향상을 함께 발표
안드로이드
퀄컴 Snapdragon 8 Elite Gen 6 (9월 22일, 2나노)
NPU 14~35% 향상
긴 입력 읽기(프리필) 최대 50% 향상을 강조
안드로이드
미디어텍 Dimensity 9600 (9월 15일, 2나노)
프리필 51%, 와트당 토큰 55% 향상
"최대 30B 모델"을 내세움
갤럭시
삼성 Exynos 2600 (2나노)
생성형 AI 성능 113% 향상
갤럭시 S26 일부 지역 모델에 탑재
표에서 세 가지가 보입니다.
첫째, TOPS 경쟁이 식었습니다. 2024년에는 "누가 40 TOPS를 넘느냐"가 뉴스였습니다. 2026년의 인텔은 48에서 50으로 사실상 제자리이고, 애플은 M5, M6, A20 Pro 어느 것에도 TOPS를 발표하지 않았습니다. 숫자를 크게 올린 곳은 퀄컴뿐입니다.
둘째, 광고 문구가 바뀌었습니다. 애플은 "메모리 대역폭 50% 향상"을, 미디어텍은 "와트당 토큰 55% 향상"을, 엔비디아와 AMD는 "120B 모델", "200B 모델"이 올라간다는 것을 내세웁니다. 제조사들이 연산 횟수(TOPS) 대신 메모리와 토큰의 언어로 말하기 시작했습니다. 왜 그런지는 다음 장에서 봅니다.
셋째, 'AI PC'의 간판이 내려가고 있습니다. 마이크로소프트가 2024년에 만든 Copilot+ PC 요건(NPU 40 TOPS 이상, 메모리 16GB 이상)은 그대로지만, 9월 신제품부터 서피스와 주요 제조사들이 그 이름을 쓰지 않습니다. 마이크로소프트 임원은 새 기기를 두고 "Copilot+ PC라고 부르지 않는다. 다만 기존 기준은 모두 충족한다"고 말했습니다. NPU는 '특별한 기능'에서 '당연히 들어 있는 부품'이 됐습니다.
⚠️
2026년 AI PC의 복병은 메모리값입니다. 노트북용 DDR5 메모리 가격은 2025년 7월의 여섯 배가 됐고, IDC는 2026년 PC 출하가 11.3% 줄 것으로 전망했습니다. 9월 IFA에는 800달러 아래에서 메모리 8GB로 되돌아간 노트북들이 나왔는데, 8GB 기기는 NPU가 40 TOPS를 넘어도 16GB 요건에 걸려 온디바이스 AI 기능을 쓰지 못합니다. 지금 AI PC 보급을 막는 것은 NPU가 아니라 메모리입니다.
노트북 사양표에서 NPU 성능은 TOPS로 적힙니다. 1 TOPS는 1초에 1조 번의 연산입니다. 숫자가 클수록 좋아 보이고, 실제로 제조사들은 이 숫자로 경쟁합니다. 그런데 "TOPS가 두 배면 챗봇이 두 배 빨리 답하나요?"라고 물으면 답은 "아니요"입니다.
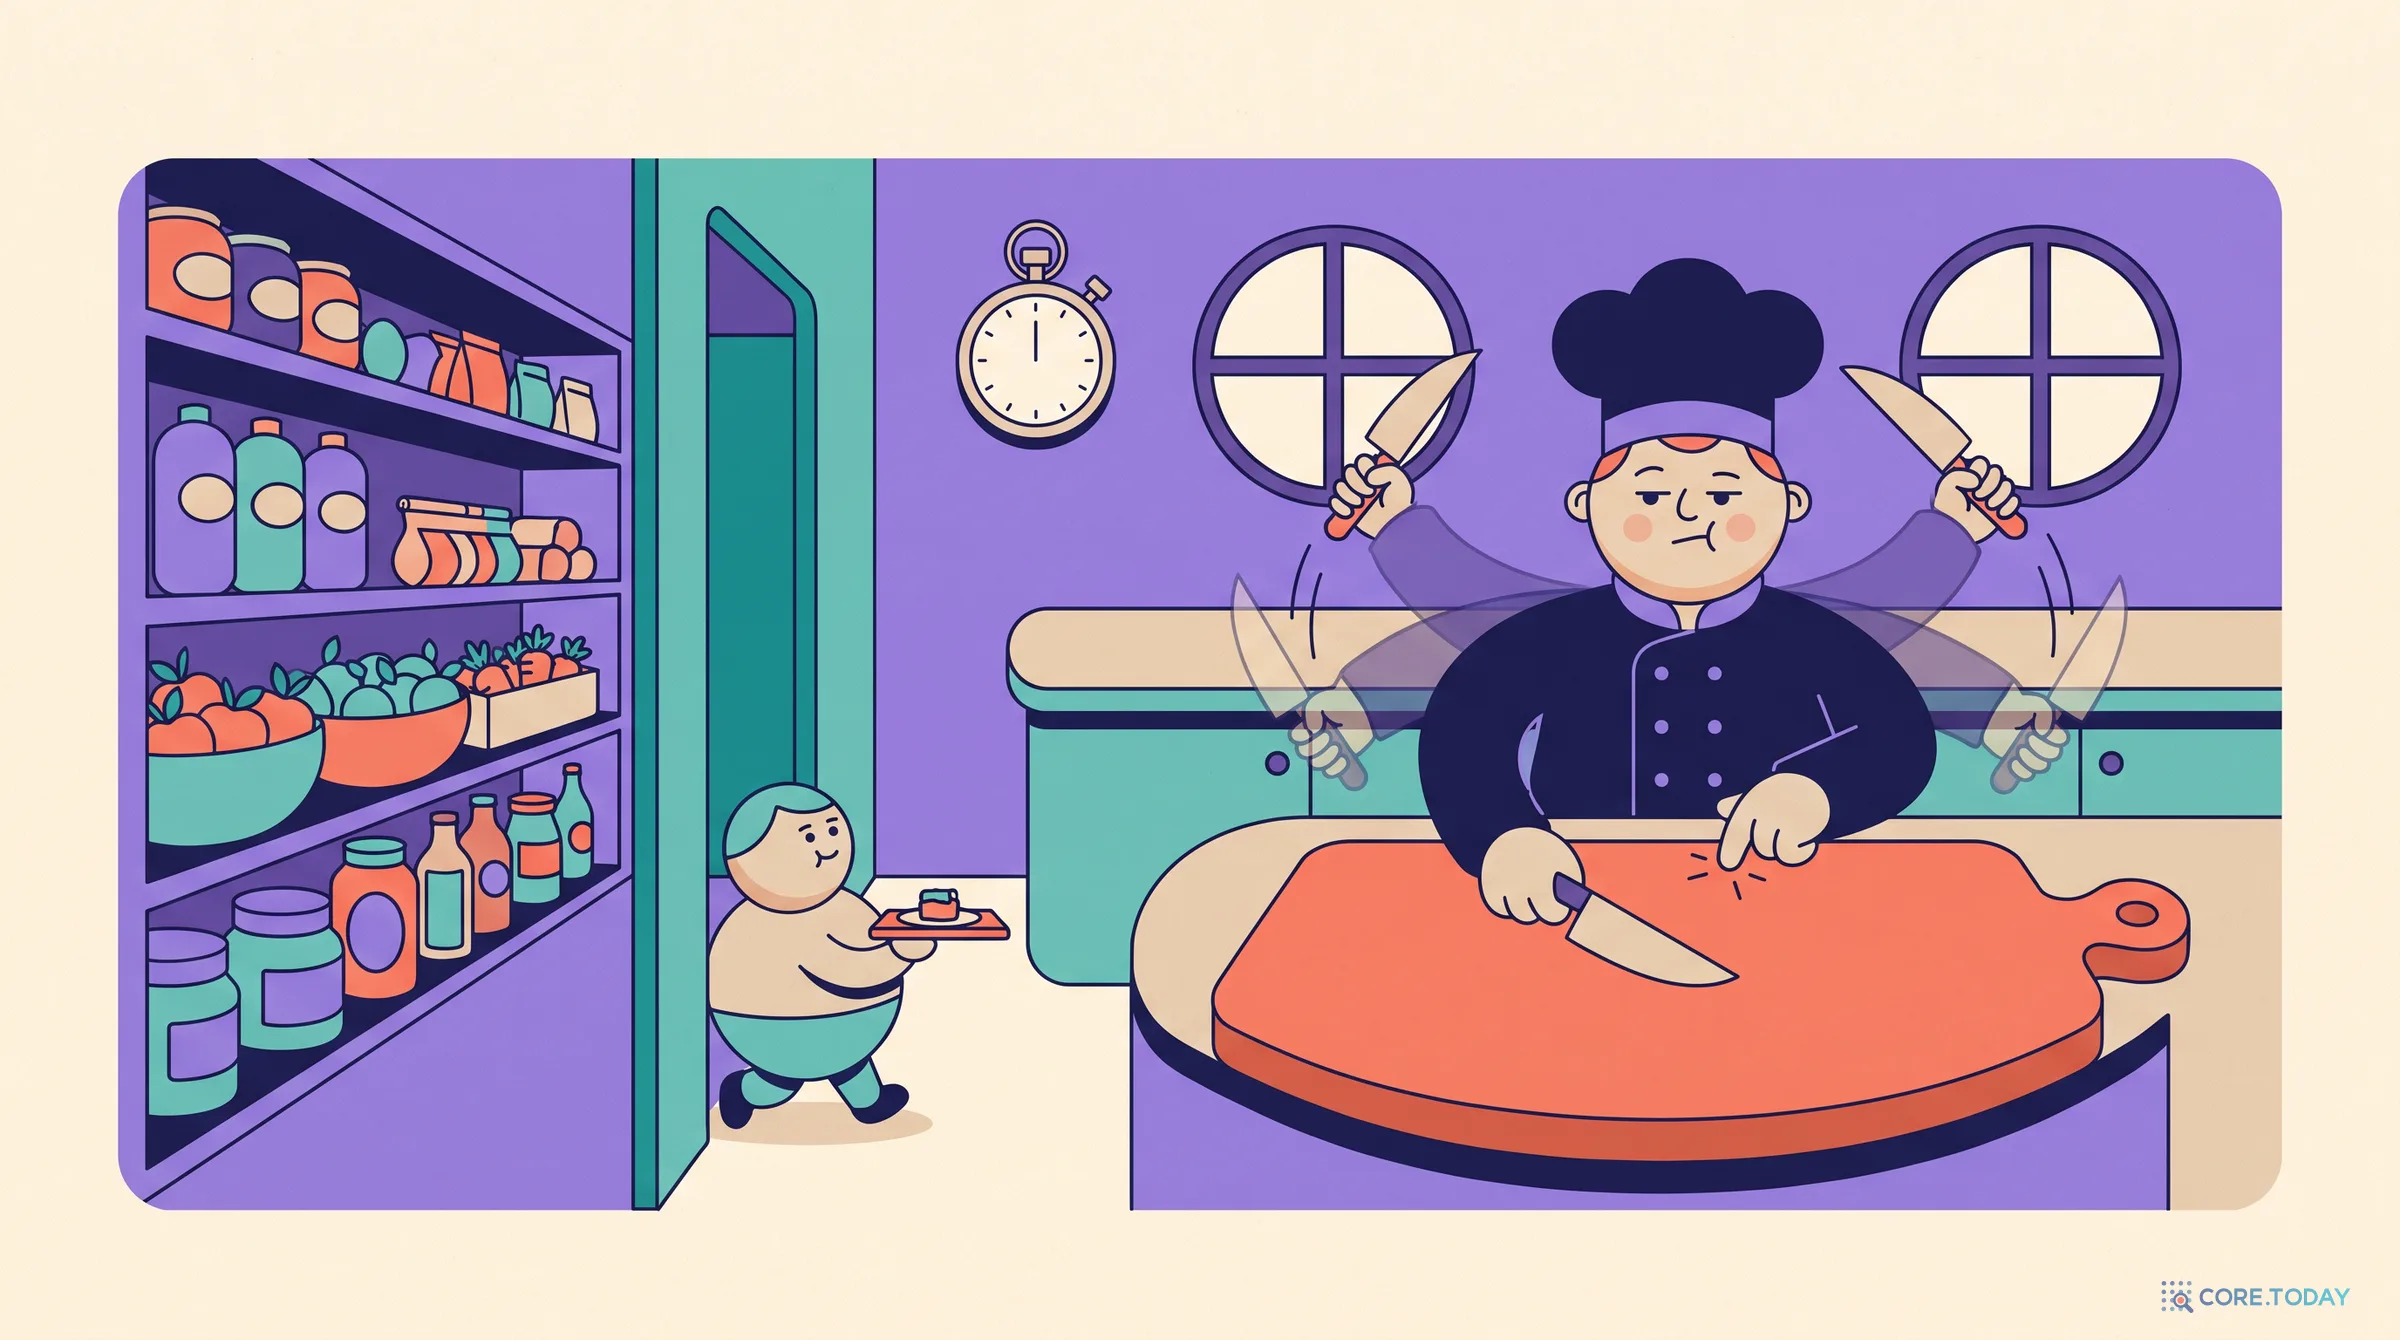
이유는 지난 GPU 글에서 본 것과 같습니다. LLM은 글자(토큰) 하나를 쓸 때마다 모델 전체를 메모리에서 읽어 와야 합니다. 요리사의 손이 아무리 빨라도 창고에서 재료가 오는 복도가 좁으면 요리는 복도의 속도로 나옵니다. 숫자로 보면 차이가 극명합니다.
8B(80억 파라미터) 모델을 45 TOPS NPU에서 돌린다고 합시다. 토큰 하나에 드는 연산은 파라미터 수의 약 두 배, 곧 160억 번입니다. 45 TOPS면 이론상 초당 2,800토큰을 계산할 수 있습니다. 한편 이 모델을 4비트로 줄이면 약 4.5GB이고, 일반 노트북의 메모리 대역폭은 초당 135GB쯤이니 1초에 모델을 30번 읽을 수 있습니다. 연산은 초당 2,800토큰을 허락하는데 메모리는 30토큰만 허락합니다. 거의 100배 차이입니다.
이것이 계산 속의 이야기만은 아니라는 증거가 제조사의 공개 자료에 있습니다. 퀄컴이 같은 모델(Llama 3.2 3B, 4비트)을 자사 칩의 NPU에서 돌려 공개한 속도입니다.
칩
NPU 성능
초당 토큰
Snapdragon X Elite (노트북, 2024)
45 TOPS
11.3
Snapdragon 8 Elite (스마트폰, 2024)
TOPS 미발표
28.0
Snapdragon 8 Elite Gen 5 (스마트폰, 2025)
TOPS 미발표
30.1
Snapdragon X2 Elite (노트북, 2026)
80 TOPS
42.5
노트북 칩의 TOPS는 1.8배가 됐는데 속도는 3.8배가 됐습니다. 그리고 TOPS를 내세우지도 않는 스마트폰 칩이 45 TOPS 노트북 칩보다 두 배 넘게 빠릅니다. TOPS가 LLM 속도를 예측하지 못한다는 것을 같은 회사의 표가 보여 줍니다. 애플의 연구 글은 이를 한 문장으로 정리합니다. 첫 토큰이 나오기까지는 연산이, 그 뒤의 토큰 생성은 메모리 대역폭이 속도를 정한다는 것입니다. M5의 생성 속도 향상(19~27%)이 메모리 대역폭 향상(28%)과 거의 같다는 측정도 함께 실었습니다.
그래서 큰 언어 모델을 내 컴퓨터에서 돌리려는 사람들이 보는 숫자는 TOPS가 아니라 메모리 용량과 메모리 대역폭입니다. 메모리 통로를 넓힌 기기들, 곧 애플의 맥(M4 Max 기준 초당 546GB), AMD Ryzen AI Max(초당 256GB), 엔비디아 DGX Spark(초당 273GB)가 로컬 LLM용으로 인기를 얻은 이유입니다. 이 기기들에서 LLM을 돌리는 것은 대개 NPU가 아니라 내장 GPU입니다.
💡
TOPS가 뜻있는 곳은 따로 있습니다. 모델이 작고 계산이 많은 일입니다. 화상회의 배경 흐림, 소음 제거, 실시간 자막, 사진 속 물체 찾기 같은 일은 모델이 수십~수백 MB라 메모리가 발목을 잡지 않고, TOPS가 높을수록 더 많은 일을 동시에 합니다. LLM에서는 긴 입력을 한꺼번에 읽는 단계에 TOPS가 듣습니다. NPU 사양을 볼 때는 "이 TOPS로 무엇을 돌릴 것인가"를 먼저 물어야 합니다.
큰 언어 모델을 NPU가 돌리지 않는다면, NPU는 무슨 일을 할까요. 마이크로소프트의 사양 문서에 올라 있는 NPU가 있어야 켜지는 Windows 기능은 이렇습니다. 화상회의 배경 흐림과 시선 보정(Studio Effects), 실시간 자막 번역, 화면 기록을 검색하는 Recall, 화면 속 글과 그림에 바로 작업을 거는 Click to Do, 자연어 파일 검색, 사진 선명하게 하기, 그림판의 이미지 생성, 게임 화면 자동 업스케일링.
공통점이 있습니다. 모델이 작고, 늘 켜져 있고, 배터리를 아껴야 하는 일입니다. NPU는 노트북 안의 야간 근무자입니다. 큰 짐은 들지 못하지만, 가벼운 일을 전기를 거의 쓰지 않으며 하루 종일 합니다.
언어 모델을 NPU에서 돌리는 길도 있긴 합니다. 다만 제조사가 직접 준비한 경로에서, 작은 모델로, 제한된 길이로입니다.
경로
2026년 10월의 상태
퀄컴 (AI Hub)
Llama 3.2 3B를 4비트로, 문맥 4,096토큰. X2 Elite에서 초당 42.5토큰
AMD (Ryzen AI 소프트웨어, FastFlowLM)
NPU 단독과 NPU+내장 GPU 혼합 모드. Gemma 3 4B가 NPU에서 초당 18토큰 안팎
인텔 (OpenVINO)
4비트 양자화 필수. 기본 설정에서 입력 1,024토큰까지
Windows 내장 모델
Phi Silica(문맥 4천 토큰급)가 NPU에서 동작. 2027년 1월 새 모델로 교체 예정
Ollama · LM Studio
문서에 NPU 지원 항목 없음. CPU와 GPU로 실행
맥의 MLX
CPU와 GPU에서 실행. 뉴럴 엔진을 쓰지 않음
정리하면 NPU 경로는 1~4B급 모델, 4천 토큰 안팎의 문맥이 기본입니다. 개발자와 애호가들이 로컬 LLM에 쓰는 대표 도구인 Ollama와 LM Studio는 NPU를 쓰지 않습니다. "120B 모델", "수천억 파라미터"를 내세우는 제품(RTX Spark, Ryzen AI Halo, M5 Ultra 맥 스튜디오)은 모두 GPU와 큰 통합 메모리로 그 일을 합니다.
그렇다고 주머니 속 NPU가 실패했다는 뜻은 아닙니다. 맡은 일이 다를 뿐입니다. 가트너는 7월에 기업용 온디바이스 AI 도구가 더디게 나오고 있다고 평가하면서도, 2029년에는 기업의 30%가 클라우드 토큰 비용을 줄이려고 AI PC를 쓸 것으로 내다봤습니다. 요약, 분류, 다시 쓰기 같은 가벼운 일을 기기에서 처리하고 무거운 일만 클라우드로 보내는 구도입니다. AI PC의 쓸모가 '새로운 기능'에서 '비용 절감'으로 옮겨 가고 있습니다.
이제 큰 쪽입니다. 데이터센터 NPU는 GPU가 하던 일 가운데 추론만 떼어 전용으로 만든 칩입니다.
GPU는 트레이닝복입니다. 어떤 체형에도 맞고 무슨 운동이든 할 수 있습니다. 학습도 추론도, 언어 모델도 영상 모델도, 내일 나올 새 구조의 모델도 돌립니다. NPU는 맞춤 정장입니다. 정해진 일에는 군더더기가 없어 전기를 덜 먹고 값도 쌀 수 있습니다. 그러나 체형이 바뀌면, 곧 모델의 구조가 바뀌면 다시 재단해야 합니다. 이 비유 하나가 데이터센터 NPU의 기회와 위험을 다 담고 있습니다.
세계 지형: 세 갈래
해외에서는 이 칩들을 NPU라고 부르지 않지만 하는 일은 같습니다. 2026년 가을의 지형은 세 갈래입니다.
갈래
대표
2026년의 상태
① 클라우드 회사의 자체 칩
구글 TPU, AWS Trainium, 마이크로소프트 Maia, 메타 MTIA, OpenAI·브로드컴 '할라페뇨'
구글은 4월에 TPU를 학습용(8t)과 추론용(8i)으로 처음 나눴고, 일부 고객에게 칩 자체를 팔기 시작했습니다. AWS Trainium3은 연초부터 출하돼 거의 다 팔렸습니다. 마이크로소프트 Maia 200(1월)은 추론 전용입니다. OpenAI의 첫 칩은 6월에 공개됐고 연말 소량 생산이 목표입니다.
② 속도 전문 칩
Cerebras, Groq, SambaNova, d-Matrix, Positron
메모리를 칩 안(SRAM)에 넣어 통로를 극단적으로 넓힌 설계입니다. Cerebras는 5월 나스닥에 상장했고, gpt-oss-120B를 초당 3,000토큰으로 서비스한다고 밝혔습니다. GPU 기반 서비스보다 훨씬 빠르지만 칩에 담을 수 있는 모델 크기에 한계가 있습니다.
③ GPU 진영의 흡수
엔비디아 Groq 3 LPU, AMD·Cerebras 제휴
아래에서 따로 다룹니다. 올해 가장 큰 사건입니다.
숫자로 보면 흐름이 분명합니다. 트렌드포스는 2026년 AI 서버 출하의 27.8%가 자체 칩(ASIC) 기반이고 GPU 기반이 69.7%이며, 2030년에는 ASIC이 약 40%까지 오를 것으로 봤습니다. 구글은 올해 증설의 약 78%를 자사 TPU로 채웁니다. 가트너는 2026년을 AI 인프라 임대 지출에서 추론(233억 달러)이 학습(190억 달러)을 처음 앞지르는 해로 집계했습니다. 학습은 한 번이지만 추론은 서비스가 살아 있는 내내 계속되기 때문에, 돈이 흐르는 방향이 추론 전용 칩 쪽으로 기울고 있습니다.
2025년 12월 24일, 엔비디아는 추론 전용 칩 회사 Groq의 기술을 약 200억 달러에 라이선스하고 창업자를 비롯한 핵심 인력을 데려왔습니다. 회사를 인수한 것은 아닙니다. Groq는 지금도 추론 클라우드 회사로 남아 있습니다. 그리고 석 달 뒤, 그 기술이 엔비디아 제품으로 나왔습니다. Groq 3 LPU 256개를 담은 LPX 랙입니다.
구조가 핵심입니다. 엔비디아는 LPU로 GPU를 대체하지 않았습니다. 일을 나눴습니다.
입력 읽기 (프리필) 긴 문맥을 한꺼번에 읽는 단계. 계산이 많고 메모리가 커야 합니다. → Rubin GPU
→
글 쓰기 (디코드) 토큰을 하나씩 뽑는 단계. 메모리 통로의 속도가 전부입니다. → Groq 3 LPU
3장에서 본 그 구분입니다. 읽기는 계산이, 쓰기는 메모리 통로가 정합니다. 그래서 읽기는 덩치 큰 GPU가, 쓰기는 통로가 극단적으로 넓은 전용 칩이 맡는 이어달리기를 짠 것입니다. 엔비디아는 이 조합이 Gemma 4 31B를 초당 3,400토큰으로 쓴다고 발표했습니다. 젠슨 황은 이런 전용 칩이 가치를 더하는 범위를 "작업의 약 25%"라고 말했습니다.
같은 구도가 다른 곳에서도 반복됩니다. AMD는 7월에 Cerebras와 손잡고 자사 GPU 랙이 읽기를, Cerebras 칩이 쓰기를 맡는 구성을 내놨습니다. 추론 칩 스타트업 d-Matrix의 다음 제품은 엔비디아 랙에 꽂히는 형태로 나옵니다.
💡
질문이 바뀌었습니다. 지난 몇 년의 질문은 "GPU냐 NPU냐"였습니다. 2026년의 질문은 "어디까지 GPU에 맡기고 어디부터 전용 칩에 맡길까"입니다. 범용 칩의 최강자가 전용 칩을 자기 랙 안에 넣었다는 것은, 추론 전용 칩의 쓸모를 시장이 인정했다는 뜻이자 전용 칩 혼자서는 전부를 할 수 없다는 뜻이기도 합니다.
화려한 숫자에는 단서가 붙습니다. 더레지스터의 분석에 따르면 초당 3,400토큰은 한 번에 한 사용자를 처리할 때의 수치이고, LPU 약 64개가 그 한 명에게 붙습니다. 긴 문맥에서는 랙 하나가 동시에 받을 수 있는 요청이 열두 개 안팎입니다. 극단적인 속도는 극단적인 값을 치르고 얻는 것입니다. 그 값을 낼 만한 일(실시간 음성, 코딩 에이전트, 긴 추론)에 쓰는 프리미엄 상품에 가깝습니다.
맞춤 정장의 위험도 올해 드러났습니다
전용 칩의 실패 사례도 같은 해에 나왔습니다. 엔비디아는 긴 문맥 처리 전용으로 예고했던 Rubin CPX를 발표 반년 만에 접었습니다. 메타는 자체 칩 가운데 하나를 취소했고, 인텔은 Gaudi가 최전선 학습 시장의 요구를 맞추지 못했다고 인정했습니다. 엔비디아 같은 회사도 전용 칩의 방향을 반년 만에 바꿉니다. 전용 칩은 만드는 데 2~3년이 걸리는데 모델의 유행은 반년마다 바뀐다는 근본적인 긴장 위에 서 있습니다.
그리고 독립된 비교가 없습니다. 9월 16일 공개된 업계 표준 벤치마크 MLPerf Inference v6.1에는 30개 기관이 참가했지만, 발표문에 이름이 오른 가속기는 엔비디아, AMD, 인텔 제품뿐입니다. 구글 TPU도, AWS Trainium도, Cerebras도, Groq도 보이지 않습니다. 전용 칩의 성능은 지금 대부분 만든 회사의 발표로만 알 수 있습니다. 이 점은 국산 NPU를 볼 때도 그대로 적용됩니다.
3월 글에서 한국의 NPU 회사들은 "유망주"였습니다. 반년이 지난 지금 가장 큰 변화는 실제 서비스에서 돌아가는 사례가 생겼다는 것입니다.
어디서
어떤 칩으로
무엇을, 얼마나
SK텔레콤
리벨리온 ATOM-Max
에이닷 통화 요약, 음성 합성, AI 고객센터, 스캠 탐지 네 가지 서비스. 하루 약 1,400만 건, 40억 토큰 이상. 서버 수십 대 규모이고 GPU와 섞어 운영
다음(Daum)
퓨리오사AI RNGD
업스테이지 Solar로 만드는 AI 요약. 하루 약 5억 토큰
삼성SDS 클라우드
퓨리오사AI RNGD
NPU를 시간 단위로 빌려 쓰는 상품(카드 1·2·4·8장 구성)
KT클라우드 · 가비아
리벨리온 ATOM 계열
NPU 임대 상품. KT클라우드는 공공 클라우드 보안 인증(CSAP)을 받은 첫 NPU 상품, 카드 약 300장
경남도청 · 울산
리벨리온 ATOM-Max
공공 CCTV 영상을 30B급 시각 언어 모델로 분석
한국도로공사
모빌린트 MLA400
고속도로 CCTV 약 4,000대 분석
BNK금융
퓨리오사AI RNGD
금융권 첫 구매. 카드 8장 서버 한 대로 시작
스톡홀름 데이터센터 (I/ONX · Velox)
퓨리오사AI RNGD
15MW 규모. 1단계 1,800장(2027년 초), 전체 8,800장 이상 계획
눈여겨볼 점이 셋 있습니다.
첫째, 돌아가는 일의 종류입니다. 통화 요약, 음성 합성, 검색 요약, CCTV 분석. 모두 모델이 정해져 있고, 하루 종일 같은 일이 대량으로 들어오는 서비스입니다. 맞춤 정장이 맞는 체형입니다. 반대로 매주 새 모델을 실험하는 연구 조직에서 NPU를 쓴다는 사례는 보이지 않습니다.
둘째, 지금 돌고 있는 것은 한 세대 전 칩입니다. SK텔레콤과 KT클라우드에서 도는 리벨리온 칩은 ATOM 계열이고, HBM을 얹은 차세대 Rebel100은 양산을 준비하는 단계입니다. 퓨리오사AI의 RNGD는 1월부터 양산에 들어가 첫 물량 약 4,000장이 나왔고, 올해 목표는 2만 장입니다.
셋째, GPU를 대체한 것이 아니라 섞어 씁니다. SK텔레콤은 같은 서비스 안에서 GPU와 NPU를 함께 돌립니다. 현실의 도입은 "전부 바꾸기"가 아니라 "정해진 일부를 옮기기"입니다.
제품: 누가 무엇을 만드나
회사
지금 팔리는 것
제원
다음 것
리벨리온
ATOM-Max (서버용)
GDDR6 64GB, 350W, 서버당 최대 8장
Rebel100: 삼성 4나노, 칩 네 개를 이어 붙인 구조, 삼성 HBM3E 144GB, 최대 600W. 2026년 하반기 양산 목표
RNGD+(HBM3E 72GB) 하반기 계획. 3세대는 브로드컴과 TSMC 2나노로 2028년 목표
하이퍼엑셀
Bertha 500 (양산 개시 보도와 샘플 단계 보도가 엇갈림)
삼성 4나노, LPDDR5X 128GB(HBM 없음), 대역폭 546GB/s, 250W
엣지용 Bertha-Edge 연말 샘플
딥엑스
DX-M1 (2025년 8월 양산)
삼성 5나노. 로봇·카메라 등 현장 기기용
DX-M2: 삼성 2나노, 5W 이하, 2027년 양산 목표
모빌린트
ARIES 카드(MLA100·MLA400), REGULUS
최대 80 TOPS급. 영상 분석·로봇용
세미파이브와 로봇용 칩 개발
표에서 메모리 칸을 보세요. 지난 GPU 글에서 "GPU 세대 교체는 절반쯤 메모리 세대 교체"라고 했는데, NPU도 같은 길을 갑니다. 리벨리온은 GDDR6에서 HBM3E로, 퓨리오사AI는 HBM3에서 HBM3E로 올라갑니다. 큰 언어 모델을 빠르게 돌리려면 결국 굵은 메모리 통로가 필요하기 때문입니다. 하이퍼엑셀은 반대로 HBM을 쓰지 않고 값싼 LPDDR 메모리를 많이 얹는 길을 택했습니다. 3세대 칩 하나에 HBM을 12개 쌓겠다는 퓨리오사AI의 계획을 두고 "스타트업이 그 물량의 HBM을 어떻게 확보하느냐"는 물음이 나오는 것도 같은 맥락입니다. NPU의 경쟁력도 메모리 조달에 묶여 있습니다.
주장을 읽는 법
NPU 발표에는 "GPU 대비 몇 배"가 빠지지 않습니다. 이 숫자들은 읽는 법이 따로 있습니다.
위젯의 다섯 주장을 훑어보면 패턴이 보입니다. 배수가 클수록 비교 대상이 오래됐거나 조건이 덜 적혀 있고, 조건이 자세할수록 배수는 수수합니다. 퓨리오사AI와 래블업이 함께 낸 백서의 "와트당 1.3~1.5배"는 화려하지 않지만, 비교 대상(현행 GPU)과 모델, 동시 요청 수가 모두 적혀 있어 그대로 도입 검토에 쓸 수 있는 숫자입니다.
돈과 정책: 뜨거운 지원, 조심스러운 수요
투자는 뜨겁습니다. 리벨리온은 3월에 약 6,400억 원 규모의 상장 전 투자를 마쳤고 기업가치는 약 3조 4천억 원으로 평가받았습니다. 퓨리오사AI와 딥엑스도 3조 원 안팎의 가치로 자금을 모으고 있습니다. 정부는 3월에 5년간 50조 원 규모의 'K-엔비디아 프로젝트'를 내놨고, 2027년 예산안에는 국산 AI 반도체 실증에 1,350억 원이 들어 있습니다. 국산 반도체를 안보 시설에 우선 구매할 수 있게 하는 법 개정안도 발의됐습니다.
그런데 매출은 아직 작습니다. 2025년 매출은 리벨리온 320억 원, 퓨리오사AI 57억 원, 딥엑스 33억 원입니다. 기업가치와 매출 사이의 간격이 지금 한국 NPU 산업의 위치를 말해 줍니다. 기대는 조 단위, 실적은 백억 단위입니다.
수요 쪽의 신호는 엇갈립니다.
전진
후퇴 또는 유보
통신사·포털·금융의 실서비스 투입
국가AI컴퓨팅센터는 입찰이 두 번 유찰된 뒤 국산 NPU 의무 비율을 뺐다고 보도됨. NPU 연구 구역은 유지
삼성SDS·KT클라우드·가비아의 NPU 임대 상품
리벨리온 차세대 칩은 가격이 정해지지 않아 주문 물량이 미정이라는 보도
스톡홀름 데이터센터 등 해외 수주
퓨리오사AI에 대한 국민성장펀드 투자는 5월에 승인됐지만 민간 매칭이 채워지지 않아 9월 말까지 집행 전
광주 NPU 전용 컴퓨팅센터 구상(NPU 8,400장)
예비타당성 조사 중. "수요가 아니라 예산에 맞춘 제품이 나올 수 있다"는 업계 우려
고객이 망설이는 이유로 보도에 반복해 나오는 것은 성능이 아니라 소프트웨어입니다. GPU에서 돌던 모델을 NPU로 옮기려면 제조사의 도구로 컴파일하는 단계를 거쳐야 하고, 새 모델이 나올 때마다 제조사가 지원을 붙여야 합니다. SK텔레콤도 상용 투입 과정에서 "시험에서는 보이지 않던 변수"를 만났다고 밝혔습니다. 좋은 소식은 이 간격이 줄고 있다는 것입니다. 리벨리온의 개발 도구는 vLLM과 허깅페이스를 지원하고, 퓨리오사AI는 OpenAI 호환 API를 제공하며 gpt-oss-120B, Solar, EXAONE 계열을 지원 목록에 올렸습니다. 6월에 리벨리온이 모델 경량화 회사 스퀴즈비츠를 인수한 것도 소프트웨어를 메우려는 움직임입니다.
NPU의 장점을 한 단어로 줄이면 전성비, 곧 전기 대비 성능입니다. 그런데 "전기를 덜 먹어서 전기요금이 싸다"는 설명은 절반만 맞습니다.
계산해 보면 서버 3년 총비용에서 전기료가 차지하는 몫은 10% 안팎입니다. 나머지는 장비값입니다. 전기료를 절반으로 줄여도 총비용은 5%쯤 줄 뿐입니다. NPU가 진짜로 힘을 쓰는 곳은 요금이 아니라 한도입니다. 건물에 들어오는 전기, 랙 하나에 허용된 전력은 정해져 있고 쉽게 늘릴 수 없습니다.
지난 GPU 글에서 8장짜리 연산용 GPU 서버 한 대가 10kW를 넘어 일반 전산실 랙에 들어가지 않는다고 썼습니다. 같은 자리에 퓨리오사AI의 8장 서버는 약 3kW로 공랭 랙에 그대로 들어갑니다. 수랭 설비도, 전력 증설 공사도 필요 없습니다. 기존 전산실을 가진 공공기관과 금융사, 통신사 국사, 공장과 도로변 같은 현장에서 NPU가 먼저 자리를 잡는 이유입니다. NPU의 첫 시장은 '전기를 아끼고 싶은 곳'이 아니라 '전기를 더 끌어올 수 없는 곳'입니다.
8. 그래서, 우리는 NPU를 써야 할까
두 NPU에 대한 답은 다릅니다.
주머니 속 NPU는 고를 일이 거의 없습니다. 새 노트북과 스마트폰에는 이미 들어 있습니다. 판단할 것은 NPU의 TOPS가 아니라, 큰 언어 모델을 기기에서 돌릴 생각이라면 메모리 용량과 대역폭, 그렇지 않다면 배터리와 가격입니다.
데이터센터 NPU는 조건이 맞을 때의 선택지입니다. 아래 점검표로 확인해 보세요.
흔한 오해
실제
TOPS가 높으면 로컬 챗봇이 빠르다
글 쓰는 속도는 메모리 대역폭이 정합니다. TOPS는 작은 모델과 긴 입력 읽기에 듣습니다.
AI PC를 사면 큰 LLM이 NPU에서 돈다
NPU가 맡는 것은 주로 작은 모델과 상시 기능입니다. 큰 모델은 내장 GPU와 큰 메모리가 돌립니다.
NPU는 GPU의 저가 대체품이다
정해진 추론 일에 맞춘 전용 장비입니다. 학습은 못 하고, 모델이 바뀌면 지원을 기다려야 합니다.
전기를 덜 먹으니 무조건 싸다
총비용의 대부분은 장비값입니다. 장점은 요금보다 전력 한도와 설치 조건에서 납니다.
'GPU 대비 몇 배'면 그만큼 좋다
무엇과, 어떤 모델로, 누가 쟀는지에 따라 뜻이 달라집니다. 내 모델로 직접 재야 합니다.
국산 NPU는 아직 실험실 물건이다
통신사·포털·금융의 실서비스에서 하루 수억~수십억 토큰을 처리하고 있습니다. 다만 일의 종류가 한정돼 있습니다.
실무적인 권고는 이렇습니다. 정해진 모델로 대량의 추론을 돌리는 서비스가 있다면, NPU를 전부 대신 조금 들여 GPU와 나란히 재 보세요. 삼성SDS와 KT클라우드, 가비아가 NPU를 시간 단위로 빌려 주므로 장비를 사지 않고도 시험할 수 있습니다. 정부의 실증 사업은 그 비용과 위험을 나눠 집니다. 재 보고, 맞으면 그 서비스만 옮기고, GPU는 모델이 자주 바뀌는 일에 남겨 두는 것. 지금 실서비스에 들어간 회사들이 실제로 걸은 길입니다.
마치며: 반년 뒤에 다시 볼 것들
반년 전의 NPU 이야기는 "가능성"이었고, 지금은 "어디에 맞는가"입니다. 주머니 속 NPU는 눈에 띄는 기능 대신 당연한 부품이 됐고, 데이터센터 NPU는 GPU의 대체재가 아니라 GPU와 일을 나누는 전용 장비로 자리를 찾고 있습니다. 다음 점검 때 확인할 것들을 적어 둡니다.
지켜볼 것
왜 중요한가
리벨리온 Rebel100의 실서비스 투입과 가격
HBM을 얹은 국산 칩이 H200급 GPU와 같은 일을 놓고 겨루는 첫 사례가 됩니다.
K-Perf 측정 결과의 공개
국산 NPU에 대한 첫 공인 성적표입니다. 공개되면 '주장'이 '기록'으로 바뀝니다.
엔비디아 LPX의 고객 실측과 독립 벤치마크
GPU와 전용 칩의 이어달리기가 실제 비용에서도 이기는지 확인됩니다.
광주 NPU 컴퓨팅센터 예비타당성 결과 (11월 말)
NPU 8,400장 규모의 공공 수요가 생길지 정해집니다.
10월 중순 Windows 행사와 새 내장 모델
NPU에 맡기는 일이 늘어나는지, 요건이 바뀌는지 볼 수 있습니다.
메모리 가격
노트북의 16GB 요건과 서버 칩의 HBM 조달, 둘 다 여기에 걸려 있습니다.
NPU를 고민하는 분께 드리는 말은 GPU 글의 결론과 같습니다. 가장 좋은 칩이 아니라 일에 맞는 칩을 고르는 것. 그리고 발표된 배수가 아니라 내 모델로 잰 숫자를 믿는 것입니다.