입문서를 떼고 운영을 시작하면 만나는 장애 아홉 가지를, 여러분의 브라우저 안에서 직접 재현해 봅니다. 재시도가 장애를 키우는 재시도 폭풍, 결제 버튼 두 번, 목록 하나에 쿼리 51번(N+1), UUIDv4 기본키가 키우는 인덱스, 서버리스가 터뜨리는 커넥션 풀, 캐시가 한꺼번에 만료되는 스탬피드, DB 저장과 메시지 발행 사이에서 사라지는 이벤트, 자정을 넘나드는 시간대 버그, 그리고 로그 바다에서 원인 찾기. 세 개의 데모는 PGlite로 브라우저 안에 진짜 PostgreSQL 18을 띄워 실제 SQL과 실행 계획을 보여 주고, 나머지는 가정을 밝힌 시뮬레이터입니다. 2025년 10월 AWS us-east-1 장애와 11월 Cloudflare 장애의 사후 분석에서 교훈을 가져왔고, 해법 코드는 FastAPI(파이썬)와 Node(타입스크립트)로 나란히 실었습니다.
FastAPI 입문과 도커 첫걸음을 마치면 API를 만들고 배포할 수 있습니다. 그다음에 만나는 것은 문법이 아니라 장애입니다. 평소엔 멀쩡하던 서비스가 트래픽이 몰린 날, DB가 잠깐 느려진 날, 사용자가 버튼을 두 번 누른 날 무너집니다. 그리고 그 원인은 대개 몇 가지 정해진 모양을 하고 있습니다.
이 글은 그 모양 아홉 가지를 모았습니다. 지난주에 쓴 프론트엔드 실전 팁처럼, 각 팁마다 여러분의 브라우저 안에서 장애를 직접 재현하는 데모를 붙였습니다. 그중 세 개(N+1·UUID·시간대)는 PGlite로 브라우저 안에 진짜 PostgreSQL 18.3을 띄워 실제 SQL과 실행 계획을 보여 줍니다. 나머지 여섯은 시뮬레이터라서, 모델의 가정을 각 데모 아래에 밝혀 두었습니다. 해법 코드는 FastAPI(파이썬)와 Node(타입스크립트)로 나란히 실었습니다.
✅
아홉 가지 요약.
① 모든 외부 호출에 타임아웃을 걸고, 재시도는 한 곳에서만, 지수 백오프 + 지터 + 재시도 예산으로.
② 돈이 움직이는 POST에는 멱등성 키. 같은 키는 같은 결과를 돌려줍니다.
③ 목록 화면의 쿼리 수를 세세요. N+1은 JOIN이나 묶음 조회로, 느린 조회는 인덱스와 EXPLAIN ANALYZE로.
④ 기본키는 UUIDv4 대신 시간순인 UUIDv7(PostgreSQL 18 uuidv7()).
⑤ 커넥션 풀은 작게, 쿼리에는 statement_timeout. 서버리스는 인스턴스 수 × 풀 크기를 계산하세요.
⑥ 인기 캐시 키가 동시에 만료되면 DB가 맞습니다. 지터·single-flight·stale-while-revalidate.
⑦ DB 저장과 메시지 발행은 한 트랜잭션에 넣을 수 없습니다. 트랜잭션 아웃박스 + 멱등한 소비자.
⑧ 시간은 timestamptz로 저장하고, 날짜 경계는 '어느 시간대의 하루'인지 명시합니다.
⑨ 로그는 JSON으로, 요청마다 trace_id로 묶고, 에러 원문은 응답이 아니라 서버 로그에만.
0. 두 장애에서 배운 것
2025년 가을, 인터넷의 큰 부분이 두 번 멈췄습니다. 두 회사 모두 상세한 사후 분석을 공개했고, 거기서 이 글의 팁 여럿이 그대로 보입니다.
2025년 10월 19~20일
AWS us-east-1(태평양 시간 19일 23:48 ~ 20일 14:20). DynamoDB의 DNS를 관리하는 자동화에 숨어 있던 경쟁 조건(race condition)으로 지역 엔드포인트의 DNS 레코드가 비었습니다. DNS는 새벽 2시 25분에 복구됐지만, 그동안 쌓인 일을 다시 처리하려던 EC2 내부 관리 시스템이 제때 끝내지 못해 시간 초과와 재시도를 반복하며 AWS의 표현으로 "혼잡 붕괴(congestive collapse)"에 빠졌습니다. 엔지니어들은 들어오는 작업을 조절(throttle)하고 호스트를 선택적으로 재시작해야 했고, 로드 밸런서는 상태 확인이 실패와 정상을 오가며 정상 노드까지 빼냈습니다.
2025년 11월 18일
Cloudflare(UTC 11:20 ~ 17:06, 핵심 트래픽은 14:30께 회복). ClickHouse 권한 변경 뒤 봇 관리용 '기능 파일'을 만드는 쿼리가 중복 행을 돌려줘 파일 크기가 두 배가 됐고, 상한(200개)을 넘은 파일을 읽은 프록시가 오류로 멈췄습니다. 파일이 5분마다 다시 만들어져 정상·비정상이 번갈아 퍼지는 바람에 처음엔 공격으로 오인했습니다. Cloudflare는 2019년 이후 최악의 장애라고 했고, 첫 번째 재발 방지책으로 "우리가 만든 설정 파일도 사용자 입력처럼 검증하겠다"를 꼽았습니다.
두 사건 모두 출발점은 작았습니다. 경쟁 조건 하나, 쿼리 하나. 피해를 키운 것은 재시도와 대기열이 서로를 밀어 올리는 구조(AWS), 그리고 검증 없이 전 세계로 퍼지는 설정(Cloudflare)이었습니다. 우리 서비스는 그보다 훨씬 작지만, 같은 모양의 장애는 같은 이유로 일어납니다.
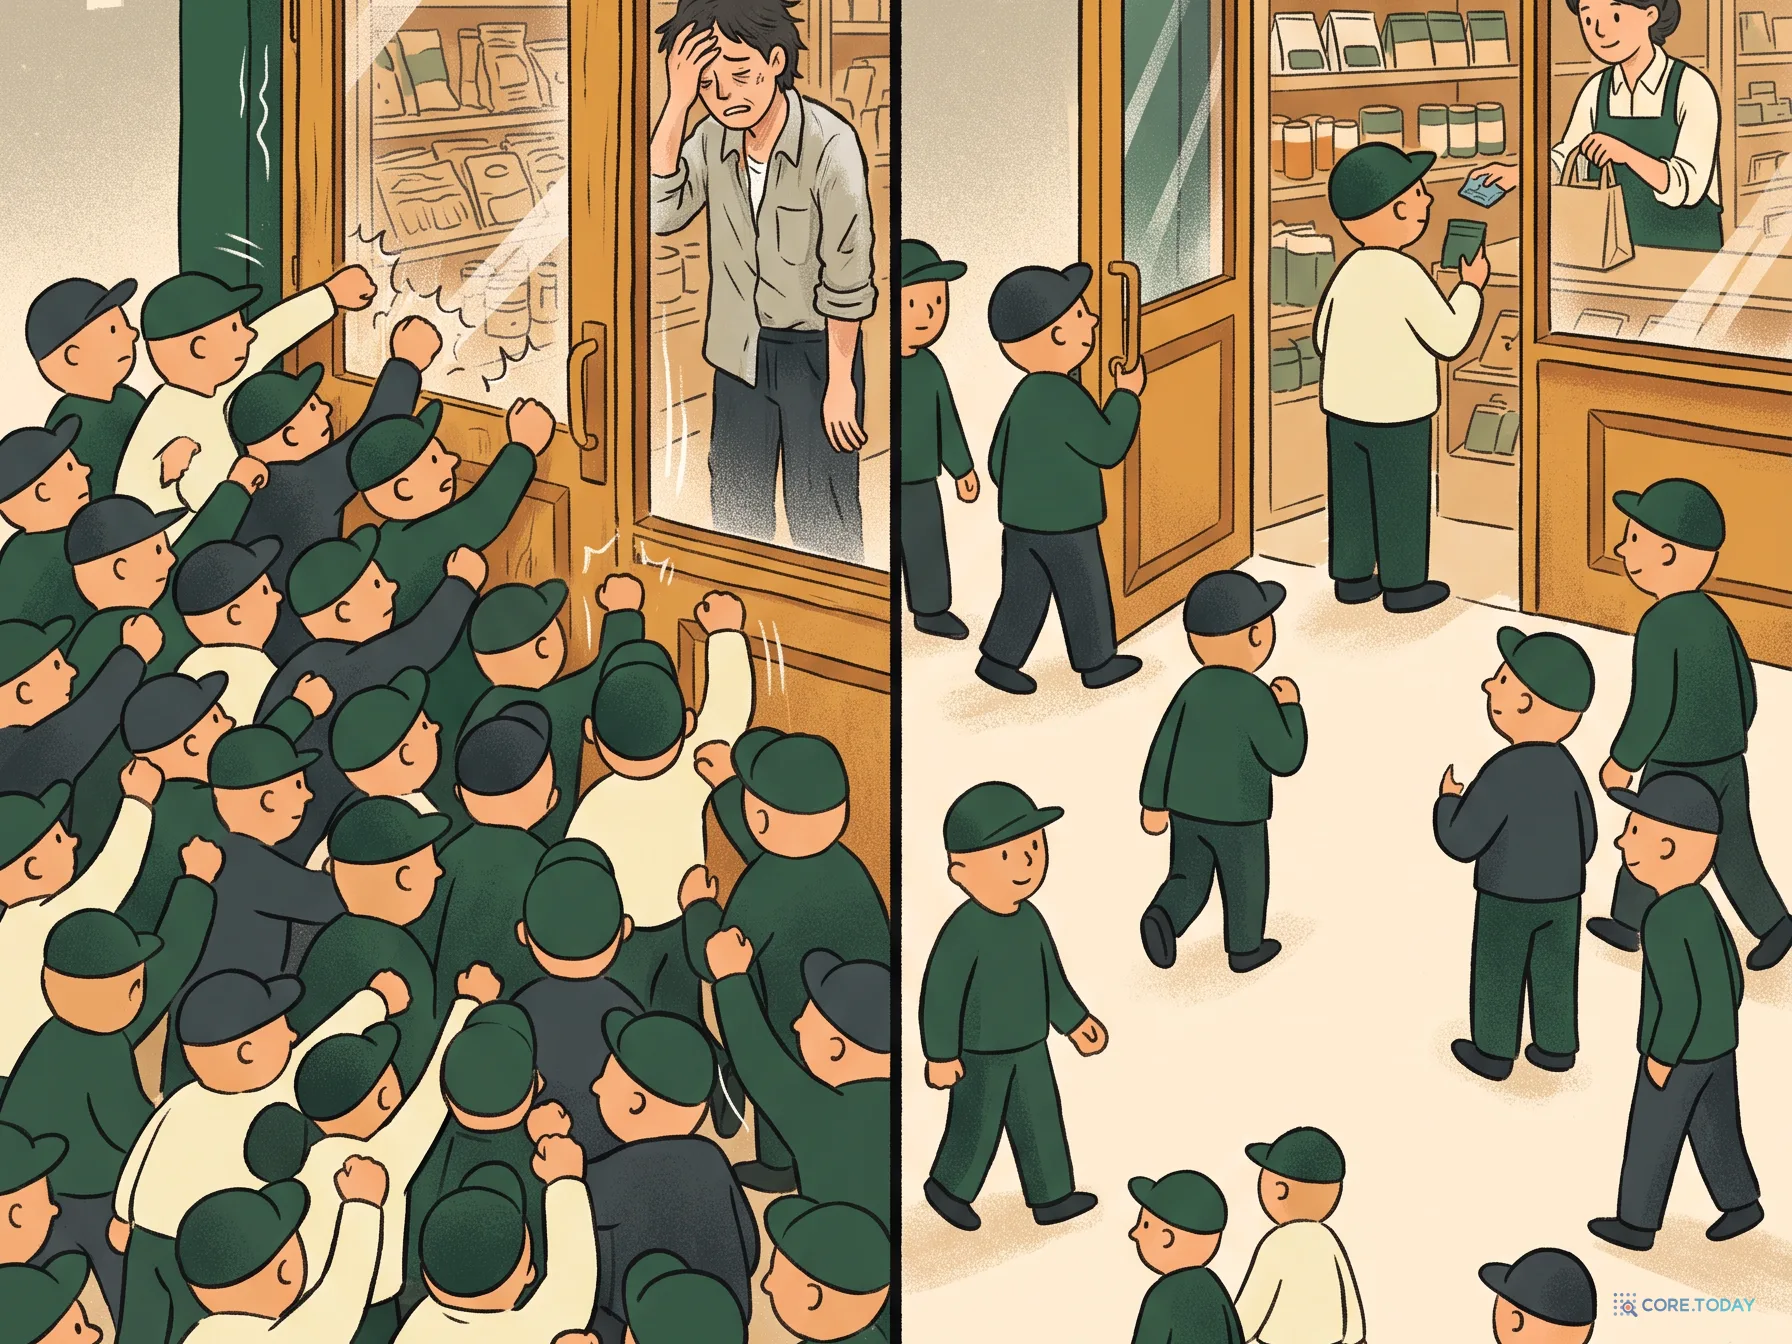
외부 API나 DB 호출에 타임아웃이 없으면, 상대가 느려지는 순간 우리 서버의 스레드·연결·메모리가 그 호출을 기다리며 묶입니다. 그래서 첫 번째 규칙은 모든 외부 호출에 타임아웃입니다. 그다음이 재시도인데, 재시도는 양날의 검입니다. AWS의 마크 브루커는 Builders' Library에서 이렇게 썼습니다. "재시도는 이기적이다." 다섯 단계로 이어진 호출에서 각 단계가 세 번씩 재시도하면 맨 아래 DB가 받는 부하는 3⁵ = 243배가 됩니다. 그래서 AWS의 권고는 재시도는 호출 스택의 한 곳에서만 하는 것입니다.
아래 시뮬레이터에서 서버가 20틱째에 잠깐 느려집니다. 재시도 방식에 따라 무슨 일이 벌어지는지 보세요.
시뮬레이터의 기본 설정(평소 부하의 1.3배 용량, 20초 동안 용량 30%로 저하, 타임아웃 2초)에서 결과는 이랬습니다.
장면 A: 서버가 잠깐 느려짐
용량 회복 뒤 정상화까지
요청 증폭
즉시 재시도(무제한)
회복 못 함
29.4배(최대 75배)
지수 백오프(지터 없음)
회복 못 함
3.7배
지수 백오프 + 풀 지터
회복 못 함
4.6배
재시도 예산 10%
8초
1.03배
+ 서버가 이미 포기된 요청을 버림
모든 정책이 즉시 회복
1.0~2.9배
서버의 대기열이 타임아웃(2초)보다 길게(4초) 쌓이면, 서버는 클라이언트가 이미 포기하고 재시도해 버린 요청을 처리하느라 용량을 씁니다. 그래서 용량이 돌아와도 부하가 내려오지 않습니다. 이것이 AWS 보고서의 '혼잡 붕괴'이고, 연구자들이 준안정 장애(metastable failure)라고 부르는 상태입니다. 백오프만으로는 빠져나오지 못했고, 빠져나오게 한 것은 재시도 총량을 묶는 예산과 기한이 지난 요청을 버리는 서버(대기열 상한, 요청에 마감 시각 전달)였습니다.
지터가 빛나는 곳은 장면 B, 모두가 같은 순간에 실패하는 경우입니다(배포 직후 클라이언트 1,000개가 한꺼번에 재접속). 지터 없는 백오프는 1,000개가 같은 박자로 다시 몰려 120초가 지나도 923개가 접속하지 못했고, 풀 지터는 23~30초 만에 모두 접속했습니다(클라이언트당 시도 3.6회). (모델 가정: 1틱 = 1초, 선입선출 대기열, 장난감 모델이라 방향만 보여 줍니다.)
AWS 아키텍처 블로그의 고전 「Exponential Backoff And Jitter」(2015)의 결론도 같습니다. 지터 없는 지수 백오프는 "명백한 패자"이고, 대기 시간을 0부터 상한까지 무작위로 고르는 풀 지터(full jitter)가 일을 가장 적게 만듭니다. 여기에 재시도 예산(예: 재시도는 전체 요청의 10%까지, 토큰 버킷으로 제한)을 더하면 최악의 경우에도 부하 증폭에 상한이 생깁니다. 타임아웃 값은 감으로 정하지 말고, 허용할 오탐률(예: 0.1%)에 해당하는 하위 서비스의 지연 백분위(p99.9)를 기준으로 정하라는 것이 같은 글의 조언입니다.
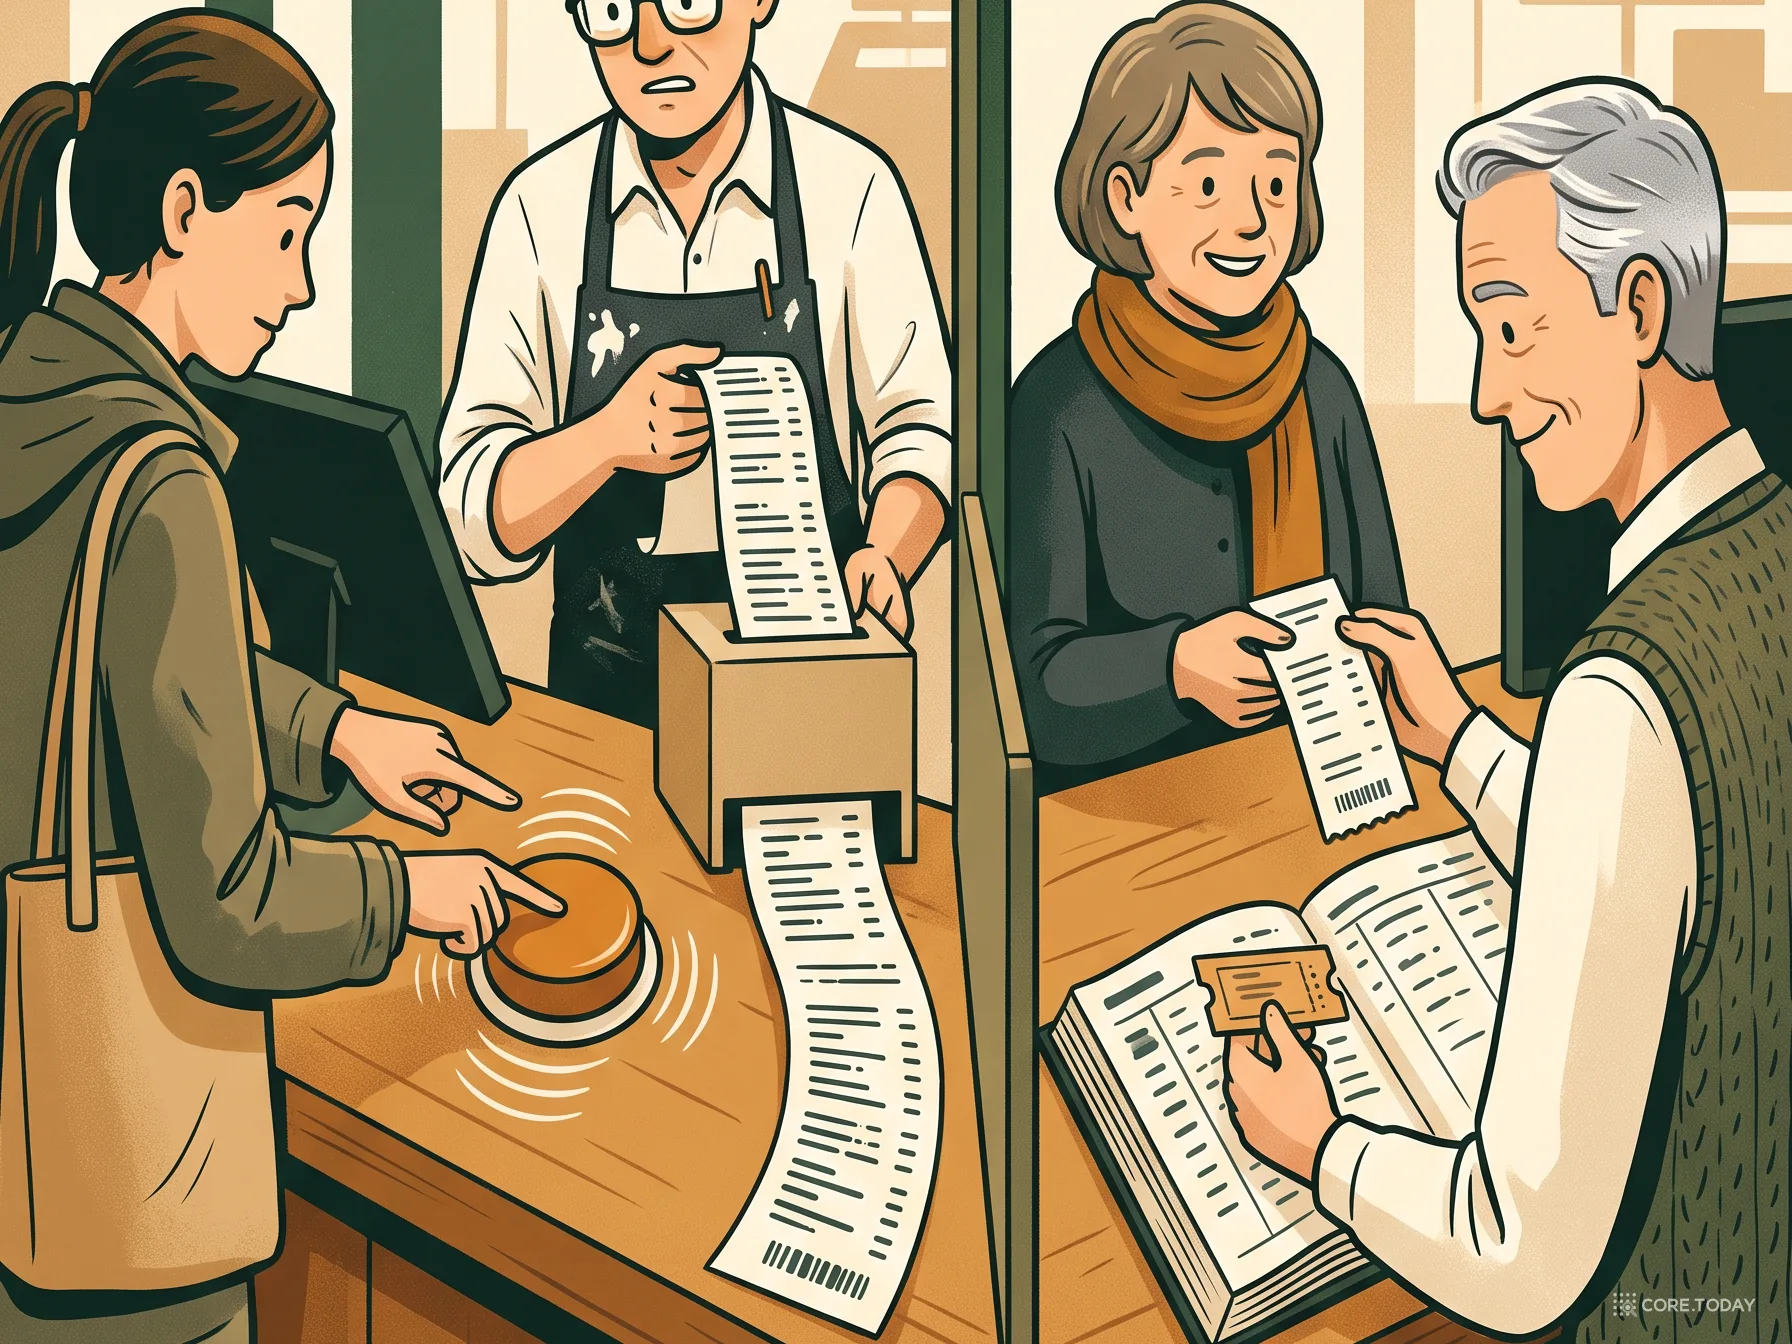
네트워크는 응답이 사라지는 곳입니다. 서버는 결제를 처리했는데 응답이 돌아오는 길에 연결이 끊기면, 클라이언트는 실패로 알고 다시 보냅니다. 사용자는 버튼을 한 번 더 누릅니다. 1장의 재시도가 바로 이 상황을 만듭니다. 해법은 멱등성 키(Idempotency-Key)입니다. 클라이언트가 '사용자의 의도 하나'마다 키를 하나 만들어 재시도 때도 같은 키를 보내면, 서버는 그 키로 처음 결과를 찾아 그대로 돌려줍니다.
규칙은 IETF HTTP API 작업반의 초안 「The Idempotency-Key HTTP Header Field」에 정리돼 있습니다(최신 -07, 2025년 10월. 아직 RFC가 아니고 초안 기한도 지났지만 사실상의 관례로 쓰입니다).
같은 키 + 다른 요청 본문 → 422
같은 키의 첫 요청이 아직 처리 중 → 409
키가 필요한데 없음 → 400
Stripe 같은 결제 API는 키별로 첫 응답(상태 코드와 본문, 500 오류까지)을 저장해 재생하고, 키를 최소 24시간 보관하며, 같은 키에 다른 파라미터가 오면 오류를 냅니다. 재생된 응답에는 Idempotent-Replayed: true 헤더가 붙습니다.
구현의 핵심은 키 저장과 실제 처리를 같은 트랜잭션에 넣는 것입니다. 키를 먼저 저장하고 처리하다 실패하면 '처리된 적 없는 키'가 남고, 처리 먼저 하고 키 저장에 실패하면 다음 재시도가 또 처리합니다.
ORM은 편하지만 쿼리를 숨깁니다. 게시글 50개를 가져온 뒤 템플릿에서 post.author.name을 부르면, ORM은 글마다 작성자를 따로 조회합니다. 글 목록 1번 + 작성자 50번 = 51번. DB가 아무리 빨라도 앱 서버와 DB 사이를 51번 오갑니다. 아래 데모는 버튼을 누르면 여러분의 브라우저 안에서 PostgreSQL 18이 뜨고(약 5MB), 작성자 500명·글 5만 개짜리 게시판에서 세 방식을 실제로 실행합니다.
제 맥(크롬 계열)에서 목록 50개, 왕복 5ms로 실행했을 때 N+1은 51번·약 270ms, 묶음 조회(IN)는 2번·약 19ms였습니다. 두 번째 실험인 인덱스는 더 극적입니다. "42번 작성자의 최근 글 20개"를 인덱스 없이 실행하면 5만 행을 모두 읽고 정렬했고(Node에서 4.6ms), (author_id, created_at desc) 복합 인덱스를 만든 뒤에는 필요한 20행만 읽었습니다(0.088ms, 약 50배). 데이터가 500만 행이면 앞쪽은 100배로 늘지만 뒤쪽은 거의 그대로입니다.
습관 두 가지. 개발 중에 요청당 쿼리 수를 로그로 보세요(SQLAlchemy echo, Drizzle·Prisma 로거, APM 트레이스). 같은 모양의 쿼리가 줄줄이 반복되면 N+1입니다. 그리고 느린 쿼리는 짐작하지 말고 EXPLAIN (ANALYZE, BUFFERS)로 봅니다. Seq Scan과 Rows Removed by Filter가 크면 인덱스 후보입니다.
분산 환경에서 ID를 미리 만들 수 있고 추측하기 어려워서 UUID를 기본키로 많이 씁니다. 문제는 흔히 쓰는 UUIDv4가 완전한 무작위라는 점입니다. B-tree 인덱스는 정렬된 구조라서, 무작위 키를 넣을 때마다 인덱스의 아무 페이지에나 끼어들어 페이지가 쪼개지고(page split), 반쯤 빈 페이지가 늘고, 최근 데이터가 메모리 캐시에 모이지 않습니다. 2024년 5월 표준이 된 RFC 9562의 UUIDv7은 앞 48비트가 밀리초 단위 유닉스 시각이라 시간순으로 커지고, 새 키는 늘 인덱스의 오른쪽 끝에 붙습니다. RFC 스스로 v4가 데이터베이스 인덱스 지역성이 나쁘고 B-tree 성능에 미치는 영향이 "극적일 수 있다"고 적었습니다.
PostgreSQL 18(2025년 9월)에 uuidv7() 함수가 들어왔습니다. 아래 데모에서 같은 수의 행을 v4와 v7로 넣고 기본키 인덱스 크기를 비교해 보세요.
Node에서 같은 SQL로 잰 값은 10만 행 기준 기본키 인덱스 v4 약 4.3MB, v7 약 3.2MB(약 26% 작음), 삽입 시간도 v7이 조금 빨랐습니다. 행이 많아지고 인덱스가 메모리보다 커질수록 차이는 더 벌어집니다. 그리고 v7로 order by id desc limit 20을 하면 그대로 '최신 20건'이 나옵니다.
주의할 점도 있습니다. v7은 생성 시각을 드러냅니다. 가입 순서나 주문 규모를 추측당하면 안 되는 공개 ID, 비밀 토큰으로는 쓰지 마세요. PostgreSQL 17 이하라면 앱에서 만듭니다. 파이썬은 3.14부터 표준 라이브러리에 uuid.uuid7()이 있고, Node는 uuid 패키지(10.0부터)의 v7()을 씁니다.
DB 연결은 비쌉니다. PostgreSQL은 연결마다 프로세스를 하나씩 띄우고, max_connections 기본값은 100입니다. 그래서 앱은 연결을 미리 만들어 돌려 쓰는 커넥션 풀을 둡니다. 얼마나 크게 잡아야 할까요? 답은 리틀의 법칙 L = λW 하나로 시작합니다. 초당 요청 200개(λ)가 각각 20ms(W) 동안 연결을 쓰면, 동시에 필요한 연결은 평균 200 × 0.02 = 4개입니다. 생각보다 훨씬 적습니다.
아래쪽 60초 시뮬레이션의 기본값(연결 40개, 초당 200건)에서 쿼리가 모두 정상이면 응답 지연은 p50 14ms, p99 92ms입니다. 그런데 5%의 요청이 3초짜리 느린 쿼리를 만나면 p95가 2.53초, p99가 3.51초로 뛰고 대기열이 최대 232건까지 쌓입니다. 느린 쿼리가 연결을 붙잡고 있는 동안 정상 요청까지 줄을 서기 때문입니다. 8%가 되면 대기열이 3,000건을 넘으며 무너집니다(p50 11.9초). 같은 5% 상황에서 statement_timeout 1초를 걸면 p50이 15ms로 돌아오고, 대신 5.4%가 빠르게 실패합니다. 느린 소수를 빨리 실패시켜 다수를 살리는 것이 타임아웃의 역할입니다. (모델 가정: 포아송 도착, 쿼리 시간 지수분포, 연결은 쿼리 동안만 점유. 긴 트랜잭션은 더 나쁩니다.)
HikariCP 문서의 유명한 경험칙은 연결 수 = 코어 수 × 2 + 디스크 수이고, "연결을 기다리는 스레드로 가득 찬 작은 풀"이 낫다고 말합니다. 2026년에 특히 조심할 곳은 서버리스입니다. 함수 인스턴스는 트래픽에 따라 수백 개로 늘어나고, 각각이 풀 10개를 열면 금세 수천 개가 됩니다. 인스턴스당 풀은 1~2로 줄이고, PgBouncer(트랜잭션 모드)나 클라우드의 관리형 풀러를 앞에 두세요. 그리고 느린 쿼리 하나가 풀 전체를 잡아먹지 못하게statement_timeout과 풀 획득 타임아웃을 함께 겁니다.
캐시는 DB를 지켜 주지만, 인기 키가 만료되는 순간에는 반대로 DB를 공격합니다. 초당 1,000번 읽히는 키의 TTL이 끝나면, 다시 채워지기까지 걸리는 시간(DB 조회 200ms라면) 동안 들어온 요청 약 200개가 모두 캐시 미스로 DB에 갑니다. 배포 직후 캐시를 통째로 비우면 수천 개 키가 같은 순간에 이 일을 겪습니다.
시뮬레이터(DB는 동시 쿼리 50개까지 제 속도, 넘으면 비례해 느려짐)에서 키 1,000개를 한꺼번에 채운 뒤 같이 만료되는 장면(초당 5,000건)을 보면, 단순 TTL은 DB 동시 쿼리가 최대 6,755개까지 치솟고 사용자 p99가 10.5초가 됐습니다. TTL에 지터만 줘도 최대 28개·1ms로 내려갑니다. 반면 키 하나가 아주 뜨거운 장면에서는 지터가 소용없고(키가 하나뿐이니 흩뜨릴 것이 없음), single-flight나 stale-while-revalidate가 DB 쿼리를 1개로 줄였습니다. stale-while-revalidate는 사용자를 빠르게 지켜 주지만 DB는 여전히 갱신 파도를 맞으므로(685개), 지터와 함께 쓰는 조합이 가장 좋았습니다. (모델 가정: 서버 한 대. 서버가 여러 대면 single-flight는 프로세스마다 따로 동작하므로 분산 잠금이나 stale-while-revalidate가 필요합니다.)
방법은 다섯 가지를 섞어 씁니다.
TTL 지터: 만료 시각을 ±10~20% 흩뜨립니다. 같이 만든 키들이 같이 죽지 않게 합니다.
single-flight(잠금): 한 요청만 DB에 가서 다시 채우고, 나머지는 기다리거나 이전 값을 받습니다.
stale-while-revalidate: 만료된 값을 잠시 더 주면서 뒤에서 새로 고칩니다. HTTP 캐시에서는 RFC 5861(2010)의 Cache-Control: max-age=600, stale-while-revalidate=30이 같은 개념입니다.
확률적 조기 갱신(XFetch): 만료가 다가올수록 높아지는 확률로 미리 갱신합니다(Vattani 등, VLDB 2015).
주문을 DB에 저장하고 "주문 생성됨" 이벤트를 메시지 브로커에 보내는 코드는 흔합니다. 문제는 DB와 브로커가 한 트랜잭션으로 묶이지 않는다는 것입니다. 저장 후 발행 전에 프로세스가 죽으면 이벤트가 사라지고, 발행 후 저장이 롤백되면 존재하지 않는 주문의 이벤트가 퍼집니다(이중 쓰기 문제). 아래에서 실패를 직접 주입해 보세요.
해법은 크리스 리처드슨의 패턴 카탈로그(microservices.io)에 정리된 트랜잭션 아웃박스입니다. 주문 행과 함께 같은 트랜잭션으로 outbox 테이블에 이벤트 행을 넣고, 별도의 릴레이가 그 테이블을 읽어 브로커에 발행합니다. 릴레이는 여러 개를 띄워도 SELECT … FOR UPDATE SKIP LOCKED로 같은 행을 나눠 가지지 않고, 아웃박스 테이블을 폴링하는 대신 Debezium의 Outbox Event Router 같은 CDC(변경 로그 추적)로 읽을 수도 있습니다. 단, 릴레이가 발행하고 '발행됨' 표시를 하기 전에 죽으면 같은 이벤트가 두 번 나갑니다. 그래서 소비자도 이벤트 ID로 중복을 거르는 멱등 처리가 짝입니다. 2장의 멱등성 키와 같은 생각입니다.
8. 시간은 UTC로 저장하고, 하루는 어느 시간대의 하루인지 밝히세요
한국은 서머타임이 없고 시간대가 하나라서 시간 버그를 늦게 만납니다. 해외 사용자를 받거나, 서버를 UTC로 돌리는 클라우드에 올리는 순간 나타납니다. 대표적인 두 가지가 timestamp(시간대 없음) 컬럼에 저장한 값이 무슨 시간대인지 아무도 모르게 되는 것, 그리고 "하루 매출"을 서버의 시간대로 자르는 것입니다. 아래 데모는 브라우저 속 PostgreSQL에서 세션 시간대만 바꿔 같은 쿼리를 실행합니다.
Node에서 같은 SQL을 돌렸을 때, 서울 기준 정답은 10월 3일 40,000원·10월 4일 70,000원이었습니다. 그런데 date_trunc('day', ts)는 세션이 UTC나 뉴욕이면 10월 2일 10,000원·10월 3일 100,000원으로 바뀌었고, 시간대 없는 timestamp로 저장한 쪽은 뉴욕 주문을 뉴욕 현지 시각으로 담고 있어 어느 세션에서든 틀렸습니다. 규칙은 이렇습니다.
저장은 timestamptz(내부적으로 UTC). 주고받을 때는 2026-10-03T14:30:00+09:00처럼 오프셋을 붙인 ISO 8601.
날짜로 묶을 때는 어느 시간대의 하루인지 명시: date_trunc('day', ts, 'Asia/Seoul')(PostgreSQL 16부터의 3인자 형식) 또는 ts at time zone 'Asia/Seoul'.
서머타임이 있는 지역의 '현지 시각'은 하루에 두 번 오거나(11월) 아예 없을 수 있습니다(3월). 반복 일정은 현지 시각과 시간대 이름을 함께 저장합니다.
자바스크립트의 새 날짜 API Temporal은 Firefox 139·Chrome 144·Node 26에 들어왔지만 Safari 정식판에는 아직 없습니다(MDN 호환성 데이터, 10월 1일). 당분간은 Intl.DateTimeFormat에 timeZone을 주는 방식이 가장 넓게 동작합니다.
9. 로그는 JSON으로, 요청마다 trace_id로
고객이 "14시 3분쯤 결제가 안 됐어요"라고 문의했습니다. 게이트웨이·주문·결제 서비스의 로그가 섞여 1분에 수천 줄씩 쌓이는데, 시간과 키워드로 grep하면 비슷한 시각의 다른 오류들이 잡힙니다. 아래 데모에서 같은 사건을 평문 로그와 구조화 로그로 찾아보세요.
구조화 로그(한 줄에 JSON 하나)에 요청마다 같은 trace_id를 넣으면, 서비스를 건너도 한 요청의 로그가 한 번에 모입니다. 서비스 사이에서는 W3C Trace Context 표준(2020년 권고안)의 traceparent 헤더(00-<32자리>-<16자리>-01)로 이 ID를 넘깁니다. OpenTelemetry가 이 일을 자동으로 해 주는데, 로그 사양 자체는 안정(Stable) 단계지만 SDK의 안정도는 언어마다 다릅니다(Java·.NET은 안정, 파이썬·자바스크립트는 아직 개발 단계).
그리고 에러 원문은 응답에 넣지 않습니다. 스택 트레이스나 SQL이 응답 본문에 실리면 공격자에게 내부 구조를 알려 주는 셈입니다. 사용자에게는 { "error": "결제 처리 중 문제가 발생했습니다", "traceId": "…" }처럼 짧은 메시지와 추적 ID만 주고, 자세한 내용은 서버 로그에만 남깁니다. 고객이 추적 ID를 알려 주면 바로 해당 요청을 찾을 수 있습니다. 이 블로그 사이트의 API도 같은 규칙을 따릅니다.
마지막으로 Cloudflare의 교훈. 내가 만든 설정 파일도 사용자 입력처럼 검증하세요. 크기 상한을 넘으면 거부하고 이전 버전을 유지하게(fail safe) 만들고, 설정 변경도 코드 배포처럼 단계적으로 내보냅니다. 같은 해 12월 5일 Cloudflare의 25분짜리 장애는 단계적 배포를 거치지 않는 전역 설정 시스템으로 나간 변경 하나에서 시작됐습니다.
부록: 2026년 10월, 백엔드 런타임·DB 현황
대상
현재
알아 둘 일정
Node.js
24(Active LTS), 26(5월 출시)
10월 20일 Node 24 유지보수 전환, 10월 28일 Node 26 LTS. Node 20은 4월 30일 지원 종료. 27부터 메이저는 1년에 한 번(27.0.0은 2027년 4월)