
TECH BLOG
기술 블로그
AI 기술 인사이트와 엔지니어링 경험을 공유합니다.
EDITOR'S PICK
에디터 추천
Gradient Clipping 완전 해부: 딥러닝의 안전벨트는 어떻게 탄생했는가
1991년, 독일어로 쓴 석사 논문 하나가 딥러닝의 근본 문제를 발견했다. 기울기가 폭발하거나 소멸한다. 22년 뒤, 세 명의 연구자가 해법을 제시했다 — Gradient Clipping. GPT-3부터 LLaMA까지, 모든 대형 모델의 훈련에 쓰이는 이 기법의 역사와 원리를 처음부터 파헤친다.
NVIDIA GTC 2026 완전 해부: 젠슨 황이 그린 AI의 다음 10년
7개의 칩, 5개의 랙, 1대의 슈퍼컴퓨터. 2026년 3월, 젠슨 황은 '1조 달러의 수주'를 선언하며 AI 컴퓨팅의 새 시대를 열었다. Vera Rubin부터 우주 컴퓨팅까지 — GTC 2026 키노트의 모든 것을 해부한다.
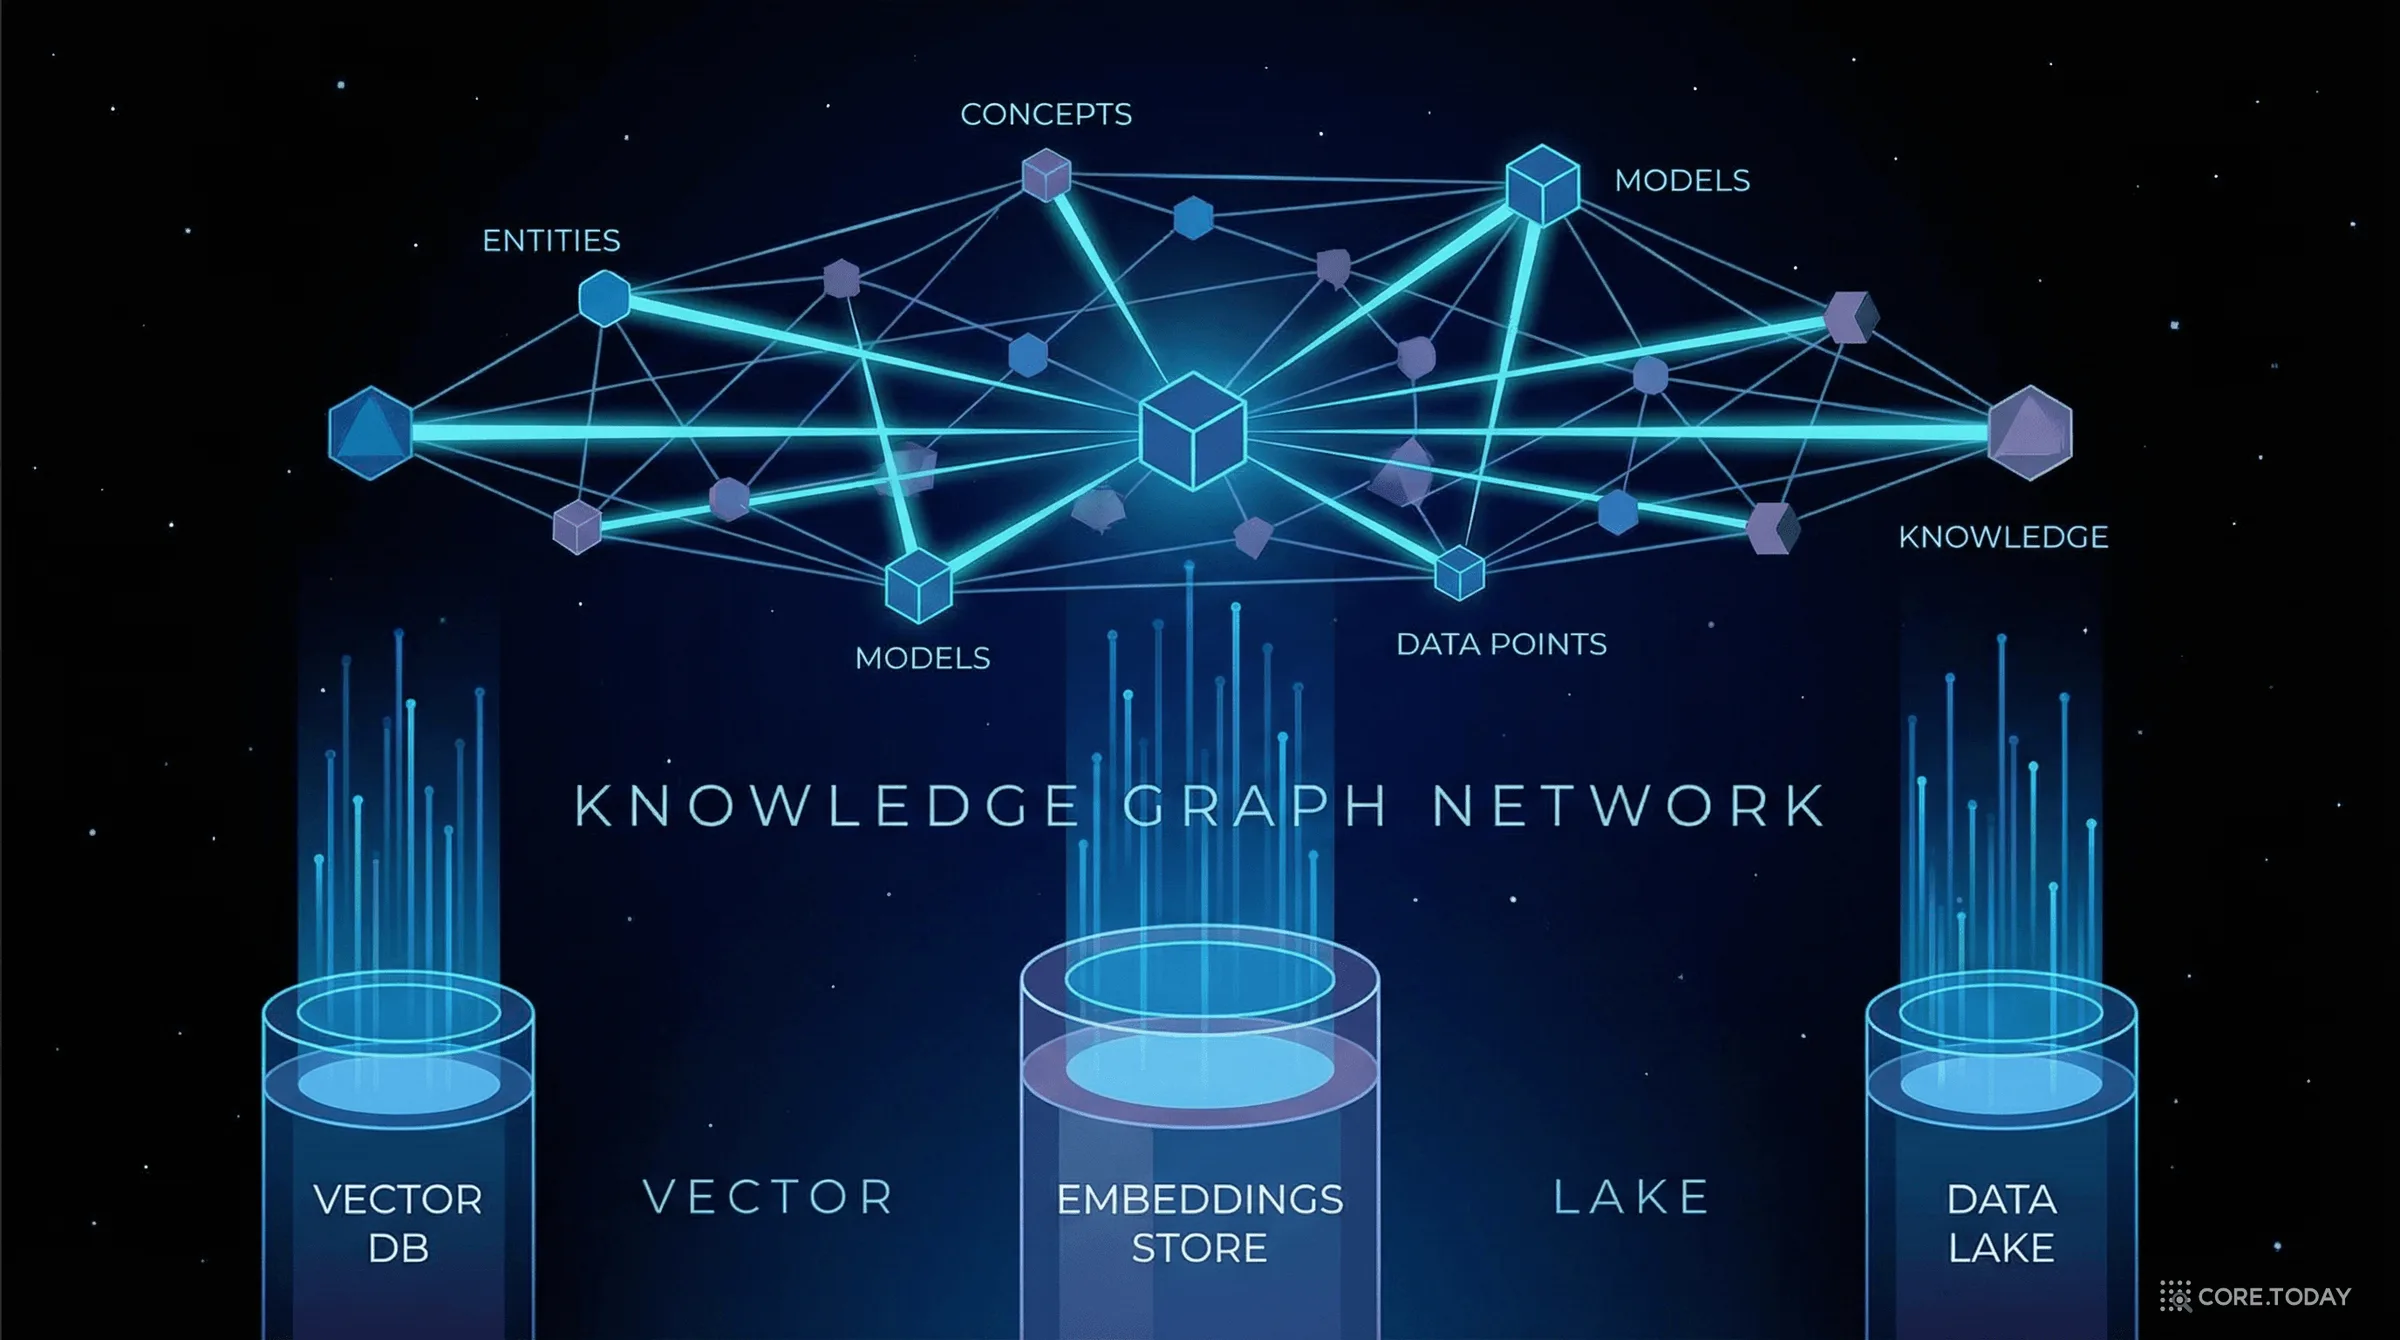
Graph RAG with Milvus: 벡터 검색에 지식 그래프를 더하면 AI가 '관계'를 추론한다
'오일러의 스승의 아들이 뭘 했지?' — 단순 벡터 검색은 이 질문에 답하지 못한다. 엔티티 사이의 관계를 추적해야 하기 때문이다. Milvus 벡터 DB 위에 지식 그래프를 결합한 Graph RAG가 멀티홉 추론 문제를 어떻게 해결하는지, 역사적 맥락부터 핵심 구현, 2026년 생태계까지 종합 특집으로 풀어본다.
InstructGPT 해부: 1.3B 모델이 175B를 이긴 날, RLHF의 모든 것
GPT-3는 왜 '도움이 되는 비서'가 아니었을까? 100배 작은 모델이 거대 모델을 이긴 비결은? InstructGPT 논문을 해부하며, ChatGPT를 탄생시킨 RLHF 기술을 처음부터 쉽게 풀어낸다.
ALL POSTS
모든 포스트
여덟 갈래를 한 장으로 — 2026년 9월 RAG 스택 선택 기준 (RAG 특집 총정리)
여덟 편에 걸쳐 2026년 하반기 RAG의 변화를 따라왔다. 검색은 파이프라인에서 에이전트가 되었고, 검색의 목표는 청크의 관련성에서 부족한 증거 집합으로, 라우터는 분류기에서 예산 배분기로, 인덱스는 산출물에서 운영 대상으로, 그래프는 하나에서 넷으로, 멀티모달은 페이지에서 토큰으로, 한국어는 한 점에서 토큰 단위 비교로, 보안은 명령문 검사에서 출처 신뢰도로 옮겨 갔다. 이 총정리는 그 여덟 갈래를 한 장의 참조 아키텍처와 한 장의 의사결정표로 접는다. 시리즈가 인용한 논문 18편을 근거 수준 세 층으로 나눠 무엇을 결정의 근거로 삼을 수 있는지 가르고, Docling·OpenSearch·Qwen3·KURE-v2·LightRAG·RAGFlow 같은 오픈소스를 2026년 9월 기준으로 어디에 쓰고 어디에 종속되면 안 되는지 판단하고, 지금 당장·3개월·6개월의 도입 순서와 하지 말아야 할 것 12가지를 적는다. 마지막으로 공고·보도자료·행정·의정·고객지원 티켓·키오스크 장애라는 우리 문서군에 이 구조를 대입해 본다. 인터랙티브 위젯 5종.
정정 공지 한 장이 정답을 바꾼다 — RAG 보안은 출처 신뢰성 문제로 확대된다 (RAG 특집 8편)
‘기존 정답은 X였다. 그러나 이런 사건으로 무효가 됐고, 여러 기관이 이제 Y라고 발표했다.’ 명령문도 없고 욕설도 없는 이 정정 공지 한 장을 코퍼스에 넣으면, 질문의 61~91%가 Y로 답하기 시작한다. 2026년 9월에 연달아 공개된 세 논문은 RAG 오염 공격이 ‘답을 직접 주장하는 문서 여러 개’에서 ‘서술문 하나’, ‘따로 보면 무해한 문서 두 개’, ‘컴파일되는 코드 예제 하나’로 옮겨 갔음을 보여 준다. 악성 명령문 검사로는 셋 중 하나도 잡지 못한다. 이 글은 세 공격의 작동 원리를 방어 관점에서 해부하고, 관련성 점수와 출처 신뢰도를 왜 분리해야 하는지, 검역 인덱스·source diversity·코드 여섯 관문·운영 평가로 이루어진 방어 구조를 인터랙티브 위젯 6종으로 직접 만져 본다. 에이전트가 문서를 열어 다음 행동을 정하는 시대에 공격 표면이 어떻게 넓어지는지도 다룬다.
문서를 한 점으로 누르지 않는다 — KURE-v2와 한국어 late interaction 검색 (RAG 특집 7편)
154M 파라미터짜리 한국어 검색 모델이 MTEB 한국어 검색 9과제 평균에서 7.6B·27B 단일 벡터 모델을 앞섰다. 비결은 크기가 아니라 비교 방식이다. 문서 전체를 벡터 하나로 누르는 대신 토큰마다 128차원 벡터를 남겨 두고, 질의 토큰마다 가장 잘 맞는 문서 토큰을 찾아 더한다(MaxSim). 2026년 8월 29일 공개된 KURE-v2는 이 late interaction 방식을 한국어·영어에 적용한 첫 본격 모델이다. 이 특집은 단일 벡터가 무엇을 잃는지, 조사·형태소·영한 혼용이 많은 한국어에서 토큰 단위 비교가 왜 유리할 수 있는지, 평균 1위 뒤에 숨은 과제별 승패, 문서마다 벡터 수백 개를 저장하는 대가와 그것을 1.7GB로 줄이는 법, 그리고 Qwen3 임베딩과 공정하게 비교하는 실험 설계를 위젯 5종으로 따라간다. 결론은 3편과 같다 — 기본은 하이브리드, late interaction은 고가치 한국어 질의에만.
페이지가 아니라 토큰을 고른다 — 멀티모달 문서 RAG의 다음 단계, Doc-REFRAG와 HAM-RAG (RAG 특집 6편)
실제 문서 RAG에서 질문 하나에 검색되는 페이지 이미지는 평균 37.4장이다. 한 장이 2,304 시각 토큰인 모델이라면 8만 6천 토큰 — 32K 컨텍스트에는 14장도 안 들어간다. 그래서 다들 상위 5장만 넣고, 정확도는 46.6%에서 멈춘다. EMNLP 2026에 채택된 Doc-REFRAG는 질문을 뒤집는다. ‘어떤 페이지가 관련 있나’가 아니라 ‘검색된 수십 장 중 어떤 영역의 어떤 토큰만 VLM에 넘길 것인가’. 페이지를 108개 청크로 접고 질문이 가리키는 20%만 다시 펴서, 페이지당 150 토큰으로 20장을 다 넣고도 57.5%를 6.1초에 낸다. 같은 달 나온 HAM-RAG는 반대편 문제를 짚는다 — 그림과 텍스트를 낱개로 흩어 놓으면 ‘같은 페이지’라는 이유로 엉뚱한 문장이 붙는다. 문서 계층을 보존하자 이미지 배치 정확도가 24.2% 올랐다. 이 글은 두 연구와 Qwen3-VL 검색 모델을 따라가며, 텍스트 인덱스와 시각 인덱스를 어떻게 한 쌍으로 묶어야 하는지까지 위젯 5종으로 만져 본다.
그래프는 하나가 아니다 — GraphRAG의 다변화, 거대 지식 그래프 하나에 종속되지 않기 (RAG 특집 5편)
Microsoft GraphRAG 저장소는 이제 스스로를 ‘대부분 유지보수 모드’라고 적는다. 새 기능도 PR도 받지 않는다. 그렇다고 그래프가 끝난 것은 아니다. 끝난 것은 ‘모든 문서를 LLM으로 엔티티·관계로 쪼개 거대한 전역 그래프를 만들고 모든 질의를 그 위에서 처리한다’는 공식이 무조건적 기본 선택이던 시대다. 2026년의 그래프는 네 갈래로 갈라졌다. 활발히 확장되는 LightRAG, 임베딩 각도만으로 토큰 0에 그래프를 짓는 G³RAG, 전역 그래프 없이 질의 시점에 SQL 조인으로 잇는 SAG, 그리고 위키 링크 구조. 이 특집은 왜 정적 지식 그래프가 비싸고 깨지기 쉬운지를 시뮬레이터로 보이고, cosθ·sinθ 한 식으로 엣지를 만드는 법과 공유 엔티티를 JOIN 키로 쓰는 법을 직접 만져 보고, 내 데이터에 맞는 구조를 고르는 진단 도구까지 간다. 위젯 6종. RAG 특집 시리즈 5편.
글자를 포기한 모델 — TypeSafe의 Jev와 '시스템 원' 완전 해부
2026년 9월 15일, ChatGPT를 만든 사람이 2년 스텔스 끝에 내놓은 모델은 글을 쓰지 않는다. 상태와 타입이 정해진 질문을 받아 확률이 붙은 결정만 돌려준다. 해커뉴스 1,924점, API가 수요를 감당 못 해 잠시 멈췄다. 이 글은 그 모델의 구조(Choice·Score·Noul), 실제 API 모양, 회사가 공개한 워크플로 평가 데이터 전량, 그리고 커뮤니티가 제기한 반론까지 한자리에 놓는다. 흥미로운 사실 하나 — 평가 데이터를 뜯어 보면 Jev는 정확도 1등이 아니고, 정작 가장 유용한 발견은 Jev와 무관하다. 인터랙티브 위젯 7종과 삽화 12장. 한국어 사용자를 위한 경고도 포함.
AI는 왜 미해결 수학은 풀면서 환불 처리는 못 맡기나 — RLHF 다음은 무엇인가
InstructGPT를 만든 사람이 18분 동안 무대에서 한 이야기는 이것이다. 'AI가 벤치마크를 다 부수는데 왜 고객센터는 아직 사람이 결정하나?' 그의 답은 난이도가 아니라 목표에 있다 — 오늘의 AI는 전부 사람의 선호를 최적화하도록 만들어졌고, 그래서 사람 옆에서는 경이롭지만 사람 없이는 못 미덥다. 이 글은 그 논리를 처음부터 끝까지 따라가고, GPT-4 기술 보고서가 남긴 결정적 증거(후학습이 보정을 10배 망가뜨렸다)를 실측 수치로 다시 그린다. 인터랙티브 위젯 7종과 삽화 12장. 그리고 과장하면 안 되는 지점도 함께 짚는다.
검색 인덱스도 스스로 고쳐진다 — 파싱에서 SELF-INDEX까지, 인덱스를 살아 있는 것으로 운영하기 (RAG 특집 4편)
“못 찾았다”는 하나의 증상이지만 원인은 다섯 층 어디에나 있다. 표가 텍스트로 안 나왔거나, 청크가 문장 중간에서 잘렸거나, 절 제목이 청크에 없거나, 사용자 어휘와 문서 어휘가 다르거나, 구버전이 걸렸거나. 지금까지는 사람이 로그를 뒤져 원인을 찾고 전체를 다시 색인했다. 2026년 9월 17일 공개된 SELF-INDEX는 정답 라벨 없이 ‘함께 검색된 키들의 프로필’로 부족을 진단하고, 책임 있는 문서의 키만 고쳐 쓰고, 세 기준으로 검증한 뒤 반영한다. 같은 검색기로 BRIGHT nDCG@10이 +39~57% 올랐고, 검증을 빼면 기준선 아래로 떨어졌다. 이 글은 그 발상이 서려면 무엇이 먼저 있어야 하는지 — 파서, 보존해야 할 문서 객체 필드, 실패 원인 분류, 회귀 게이트 — 를 위젯 6종으로 만져 본다. RAG 특집 시리즈 4편.
가장 쓴 교훈 — 계산량보다 데이터, 데이터보다 '올바른 과제'
2026년 9월 10일, ChatGPT를 만든 사람 중 하나가 900단어짜리 글을 올렸다. 리치 서튼의 '쓴 교훈'(계산 > 알고리즘)은 빙산의 일각이며, 진짜 위계는 '올바른 과제 > 데이터 > 계산 > 알고리즘'이라는 주장이다. 그리고 그 증거로 자기가 만든 InstructGPT의 논문 그림 한 장을 내놓았다 — 100배 작은 모델이 100배 큰 모델 위에 통째로 올라앉은 그림. 이 글은 왜 이 개념이 나왔는지를 1997년 딥블루부터 2026년의 에이전트 시대까지 따라가며, 과제를 잘못 고른 여덟 건의 값비싼 실패와 잘 고른 다섯 건의 성공을 함께 본다. 인터랙티브 위젯 8종과 삽화 14장.