
변화하고 싶다면, 데이터 스토리텔링
코어닷투데이는 데이터 스토리가 기업을 변화시킬 수 있다고 믿습니다. 2016년부터 2021년까지 다양한 데이터 분석 사례를 쌓으며, 데이터에서 어떤 가치를 끌어내고 싶은지, 그러려면 어떤 도구가 필요한지, 데이터와 기술을 연결해 종합적으로 이해하는 법을 배웠습니다. 2022년, 코어닷투데이는 이 경험과 기술 인프라를 넓혀 기업의 문제를 해결하는 데이터 스토리텔링 플랫폼을 선보였습니다.
- 비전 — 데이터로 변화를 만드는 기회를 창출한다
- 미션 — 기업과 전문가가 서로 교류하면서 생산성을 높이고, 성공적인 데이터 솔루션을 갖도록 만든다
- 사회적 가치 — 데이터 분석 결과물의 객관성을 확보하는 신뢰성, 손쉬운 공유와 재사용이 가능한 재현성
데이터를 비즈니스의 무기로 쓰고 싶지만, 데이터와 기술자를 모두 자체 보유해야 할 것 같고, 데이터 전문 인력은 구하기 어렵고(높은 고정비, 모집·홍보·검증 부담), 세상의 변화는 너무 빠릅니다. 코어닷투데이는 이런 기업의 데이터 고민을 필요한 순간, 필요한 만큼 검증된 데이터 전문가와 연결해 해결합니다.
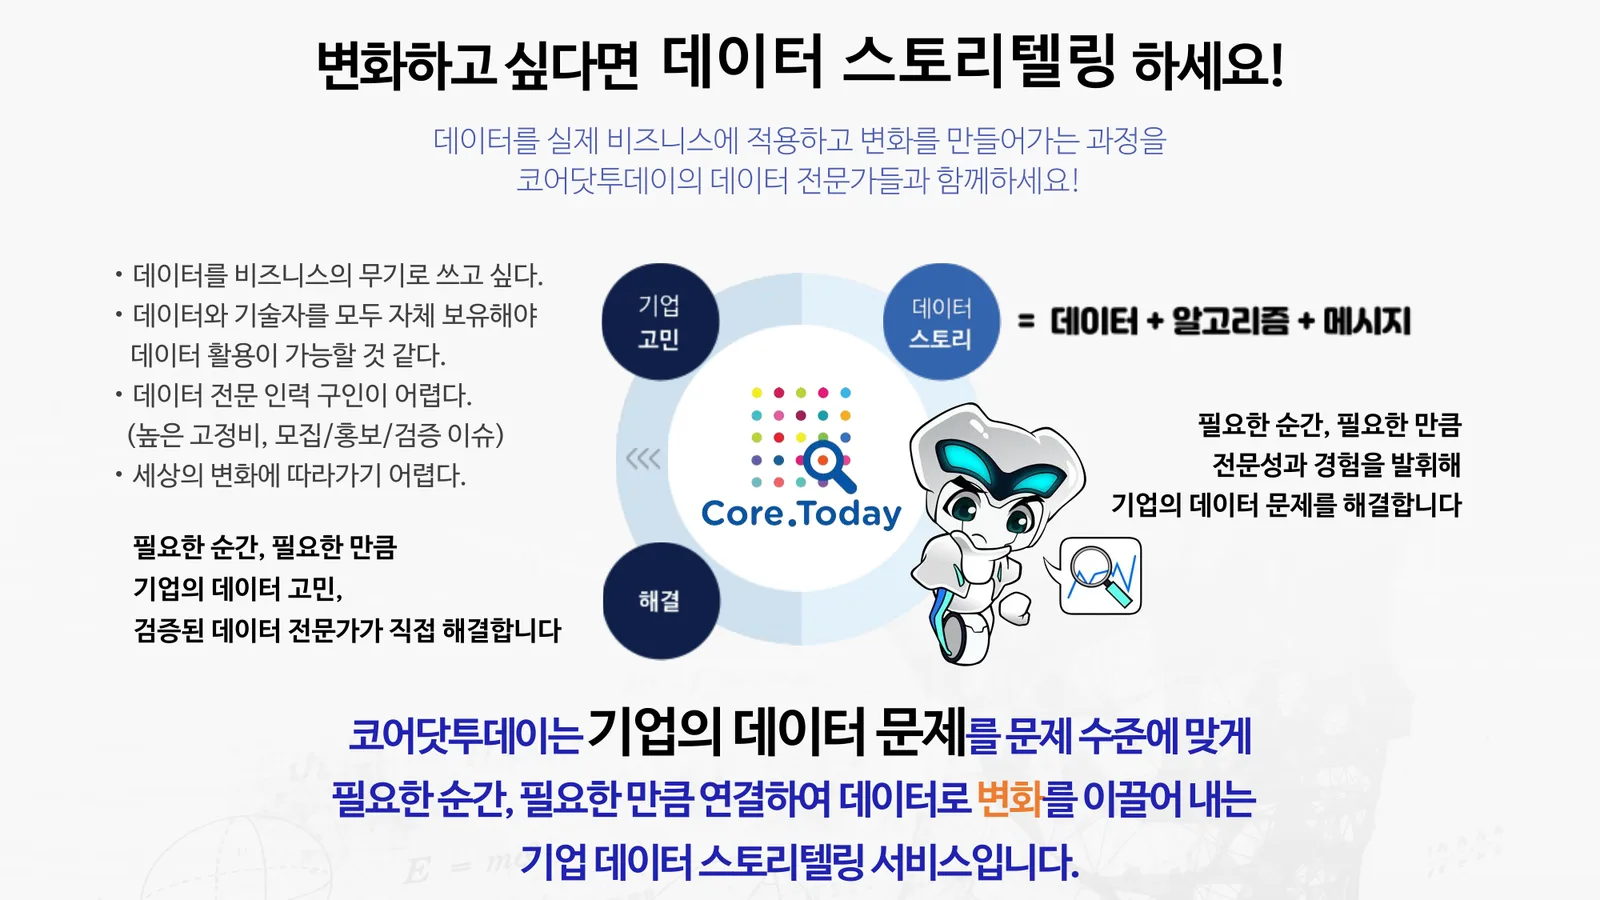
데이터 스토리 = 데이터 + 알고리즘 + 메시지
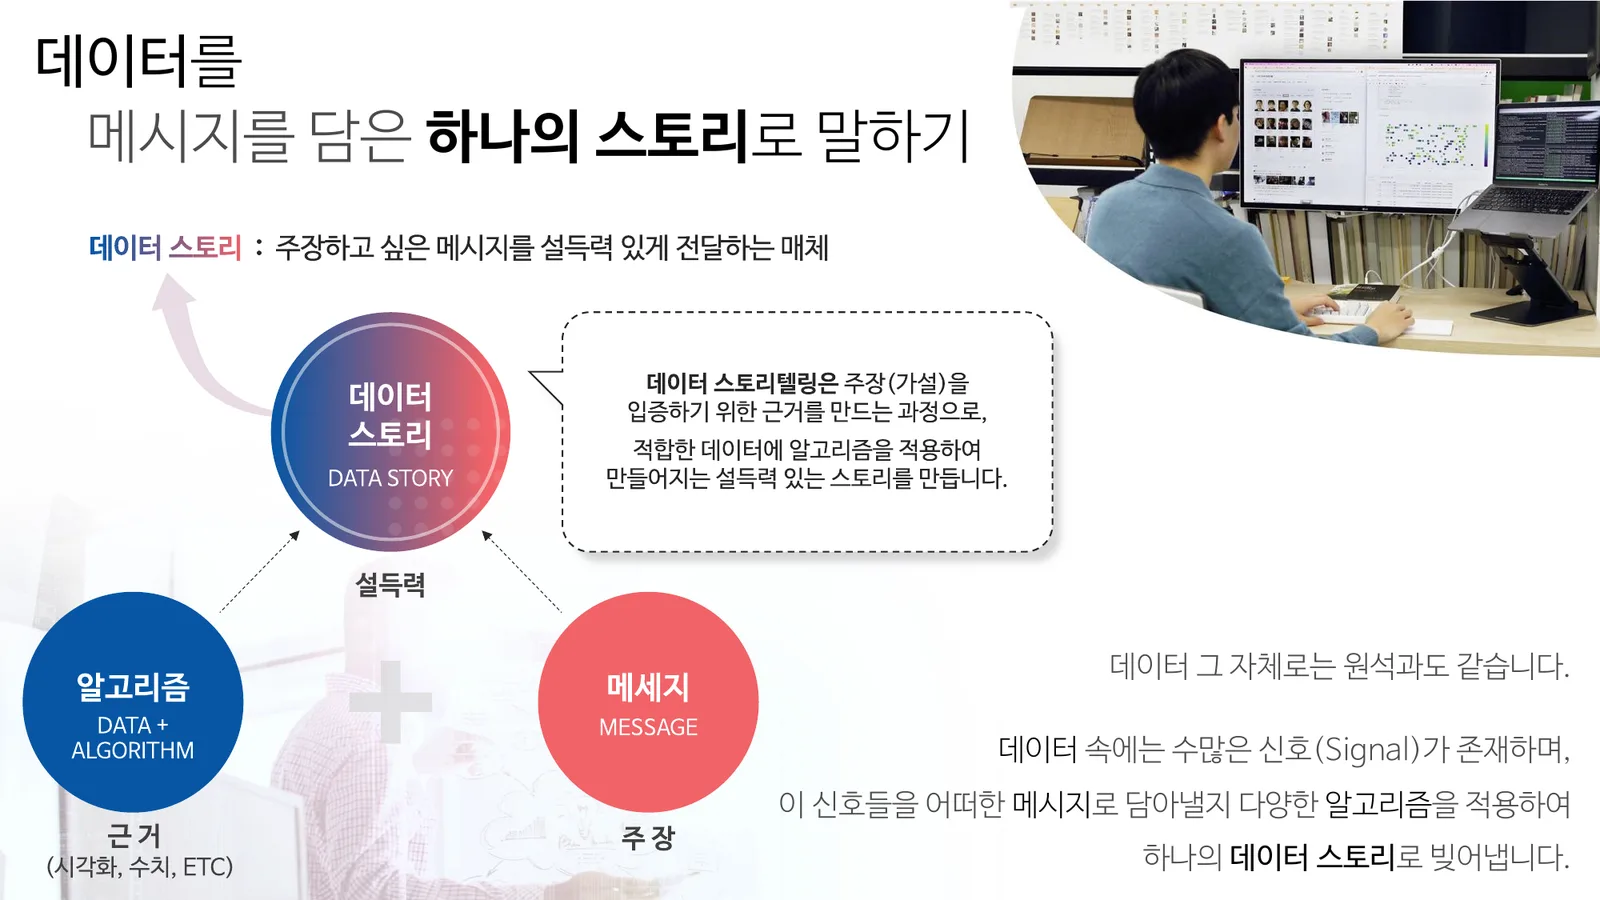
데이터 스토리는 주장하고 싶은 메시지를 설득력 있게 전달하는 매체입니다. 데이터 스토리텔링은 주장(가설)을 입증하기 위한 근거를 만드는 과정으로, 적합한 데이터에 알고리즘을 적용해 설득력 있는 스토리를 만듭니다.
| 구성 요소 | 역할 |
|---|---|
| 데이터 + 알고리즘 | 근거 — 시각화, 수치 등 |
| 메시지 | 주장 |
| 데이터 스토리 | 근거와 주장이 만나 생기는 설득력 |
데이터 그 자체로는 원석과도 같습니다. 데이터 속에는 수많은 신호(Signal)가 있고, 이 신호들을 어떤 메시지로 담아낼지 다양한 알고리즘을 적용해 하나의 데이터 스토리로 빚어냅니다.
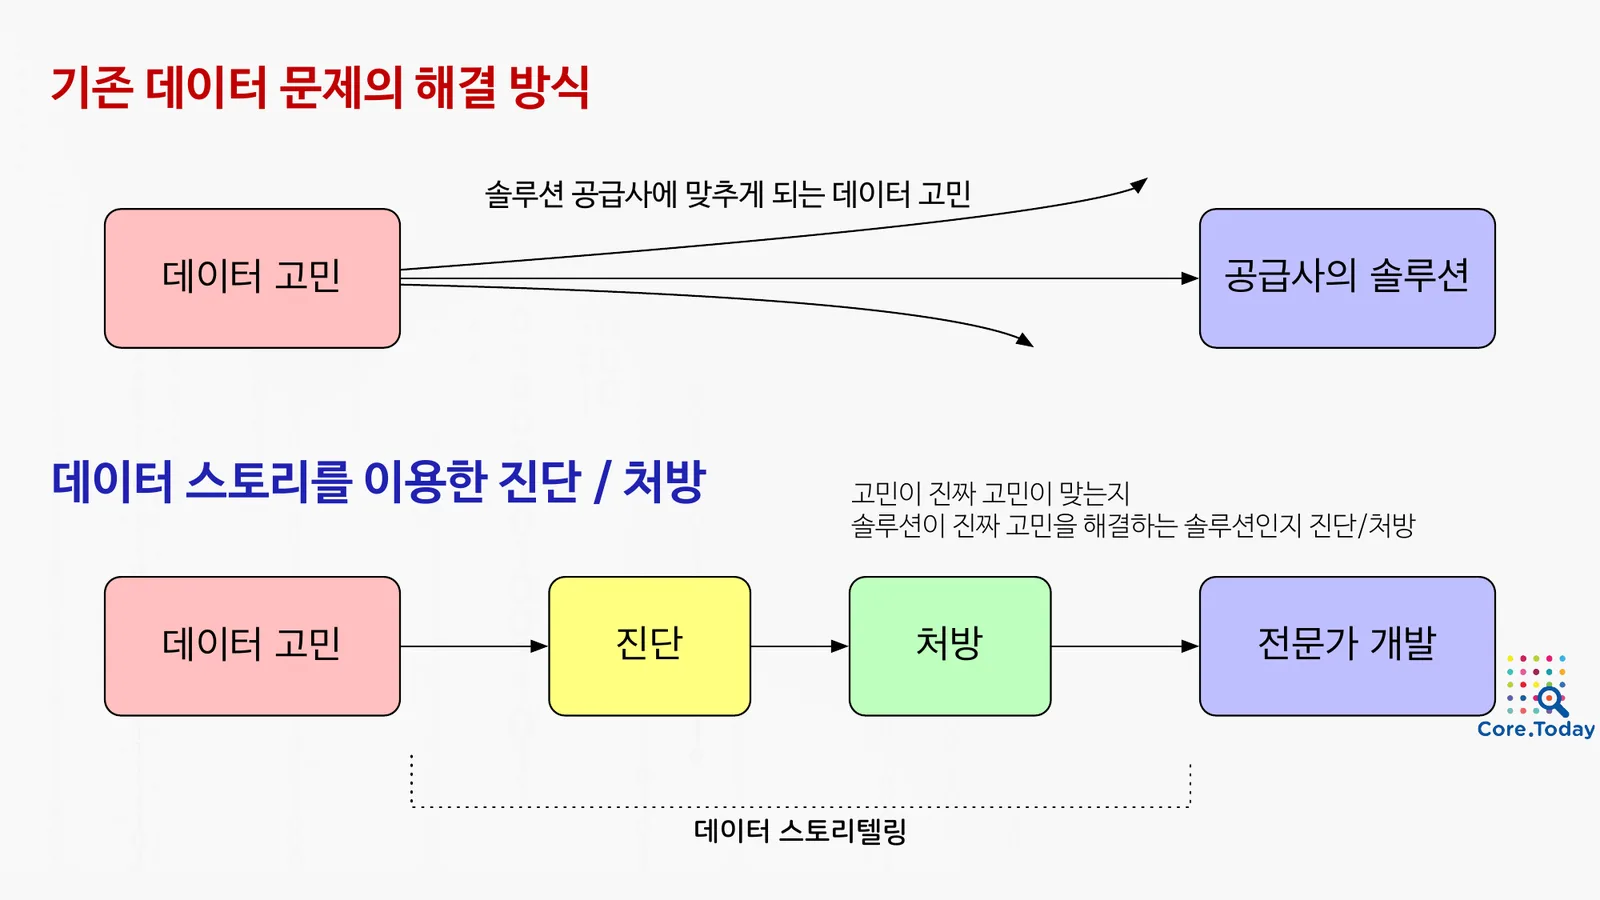
진짜 고민을 먼저 찾는다 — 진단과 처방
기존에는 데이터 고민이 생기면 솔루션 공급사의 제품에 고민을 맞추는 경우가 많았습니다. 코어닷투데이는 먼저 그 고민이 진짜 고민이 맞는지, 그 솔루션이 진짜 고민을 해결하는지 데이터 스토리로 진단하고 처방합니다. 진단과 처방을 거친 뒤에 전문가가 최적의 솔루션을 개발합니다.
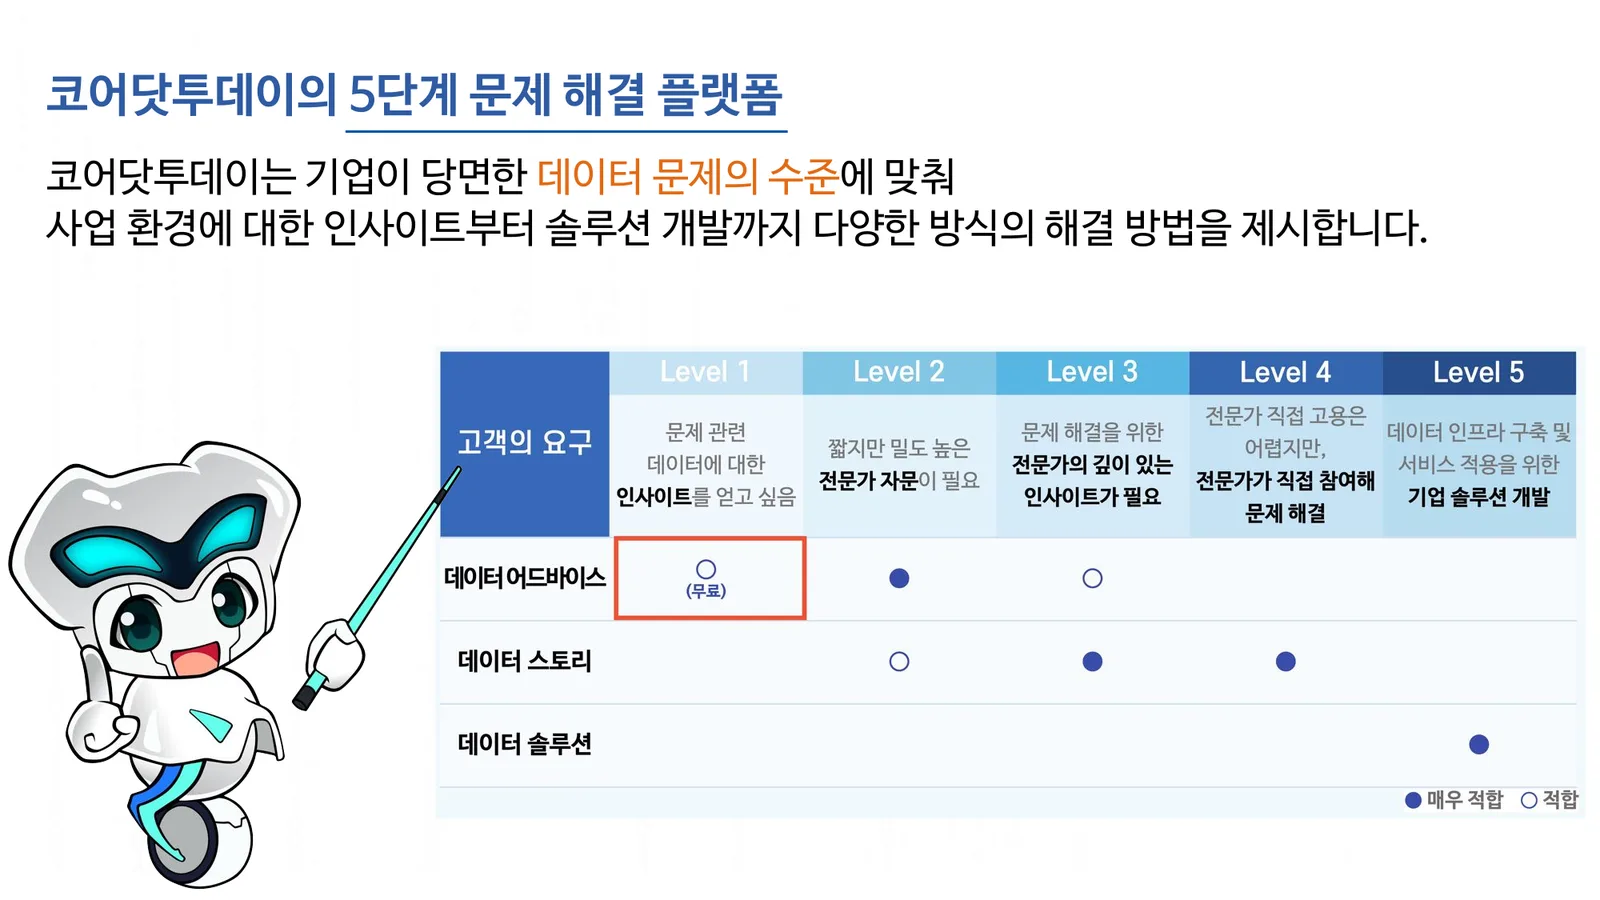
문제 수준에 맞춘 5단계 문제 해결
코어닷투데이는 기업이 당면한 데이터 문제의 수준에 맞춰, 사업 환경에 대한 인사이트부터 솔루션 개발까지 다양한 방식의 해결 방법을 제시합니다.
| 단계 | 고객의 요구 | 적합한 방식 |
|---|---|---|
| Level 1 | 문제 관련 데이터에 대한 인사이트를 얻고 싶음 | 데이터 어드바이스 (무료) |
| Level 2 | 짧지만 밀도 높은 전문가 자문이 필요 | 데이터 어드바이스 · 데이터 스토리 |
| Level 3 | 문제 해결을 위한 전문가의 깊이 있는 인사이트가 필요 | 데이터 스토리 |
| Level 4 | 전문가 직접 고용은 어렵지만, 전문가가 직접 참여해 문제 해결 | 데이터 스토리 |
| Level 5 | 데이터 인프라 구축 및 서비스 적용을 위한 기업 솔루션 개발 | 데이터 솔루션 |
비즈니스 모델 — 고객과 데이터 전문가 그룹을 잇다
- 기업의 데이터 고민을 의뢰 — 데이터 어드바이스는 누구나 무료입니다.
- 문제 수준에 맞는 데이터 문제 진단 — 최적의 전문가 그룹이 데이터 스토리로 처방합니다.
- 데이터 문제를 작은 단위로 쪼개어 — 지속적인 데이터 스토리로 문제를 해결합니다.
데이터 워크스페이스에서는 기획(데이터 기획), 데이터 파이프라인(수집·정제·통합·분석), 해석(데이터 해석)의 각 단계마다 데이터 스토리가 쌓이고, 전문가들은 기여한 만큼 리워드를 받습니다. 기업과 데이터 전문가 그룹을 프로젝트 단위의 유연한 방식으로 연결해 데이터 문화 생태계를 만드는 구조입니다.
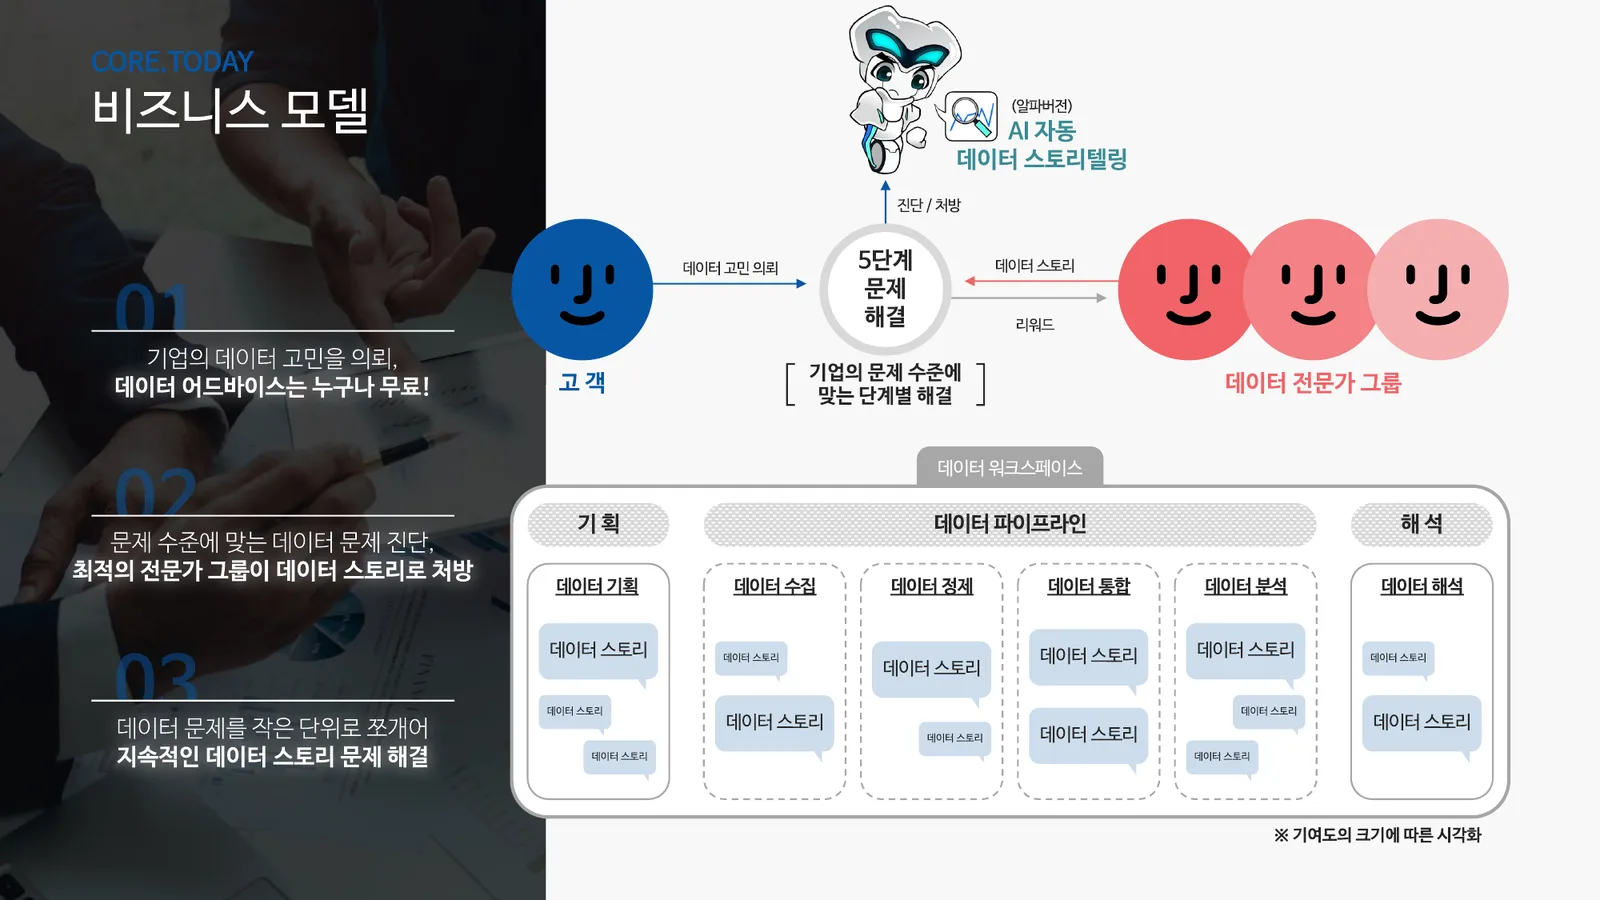
전문가 그룹은 코어닷투데이의 데이터 엔지니어·데이터 디렉터와, 데이터바우처 공급기업으로 구성된 데이터 가공 그룹의 데이터 엔지니어·데이터 사이언티스트입니다.
데이터 스토리텔링 사례
| 사례 | 수준 | 고민 · 메시지 | 데이터 · 알고리즘 |
|---|---|---|---|
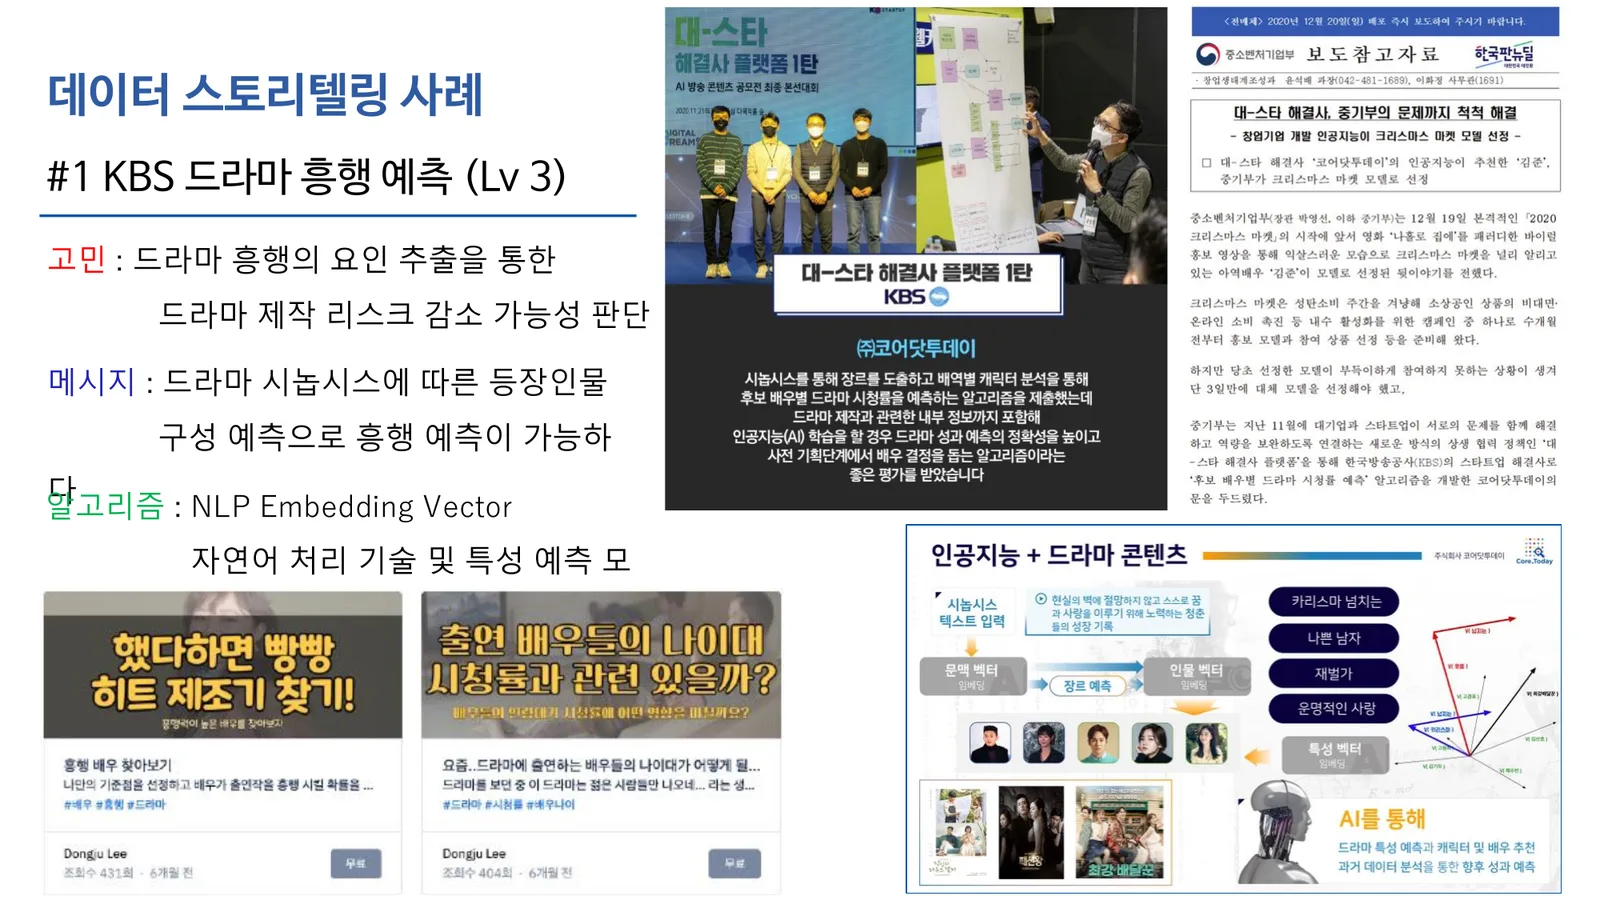
| KBS 드라마 흥행 예측 | Lv 3 | 드라마 흥행 요인을 추출해 제작 리스크를 줄일 수 있는가 → 시놉시스에 따른 등장인물 구성 예측으로 흥행 예측이 가능하다 | NLP 임베딩 벡터, 자연어 처리와 특성 예측 모델 |
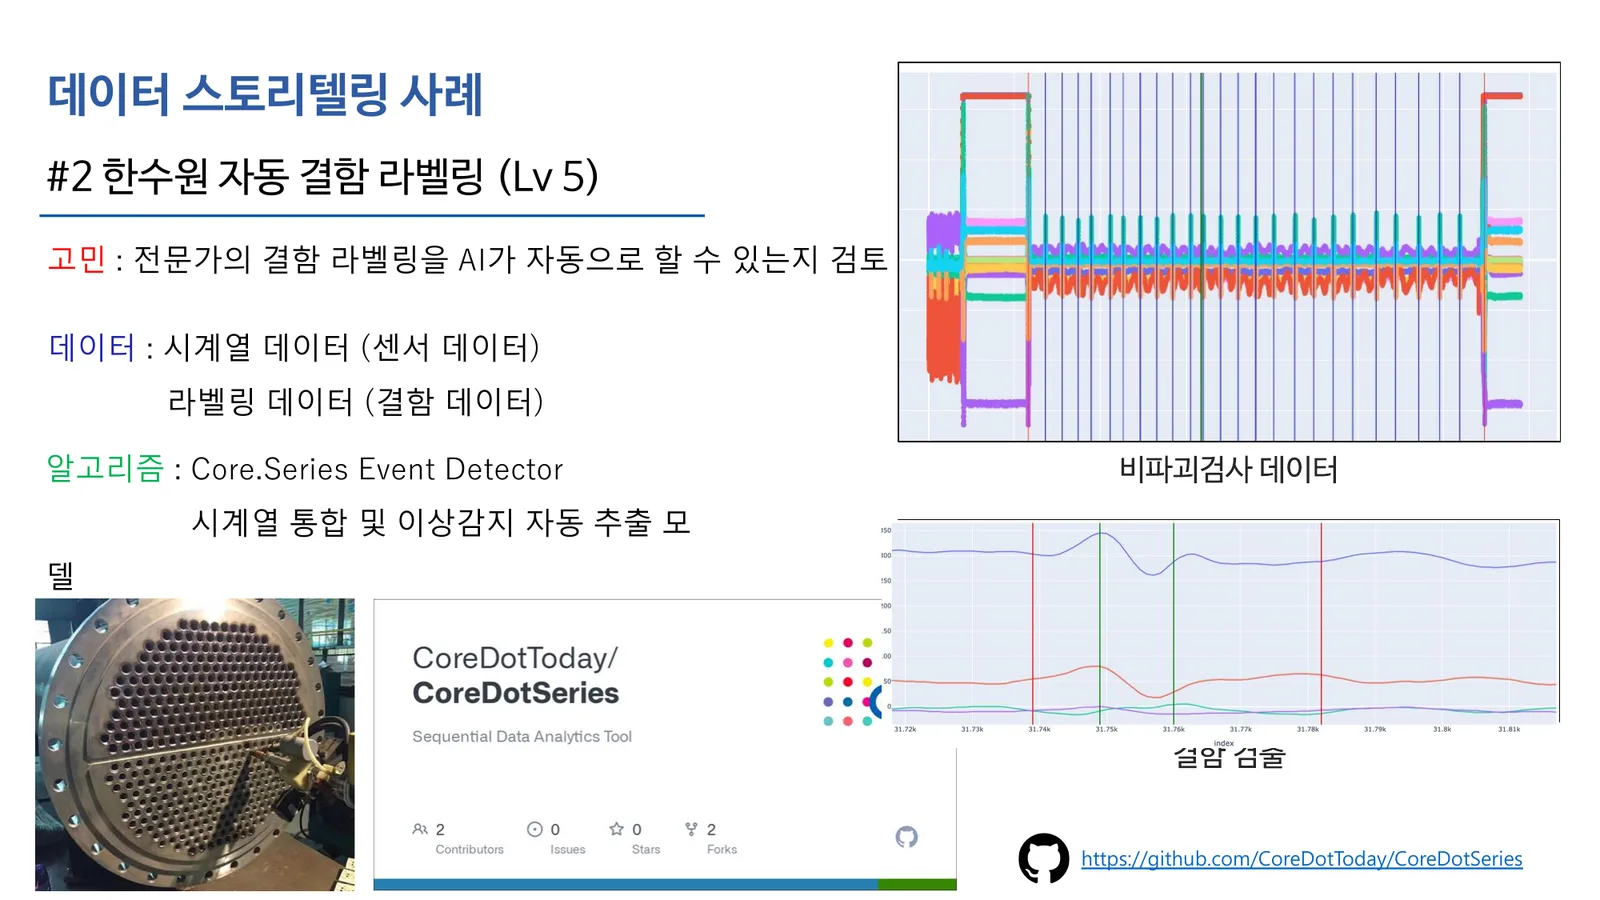
| 한수원 자동 결함 라벨링 | Lv 5 | 전문가의 결함 라벨링을 AI가 자동으로 할 수 있는가 | 센서 시계열 + 결함 라벨링 데이터, Core.Series Event Detector(시계열 통합·이상감지 자동 추출) |
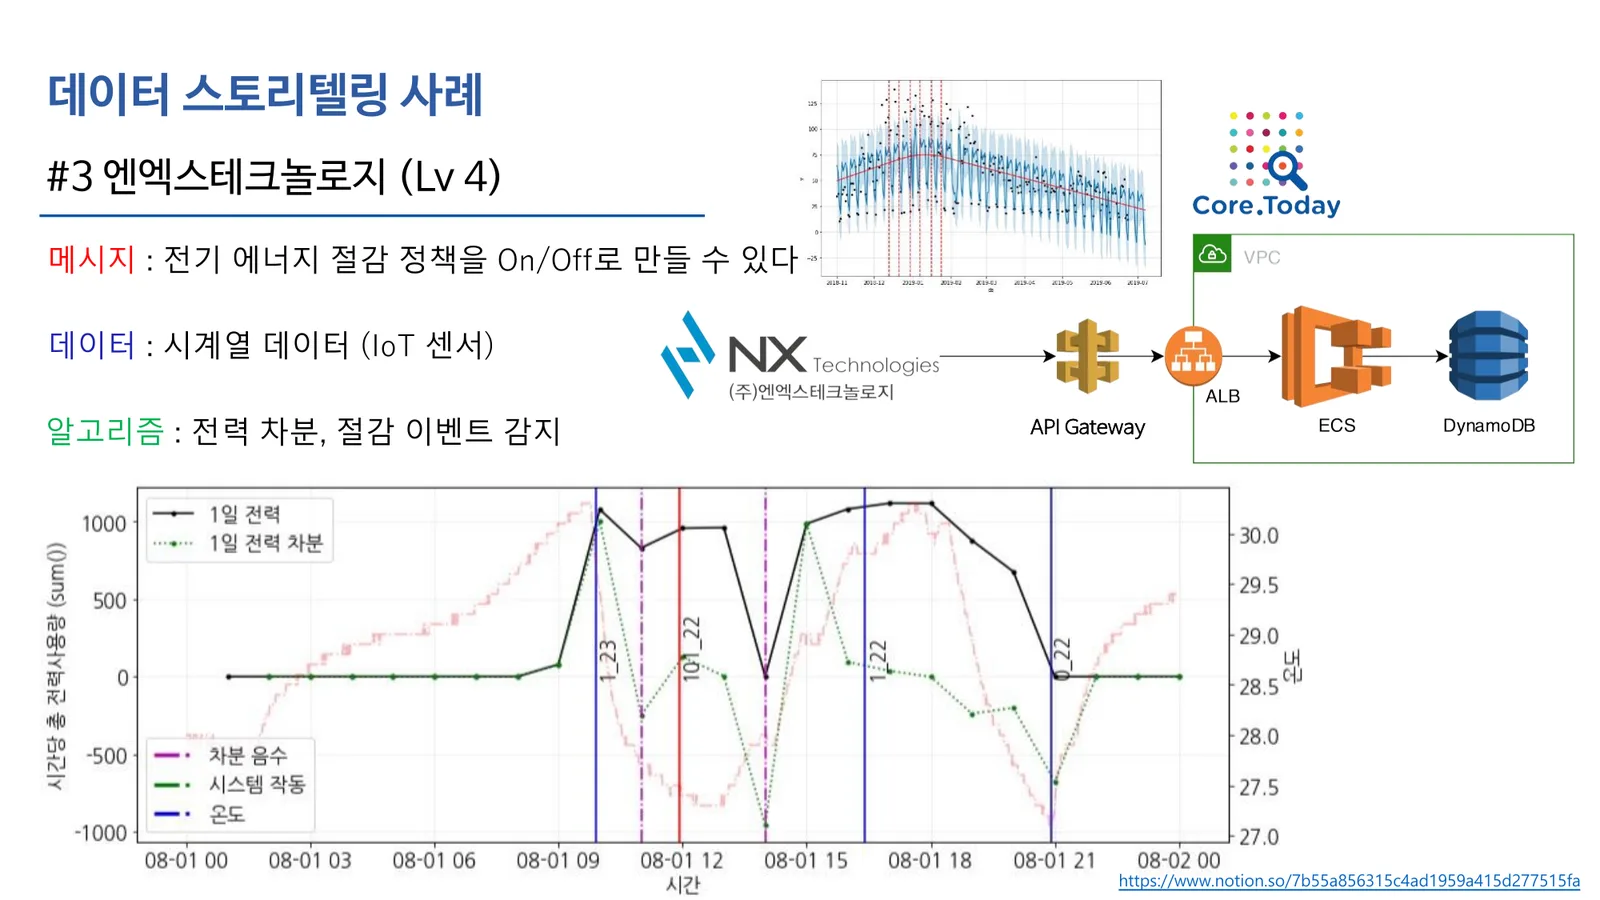
| 엔엑스테크놀로지 | Lv 4 | 전기 에너지 절감 정책을 On/Off로 만들 수 있다 | IoT 센서 시계열, 전력 차분·절감 이벤트 감지(API Gateway·ECS·DynamoDB) |
| AI + Tech 아티스트 콜라보 | Lv 4 | 지구인과 외계인이 소통하는 AI 외교관 | 자연어 데이터, BlenderBot 9B(36 layer) |
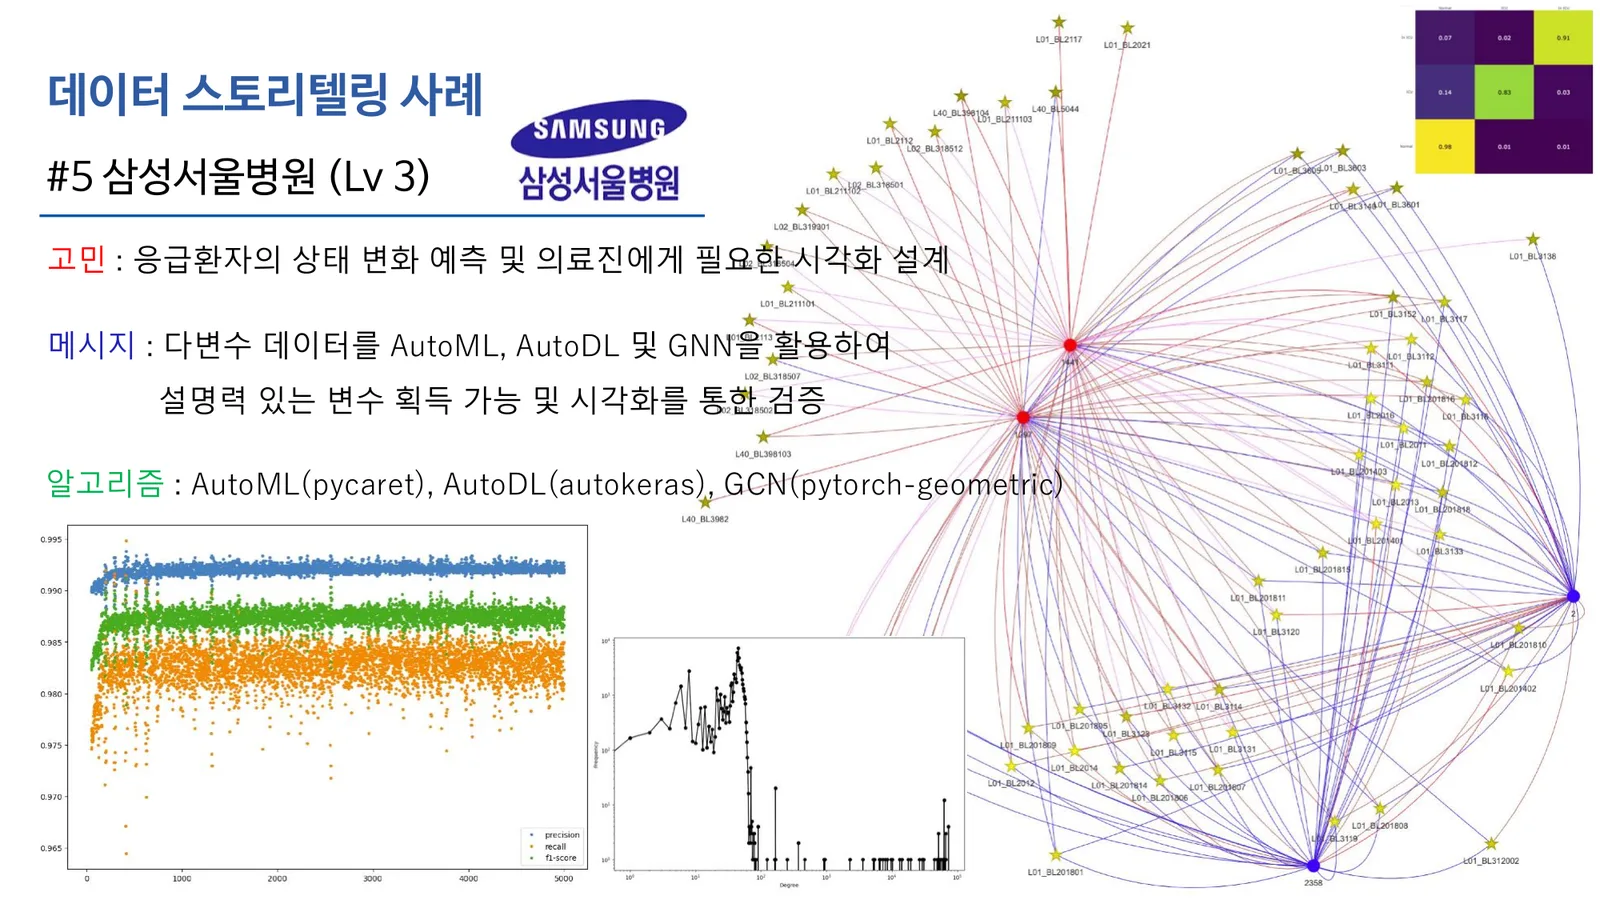
| 삼성서울병원 | Lv 3 | 응급환자의 상태 변화 예측과 의료진에게 필요한 시각화 설계 → 다변수 데이터로 설명력 있는 변수를 얻고 시각화로 검증 | AutoML(pycaret), AutoDL(autokeras), GCN(pytorch-geometric) |
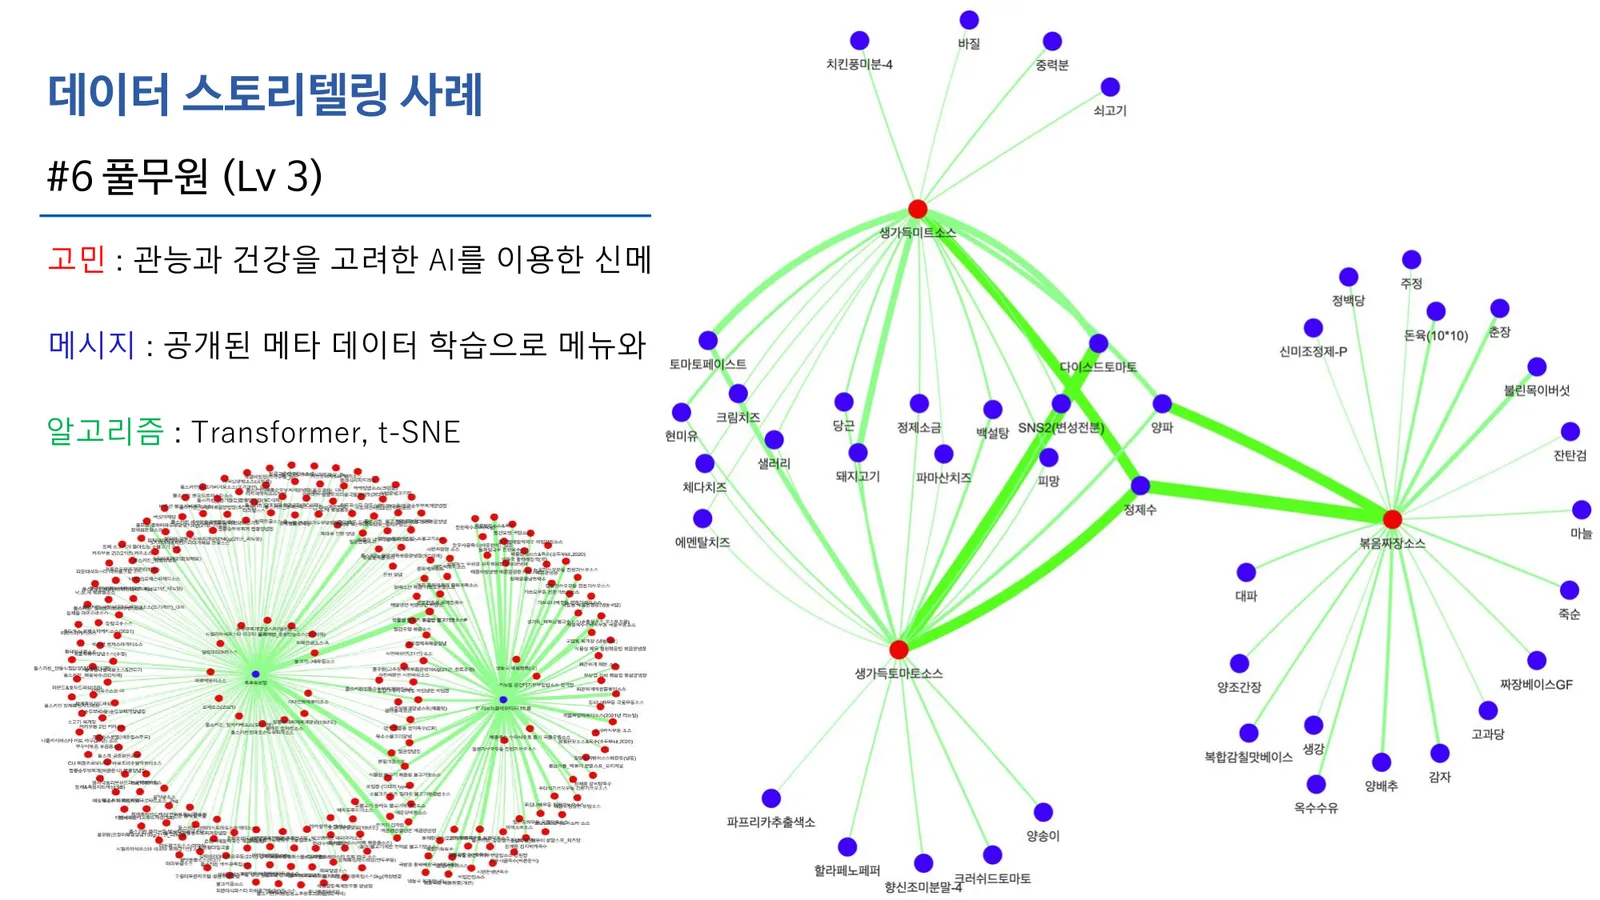
| 풀무원 | Lv 3 | 관능과 건강을 고려한 AI 신메뉴 개발 → 공개 메타데이터 학습으로 메뉴와 성분을 올바르게 임베딩할 수 있다 | Transformer, t-SNE |
KBS 드라마 흥행 예측
시놉시스 텍스트를 입력하면 문맥 벡터에서 장르를 예측하고, 인물 벡터와 특성 벡터로 '카리스마 넘치는', '나쁜 남자', '재벌가', '운명적인 사랑' 같은 캐릭터 특성을 뽑아 어울리는 배우를 추천한 뒤, 과거 데이터 분석으로 향후 성과를 예측합니다. 자세한 내용은 KBS 드라마 시청률 예측 과제에서 볼 수 있습니다.
한수원 자동 결함 라벨링
비파괴검사 센서의 시계열 데이터와 전문가가 남긴 결함 라벨을 함께 학습해, 결함 신호를 자동으로 찾아 라벨링합니다. 시계열 분석 도구는 오픈소스 CoreDotSeries로 공개했습니다.
엔엑스테크놀로지 — 전력 절감
IoT 센서로 모은 전력 사용량의 차분에서 절감 이벤트를 감지해, 전기 에너지 절감 정책을 On/Off로 만들 수 있음을 보였습니다. 분석 결과는 AWS API Gateway·ECS·DynamoDB 구성으로 연결했습니다.
삼성서울병원 · 풀무원
삼성서울병원 사례에서는 응급환자의 다변수 데이터에 AutoML·AutoDL·그래프 신경망을 적용해 설명력 있는 변수를 찾고 시각화로 검증했습니다. 풀무원 사례에서는 공개 메타데이터로 메뉴와 성분을 임베딩해 AI 신메뉴 개발의 가능성을 확인했고, 이는 2022 대-스타 해결사 플랫폼 풀무원 과제 선정으로 이어졌습니다.
AI가 보조하는 자동 데이터 스토리텔링
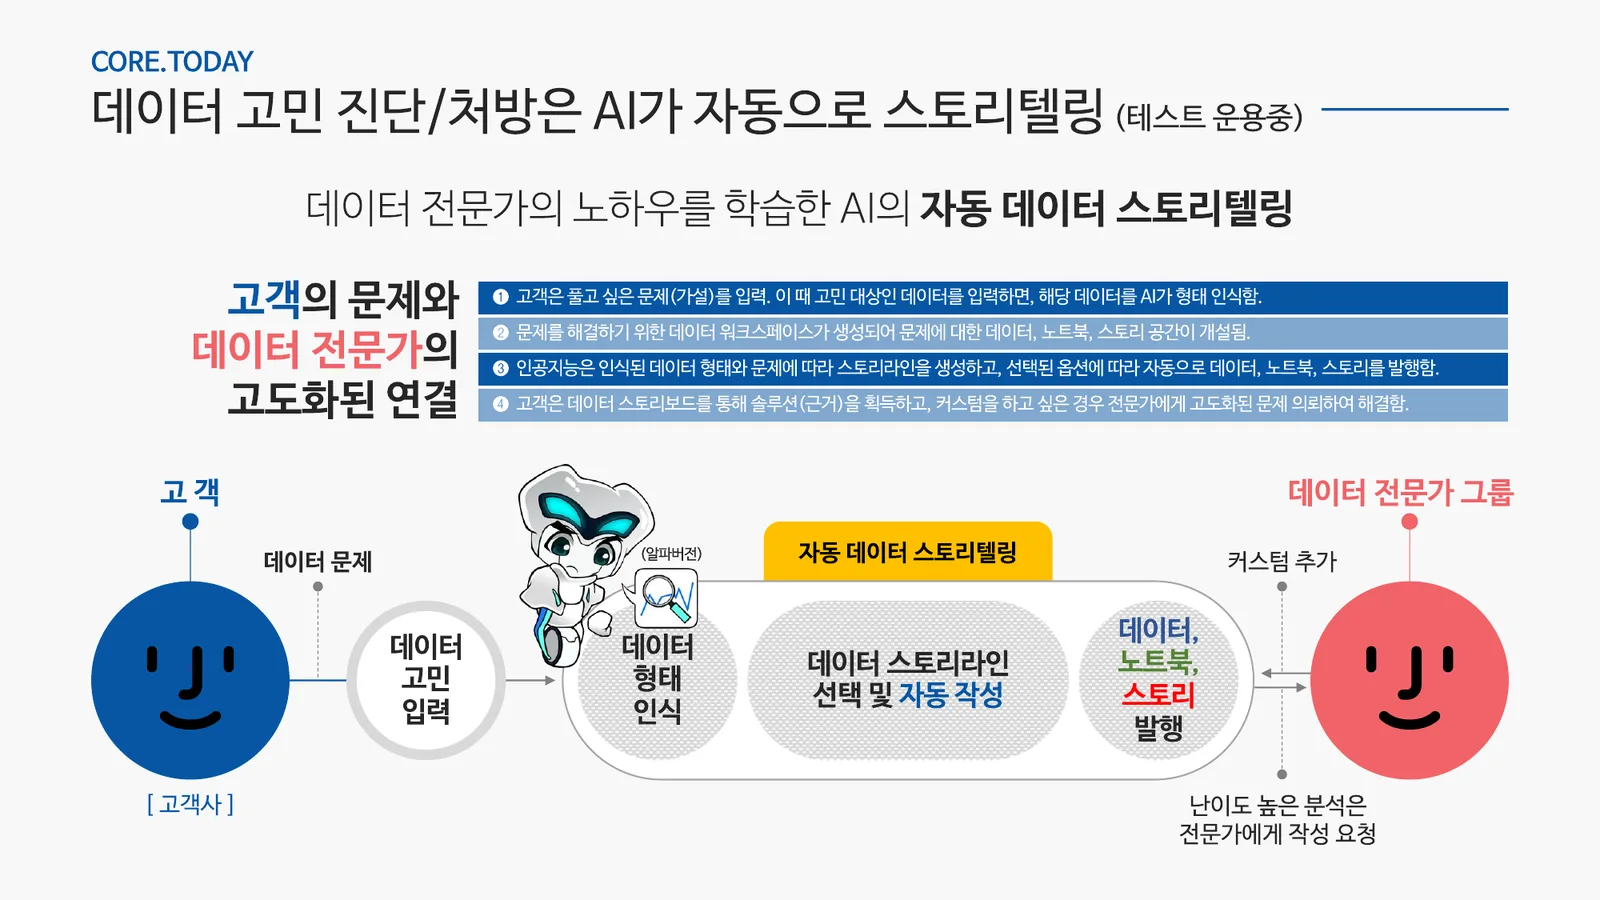
코어닷투데이는 데이터 전문가의 노하우를 학습한 AI가 데이터 고민을 자동으로 진단·처방하는 자동 데이터 스토리텔링을 알파버전으로 시험 운용했습니다.
- 고객이 풀고 싶은 문제(가설)와 데이터를 입력하면, AI가 데이터의 형태를 인식합니다.
- 문제를 풀기 위한 데이터 워크스페이스가 만들어지고, 데이터·노트북·스토리 공간이 열립니다.
- AI가 데이터 형태와 문제에 맞는 스토리라인을 만들고, 선택한 옵션에 따라 데이터·노트북·스토리를 자동으로 발행합니다.
- 고객은 데이터 스토리보드에서 근거를 얻고, 더 깊은 분석이 필요하면 전문가에게 고도화된 문제를 의뢰합니다.
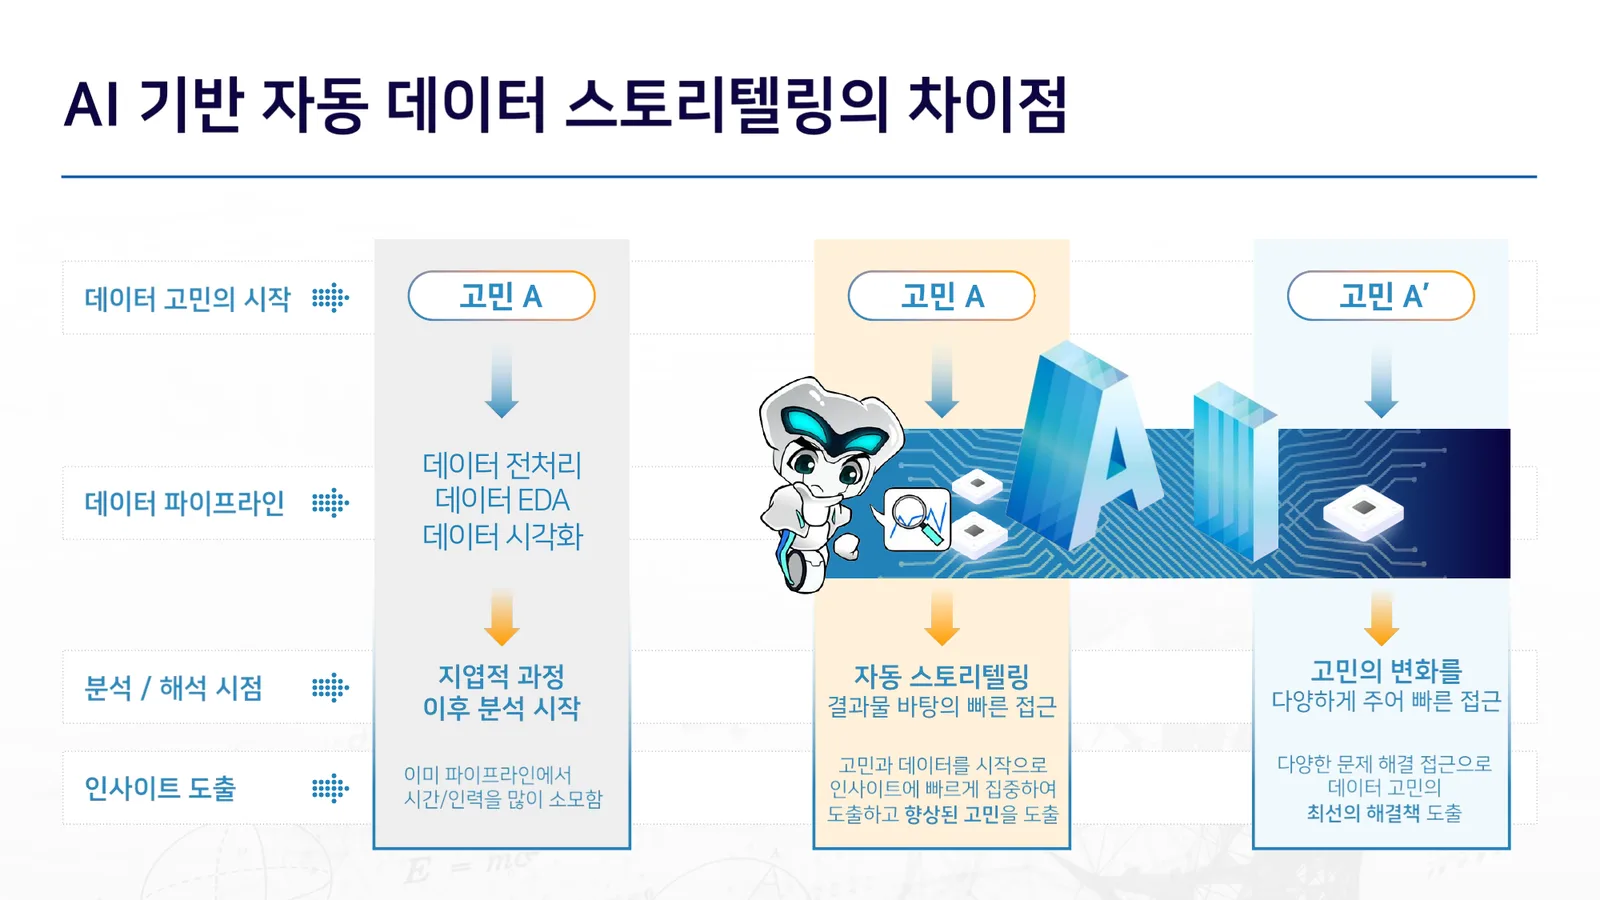
기존 방식은 데이터 전처리·EDA·시각화라는 지엽적인 과정을 거친 뒤에야 분석이 시작돼, 파이프라인에서 시간과 인력을 많이 썼습니다. 자동 데이터 스토리텔링은 고민과 데이터에서 곧바로 출발해 결과물을 바탕으로 빠르게 인사이트에 집중하고, 고민 자체를 다양하게 바꿔 보며 최선의 해결책을 찾게 합니다.
공공 데이터 스토리 사례
플랫폼에는 공공 데이터로 만든 데이터 스토리가 쌓였습니다.
| 데이터 스토리 | 질문 | 데이터 | 알고리즘 | 메시지 |
|---|---|---|---|---|
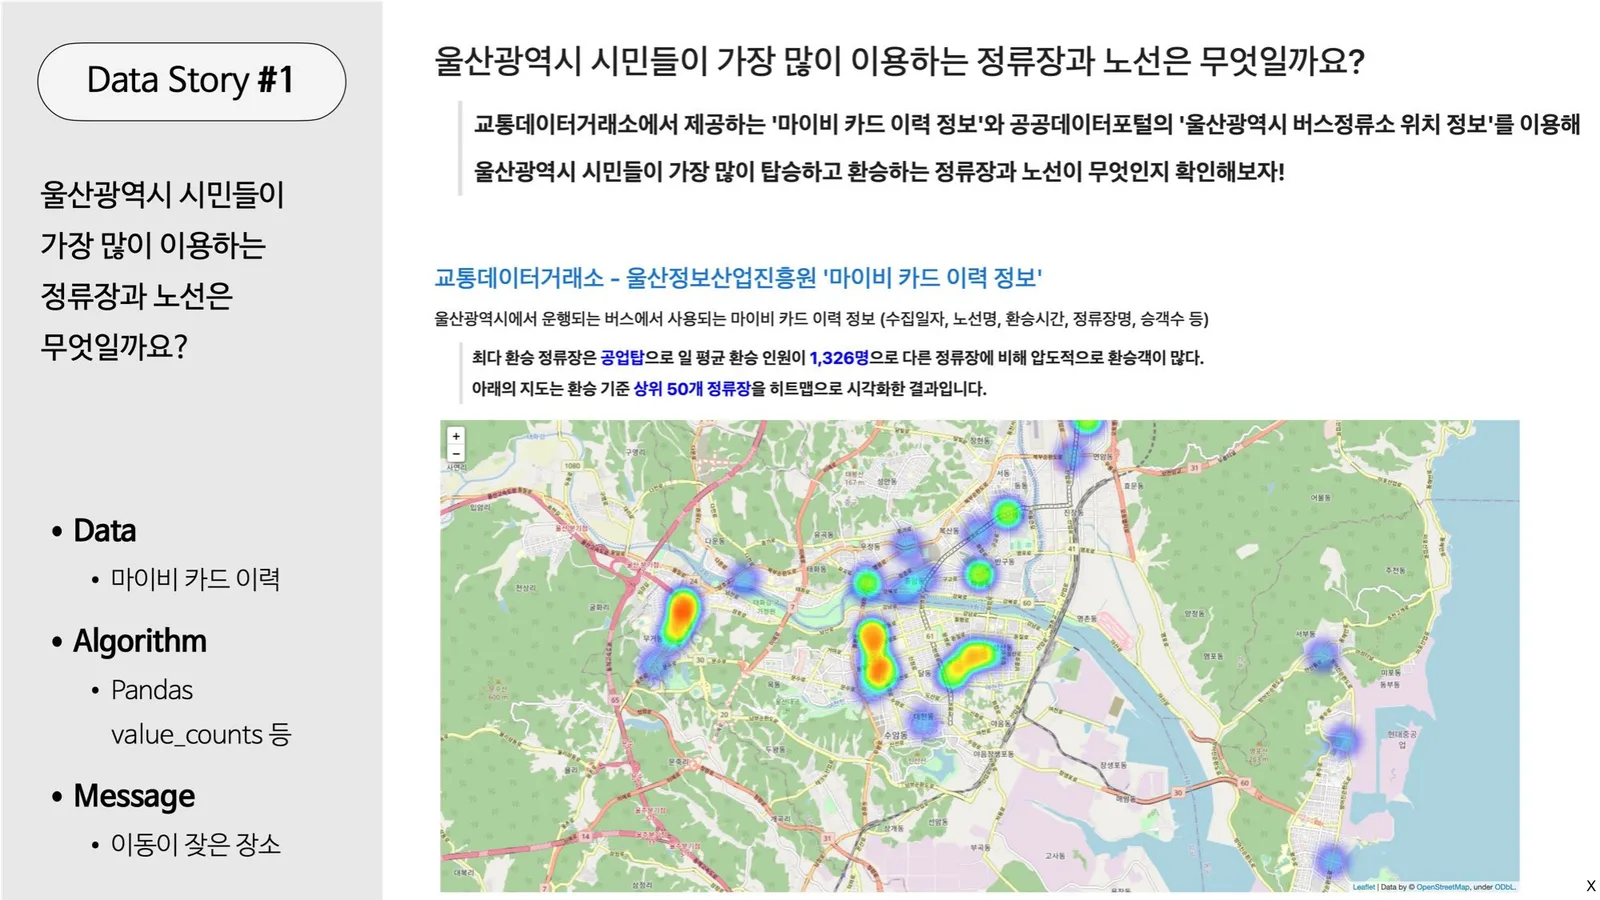
| #1 | 울산 시민들이 가장 많이 이용하는 정류장과 노선은? | 교통데이터거래소 '마이비 카드 이력 정보', 공공데이터포털 '울산광역시 버스정류소 위치 정보' | Pandas value_counts 등 | 최다 환승 정류장은 공업탑(일 평균 환승 1,326명) — 상위 50개 정류장 히트맵 |
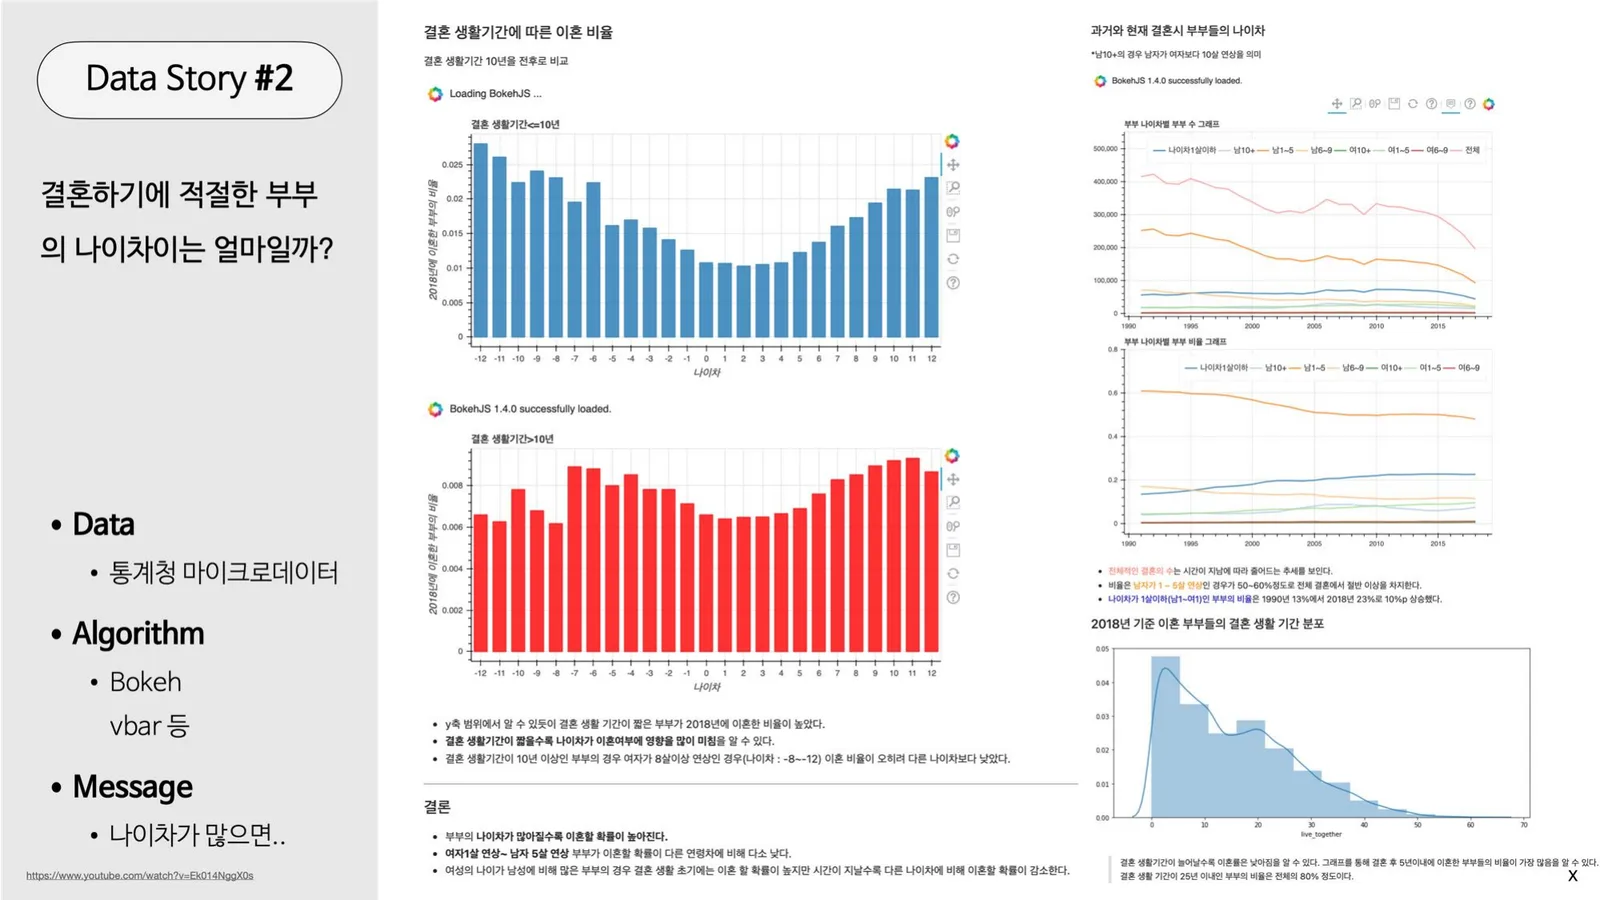
| #2 | 결혼하기에 적절한 부부의 나이 차이는? | 통계청 마이크로데이터 | Bokeh vbar 등 | 나이 차가 많을수록 이혼 확률이 높아진다 |
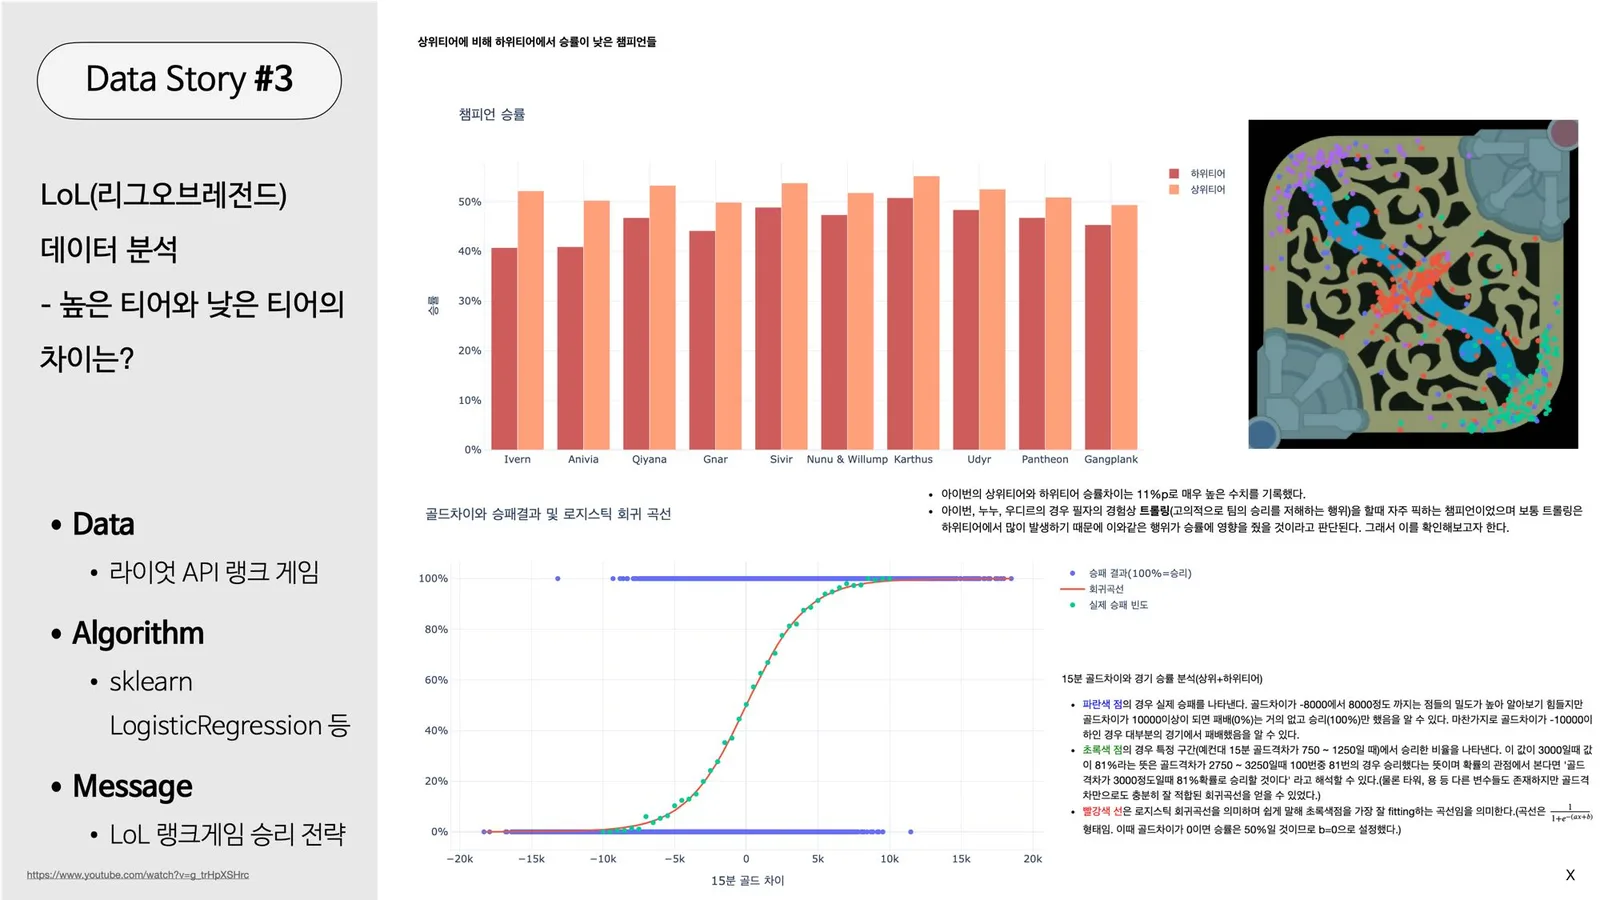
| #3 | 리그 오브 레전드, 높은 티어와 낮은 티어의 차이는? | 라이엇 API 랭크 게임 | sklearn 로지스틱 회귀 등 | 15분 골드 차이와 승률 — 랭크 게임 승리 전략 |
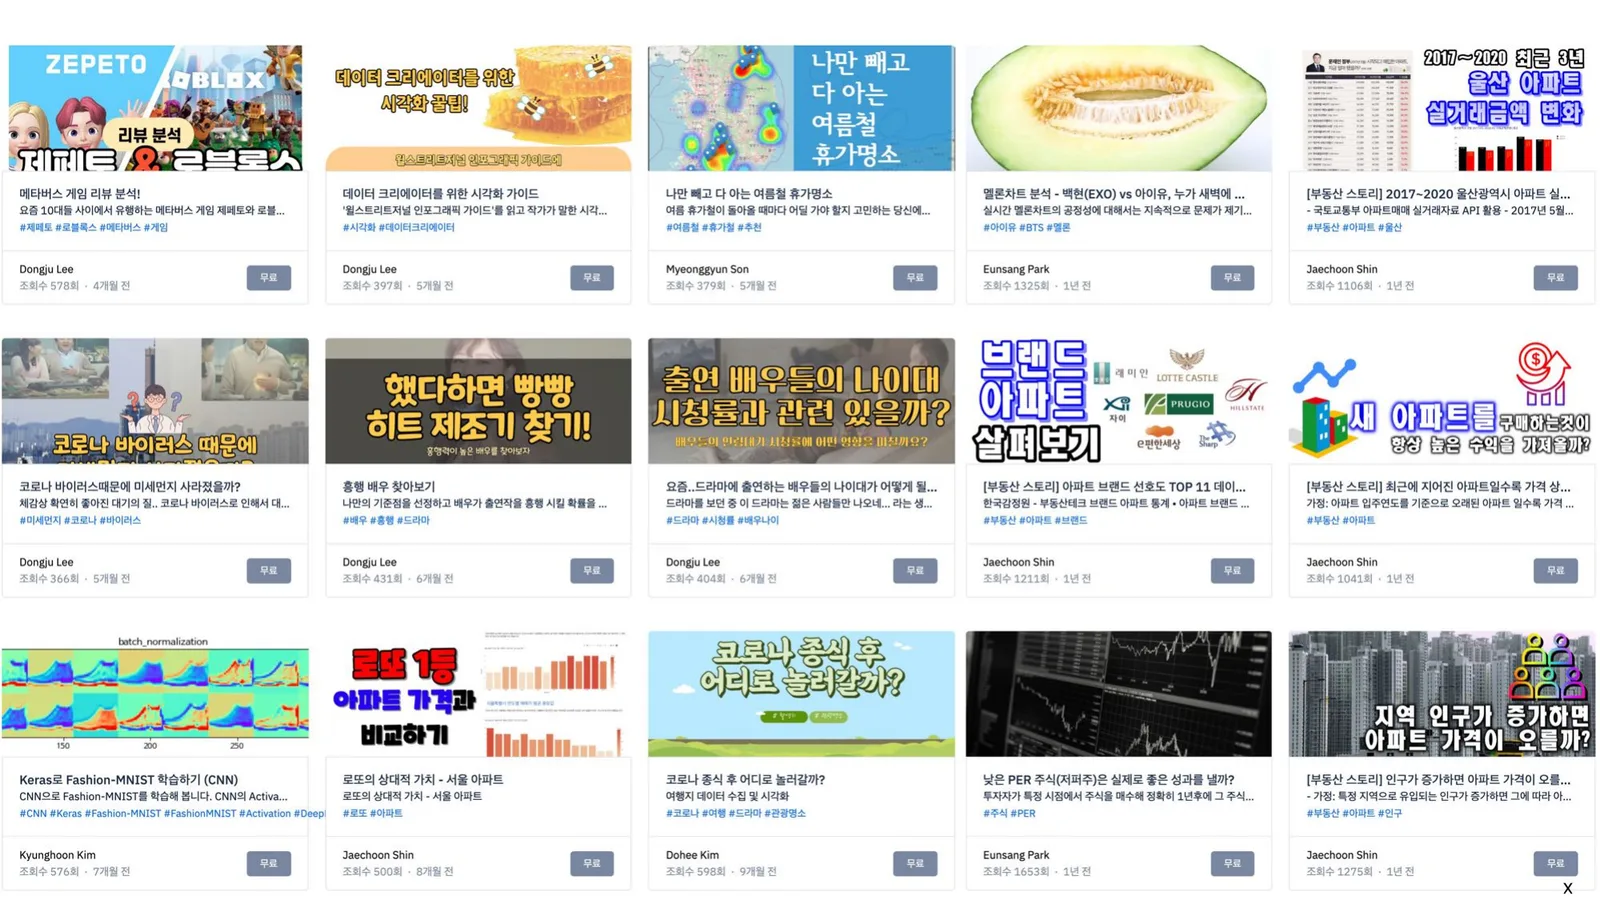
메타버스 게임 리뷰 분석, 여름철 휴가 명소, 멜론 차트 분석, 울산 아파트 실거래가, 코로나19와 미세먼지, 흥행 배우 찾기, 로또 1등과 서울 아파트 가격, 저PER 주식의 성과 등 일상의 질문이 데이터 스토리가 됐습니다.
당신도 데이터 크리에이터가 될 수 있습니다
데이터 크리에이터는 데이터 스토리를 만드는 사람입니다. 유튜브 크리에이터처럼 각자의 기술과 지식, 아이디어로 구독자가 즐길 수 있는 콘텐츠를 만듭니다. 코어닷투데이는 데이터 크리에이터가 데이터 스토리를 만들고 공유하는 플랫폼을 운영하며, 데이터 크리에이터를 기르고 있습니다.
데이터 크리에이터 양성
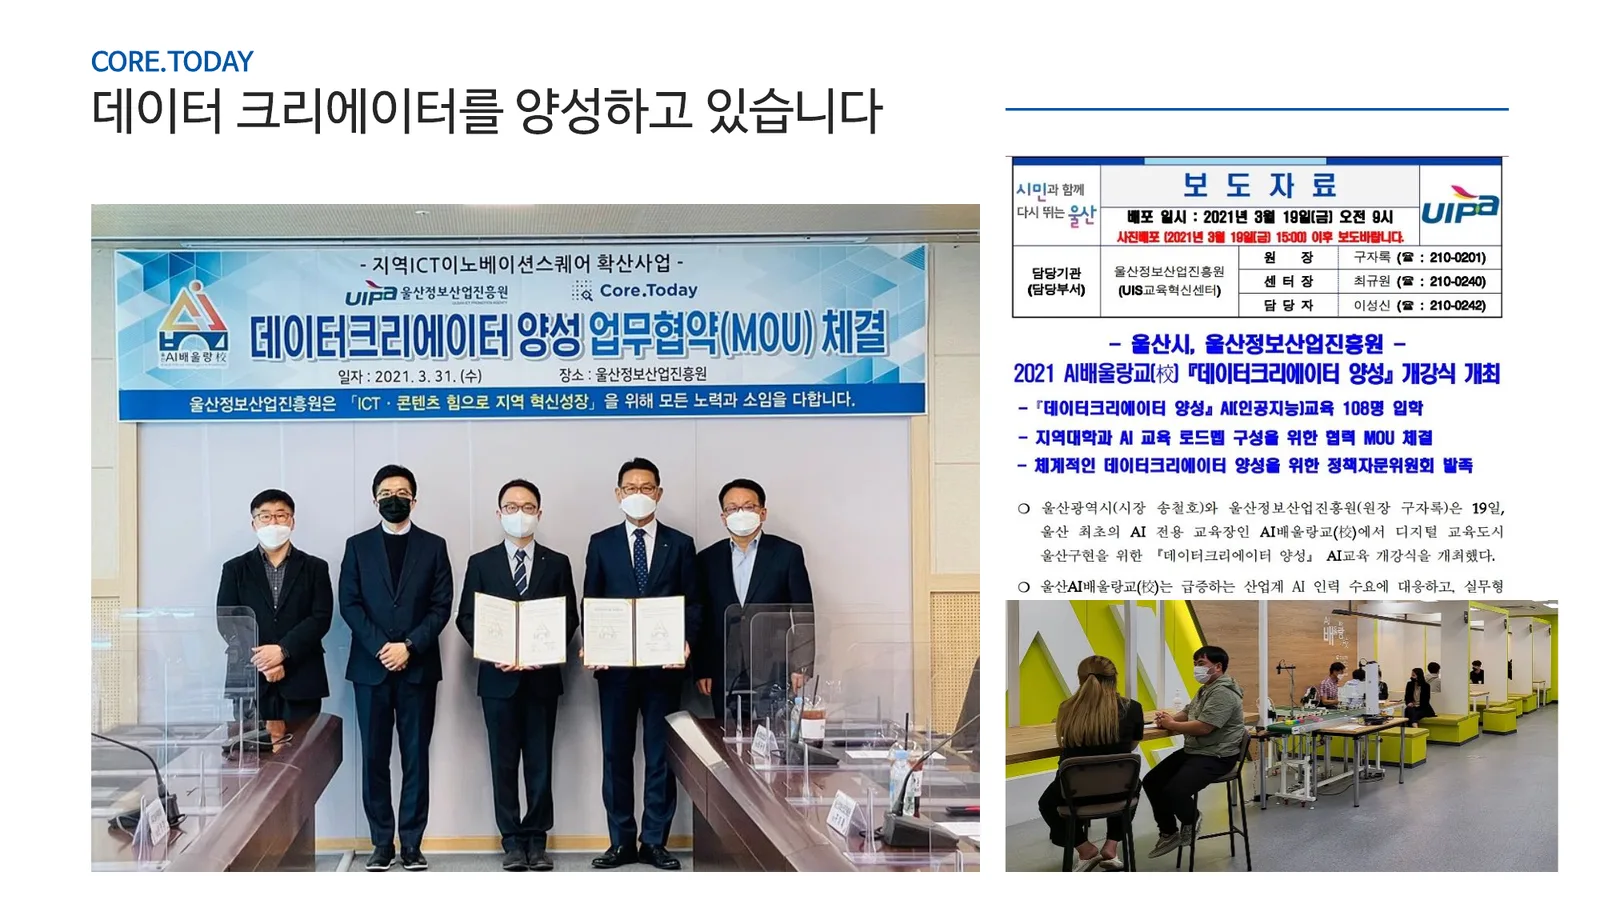
2021년 3월 울산정보산업진흥원과 데이터크리에이터 양성 업무협약을 맺었습니다. 같은 달 울산시와 울산정보산업진흥원은 울산 최초의 AI 전용 교육장 AI배울랑교에서 '데이터크리에이터 양성' AI 교육 개강식을 열었고, 108명이 입학했습니다.
데이터 엔지니어 — 도구로 메시지 완성을 돕는다
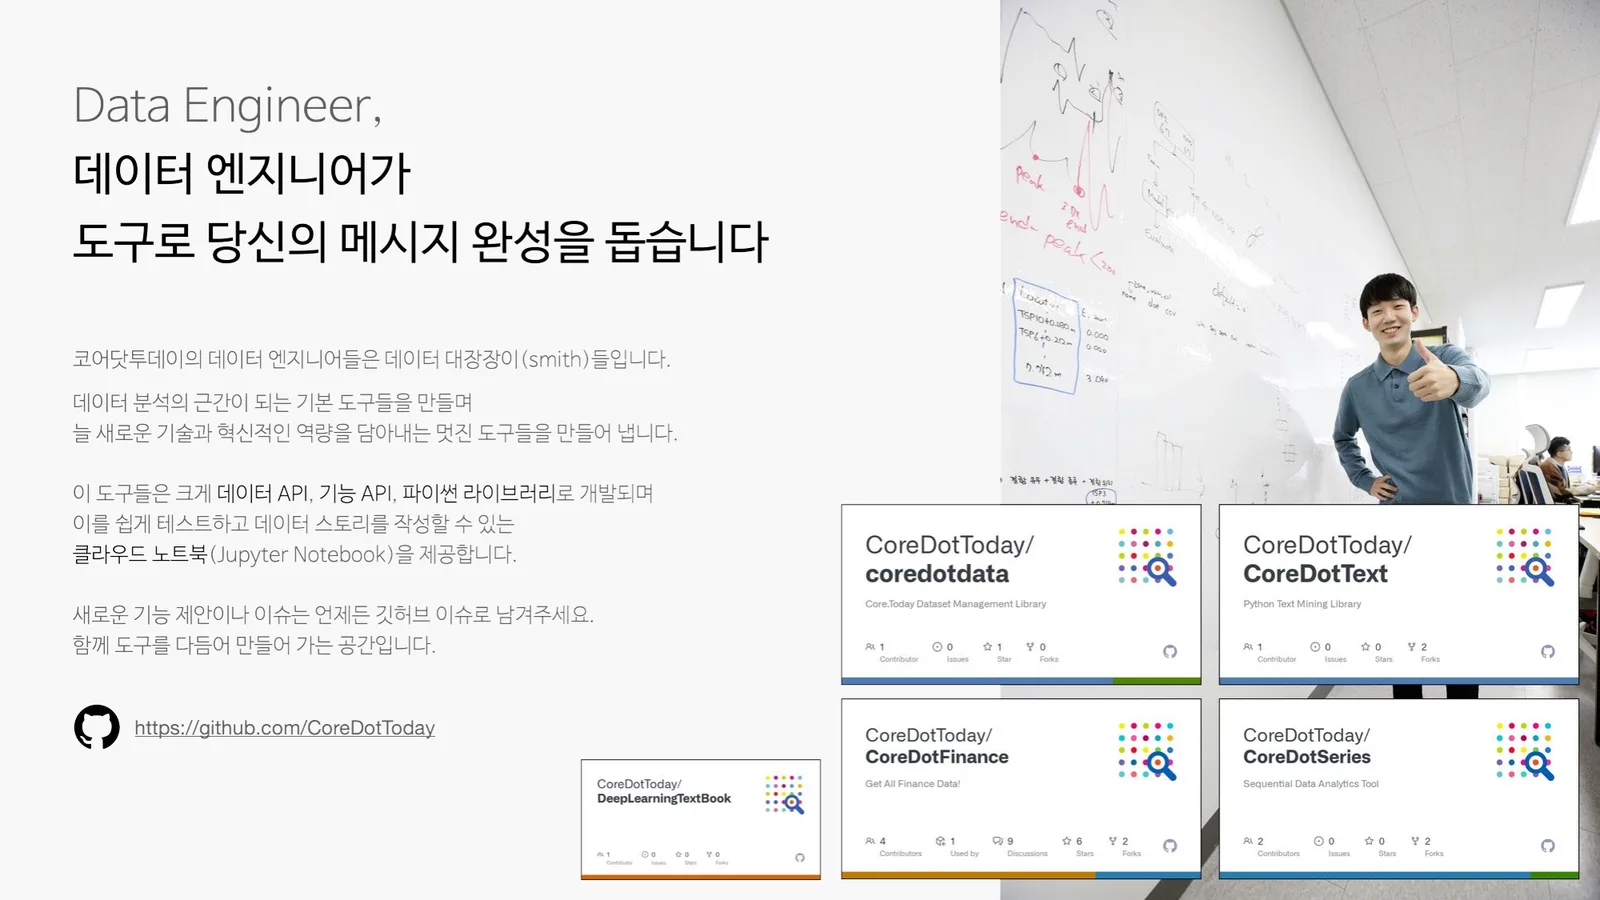
코어닷투데이의 데이터 엔지니어들은 데이터 대장장이(smith)입니다. 데이터 분석의 근간이 되는 기본 도구를 만들고, 새로운 기술과 역량을 담은 도구를 만들어 냅니다. 이 도구들은 데이터 API, 기능 API, 파이썬 라이브러리로 개발되며, 이를 쉽게 테스트하고 데이터 스토리를 작성할 수 있는 클라우드 노트북(Jupyter Notebook)을 제공합니다. github.com/CoreDotToday에 coredotdata(데이터셋 관리), CoreDotText(텍스트 마이닝), CoreDotFinance(금융 데이터), CoreDotSeries(시계열 분석), DeepLearningTextBook을 공개했습니다.
리드 데이터 크리에이터 — 교육으로 메시지 완성을 돕는다
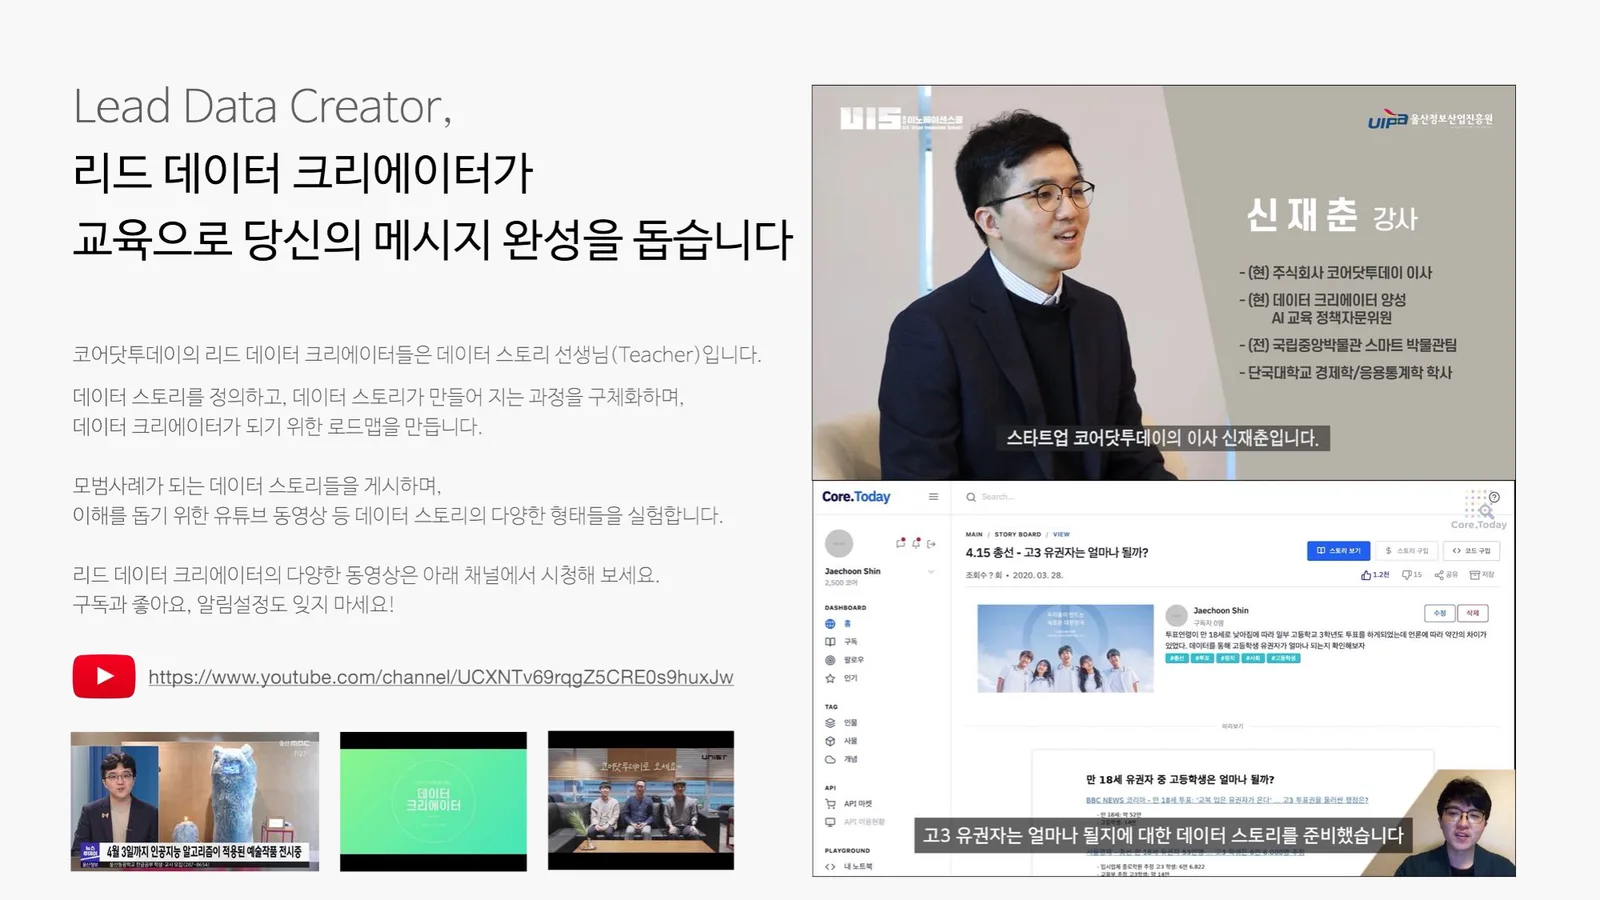
리드 데이터 크리에이터는 데이터 스토리 선생님(Teacher)입니다. 데이터 스토리를 정의하고, 데이터 스토리가 만들어지는 과정을 구체화하며, 데이터 크리에이터가 되기 위한 로드맵을 만듭니다. 모범 사례가 되는 데이터 스토리를 게시하고, 이해를 돕는 유튜브 영상 등 데이터 스토리의 다양한 형태를 실험합니다.
이어진 이야기
- 데이터 스토리텔링 플랫폼은 2020년 과기정통부 민관 협력 기반 ICT 스타트업 육성사업에 선정돼 개발을 시작했습니다.
- 데이터 크리에이터 비전과 구성원 이야기는 UNIST 매거진 2021 가을호, 파이낸셜뉴스 인터뷰, 그린 비즈니스위크 2022 인터뷰에서도 볼 수 있습니다.
- 이후 코어닷투데이는 AI를 함께 쓰는 AI 협업 플랫폼으로 플랫폼을 넓혔습니다.
어려운 데이터 고민, 데이터 스토리텔링으로 해결하세요! Data Story = Data + Algorithm + Message