
#pgvector
3개의 포스트
4096차원에 HNSW가 필요한 이유 — 전수 비교의 벽, 차원의 저주, 그리고 그래프를 걸어서 찾는 법 (한국어 검색 스택 4편)
1편에서 가장 좋았던 Qwen3-Embedding-8B는 문장 하나를 4,096개 숫자로 바꿉니다. 문서 589건이면 질문 하나에 589번 내적하면 되니 1초도 안 걸립니다. 그런데 문서가 5,000만 건이면? 같은 방식으로는 질문 하나에 2,000억 번 곱셈이고, 서버가 아무리 좋아도 초 단위입니다. 벡터 DB가 HNSW라는 인덱스를 쓰는 이유가 여기 있습니다. 이 글은 왜 고차원에서는 트리 인덱스가 소용없는지(차원의 저주), HNSW가 어떻게 스킵 리스트와 작은 세상 그래프를 합쳐 로그 시간에 근사 최근접을 찾는지, M·ef_construction·ef_search 세 손잡이가 무엇을 바꾸는지를 그림과 장난감 시뮬레이터로 풀고, 4,096차원 벡터 1만·10만·30만 개로 전수 비교와 hnswlib을 직접 재서 비교합니다. 10만 개에서 전수 비교 56ms 대 HNSW 1.3ms(재현율 0.98). 그리고 4,096차원의 진짜 병목은 그래프가 아니라 벡터 자체라는 것, 그래서 3편의 마트료시카 절단과 양자화가 HNSW와 곱해진다는 것을 메모리 계산기로 보입니다. 인터랙티브 4개와 삽화 8장.
[특집] 벡터 데이터베이스는 죽었다? — 터보퍼퍼가 벡터를 '색인 하나'로 내린 이유와 2026년 검색 인프라의 지각변동
2026년 9월 30일, 커서·노션·앤트로픽의 검색을 떠받치는 터보퍼퍼가 「RIP, vector database」라는 글을 올렸습니다. 3년 동안 모든 데이터를 벡터 클러스터 주소 아래 저장해 온 구조를 버리고, 벡터 색인을 '또 하나의 보조 색인'으로 내린다는 선언입니다. 벡터 하나가 이사하면 문서 전체와 색인이 따라 움직이는 쓰기 증폭, 토큰마다 문서를 복사하는 저장 증폭, 100~200개 상자에 갇힌 CPU — 원문이 밝힌 세 가지 이유를 키-값 예시 그대로 풀고, 2016년 우버가 포스트그레스를 떠난 이유와 InnoDB의 클러스터드 인덱스까지 거슬러 올라갑니다. 그리고 이 글이 터보퍼퍼만의 이야기가 아닌 이유 — 모든 DB가 벡터를 품고, S3가 벡터를 저장하고, 파인콘이 BM25를 붙이고, 클로드 코드가 grep을 고른 2025~2026년의 흐름을 검증된 숫자로 짚습니다. 인터랙티브 6개와 삽화 11장.
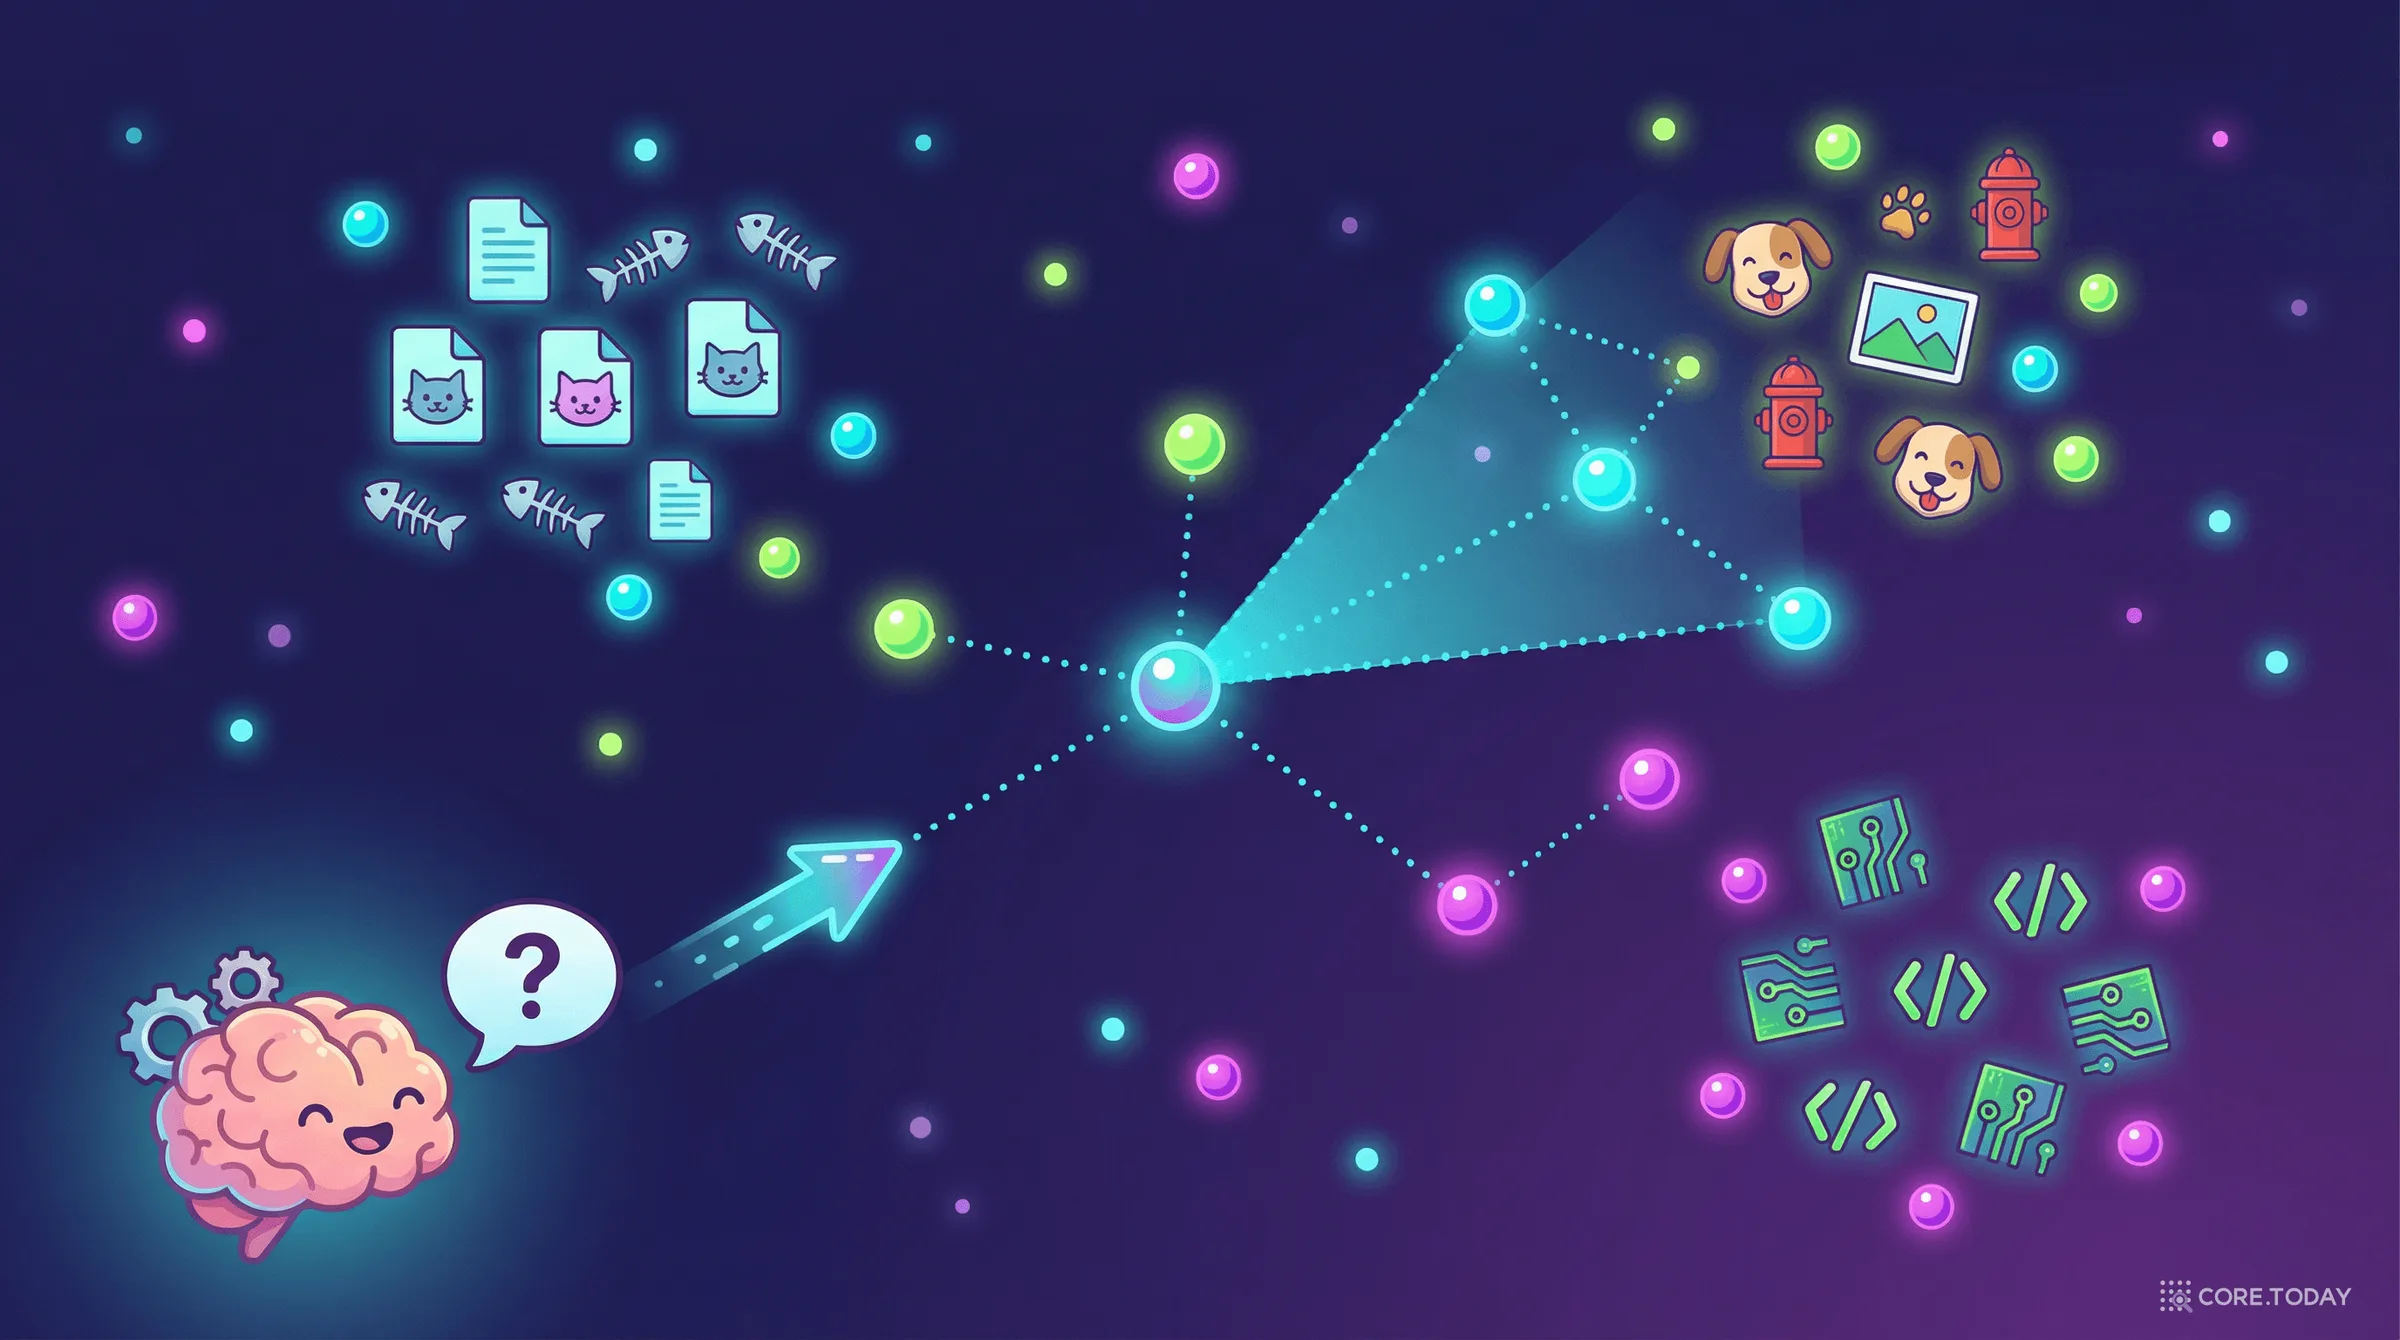
벡터 데이터베이스 완전 정복: AI가 '의미'를 검색하는 시대의 새로운 저장소
'강아지 사진'을 검색하면 'puppy', '댕댕이', '반려견' 사진도 찾아주는 검색. 키워드가 아닌 '의미'로 검색하는 기술의 핵심에 벡터 데이터베이스가 있다. 임베딩이 무엇이고, ANN 알고리즘이 어떻게 작동하며, RAG에서 왜 필수인지를 논문과 실전 사례로 풀어본다.