
#RRF
7개의 포스트
‘비슷하다’는 네 가지 질문이다 — 알프스 꽃밭의 자카드에서 2026년 한국어 사실탐색기까지, 유사도 125년
2026년 10월, 코어닷투데이 사실탐색기는 부산 조례 부칙의 '1981년 1월 1일부터 시행'과 '1984년 1월 1일부터 시행'을 같은 값으로 묶었습니다. 두 문장이 71% 비슷하다는 계산 때문이었습니다. 이 글은 '비슷하다'를 재는 기술이 왜 생겨났는지부터 시작합니다. 1901년 알프스 식물 목록을 비교한 자카드, 인구조사 이름을 소리로 묶은 사운덱스, 단어를 벡터로 바꾼 설턴과 IDF의 스파크 존스, 뜻을 좌표로 만든 임베딩까지요. 그리고 같은 기술이 한국어 공적 기록 앞에서 어디서 미끄러지는지, 2026년 임베딩 14종 실측과 최신 논문으로 따라갑니다. 결론은 하나입니다. '비슷하다'는 같은 대상·같은 값·같은 사건·비슷한 사안이라는 네 가지 다른 질문이고, 질문마다 도구가 다릅니다.
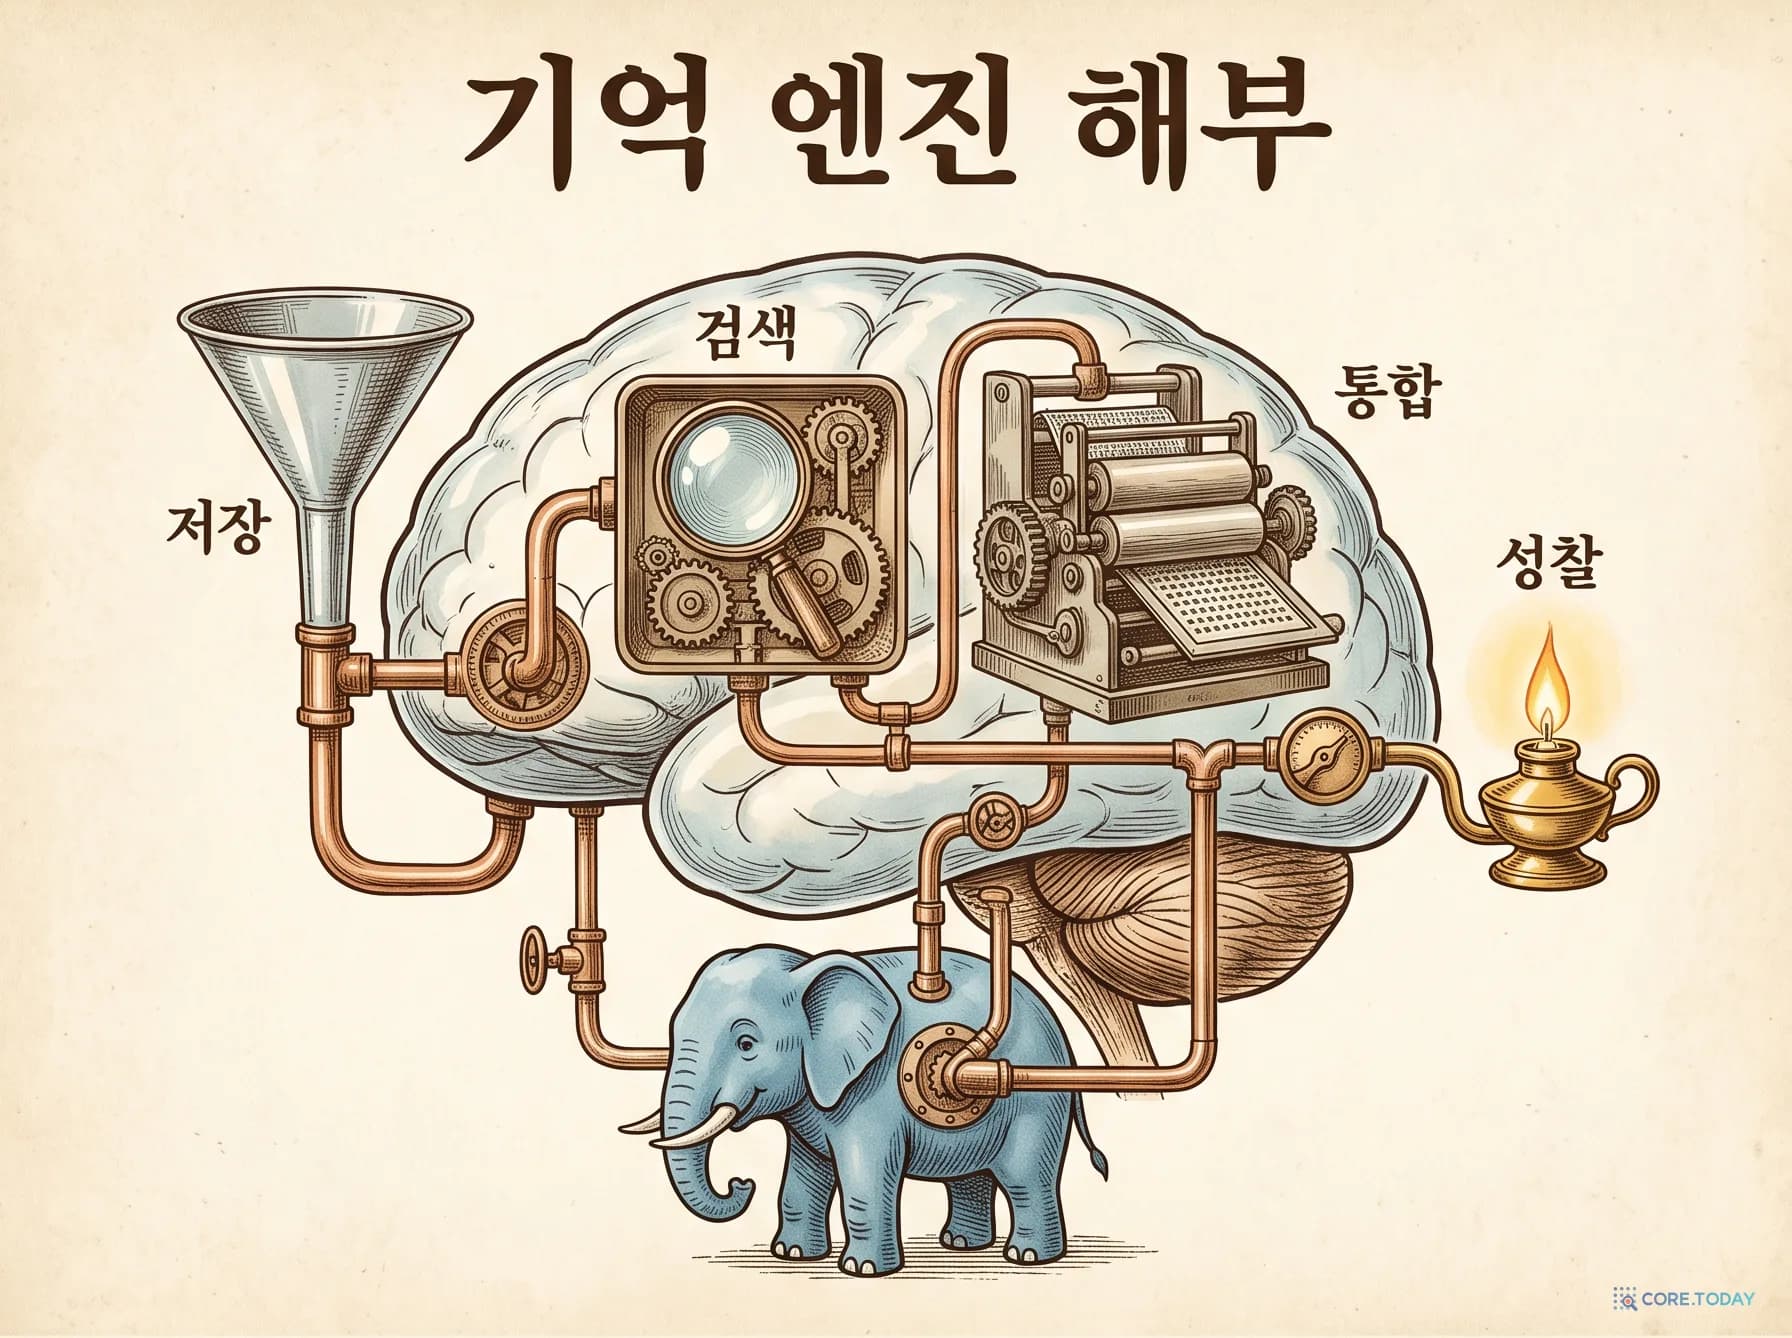
에이전트 기억 엔진 해부 — Hindsight의 코드를 열고 Mem0·Graphiti·Letta·Cognee를 나란히 눕혔다
논문 대신 코드를 열었다. GitHub 별 5만 개가 넘는 Hindsight의 저장·검색·통합·성찰 경로를 상수와 공식, 파일 위치까지 따라가고, 같은 칼로 Mem0·Graphiti·Letta·Cognee를 해부했다. 핵심은 '고전 검색 기법 + LLM 판단'의 분업이다. 엔티티는 임베딩이 아니라 글자 조각으로 합치고, 순위는 점수가 아니라 등수로 섞고, 쉬운 판단은 LLM이 아니라 1초짜리 결정 모델이 내린다. 그리고 다섯 엔진 모두 '잊는 법'은 구현하지 않았다. Mem0이 2026년 4월 그래프와 UPDATE를 버린 이유, Graphiti의 RRF 상수가 60이 아니라 1인 이유, Letta가 기억을 git 저장소로 바꾼 이유, 그리고 한국어 이름 '김민지'와 '민지'가 왜 한 사람으로 합쳐지지 않는지까지 — 인터랙티브 위젯 7개로 직접 돌려 본다.
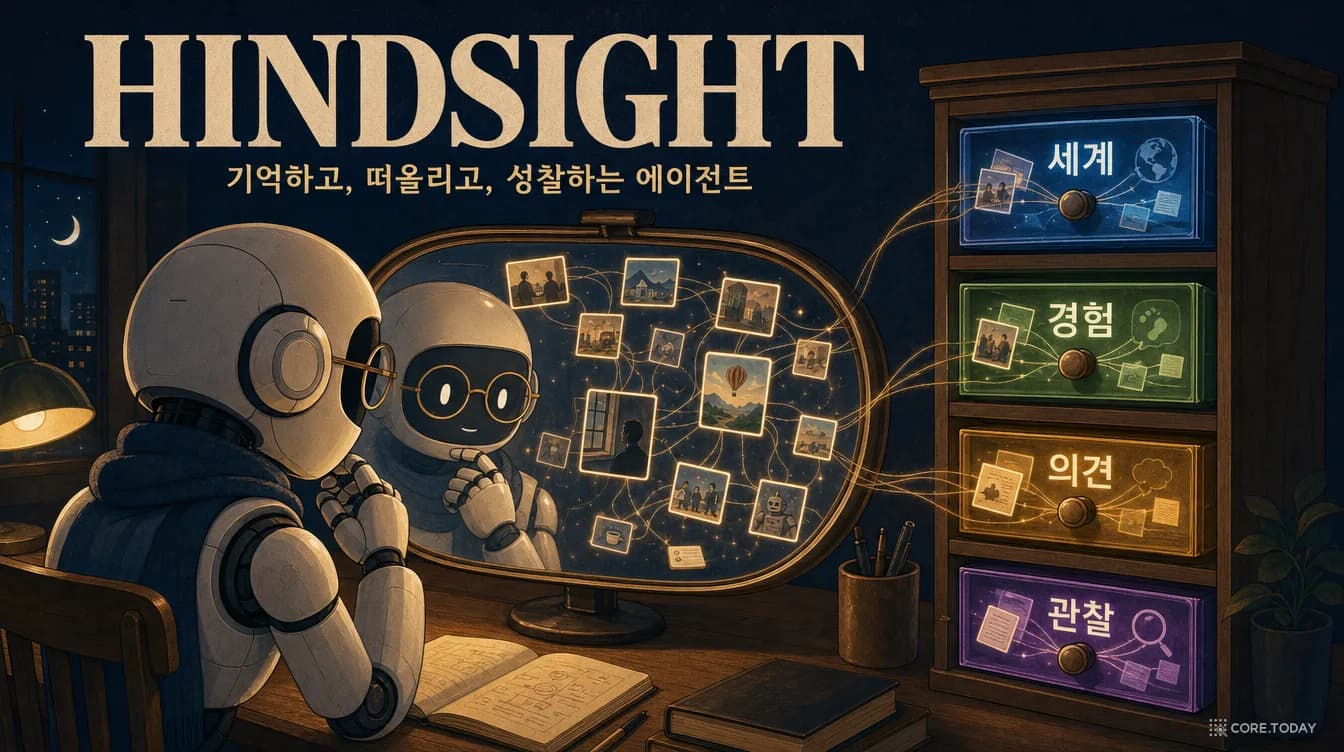
Hindsight 완전 해부 — 에이전트에게 '본 것'과 '믿는 것'을 따로 기억하게 했더니 생긴 일
11개월 만에 GitHub 별 4만 7천 개. 오픈소스 에이전트 메모리 Hindsight는 기억을 하나의 벡터 창고가 아니라 네 개의 서랍 — 세계·경험·의견·관찰 — 으로 나누고, 저장(retain)·회상(recall)·성찰(reflect) 세 동작으로 다룬다. 같은 20B 모델의 LongMemEval 점수가 39.0%에서 83.6%로 뛰었다. 왜 '증거와 믿음의 분리'가 중요한지, 네 갈래 검색과 역순위 융합·확산 활성화가 어떻게 돌아가는지, 성격 다이얼과 의견 강화 공식은 무엇인지, 그리고 2026년의 제품은 논문과 어떻게 달라졌는지 — 심리학의 140년 계보부터 벤치마크의 함정, 경쟁 설계와의 비교까지 인터랙티브 위젯 7개로 완전 해부한다.
조건이 둘, 셋이 되면 — 질문을 쪼개는 검색과 Jev의 조건별 판정, 한국어 실측 (한국어 검색 스택 10편)
8편이 풀지 못한 숙제가 있었습니다. 'AWS 보안 글', 'Claude Code에서 MCP를 쓰는 글'처럼 두 주제를 모두 만족해야 하는 질문입니다. 이 글은 조건 1개·2개·3개짜리 한국어 질문 52개와 조건 순서만 바꾼 쌍둥이 질문 40개로, 조건이 늘 때 검색이 어떻게 무너지는지와 그것을 어떻게 막는지를 쟀습니다. 질문을 한 번에 임베딩하면 nDCG@10이 조건 1개 0.940에서 2개 0.519, 3개 0.387로 떨어졌습니다. 질문을 조건별로 쪼개 따로 찾고 합치기만 해도 3개에서 0.592로 버텼고, 그 후보를 Jev가 판정하면 2개와 3개 모두 0.725였습니다. Jev는 한 호출에 질문을 여러 개 받으므로 조건마다 따로 물어도 조건 하나당 토큰 90개, 지연 2ms만 늘었고, 어느 조건이 빠졌는지까지 알려 줬습니다. 의외의 발견도 있었습니다. 판정할 문장 자체가 바뀌는 탓에 'Jev 한 질문'이 조건 순서에 가장 민감했고, 조건별로 묻자 그 흔들림이 사라졌습니다. Jev 9,544회 호출에 0.27달러. 인터랙티브 4개와 삽화 7장.
키워드와 의미, 둘 다 쓴다 — BM25·벡터·RRF·리랭커, 논문과 실측으로 보는 하이브리드 검색 (한국어 검색 스택 2편)
원문 메모의 그림은 이랬습니다. BM25와 벡터 검색을 나란히 돌리고, 결과를 RRF로 합치고, 리랭커로 다시 고른다. 이 글은 그 그림의 각 칸을 논문과 실측으로 채웁니다. 2009년 SIGIR의 두 쪽짜리 논문이 제안한 RRF는 점수 대신 등수만 쓰는 단순한 공식인데 왜 통하는지, k=60은 어디서 왔는지, 2023년 TOIS 논문은 왜 '점수 융합이 RRF보다 낫다'고 했는지, 2025년의 '약한 고리' 발견은 무엇인지. 그리고 1편의 한국어 코퍼스로 직접 재 보니, 등가중 RRF는 벡터 단독보다 오히려 나빴고 이유는 BM25가 약한 고리였기 때문이었습니다. 반면 강한 임베딩 둘(Qwen3-8B + BGE-M3)을 RRF로 합치자 어느 쪽 단독보다 좋아졌습니다. 리랭커는 '따로 읽고 비교'하는 바이 인코더와 '같이 읽고 판정'하는 크로스 인코더의 차이로 풀고, 로컬 LLM을 리랭커로 써서 상위 10개의 순서가 얼마나 바뀌는지 잽니다. 인터랙티브 5개와 삽화 8장.
질문마다 다른 검색기, 다른 모델, 다른 예산 — 동적 라우팅과 DRAG (RAG 특집 3편)
HotpotQA 질의의 22%는 BM25만으로 검색해도 정답이 나온다. 가장 비싼 구성이 꼭 필요한 질의는 15.6%다. 그런데 대부분의 RAG는 모든 질의에 같은 검색기와 같은 모델을 쓴다. 2026년 9월 15일 공개된 DRAG는 검색기 4단계 × 생성기 추론 강도를 전부 조합해 잰 뒤 두 가지를 보여 줬다 — 더 강한 검색이 더 많은 추론보다 크게 이기지만 단조롭게 좋아지지는 않는다는 것, 그리고 정답을 아는 오라클 라우터는 최고 정적 구성보다 정확하면서 지연은 절반이라는 것. 이 특집은 1편의 5경로 라우팅을 8경로로 확장하고, 라우터가 경로와 함께 정해야 하는 8가지 결정, 오라클 대비 손실(router regret)을 재는 법, 그리고 같은 날 나온 추론형 임베딩(CoFree)·추론형 재랭커(MERIT-Rank)가 라우터의 선택지를 어떻게 늘렸는지를 위젯 5종으로 따라간다. 결론은 하나다 — 추론형 부품은 맨 위 한 단이고, 대부분의 질의는 아래에서 끝나야 한다.
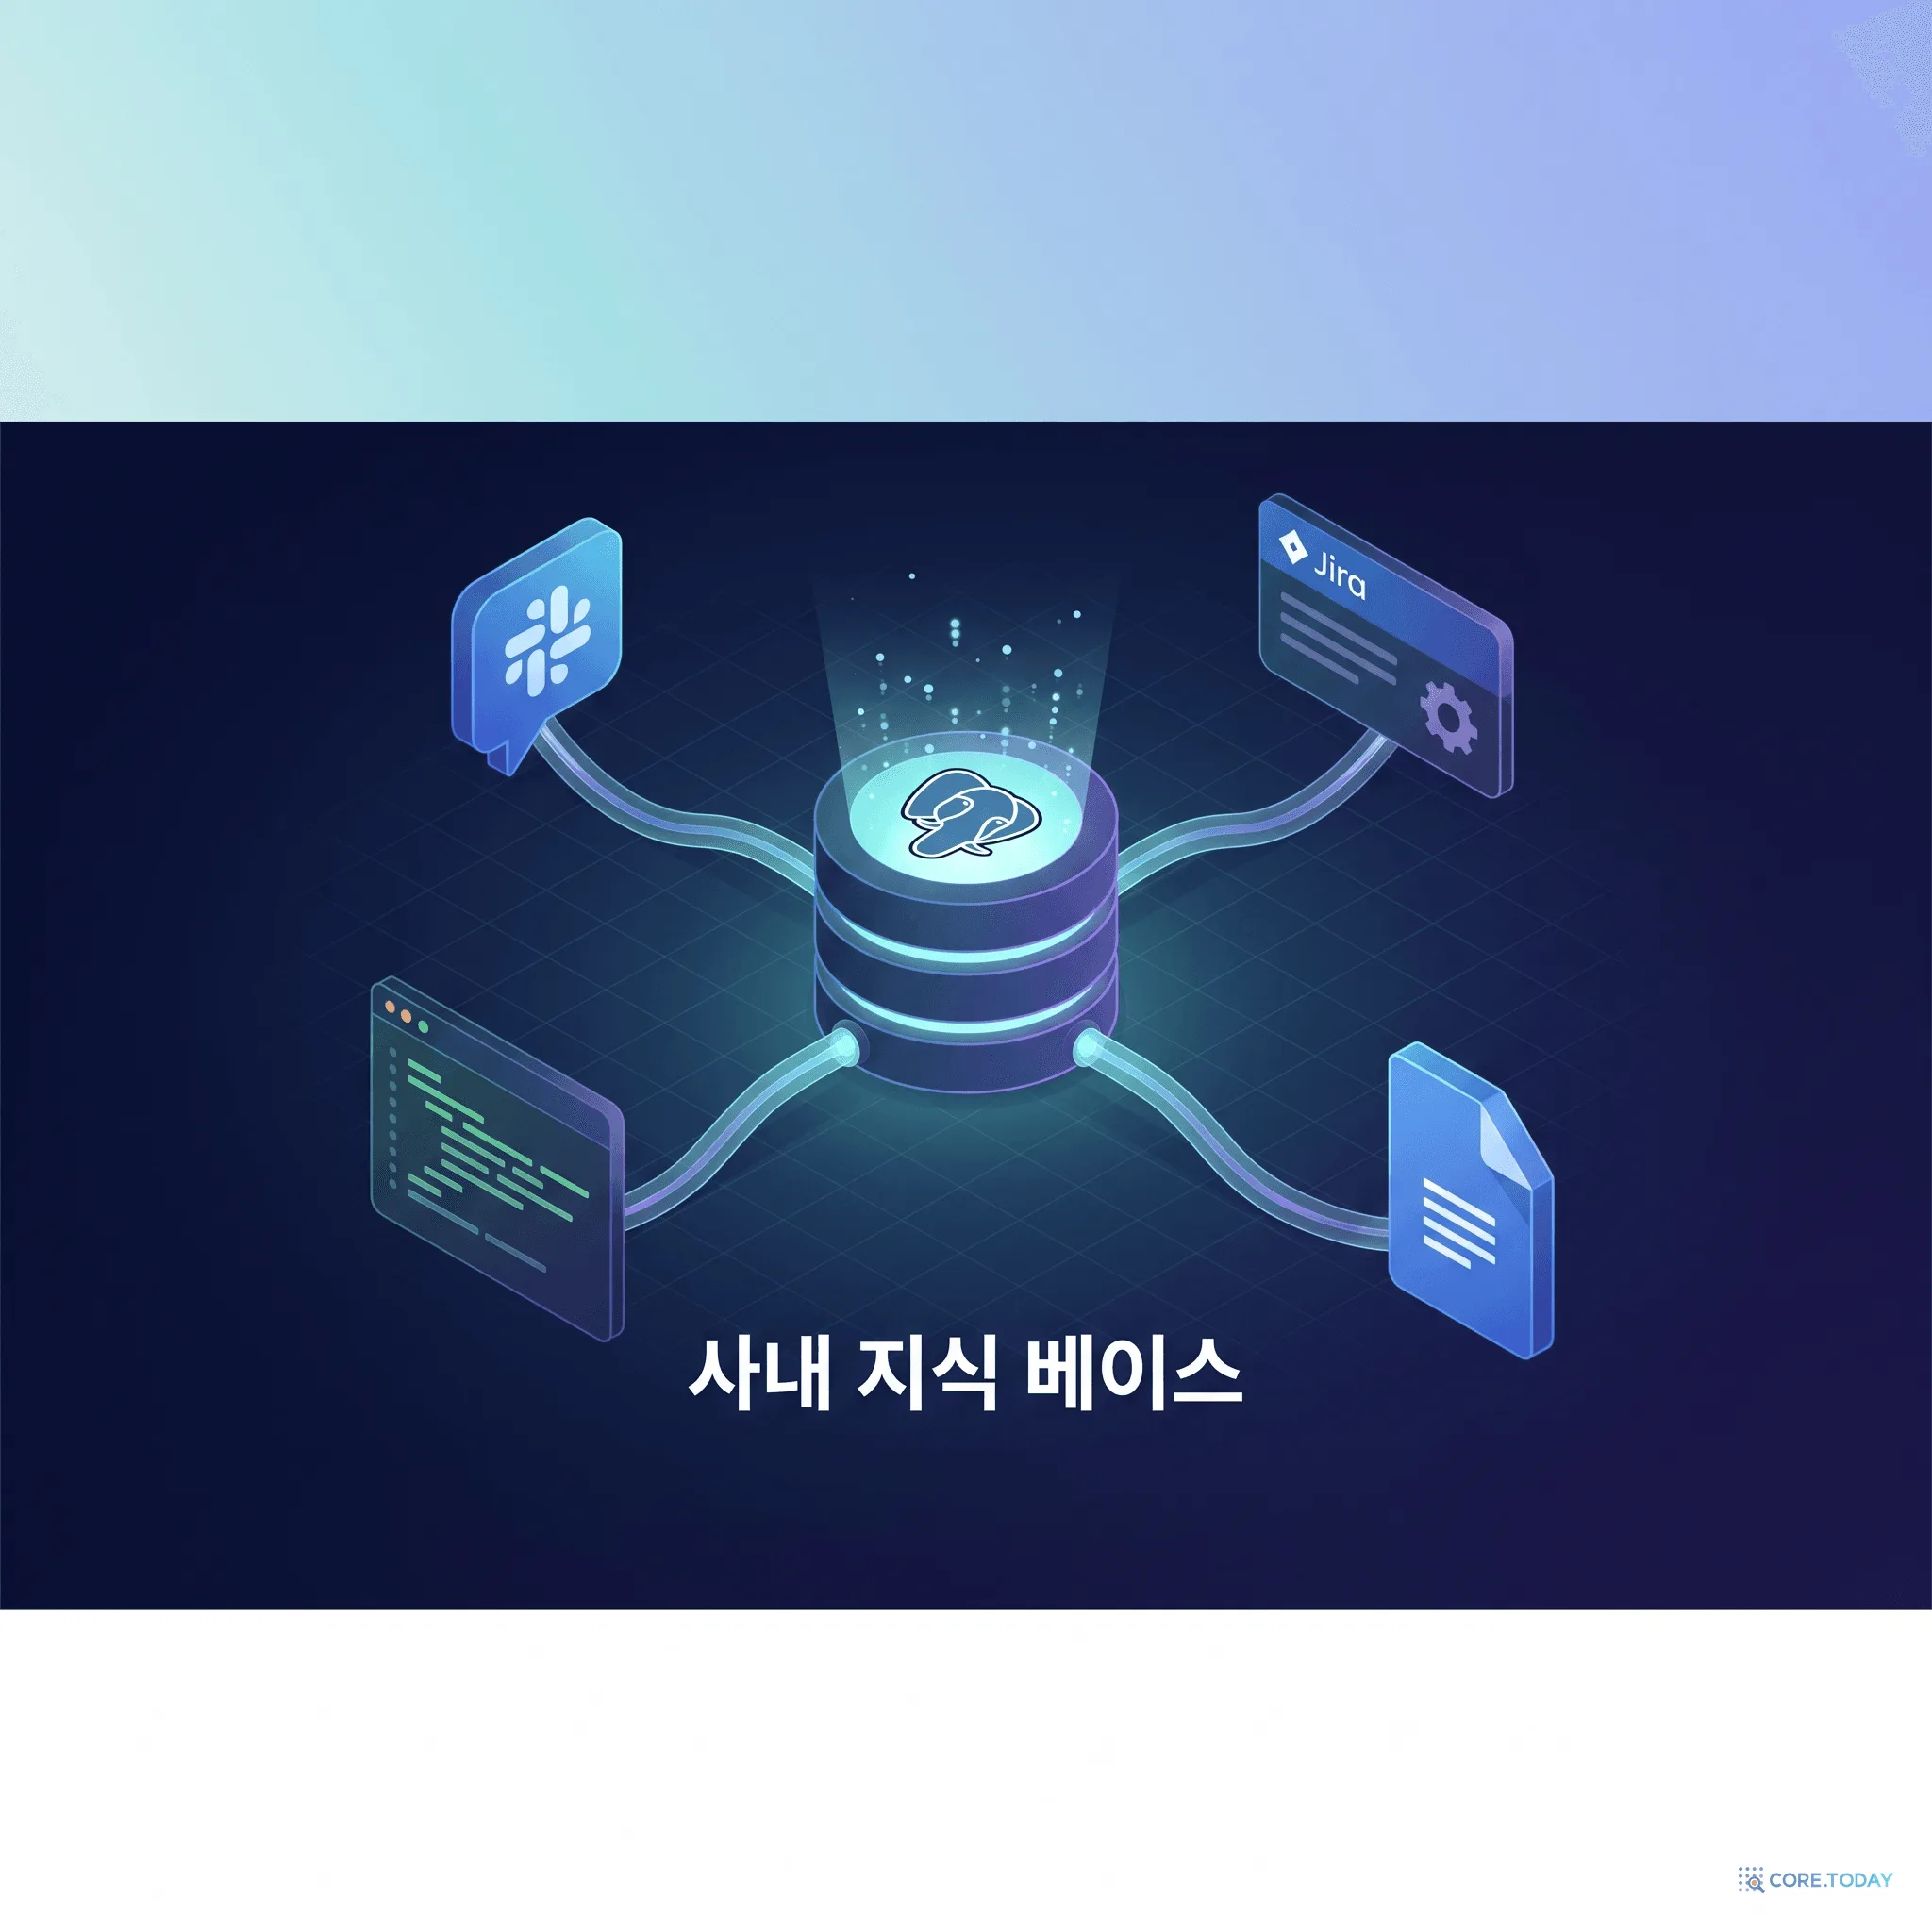
하루 15,000개의 질문에 답하는 사내 AI — Cerebras는 지식 베이스를 어떻게 만들었나
"그거 어디 있죠?" "이거 누가 담당이죠?" — 회사가 커질수록 정보는 흩어지고, 같은 질문이 반복된다. Cerebras는 Slack·코드·문서를 하나의 임베딩 테이블로 모아 하루 15,000개 질문에 답하는 사내 지식 베이스를 만들었다. 그 안에는 반세기 검색의 역사가 응축돼 있다. 키워드 검색에서 BM25, 임베딩, HNSW, 하이브리드, 그리고 에이전트 검색까지 — 왜 이런 개념들이 하나씩 필요해졌는지, 인터랙티브하게 만져보며 이해한다.