
#RLVR
8개의 포스트
[특집] 학교는 손실 함수다 — 340만 명이 읽은 'AI 시대의 커리어 조언', 채점할 수 없는 일을 찾아서
2026년 7월 3일 새벽, 전 OpenAI·딥마인드 연구자 필 첸이 X에 올린 에세이 한 편이 주말 사이 300만 명을 넘게 읽혔다. 첫 문장은 이랬다 — 'AI는 손실 함수를 쓸 수 있는 모든 것에서 좋아진다. 그리고 학교는 대부분 손실 함수다.' 이 글은 그 한 문장을 끝까지 파고든다. 손실 함수와 '검증 가능한 보상'이 모델을 어떻게 가르치는지(DeepSeek-R1의 AIME 15.6%→71.0% 곡선, GRPO의 구조), 제이슨 웨이의 '검증자의 법칙'이 왜 커리어 예언이 되는지, 그리고 '문제 찾기·가장 야심찬 형태·마지막 10%·xG와 효율·연구 진입'이라는 여섯 조언이 1938년 아인슈타인부터 2025년 '탄광 속 카나리아'까지 어떤 생각의 계보 위에 서 있는지를 사례와 데이터로 풀었다. 리트코드를 옹호한 반론과 '문제 선정도 결국 채점 가능해지지 않느냐'는 날카로운 질문, 메타의 AI 동반 면접과 우버의 토큰 예산 소진, 네이버·카카오의 신입 공채 실종까지 — 2026년 가을, 한국의 독자가 이 글에서 무엇을 가져가야 하는지 다섯 개의 인터랙티브 도구와 함께 정리했다.
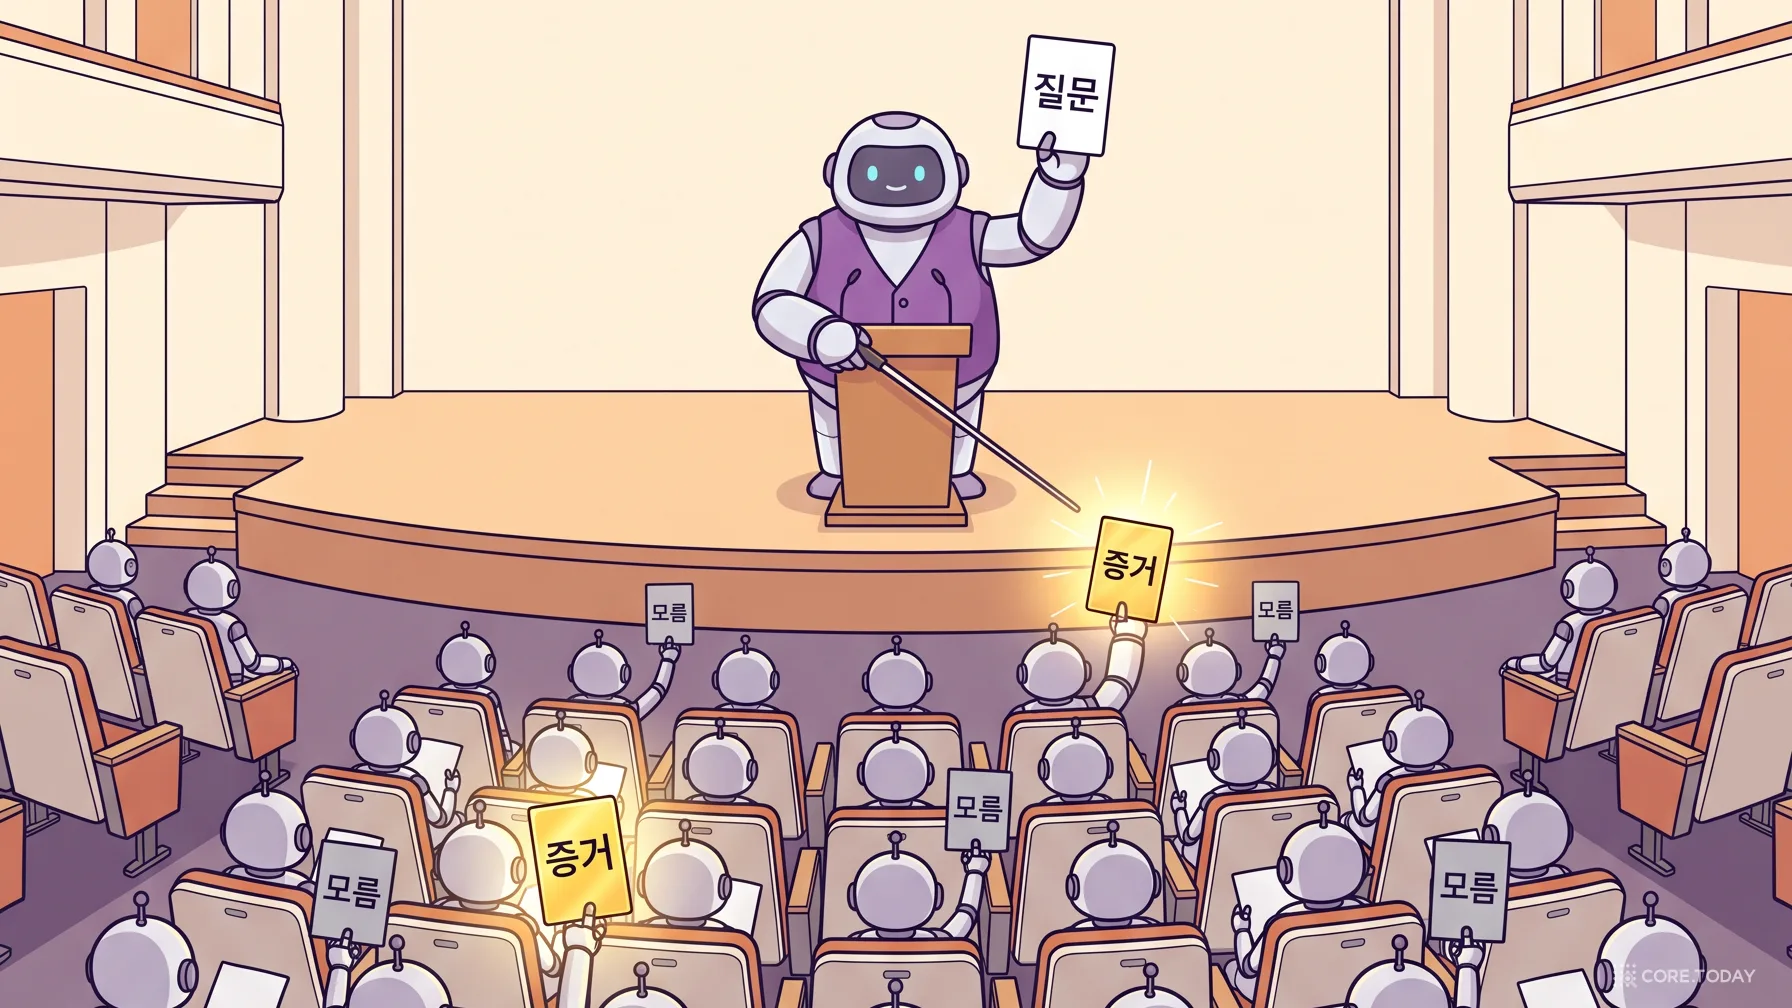
읽기는 병렬로, 추론은 깊게 — 896K 토큰 문서를 4B 모델이 읽어 내는 법, PARSER 논문 특집
100만 토큰짜리 창을 가진 모델도 긴 문서 앞에서는 정확도가 수십 점씩 떨어집니다. 홍콩중문대 연구진이 2026년 9월에 내놓은 PARSER는 '문서를 읽는 순서는 문서가 정하지만, 질문을 푸는 순서는 질문이 정해야 한다'는 한 문장에서 출발합니다. 문서를 보지 않는 리드 에이전트가 질문을 쪼개 수천 개의 청크 담당 서브에이전트에게 동시에 흩뿌리고, 돌아온 증거로 다음 질문을 다듬습니다. 4B 모델이 896K 토큰에서 순차 메모리 에이전트를 12점 앞서고, 9B 모델이 DeepSeek-V4-Pro를 6.3점 앞섰으며, 지연은 11배 줄었습니다. 이 글은 Transformer의 어텐션 창에서 시작해 'Lost in the Middle'과 Context Rot, MemAgent의 순차 메모리까지 이 논문이 서 있는 자리를 되짚고, 흩뿌리기-모으기 구조와 리드 에이전트만 강화학습하는 설계, 세 가지 통제 실험, 실패 사례와 한계, 그리고 2026년 멀티 에이전트 지형에서의 의미를 사례와 함께 풀어 씁니다. 시뮬레이터·결과 탐색기·접근법 가이드 위젯 3개.
AI는 왜 미해결 수학은 풀면서 환불 처리는 못 맡기나 — RLHF 다음은 무엇인가
InstructGPT를 만든 사람이 18분 동안 무대에서 한 이야기는 이것이다. 'AI가 벤치마크를 다 부수는데 왜 고객센터는 아직 사람이 결정하나?' 그의 답은 난이도가 아니라 목표에 있다 — 오늘의 AI는 전부 사람의 선호를 최적화하도록 만들어졌고, 그래서 사람 옆에서는 경이롭지만 사람 없이는 못 미덥다. 이 글은 그 논리를 처음부터 끝까지 따라가고, GPT-4 기술 보고서가 남긴 결정적 증거(후학습이 보정을 10배 망가뜨렸다)를 실측 수치로 다시 그린다. 인터랙티브 위젯 7종과 삽화 12장. 그리고 과장하면 안 되는 지점도 함께 짚는다.
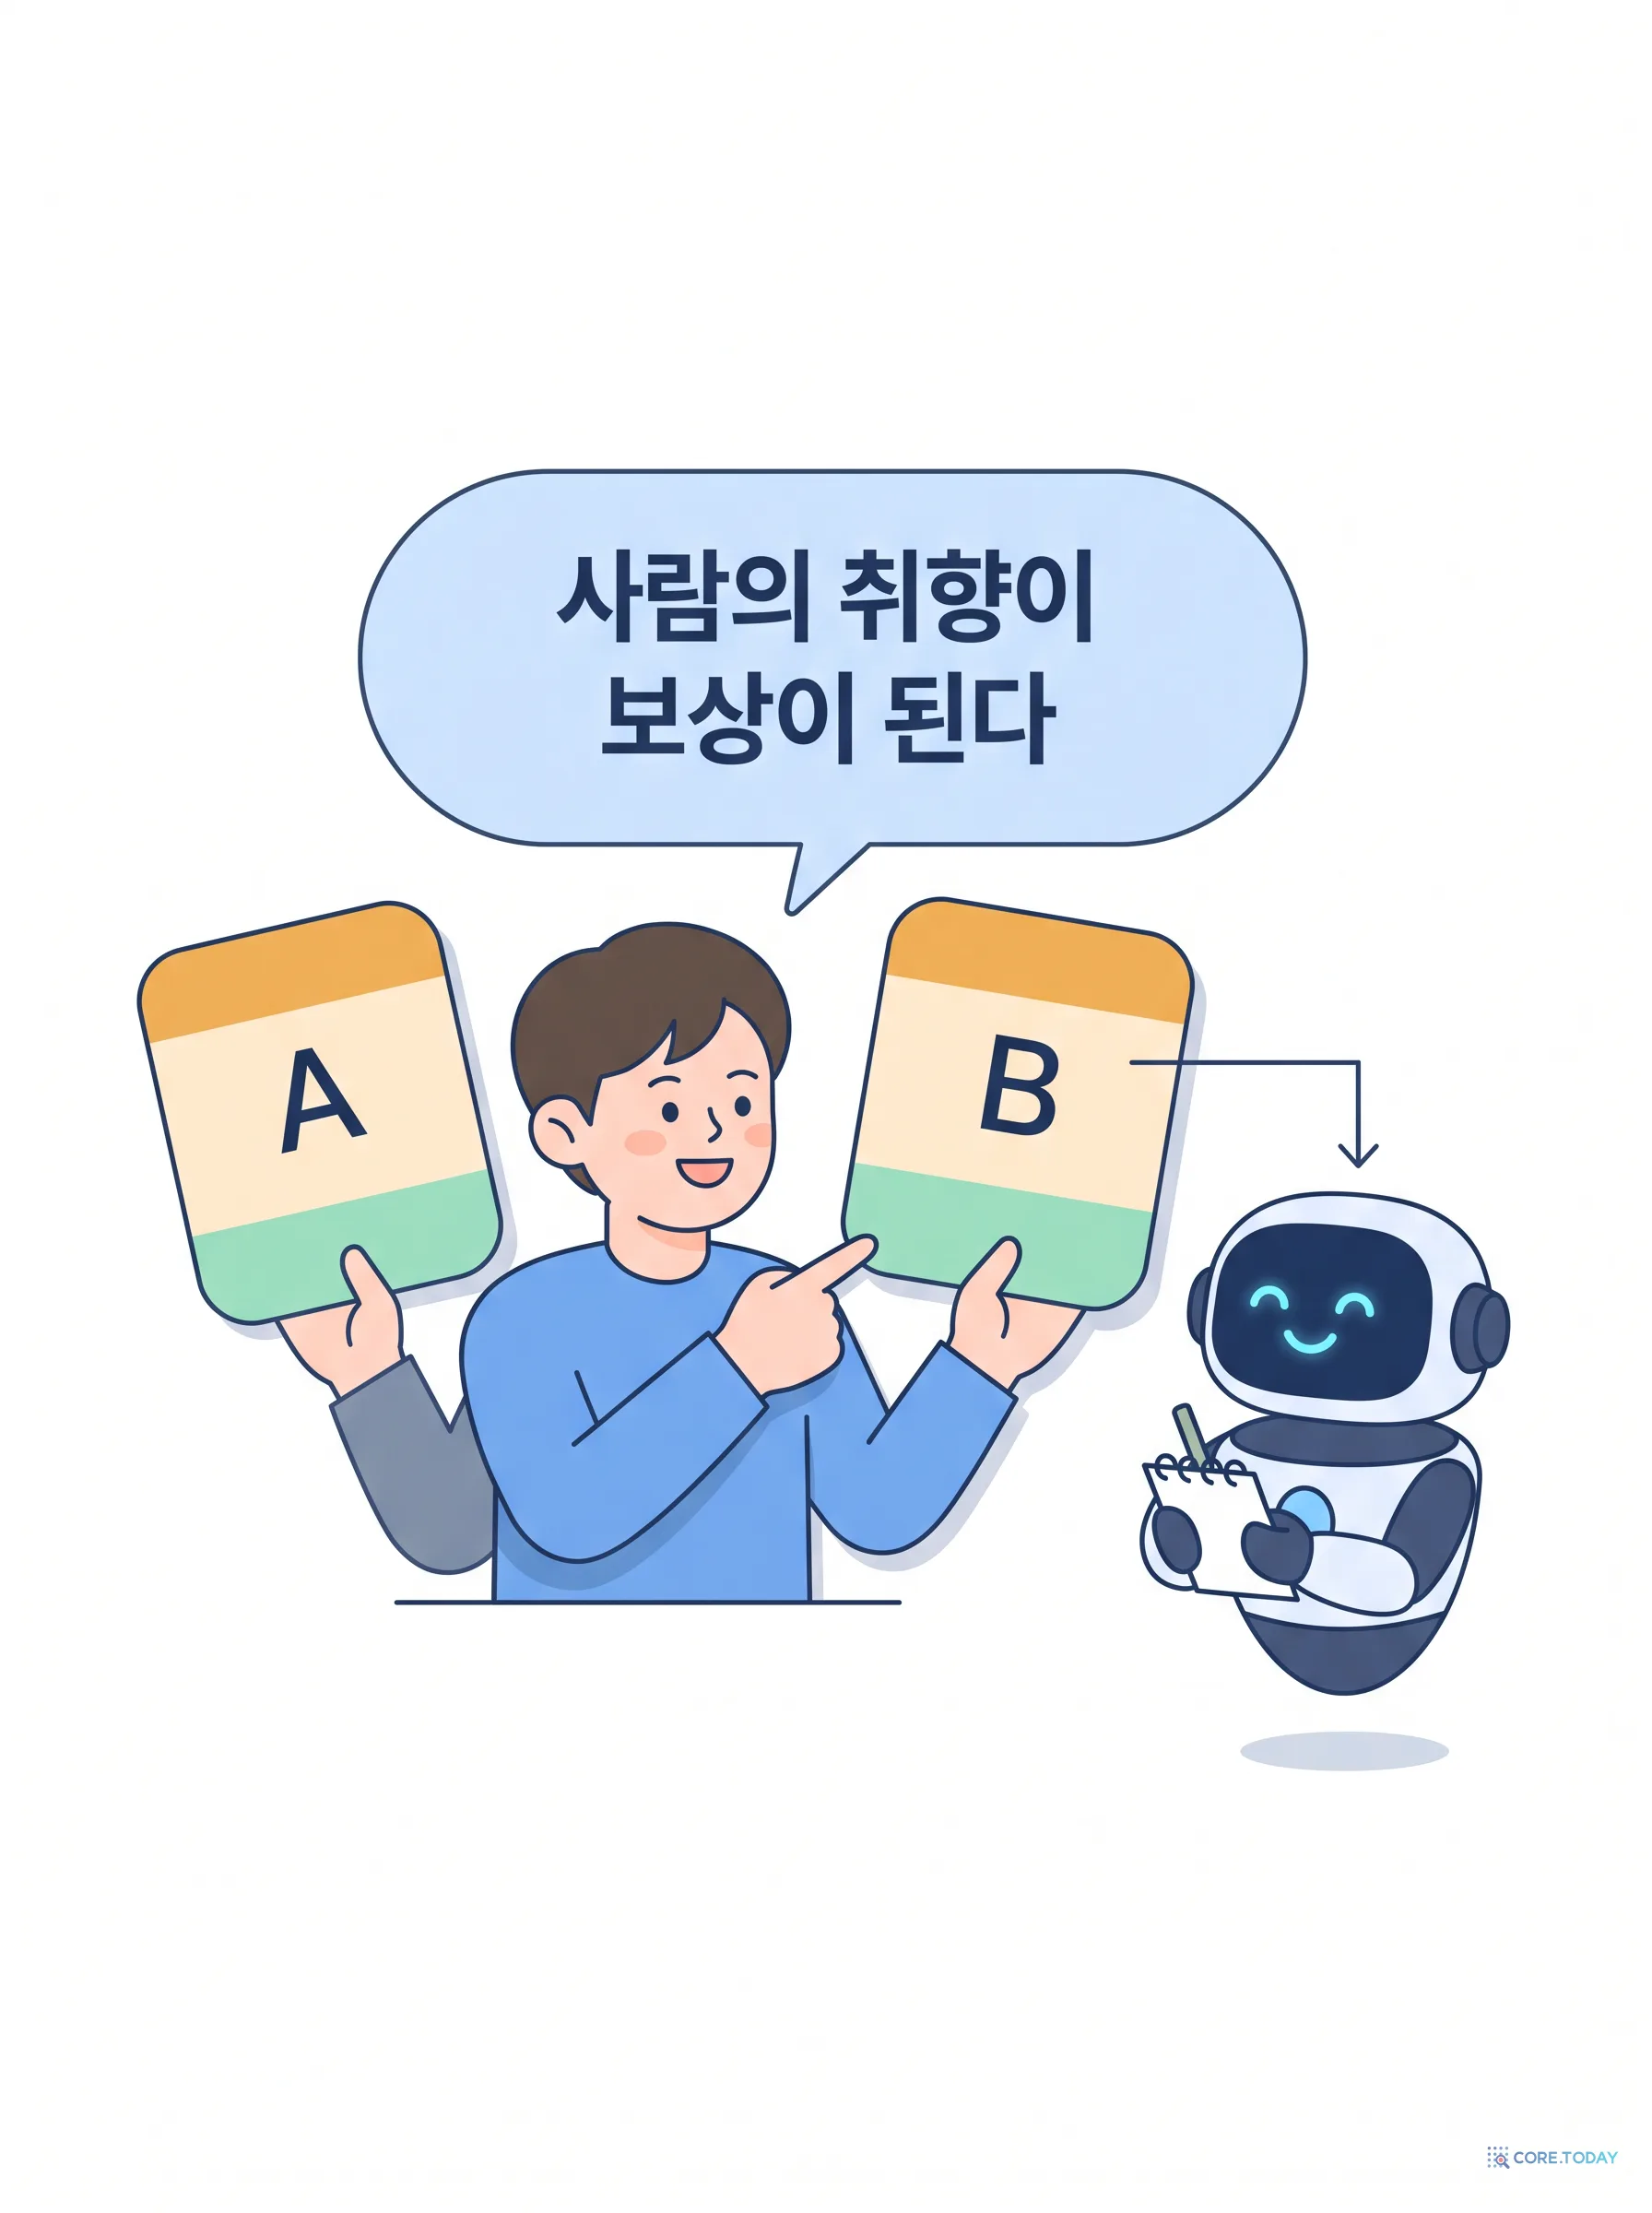
“달 착륙을 6살에게 설명해 줘” — 되묻기만 하던 AI는 어떻게 말귀를 알아듣게 됐나 (RLHF 특집)
2022년 1월, OpenAI는 “사용자의 의도를 GPT-3보다 훨씬 잘 따르는” 모델을 발표했다. 13억 파라미터 모델이 1750억 모델을 이겼고, 그 비용은 사전학습의 1.6%였다. 열 달 뒤 같은 레시피로 만든 ChatGPT가 세상을 바꿨다. 이 글은 그 기술 — 인간 피드백 강화학습(RLHF) — 이 왜 필요했는지를 2017년 뒤공중돌기 로봇부터 따라간다. 보상을 글로 적을 수 없다는 문제, 순위 하나가 여섯 개의 비교가 되는 방식, 보상 모델을 너무 믿으면 벌어지는 일, 그리고 RLHF가 고친 것이 아니라 ‘만든’ 네 가지 버릇까지. 인터랙티브 위젯 8종과 삽화로 풀었다.
당신의 AI, 빌린 겁니까 가진 겁니까 (2부): SFT에서 GRPO까지, '디지털 트윈'이라는 훈련장
'강화학습으로 모델을 훈련한다'는 말은 정확히 무슨 뜻일까? 사전학습·SFT·RLHF·RLVR로 이어지는 개념의 사다리를 밟아 오르고, 요즘 화제인 GRPO를 '커브로 채점하는 시험'에 빗대 직관적으로 푼다. 그리고 모델이 실제로 업무를 연습하는 '디지털 트윈'과 보상 설계까지, Fermisense의 카탈로그 실험을 해부한다.
데이터가 유일한 해자다 — AI 앱 시대, 무엇이 진짜 방어선인가
"모델은 곧 상품이 된다. 그럼 우리에게 남는 건 뭔가?" 2026년 모든 AI 회사가 마주한 질문에 대한 한 가지 답 — 데이터. 그런데 2019년 a16z는 '데이터 해자는 텅 빈 약속'이라고 못 박았다. 누가 맞는가? 구글의 클릭 로그와 아마존의 추천 엔진에서 시작해, 친칠라 논문이 데이터를 왕좌에 앉힌 순간, 인류의 텍스트가 바닥나는 2026~2032년, 그리고 RLVR이 바꾼 '어떤 데이터가 중요한가'라는 질문까지 추적한다. 핵심은 데이터의 '양'이 아니라 피드백 밀도 — 왜 코딩 에이전트는 이겼고 슬라이드 생성기는 지지부진했는지, 2×2 지도와 계산기로 직접 확인해 본다.
포스트 트레이닝 혁명 — RLHF에서 SimPO, KTO, ORPO, RLVR까지 완전 정리
LLM을 똑똑하게 만드는 건 사전 학습이지만, 쓸모 있게 만드는 건 포스트 트레이닝이다. RLHF의 복잡함에서 DPO의 우아함으로, 그리고 SimPO·KTO·ORPO·RLVR까지 — 2026년 AI 정렬 기술의 모든 것.
Nathan Lambert의 RLHF Book 리뷰 — RLHF 전체 지형도를 하나로
ChatGPT를 만든 비밀 무기 RLHF. 그런데 실제로 어떻게 작동하는지 아는 사람은 드물다. AI2의 Nathan Lambert가 쓴 218페이지 무료 교재가 SFT부터 PPO, GRPO, DPO, RLVR, 과최적화, 평가까지 RLHF의 모든 것을 하나로 정리했다. 핵심만 짚어본다.