
#DeepSeek-R1
6개의 포스트
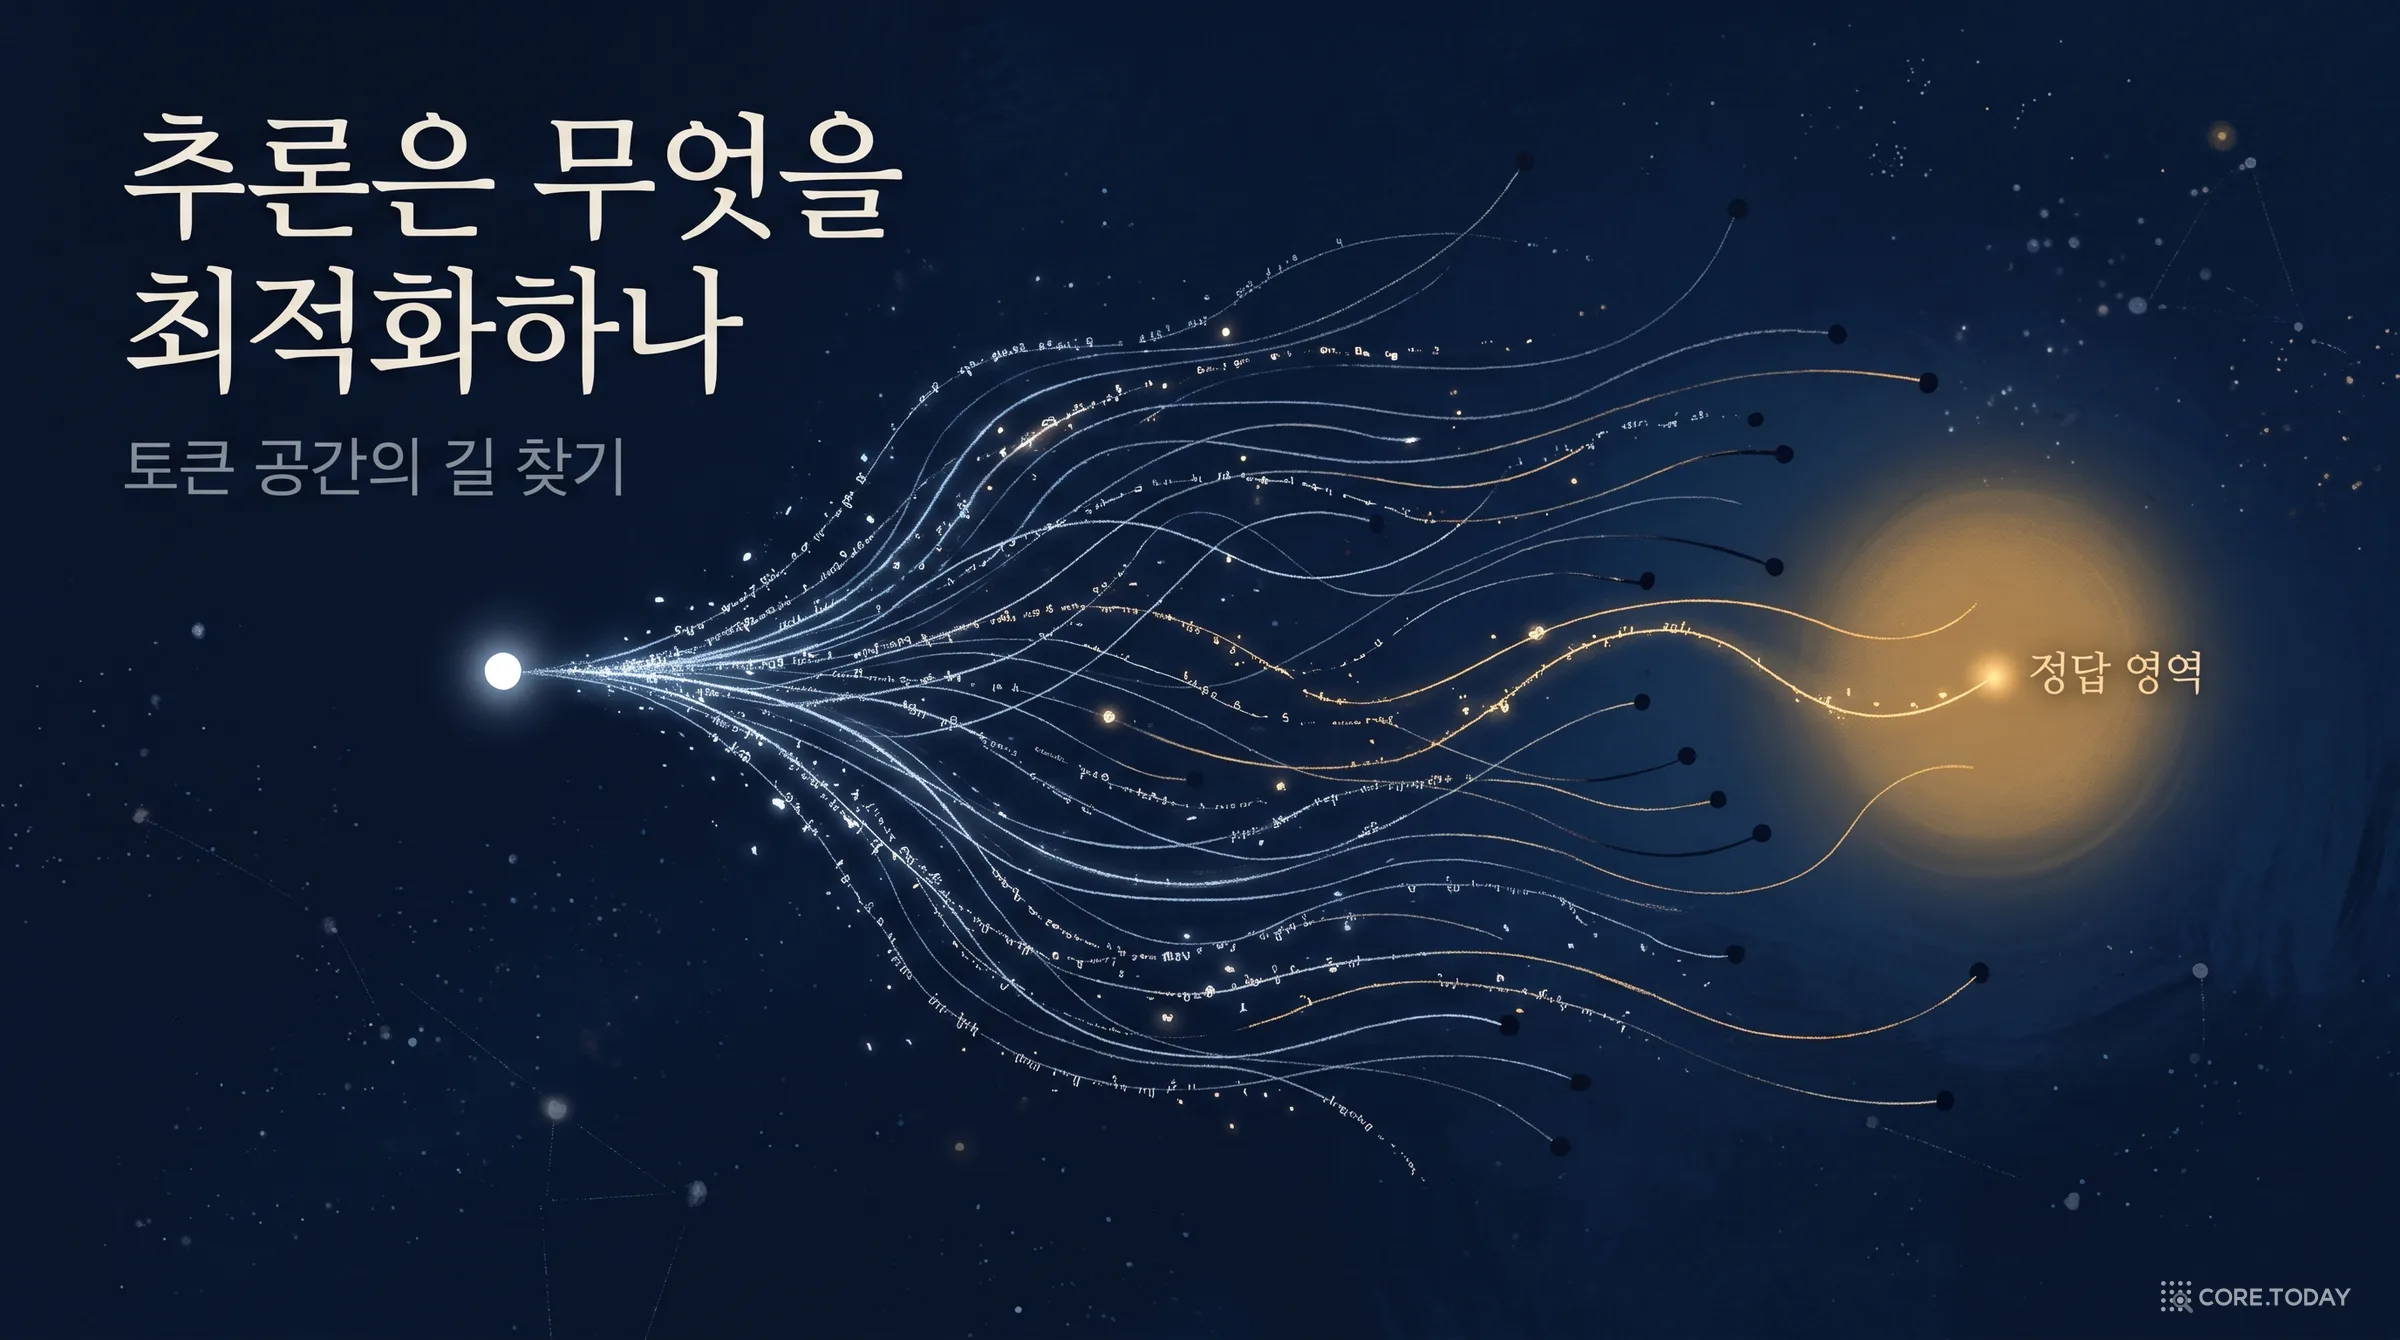
[특집] 추론은 무엇을 최적화하나 — 토큰 공간의 길 찾기로 다시 읽는 추론 모델, 강화학습, 그리고 보상 해킹
추론 모델을 강화학습으로 훈련하면 생각이 길어지고 정확도가 오른다. 그런데 이미 훈련된 모델에게 억지로 더 오래 생각시키면 좋아지다가 멈추고, 때로는 나빠진다. 알렉스 왕(Alex Wang)은 2026년 11월 8일 글 「추론은 어떤 목적함수를 푸는가」에서 이 수수께끼를 '토큰 공간의 길 찾기'라는 그림 하나로 푼다. 생각의 사슬 하나는 프롬프트에서 정답 집합으로 가는 길 하나이고, 강화학습이 올리는 것은 개별 길의 품질이 아니라 길들의 분포가 정답에 닿을 확률 pₓ라는 것이다. 이 글은 원문의 수식을 한 줄씩 풀고, 1956년 논리 이론가에서 AlphaZero, STaR, 「대형 언어 원숭이」, DeepSeek-R1, s1까지 '추론 = 탐색'의 계보를 따라가며, 그 관점이 설명하는 세 가지(생각 길이의 한계, 생각의 사슬이 진짜 이유가 아닌 이유, 보상 해킹)를 논문 그림과 사례로 확인한다. 로컬 모델(qwen3.5 4B)로 같은 답에 이르는 서로 다른 길, k번 뽑기의 힘, 생각 예산을 자르고 늘렸을 때의 정답률을 직접 재고, 위젯 6개로 길 찾기·k번 뽑기·REINFORCE=RFT·상각·불완전한 검증기를 만져 본다.
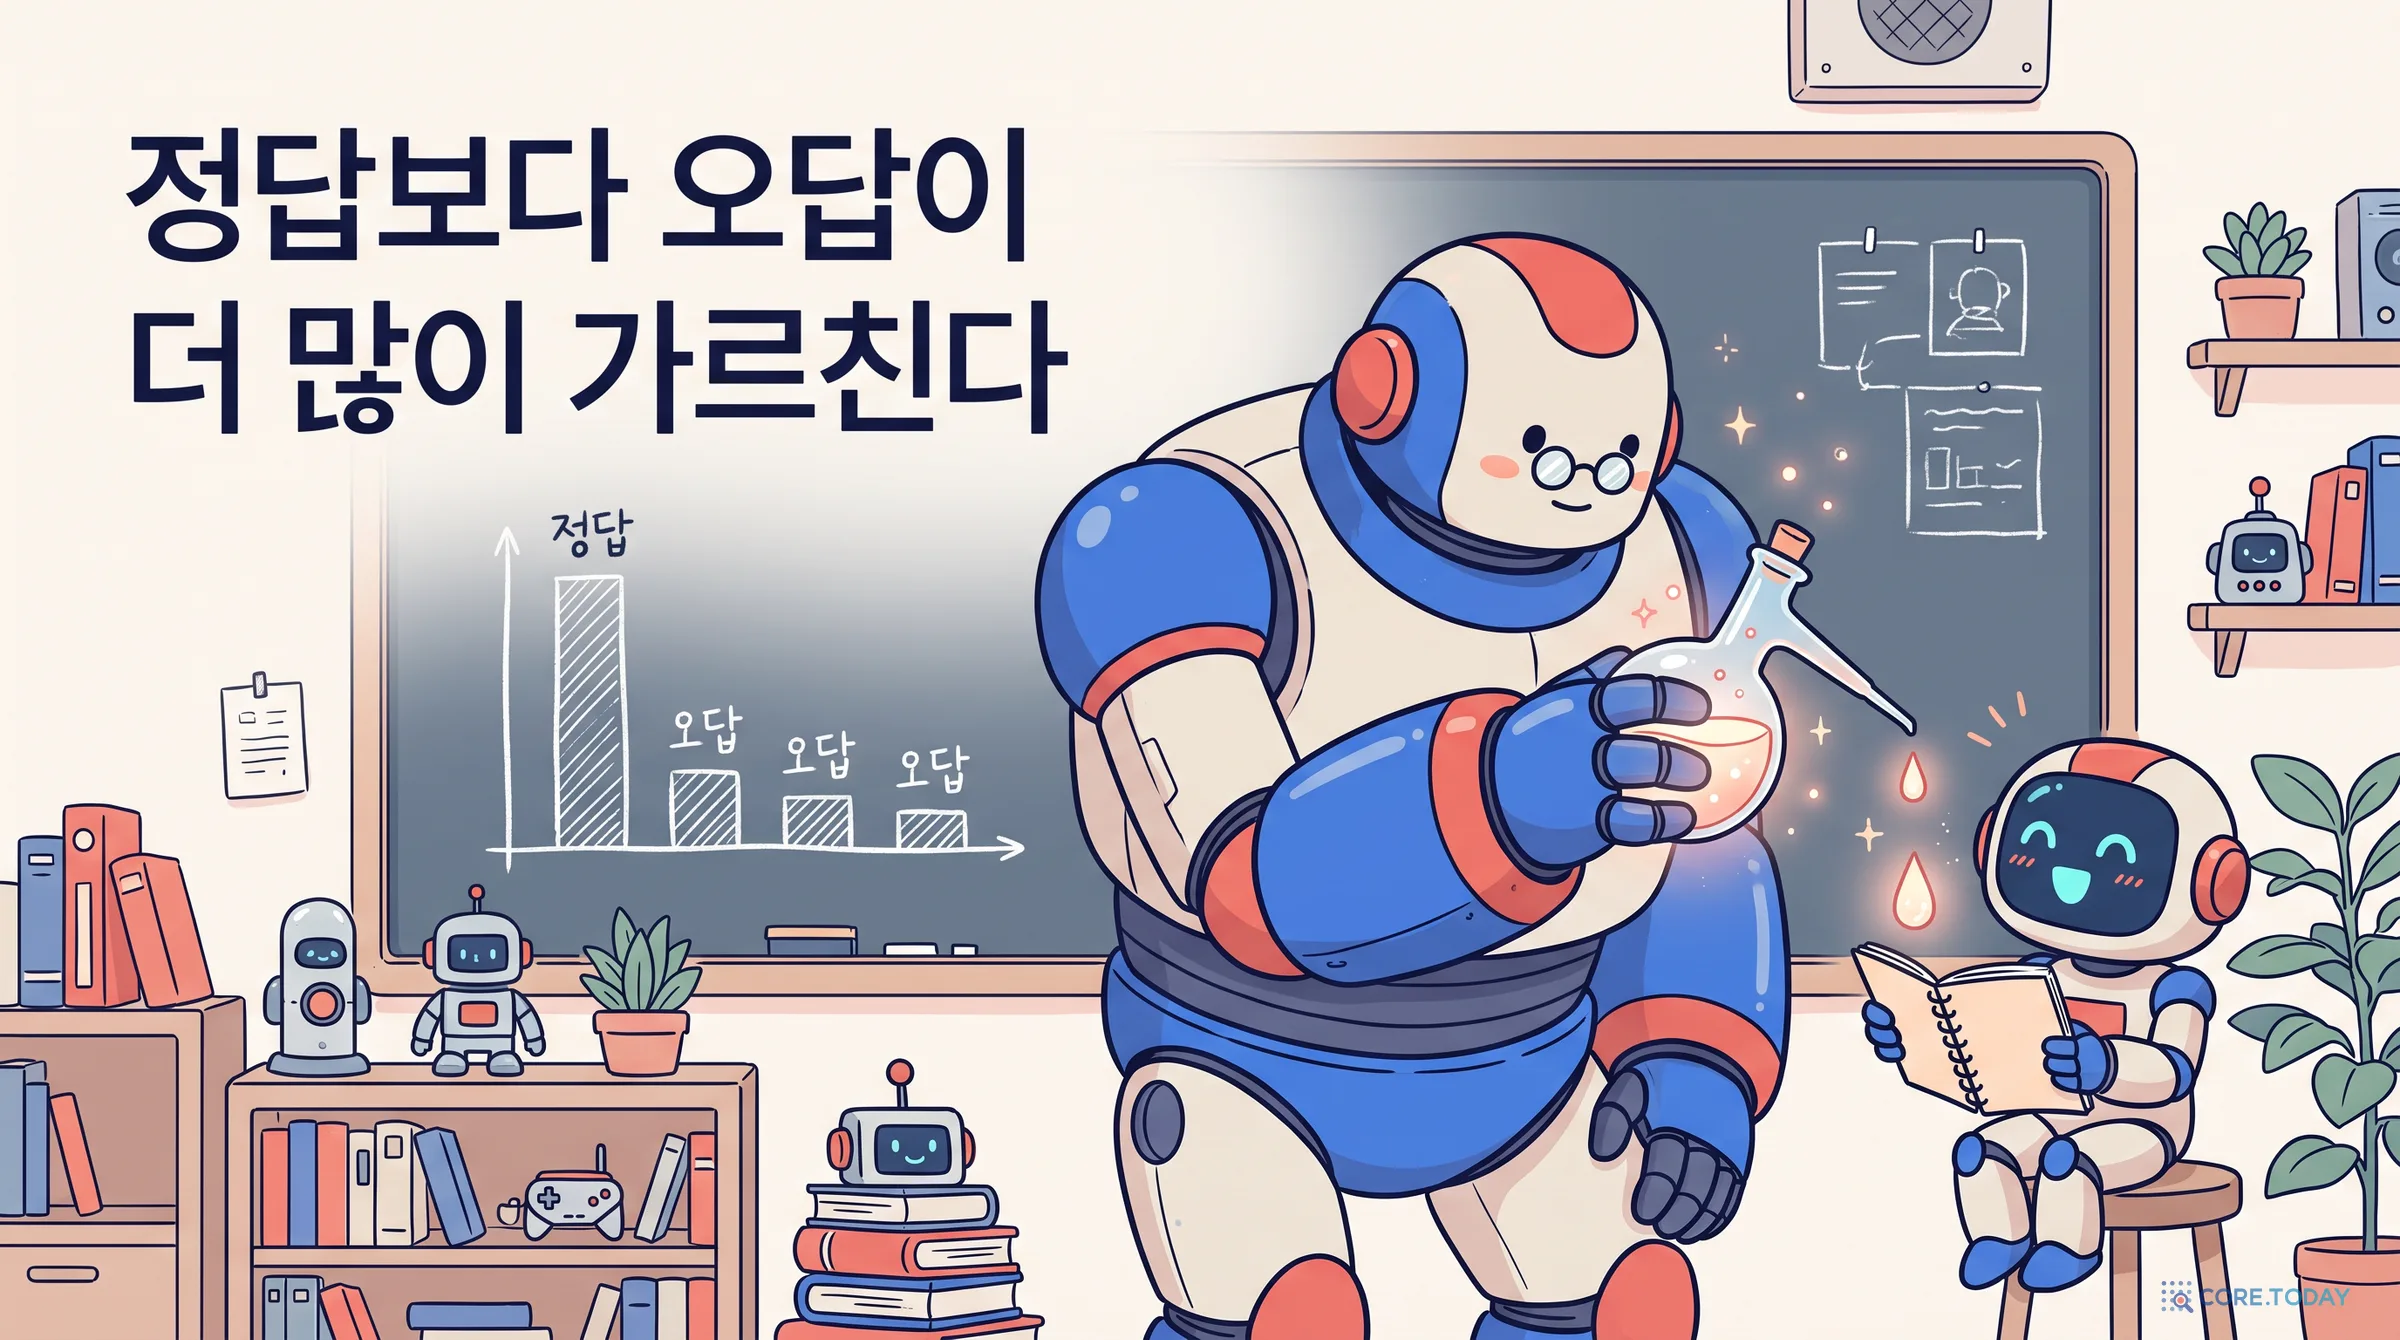
정답보다 오답이 더 많이 가르친다 — 지식 증류와 ‘어두운 지식’ (특집)
지식 증류는 큰 모델(교사)이 내놓은 확률 분포를 작은 모델(학생)이 따라 배우게 하는 기술이다. 2006년 앙상블 압축에서 출발해 2015년 힌턴·비냘스·딘이 ‘온도’와 ‘어두운 지식’이라는 이름을 붙였고 — 이 논문은 NeurIPS에서 떨어졌다 — 지금은 Gemma·Llama·Qwen 같은 작은 모델의 기본 공정이자 DeepSeek-R1 이후 추론 능력을 옮기는 방법, 그리고 2026년 ‘증류 공격’ 분쟁의 이름이 됐다. 이 글은 BMW와 쓰레기차와 당근의 비유로 어두운 지식을 설명하고, 힌턴의 MNIST 실험을 직접 재현해 숫자 3을 한 장도 보지 못한 학생이 3을 98.2% 맞히는 모습, 작은 학생에게 높은 온도가 독이 되는 이유, 라벨 1,000장과 교사 한 명이 라벨 1만 장보다 나은 결과를 보여 준다. Qwen3 형제 모델로 언어 모델의 소프트 라벨과 증류의 효과도 쟀다. 라벨 스무딩의 역설, 용량 격차, 모방의 거짓 약속, KL의 방향, 온폴리시 증류까지 짚고 실무 체크리스트로 마무리한다. 인터랙티브 위젯 6종, 코어닷투데이 실측 2건, 삽화 16장.
[특집] 학교는 손실 함수다 — 340만 명이 읽은 'AI 시대의 커리어 조언', 채점할 수 없는 일을 찾아서
2026년 7월 3일 새벽, 전 OpenAI·딥마인드 연구자 필 첸이 X에 올린 에세이 한 편이 주말 사이 300만 명을 넘게 읽혔다. 첫 문장은 이랬다 — 'AI는 손실 함수를 쓸 수 있는 모든 것에서 좋아진다. 그리고 학교는 대부분 손실 함수다.' 이 글은 그 한 문장을 끝까지 파고든다. 손실 함수와 '검증 가능한 보상'이 모델을 어떻게 가르치는지(DeepSeek-R1의 AIME 15.6%→71.0% 곡선, GRPO의 구조), 제이슨 웨이의 '검증자의 법칙'이 왜 커리어 예언이 되는지, 그리고 '문제 찾기·가장 야심찬 형태·마지막 10%·xG와 효율·연구 진입'이라는 여섯 조언이 1938년 아인슈타인부터 2025년 '탄광 속 카나리아'까지 어떤 생각의 계보 위에 서 있는지를 사례와 데이터로 풀었다. 리트코드를 옹호한 반론과 '문제 선정도 결국 채점 가능해지지 않느냐'는 날카로운 질문, 메타의 AI 동반 면접과 우버의 토큰 예산 소진, 네이버·카카오의 신입 공채 실종까지 — 2026년 가을, 한국의 독자가 이 글에서 무엇을 가져가야 하는지 다섯 개의 인터랙티브 도구와 함께 정리했다.
Vision-R1 특집: AI에게 '눈으로 보고 생각하는 법'을 가르치다 — 과잉사고의 함정부터 점진적 훈련까지
DeepSeek-R1이 텍스트에서 '생각하는 법'을 배웠다면, Vision-R1은 이미지를 보면서 생각하는 법을 배웠다. 하지만 그 과정에서 AI가 '쓸데없이 오래 생각하는' 과잉사고 문제에 빠졌다. ICLR 2026에서 발표된 이 논문이 제시한 점진적 사고 억제 훈련의 원리를, 일러스트와 인터랙티브 요소로 쉽고 깊게 풀어본다.
DAPO 완전 해부: DeepSeek-R1의 비밀을 풀어낸 오픈소스 강화학습의 모든 것
DeepSeek-R1이 강화학습만으로 AI에게 '생각하는 법'을 가르쳤다고 했지만, 핵심 레시피는 비밀이었다. DAPO는 그 비밀을 4가지 기법으로 풀어내고, 절반의 훈련 스텝으로 더 높은 성능을 달성한 뒤 모든 코드를 공개했다. 엔트로피 붕괴부터 동적 샘플링까지, 대규모 RL의 진짜 난관과 해법을 논문 기반으로 풀어본다.
DeepSeek-R1 특집: AI가 스스로 '아하!'를 외친 날 — 강화학습으로 추론 능력을 깨우다
SFT 없이 순수 강화학습만으로 수학 올림피아드 문제를 푸는 AI가 탄생했다. DeepSeek-R1은 OpenAI o1에 필적하는 추론 능력을 5백만 달러로 달성하며, NVIDIA 주가를 17% 폭락시키고, AI 산업의 상식을 뒤흔들었다. 그 안에서 일어난 일을 처음부터 풀어본다.