
#환각
9개의 포스트
‘23% 틀렸다’와 ‘4% 틀렸다’는 같은 받아쓰기다 — WER·CER, 한국어는 왜 글자로 재나 (특집)
WER(단어 오류율)과 CER(글자 오류율)은 음성 인식기의 받아쓰기를 채점하는 표준 성적표다. 정답과 받아쓰기를 나란히 놓고 대체·삭제·삽입의 수를 세어 정답 길이로 나눈다. 1965년의 편집 거리에서 출발해 1988년 DARPA 벤치마크에서 지금의 모습을 갖췄고, 2016년 ‘사람 수준’ 논쟁을 거쳐 지금도 모든 음성 인식 모델의 성적이 이 숫자로 매겨진다. 이 글은 한국어가 왜 단어가 아니라 글자로 재는지를 띄어쓰기와 어절에서 풀고, 공개 모델 Whisper 6종을 한국어 시험 세트 두 개로 직접 재서 어절 WER 22.6%와 CER 4.3%가 같은 받아쓰기에서 나온다는 것, 어절 오류의 64%가 띄어쓰기 차이라는 것, 숫자 표기 규칙 하나로 CER이 26% 달라진다는 것을 보여 준다. 무음에 뉴스 앵커의 인사를 지어내는 환각, 같은 점수 속의 다른 피해까지 따라간다. 인터랙티브 위젯 6종, 코어닷투데이 실측, 삽화 12장.
[특집] 본문에 없는 사실은 받지 않는다 — 앵커로 묶은 지식 그래프 추출 AEVS, 그리고 출처를 글자 단위로 다는 시대
LLM에게 문서에서 사실(주어·관계·목적어)을 뽑게 하면 '세상에서는 참이지만 본문에는 없는' 트리플이 섞입니다. 2026년 3월 MDPI Computers에 실린 AEVS는 본문에서 개체·관계구·값과 그 글자 위치를 먼저 찾아 '앵커'로 삼고, 트리플을 앵커로만 조합한 뒤, 원소마다 원문으로 되돌려 검증합니다. 세 데이터셋에서 학습 모델과 EDC를 넘었고, 남은 오류의 95% 이상은 개체가 아니라 관계였습니다. 다만 'EDC 대비 최대 +0.152'는 서로 다른 모델끼리의 비교였고(같은 모델이면 +0.007~+0.074), 공개 코드는 논문과 달리 셋 중 둘만 맞아도 통과시켜 논문 자신의 환각 예시를 모두 받아들였습니다. 코어닷투데이가 로컬 모델로 한국어 30문장과 WebNLG 20문장을 다시 돌려 보니, 스키마를 준 '그냥 묻기'에서는 환각이 나오지 않았고 AEVS는 한국어에서 오히려 재현율을 잃었습니다(F1 0.80 대 0.72). 그냥 묻기에서 스키마를 빼면 F1이 0.18로 무너져, 향상의 상당 부분이 스키마 몫일 수 있음을 보여 줍니다. 검증 LLM은 본문에 충실한 반사실 트리플을 '현실과 다르다'며 거부하기도 했습니다. 역사, 논문의 주요 그림과 표, 2026년의 '글자 단위 출처' 도구들까지 함께 읽습니다.
AI에게 '얼마나 확신해?'라고 묻지 마세요 — 0.85는 계기판이 아니라 문장이다
LLM에게 확신도를 물으면 언제나 그럴듯한 숫자가 나옵니다. 앰루트 조시의 짧은 글은 그 숫자가 측정이 아니라 '다음에 올 법한 글자'라고 지적해 해커뉴스 첫 화면에 올랐습니다. 1950년 브라이어의 일기예보 채점에서 2017년 '현대 신경망은 과신한다', GPT-4의 RLHF 보정 붕괴, 2025년 '왜 언어 모델은 환각하는가'까지 확신도 연구 75년을 따라가고, 코어닷투데이가 대화형 모델 5개와 판정 모델 4개에 한국어 객관식 598문항과 SimpleQA 200문항을 직접 물어 확신도의 정체를 쟀습니다. 작은 모델은 '정말?' 한마디에 답의 55%를 뒤집으면서 확신도를 91에서 95로 올렸고, 앞에 쓴 한 문장에 확신도가 53점 움직였습니다. 반면 GPT-6.1 Sol과 Claude Sonnet 5.5의 숫자에는 분명한 정보가 있었는데, 같은 '90'이 모델마다 다른 뜻이었습니다. 판정 모델과 기록 기반 규칙이 내놓는 확률까지 비교합니다. 인터랙티브 6개와 삽화 10장, 논문 그림 6장.
임베딩은 '아니다'를 못 읽는다 — Jev를 RAG 환각 검문소에 세우다 (한국어 검색 스택 7편)
임베딩 모델은 '매출이 30% 늘었다'와 '매출이 30% 줄었다'를 거의 같은 문장으로 봅니다. 검색에는 맞는 판단이지만, RAG 답변의 마지막 관문에서는 치명적입니다. 이 글은 6편에 이어 TypeSafe의 Jev를 한국어 검색 파이프라인의 새 자리, 답변 뒤의 '환각 검문소'에 세웁니다. 코어닷투데이 블로그 문단 87개로 참 주장 257개와 숫자·방향·주체를 바꾸거나 없는 사실을 덧붙인 거짓 주장 344개를 만들고, 임베딩 둘·크로스 인코더·NLI 모델·로컬 LLM 둘·Jev에게 같은 601쌍을 판정시켰습니다. 참 주장의 90%를 통과시키는 임계값에서 BGE-M3 코사인은 숫자를 바꾼 거짓의 3%만 잡았고, Jev는 100%를 잡았습니다(AUROC 0.995). 0.3B NLI 모델이 의외의 복병이었고(0.959), 숫자를 1만 바꿔도 잡던 Jev는 문서의 숫자로 계산해야 하는 주장에서 약해졌습니다. 601번 검문에 0.021달러. 인터랙티브 7개와 삽화 8장.
[특집] AI 때문에 두 번째 뇌를 만들었다 — '이해를 위임하지 마라'의 역사, 과학, 그리고 2026년
AI 회의론자인 한 개발자가 챗봇에게 '2>&1이었나 2&>1이었나'를 묻다가, 존재하지 않는 플래그를 자신 있게 알려 주는 답을 받고 개인 노트 볼트를 만들기로 결심했습니다. 2026년 9월 화제가 된 글 'Clankers Made Me Build a Second Brain'을 출발점으로, 플라톤의 『파이드로스』에서 1945년 메멕스, 9만 장의 카드를 남긴 루만의 제텔카스텐, 2026년 카파시의 LLM 위키까지 '생각을 밖에 적어 두는 2,400년의 역사'를 따라가고, 생성 효과·구글 효과·인지 부채 연구로 '왜 직접 써야 남는가'를 따져 봅니다. 두 번째 뇌가 생산성 연극으로 변하는 순간과, AI와 함께 쓰되 이해만은 넘기지 않는 방법까지 정리했습니다.
AI는 왜 미해결 수학은 풀면서 환불 처리는 못 맡기나 — RLHF 다음은 무엇인가
InstructGPT를 만든 사람이 18분 동안 무대에서 한 이야기는 이것이다. 'AI가 벤치마크를 다 부수는데 왜 고객센터는 아직 사람이 결정하나?' 그의 답은 난이도가 아니라 목표에 있다 — 오늘의 AI는 전부 사람의 선호를 최적화하도록 만들어졌고, 그래서 사람 옆에서는 경이롭지만 사람 없이는 못 미덥다. 이 글은 그 논리를 처음부터 끝까지 따라가고, GPT-4 기술 보고서가 남긴 결정적 증거(후학습이 보정을 10배 망가뜨렸다)를 실측 수치로 다시 그린다. 인터랙티브 위젯 7종과 삽화 12장. 그리고 과장하면 안 되는 지점도 함께 짚는다.
AI가 실험실에 들어왔다 — 구글 Co-Scientist가 진짜 물질을 만들어낸 과정
AI가 논문을 '쓰는' 시대는 이미 왔다. 그런데 실제로 존재하지 않는 실험 결과를 쓰는 게 문제였다. 구글 딥마인드가 83쪽 논문으로 답한 것 — 화학 증착로를 직접 제어해 새 2D 결정을 만들고, 대장균 군집 모양을 예측하고, 스스로 발견한 의료 에이전트로 프런티어 모델 6종을 이겼다. 그리고 전문가 30명의 450건 리뷰로 '조작 90% → 4%'를 증명했다.
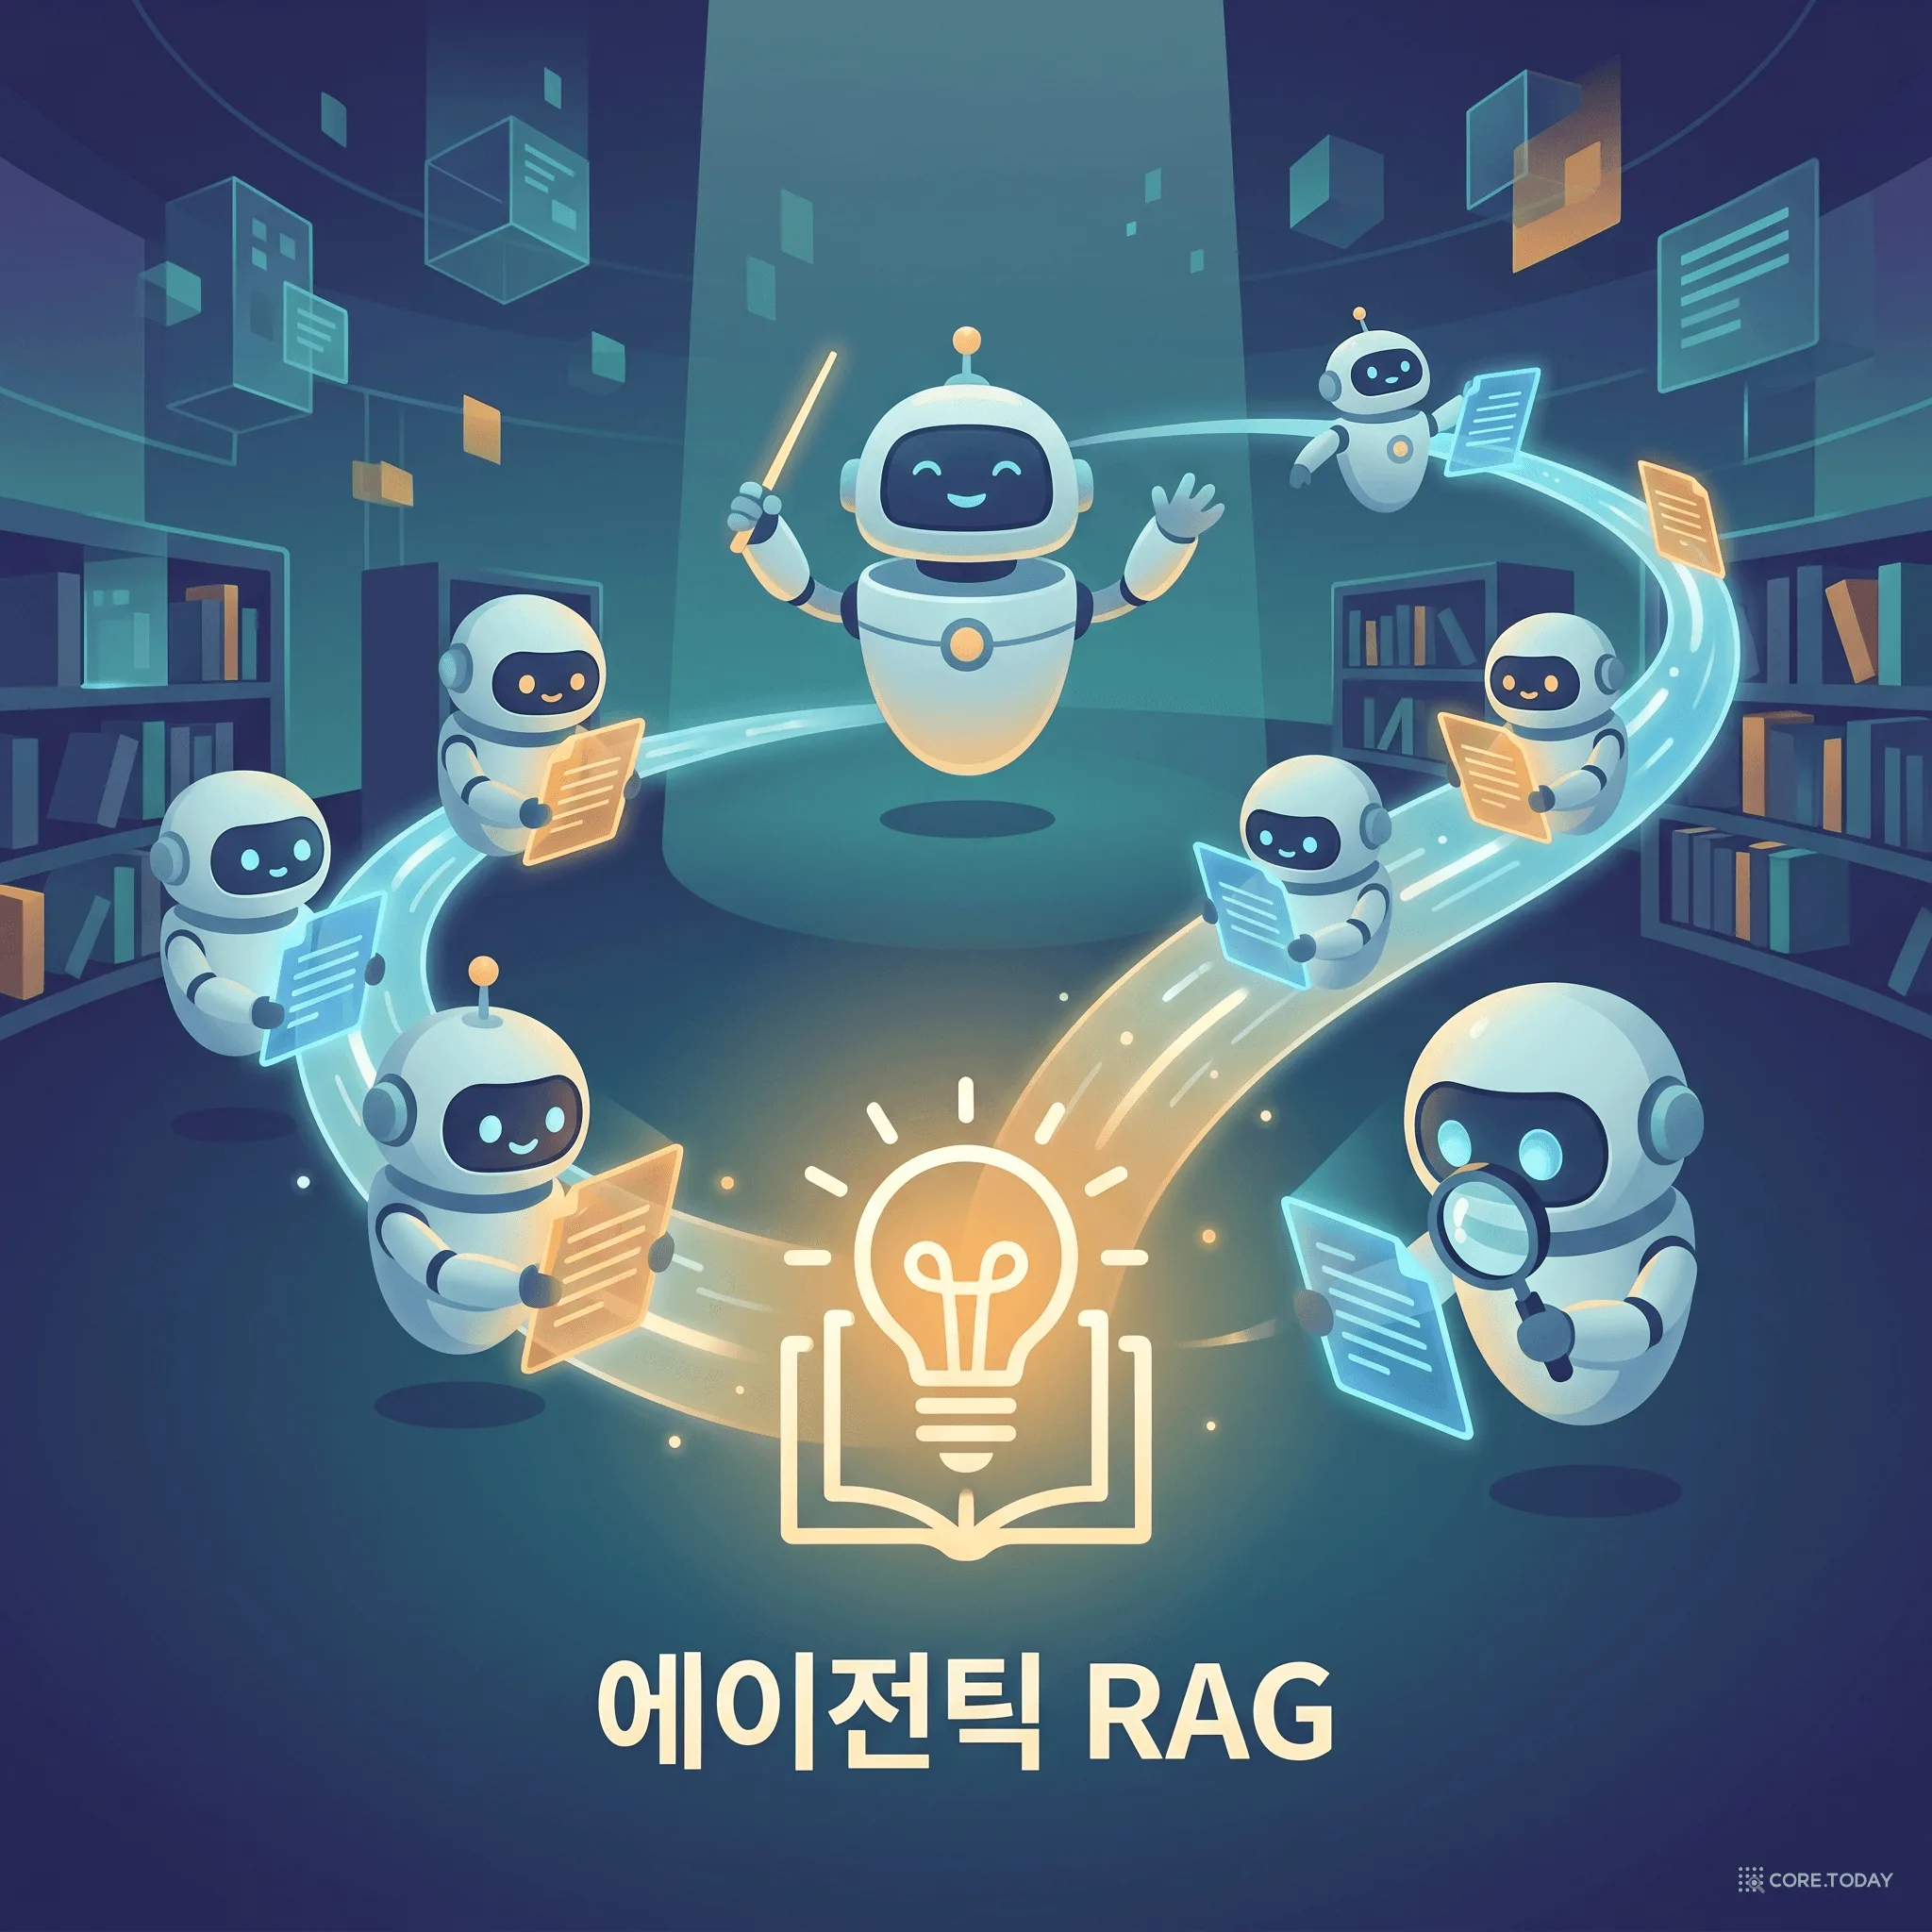
AI 사서 7명이 협업한다 — Google의 Agentic RAG가 '믿을 수 있는 답'을 만드는 법
한 번 검색하고 답하는 RAG는 여러 데이터베이스에 흩어진 질문 앞에서 무너진다. Google이 Gemini Enterprise에 넣은 Agentic RAG는 7명의 전문 에이전트가 '계획 → 검색 → 충분성 검증 → 재검색 → 합성'을 반복해 답을 만든다. 왜 이 구조가 나왔는지 ReAct부터의 역사와 논문, 병원·기업 사례, FRAMES 벤치마크(정확도 34%↑)로 쉽고 자세하게 풀었다.
RAG 완전 이해: LLM은 왜 거짓말을 하고, 검색은 어떻게 이를 바로잡는가
1000권을 외운 천재가 왜 어제 환율을 틀리는지, 그리고 '답하기 전에 먼저 찾아봐'라는 단순한 아이디어가 어떻게 AI의 가장 중요한 아키텍처 패턴이 되었는지를 논문과 사례로 풀어본다.