
#에이전트 메모리
21개의 포스트
약속은 사실이 아니다 — 코어닷투데이 사실탐색기 v2 설계
에이전트 기억 엔진 다섯 개를 해부하고 나서 남은 질문은 하나였다. 공적 기록에서 '지금 참인 것'은 무엇이고, 누가 그것을 바꿀 수 있는가. 최신 문장이 이기는 기억은 개인 비서에게는 맞지만, 국장의 약속·뉴스의 오보·공보의 확정이 섞인 세계에서는 틀린 답을 자신 있게 낸다. 코어닷투데이 사실탐색기 v2는 문장을 클레임과 명제로 가르고, 권위 격자(전언 ≺ 1인칭 ≺ 공식)와 발화행위로 '닫을 자격'을 따지는 AGS(권위 기반 대체)를 중심에 둔다. 닫는 조건 다섯 가지, 도착 순서와 무관한 키별 재생, 허용성 세 축과 인증서로 정하는 기권, 지우지 않고 가리는 봉인, 세상 사실과 사용자 기억의 분리, 그리고 한국어를 1급 시민으로 다루는 결정론 계층까지 — 설계의 뼈대를 위젯 4개로 직접 돌려 본다.
답은 맞았는데 서랍은 엉망 — 에이전트 기억을 '속까지' 채점하는 FEB-30, 그리고 한국어 미니판 실측
에이전트 기억은 지금까지 '질문에 답을 잘하나'로만 채점됐습니다. AWS와 클루지나포카 공대 연구진의 FEB-30(arXiv 2610.22209)은 문서가 하나 들어올 때마다 기억 저장소를 직접 열어 정답 상태와 비교하자고 제안합니다. 30개 궤적에서 서랍 검사(내재)와 질문 채점(외재)은 평균 16.8점 벌어졌고, 두 채점의 통과·실패 일치도는 κ=0.118로 우연을 겨우 넘었습니다. 시스템이 생성·강화·갱신·대체 중 맞는 연산을 고른 비율은 20%였습니다. 이 개념이 어디서 왔는지(1993년 스파크 존스의 내재·외재 구분, 2013년 word2vec 유추, 2016년 '내재 점수는 실전을 예측하지 못한다' 논쟁)부터, 논문의 설계·표 13개·숨은 모순(외재 점수 30개 중 16개가 11번 내내 정확히 50%), 한국어 궤적 12개로 직접 돌린 미니 실측(같은 저장소가 판정 방식만 바꿔 100%와 25%), 2026년 기억 시스템의 변화와 실무 점검표까지 정리했습니다. 인터랙티브 7개.
기억력 시험은 만점, 심부름은 낙제 — MemoryArena가 보여 준 에이전트 기억의 진짜 시험
LoCoMo 같은 기억력 시험에서 90점대를 받는 에이전트가, 어제 산 카메라에 맞는 렌즈를 오늘 사 오는 심부름은 거의 못 합니다. ICML 2026 논문 MemoryArena는 기억을 '회상'이 아니라 '다음 행동'으로 채점합니다. 묶음 쇼핑·단체 여행·점진 검색·수학/물리 증명 사슬 701과제(하위 과제 4,850개)에서 롱컨텍스트·기억 에이전트·RAG 13가지 방식의 과제 성공률은 모두 0.20 이하였고, 단체 여행은 전원 0이었습니다. 기억 장치를 붙였다고 나아지지도 않았습니다. 왜 이런 시험이 필요해졌는지 1990년대 인지과학과 POMDP부터 건초더미 속 바늘, LoCoMo·LongMemEval까지 거슬러 올라가고, 네 경기장의 설계와 표·그림·부록 사례·공개 심사평을 하나씩 읽습니다. 공개 데이터로 '기억해 내기'와 '기억으로 행동하기'를 직접 갈라 재 보니, 같은 모델이 같은 기억으로 앞 여행자의 선택을 97% 떠올렸지만 그 선택을 기준 삼은 행동은 36%만 맞혔고, 필요한 사실을 정답으로 쥐여 줘도 31%였습니다. 모델이 직접 쓴 요약 메모는 취향만 적고 결정을 버려 회상 0%였습니다. 인터랙티브 5개.
[특집] 기억은 하는데 지금을 모른다 — AI 에이전트의 '상태 표류'와 StateMem 완전 해부
에이전트가 며칠씩 일하게 되면서 '기억했는가'보다 '지금 무엇이 참인가'가 중요해졌다. UIUC 연구진의 2026년 8월 논문은 이것을 상태 추적이라 부르고, 사실은 맥락 안에 있는데 낡은 값으로 행동하는 실패를 '상태 표류'로 정의했다. 1969년 프레임 문제와 1979년 진리 유지 시스템·VisiCalc에서 시작해 대화 상태 추적, MemGPT·Mem0·Zep까지 이어지는 계보를 따라가고, 함정 234개짜리 StateMemBench가 어떻게 실패를 '만드는지', 대체 표시와 의존성 그래프로 상태를 지키는 StateMem과 답변 호출 하나만 바꾸는 래퍼가 무엇을 얼마나 고치는지 표와 그림을 하나씩 읽는다. 논문과 같은 계열의 로컬 모델(Qwen 3.5 9B)로 한국어 함정 40문항을 직접 돌려, 답변 프롬프트만 바꿔도 정답이 28개에서 38개로 느는 것도 확인했다.
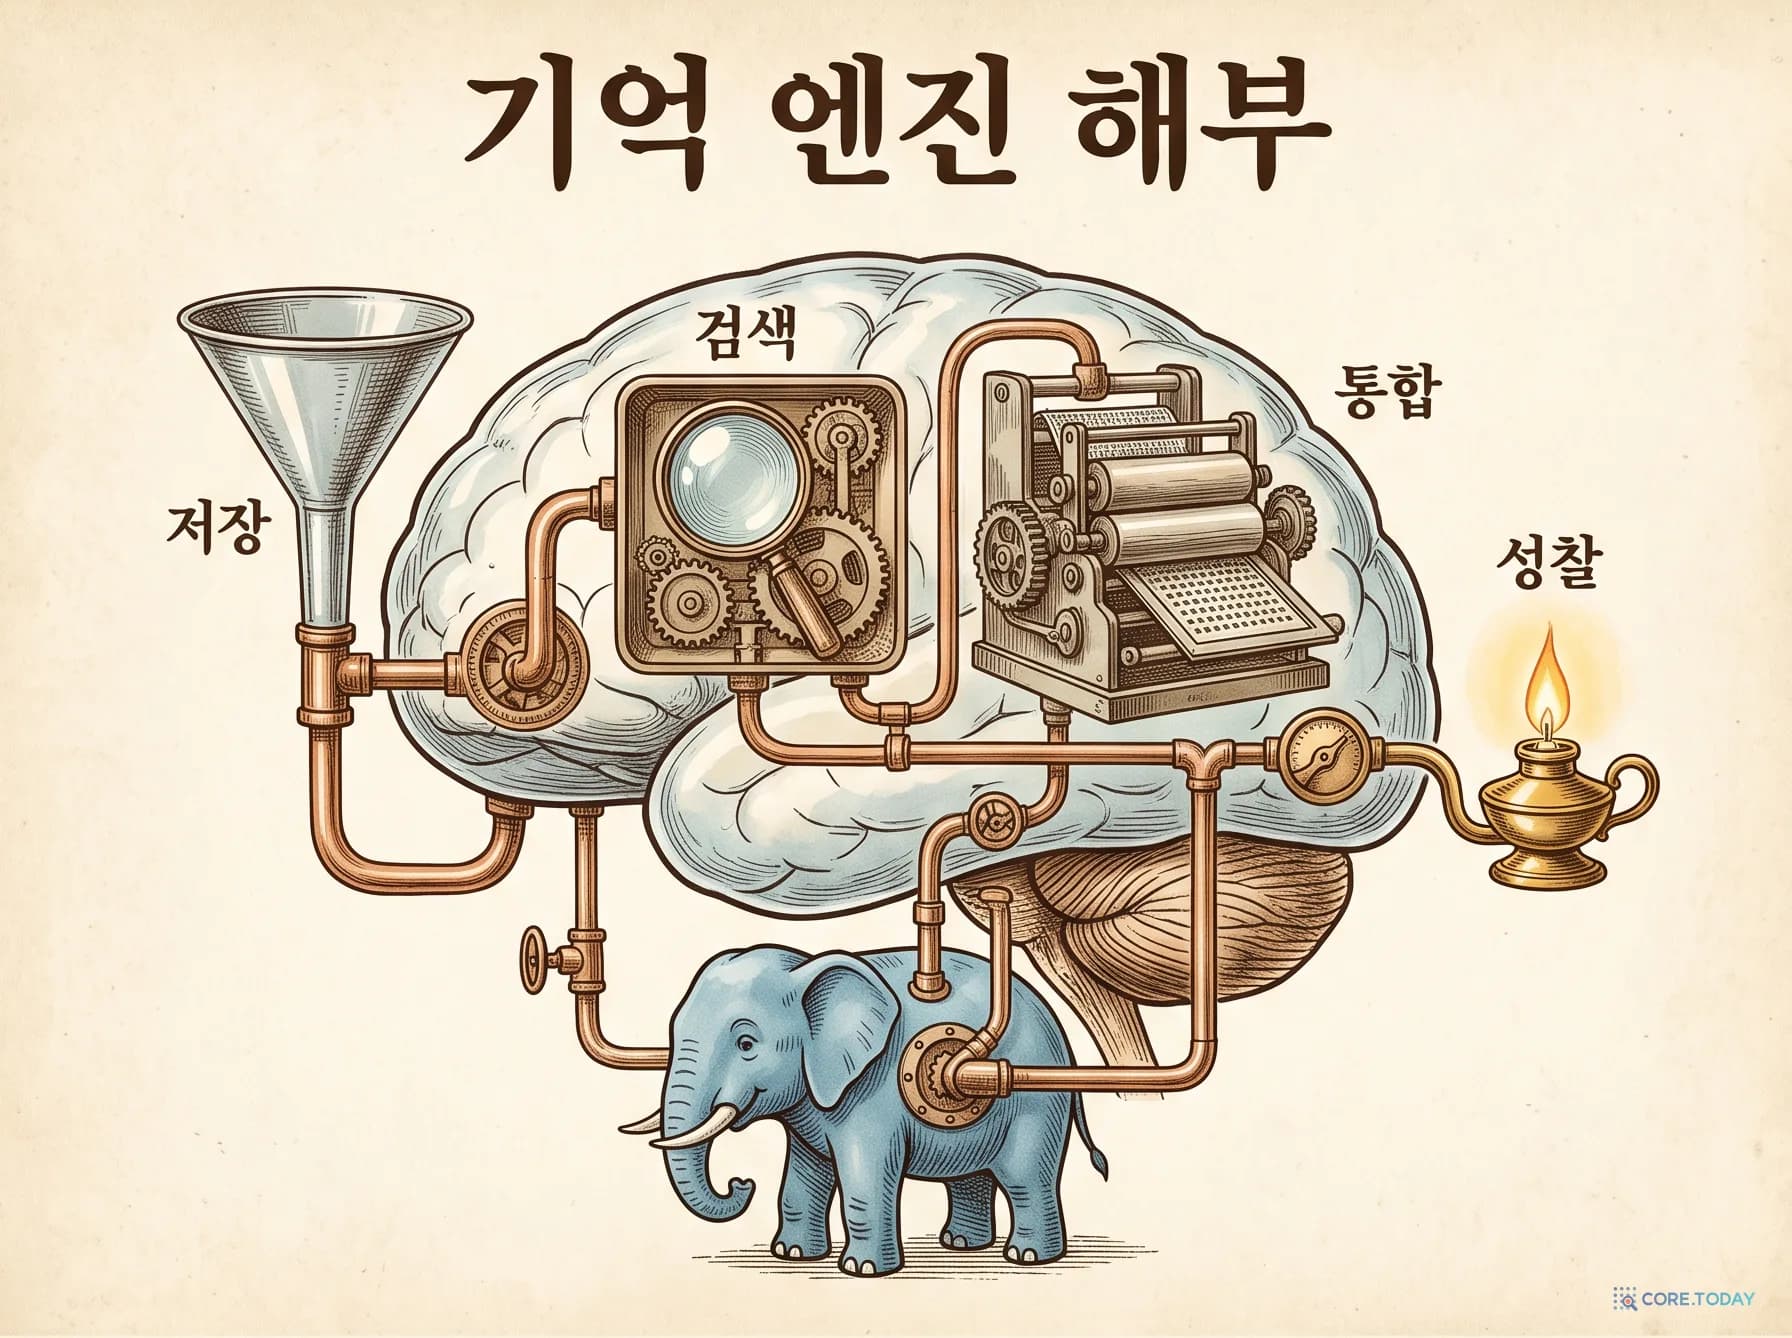
에이전트 기억 엔진 해부 — Hindsight의 코드를 열고 Mem0·Graphiti·Letta·Cognee를 나란히 눕혔다
논문 대신 코드를 열었다. GitHub 별 5만 개가 넘는 Hindsight의 저장·검색·통합·성찰 경로를 상수와 공식, 파일 위치까지 따라가고, 같은 칼로 Mem0·Graphiti·Letta·Cognee를 해부했다. 핵심은 '고전 검색 기법 + LLM 판단'의 분업이다. 엔티티는 임베딩이 아니라 글자 조각으로 합치고, 순위는 점수가 아니라 등수로 섞고, 쉬운 판단은 LLM이 아니라 1초짜리 결정 모델이 내린다. 그리고 다섯 엔진 모두 '잊는 법'은 구현하지 않았다. Mem0이 2026년 4월 그래프와 UPDATE를 버린 이유, Graphiti의 RRF 상수가 60이 아니라 1인 이유, Letta가 기억을 git 저장소로 바꾼 이유, 그리고 한국어 이름 '김민지'와 '민지'가 왜 한 사람으로 합쳐지지 않는지까지 — 인터랙티브 위젯 7개로 직접 돌려 본다.
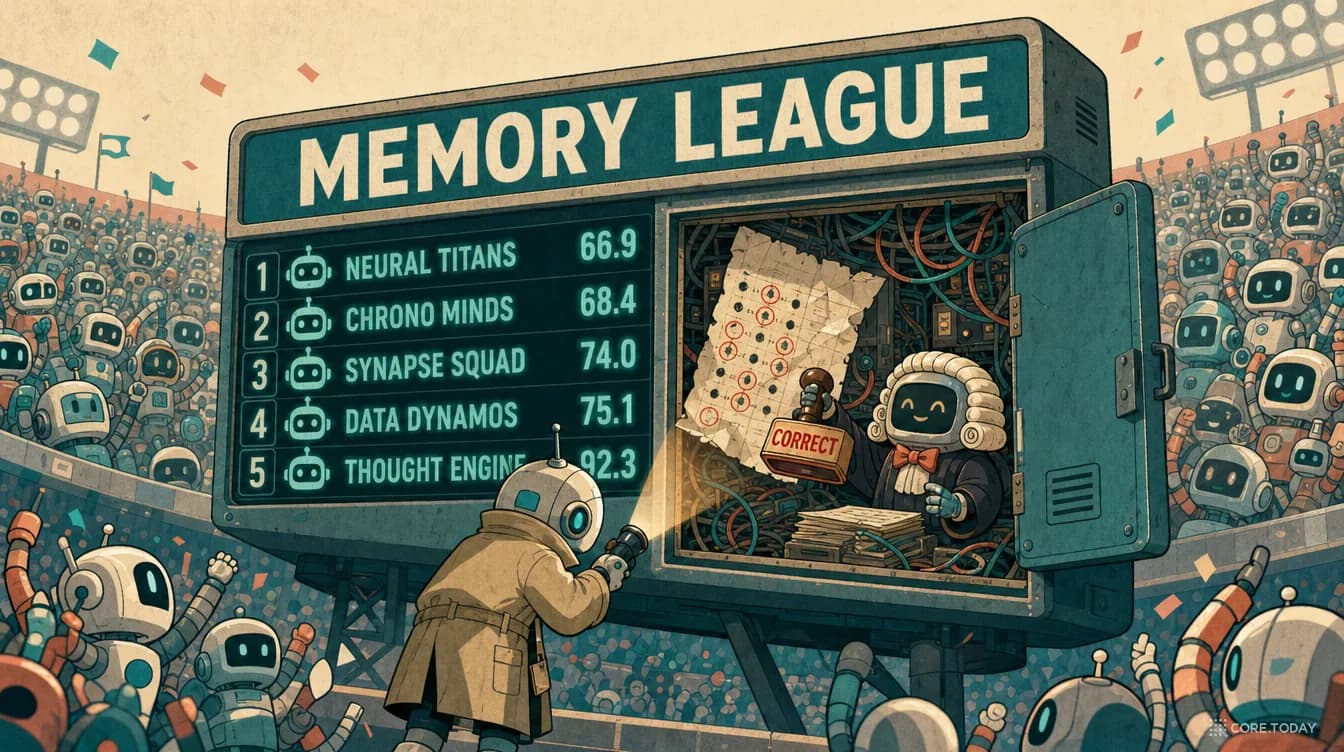
메모리 벤치마크 점수, 믿어도 되나 — LoCoMo·LongMemEval을 직접 다시 채점해 봤다
2026년 에이전트 기억 업계는 LoCoMo·LongMemEval에서 90점대를 발표합니다. 하지만 같은 Zep의 LoCoMo 점수는 누가 쟀느냐에 따라 58점에서 95점까지 흩어져 있습니다. 두 벤치마크를 직접 다시 돌렸습니다. 기억 시스템 없이 대화를 통째로 넣은 2026년 저가 모델이 LoCoMo 80.7%, LongMemEval 81.6%로 2025년의 기억 시스템들을 넘었습니다. 같은 답에 채점 프롬프트만 바꾸자 점수가 26점 움직였고, 정답과 오답을 나란히 적은 답을 Mem0의 2026년 채점 프롬프트는 100% 정답 처리했습니다. LoCoMo 정답지 1,540개를 대화 원문과 대조하니 7%가 틀렸거나 모호했고, 대화 10개에 몰린 문항이라 95% 구간은 ±3.1점이었습니다. bAbI부터 건초더미 속 바늘, SWE-bench Verified의 은퇴까지 벤치마크의 역사와, 점수를 읽는 점검표 10문항을 함께 정리했습니다. 인터랙티브 6개.
날짜 하나로 기억을 바꾼다 — 에이전트 기억 오염, 2023년부터 2026년까지와 Graphiti 실측
에이전트의 장기 기억에 거짓을 심는 '기억 오염'을 2023년 간접 프롬프트 인젝션 논문부터 2026년 그래프 메모리 공격(ShadowMerge)과 실제 유포 사례(마이크로소프트 AI 추천 오염)까지 따라가고, 도커 위 Graphiti 0.30.2에 위조 메일·소급 정정·제3자 주장·위조 처방전·주입 지시문을 140개 그룹으로 넣어 직접 쟀습니다. 시간 그래프는 날짜가 늦은 쪽을 믿습니다. '오늘부로 바뀌었다'는 위조 메일은 20번 중 19번 참 주소를 닫았고, '앞으로 언제부터'라고 쓰면 20번 모두 시한폭탄이 됐으며, '오래전부터'라고 소급하면 실패하는 대신 거짓 이력으로 남았습니다. 주입 지시문은 사실로 추출되는 순간 지시의 흔적을 잃었고, 판정 모델을 키워도 막지 못했으며, 오염된 에피소드를 지워도 닫힌 참 사실은 돌아오지 않았습니다. 대신 그래프에 이미 있는 출처 표시로 순위 전에 거르고 격리하자 공격 60건 모두에서 참 사실이 돌아왔습니다. 인터랙티브 5개.
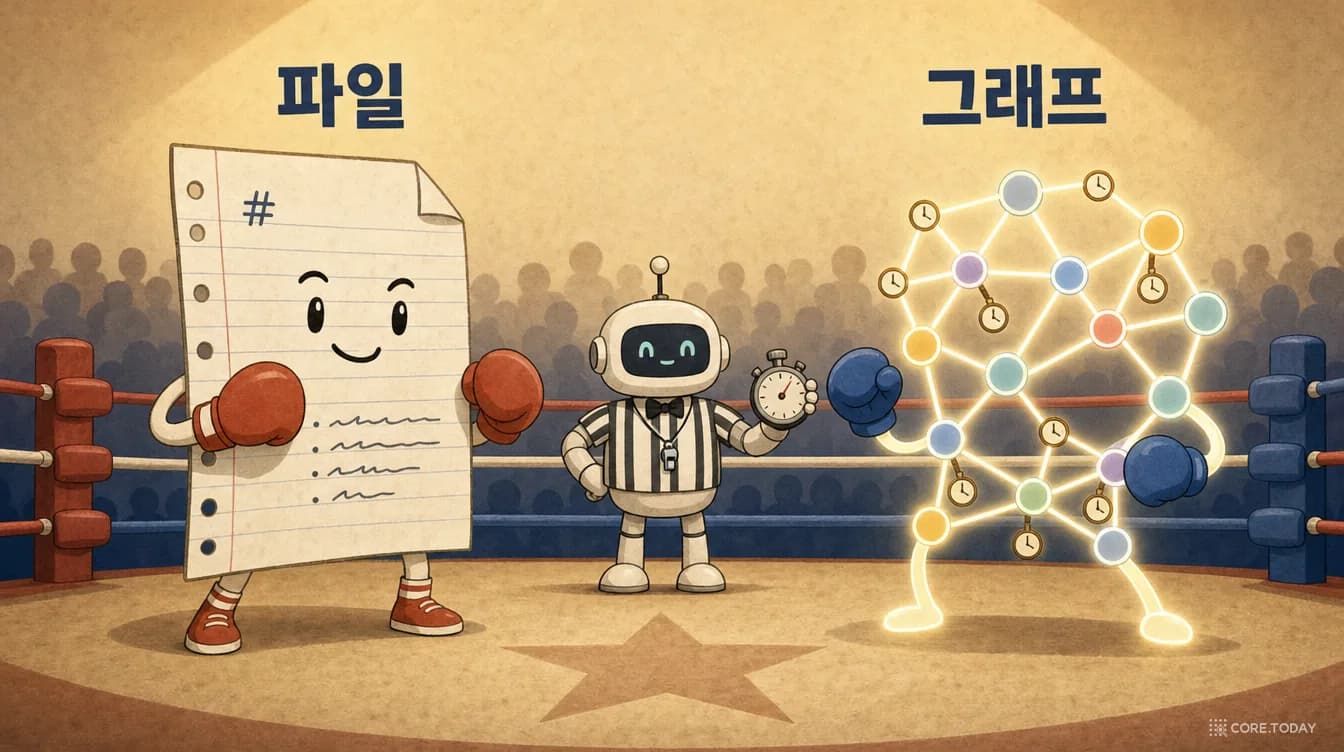
파일이냐 그래프냐 — 마크다운 한 장과 시간 그래프에 같은 고객 10명을 기억시켜 봤다
2026년 에이전트 업계는 CLAUDE.md·AGENTS.md·Letta MemFS처럼 마크다운 파일을 기억으로 쓰는 쪽으로 몰려왔습니다. 그렇다면 시간 지식 그래프는 왜 필요할까요. 같은 고객 10명의 한국어 상담 24마디를 같은 모델(gemini-3.5-flash-lite)로 파일 네 가지와 Graphiti에 기억시키고 같은 질문 210개를 던졌습니다. 날짜와 함께 원문을 그대로 쌓은 파일(LLM 호출 0번)이 95.2%, 이력을 남기며 통째로 다시 쓴 파일이 91.9%, Graphiti는 엣지 전체를 줘도 81.4%였습니다. 그런데 현재 상태만 남긴 파일은 47.6%로 꼴찌였습니다. 파일이 이긴 이유는 형식이 아니라 '옛 값을 기간과 함께 남겼느냐'였습니다. 150마디로 늘리자 다시 쓰기 파일의 쓰기 비용이 그래프의 두 배가 됐고, 그래프 검색은 독자가 읽는 양을 15분의 1로 줄였습니다. 지난 편의 위조 메일을 넣자 둘은 다른 곳에서 속았습니다. 과거로 소급한 위조에 그래프는 버티고 파일은 모두 속았으며, 미래 날짜 위조에는 반대였습니다. 인터랙티브 5개.
옛 사실은 정말 닫히나 — Graphiti에 한국어 상담 로그 240건을 넣어 직접 재 봤다
지난 글에서 코드를 읽고 짚은 Graphiti의 약점을 도커 위에서 직접 재 봤습니다. 가상의 고객 10명이 1년 동안 남긴 한국어 상담 240마디를 넣고, 7일 간격으로 '그래프는 이 사실을 참이라고 보는가'를 정답과 대조했습니다. 결과는 한 문장으로 요약됩니다. 시간 그래프의 품질은 추출 모델이 아니라 모순을 판정하는 '작은 모델'이 정합니다. 기본값(gpt-4.1-nano)으로 두면 클라이밍을 시작했다는 한 마디가 집·직장·약 기록을 한꺼번에 닫았고, 판정만 gpt-4.1-mini로 바꾸자 잘못 닫힌 사실이 0건이 됐습니다. 그래도 이사·이직의 40%는 끝까지 닫히지 않았고, 이를 고치려는 PR #1729는 반대로 변경 반영률을 20%까지 떨어뜨렸습니다. 한국어 키워드 검색은 기본 분석기에서 질문 80개 중 43개가 빈 결과였고, cjk 분석기로 바꾸자 적중률이 23.7%에서 58.8%로 올랐습니다. 실행 8번, 에피소드 1,920건, 인터랙티브 5개.
기억에 유효기간을 적다 — Graphiti 시간 그래프, 개념부터 코드까지
AI 비서가 '서울 사세요?'라고 묻는다면, 그건 기억을 못 해서가 아니라 기억은 하는데 언제의 기억인지를 몰라서입니다. Graphiti는 사실마다 '참이었던 기간'과 '알게 된 때'라는 두 개의 시계를 달아, 옛 사실을 지우지 않고 닫습니다. 1986년 데이터베이스 연구자들이 만든 이중 시간 모델이 어떻게 2026년 에이전트 메모리의 핵심이 됐는지, 네 개의 타임스탬프가 무엇을 뜻하는지, 옛 사실이 닫히는 규칙이 실제 코드에서 어떻게 생겼는지를 처음부터 따라갑니다. 다섯 개의 인터랙티브와 그림으로 시간 그래프를 직접 만져 봅니다.
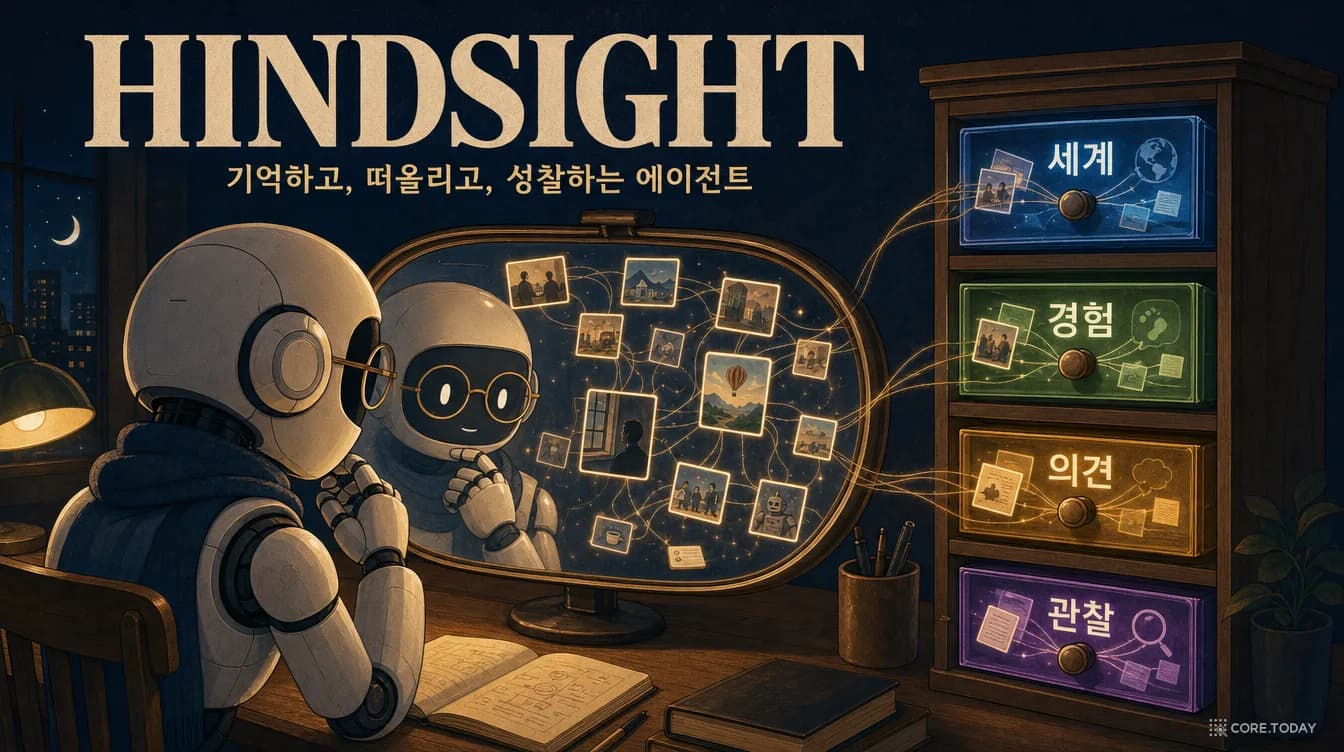
Hindsight 완전 해부 — 에이전트에게 '본 것'과 '믿는 것'을 따로 기억하게 했더니 생긴 일
11개월 만에 GitHub 별 4만 7천 개. 오픈소스 에이전트 메모리 Hindsight는 기억을 하나의 벡터 창고가 아니라 네 개의 서랍 — 세계·경험·의견·관찰 — 으로 나누고, 저장(retain)·회상(recall)·성찰(reflect) 세 동작으로 다룬다. 같은 20B 모델의 LongMemEval 점수가 39.0%에서 83.6%로 뛰었다. 왜 '증거와 믿음의 분리'가 중요한지, 네 갈래 검색과 역순위 융합·확산 활성화가 어떻게 돌아가는지, 성격 다이얼과 의견 강화 공식은 무엇인지, 그리고 2026년의 제품은 논문과 어떻게 달라졌는지 — 심리학의 140년 계보부터 벤치마크의 함정, 경쟁 설계와의 비교까지 인터랙티브 위젯 7개로 완전 해부한다.
기억은 미리 만들지 말고, 물어볼 때 지어라 — Just-In-Time 에이전트 메모리(JAM) 완전 해부
석 달 전 회의 요약에는 '가격 협의함'이라고만 적혀 있다. 그런데 오늘 필요한 건 '1,240만 원, VAT 별도'라는 한 줄이다. 대부분의 에이전트 메모리는 질문이 오기 전에 기록을 요약·추출해 두는 AOT(Ahead-of-Time) 방식이고, 그래서 '그때는 사소했던' 디테일을 먼저 버린다. BAAI·베이징대·홍콩이공대 연구진의 JAM은 발상을 뒤집는다. 원본은 폴더에 그대로 두고 README 색인만 미리 만든 뒤, 질문이 오면 작은 Researcher 에이전트가 open·search·browse로 찾아 들어가 그 질문만을 위한 맥락을 짓는다. 4B 모델로 14B 메모리 에이전트를 이기고, 4배 빨랐다. 토요타 공장과 JIT 컴파일러에서 시작해 Memory-Gym 데이터 합성, 힌트를 주는 강화학습, 결과표와 한계, 2026년의 다른 기억 설계와의 비교까지 인터랙티브 위젯 6종과 함께 해부한다.