
#양자화
13개의 포스트
새 판정 모델, 한국어로 다시 재다 — StartLux·d3·Perplexity Decider·AutoTrust JEV·Liquid d1
StartLux가 0.8B부터 27B까지 모든 크기에서 동급보다 7.4~16.9점 앞선다는 그림을 냈고, d3·Perplexity Decider·AutoTrust JEV·Liquid d1이 잇달아 Ollama에 올라왔습니다. 코어닷투데이는 새 판정 모델 15가지 구성을 11월 1일과 같은 한국어 2,221문항과, 사실탐색기의 부산 공공기록으로 새로 만든 사실 탐색 1,449문항에 올렸습니다. 한국어에서 StartLux가 동급을 뚜렷하게 앞선 곳은 0.8B(+6.9점)뿐이고, 4B는 +1.5점, 2B·9B·27B는 d3와 겹쳤습니다. 게시판의 비공개 시험을 합친 총점에서도 StartLux의 공개분 우위는 크게 줄었습니다. Ollama의 d3는 8비트 포장에도 원본과 0.4점 안쪽으로 같았고, 사실 탐색에서는 d3:27b와 StartLux 27B가 87점대로 맨 위였습니다. 판정 모델의 문턱을 라벨로 고르면 값 비교는 모든 모델이 완벽했고, 남은 어려움은 ‘본문에 이유가 적혀 있는가’를 묻는 부재 검문 하나였습니다.
말할수록 무거워지는 기억 — KV 캐시로 본 긴 대화의 비용, 2017년의 첫 캐시부터 GQA·페이지드 어텐션·MLA·어텐션 싱크까지 (특집)
챗봇과의 대화가 길어질수록 답이 느려지고 요금이 오르는 이유는 KV 캐시에 있다. 언어 모델은 한 토큰씩 글을 쓰는데, 앞서 읽은 모든 토큰의 ‘키(K)’와 ‘값(V)’을 메모리에 쌓아 두고 다시 꺼내 쓴다. 계산을 메모리와 맞바꾼 이 장치 덕분에 생성은 빨라졌지만, 대신 대화가 길어질수록 GPU 메모리를 정직하게 잡아먹는다. 이 글은 2017년 원조 트랜스포머 논문에는 없던 캐시가 석 달 뒤 구글 코드에 들어간 이야기에서 시작해, 헤드를 나눠 쓰는 MQA·GQA, 캐시를 압축해 담는 딥시크의 MLA, 운영체제의 가상 메모리를 빌려 온 페이지드 어텐션, 같은 앞부분을 재사용하는 프롬프트 캐싱, 캐시를 2비트로 줄이는 양자화, 그리고 모델이 첫 토큰을 ‘주의 하수구’로 쓴다는 어텐션 싱크까지 따라간다. 그리고 직접 쟀다. 사내 V100에서 Qwen3 0.6B~8B의 캐시 크기와 속도, 동시 사용자 한계, 앞부분 재사용 효과, 캐시 양자화, 창 크기 제한을 실험했고, 피티아의 학습 체크포인트를 거슬러 올라가 어텐션 싱크가 생기는 순간을 찾았다. 1.6만 토큰짜리 앞부분의 캐시를 재사용하자 Qwen3-8B의 첫 토큰이 54배 빨리 나왔다. 캐시를 4비트로 줄일 때 Qwen3는 키를 토큰별로 자르자 무너졌지만, 채널별로 자르면 멀쩡했다. 최근 토큰만 남기자 흔들리던 모델은 첫 토큰 하나를 붙잡아 두자 되살아났다. 인터랙티브 위젯 7종, 코어닷투데이 실측, 삽화 13장.
리더보드 1·2·3위를 한국어로 붙였더니 — GLiDE·Sieve·KnowLine 판정 모델 실측
Decision Index 0.4.1에서 KnowLine 71.86, GLiDE 71.52, Sieve 71.10. 247개 모델의 맨 위에서 세 모델이 0.76점 안에 묶였고 Jev 1.13은 59.22였습니다. 그런데 이 리더보드에는 한국어가 없습니다. 코어닷투데이는 core2의 A100 80GB와 core3의 A100 40GB에 세 모델을 올려 한국어 2,221문항과 변형 문항으로 재고, Jev와 기존 로컬 모델 8종과 나란히 놓았습니다. 세 모델은 모두 Jev를 앞섰지만 5~8점 차였고, Sieve와 KnowLine은 구분되지 않았으며 GLiDE는 그 둘에 뒤졌습니다. 가장 크게 갈린 곳은 점수가 아니라 글 속에 심은 지시였습니다. Sieve는 65%가 넘어갔고 KnowLine은 0.3%만 넘어갔는데, 그 KnowLine도 평서문으로 쓴 고객 메모에는 16건을 다 따랐습니다. 세 모델의 약점이 서로 다르고, 세 칸을 모두 통과한 모델은 없었습니다. 8비트로 줄여도 세 모델 모두 점수를 잃지 않았고, 셋 다 40GB 카드에서 돌았습니다. KnowLine이 4천 토큰에서 막힌 원인은 서버의 한 줄이었고, 인자 두 개로 2만 3천 토큰까지 늘렸습니다.
[특집] 같은 가중치, 10배 가격 — 오픈 모델을 사는 법
OpenRouter에 올라온 오픈 웨이트 모델 28개의 엔드포인트 518개를 내려받아 같은 모델의 가격을 나란히 놓았습니다. 출력 단가의 폭은 중앙값으로 2.8배, 입력 단가는 5배였고, GLM-5.3은 49개 엔드포인트 사이에서 채팅형 섞인 가격이 10.7배 벌어졌습니다. 가장 싼 공급자는 캐시 적중률과 입력:출력 비율에 따라 바뀌었고(DeepSeek V4.1 Flash는 채팅·RAG·에이전트에서 1등이 모두 달랐습니다), 가장 싼 가격 상당수에는 할인 표시와 미공개 양자화가 붙어 있었습니다. InferenceX 원가로 보면 모든 공급자 가격이 최신 칩에서는 남지만 H100·H200급에서는 DeepSeek V4.1 Flash를 파는 42곳 모두가 손해였고, 연구소 자체 가격은 최적 칩 원가의 1.4~9.2배였습니다. 같은 가중치는 같은 상품이 아니며, 오픈 모델은 출력 단가가 아니라 '내 작업 모양의 섞인 가격'과 라벨로 사야 합니다.
글·사진·소리·영상을 하나의 좌표로 — 내 폰 안에서 도는 740M 임베딩 모델, EmbeddingGemma 2 특집
2026년 10월 6일 구글 딥마인드가 공개한 EmbeddingGemma 2는 텍스트·코드·이미지·비디오·오디오를 하나의 768차원 공간에 놓는 7억 4천만 파라미터짜리 공개 임베딩 모델입니다. 텍스트만 쓰면 191MB, 전부 켜도 567MB로 스마트폰 안에서 돌고, 음성 메모로 영상을 찾고 사진으로 문서를 찾는 일이 서버 없이 가능해집니다. 이 글은 '단어는 친구를 보면 안다'는 1950년대 가설에서 word2vec의 왕−남자+여자=여왕, SBERT의 65시간→5초, CLIP의 N×N 행렬, ImageBind와 Gemini Embedding 2까지 임베딩이 걸어온 길을 되짚고, EmbeddingGemma 2의 모듈 구조·토큰 예산·마트료시카 절단·양자화를 논문 그림과 표로 뜯어봅니다. 구글이 비교하지 않은 경쟁 모델, 해커뉴스의 반론, 한국의 망분리·KURE, 그리고 단일 벡터의 이론적 한계까지 함께 다룹니다. 위젯 5개와 일러스트 9장.
마트료시카 임베딩 — 벡터를 앞에서부터 잘라도 되는 이유와, 잘랐을 때 실제로 남는 것 (한국어 검색 스택 3편)
Qwen3-Embedding-8B의 벡터는 숫자 4,096개입니다. 5,000만 청크를 float32로 저장하면 벡터만 819GB입니다. 그런데 이 벡터의 앞 256개만 남기고 나머지를 버려도 검색 품질의 93%가 남는다면? 그것이 마트료시카 임베딩입니다. 2022년 논문 「Matryoshka Representation Learning」이 제안하고 OpenAI text-embedding-3, Nomic v2, Qwen3 Embedding이 채택한 이 기법은 '중요한 정보를 벡터의 앞쪽에 몰아넣도록' 학습해, 러시아 인형처럼 큰 벡터 안에 작은 벡터가 들어 있게 만듭니다. 이 글은 원리를 장난감 모형으로 손에 잡히게 설명하고, 같은 한국어 코퍼스로 Qwen3 4B·8B와 Nomic v2를 32차원까지 잘라 가며 잰 실측 곡선, 저장 비용 계산기, 그리고 '짧게 걸러서 길게 고르는' 두 단계 적응형 검색이 전체 차원의 품질을 얼마나 되찾는지를 보여 줍니다. 인터랙티브 4개와 삽화 7장.
모델 서빙 설계 가이드 2026 — 요청 하나의 여정으로 배우는 구조와 노하우
2026년 10월의 모델 서빙에서 엔진은 사실상 정해졌습니다(vLLM, SGLang). 설계의 승부는 엔진 바깥에서 납니다. 이 글은 요청 하나가 들어와 답이 나가기까지의 여정을 식당 운영에 빗대어 따라가며, 지금 통하는 설계와 그 근거를 정리합니다. 응답 시간을 대기·읽기·쓰기로 나눠 재는 법, 최대 처리량이 아니라 굿풋으로 용량을 세는 법, 엔진의 기본값(동시 처리 1,024개, 대기열 무제한)을 그대로 쓰면 안 되는 이유, 같은 대화를 같은 서버로 보내는 것만으로 처리량이 두 배가 되는 라우팅, 받을 수 없는 요청을 거절하는 입장 제어, GPU 사용률이 아닌 확장 신호, 수십 GB 모델의 콜드 스타트를 줄이는 방법, 세대별 양자화 선택, 그리고 규모별 구성까지. vLLM 0.30과 llm-d 0.10의 문서, 그리고 Together·Modal·Baseten·토스·네이버 등이 올해 공개한 운영 사례의 수치를 근거로 삼았습니다. 직접 움직여 보는 위젯 6개가 들어 있습니다.
로컬 AI는 '열등한 Opus'가 아니다: 내 컴퓨터 속 모델은 완전히 다른 연장이다
1만 2천 달러짜리 GPU를 사서 자기 사무실에 AI를 들인 한 엔지니어가 던진 한 문장이 화제가 됐다. '로컬 Qwen은 더 싼 Opus가 아니라, 아예 다른 연장이다.' 대장장이가 칼을 담금질하듯 한순간도 눈을 뗄 수 없는 이 모델은 왜 어떤 일에서는 무너지고 어떤 일에서는 클라우드를 압도할까. 오픈웨이트 AI의 역사부터 트랜스포머·MoE·양자화·투기적 디코딩 같은 핵심 아키텍처, 벤치마크의 함정, 그리고 2026년 데이터 주권의 시대에 로컬 모델이 차지하는 진짜 자리까지 — 쉽고 자세하게 풀어본다.
Apple의 역(逆)베팅: 데이터센터 대신 당신의 주머니 — 온디바이스 AI 완전 해부
전 세계 빅테크가 데이터센터에 한 해 $725B를 쏟아붓는 동안, Apple은 정반대로 베팅했다 — 이미 사용자 주머니 속에 있는 수십억 대 기기. 2026년 6월 WWDC를 앞두고 Apple은 15년간 쌓은 자체 실리콘 경험을 무기로 "클라우드 대신 기기에서" AI를 돌리는 온디바이스 전략을 전면에 내세운다. 메인프레임→PC→클라우드→엣지로 도는 컴퓨팅의 진자, A11(0.6 TOPS)에서 M4(38 TOPS)까지 63배 커진 Neural Engine, 통합 메모리로 671B 모델을 Mac에 통째로 올리는 법, Apple Intelligence의 영광과 BBC 헤드라인 참사·Siri 연기·$250M 합의, Private Cloud Compute의 5대 프라이버시 보장, 2026년 Google Gemini 딜과 Nvidia 컨피덴셜 컴퓨트, 증류·양자화·LoRA로 모델을 다이어트시키는 원리, "사용자가 사준 컴퓨팅" $50B 논리, 그리고 개발자·기업을 위한 온디바이스 vs 클라우드 실무 의사결정까지. 인터랙티브 시뮬레이터 3종 포함.
70B 모델을 스마트폰에서 돌린다 — AI 추론 최적화의 모든 것
GPT급 거대 모델을 실시간으로, 저비용으로, 심지어 스마트폰에서도 돌리려면? 양자화, 프루닝, 지식 증류, 컴파일러 최적화까지 — AI 추론 최적화의 핵심 기법들을 실전 사례와 함께 총정리한다.
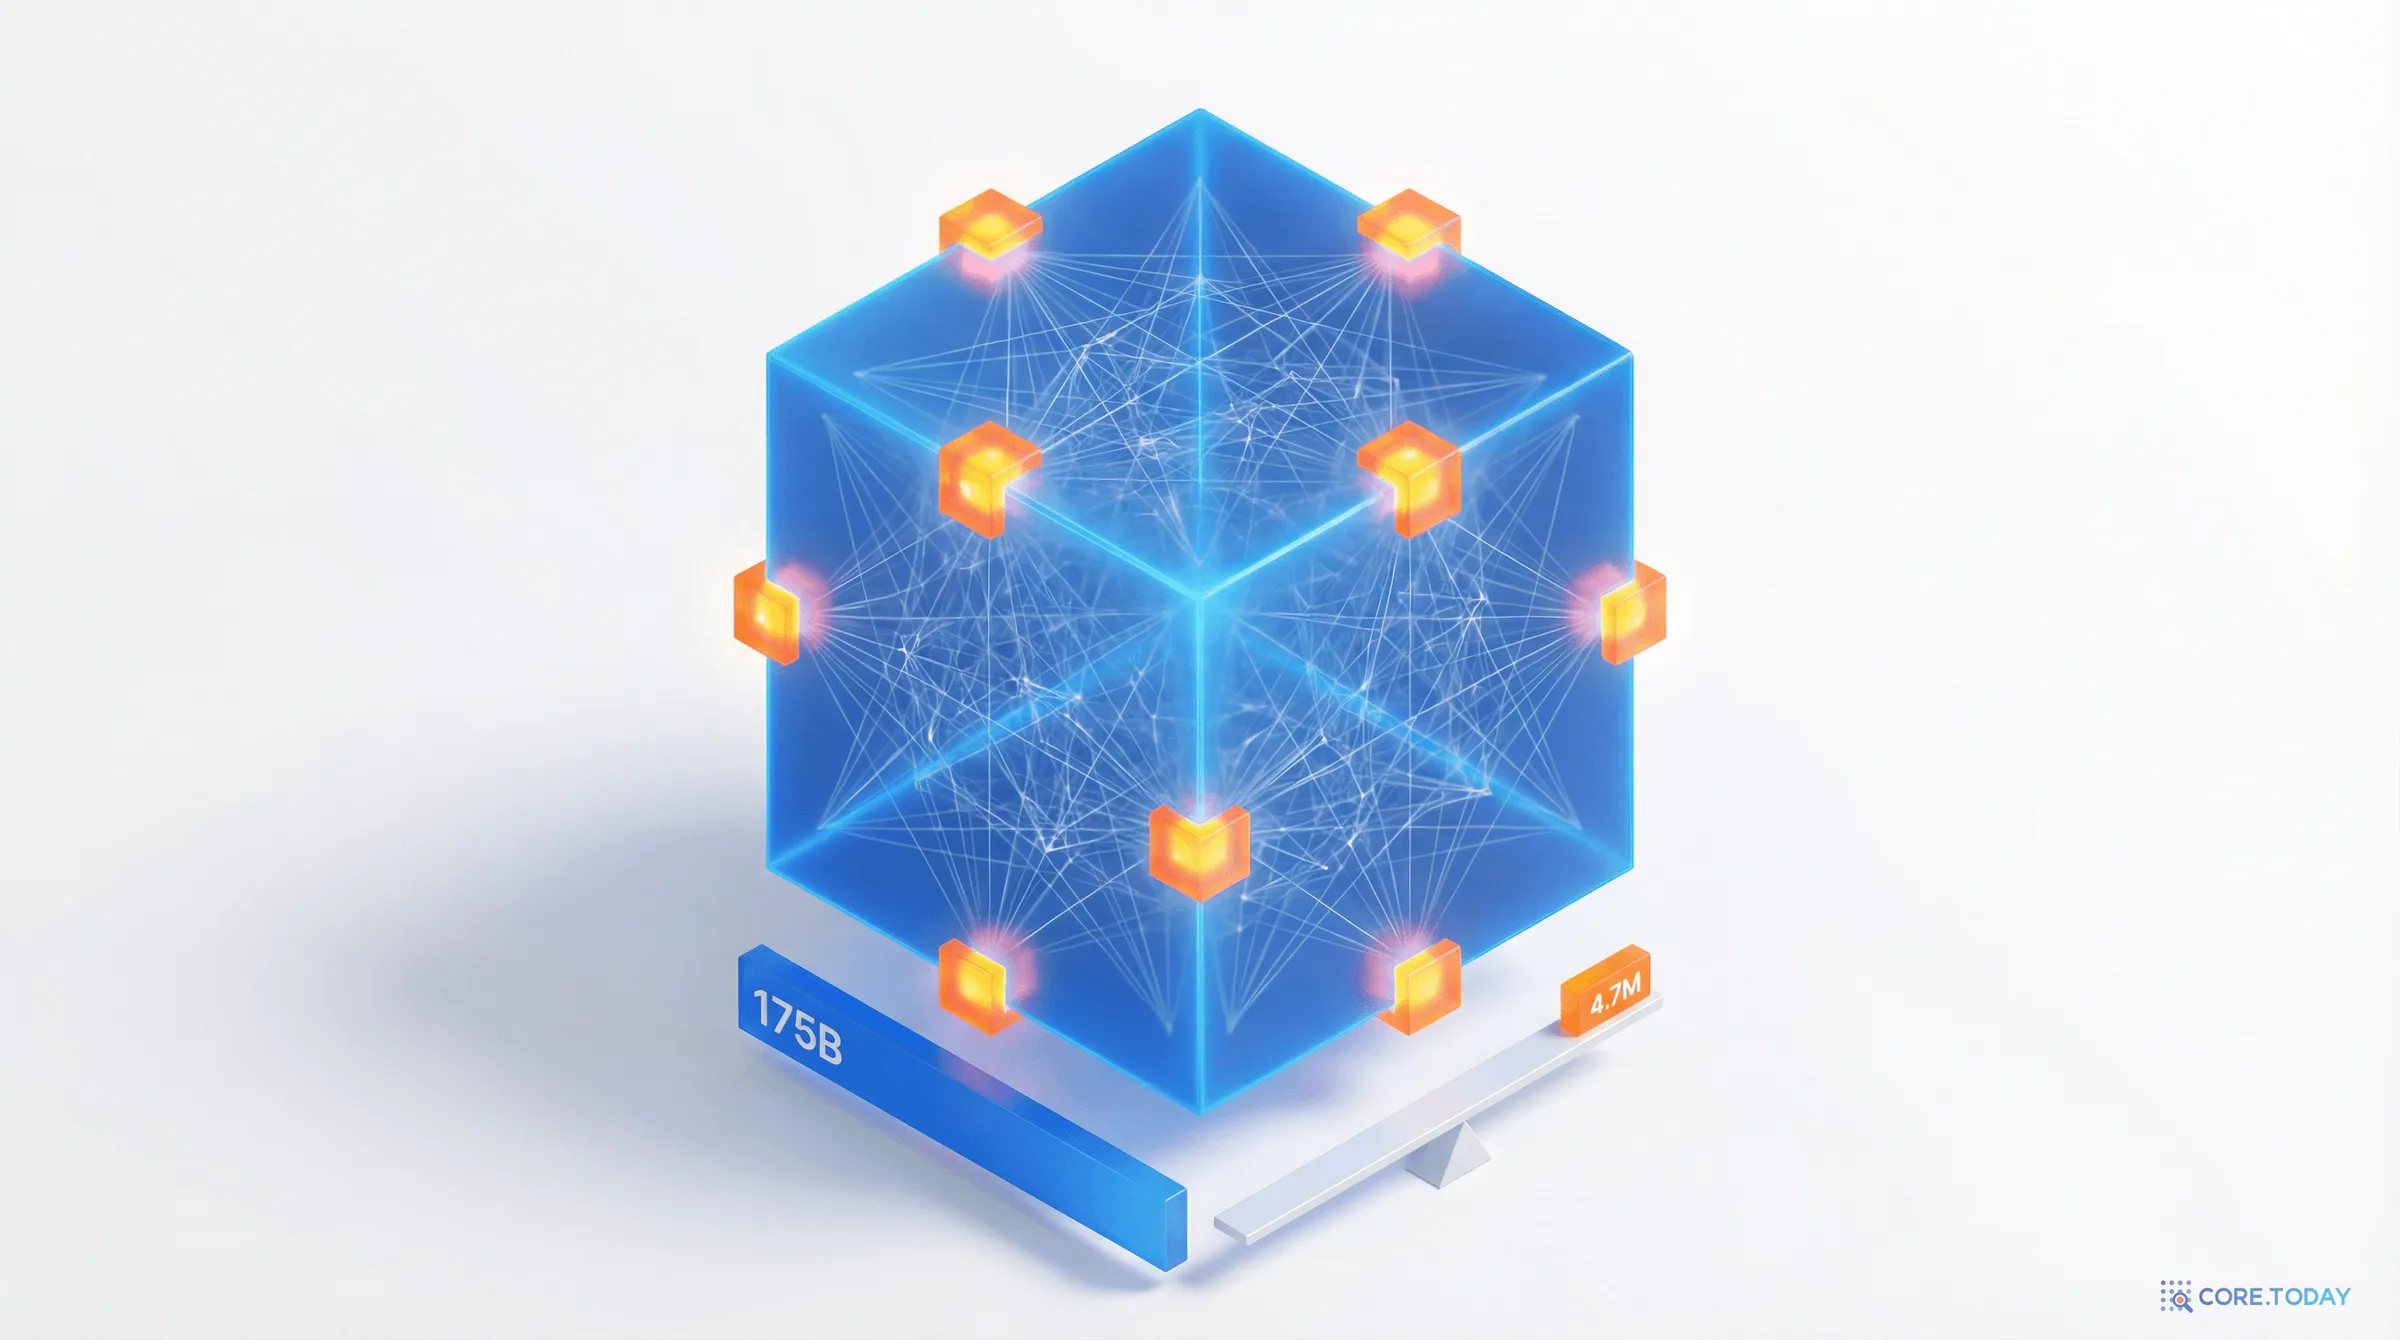
LoRA / QLoRA 특집: 1,750억 개 파라미터를 35MB로 길들이는 마법
GPT-3 175B를 파인튜닝하려면 1.2TB GPU 메모리가 필요하다. LoRA는 학습 파라미터를 1만 배 줄이고, QLoRA는 65B 모델을 단일 48GB GPU에서 학습 가능하게 만들었다. 저랭크 분해의 수학부터 2026년 모든 오픈소스 모델의 표준이 된 여정까지, 두 논문을 낱낱이 해부한다.
8-bit Adam 특집: 옵티마이저 메모리를 75% 줄인 블록별 양자화의 비밀
Adam 옵티마이저의 상태만 84GB — 모델보다 6배 크다. 2021년, Tim Dettmers는 옵티마이저 상태를 8비트로 압축해 75%를 절약하면서도 32비트와 동일한 학습 품질을 유지하는 방법을 발견했다. 블록별 양자화와 동적 트리 양자화의 원리를 파헤친다.