
#벤치마크
17개의 포스트
작은 모델, 큰 벤치마크 — K-LegalDeID로 읽는 BIO와 CRF의 귀환, 109만 건의 데이터, 그리고 0.99 뒤의 0.94
판결문 비실명화에 대한 두 번째 답이 2026년 3월 EACL에 나왔습니다. 고려대 연구진의 K-LegalDeID는 앞선 Thunder-DeID와 거의 모든 선택이 반대입니다. 라벨은 729개가 아니라 11개, 모델은 처음부터 사전학습한 15억 파라미터가 아니라 공개된 KLUE-BERT 1억 1천만에 CRF 층 하나, 데이터는 판결문 6,700건이 아니라 채팅·판결문·공개 데이터를 합친 109만 문장입니다. 그리고 엄격한 개체 단위 F1 0.9923을 보고합니다. 이 글은 1995년의 BIO 표기와 2001년의 CRF가 왜 2026년에 다시 쓰이는지부터 풀고, 39개 법 분야 2,000건의 새 데이터와 주석자 일치도 0.7352, 여섯 가지 채점 방식을 그림·표·위젯으로 따라갑니다. 숫자를 뜯어 보면 0.9923은 채팅이 대부분인 시험지의 점수이고, 새로 만든 판결문만으로는 0.94~0.97이며, 다른 연구실의 정답지로 채점하면 0.37로 떨어집니다. 코어닷투데이는 공개된 KLUE-BERT 어휘로 이름 2,000개에 조사를 붙여 직접 토큰화해, 경계가 맞아떨어지는 비율 97.3%와 ‘신한은행’이 한 토큰이 되는 문제를 확인했습니다.
두 논문이 남긴 숙제 — 판결문 비실명화는 어디로 가야 하나: 729 대 11, 0.99 대 0.37, 그리고 세계의 흐름
한국 판결문 비실명화를 다룬 두 논문, 서울대의 Thunder-DeID와 고려대의 K-LegalDeID를 열세 가지 설계 선택으로 나란히 놓고 읽습니다. 한쪽은 729개 라벨과 전용 사전학습으로 세밀하게, 다른 쪽은 11개 라벨과 CRF로 가볍게 갔습니다. 두 논문 모두 0.98~0.99를 보고하지만, 한쪽 모델을 다른 쪽 정답지로 채점하면 0.37이 나오고, 서울대의 후속작 Thunder-DeID+가 원래 모델을 전체 길이 판결문에서 어절 단위로 다시 재니 0.73이었습니다. 숫자가 모델의 실력이 아니라 자와 시험지를 재고 있다는 뜻입니다. 이 글은 그 간극의 원인을 정답 정의, 평가 단위, 원본 부재로 나누어 짚고, 재식별 성공률로 채점하는 RAT-Bench, 독일의 ‘프로젝트 5만’과 일본의 지정 법인 제도, EU AI Act의 익명화 예외 같은 2024~2026년 세계의 흐름을 정리합니다. 그 위에서 한국이 택할 수 있는 일곱 가지 방향을 제안합니다. 시험지를 법원 안에 두고 모델이 찾아가게 할 것, 정답의 정의부터 맞출 것, 문서 단위와 재식별 위험으로 잴 것, 층을 쌓을 것, 사람의 자리를 설계할 것, 공개의 단계를 나눌 것, 벤치마크를 살아 있게 할 것입니다.
한 줄만 틀려도 버린다 — 뉴스 4만 7천 묶음을 읽힐 LLM, 7종 12가지 설정을 같은 검증기로 재다
사실탐색기는 같은 사건을 다룬 기사 묶음 4만 7,300개에서 주장·시점·같은 사건 관계를 원문 인용과 함께 뽑아야 합니다. 어느 모델에 맡길지 정하려고 Claude 3종, DeepSeek Flash, Muse Spark, 무료 K-EXAONE, 사내 A100에 올린 Qwen3.8-27B까지 7종 12가지 설정을 같은 지시문과 같은 검증기로 쟀습니다. 검증기는 행 하나만 틀려도 이야기 전체를 거부합니다. 그래서 순위는 ‘통과하면 얼마나 잘하나’보다 ‘긴 이야기에서 끝까지 버티나’로 갈렸습니다. Claude Haiku 5.5는 7개를 모두 통과하며 기준 주장의 89%를 회수했습니다. DeepSeek·EXAONE·Qwen은 통과한 이야기에서는 72~88%를 회수하고도 긴 이야기를 거의 다 잃어, 판본에 남은 양이 14~29%였습니다. 지시문 한 줄은 Sonnet 5.5의 회수율을 34%에서 68%로 두 배 올렸지만 DeepSeek에는 독이 됐고, 생각 모드는 답 대신 생각만 남겼습니다. 무료와 할인의 조건, 사내 GPU로 돌리는 데 드는 시간, 주장 하나당 비용까지 정리했습니다. 위젯 3종, 코어닷투데이 실측, 삽화 6장.
‘롯데 홈구장 새로 짓는 거’를 찾아라 — 부산 공적 기록으로 잰 한국어 임베딩 모델 14종
사실탐색기가 질문 속 바꿔 말한 이름을 찾을 때 쓰는 임베딩 모델을 고르려고, 부산 공적 기록 362건에서 만든 네 과제로 임베딩 14종(설정 28가지)을 맥과 A100에서 쟀습니다. 한국어로 다시 학습한 1.1B 모델 KURE-v3가 8B 모델들보다 앞섰고, 300M짜리 EmbeddingGemma 1세대가 그 바로 뒤에 붙었습니다. 그러나 과제마다 1위가 바뀌었고, 권장 접두사를 빼면 1위 모델이 글자 검색보다도 못해졌으며, 열네 모델 가운데 여섯은 ‘7월 1일’과 ‘7월 8일’처럼 숫자 하나 다른 값의 절반 넘게를 같은 값 쪽으로 봤습니다. 무엇을 고를지와 함께, 임베딩에 맡기지 말아야 할 일을 정리했습니다.
답은 맞았는데 서랍은 엉망 — 에이전트 기억을 '속까지' 채점하는 FEB-30, 그리고 한국어 미니판 실측
에이전트 기억은 지금까지 '질문에 답을 잘하나'로만 채점됐습니다. AWS와 클루지나포카 공대 연구진의 FEB-30(arXiv 2610.22209)은 문서가 하나 들어올 때마다 기억 저장소를 직접 열어 정답 상태와 비교하자고 제안합니다. 30개 궤적에서 서랍 검사(내재)와 질문 채점(외재)은 평균 16.8점 벌어졌고, 두 채점의 통과·실패 일치도는 κ=0.118로 우연을 겨우 넘었습니다. 시스템이 생성·강화·갱신·대체 중 맞는 연산을 고른 비율은 20%였습니다. 이 개념이 어디서 왔는지(1993년 스파크 존스의 내재·외재 구분, 2013년 word2vec 유추, 2016년 '내재 점수는 실전을 예측하지 못한다' 논쟁)부터, 논문의 설계·표 13개·숨은 모순(외재 점수 30개 중 16개가 11번 내내 정확히 50%), 한국어 궤적 12개로 직접 돌린 미니 실측(같은 저장소가 판정 방식만 바꿔 100%와 25%), 2026년 기억 시스템의 변화와 실무 점검표까지 정리했습니다. 인터랙티브 7개.
기억력 시험은 만점, 심부름은 낙제 — MemoryArena가 보여 준 에이전트 기억의 진짜 시험
LoCoMo 같은 기억력 시험에서 90점대를 받는 에이전트가, 어제 산 카메라에 맞는 렌즈를 오늘 사 오는 심부름은 거의 못 합니다. ICML 2026 논문 MemoryArena는 기억을 '회상'이 아니라 '다음 행동'으로 채점합니다. 묶음 쇼핑·단체 여행·점진 검색·수학/물리 증명 사슬 701과제(하위 과제 4,850개)에서 롱컨텍스트·기억 에이전트·RAG 13가지 방식의 과제 성공률은 모두 0.20 이하였고, 단체 여행은 전원 0이었습니다. 기억 장치를 붙였다고 나아지지도 않았습니다. 왜 이런 시험이 필요해졌는지 1990년대 인지과학과 POMDP부터 건초더미 속 바늘, LoCoMo·LongMemEval까지 거슬러 올라가고, 네 경기장의 설계와 표·그림·부록 사례·공개 심사평을 하나씩 읽습니다. 공개 데이터로 '기억해 내기'와 '기억으로 행동하기'를 직접 갈라 재 보니, 같은 모델이 같은 기억으로 앞 여행자의 선택을 97% 떠올렸지만 그 선택을 기준 삼은 행동은 36%만 맞혔고, 필요한 사실을 정답으로 쥐여 줘도 31%였습니다. 모델이 직접 쓴 요약 메모는 취향만 적고 결정을 버려 회상 0%였습니다. 인터랙티브 5개.
[특집] Gemini 4 Argon 모델 카드 정독 — 19개 시험의 속사정과 구글이 '배제할 수 없다'고 적은 세 줄
구글이 9월 30일 '신뢰할 수 있는 사이버 방어자'에게만 먼저 풀었던 Gemini 4 Argon이 10월 13일 전 세계에 공개됐습니다. 모델 카드, 5쪽짜리 평가 방법 문서, 217쪽짜리 안전·보안 보고서가 함께 나왔습니다. 이 글은 셋을 처음부터 끝까지 읽고 정리한 특집입니다. 카드가 한 줄로 넘긴 '대규모 희소 Mixture-of-Experts'를 1991년 논문부터 거슬러 올라가 풀고, 입출력 합계 100만 토큰과 GraphWalks 시험이 무엇을 재는지 직접 풀어 보게 했습니다. 19줄 성적표는 줄마다 공개 리더보드와 맞춰 봤습니다. 하비 법률 시험 19.6%는 경쟁 세 모델보다 세 배 높지만 전체 79개 모델 중에서는 6위입니다. 과학 터미널 시험의 57.6%는 독립 측정에서 44.3%로 나왔습니다. 그리고 구글이 스스로 '배제할 수 없다'고 적은 세 가지(생물 무기 CCL, 사이버 CCL, 은밀성·상황 인식 TCL)를 프런티어 안전 프레임워크의 언어로 풀었습니다. 15개 과제 중 14개 통과, 평가를 알아챈 비율 0%→37.8%, 생각 없이 차 끓이는 이야기만 적고도 정답을 맞힌 장면까지 담았습니다. 인터랙티브 6개, 일러스트 10장, 논문·보고서 그림 10장.
메모리 벤치마크 점수, 믿어도 되나 — LoCoMo·LongMemEval을 직접 다시 채점해 봤다
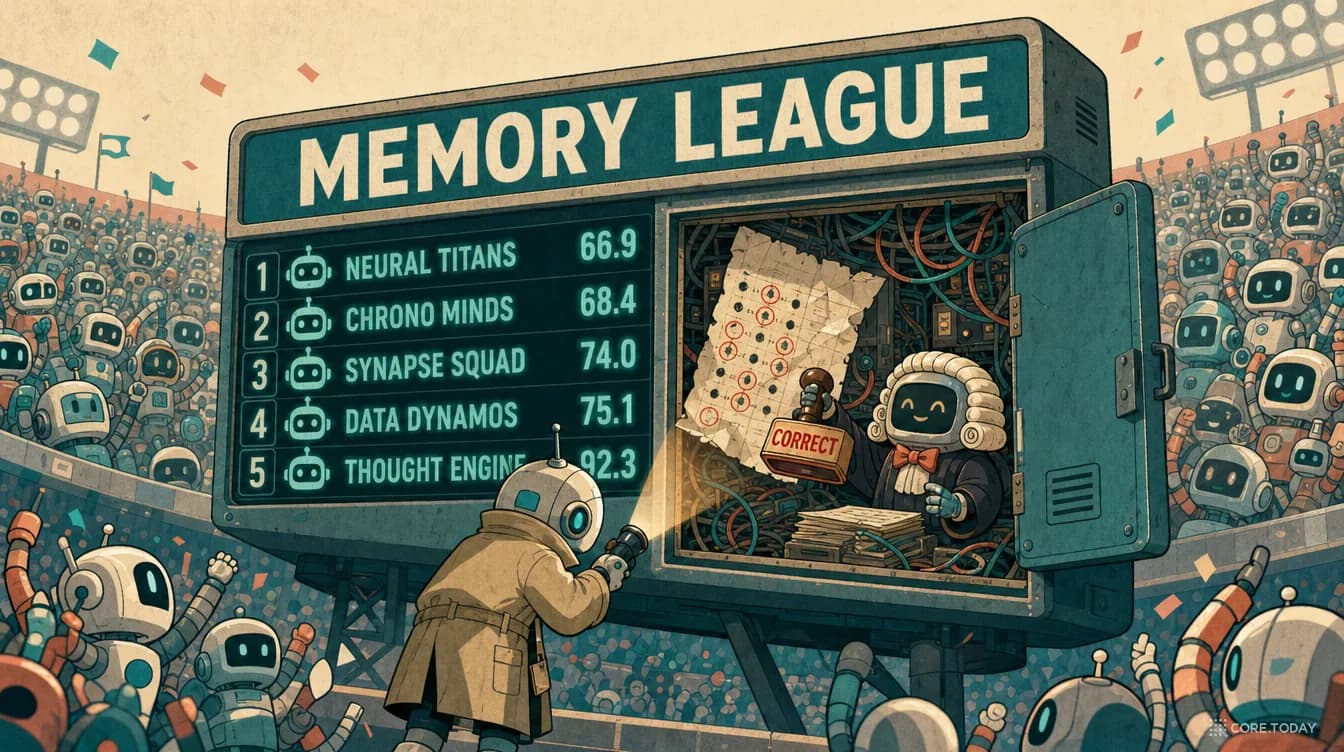
2026년 에이전트 기억 업계는 LoCoMo·LongMemEval에서 90점대를 발표합니다. 하지만 같은 Zep의 LoCoMo 점수는 누가 쟀느냐에 따라 58점에서 95점까지 흩어져 있습니다. 두 벤치마크를 직접 다시 돌렸습니다. 기억 시스템 없이 대화를 통째로 넣은 2026년 저가 모델이 LoCoMo 80.7%, LongMemEval 81.6%로 2025년의 기억 시스템들을 넘었습니다. 같은 답에 채점 프롬프트만 바꾸자 점수가 26점 움직였고, 정답과 오답을 나란히 적은 답을 Mem0의 2026년 채점 프롬프트는 100% 정답 처리했습니다. LoCoMo 정답지 1,540개를 대화 원문과 대조하니 7%가 틀렸거나 모호했고, 대화 10개에 몰린 문항이라 95% 구간은 ±3.1점이었습니다. bAbI부터 건초더미 속 바늘, SWE-bench Verified의 은퇴까지 벤치마크의 역사와, 점수를 읽는 점검표 10문항을 함께 정리했습니다. 인터랙티브 6개.
옛 사실은 정말 닫히나 — Graphiti에 한국어 상담 로그 240건을 넣어 직접 재 봤다
지난 글에서 코드를 읽고 짚은 Graphiti의 약점을 도커 위에서 직접 재 봤습니다. 가상의 고객 10명이 1년 동안 남긴 한국어 상담 240마디를 넣고, 7일 간격으로 '그래프는 이 사실을 참이라고 보는가'를 정답과 대조했습니다. 결과는 한 문장으로 요약됩니다. 시간 그래프의 품질은 추출 모델이 아니라 모순을 판정하는 '작은 모델'이 정합니다. 기본값(gpt-4.1-nano)으로 두면 클라이밍을 시작했다는 한 마디가 집·직장·약 기록을 한꺼번에 닫았고, 판정만 gpt-4.1-mini로 바꾸자 잘못 닫힌 사실이 0건이 됐습니다. 그래도 이사·이직의 40%는 끝까지 닫히지 않았고, 이를 고치려는 PR #1729는 반대로 변경 반영률을 20%까지 떨어뜨렸습니다. 한국어 키워드 검색은 기본 분석기에서 질문 80개 중 43개가 빈 결과였고, cjk 분석기로 바꾸자 적중률이 23.7%에서 58.8%로 올랐습니다. 실행 8번, 에피소드 1,920건, 인터랙티브 5개.
벤치마크 점수로 AI 모델을 고르면 안 되는 이유 — 독파모 2차 평가 원점수로 직접 계산해 보기
8월 18일 발표된 독자 AI 파운데이션 모델 2차 평가에서 SKT·업스테이지·LG가 통과하고 모티프가 탈락했습니다. 그런데 과기정통부가 8월 27일 공개한 세부 점수를 보면 모티프는 벤치마크 점수 1위였고, 국제 평가 기관 Artificial Analysis의 지수에서는 2위와 10점 넘게 차이가 났습니다. 결과를 가른 것은 전문가와 사용자 평가였습니다. 평가위원 10명과 국민 평가단 185명의 원점수까지 공개된 자료로, 가중치를 바꾸면 순위가 어떻게 달라지는지 직접 계산해 볼 수 있게 했습니다. 공정했느냐를 따지려는 글이 아닙니다. 국내 모델을 고르는 기업에 '벤치마크 1위'가 무엇을 뜻하고 무엇을 뜻하지 않는지 보여 주는 드문 공개 데이터라서 들여다봤습니다. 2027년 AI 예산 9.4조와 '모두의 AI'까지 함께 정리했습니다.
[특집] 소버린 AI 2차 평가의 역설 — 벤치마크 1위가 탈락했다: 독자 AI 파운데이션 모델 14개월과 '무엇으로 평가할 것인가'
2026년 8월, 국가대표 AI 모델을 가리는 '독자 AI 파운데이션 모델' 2차 평가에서 모티프테크놀로지스가 탈락했습니다. 그런데 세계적 평가 지표인 Artificial Analysis 지수로는 네 팀 중 모티프가 가장 높았습니다. 벤치마크 합계도 1위, 그러나 전문가와 사용자 점수는 꼴찌. 공개된 세부 점수로 배점을 바꿔 다시 채점해 보면, 이 탈락은 '모델의 우열'이 아니라 '무엇을 중시하기로 정했는가'의 결과에 가깝습니다. 1차에서 '독자성' 기준으로 탈락한 네이버, '처음부터 학습했나'를 둘러싼 공개 검증, 평가 화면에 모델 이름이 그대로 보였다는 지적, 절반 넘게 놀고 있는 임차 GPU, 그리고 '경쟁에서 육성으로'의 방향 전환까지 — 14개월의 기록과 다른 나라의 선택을 함께 봅니다.
글자를 포기한 모델 — TypeSafe의 Jev와 '시스템 원' 완전 해부
2026년 9월 15일, ChatGPT를 만든 사람이 2년 스텔스 끝에 내놓은 모델은 글을 쓰지 않는다. 상태와 타입이 정해진 질문을 받아 확률이 붙은 결정만 돌려준다. 해커뉴스 1,924점, API가 수요를 감당 못 해 잠시 멈췄다. 이 글은 그 모델의 구조(Choice·Score·Noul), 실제 API 모양, 회사가 공개한 워크플로 평가 데이터 전량, 그리고 커뮤니티가 제기한 반론까지 한자리에 놓는다. 흥미로운 사실 하나 — 평가 데이터를 뜯어 보면 Jev는 정확도 1등이 아니고, 정작 가장 유용한 발견은 Jev와 무관하다. 인터랙티브 위젯 7종과 삽화 12장. 한국어 사용자를 위한 경고도 포함.