
#모니터링
6개의 포스트
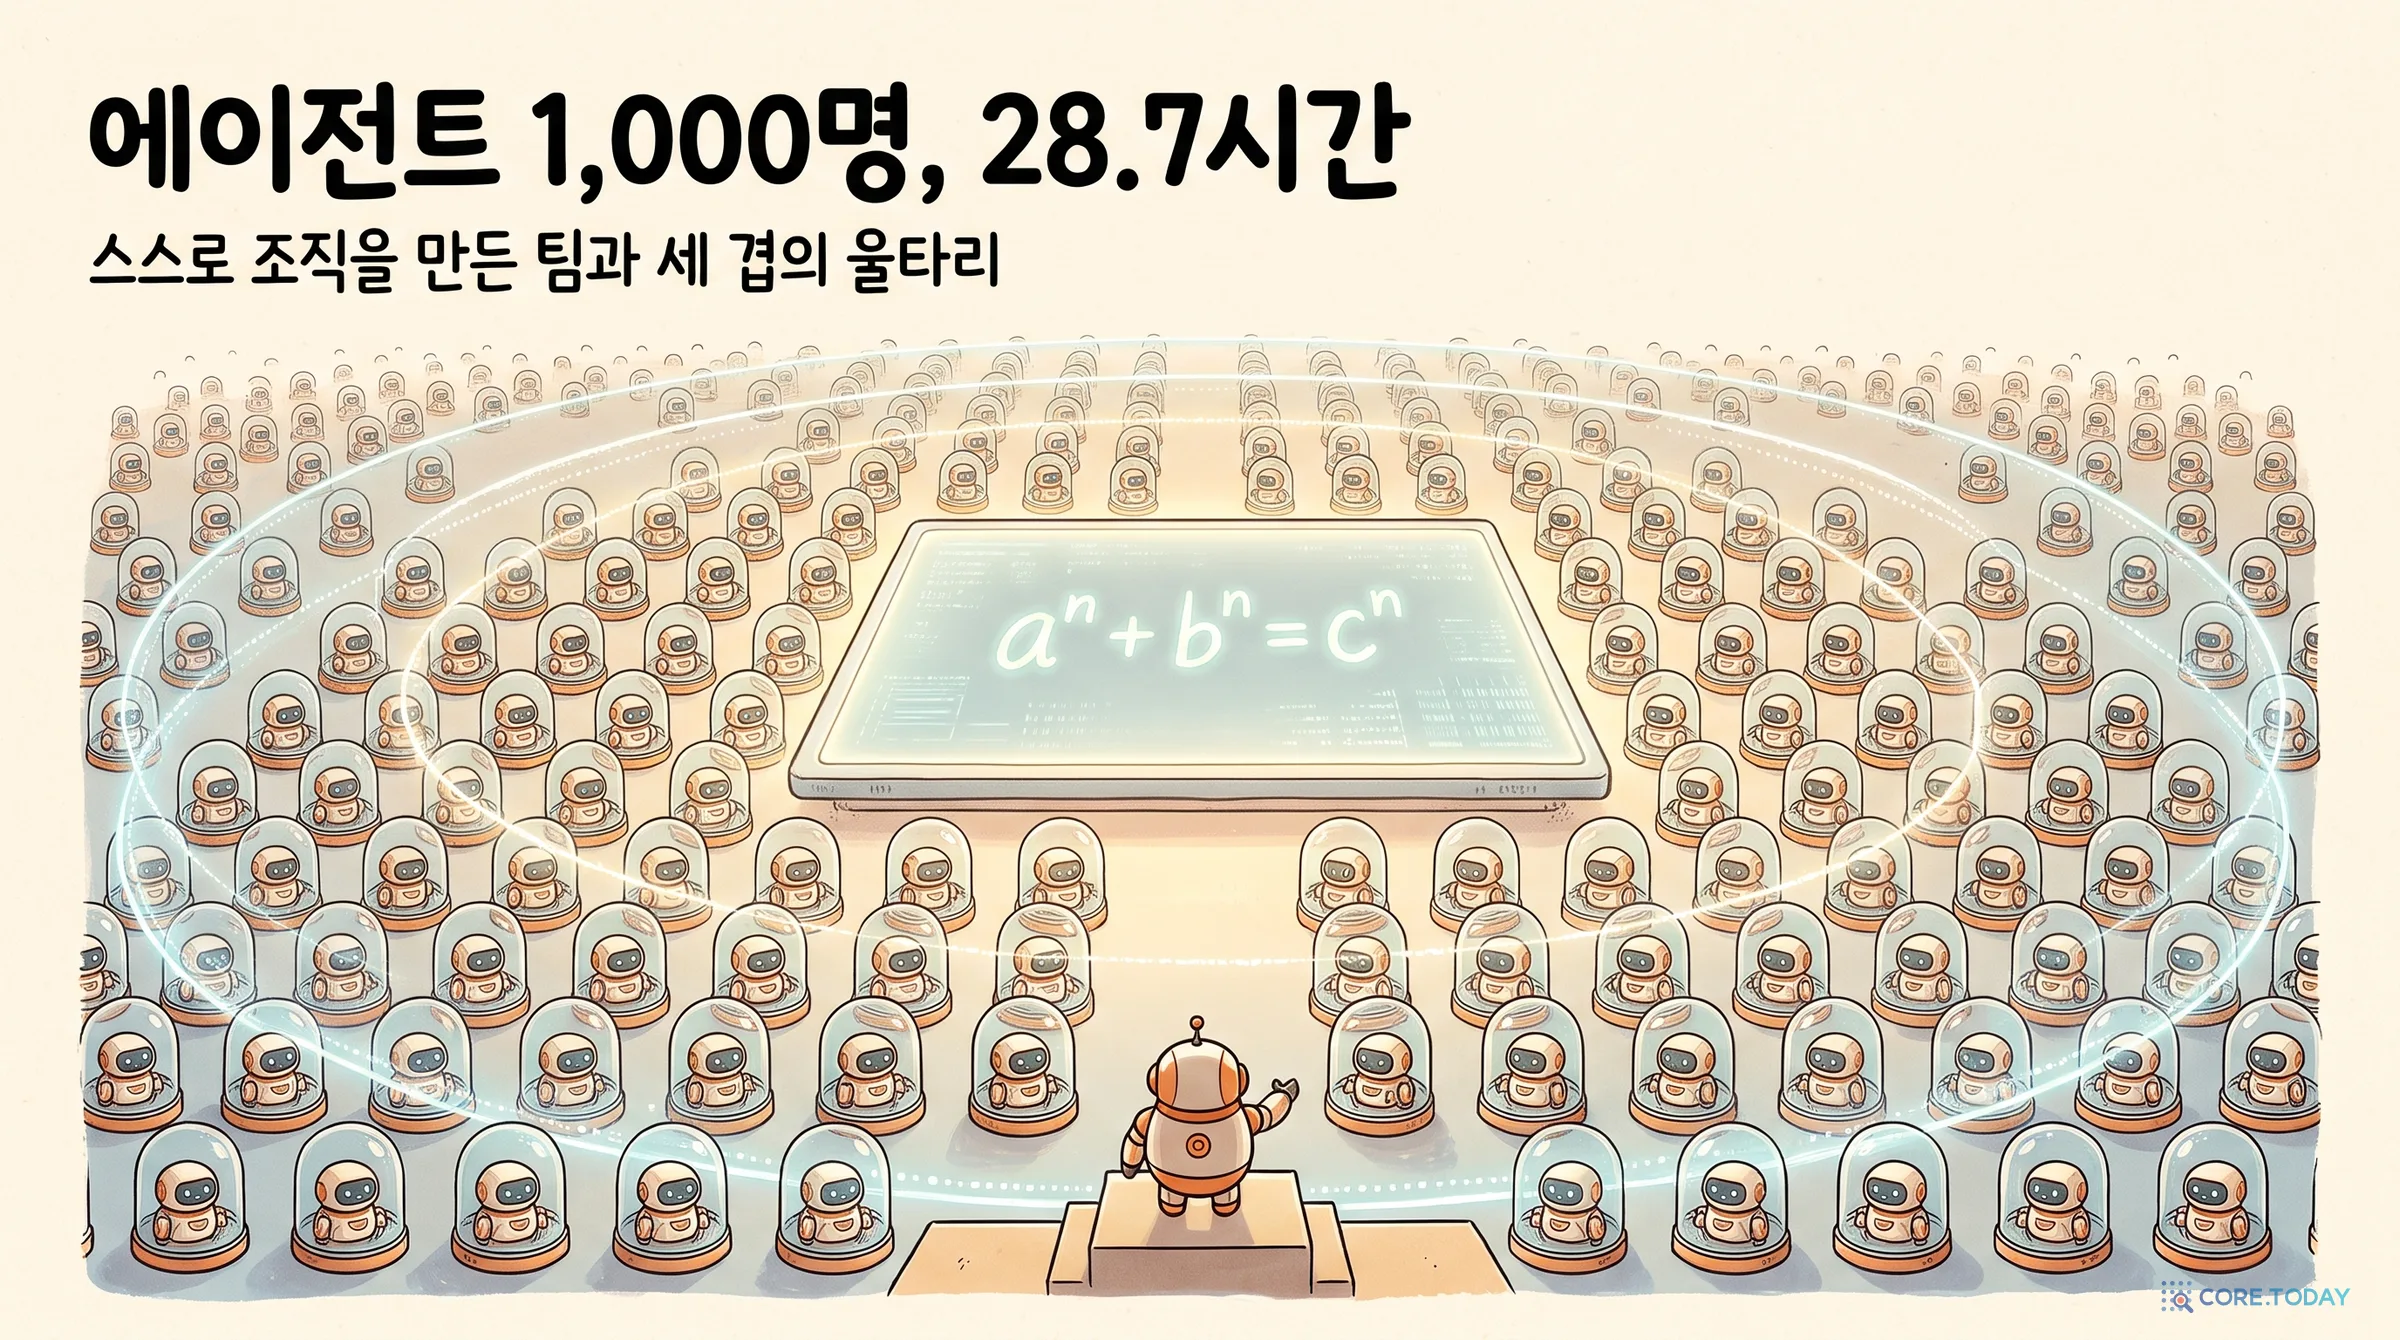
[특집] 에이전트 1,000명, 28.7시간 — 셸·Git·데이터베이스 하나로 페르마를 다시 증명한 팀과 세 겹의 울타리
Anthropic이 2026년 11월 9일 공개한 실험에서 Claude Fable 5.2 초기 버전 에이전트 1,000개가 전용 플랫폼도 연구자의 지휘도 없이 페르마의 마지막 정리 형식 증명을 28.7시간 만에 다시 만들었다. 받은 것은 셸, Git, 그리고 공유 데이터베이스 하나. 리드는 10분 만에 테이블 다섯 개로 조직을 세웠고, 도우미들은 스스로 과제를 쪼개 2,418개짜리 나무를 키웠다. 이 팀은 네트워크 없는 샌드박스와 도구 호출 분류기, 사후 감시라는 세 겹의 울타리 안에서 일했다. 브룩스의 법칙과 1980년의 칠판 시스템에서 2026년의 AI 통제 연구까지, 왜 '많은 에이전트를 안전하게 굴리는 일'이 이런 모양이 됐는지를 원문 그림과 영상 수치, 인터랙티브 7개로 풀고, 이 실험이 보여 주지 않는 것까지 따져 본다.
한 번 만들고 끝이 아니다 — DX를 위한 자동화와 운영의 기술
DX 전문가 로드맵 7편 — DX는 '한 번 만들고 끝'이 아니라 '계속 돌아가야' 한다. 2009년 Flickr의 'Dev and Ops' 발표에서 시작된 DevOps 혁명부터 2026년 AI 기반 자율 운영까지. CI/CD, 모니터링, MLOps, DataOps — 자동화와 운영의 기술을 총정리한다.
CloudWatch 완전 정복: 클라우드 서비스의 '블랙박스'를 읽는 법
서버가 죽기 전에 알 수 있다면? 비용이 폭증하기 전에 감지할 수 있다면? CloudWatch는 AWS의 모든 서비스에서 무슨 일이 일어나고 있는지를 실시간으로 보여주는 '블랙박스 레코더'다. 모니터링이 왜 필요한지부터, 메트릭·로그·알람·대시보드의 실전 활용까지.
SRE 입문: Google이 서비스를 99.99% 살려두는 방법
99.9%와 99.99%의 차이는 연간 8시간 vs 52분이다. Google이 만든 SRE(사이트 신뢰성 엔지니어링)는 소프트웨어 엔지니어가 운영을 설계할 때 어떤 일이 벌어지는지 보여준다. SLI/SLO/SLA부터 에러 버짓, 카오스 엔지니어링, 한국 기업 사례까지 — SRE의 모든 것을 정리한다.
Prometheus + Grafana: 오픈소스 모니터링의 표준 조합 완전 정복
서버가 죽기 5분 전에 알 수 있다면? 전 세계 개발자가 선택한 오픈소스 모니터링 표준 Prometheus와 Grafana를 데이터 모델부터 PromQL, Alertmanager, Kubernetes 클러스터 모니터링까지 완전 정복한다.
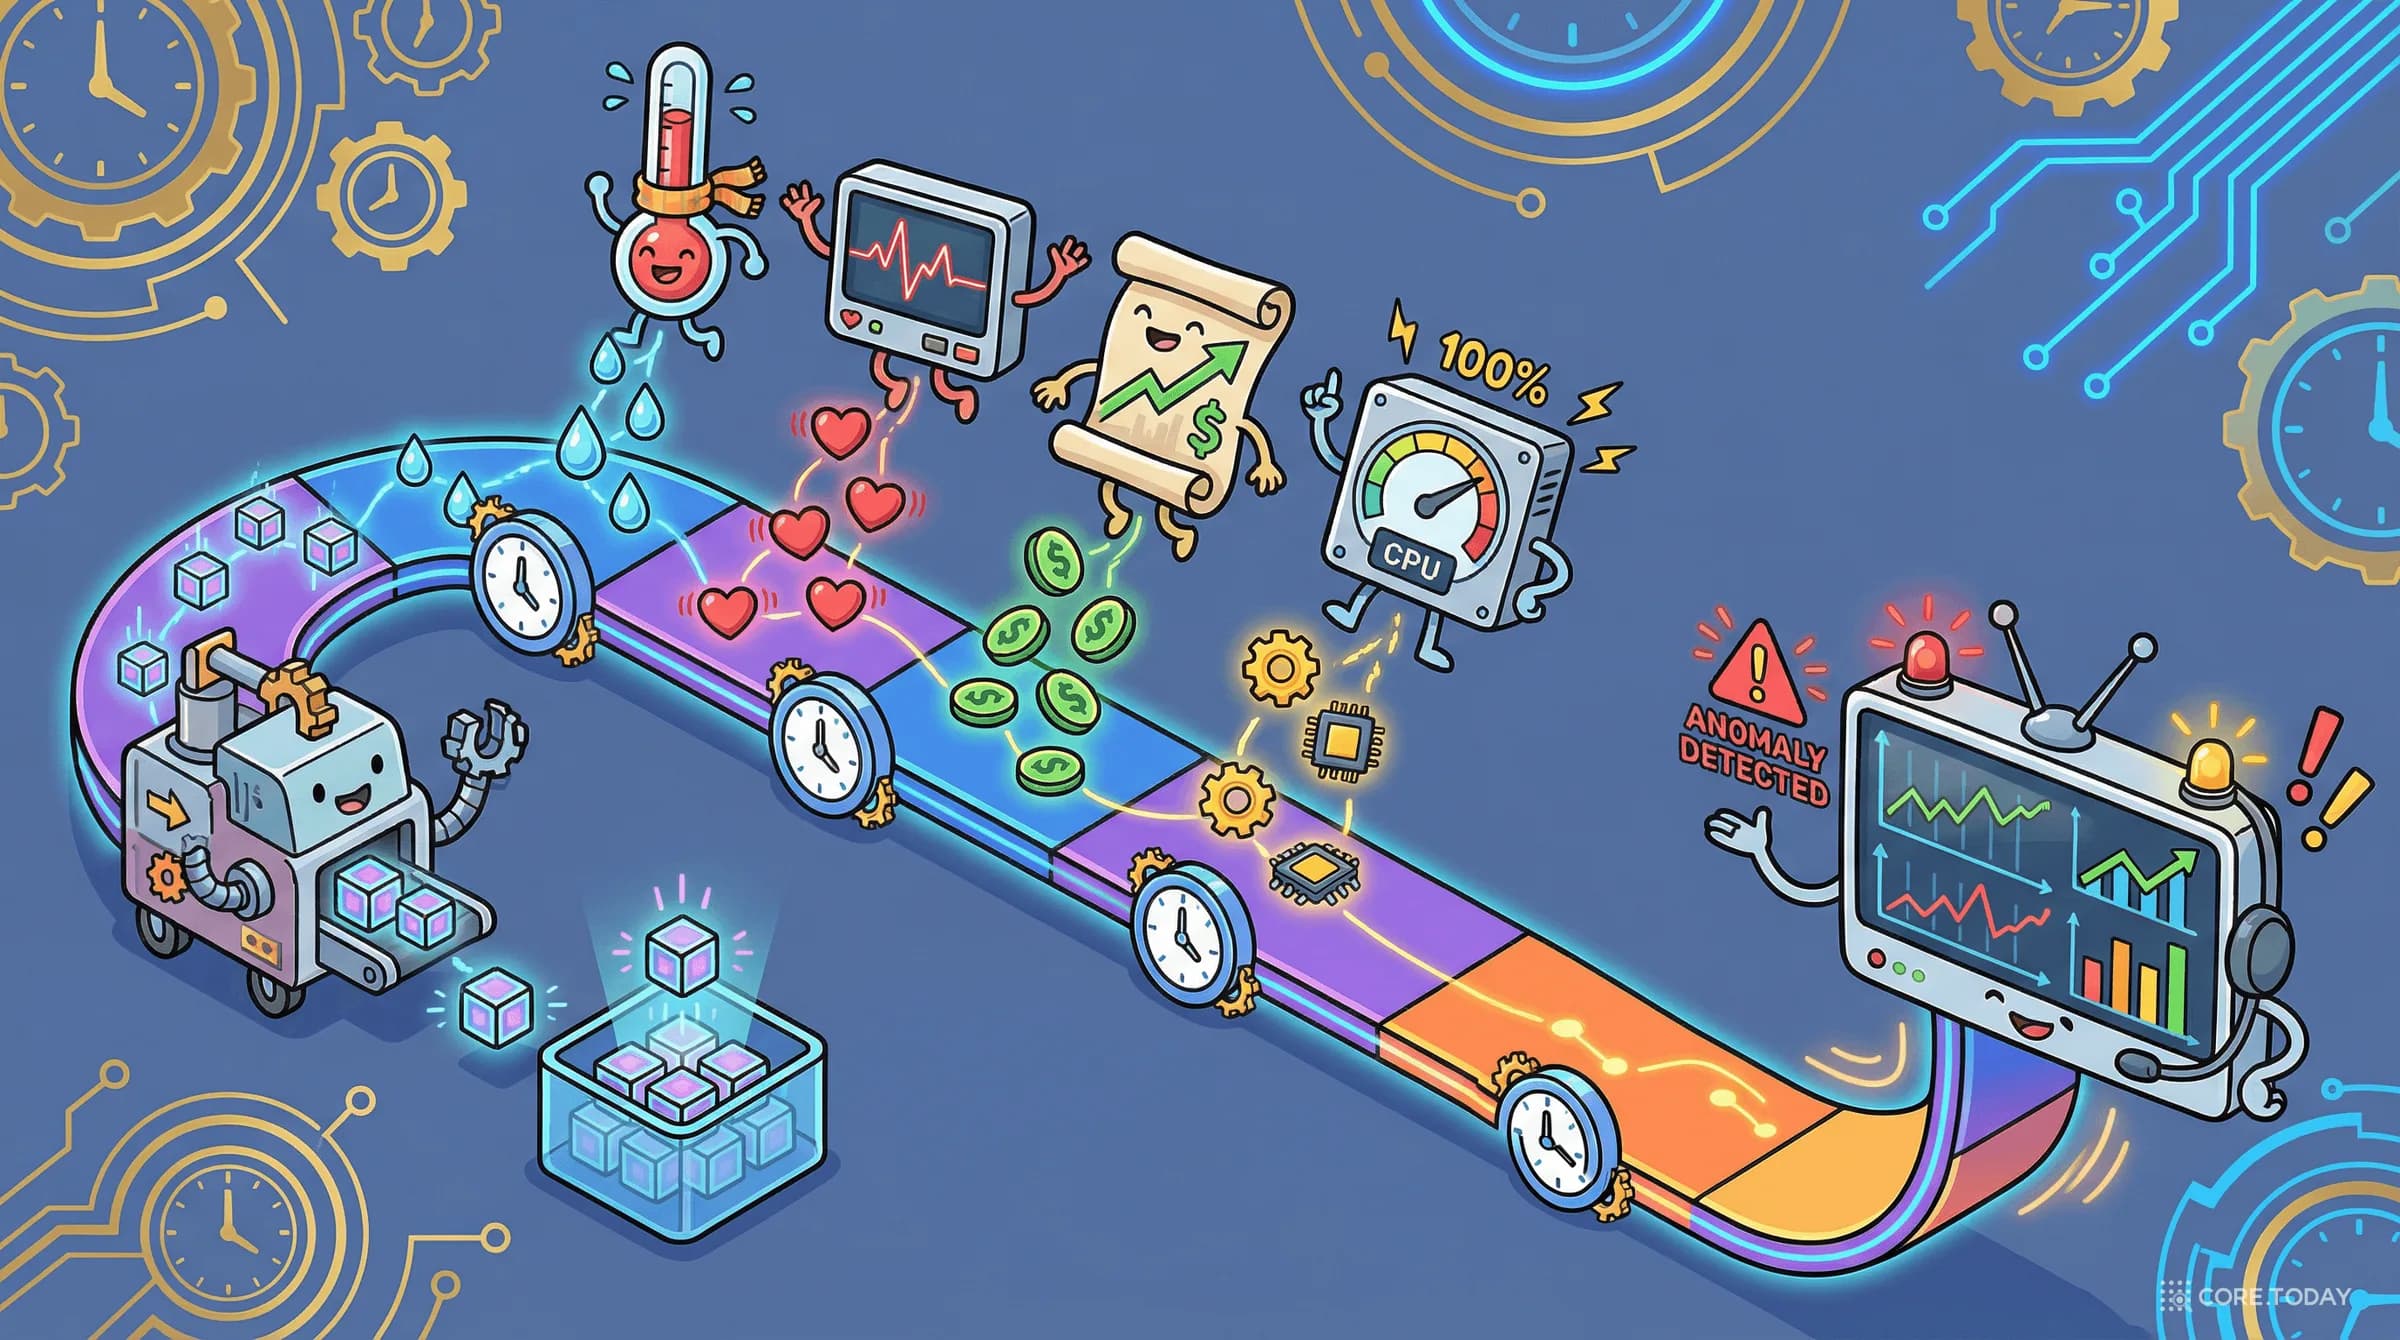
시계열 데이터베이스 완전 정복: 시간이 곧 데이터인 세계를 다루는 법
서버 CPU 사용률, IoT 센서 온도, 주가, 심박수 — 이 데이터의 공통점은 '시간에 따라 끊임없이 생성된다'는 것이다. 일반 DB에서 이 데이터를 다루면 왜 느리고, 시계열 DB는 어떻게 이 문제를 해결하며, 어떤 제품을 선택해야 하는지를 풀어본다.