
#리걸테크
9개의 포스트
작은 모델, 큰 벤치마크 — K-LegalDeID로 읽는 BIO와 CRF의 귀환, 109만 건의 데이터, 그리고 0.99 뒤의 0.94
판결문 비실명화에 대한 두 번째 답이 2026년 3월 EACL에 나왔습니다. 고려대 연구진의 K-LegalDeID는 앞선 Thunder-DeID와 거의 모든 선택이 반대입니다. 라벨은 729개가 아니라 11개, 모델은 처음부터 사전학습한 15억 파라미터가 아니라 공개된 KLUE-BERT 1억 1천만에 CRF 층 하나, 데이터는 판결문 6,700건이 아니라 채팅·판결문·공개 데이터를 합친 109만 문장입니다. 그리고 엄격한 개체 단위 F1 0.9923을 보고합니다. 이 글은 1995년의 BIO 표기와 2001년의 CRF가 왜 2026년에 다시 쓰이는지부터 풀고, 39개 법 분야 2,000건의 새 데이터와 주석자 일치도 0.7352, 여섯 가지 채점 방식을 그림·표·위젯으로 따라갑니다. 숫자를 뜯어 보면 0.9923은 채팅이 대부분인 시험지의 점수이고, 새로 만든 판결문만으로는 0.94~0.97이며, 다른 연구실의 정답지로 채점하면 0.37로 떨어집니다. 코어닷투데이는 공개된 KLUE-BERT 어휘로 이름 2,000개에 조사를 붙여 직접 토큰화해, 경계가 맞아떨어지는 비율 97.3%와 ‘신한은행’이 한 토큰이 되는 문제를 확인했습니다.
두 논문이 남긴 숙제 — 판결문 비실명화는 어디로 가야 하나: 729 대 11, 0.99 대 0.37, 그리고 세계의 흐름
한국 판결문 비실명화를 다룬 두 논문, 서울대의 Thunder-DeID와 고려대의 K-LegalDeID를 열세 가지 설계 선택으로 나란히 놓고 읽습니다. 한쪽은 729개 라벨과 전용 사전학습으로 세밀하게, 다른 쪽은 11개 라벨과 CRF로 가볍게 갔습니다. 두 논문 모두 0.98~0.99를 보고하지만, 한쪽 모델을 다른 쪽 정답지로 채점하면 0.37이 나오고, 서울대의 후속작 Thunder-DeID+가 원래 모델을 전체 길이 판결문에서 어절 단위로 다시 재니 0.73이었습니다. 숫자가 모델의 실력이 아니라 자와 시험지를 재고 있다는 뜻입니다. 이 글은 그 간극의 원인을 정답 정의, 평가 단위, 원본 부재로 나누어 짚고, 재식별 성공률로 채점하는 RAT-Bench, 독일의 ‘프로젝트 5만’과 일본의 지정 법인 제도, EU AI Act의 익명화 예외 같은 2024~2026년 세계의 흐름을 정리합니다. 그 위에서 한국이 택할 수 있는 일곱 가지 방향을 제안합니다. 시험지를 법원 안에 두고 모델이 찾아가게 할 것, 정답의 정의부터 맞출 것, 문서 단위와 재식별 위험으로 잴 것, 층을 쌓을 것, 사람의 자리를 설계할 것, 공개의 단계를 나눌 것, 벤치마크를 살아 있게 할 것입니다.
판결문의 이름을 지우는 AI — Thunder-DeID로 읽는 비실명화의 역사, 729개의 꼬리표, 그리고 2026년
한국의 판결문은 공개가 원칙이지만, 공개 전에 사람 이름과 주소, 가게 이름까지 지워야 합니다. 이 일은 지금도 대부분 사람 손으로 이뤄지고, 법원의 자동 프로그램은 2019년 자료에서 정확도 15%, 2025년 자료에서 처리율 8%로 보고됐습니다. 서울대 연구진의 Thunder-DeID(EMNLP 2025 Findings)는 이 문제를 토큰 분류 모델로 풉니다. 원본 판결문을 구할 수 없다는 제약을 뒤집어, 이미 지워진 판결문 6,700건에 사람이 종류 꼬리표 48,306개를 붙이고 그 자리에 진짜 같은 이름을 채워 넣어 학습 데이터를 만들었습니다. 그 과정에서 나온 2단·16갈래·80가지·729개 라벨의 분류 체계, 조사를 떼어 내는 토크나이저, 에폭마다 이름을 갈아 끼우는 증강, 처음부터 사전학습한 DeBERTa 계열 모델(이진 F1 0.98, 종류 F1 0.91)을 그림과 표와 함께 하나씩 풉니다. 스위니의 87%에서 2026년 9월 법원 홈페이지 사고까지 재식별의 역사를 따라가고, 코어닷투데이가 로컬 모델로 직접 돌려 본 ‘다시 쓰게 하기’와 ‘가리킬 곳만 말하게 하기’의 차이, 논문이 말하지 않는 한계, 형사 판결문 공개 확대를 앞둔 2026년에 이 기술이 놓인 자리를 정리했습니다.
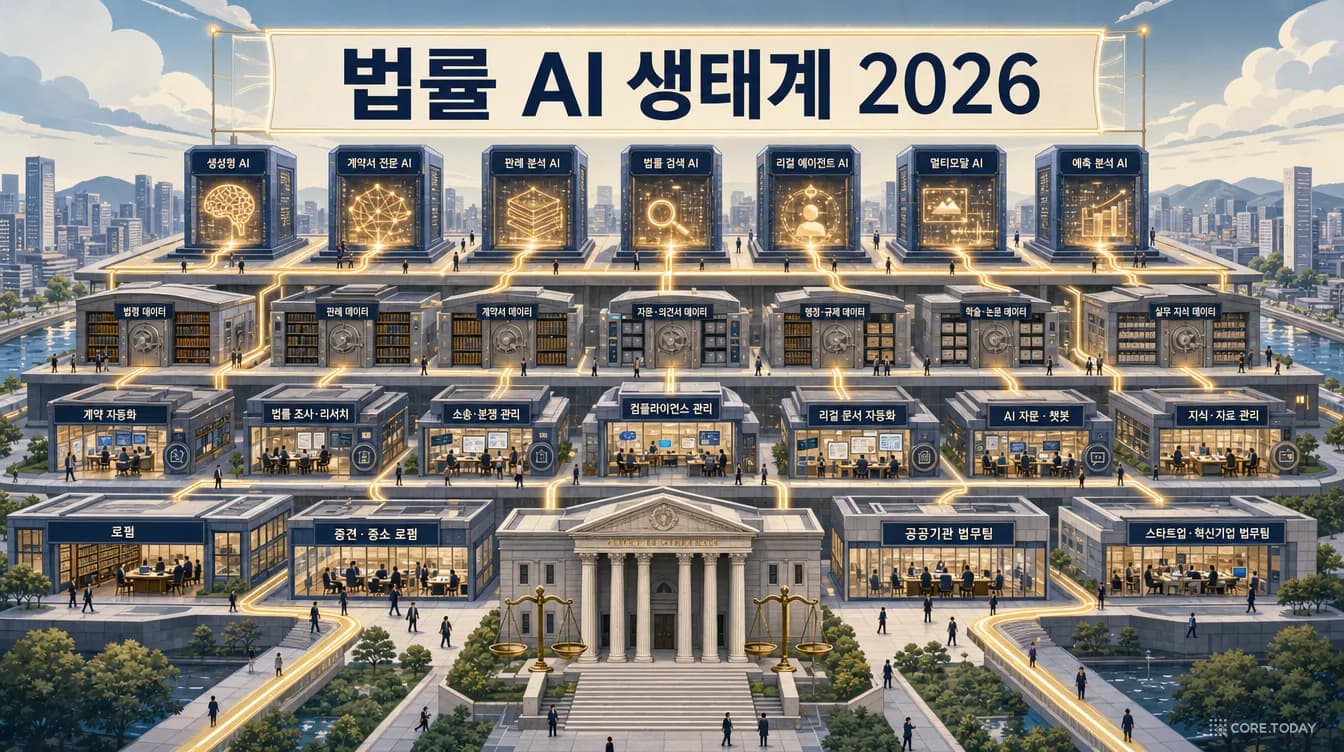
법률 AI 생태계 지도 2026 — 모델 회사는 법률로 내려오고, 법원은 검증을 요구하고, 돈은 '책임질 수 있는 결과물'로 모인다
2026년 2월 3일, Anthropic이 법률 업무 플러그인 하나를 내놓자 Thomson Reuters 주가가 하루에 16% 빠졌습니다. 그런데 반년 뒤 그 회사의 법률 매출은 10% 늘었고, 같은 해 법률 AI 스타트업 Harvey의 몸값은 80억 달러에서 155억 달러로 뛰었습니다. 한쪽에선 전 세계 법원이 AI가 지어낸 판례를 지적한 결정이 2,184건까지 쌓였고, 한국 법원 판결문에는 'AI Hallucination'이라는 영어가 그대로 적혔습니다. 모순처럼 보이는 이 장면들은 하나의 지도 위에 놓으면 이해됩니다. 모델·데이터·업무 도구·로펌·법원의 다섯 층이 2024년에서 2026년 사이 각각 어떻게 움직였는지, 법률 AI 시험지가 '변호사시험'에서 '실무 과제 전 항목 통과'로 바뀐 이유, 시간당 청구가 흔들리는 경제학, 신입 변호사의 사다리, 나홀로 소송의 역설, 그리고 한국 법원·로펌·리걸테크의 2026년까지. 논문과 판결과 실적 발표를 근거로 일곱 가지 인사이트를 뽑았습니다. 인터랙티브 6개, 논문·보고서 그림 8장, 삽화 9장.
GLM-Legal 완전 해부 — 가벼운 모델이 법률 에이전트 시험에서 프런티어를 이긴 방법: 중간학습, 하네스 공진화, 그리고 19.2%의 의미
2026년 10월 12일, 중국 Z.ai가 법률 특화 모델 GLM-Legal을 공개했습니다. 활성 파라미터 18B짜리 가벼운 모델(GLM-5.3-Flash) 위에 법률 중간학습과 수만 개의 법률 과제 환경 강화학습을 얹었더니, 로펌 실무 과제를 끝까지 해내야 하는 Harvey LAB에서 전 항목 통과율 19.2%로 Claude Fable 5(11.3%)와 GPT-6 Astra(5.4%)를 앞섰습니다. 과제당 비용은 0.15달러로 Fable 5의 약 130분의 1입니다. 그런데 19.2%는 열 건 중 여덟 건을 '불합격'했다는 뜻이기도 합니다. 1970년대 규칙 기반 법률 AI부터 가짜 판례 사건, LegalBench에서 Harvey LAB으로 바뀐 시험지, 중간학습과 하네스 공진화라는 아키텍처, 시연 세 장면, 순위표에서 빠진 모델과 퇴보한 지표까지, 이 발표를 둘러싼 모든 것을 쉽게 풀어 씁니다. 인터랙티브 6개, 논문·벤치마크 그림 11장, 삽화 10장.
[특집] '쉬우면 베껴도 된다'는 없다 — Thomson Reuters v. ROSS 항소심과 RAG·리걸테크 저작권 지도
9월 29일 미국 제3순회항소법원이 AI와 공정이용에 관한 첫 항소심 판결을 냈습니다. 법률 리서치 스타트업 ROSS가 웨스트로의 판례 요지(헤드노트)로 AI를 훈련한 것은 공정이용이 아니라는 결론입니다. 판결문을 읽어 보면 핵심은 'AI 학습이냐'가 아니라 '원본 시장을 대체하느냐'와 '꼭 필요했느냐'에 있었습니다. 법원은 원본 판례는 자유롭게 쓸 수 있었는데 편해서 헤드노트를 베꼈다며 이렇게 썼습니다. '필요와 달리 편의는 복제의 정당화 사유가 아니다.' 생성형 학습을 공정이용으로 본 Bartz·Kadrey 판결, 독일 GEMA v. Suno, 한국의 지상파 3사 v. 네이버 소송과 개인정보 AI 특례까지 엮어, 검색·요약형 AI 서비스가 어디서 위험해지는지 지도로 그렸습니다.
한국 빅로 AI 백서 2026: 율촌·김앤장·광장이 진짜로 쓰는 AI
2025년 12월 31일, 율촌이 BHSN과 함께 *AI:Yul (아이율)*을 가동했다. 같은 시기 김앤장은 자체 AI 번역 시스템을, 광장은 인터넷과 *물리적으로 분리된* eLK를, 세종은 글로벌 Harvey를 도입했다. 한국 7대 로펌의 AI 도입은 — 표면적으로는 비슷하지만 *전략은 모두 다르다.* 폐쇄형 RAG, 자체 LLM, 물리적 분리, Harvey 파트너십, 선거법 챗봇 — 5가지 패턴 + 5개 로펌의 *모든 정보를 통합해* 한국 어디에서도 본 적 없는 *2026 빅로 AI 백서*를 작성한다. 시리즈 6편.
Claude for Legal 완전 해부: AI가 법률 산업의 운영체제가 되는 날
2026년 5월 12일, Anthropic이 'Claude for Legal'을 출시하며 12개의 실무 플러그인과 20개 이상의 MCP 커넥터를 공개했다. 변호사가 가짜 판례를 인용해 벌금을 물던 시대에서, AI가 법률 워크플로우의 OS가 되는 시대로 — 그 사이에 무슨 일이 벌어졌는가. 역사부터 기술 아키텍처(MCP, Agent Skills, CLAUDE.md), 12개 플러그인, 파트너 사례, 그리고 한국 시장의 함의까지 완전 해부한다.
리걸테크 AI 대전 2026: 변호사의 일을 빼앗는 130조 원 시장의 모든 것
2026년 글로벌 리걸테크 시장이 965억 달러(약 130조 원)를 넘어섰다. Harvey($11B), Legora($5.55B), Hebbia($700M)가 수십억 달러 단위로 경쟁하고, 한국에서는 로폼·LBOX·Casenote·BHSN이 변협과의 25년 갈등 끝에 대법원 판결로 길이 열렸다. 시간당 $2,000짜리 변호사 노동을 1시간 단위가 아니라 1분 단위로 다시 가격 매기는 AI의 폭발 — 이 산업의 모든 플레이어, 모든 기술, 모든 윤리 논쟁을 한 편으로 정리한다.